263 joueurs de baseball, 19 statistiques par joueur, et l’envie de lancer un réseau de neurones pour prédire leur salaire. Trois modèles se disputent la tâche, et c’est le plus modeste qui sort vainqueur. Cette scène résume le piège : choisir un Transformer parce que tout le monde en parle, avant de regarder ce que tu as vraiment sous la main. Au fil de cette lecture, tu apprendras à trancher avec trois repères : tes données, ta tâche et ton budget.
Sommaire
- L’essentiel en 30 secondes
- Avant tout : ton problème a-t-il besoin d’un réseau profond ?
- Texte ou son : quelles alternatives plus légères ?
- Entraîner soi-même : ce que ça exige en données et en calcul
- La voie ordinaire : adapter un modèle déjà entraîné
- Ce que ça coûte une fois en production
- Quand il vaut mieux s’en passer
- Cas limites : quand le sujet sort du texte
- Trancher : cinq questions dans l’ordre
L’essentiel en 30 secondes
- Un réseau profond devient attractif quand tes données ont une structure séquentielle riche (texte, son, image) et que l’échantillon est très grand ; sinon, le modèle le plus simple suffit souvent.
- Entraîner un grand modèle de zéro est hors de portée : on adapte un modèle pré-entraîné, de préférence avec une méthode légère comme LoRA.
- Le budget se joue sur trois postes : l’entraînement, la mémoire, l’inférence.
- Pour des faits qui changent, chercher dans tes documents coûte moins cher que réentraîner.
- Sur un domaine bien délimité, un petit modèle spécialisé peut égaler un géant généraliste.
Avant tout : ton problème a-t-il besoin d’un réseau profond ?
Reprenons nos 263 joueurs. Une régression linéaire (20 paramètres), un lasso qui retient 12 variables et un réseau à une couche cachée de 64 unités (1 345 paramètres) obtiennent des performances de test très proches. Finalement, un modèle linéaire encore plus simple, réajusté sur les quatre variables les plus robustes, l’emporte sur les trois.
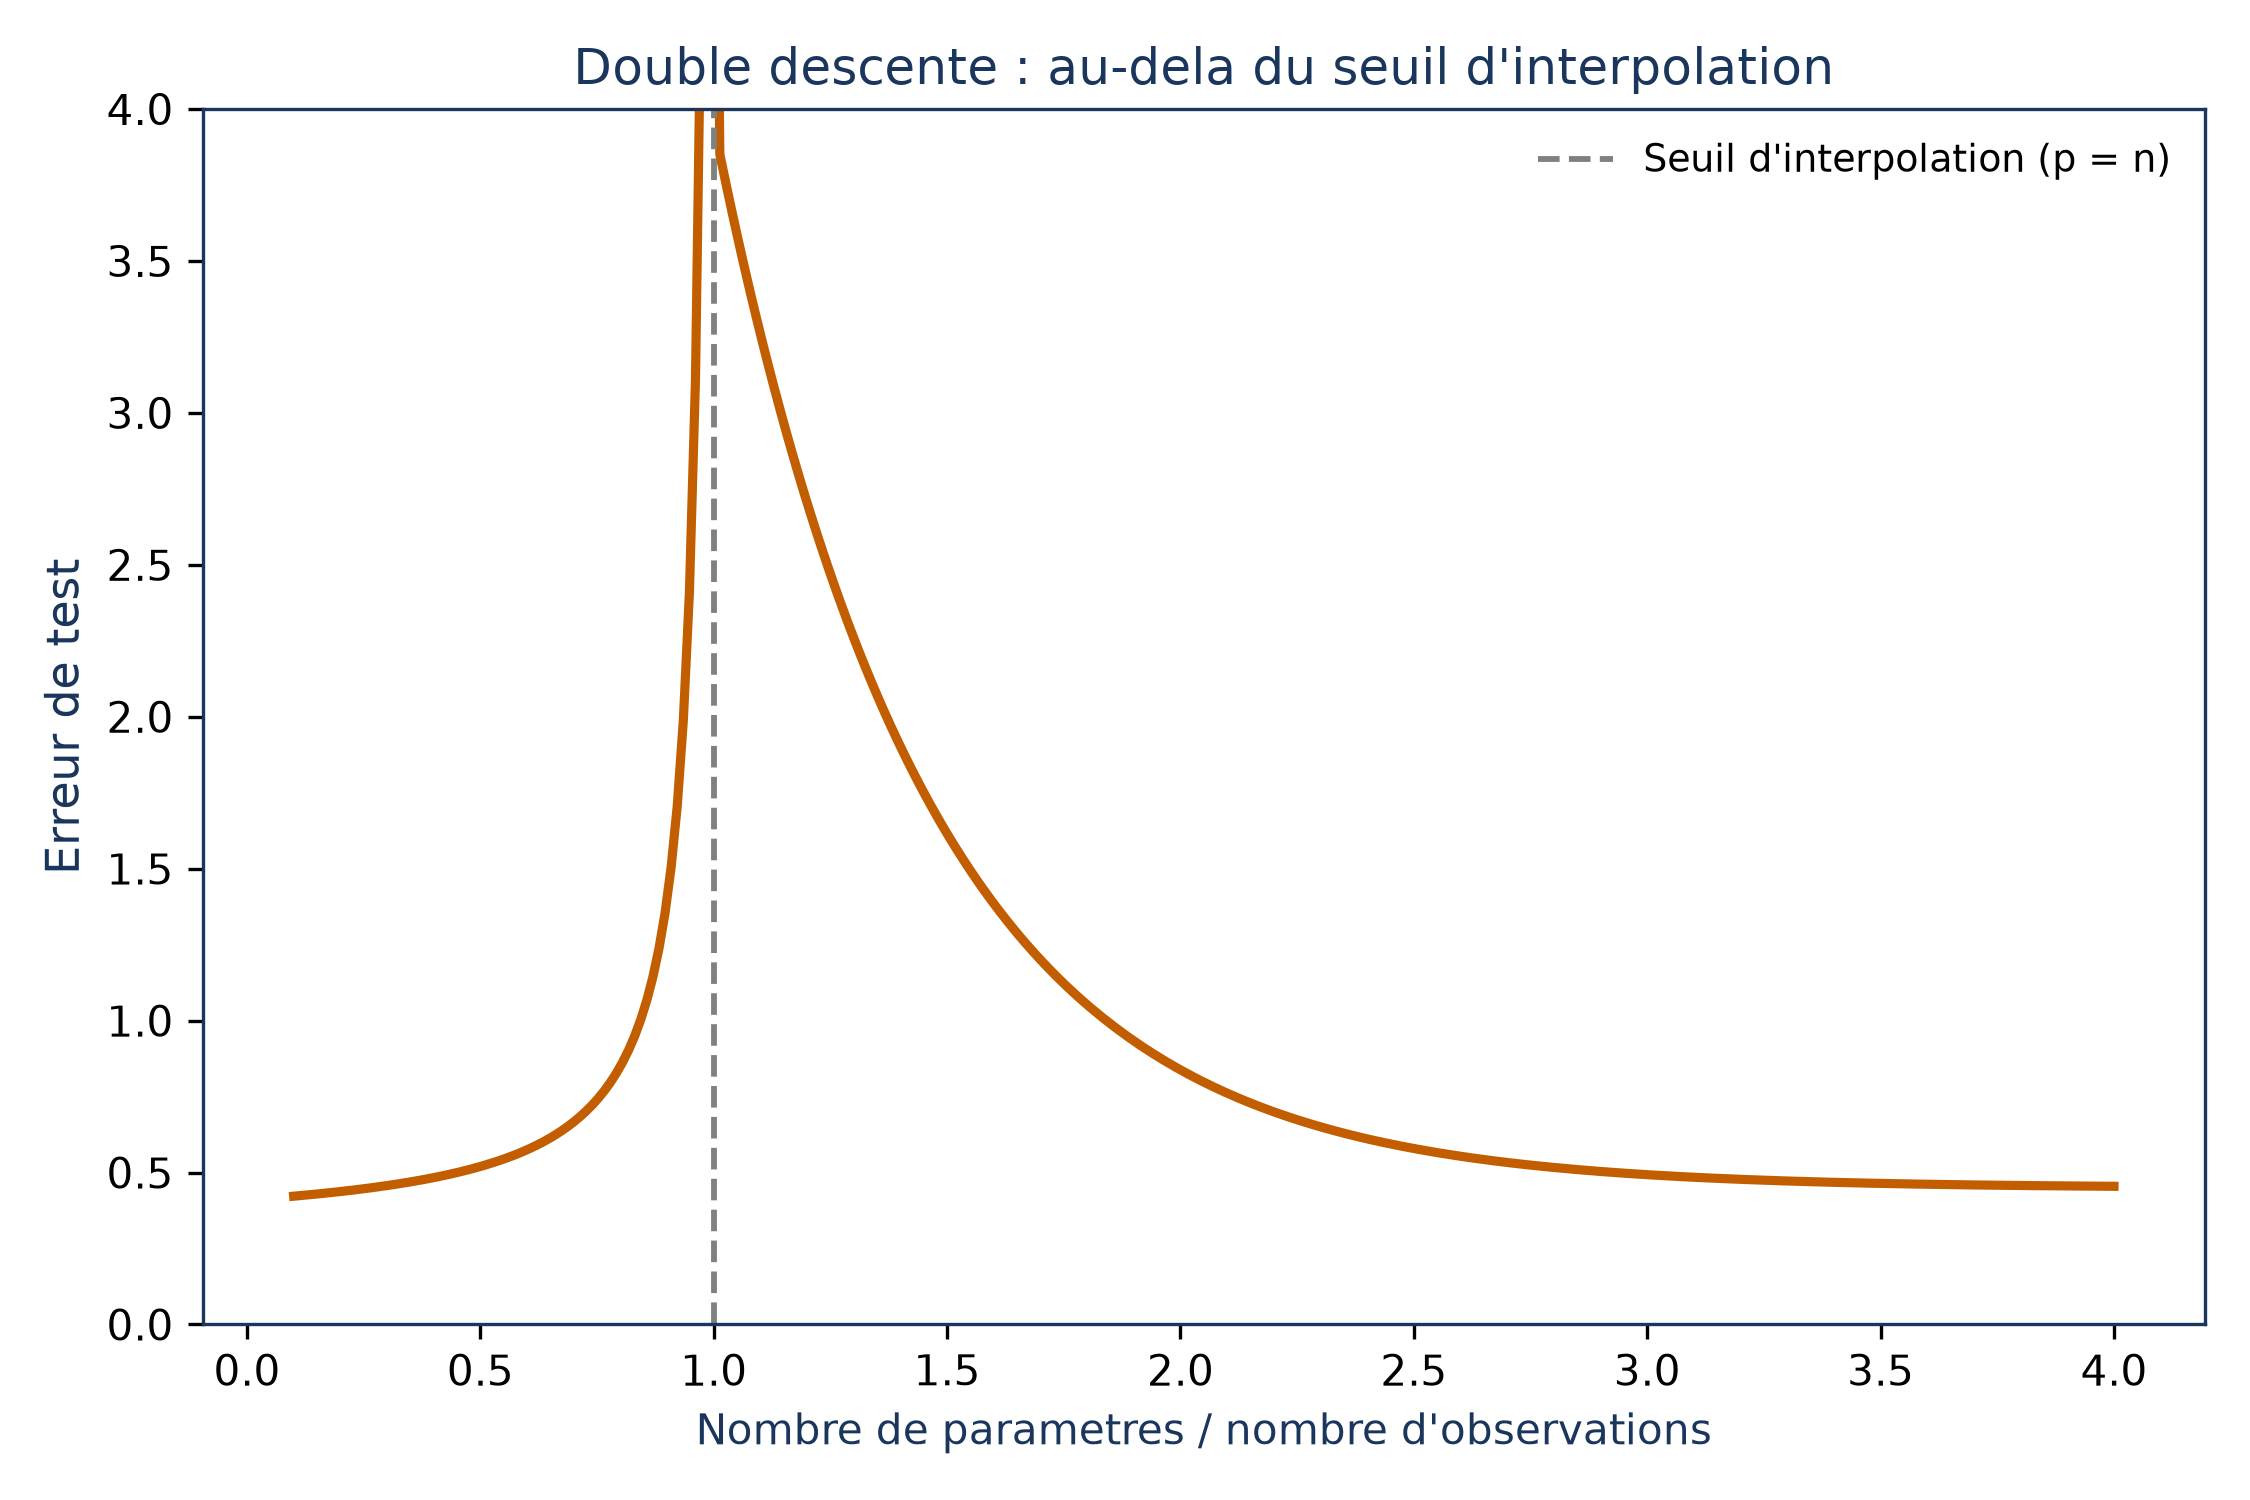
Le réseau compte pourtant bien plus de paramètres que de joueurs. Au-delà de ce seuil, que l’on appelle le seuil d’interpolation (le moment où un modèle peut coller exactement à ses données d’entraînement), l’erreur de test peut se remettre à baisser : c’est ce qui permet à des réseaux surdimensionnés de bien généraliser. Ici, cette liberté supplémentaire n’a rien rapporté.
La règle de départ est donc celle du rasoir d’Occam : quand plusieurs méthodes se valent, on garde la plus simple. Un modèle linéaire se présente, se comprend et se débogue bien plus aisément qu’un réseau, boîte noire par nature.
Le profond ne s’impose que dans des régimes précis :
- l’échantillon d’entraînement est très grand ;
- l’interprétabilité du modèle final n’est pas une priorité ;
- les données ont une structure spatiale ou séquentielle riche (image, texte, son) que les méthodes classiques peinent à exploiter.
📌 À retenir Un Transformer est un réseau profond : il hérite de ces conditions. Si tes données tiennent en quelques centaines de lignes de chiffres, la question de l’architecture ne se pose même pas.
Texte ou son : quelles alternatives plus légères ?
Supposons que ton signal soit bien du texte ou une séquence. Le Transformer n’est alors qu’une option parmi d’autres, et chacune a son profil.
Les GRU, variante des réseaux récurrents munie de portes, ont moins de paramètres et coûtent moins de calcul. Revers de la médaille : ils sont plus enclins au surapprentissage. Ils tiennent de longues séquences sans oublier le passé, et se comportent bien sur de nombreuses tâches textuelles, mais aussi en reconnaissance vocale ou en génération musicale. Pour des dépendances à très long terme, les LSTM, dotés d’une mémoire dédiée, font mieux.
Les convolutions à une dimension font glisser un filtre sur la séquence, ce qui est très rapide. Le filtre couvre de trois à sept mots, voire plus, et le modèle apprend les motifs entre les mots situés dans cette fenêtre. On en empile plusieurs, avec un max pooling pour garder les caractéristiques les plus marquantes.
Pour une image, le réseau convolutif reste l’architecture de référence : un même petit filtre (3 × 3 ou 5 × 5 pixels) est réutilisé partout, ce qui réduit drastiquement le nombre de paramètres.
Pour choisir, pose-toi deux questions. L’information utile tient-elle dans une fenêtre de quelques mots, ou faut-il relier des éléments très éloignés ? Et as-tu assez de données et de calcul pour payer le modèle le plus lourd ? Les sections suivantes chiffrent la seconde.
Entraîner soi-même : ce que ça exige en données et en calcul
Le pré-entraînement d’un grand modèle lit plus de mille milliards de jetons et peut mobiliser des milliers de GPU pendant des mois. C’est l’étape la plus coûteuse de tout le cycle. Pour situer l’ordre de grandeur, GPT-3 a été nourri de Common Crawl (410 milliards de jetons), de deux corpus de textes édités (Books1 et Books2, avec 12 et 55 milliards) et de Wikipédia (3 milliards).
Trois ingrédients gouvernent la performance : le nombre de paramètres  , la taille des données
 et la quantité de calcul
 . OpenAI a relié ces facteurs par une loi d’échelle : quand on fait varier l’un en gardant les deux autres constants, la perte
 vaut
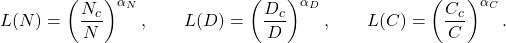
Chaque terme est une loi de puissance décroissante :  ,
 ,
 sont des constantes et
 ,
 ,
 des exposants propres à chaque facteur. Plus tu en investis, plus la perte baisse.
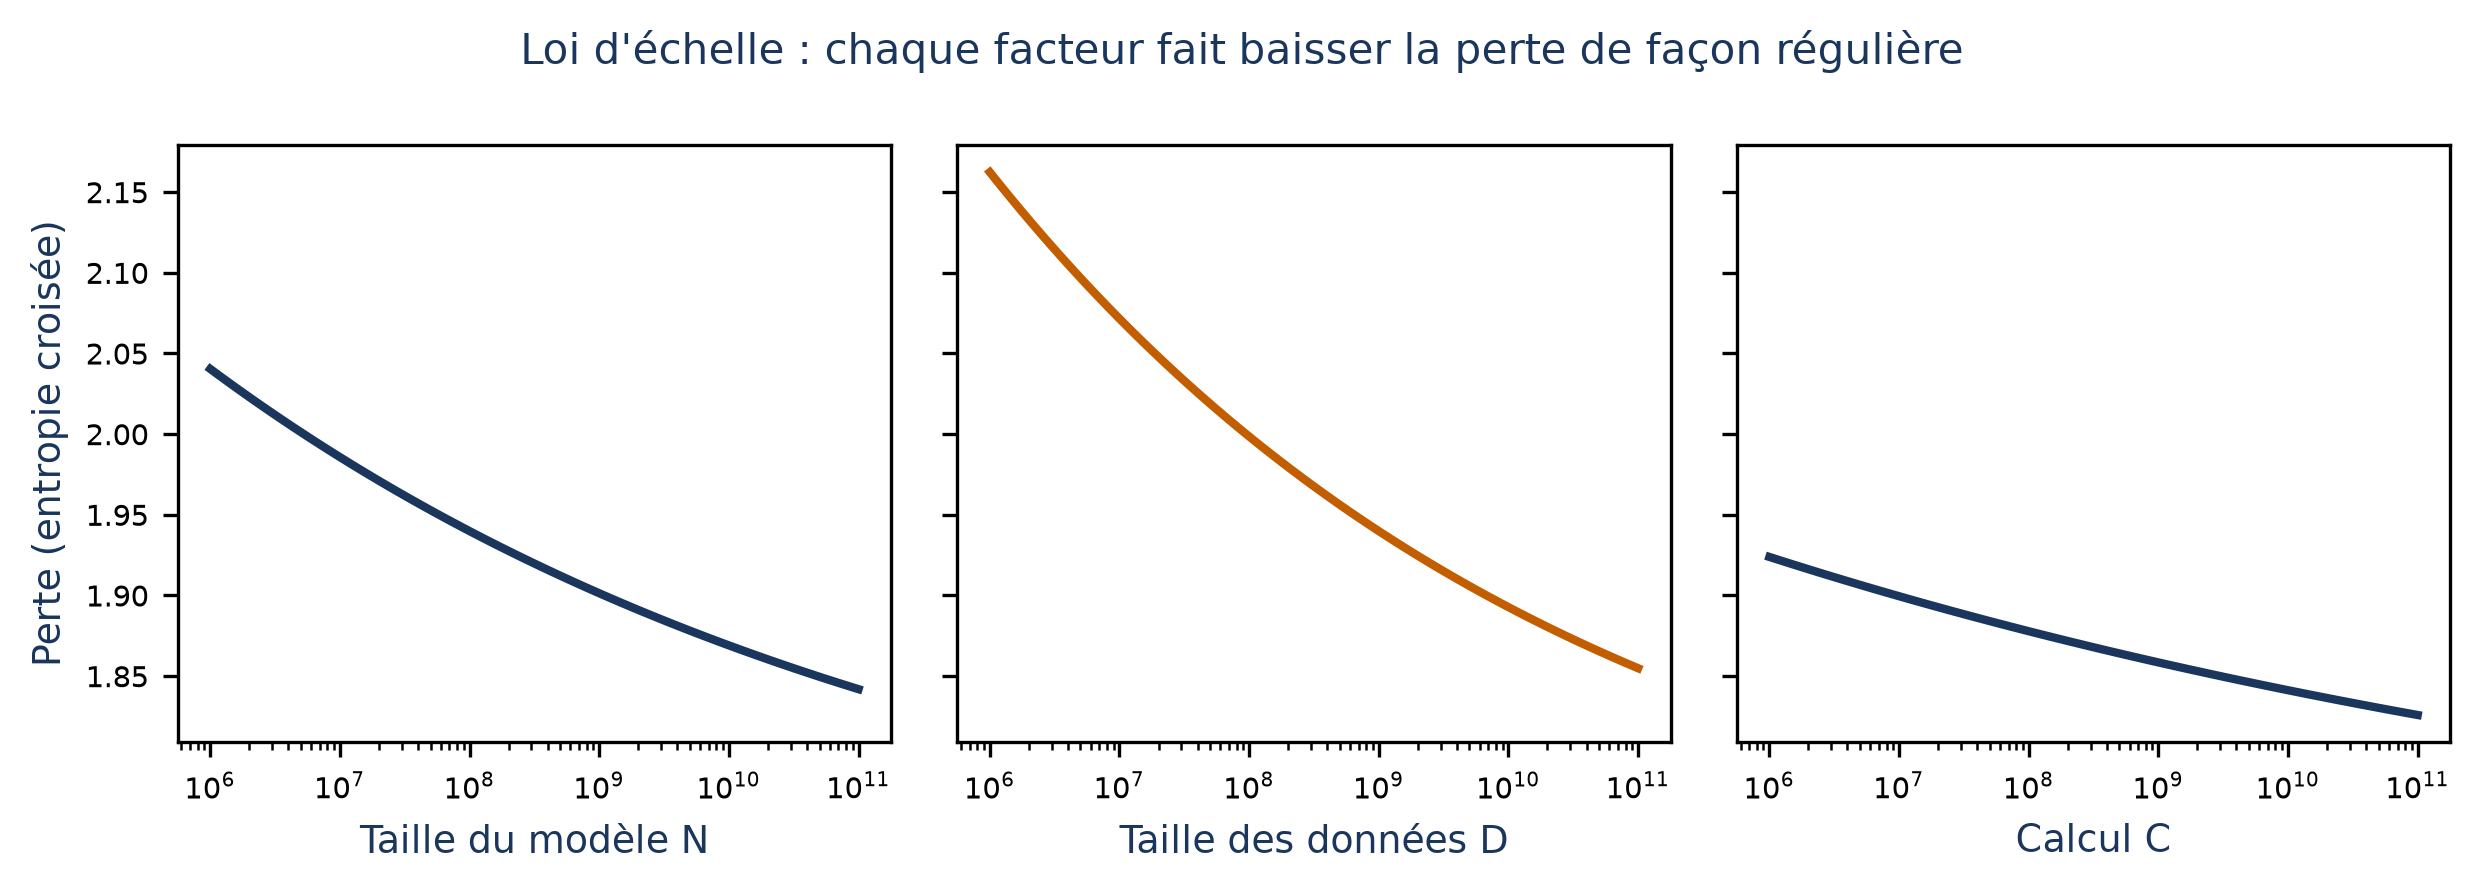
Cette prévisibilité sert directement la décision : elle permet de comparer l’intérêt d’un modèle plus grand et celui de données supplémentaires. Les constantes dépendent toutefois de l’architecture et des choix d’entraînement.
Les travaux ultérieurs nuancent le tableau. Selon Chinchilla (DeepMind), la performance dépend bien plus du nombre de jetons qu’on ne le pensait : beaucoup de grands modèles seraient sous-ajustés. Llama (Meta) ajoute que la qualité compte autant que la quantité, et que des textes écrits par des humains valent mieux que des textes synthétiques. Plusieurs études signalent même un risque d’effondrement du modèle (model collapse) quand on l’entraîne sur des données synthétiques.
💡 Intuition Un modèle de plus de 100 milliards de paramètres coûte cher en architecture, en temps et en argent. La loi d’échelle autorise une parade : expérimenter sur un petit modèle proxy, puis réutiliser ce qu’on y a appris.
La voie ordinaire : adapter un modèle déjà entraîné
Ce seuil franchi par d’autres, tu n’as pas à le franchir toi-même. Entraîner de zéro est très coûteux, et la plupart des entreprises utilisent un modèle pré-entraîné qu’elles ajustent.
Le choix du modèle de départ pèse sur la suite. Il tient compte de la qualité visée, des ressources disponibles et, parfois, d’un modèle moins bon en général mais meilleur sur un aspect précis (pour un assistant de code, mieux vaut un champion des tests de code). La taille agit sur la mémoire, le stockage, le coût et la latence. Enfin, certains modèles accessibles ne sont pas utilisables commercialement : vérifie la licence.
Le réflexe recommandé : partir d’un modèle pré-entraîné avant d’envisager un ajustement. Il généralise mieux sur des sujets variés et se déploie plus vite. Le modèle ajusté, lui, convient mieux à un domaine spécialisé (comptes rendus médicaux, notices techniques), à un format ou un ton à imposer, au prix d’un coût de stockage et de calcul plus élevé.
Quand l’ajustement vaut la peine, les gains peuvent être spectaculaires. Prends la traduction de l’anglais vers SQL : les modèles de code généralistes comptent des centaines de milliards de paramètres, alors qu’un modèle affiné de quelques milliards peut égaler leurs performances sur cette tâche. L’exemple est extrême, mais il montre ce qu’il faut réunir : un domaine étroit, un moyen fiable de mesurer la réussite et des exemples étiquetés en nombre suffisant.
Côté données, compte en milliers d’exemples représentatifs pour affiner un grand modèle sur ton domaine. Pour aligner un modèle sur des préférences humaines, la fourchette est de 10 000 à 100 000 paires rédigées par des annotateurs. Et pour de petits modèles, l’ajustement supervisé peut même tourner sur un simple ordinateur portable.
Reste le coût de l’ajustement lui-même : pour un modèle de plus de 100 milliards de paramètres, même une légère mise à jour exige une infrastructure considérable. D’où l’intérêt de garder les poids gelés. L’idée de LoRA : les poids ajustés s’écrivent
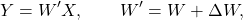
où  désigne les poids d’origine,
 l’entrée,
 la sortie et
 la mise à jour apprise. Selon l’hypothèse du rang intrinsèque, tout n’est pas important : on le représente comme le produit de deux petites matrices, et l’on n’entraîne que celles-ci.
Les adaptateurs suivent un autre chemin : de petites couches ajoutées dans les blocs, qui projettent par exemple de 1 024 vers 24 dimensions puis reviennent à 1 024, soit moins de 50 000 paramètres par adaptateur. À leur première évaluation, ils ont égalé l’ajustement complet de BERT en n’entraînant que 3,6 % de paramètres en plus. LoRA et les adaptateurs restent les techniques les plus utilisées.
Ce que ça coûte une fois en production
Premier poste : le matériel. Pour ajuster un modèle, compte environ une heure sur CPU contre moins de cinq minutes sur GPU.
Deuxième poste : la mémoire. Pour écrire chaque nouveau jeton, il faut le contexte qui précède. Sans précaution, on recalculerait à chaque pas les clés et les valeurs de tous les jetons précédents, ce qui donne un coût quadratique. Le cache KV les garde, et le coût devient proche du linéaire, mais la mémoire devient la contrainte : il faut conserver le cache par jeton, par tête d’attention et par couche, ce qui limite la fenêtre de contexte utilisable.
L’attention reste l’opération la plus coûteuse. On l’optimise par des noyaux comme FlashAttention sans perte de qualité, ou par de nouveaux algorithmes (fenêtre glissante, attention linéaire, Mamba) avec, cette fois, un compromis de qualité.
Troisième poste : l’endroit où tourne le modèle. Sur un téléphone, même haut de gamme, le plafond se situe autour d’un ou deux milliards de paramètres. À l’autre extrémité, un modèle de 67 milliards de paramètres peut réclamer plusieurs cartes graphiques haut de gamme, ce qui pousse la plupart des développeurs vers une API hébergée, sauf à recourir à la quantification.
Reste à comparer API et GPU dédiés. Sur une API, le coût est une fonction linéaire de l’usage : prix au million de jetons multiplié par le nombre de jetons. Sur GPU dédiés, il dépend de la taille de lot, des motifs de trafic et des longueurs de séquence. Plutôt que de deviner un prix au jeton à partir de ta facture de GPU, calcule ce que te coûte l’API au total et mets ce chiffre face au dédié.
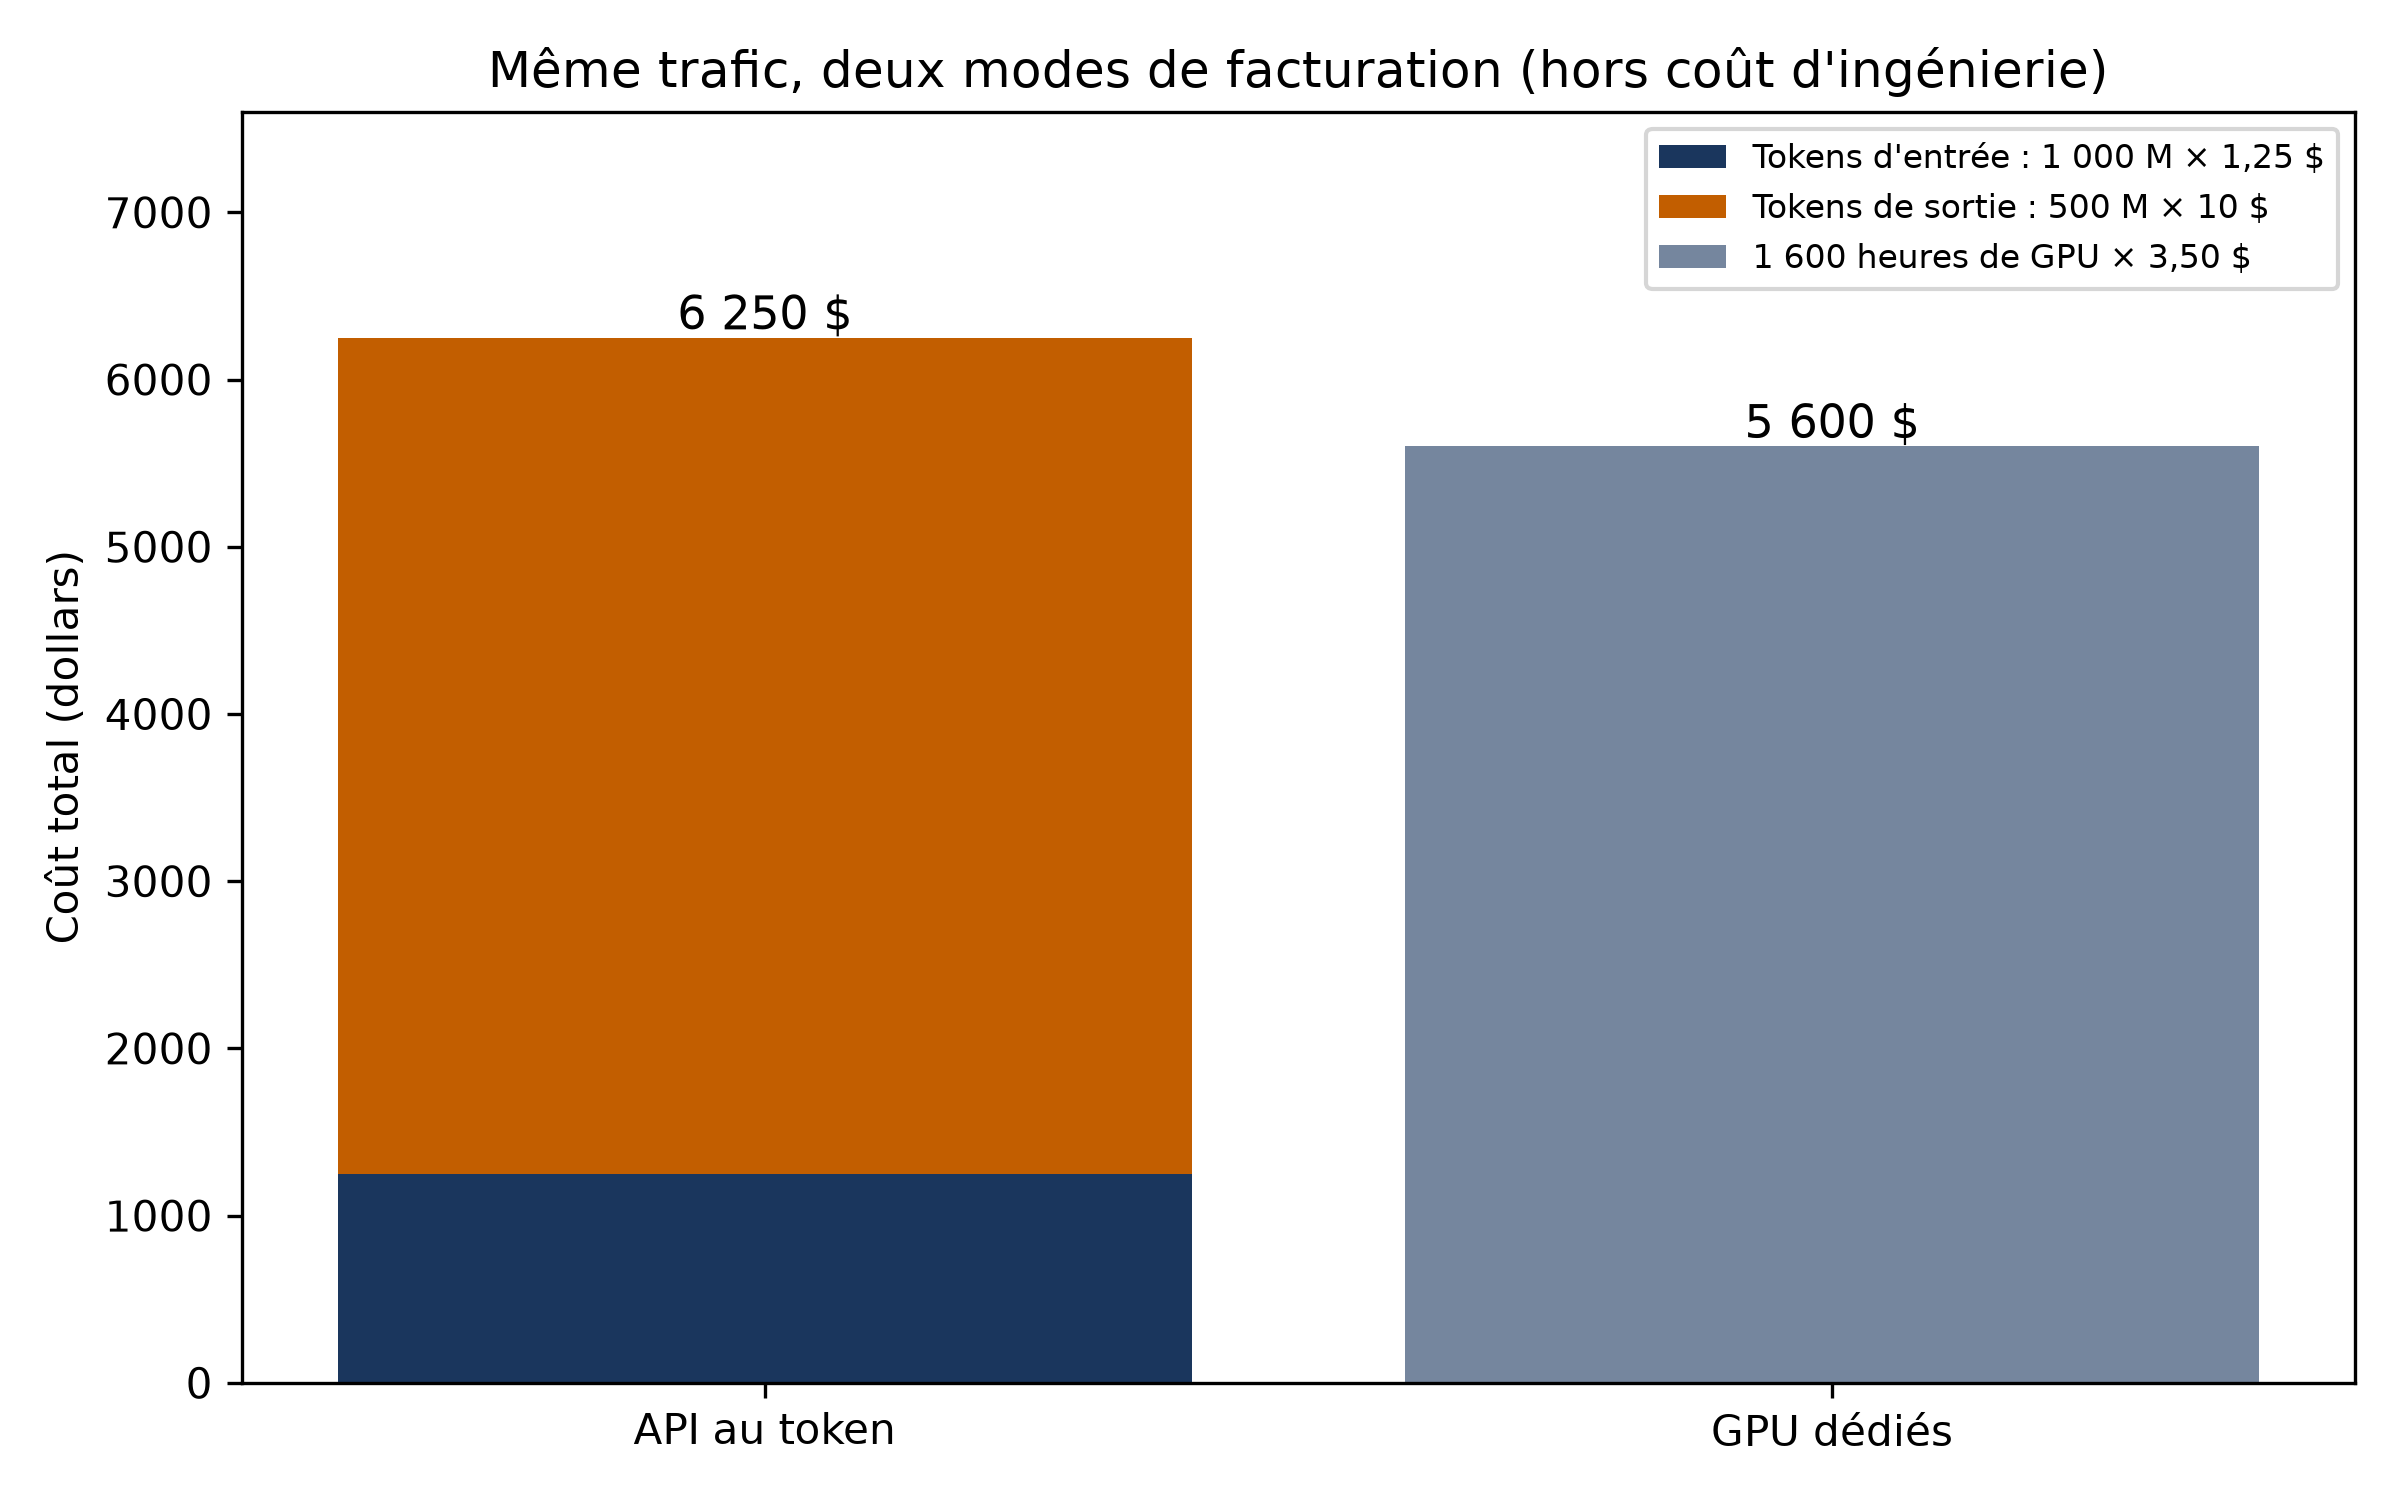
⚠️ Piège Une estimation sur une journée trompe. Mieux vaut mesurer sur sept jours au moins, afin que les pics et les creux d’usage se compensent. Ajoute enfin les heures d’ingénierie nécessaires pour bâtir et entretenir le système : l’ensemble forme le coût total de possession.
Quand il vaut mieux s’en passer
Premier cas : tu as besoin d’explications. Quand l’objectif est de comprendre comment dépend de  , les modèles restrictifs sont nettement plus interprétables. Et même pour la seule prédiction, une méthode très flexible n’est pas toujours la meilleure : le surajustement peut lui valoir de moins bonnes prédictions sur de nouvelles données.
Second cas : tu veux apporter des faits que le modèle ne connaît pas. On a d’abord pensé à l’ajustement supervisé, en lui fournissant des paires question-réponse. Certaines études y voient un gain de fiabilité, d’autres montrent que les modèles peinent à vraiment apprendre de nouveaux faits ainsi.
L’alternative est la génération augmentée par récupération : on injecte dans la question les faits pertinents trouvés dans une base de documents, plutôt que de compter sur la mémoire du modèle. Les deux approches se comparent point par point :
| Critère | Recherche dans tes documents | Ajustement du modèle |
|---|---|---|
| Mise à jour des connaissances | Directe et dynamique : on ajoute ou retire de l’information en temps réel | Réentraînement, donc statique : impraticable si les changements sont fréquents |
| Effet sur le modèle | Apporte de l’information sans changer comportement ni style | Change le comportement, le style, et peut apporter des compétences nouvelles |
| Traçabilité | Permet de suivre les sources d’une réponse | Moins interprétable : difficile de savoir d’où vient un comportement |
| Latence | Le temps de récupération s’ajoute à celui de génération | Latence plus faible |
| Données à préparer | Traitement minimal | Jeux de qualité, coûteux à constituer (trop peu d’exemples n’apportent pas d’amélioration notable) |
Les deux ne s’excluent pas pour autant. Un modèle ajusté peut mieux comprendre et exploiter le contexte récupéré, et il sert aussi quand les données ont un format précis (code, tableaux, XML).
Cas limites : quand le sujet sort du texte
Les architectures voisines du Transformer ne se limitent pas aux LLM. Modèles vision-langage, d’embedding de texte, de reconnaissance vocale ou de synthèse vocale reposent sur des architectures proches, si bien que les mêmes moteurs et techniques s’appliquent. Pour les images et les vidéos, le débruitage itératif domine, même si les transformeurs de diffusion hybrides tiennent de plus en plus le haut du pavé en qualité.
Un point de vigilance pour ce mélange des genres : la diffusion ne produit qu’une taille de sortie fixe, alors qu’un modèle autorégressif génère une sortie de longueur variable. C’est l’un des problèmes que les LLM résolvent dans les pipelines d’images.
Dernier terrain d’essai : la décision séquentielle. On peut traiter l’apprentissage par renforcement comme un problème de modélisation de séquences, ce qui colle à la façon dont ces modèles sont entraînés. Les connaissances préalables réduisent le besoin de collecte de données. En contrepartie, le coût de calcul reste élevé, même en inférence seule et sans ajustement.
Trancher : cinq questions dans l’ordre
Parcours ces questions dans l’ordre : dès qu’une réponse t’oriente vers une option plus simple, tu peux t’arrêter.
| Question | Si oui | Si non |
|---|---|---|
| Ton jeu est-il petit, ou l’explication des résultats compte-t-elle ? | Reste sur un modèle linéaire ou un lasso | Continue |
| Ton signal est-il du texte, du son ou une séquence riche, avec un grand échantillon ? | Un réseau profond se justifie ; compare d’abord GRU et convolutions 1D | Un modèle plus simple suffit |
| Existe-t-il un modèle pré-entraîné de bonne qualité, avec une licence compatible ? | Pars de lui, avec un ajustement léger (LoRA, adaptateurs) | Réévalue le besoin avant d’entraîner de zéro |
| Tes connaissances changent-elles souvent ? | Cherche dans tes documents plutôt que de réentraîner | L’ajustement peut suffire |
| Ton budget de mémoire et d’inférence tient-il sur une semaine d’usage ? | Tu peux lancer | Réduis la taille du modèle, ou passe par une API |
Un Transformer est le bon choix quand tes données, ta tâche et ton budget le justifient tous les trois. Dès que l’un des trois manque, le modèle le plus simple qui fait le travail reste la meilleure réponse.