Un enfant qui apprend à faire du vélo ne reçoit aucun mode d’emploi qui dicte chaque mouvement du guidon. Il pédale, il observe ce qui se passe, il ajuste, et le monde lui répond à chaque essai. Des machines peuvent apprendre de cette façon : c’est ce qu’on appelle l’apprentissage par renforcement. À la fin de cette page, tu sauras nommer ses pièces, suivre la boucle qui les relie et reconnaître un problème qui s’y prête.
Sommaire
- L’essentiel en 30 secondes
- Apprendre sans corrigé : ce qui distingue le renforcement
- Les pièces du puzzle : agent, environnement, état, action
- Un labyrinthe pour tout voir tourner
- Récompense, retour, valeur : viser le long terme
- Explorer ou exploiter : le dilemme du restaurant
- Comment un agent apprend vraiment : du tableau au réseau de neurones
- À quoi ça sert, concrètement
- Ce que le renforcement ne fait pas (encore)
L’essentiel en 30 secondes
- L’apprentissage par renforcement est une branche de l’apprentissage automatique où un système apprend à décider en essayant, sans qu’on lui montre la bonne réponse.
- Tout repose sur une boucle : un agent agit, l’environnement répond par un nouvel état et une récompense, et le cycle recommence.
- Le but n’est pas le gain du moment mais la récompense cumulée sur la durée, ce qui permet de sacrifier un point pour en gagner davantage plus tard.
- L’agent doit sans cesse arbitrer entre explorer l’inconnu et exploiter ce qui marche déjà.
- Cette approche convient aux décisions qui s’enchaînent, avec un retour tardif : jeux, robotique, conduite autonome, alignement des modèles de langage.
Apprendre sans corrigé : ce qui distingue le renforcement
Dans l’apprentissage supervisé, chaque exemple d’entraînement arrive avec sa réponse : on a des valeurs d’entrée et une valeur cible associée, et le modèle en déduit une fonction qui relie les deux.
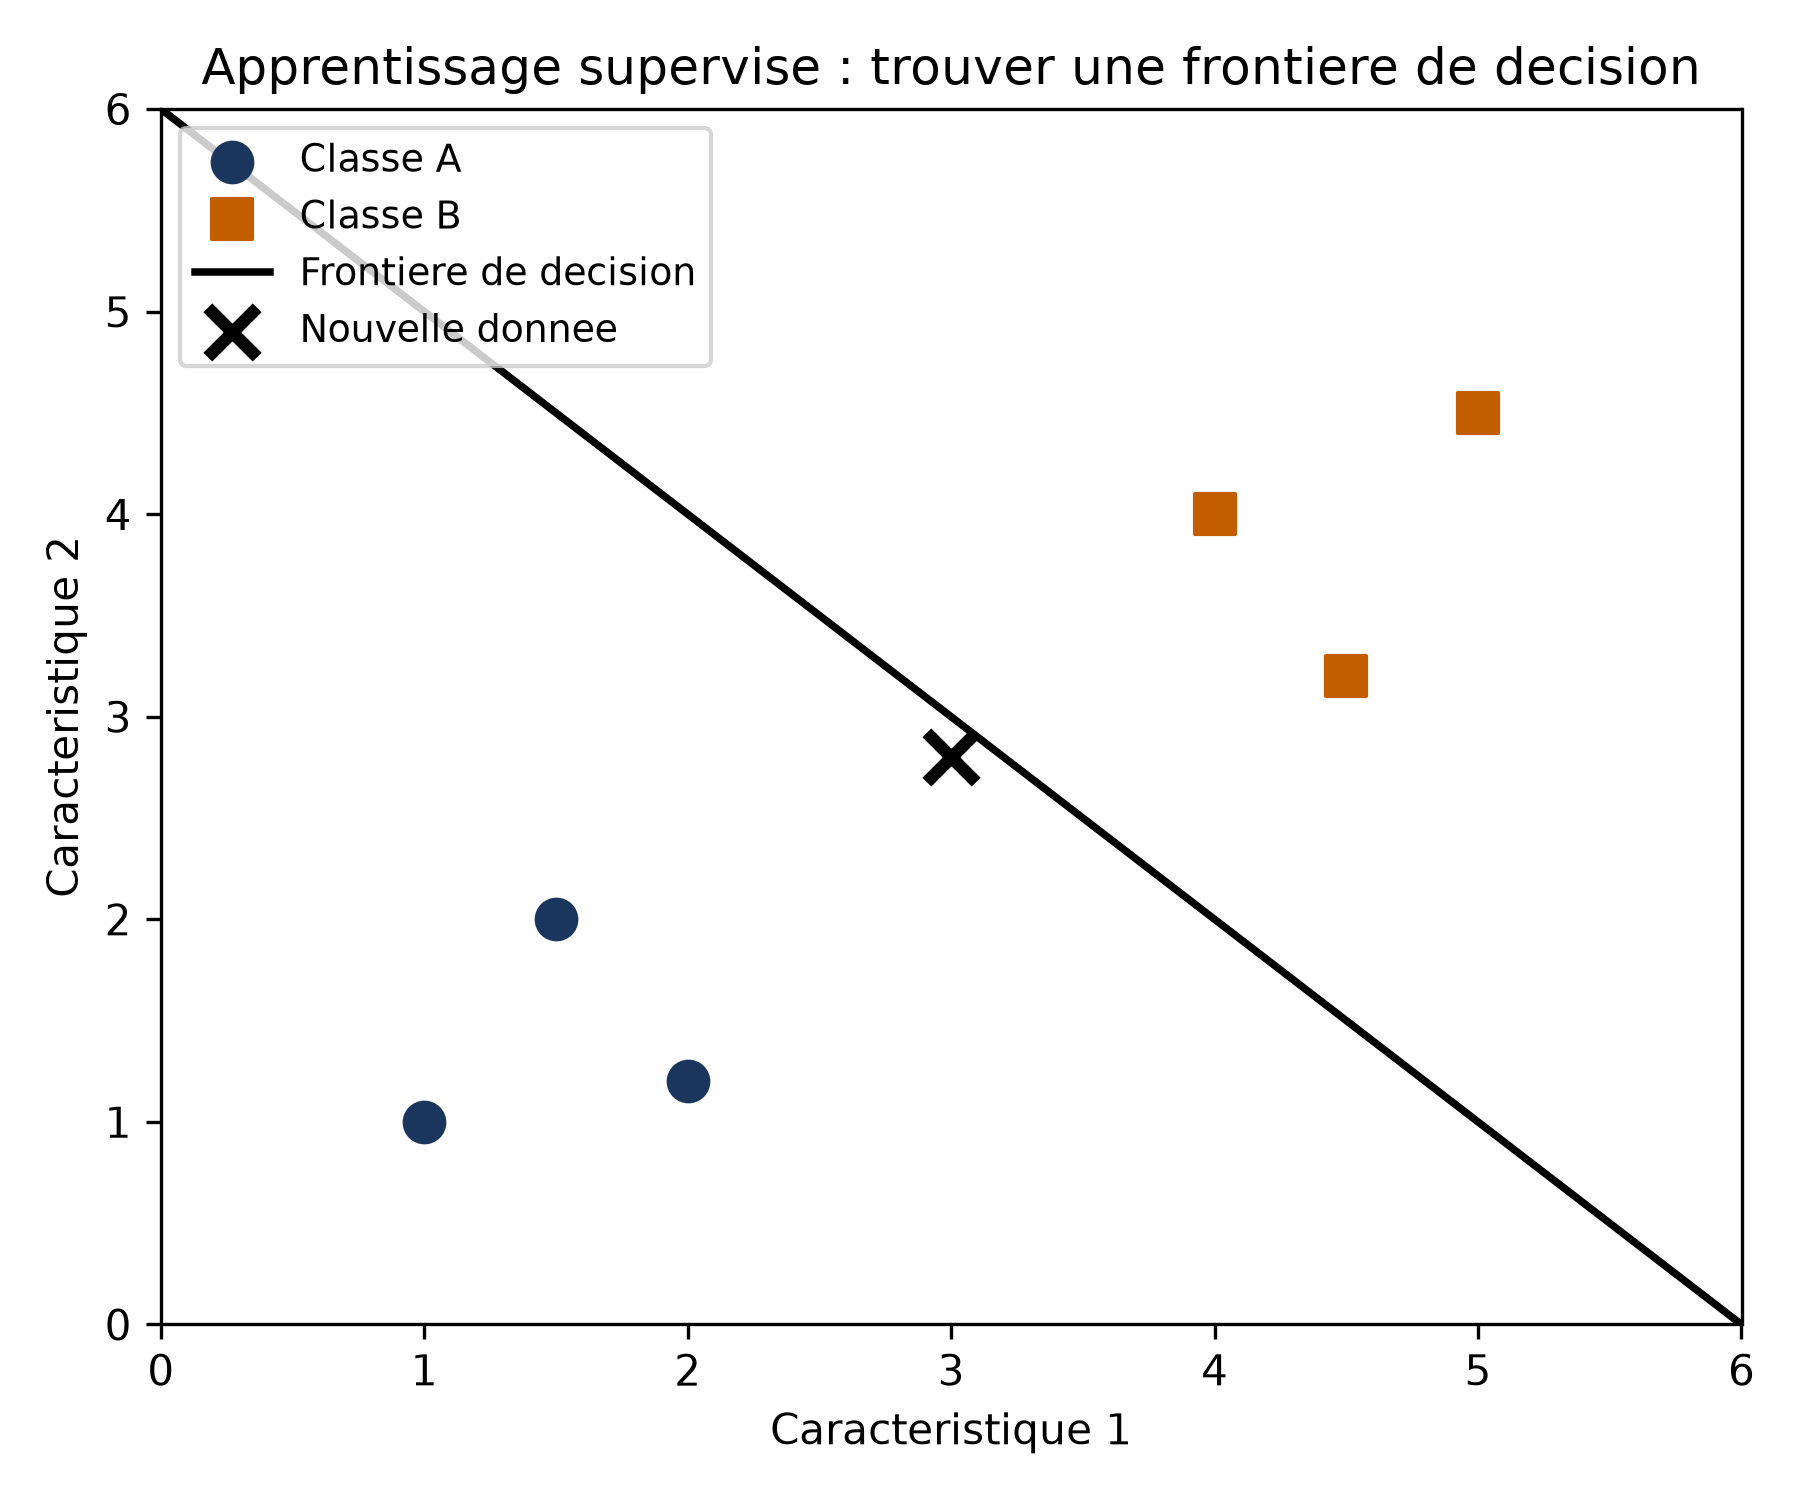
L’apprentissage non supervisé retire aussi la cible, mais pour un autre but : révéler une structure déjà présente dans les données, comme des regroupements ou des valeurs atypiques.
L’apprentissage par renforcement part d’un troisième principe. Un système y prend des décisions pour maximiser une récompense cumulée : personne ne lui dit quelles actions mener, il explore l’environnement et découvre lesquelles paient.
Deux idées en découlent. D’abord l’essai-erreur : l’agent n’a que l’expérience pour progresser. Ensuite la récompense différée : au jeu d’échecs, sacrifier une pièce peut ne rapporter que plus tard, quand la partie est gagnée.
💡 Intuition Un étiqueteur te dit « voici la bonne réponse ». Un environnement, lui, se contente de te dire « ça a marché » ou « ça a mal tourné », parfois bien après ton geste.
Les pièces du puzzle : agent, environnement, état, action
Un système de renforcement se décrit avec six éléments : un agent, un environnement, un état, une politique, un signal de récompense et une fonction de valeur.
L’agent est l’apprenant, celui qui prend les décisions. L’environnement est tout ce avec quoi il interagit. Un état décrit la configuration de cet environnement à un instant donné, par exemple la position des pièces sur un échiquier avant un coup.
Face à un état, l’agent choisit une action parmi celles qui lui sont permises. L’ensemble de ces actions peut être discret (les déplacements dans un labyrinthe) ou continu (des vecteurs de valeurs réelles). Dès que l’agent agit, l’environnement change, donc l’état aussi.
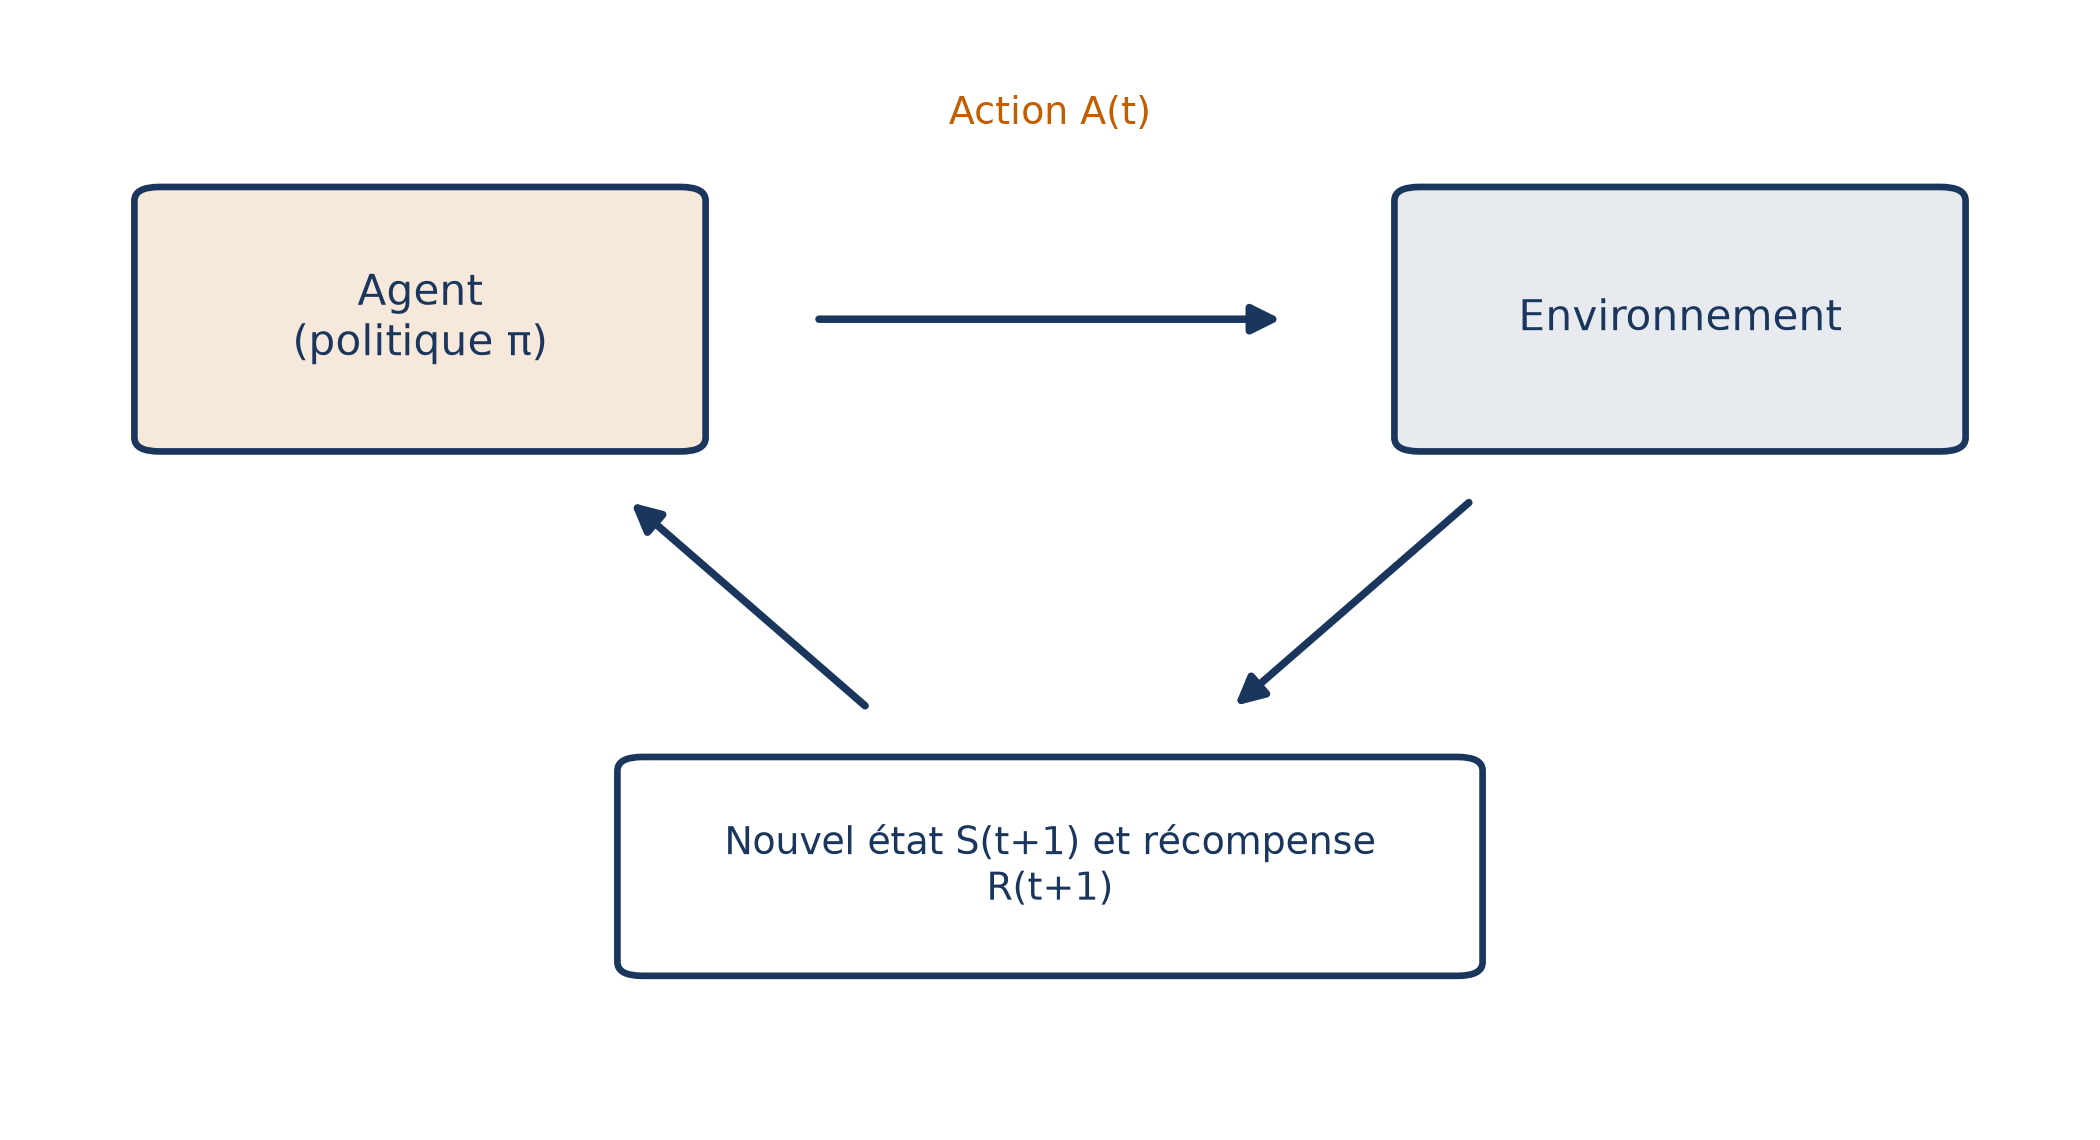
La politique est le comportement de l’agent : elle associe une action à chaque état. Ce peut être une liste de règles, une table de correspondance ou une fonction, déterministe ou stochastique (une probabilité par action). Le plus souvent, elle est paramétrée, et c’est un réseau de neurones dont un algorithme d’optimisation règle les paramètres.
Il arrive que l’agent ne voie qu’une partie de l’état. Un robot qui explore un labyrinthe n’a que sa caméra : ce qu’elle lui renvoie est une observation, un sous-ensemble de l’état réel.
Un labyrinthe pour tout voir tourner
Prends un agent qui doit sortir d’un labyrinthe. L’état, c’est sa position. Ses actions : aller à l’est, à l’ouest, au nord ou au sud. La politique dit quelle direction prendre dans chaque case. La récompense peut être une pénalité quand il choisit une action interdite, comme foncer dans un mur, et le but est de trouver la sortie.
À chaque pas de temps, l’agent observe l’état, choisit une action selon sa politique et reçoit une récompense. Il se retrouve alors dans un nouvel état, et le cycle repart.
Au début, aucune carte, aucune consigne : seulement des essais. Et la politique n’est pas forcément figée, puisqu’elle peut être mise à jour à la fin de chaque cycle. C’est cette révision, essai après essai, qui constitue l’apprentissage proprement dit.
Récompense, retour, valeur : viser le long terme
La récompense est un signal, positif ou négatif, en général un nombre unique, que l’agent reçoit à chaque pas. Elle lui donne un but, local comme global : perdre une pièce est une récompense négative locale, gagner la partie une récompense globale.
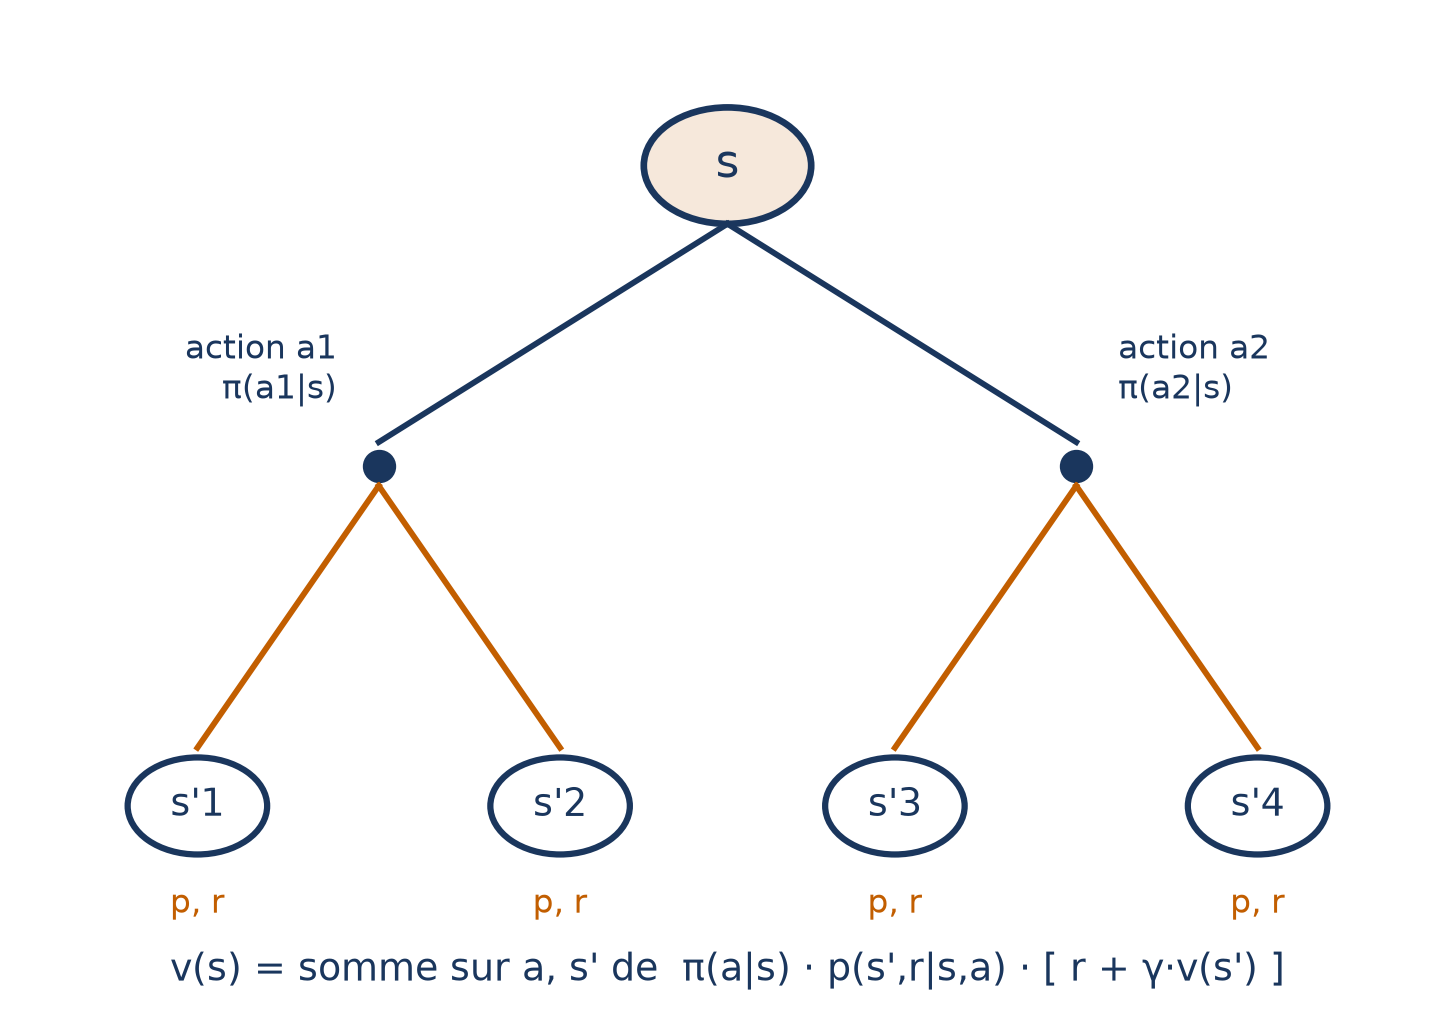
Mais la récompense ne dit que ce qui est bon tout de suite. La fonction de valeur décrit ce qui l’est à long terme : la valeur d’un état est la quantité totale de récompense que l’agent peut espérer obtenir à l’avenir en partant de cet état. Sacrifier une pièce rapporte peu sur le moment, mais peut valoir la victoire.
Pour que l’agent vise cette valeur, on lui fait maximiser une somme, le retour  :
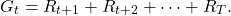
Dans cette tâche à épisodes (une partie, une sortie de labyrinthe), additionne toutes les récompenses reçues entre l’instant  et la fin de l’épisode à l’instant
 . Rien d’immédiat n’est privilégié : un petit gain sacrifié peut être compensé par un gros plus loin. En pratique, on pondère souvent les récompenses futures par un facteur d’actualisation
 , qui règle leur poids face aux récompenses immédiates.
⚠️ Piège Un agent maximise la récompense par tous les moyens possibles. Si on récompense chaque pièce mangée plutôt que la victoire, il collectionnera les pièces, quitte à perdre la partie.
Ce cadre s’appelle un processus de décision markovien. Il réduit tout problème à trois signaux, les actions, les états et les récompenses, et la dynamique de l’environnement s’écrit avec une probabilité de transition :
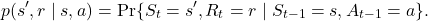
Lis-la ainsi : sachant que l’agent était dans l’état  et a fait l’action
 ,
 donne la probabilité d’arriver dans l’état
 en touchant la récompense
 .
Explorer ou exploiter : le dilemme du restaurant
Dans une ville nouvelle, tu essaies d’abord plusieurs restaurants. Tu découvres des favoris et tu y retournes plus souvent : tu exploites ce que tu sais. Mais si tu ne bouges plus de tes habitudes, tu risques de manquer un meilleur endroit. Savoir quand essayer du neuf et quand s’en tenir à ce qui marche reste une question ouverte de la théorie.
L’agent vit le même dilemme : il doit exploiter ses connaissances pour atteindre son but, mais aussi explorer pour mieux choisir plus tard, car le chemin le plus évident n’est pas forcément le meilleur.
Pour estimer la valeur d’une action, on n’a pas besoin de recalculer toute la moyenne à chaque fois. On corrige l’ancienne estimation  de la valeur de l’action d’une fraction de l’erreur entre la récompense observée
 et cette estimation :
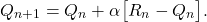
Ici  est un pas d’apprentissage fixe. Il simplifie le calcul, et surtout il donne plus de poids aux récompenses récentes, ce qui aide quand les probabilités de gain changent avec le temps. Partir d’estimations initiales optimistes pousse même l’agent à explorer davantage, sans autre mécanisme.
📌 À retenir Apprendre, c’est corriger une estimation par l’écart entre ce qu’on attendait et ce qu’on a reçu. Presque tout l’apprentissage par renforcement est une variation sur cette phrase.
Comment un agent apprend vraiment : du tableau au réseau de neurones
Quand l’environnement est petit, politiques et valeurs tiennent dans de simples fonctions. Quand il devient grand (images, vidéos, actions continues), elles ne généralisent plus. Le renforcement profond les représente alors par des réseaux de neurones, capables en théorie d’approcher n’importe quelle fonction complexe.
Le principe est simple. On initialise un réseau de paramètres  , dont les poids aléatoires produisent d’abord des actions aléatoires. On laisse l’agent jouer jusqu’à la fin de la partie, ce qui génère une trajectoire d’états et d’actions, on collecte les récompenses, puis on fait une montée de gradient pour augmenter le retour espéré.
Une variante répandue sépare deux rôles. L’acteur est le décideur, qui apprend à améliorer ses décisions. Le critique est un conseiller qui estime la valeur de ses actions et lui donne un retour : il calcule une erreur de différence temporelle, l’écart entre sa prévision et ce que l’agent vient d’observer.
Les méthodes se rangent aussi selon un autre axe. Les méthodes sans modèle apprennent directement des séquences état-action-récompense et sont plus simples à implémenter. Celles avec modèle se construisent un modèle interne de l’environnement pour simuler et planifier : elles économisent des interactions réelles, au prix d’une complexité et d’un coût de calcul supérieurs.
À quoi ça sert, concrètement
Le terrain d’entraînement historique, ce sont les jeux : AlphaZero, DQN sur le go, les échecs ou les jeux Atari. Un jeu offre un environnement complexe, des récompenses claires, immédiates comme différées, et des benchmarks qui permettent de comparer vite deux algorithmes.
AlphaZero a marqué les esprits : le même algorithme sert pour les échecs, le shogi et le go, sans connaissance humaine, en jouant des millions de parties contre lui-même.
Au-delà du jeu, on retrouve le renforcement en robotique, en conduite autonome, en optimisation et contrôle (finance, santé, logistique, automatisation industrielle) et dans la gestion de l’énergie.
Il croise aussi les modèles de langage. Des algorithmes de renforcement servent à aligner un modèle sur les préférences humaines, pour limiter les contenus biaisés ou toxiques.
Quand on sait écrire un évaluateur mesurable (une métrique, un validateur à règles, un modèle de notation), on peut même optimiser un modèle directement vers ce signal : c’est le principe du renforcement à récompenses vérifiables.
Ce que le renforcement ne fait pas (encore)
Il ne remplace pas la récompense bien posée : concevoir la récompense reste difficile, surtout quand elle est éparse, avec un retour limité et tardif. Elle contrôle tout le comportement, et un biais peut conduire à des comportements inattendus.
Il ne généralise pas facilement : entraînés dans un environnement simulé précis, les agents y excellent, mais transférer ce savoir à des environnements changeants est difficile, ce qui limite l’usage dans le monde réel.
Il n’est pas économe. L’ensemble reste gourmand en ressources, et une méthode comme A3C peut donner des résultats variables d’un lancement à l’autre. Même AlphaZero a un coût de calcul énorme, et il marche surtout pour les cadres à information parfaite.
Enfin, les méthodes avec modèle accumulent des erreurs : plus l’horizon de prédiction s’allonge, plus l’écart avec la trajectoire optimale grandit. Et si l’agent doit apprendre son propre modèle de l’environnement, il peut s’y comporter de façon optimale tout en étant mauvais dans la réalité.