Pour apprendre à écrire des articles scientifiques, tu n’as pas besoin de réapprendre l’anglais : tu pars de ce que tu sais déjà et tu l’adaptes à ce genre précis. Un modèle d’intelligence artificielle peut suivre le même chemin, et ce chemin s’appelle le finetuning. Voici de quoi comprendre ce que le finetuning change dans un modèle, comment il se déroule et où il s’arrête.
Sommaire
- L’essentiel en 30 secondes
- Réapprendre l’anglais ? Non, on adapte
- Pourquoi ajuster au lieu de partir de zéro
- Ce qui bouge dans le modèle : ses poids
- Un exemple : apprendre à traduire à un modèle qui prédit le mot suivant
- Dans le code : la boucle d’entraînement
- Ajuster sans tout toucher : l’idée de LoRA
- Quatre leviers, quatre apprentissages
- Prompt, génération augmentée, distillation : où il se place
- Idées reçues et limites
L’essentiel en 30 secondes
- Finetuner, c’est poursuivre l’entraînement d’un modèle déjà préentraîné sur de nouvelles données, pour l’adapter à un usage précis.
- L’opération change les poids, jamais l’architecture : le modèle garde sa forme, ses valeurs bougent.
- Là où BERT a mobilisé 64 TPU pendant quatre jours, le finetuning tient sur un seul GPU, voire un CPU.
- Avec LoRA, on n’entraîne que 17,5 millions de paramètres sur les 175 milliards de GPT-3.
- Le finetuning vise surtout le style, le ton et le vocabulaire, et il ne se décrète pas : dans le doute, on essaie d’abord plus léger.
Réapprendre l’anglais ? Non, on adapte
Pendant le préentraînement, un Transformer lit d’énormes quantités de texte et en tire des règles générales sur la structure d’une langue. On exploite ensuite ces règles pour une myriade d’applications. C’est ce qu’on appelle l’apprentissage par transfert : réutiliser un modèle entraîné sur beaucoup de données pour une tâche différente de celle d’origine.
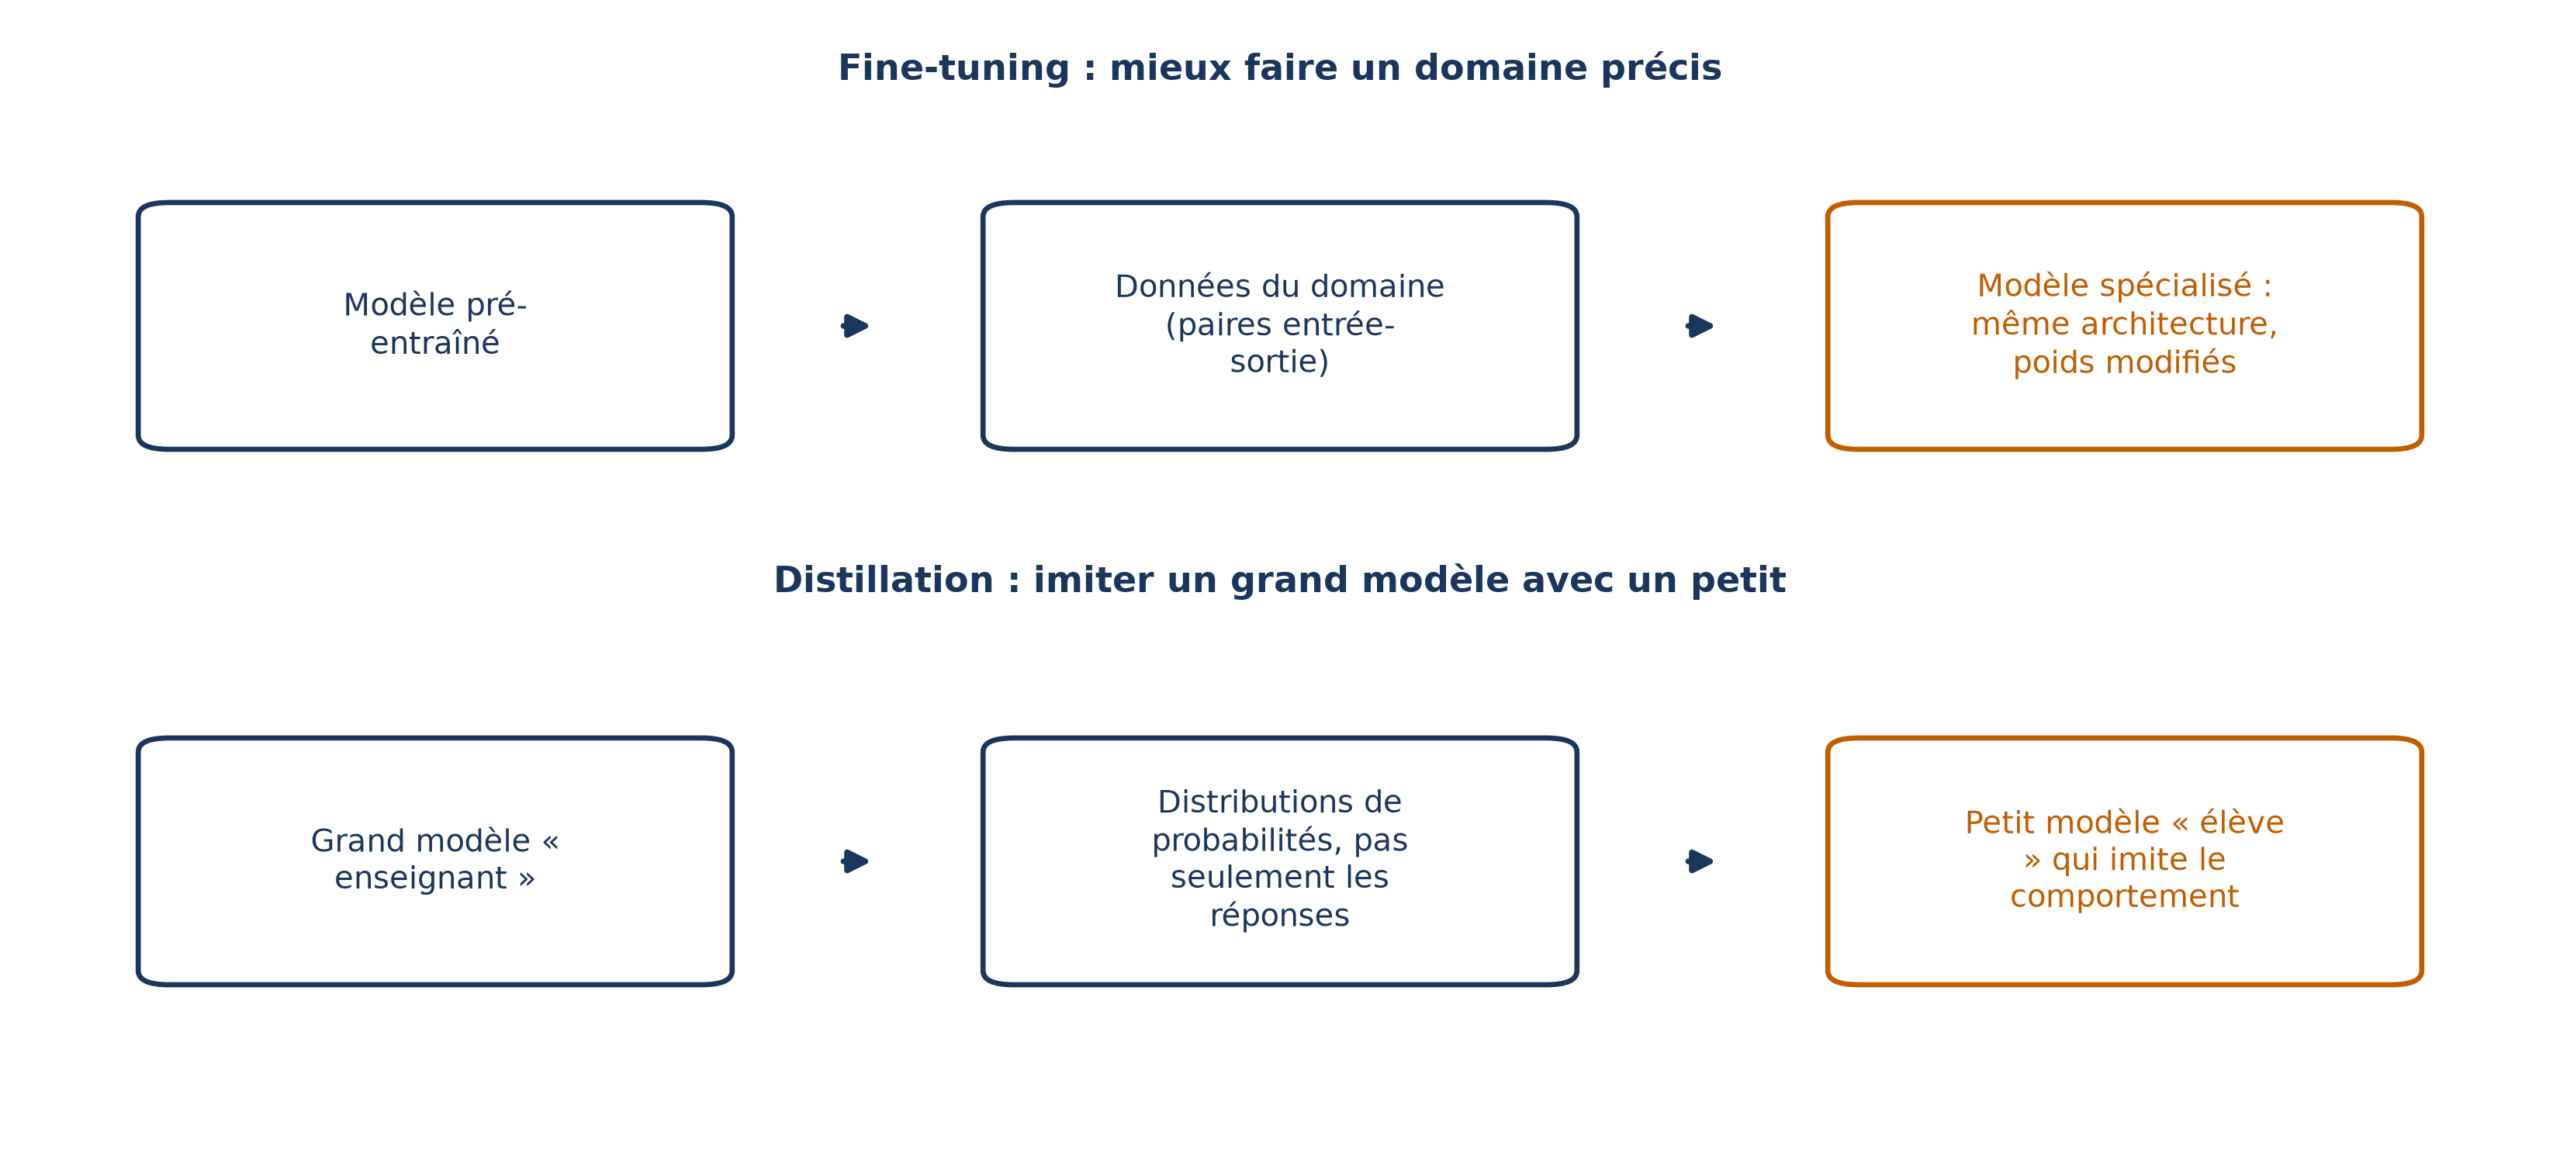
Le finetuning (on dit aussi ajustement fin ou affinage) en est un cas particulier : on prend un modèle de fondation préentraîné et on l’adapte à un usage précis en lui présentant de nouvelles données. Ce modèle de départ a été nourri de jeux de données généralistes immenses : il en retire une base solide de langue et de concepts. L’ajustement cible ses paramètres sur une tâche ou un domaine, en gardant ses capacités générales.
💡 Intuition Tu ne fabriques pas un nouveau modèle : tu reprends un modèle qui sait déjà lire et tu le spécialises, comme on affûte un outil qui existe déjà.
Pourquoi ajuster au lieu de partir de zéro
Entraîner un modèle depuis zéro sur des trillions de jetons est réservé aux grands laboratoires, ceux qui disposent de vastes ressources de calcul et de données propriétaires. Pour presque toutes les équipes, la meilleure approche consiste à partir de modèles libres de haute qualité, aux licences adaptées.
L’écart de coût se chiffre. L’entraînement de BERT a mobilisé 64 TPU (un matériel spécialisé pour les opérations sur tenseurs) pendant quatre jours, ce qui dépasse les moyens de la plupart des utilisateurs. Son finetuning, lui, se fait sur un seul GPU, voire sur un CPU. Il suffit même de quelques exemples pour atteindre des performances similaires, voire meilleures, qu’un modèle entraîné de zéro.
Reste à savoir quand l’ajustement paie. Trois situations reviennent : un domaine de spécialité où le jargon et un guide de style strict comptent, un ton et un format qui doivent rester constants (communications financières, mentions légales), et des appels d’outils ou d’API qui doivent être précis, comme les dosages médicaux.
Ce dernier cas se voit bien avec un agent. Un modèle ajusté commet moins d’erreurs sur les appels d’outils, il apprend à juger quand ne pas appeler un outil, et il réduit le coût en jetons en évitant les essais répétés et les appels malformés. Face à la phrase « s’il pleut demain, je resterai chez moi », il peut estimer qu’aucune requête n’est utile et simplement répondre.
Ce qui bouge dans le modèle : ses poids
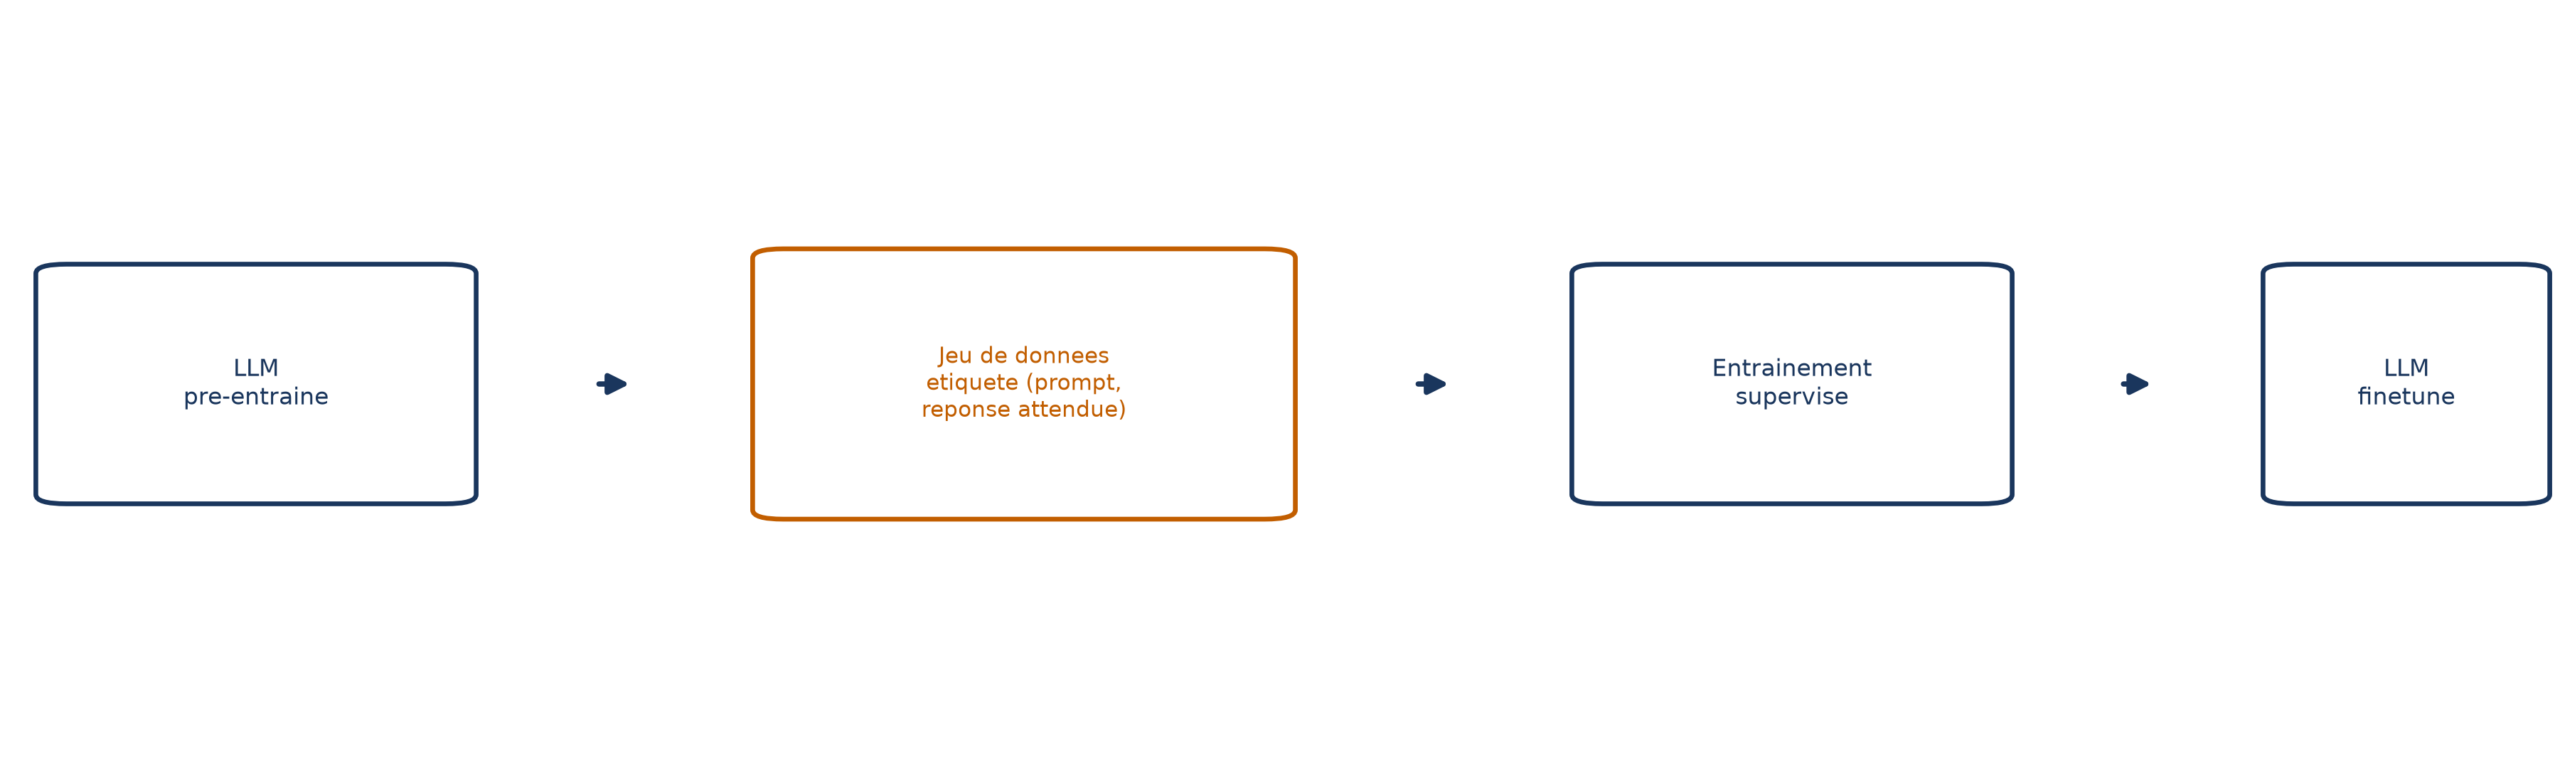
Un modèle, c’est une architecture et des valeurs de poids. Le finetuning modifie les valeurs et garde l’architecture. Concrètement, on poursuit l’entraînement sur un jeu de données étiqueté, qui associe des invites à des réponses attendues : c’est le finetuning supervisé, noté SFT.
La mécanique ressemble beaucoup à celle de n’importe quel réseau de neurones : un Transformer est un modèle d’apprentissage profond, et l’on y retrouve des hyperparamètres semblables. La différence tient à ce qu’on ne veut pas détruire ce que le modèle a appris.
D’où une première variante, qui préserve sa représentation interne. La plupart des couches sont gelées, c’est-à-dire que leurs poids ne changent pas, et l’on entraîne seulement une ou deux couches ajoutées au sommet. Elles apprennent à exploiter la représentation du modèle pour la tâche visée.
Côté données, la quantité dépend de la taille du modèle. Les grands se contentent d’environ 1 000 exemples de qualité, les petits en demandent beaucoup plus, jusqu’à un million d’exemples pour un modèle de 7 milliards de paramètres. Bâtir ces milliers d’exemples coûte cher : une petite part seulement est écrite par des humains, le reste vient d’un modèle générateur ou de jeux publics déjà existants.
Le jeu passe ensuite par un prétraitement. On écarte les exemples de mauvaise qualité, on filtre selon la longueur et le format, et l’on déduplique. Une étape de décontamination vérifie qu’aucun exemple du jeu de test ne se glisse dans l’entraînement : sans elle, tu ne pourrais plus détecter le surapprentissage ni la mémorisation.
Un exemple : apprendre à traduire à un modèle qui prédit le mot suivant
Prends un modèle comme GPT-2, qui n’a qu’un décodeur et ne sait que prolonger un texte. Le Transformer d’origine comptait un encodeur et un décodeur pour traduire. Comment amener ce modèle à traduire quand même ?
On construit le jeu d’exemples avec une astuce : chaque exemple s’écrit <phrase en anglais>, puis un jeton spécial <to-fr>, puis <phrase en français>. Le modèle est ajusté de la façon habituelle, en prédisant le jeton suivant. Le jeton spécial joue le rôle d’un signal : après lui, c’est la traduction qui vient.
La même recette apprend le résumé : on insère à la place un jeton qui signifie « résumé ». Une fois l’ajustement fait, le modèle n’a rien d’autre à faire que ce qu’il sait déjà, prolonger un texte. On lui a juste montré quelle suite correspond à quelle tâche.
Ce choix d’un décodeur n’a rien d’anodin. Les encodeurs comme BERT ne sont pas optimaux pour les tâches génératives, à cause de leur entraînement par masquage, alors que les décodeurs le sont. En revanche, BERT a battu l’état de l’art à sa sortie sur plusieurs tâches de compréhension (paraphrases, questions-réponses, sentiments) et a donné naissance à des variantes de domaine comme SciBERT.
Dans le code : la boucle d’entraînement
Tu as un modèle de départ et des paires (invite, réponse) rangées en un jeu d’entraînement et un jeu de test. Reste à lancer l’entraînement. Cette fonction, écrite avec la bibliothèque TRL de Hugging Face, configure et exécute un finetuning supervisé :
def train(
    model,
    tokenizer,
    dataset: DatasetDict,
    peft_cfg: LoraConfig,
    output_dir: str,
    epochs: int = 1,
    lr: float = 1e-4,
    batch_size: int = 1,
    grad_accum: int = 4,
    max_seq_len: int = 1500,
):
    train_args = SFTConfig(
        output_dir=output_dir,
        per_device_train_batch_size=batch_size,
        per_device_eval_batch_size=batch_size,
        gradient_accumulation_steps=grad_accum,
        save_strategy="no",
        eval_strategy="epoch",
        logging_steps=5,
        learning_rate=lr,
        num_train_epochs=epochs,
        max_grad_norm=1.0,
        warmup_ratio=0.1,
        lr_scheduler_type="cosine",
        report_to=None,
        bf16=True,
        gradient_checkpointing=True,
        gradient_checkpointing_kwargs={"use_reentrant": False},
        packing=True,
        max_seq_length=max_seq_len,
    )

    trainer = SFTTrainer(
        model=model,
        args=train_args,
        train_dataset=dataset["train"],
        eval_dataset=dataset["test"],
        processing_class=tokenizer,
        peft_config=peft_cfg,
    )

    trainer.train()
    trainer.save_model()
    return trainer
Lis le code de bas en haut. SFTTrainer reçoit le modèle, les réglages, le jeu d’entraînement et le jeu de test (dataset["train"] et dataset["test"]), plus peft_cfg, la configuration qui active l’ajustement par LoRA, dont il est question juste après. trainer.train() lance l’apprentissage et trainer.save_model() sauvegarde le résultat.
Les réglages de SFTConfig sont ceux d’un entraînement classique : nombre d’époques, taille de lot, taux d’apprentissage avec une planification cosinus, précision bf16. Deux options servent surtout à tenir en mémoire, le gradient checkpointing et le packing des séquences.
Une fois l’ajustement terminé, on mesure le résultat sur ce pour quoi on l’a fait : suivi d’instructions, conversation, usage d’outils. L’évaluation ne s’arrête donc pas à la courbe de perte.
Ajuster sans tout toucher : l’idée de LoRA
Les grands modèles sont surparamétrés. C’est un atout au préentraînement, mais ça rend le finetuning complet très coûteux : leurs matrices de poids contiennent beaucoup de dépendance linéaire, ce qui est surtout inutile pour s’adapter à un domaine. LoRA (Low-Rank Adaptation) exploite cette redondance.
Le principe : on garde gelés les poids d’origine  et l’on ne leur ajoute qu’une correction, produit de deux petites matrices
 et
 :
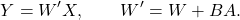
Ici  est l’entrée et
 la sortie.
 désigne les poids ajustés, et sont deux matrices de faible rang, et seules elles sont entraînées.
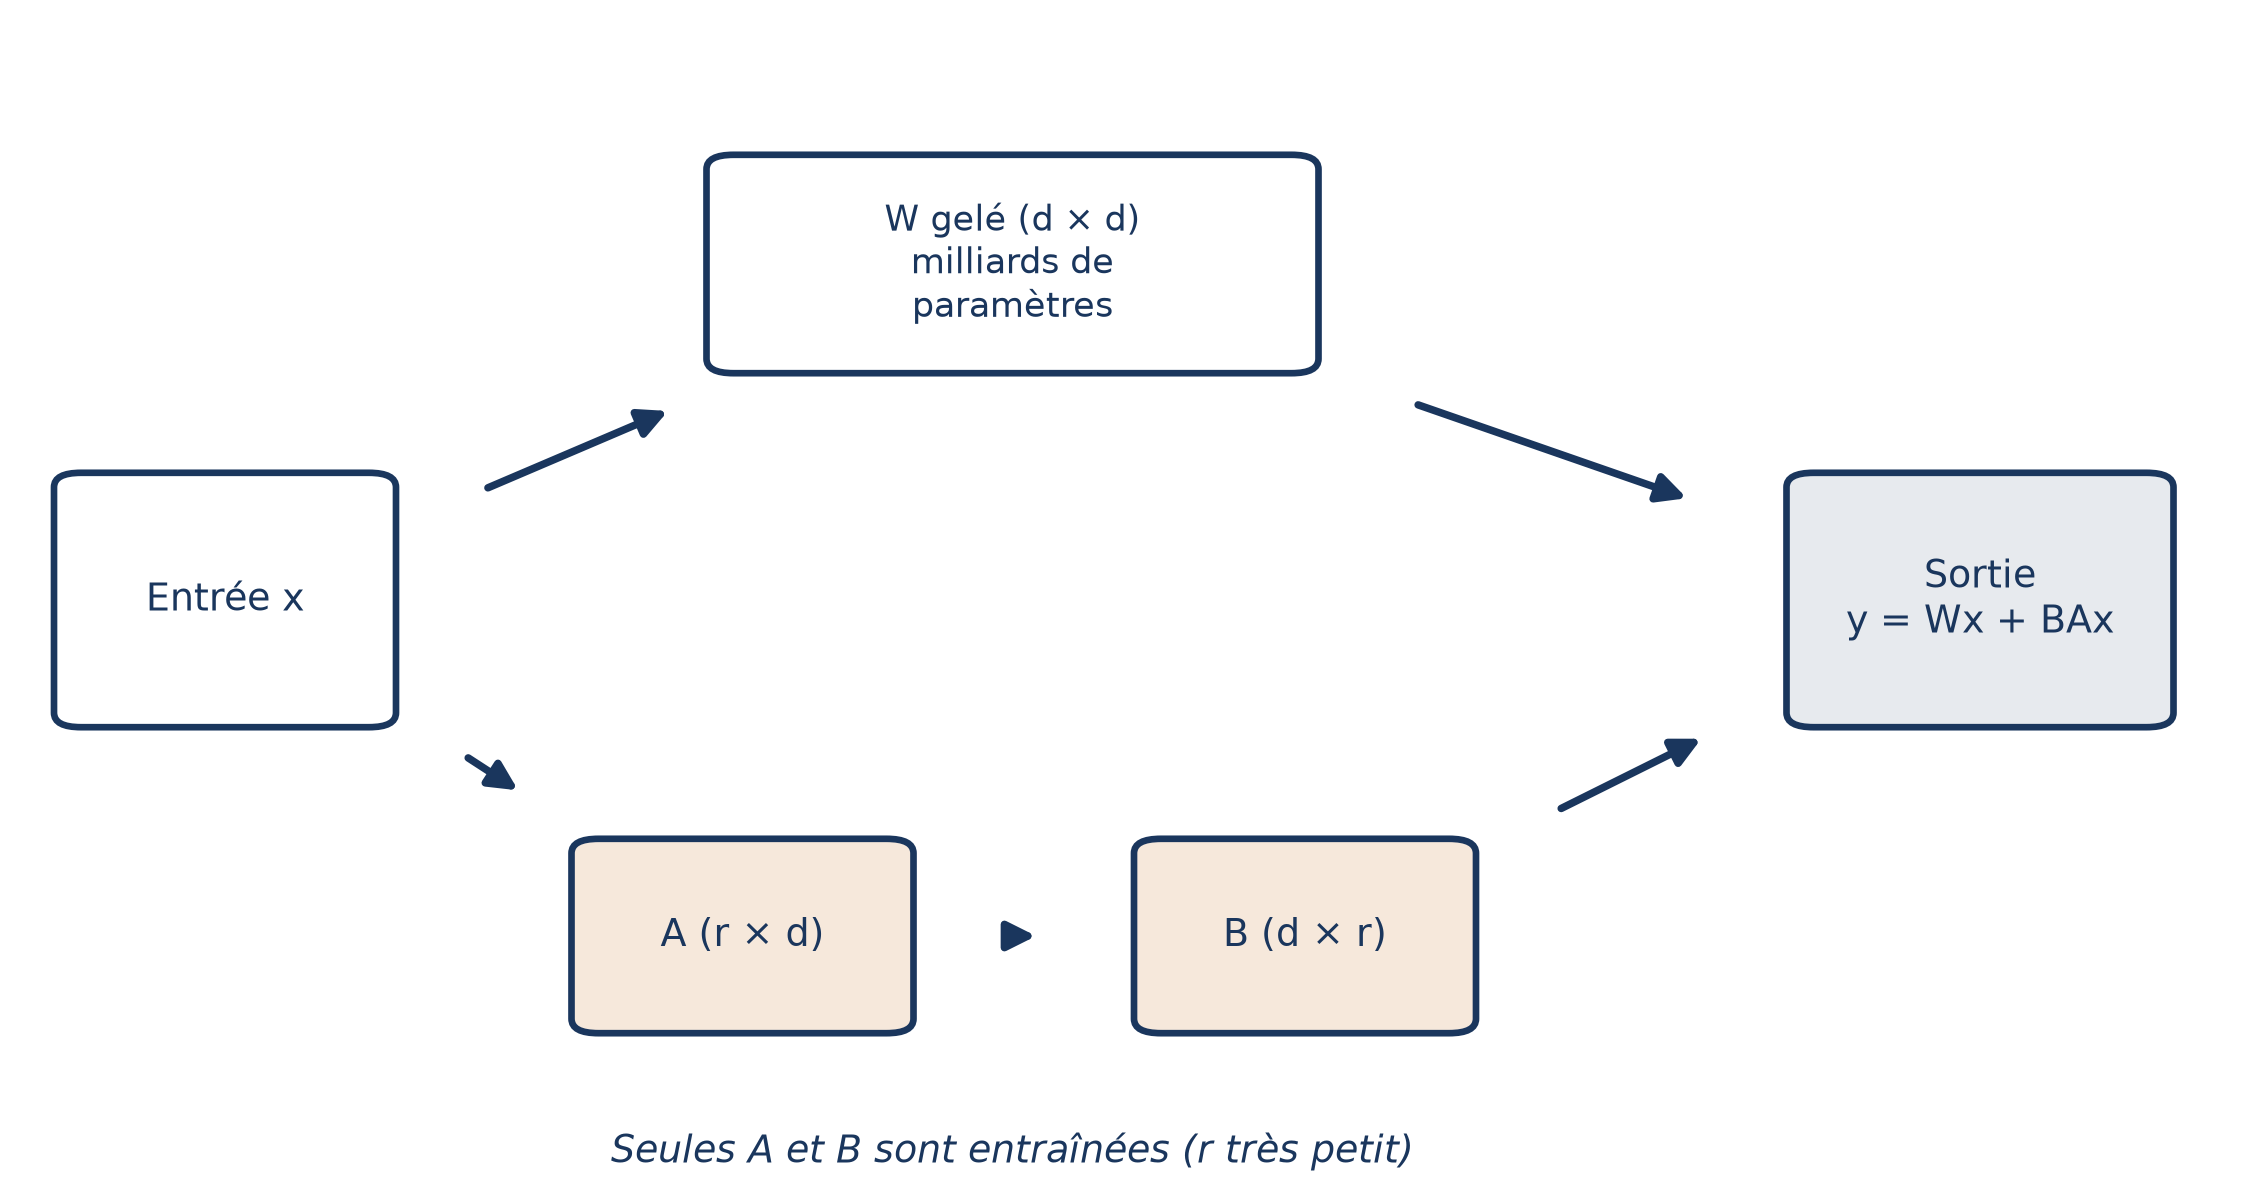
Un hyperparamètre  règle leur taille : plus il est grand, plus les matrices portent d’information, mais aussi de paramètres et de coût de calcul. Les résultats montrent que même un rang faible fonctionne bien.
Le gain se compte vite. Pour GPT-3 (175 milliards de paramètres), on n’entraîne que 17,5 millions de paramètres, soit un paramètre sur dix mille. L’inférence ne coûte pas plus cher, puisqu’on additionne simplement la matrice de changement aux poids d’origine.
Les poids d’origine restent intacts, donc LoRA n’altère pas les capacités de départ du modèle, et les points de sauvegarde pèsent moins en mémoire. On peut aussi créer des matrices de changement différentes pour des applications et des domaines différents.
Quatre leviers, quatre apprentissages
Le finetuning ne se limite pas à imiter des réponses : on distingue quatre leviers pour adapter un modèle préentraîné, selon ce qu’on lui montre :
| Levier | Ce qu’on lui donne | Ce qu’il apprend |
|---|---|---|
| Finetuning supervisé (SFT) | Des paires (invite, réponse) soigneusement choisies | Exactement comment se comporter : classification, sorties structurées, correction d’erreurs de suivi d’instructions |
| Finetuning de vision | Des paires image-étiquette | À mieux comprendre le multimodal |
| Optimisation directe des préférences (DPO) | Des couples (bonne réponse, mauvaise réponse) | À préférer la meilleure réponse des deux, ce qui sert le ton, le style ou la façon de résumer |
| Finetuning par renforcement (RFT) | Des sorties notées par des experts | À renforcer des chaînes de raisonnement complexes, pour des domaines à fort enjeu comme l’analyse juridique |
Un cas concret pour la DPO : améliorer les réponses d’un centre d’assistance informatique avec un petit modèle Phi-3. Chaque ligne du jeu de données porte une invite, une réponse préférée (chosen) et une réponse moins bonne (rejected), et un paramètre beta règle avec quelle force le modèle privilégie la préférée. Le modèle de base y est chargé en 4 bits, avec des adaptateurs LoRA de rang 8.
L’instruction tuning et l’alignement sur les préférences humaines sont eux aussi des finetunings : on ajuste les mêmes poids, avec un autre objectif.
Prompt, génération augmentée, distillation : où il se place
On présente souvent le finetuning et la génération augmentée par récupération comme des rivaux. Ils relèvent en réalité de mécanismes complémentaires : la récupération enrichit la mémoire non paramétrique du modèle sans toucher à ses poids, tandis que le finetuning supervisé modifie la mémoire paramétrique elle-même. Il est surtout pertinent quand on veut changer la manière de répondre : style, ton, vocabulaire.
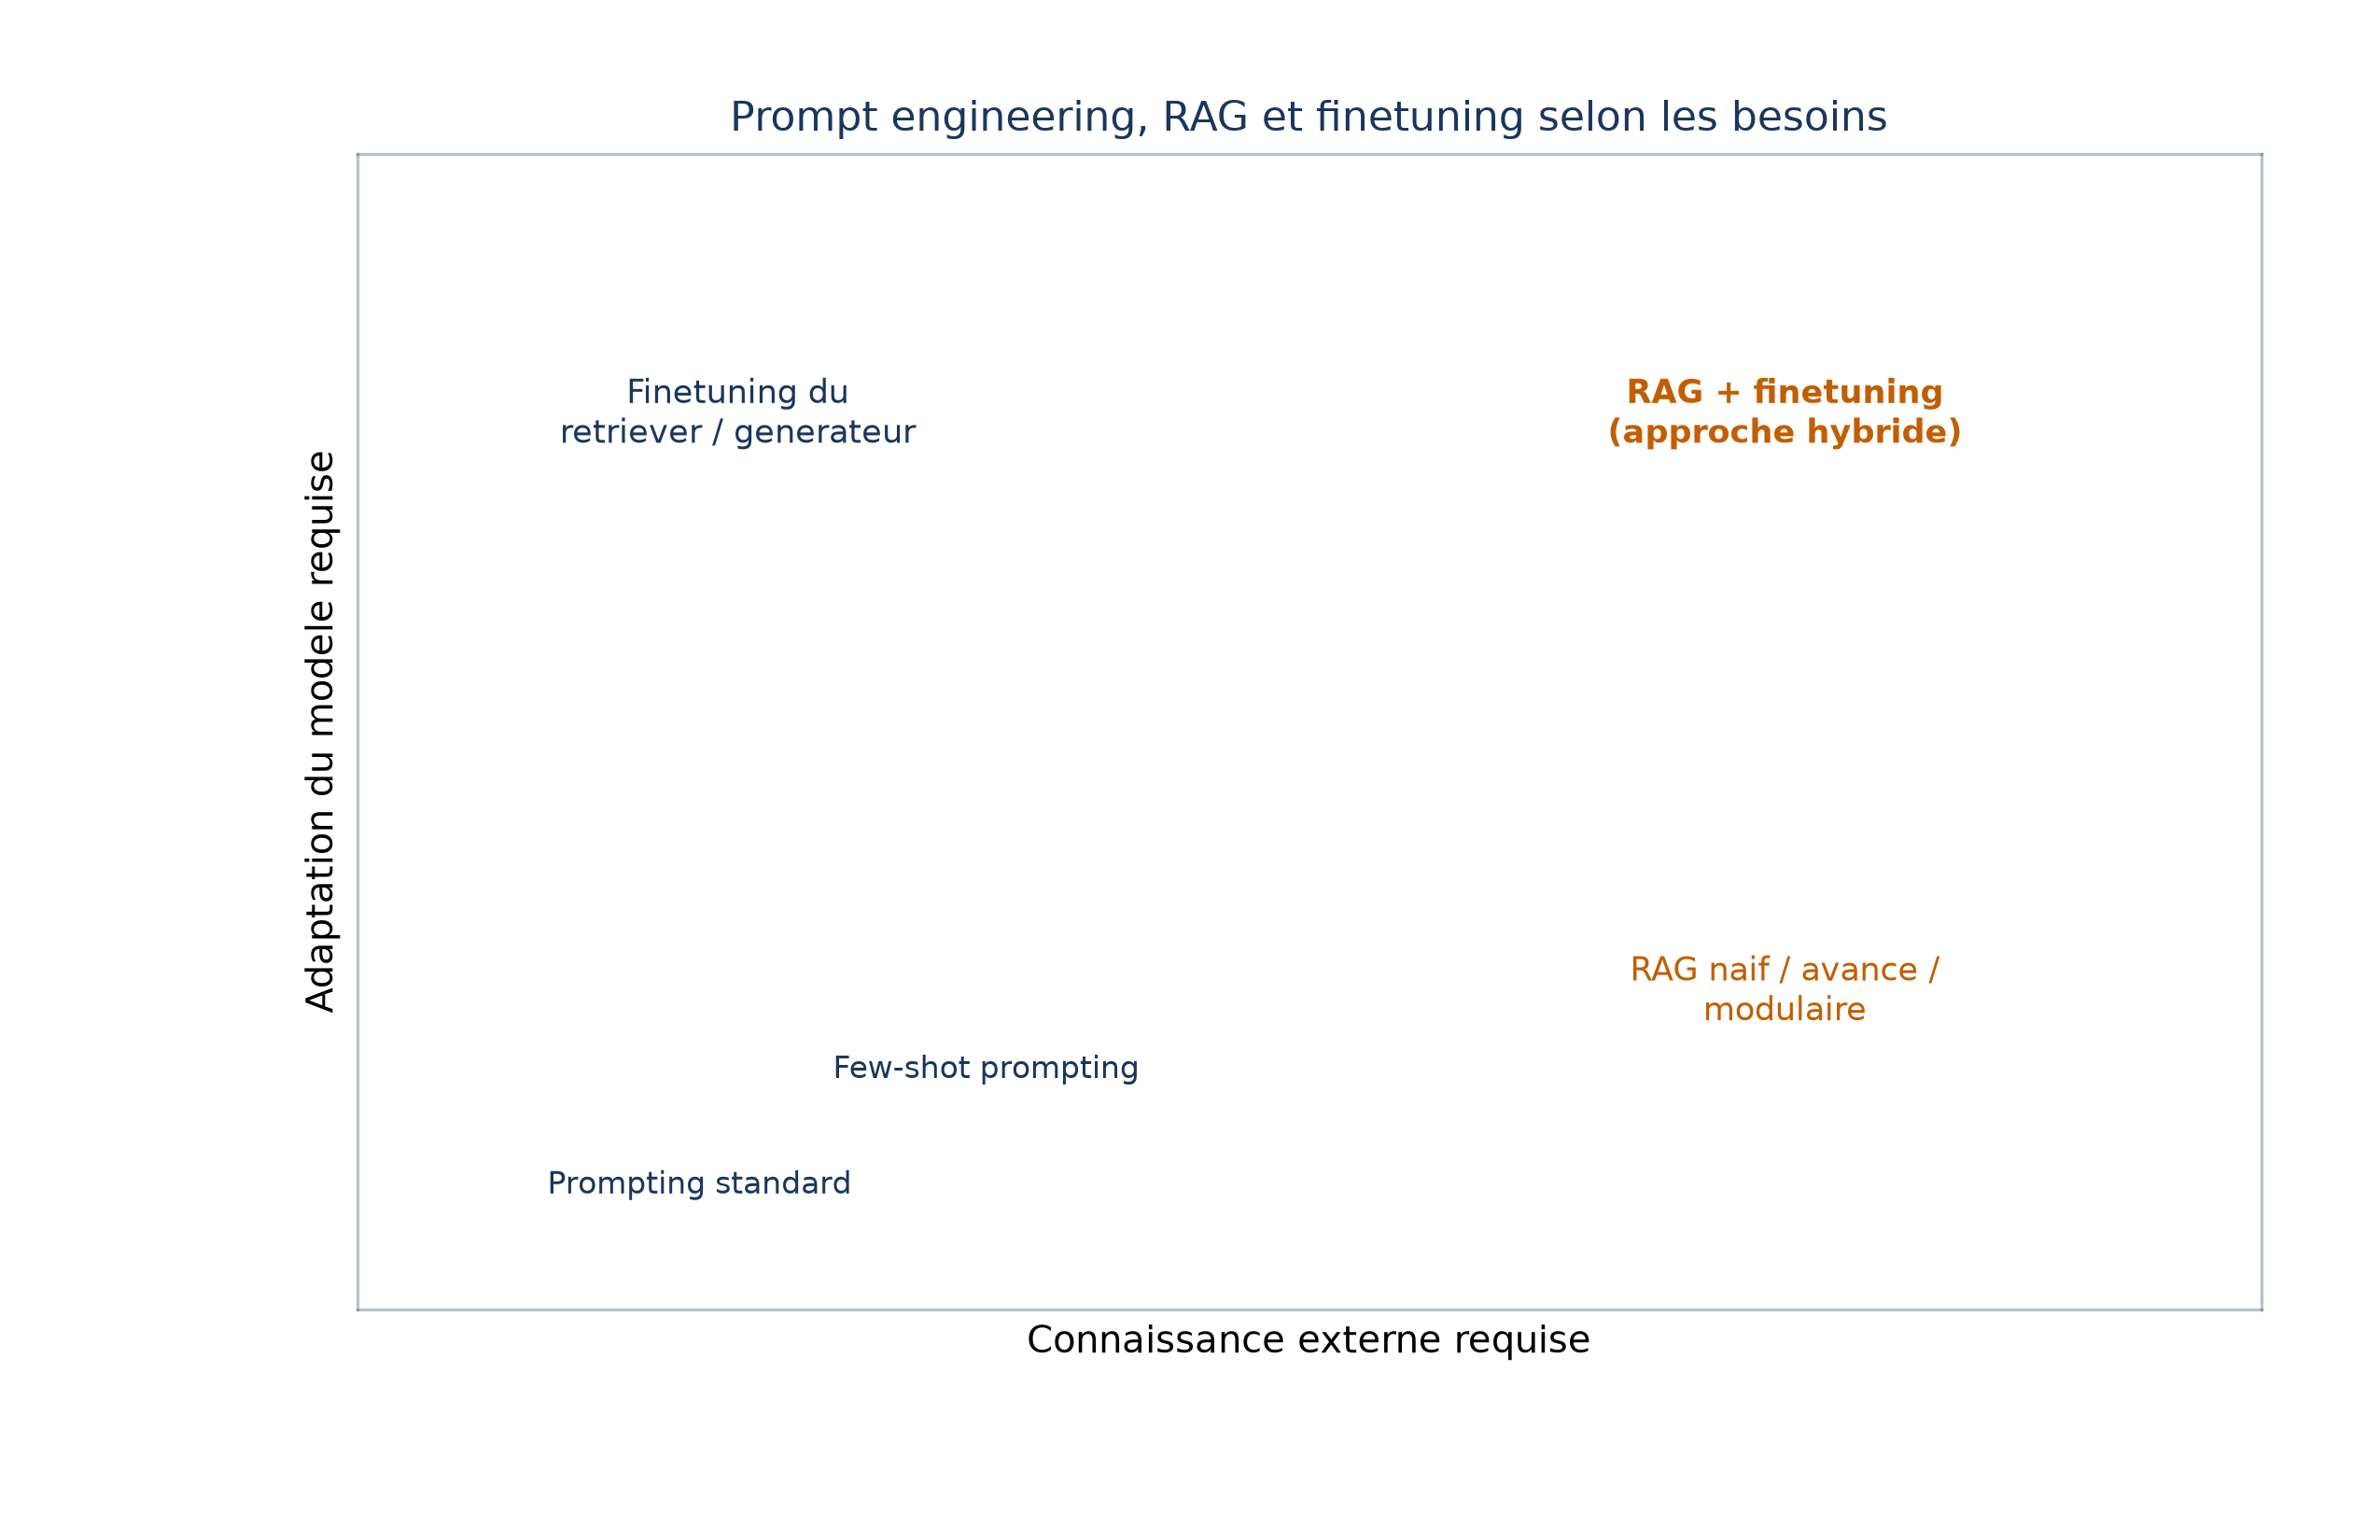
Les exemples pratiques parlent d’eux-mêmes. Résumer dans un domaine très spécialisé demande que le modèle comprenne bien le contexte, donc le finetuning convient mieux. Répondre à des questions sur une documentation exige de réduire les hallucinations et de citer des sources, donc la récupération est meilleure. Générer du code appelle les deux : une base de code dynamique et un modèle adapté à la tâche.
Le finetuning ne concerne pas que le modèle de langage. On peut aussi ajuster le modèle d’embedding sur un jeu de données précis : il saisit mieux les nuances du domaine, d’où une meilleure récupération. Ça coûte bien moins que de l’entraîner de zéro, et des bibliothèques comme Sentence Transformers facilitent le processus, avec des exemples positifs et négatifs.
Reste une confusion fréquente avec la distillation. Dans celle-ci, un grand modèle « enseignant » entraîne un petit modèle « élève » à l’imiter, en lui montrant ses distributions de probabilités, pas seulement ses réponses.
Idées reçues et limites
« Finetuner, c’est entraîner un modèle »
Pas au sens du préentraînement. Souvent, les modèles libres de qualité comprennent déjà un post-entraînement ou un réglage d’instructions proche de la tâche. Cela supprime le besoin d’ajustement supplémentaire, ou le réduit à des mises à jour ciblées minimales.
« C’est une potion magique »
L’ajustement exploite les connaissances préexistantes mais recentre le modèle sur un domaine, ce qui peut dégrader la performance et provoquer des hallucinations. Un jeu d’exemples trop étroit ou périmé expose aussi au surajustement aux données historiques, et à l’oubli des tendances émergentes. C’est pour cela qu’on décontamine le jeu de test, comme vu plus haut.
« On finetune une fois, et c’est réglé »
Un modèle ajusté exige une gestion de versions, un calendrier de réentraînement et des contrôles de compatibilité. Pire, les fournisseurs sortent régulièrement de meilleurs modèles de base : une nouvelle version peut surpasser ton modèle ajusté et anéantir des mois de réentraînement.
Et le modèle ne peut pas apprendre en continu sans accroc : permettre à un modèle de s’adapter à de nouvelles tâches sans oublier ce qu’il a appris, c’est le problème de l’oubli catastrophique, qui reste ouvert aujourd’hui.
📌 À retenir Avant d’investir, on regarde si un modèle préentraîné ou réglé pour les instructions répond au besoin avec de l’ingénierie d’invite, un apprentissage non paramétrique ou une adaptation légère. Dans le doute, ne finetune pas : d’autres actions coûtent moins cher et pèsent souvent davantage.