Imagine que tu lises une critique de film avec pour seul support une page de brouillon. À chaque phrase, tu choisis : qu’est-ce que j’efface, qu’est-ce que je garde, qu’est-ce que j’ajoute ? Un GRU fait exactement ce choix, mot après mot, sur une page unique. Tu vas voir comment il s’y prend, ce qu’il simplifie par rapport au LSTM et où sa légèreté se paie.
Sommaire
- L’essentiel en 30 secondes
- Un seul carnet au lieu de deux : ce qu’est un GRU
- Les deux portes : qui décide de quoi
- Un pas de calcul : du brouillon à l’état suivant
- GRU contre LSTM : ce que la simplification retire
- Un GRU au travail : lire un avis de film
- Léger ne veut pas dire gratuit
L’essentiel en 30 secondes
- Un GRU (gated recurrent unit) est une variante allégée du LSTM : il a lui aussi des portes internes, mais il est beaucoup plus simple.
- Il ne garde qu’un seul état, l’état caché, là où le LSTM en entretient deux.
- Il a deux portes : la porte de mise à jour
 et la porte de réinitialisation
 .
- Le nouvel état est un mélange entre ancien état et candidat, dosé par .
- Moins de paramètres et une convergence parfois plus rapide, mais un risque de surapprentissage plus élevé et une mémoire moins fine à très long terme.
Un seul carnet au lieu de deux : ce qu’est un GRU
Un GRU est une cellule de réseau récurrent pensée comme une version simplifiée du LSTM. Il lutte comme lui contre le gradient évanescent, et garde du LSTM quatre ingrédients : l’addition, le produit de Hadamard, un contexte porté d’un pas à l’autre, et des portes qui contrôlent l’information dans la couche.
Reprenons le brouillon. Le LSTM tient deux pages : une mémoire courte  , utile à l’instant
 , et une mémoire longue
 . Le GRU n’en tient qu’une seule, son état caché , qui porte à la fois ce qu’il faut sortir maintenant et ce qu’il faut retenir pour la suite.
💡 Intuition Pense à une page de brouillon que tu réécris à chaque nouvelle phrase. Deux curseurs règlent la réécriture : l’un dit combien de l’ancien texte tu conserves, l’autre combien tu consultes de l’ancien texte avant de rédiger le nouveau.
Malgré un nombre de paramètres réduit, un GRU peut converger plus vite et atteindre des performances comparables à celles du LSTM.
Les deux portes : qui décide de quoi
Les deux portes sont calculées de la même façon, à partir de l’entrée courante  et de l’état précédent
 :

Chaque porte a son biais ( ,
 ) et ses matrices de poids :
 pondère l’entrée,
 pondère le passé. La sigmoïde
 ramène chaque composante entre 0 et 1, ce qui donne à la porte son rôle d’interrupteur progressif.
La porte de mise à jour descend de la porte d’oubli du LSTM : quand ses valeurs sont proches de 1, l’information importante est conservée ; proches de 0, l’information sans importance est réécrite.
La porte de réinitialisation descend de la porte d’entrée, avec une différence de taille : elle n’est plus indépendante, elle est reliée à la porte de mise à jour. Elle règle la part de l’état précédent ignorée quand on calcule le nouvel état.
Un pas de calcul : du brouillon à l’état suivant
Une fois et connues, le GRU fabrique un état candidat  , le brouillon du nouvel état, puis le mélange avec l’ancien :

Lis la première égalité : le passé n’entre dans le brouillon qu’après avoir traversé le filtre . Si est proche de 0, le brouillon ne repose presque plus que sur l’entrée : c’est la part « ignorée » de l’état précédent. Cette porte décide donc quelle nouvelle information entre et quelle part utile du passé reste.
La seconde égalité est le cœur du dispositif. Les poids et  s’additionnent à 1 : le nouvel état est une moyenne pondérée. Avec proche de 1, l’état traverse le pas presque inchangé ; avec proche de 0, il est remplacé par le candidat.
Le LSTM, lui, règle l’oubli et l’ajout avec deux portes indépendantes,  et
 . Le GRU n’en utilise qu’une : tout ce qu’il garde de l’ancien, il le retire au nouveau.
GRU contre LSTM : ce que la simplification retire
Le tableau met face à face les deux cellules, telles que leurs équations les décrivent :
| LSTM | GRU | |
|---|---|---|
| États entretenus | deux : et |
un seul : |
| Portes | trois (oubli, entrée, sortie), indépendantes | deux (mise à jour, réinitialisation), reliées |
| Blocs de poids dans les équations | quatre (, ,  ,  ) |
trois (, ,  ) |
| Valeurs rendues par la couche PyTorch | sortie, état caché et état de cellule | sortie et état caché |
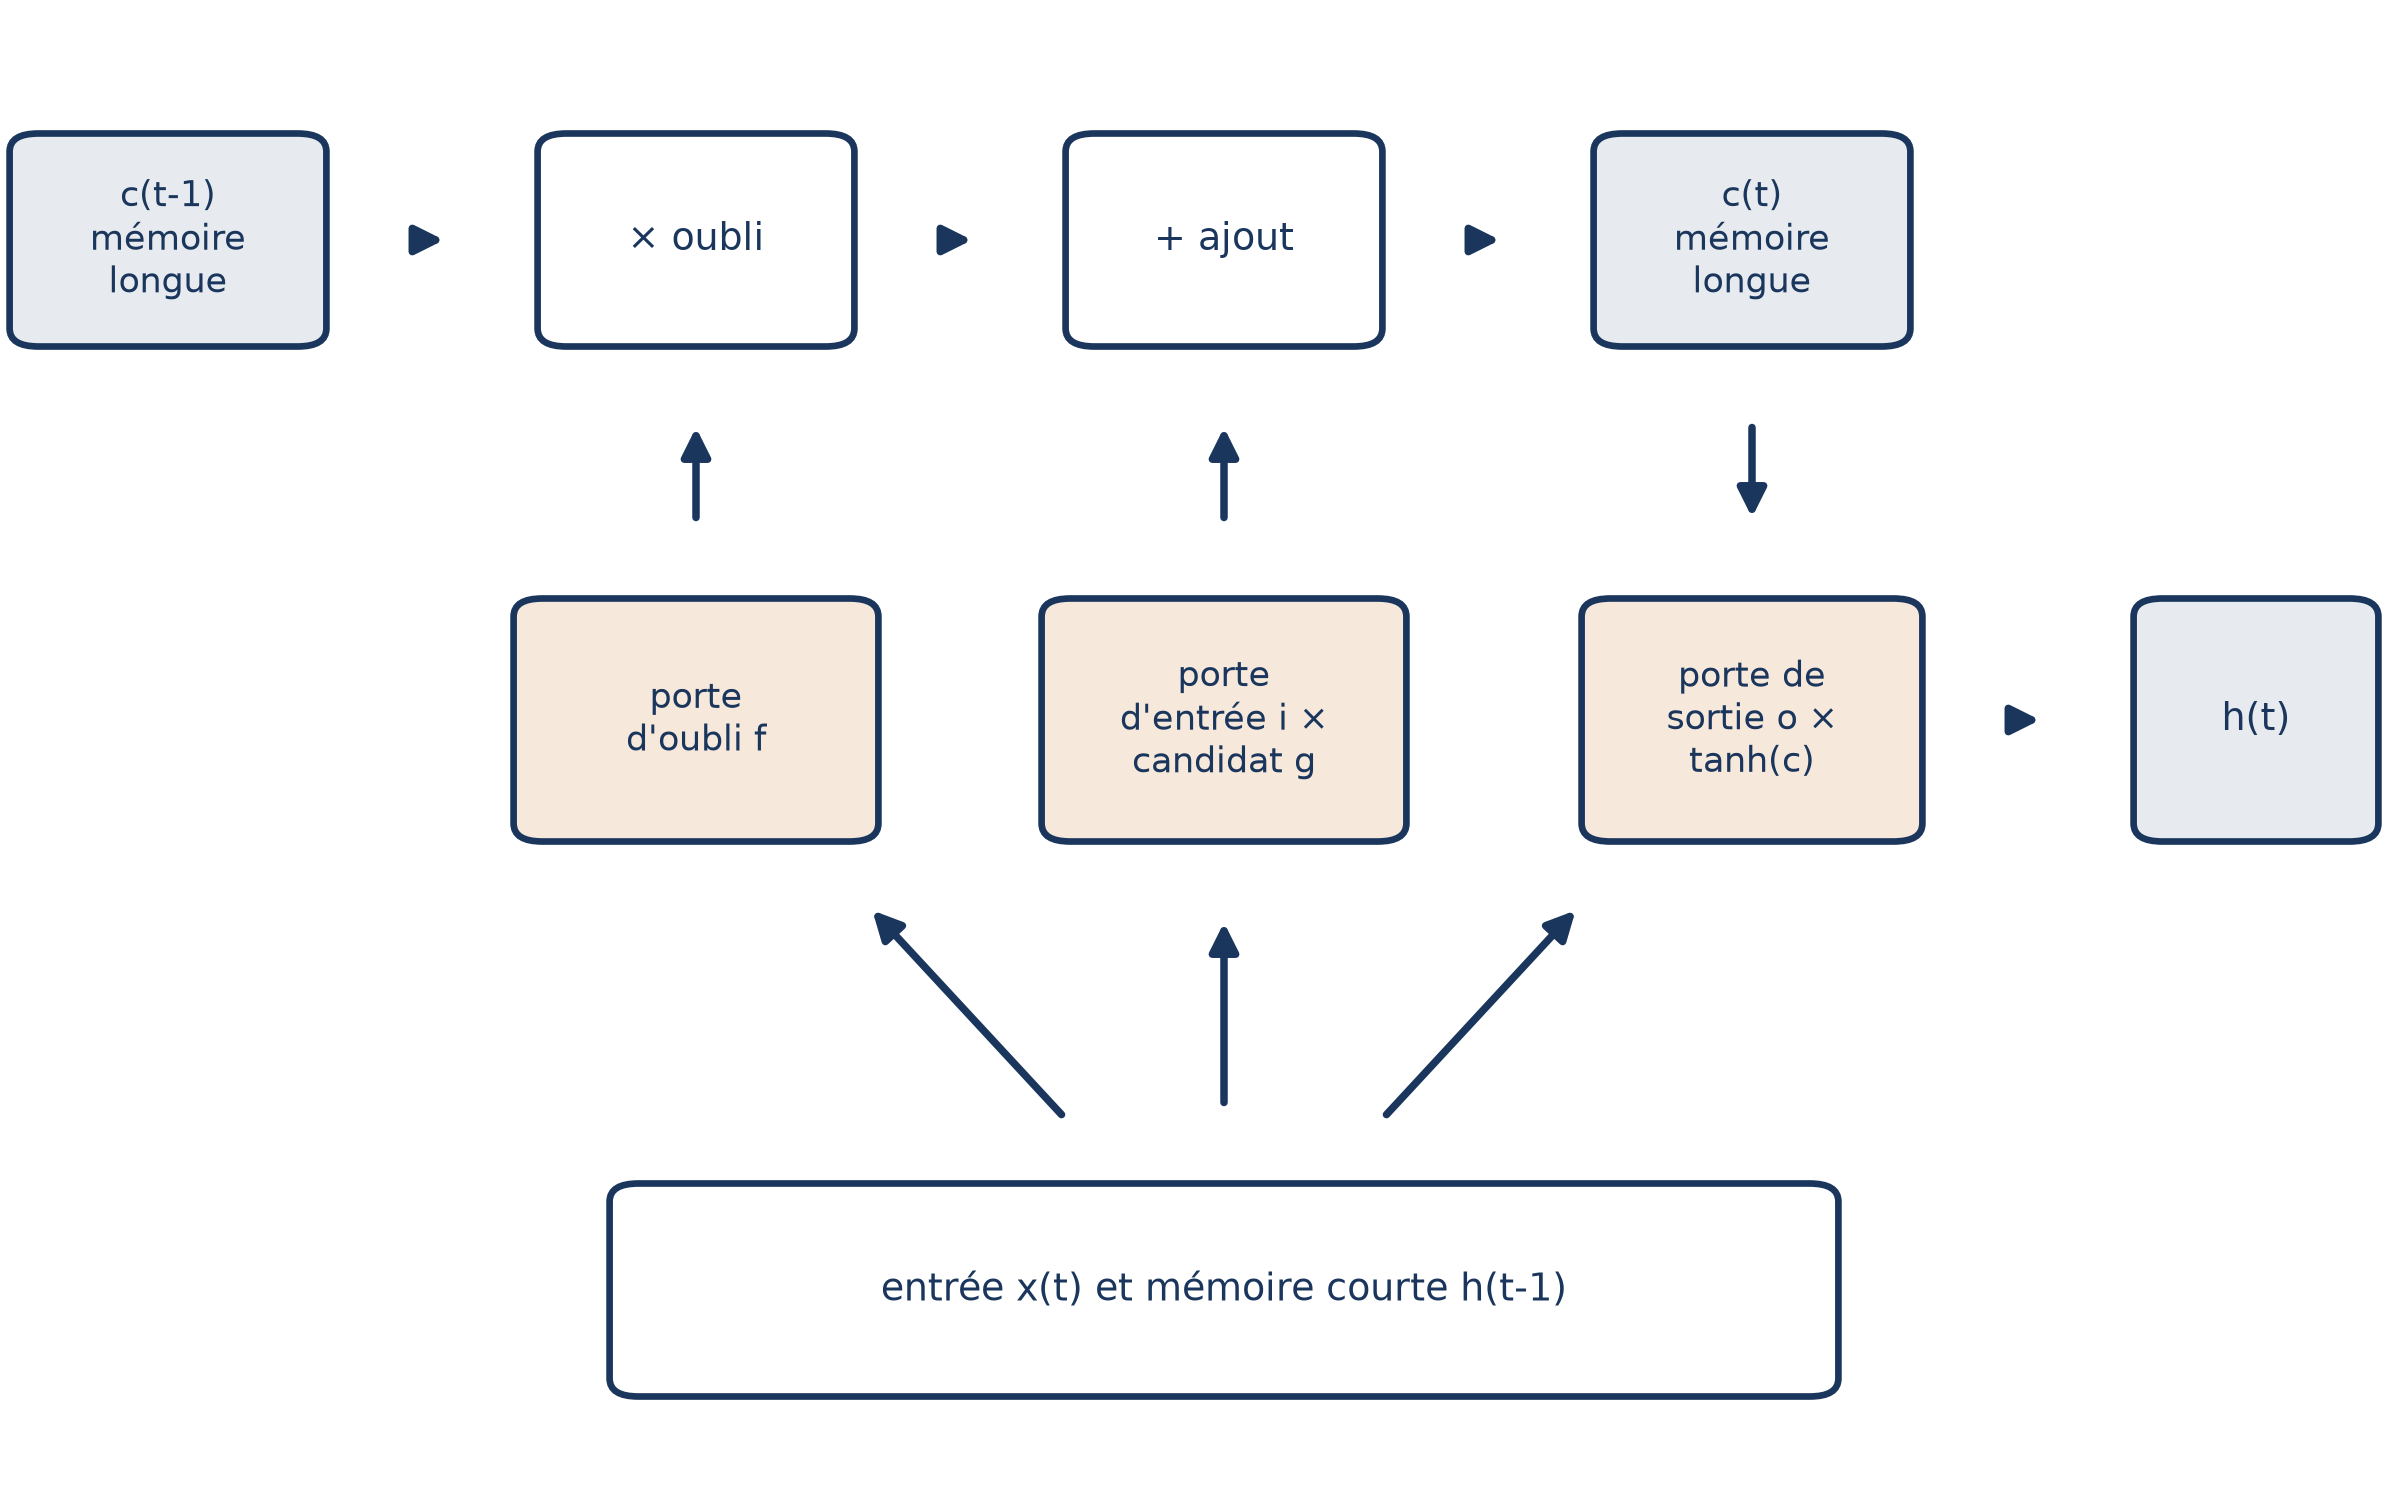
Repère la ligne du haut, celle de la mémoire longue : c’est précisément ce que le GRU supprime. Dans le schéma d’un GRU, il ne resterait que la mémoire courte , pilotée par et .
Cette ligne en moins se traduit par moins de paramètres et moins de calcul. Le GRU sait quand même traiter de longues séquences sans oublier les entrées passées, et il se comporte bien sur de nombreuses tâches textuelles, en reconnaissance vocale ou en génération musicale.
Un GRU au travail : lire un avis de film
Question concrète : comment faire lire un avis à un réseau pour qu’il rende un verdict, positif ou négatif ? On empile des couches GRU qui avalent le texte mot après mot. Avant de l’assembler, regarde la brique seule. Les extraits supposent que numpy et torch sont déjà importés ; on fabrique un tenseur aléatoire de dimensions 10, 5, 3 et on le passe dans une couche GRU :
data_tensor = torch.tensor(np.random.random((10, 5, 3)),
                           dtype=torch.float32)
GRU =nn.GRU(input_size=3, hidden_size=10,
            num_layers=1, batch_first=True)
output, hidden = GRU(data_tensor)
Chaque élément de la séquence est décrit par 3 nombres (input_size=3) et l’état caché en compte 10 (hidden_size=10). Remarque la dernière ligne : la couche rend output et hidden, rien d’autre. Pas d’état de cellule, comme le tableau de la section précédente l’annonçait.
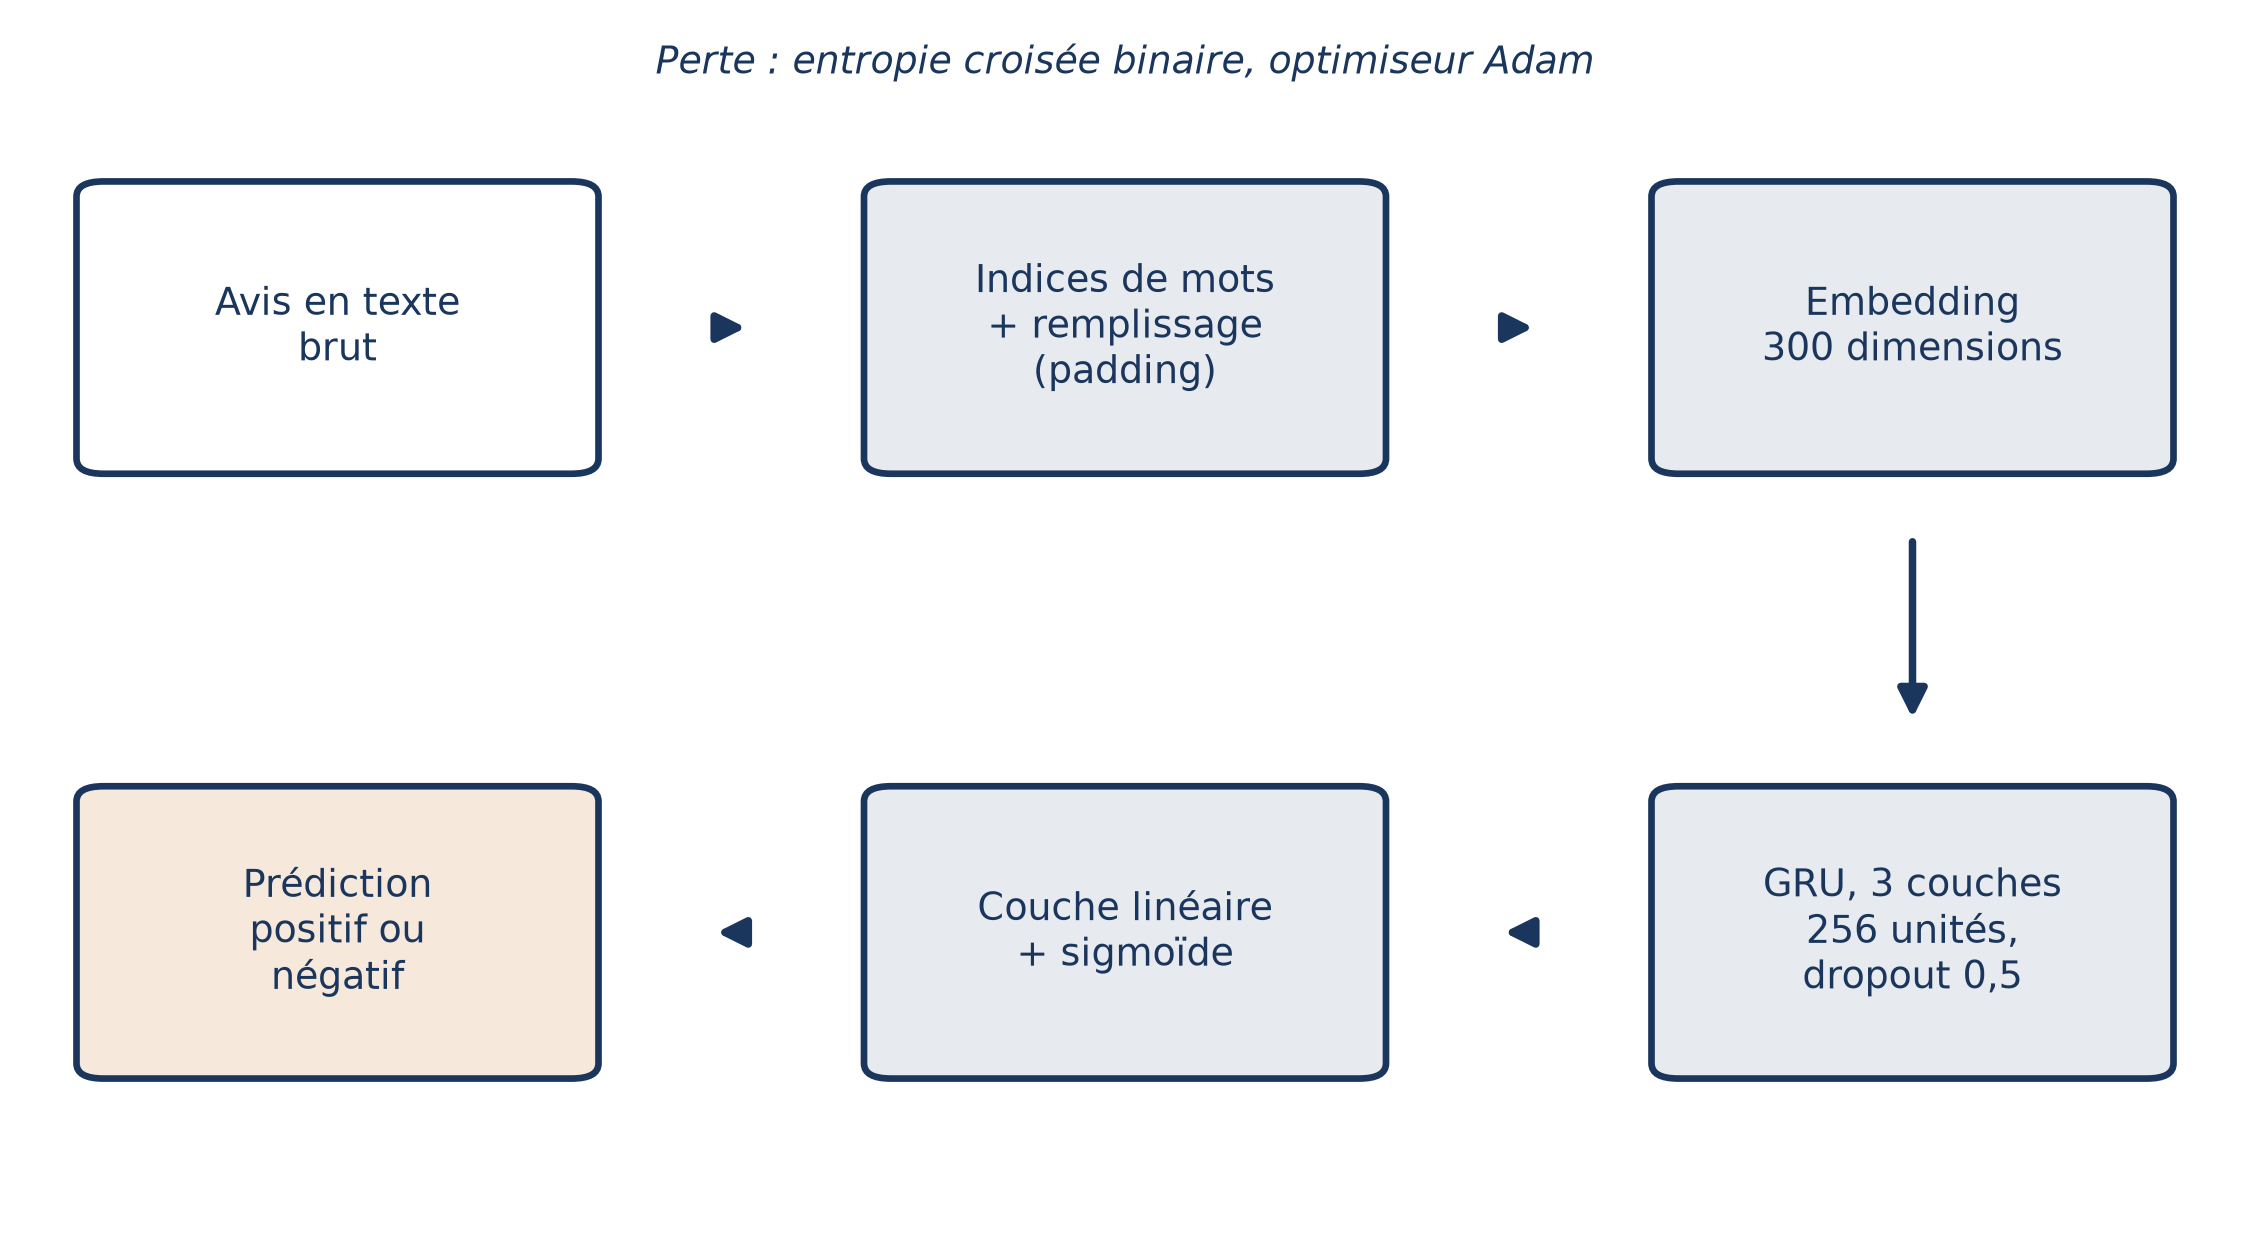
Pour le vrai classifieur, l’avis brut est converti en indices de mots, complété par du remplissage, puis transformé en vecteurs de 300 dimensions. Ces vecteurs entrent dans un GRU de 3 couches de 256 unités avec un dropout de 0,5, et une couche linéaire suivie d’une sigmoïde fournit la prédiction.
Le code qui fixe ces dimensions tient en quelques lignes :
# Hyperparameters
no_layers = 3
vocab_size = len(vocab) + 1  # extra 1 for padding
embedding_dim = 300
output_dim = 1
hidden_dim = 256
# Initialize the model
model = SentimentRNN(no_layers, vocab_size, hidden_dim,
                     embedding_dim, drop_prob=0.5)
vocab est le vocabulaire des avis, auquel on ajoute une place pour le remplissage ; SentimentRNN est le modèle qui assemble embedding, couches GRU et couche linéaire. output_dim = 1 correspond à la probabilité unique que l’avis soit positif, et le dropout stabilise l’entraînement. Le verdict n’ayant que deux issues, l’entraînement s’appuie sur l’entropie croisée binaire et l’optimiseur Adam.
Léger ne veut pas dire gratuit
Deux idées reçues à ranger.
« Un GRU est un LSTM au rabais. » Non : à performances comparables, il demande moins de paramètres et peut converger plus vite. Mais il est moins efficace que le LSTM pour modéliser des dépendances à très long terme ou des motifs complexes.
⚠️ Piège Moins de paramètres, c’est aussi plus de risque de surapprentissage. Un GRU léger n’est pas un GRU sans réglage de régularisation, comme le dropout de l’exemple précédent.
« Les portes sont codées à la main. » Non plus : et sont des calculs, avec des poids propres à chaque porte, appliqués à l’entrée et à l’état du moment. Rien n’est figé d’avance.
📌 À retenir Un GRU est un réseau récurrent à une seule mémoire et deux portes :