Montre à une machine 50 000 avis de films, chacun étiqueté « positif » ou « négatif », et elle finit par deviner le ton d’un avis qu’elle n’a jamais lu. Personne ne lui a dicté la liste des mots à surveiller : elle a réglé elle-même ses paramètres, essai après essai. C’est l’idée d’un modèle d’apprentissage profond. Ici, tu vas voir de quoi il est fait, comment il calcule, comment il apprend, et dans quels usages tu le croises déjà.
Sommaire
- L’essentiel en 30 secondes
- Un empilement de couches, pas un programme écrit à la main
- Dans une couche, chaque neurone ne fait que deux gestes
- Pourquoi empiler ne suffit pas : la cassure de la linéarité
- Comment les poids se règlent tout seuls
- Ce que les couches finissent par savoir voir
- Un avis de film, du texte brut au verdict
- Une même famille, des formes différentes selon les données
- À quoi un modèle profond sert concrètement
- D’où vient son succès : une vieille idée devenue praticable
- Trois idées reçues à ranger
L’essentiel en 30 secondes
- Un modèle d’apprentissage profond est un réseau de neurones à plusieurs couches cachées : la sortie de chaque couche devient l’entrée de la suivante.
- Chaque neurone fait deux gestes : une somme pondérée de ses entrées, puis le passage par une fonction d’activation non linéaire.
- Sans cette non-linéarité, les couches s’effondrent en une seule : la profondeur n’apporterait rien.
- Les poids se règlent par descente de gradient et rétropropagation, qui font remonter l’erreur de la sortie vers l’entrée.
- Les couches successives bâtissent des représentations de plus en plus abstraites : plus besoin de décrire à la main ce qu’il faut regarder.
Un empilement de couches, pas un programme écrit à la main
Un réseau de neurones organise ses neurones en couches. Une couche d’entrée reçoit les données, une ou plusieurs couches cachées les transforment, et une couche de sortie renvoie la réponse. L’information circule d’abord vers l’avant, des entrées vers la sortie : on parle de propagation avant.
Le mot profond ne désigne rien de plus mystérieux que ceci : on empile plusieurs couches cachées. La sortie d’une couche devient l’entrée de la suivante.
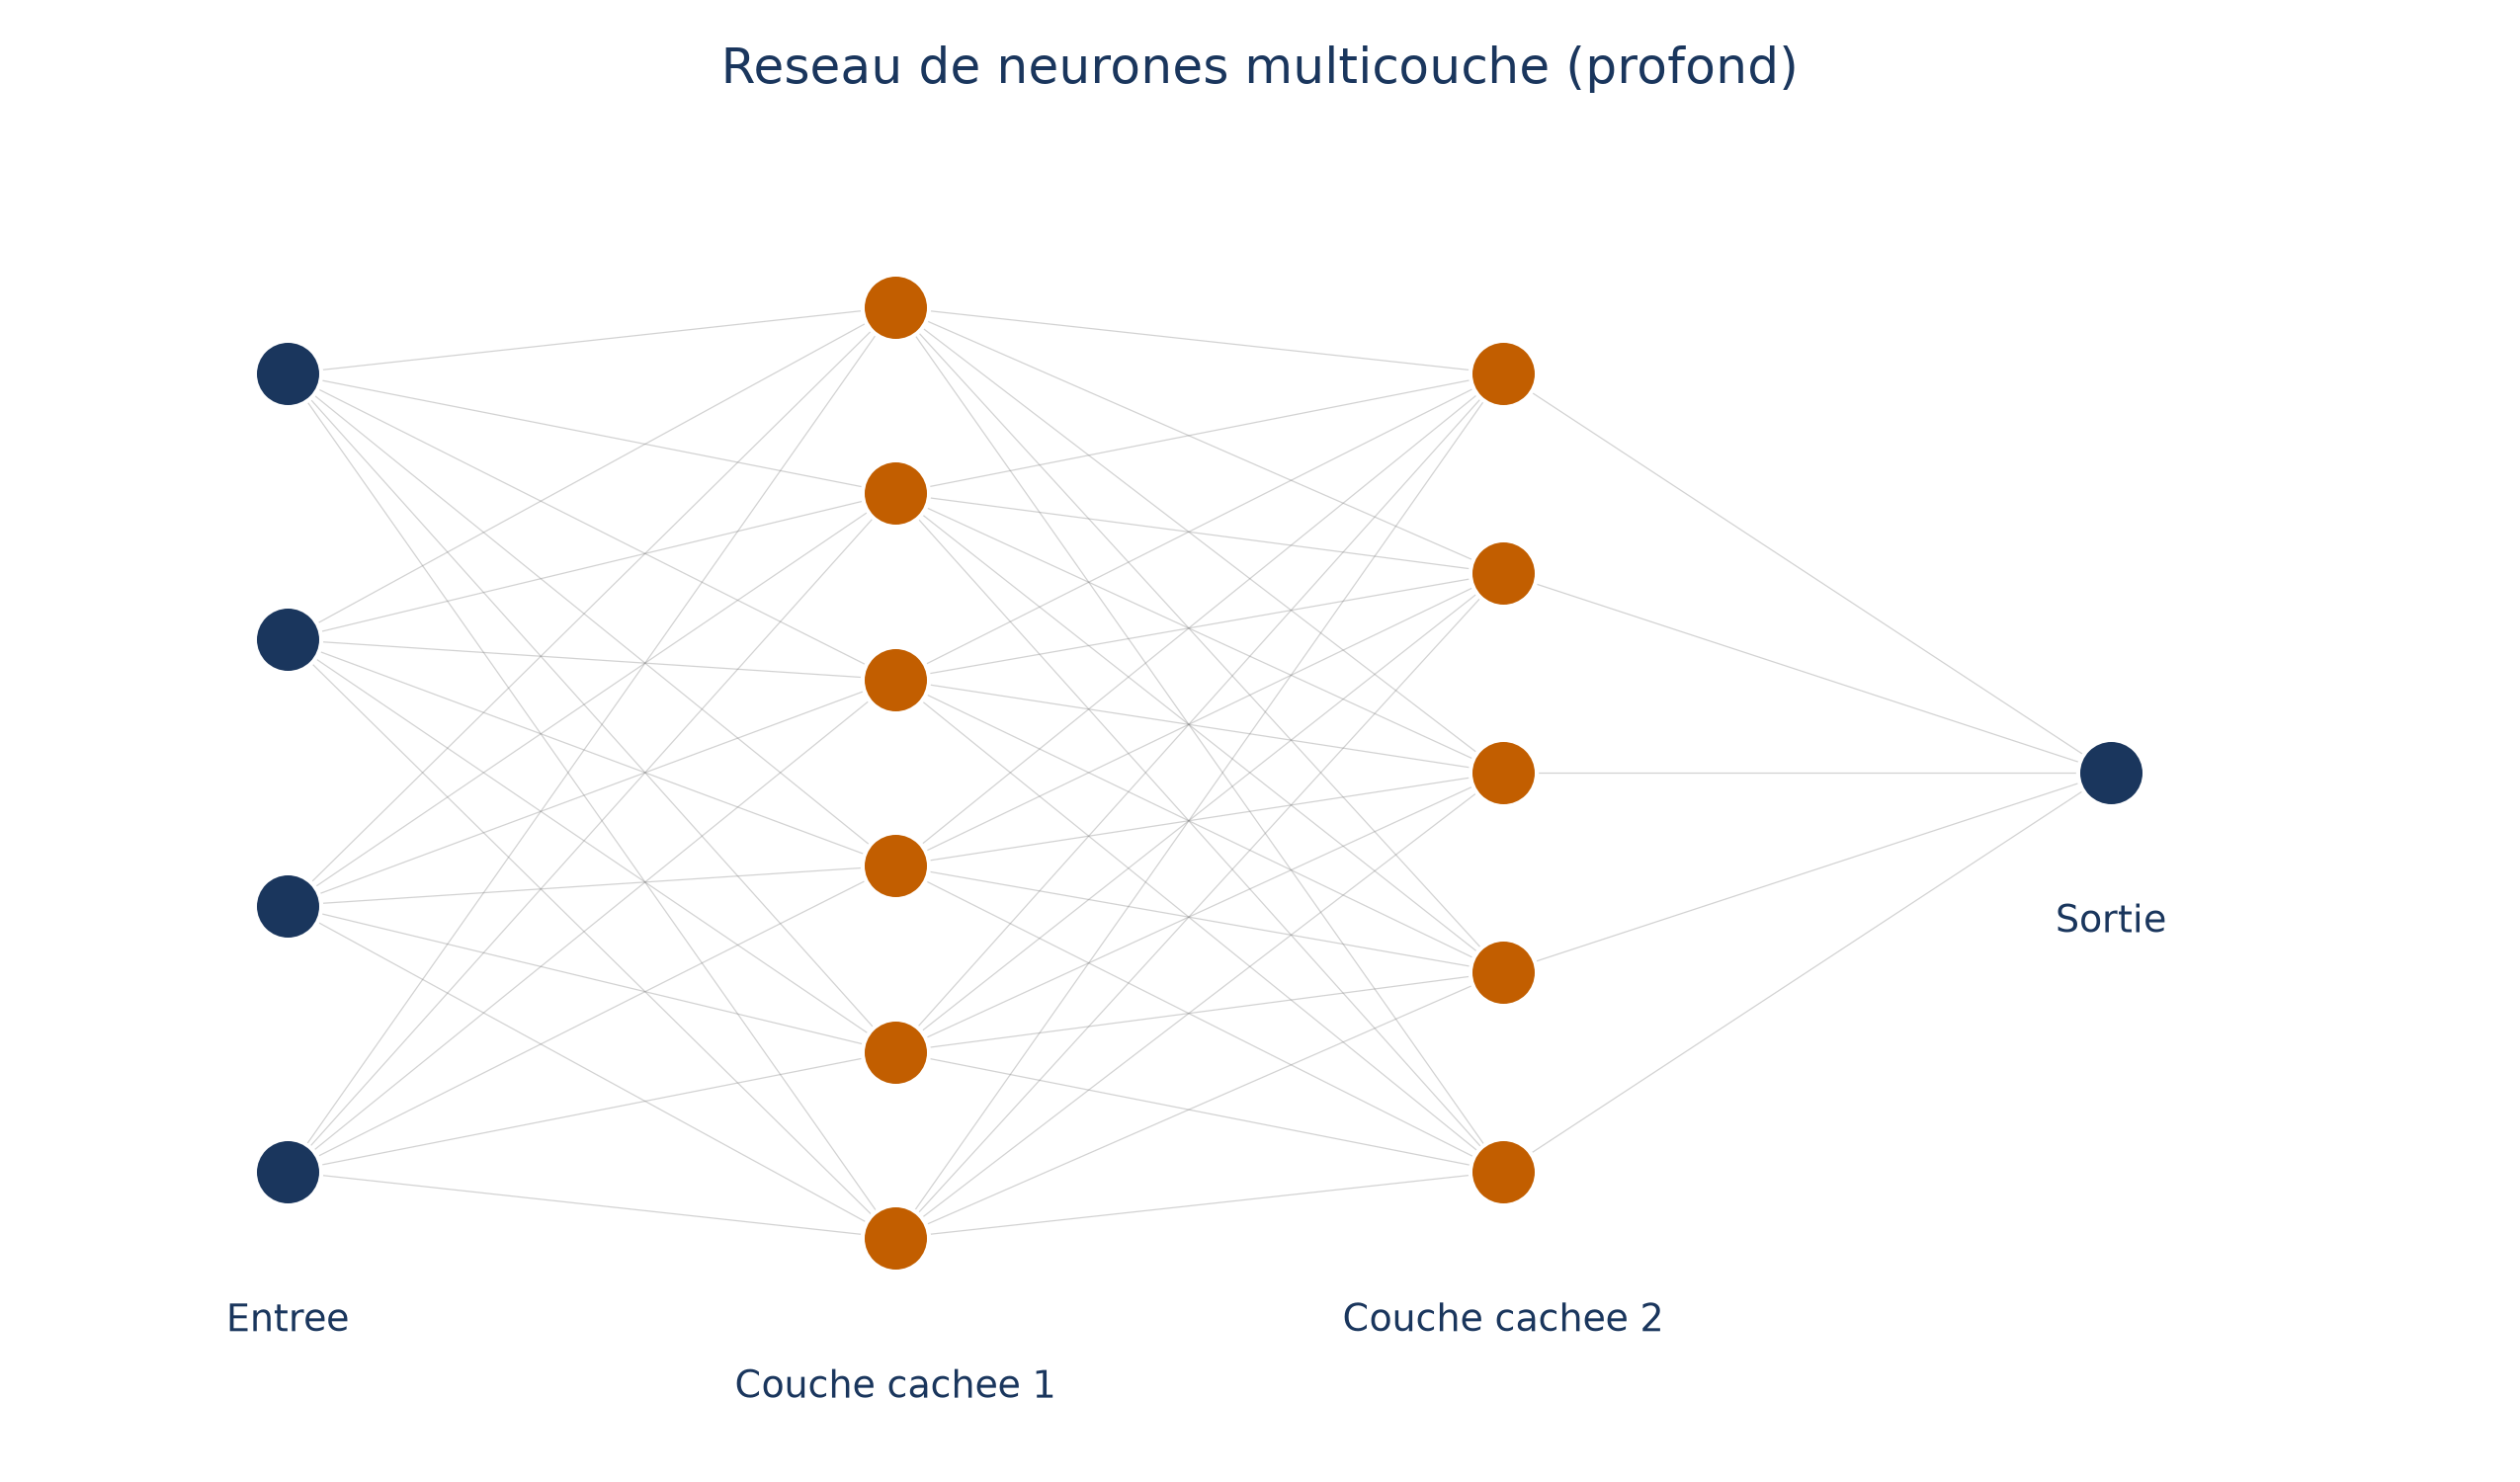
Combien de couches faut-il pour mériter le mot ? Il n’y a pas de seuil officiel, mais les ordres de grandeur ont beaucoup bougé. Les premiers réseaux n’en avaient que quelques-unes ; dans les années 2000, la recherche a visé plusieurs dizaines de couches ; les réseaux des grands modèles de langage comptent aujourd’hui des dizaines à des centaines de couches.
Quant aux valeurs numériques qui règlent le comportement du réseau, ses poids, elles ne sont pas écrites par un humain. Elles sont fixées pendant l’entraînement.
Dans une couche, chaque neurone ne fait que deux gestes
L’unité de base est le neurone : un petit programme qui reçoit plusieurs entrées, multiplie chacune par un poids, additionne le tout (c’est un produit scalaire) et ajoute un biais. Le résultat traverse ensuite une fonction d’activation. Un groupe de neurones indépendants forme une couche ; le « réseau » se trouve entre les couches, là où chaque neurone reçoit les sorties de la couche précédente.
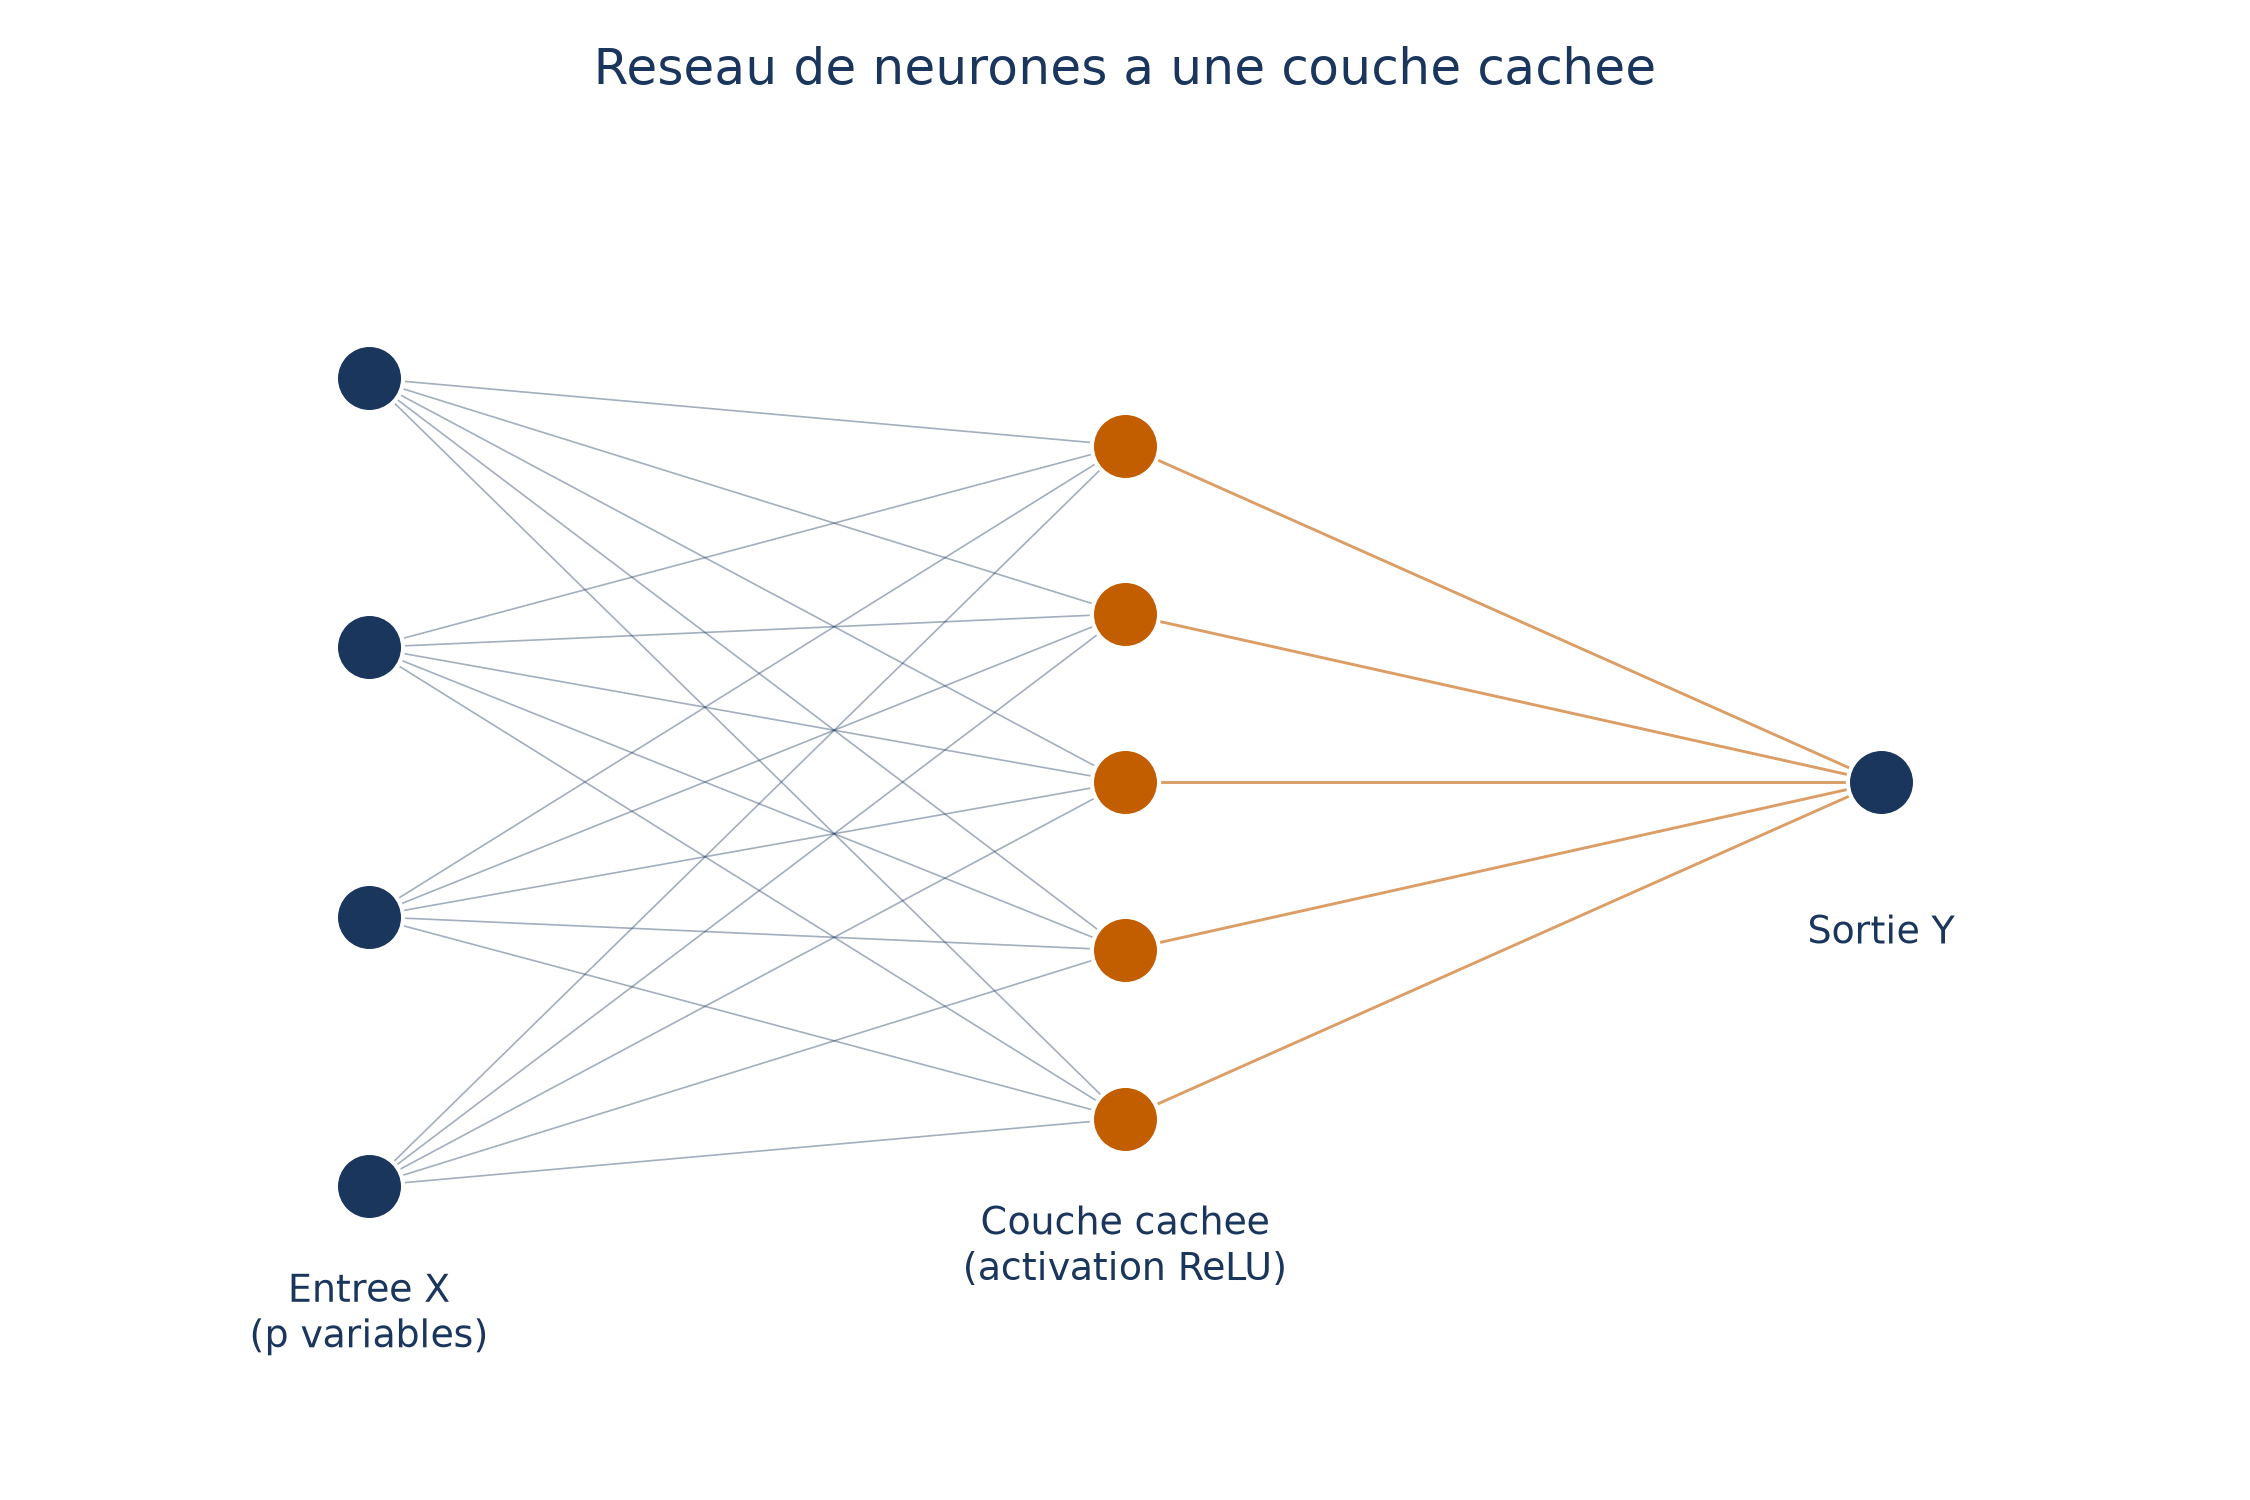
Pour la version à une couche cachée, avec  entrées
 et
 neurones cachés, l’activité du neurone
 s’écrit :
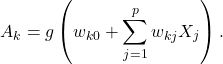
Lis-la de l’intérieur vers l’extérieur : chaque entrée  est multipliée par son poids
 , on additionne le tout avec le biais
 , puis la fonction d’activation
 transforme ce total en
 .
La sortie du réseau est ensuite une combinaison linéaire des neurones cachés :
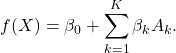
Le biais n’est qu’un neurone supplémentaire de valeur constante 1, dont le poids décale la fonction d’activation, un peu comme l’ordonnée à l’origine décale une droite. Pour une couche entière, on trouve aussi l’écriture matricielle  : même calcul, rangé dans une grille de poids
 .
💡 Intuition Imagine un jury : chaque entrée est un indice, son poids dit combien il compte, et l’activation décide si le total suffit pour « s’allumer ». Entraîner le réseau, c’est apprendre à pondérer les indices.
Pourquoi empiler ne suffit pas : la cassure de la linéarité
On pourrait croire qu’il suffit d’ajouter des couches pour gagner en puissance. Or multiplier un vecteur par deux matrices revient à le multiplier par leur produit. Une suite de couches purement linéaires s’effondre donc en une seule couche dont la matrice est le produit de toutes les autres.
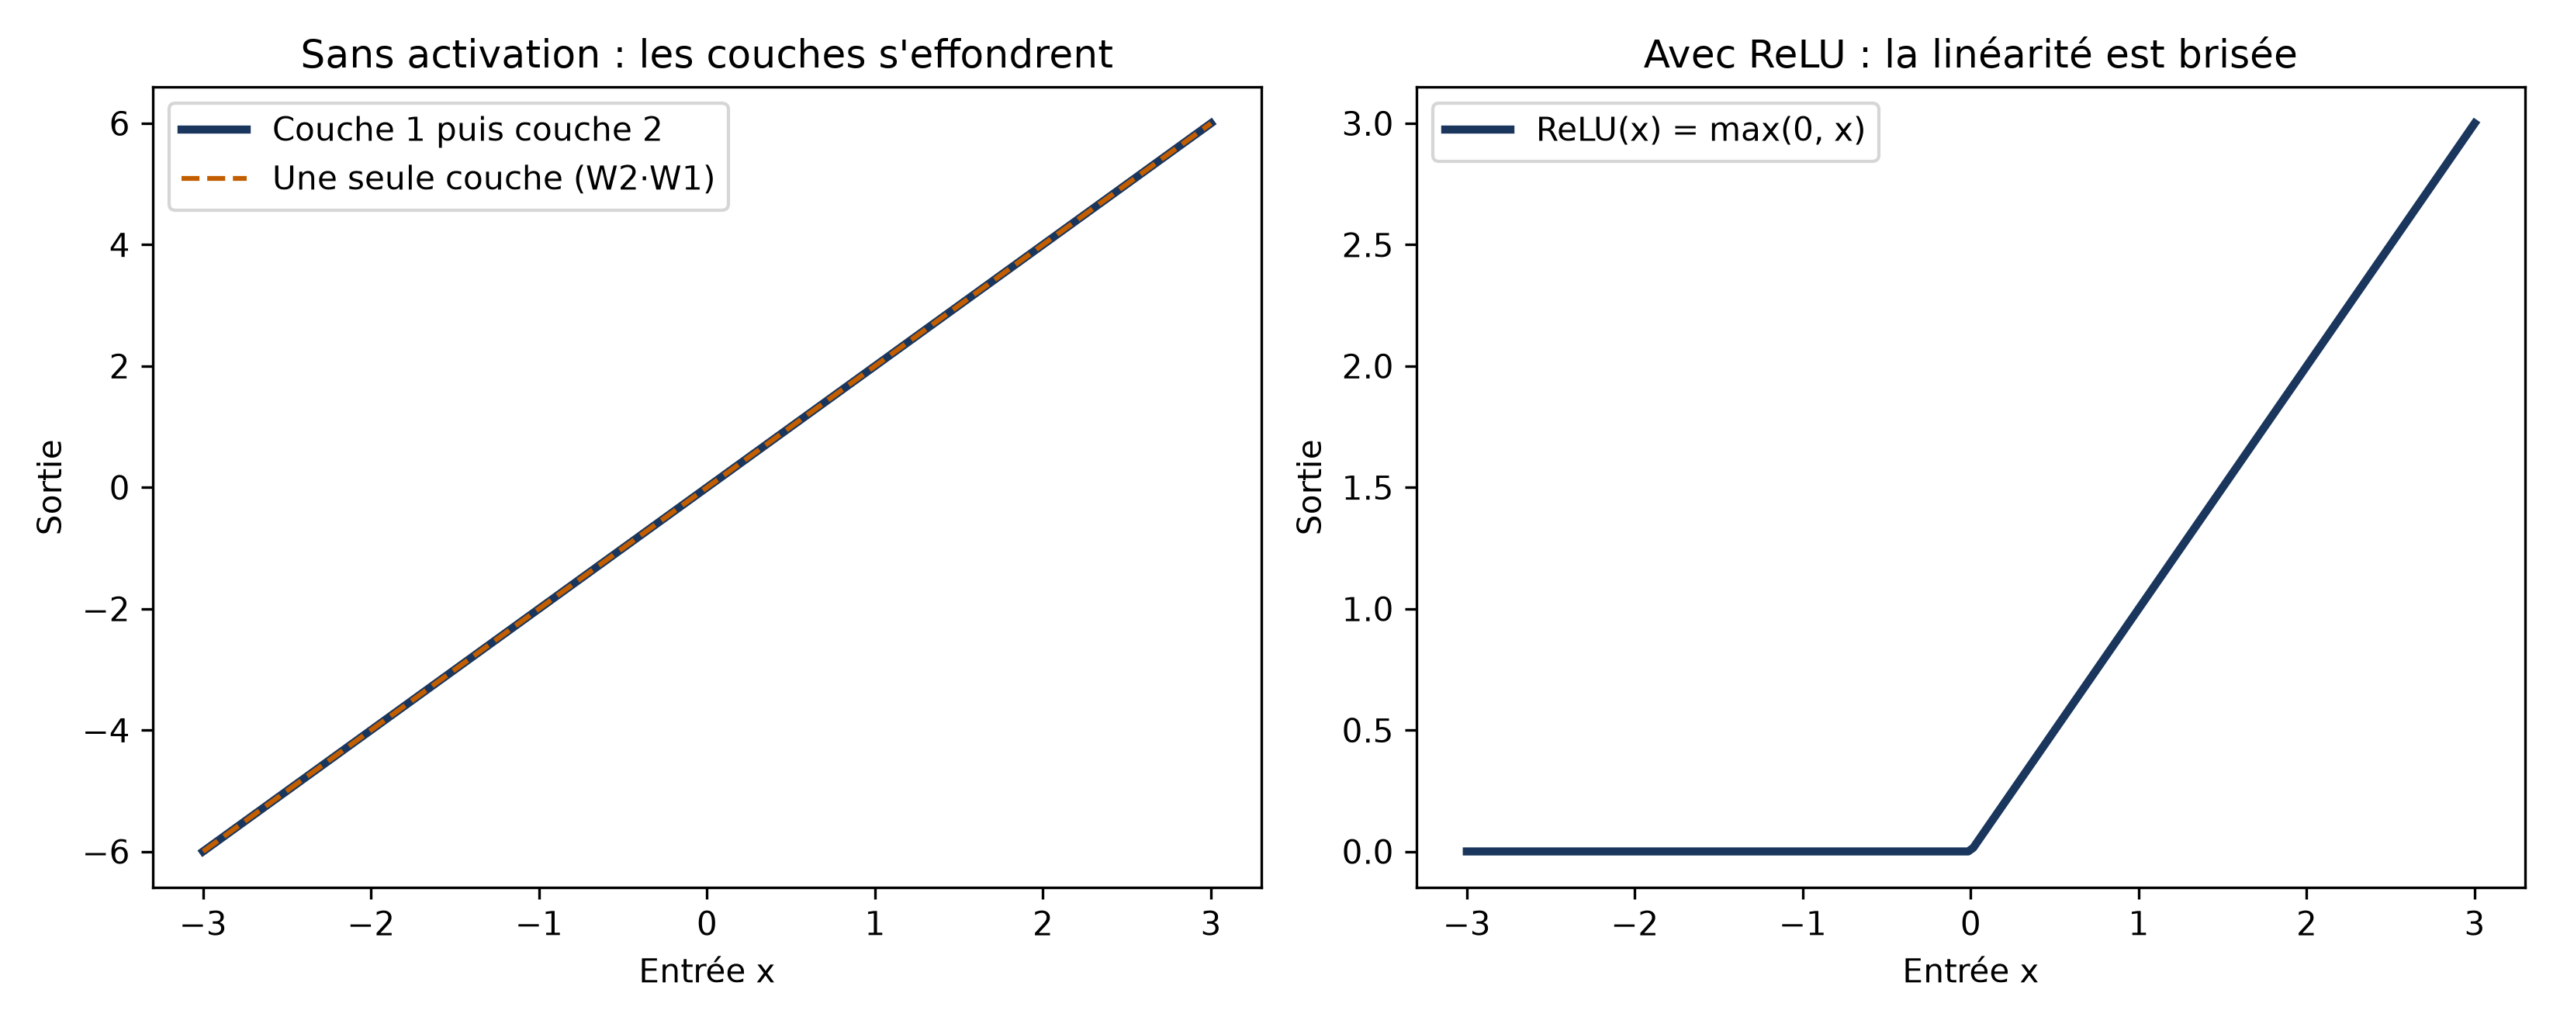
⚠️ Piège Sans fonction d’activation non linéaire, un réseau, aussi profond soit-il, se réduit mathématiquement à un simple modèle linéaire en les entrées d’origine.
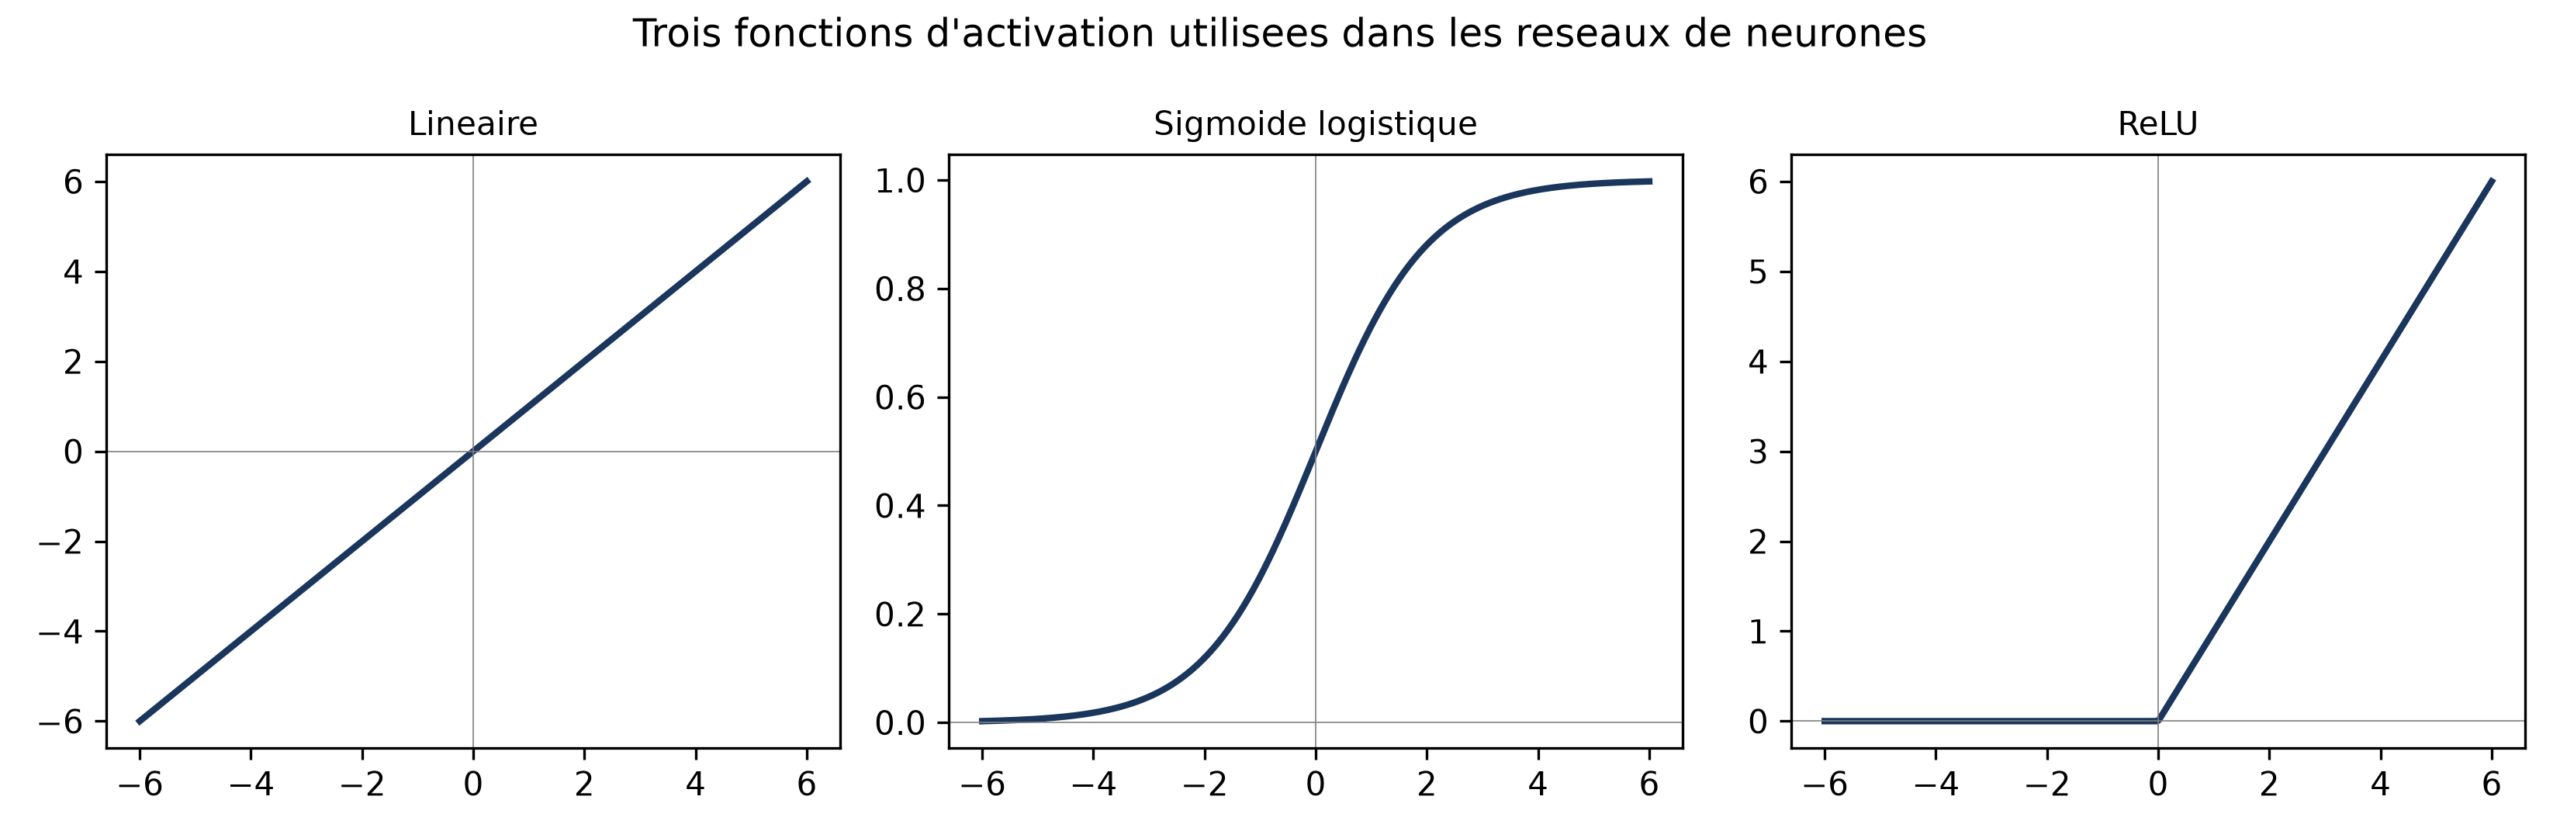
La fonction d’activation doit donc être non linéaire, et (presque partout) dérivable pour permettre la rétropropagation. La plus courante aujourd’hui est la ReLU :  si
 , et
 sinon. Elle est bien moins coûteuse à calculer que l’ancienne favorite, la sigmoïde.
Elle a aussi débloqué la profondeur. La sigmoïde et la tangente hyperbolique saturent pour de grandes valeurs d’entrée : leur courbe s’aplatit et leur dérivée devient quasi nulle. Propagée à travers de nombreuses couches, cette dérivée éteint le signal d’erreur : c’est le problème du gradient qui s’évanouit. La ReLU garde un gradient égal à 0 ou à 1 et transmet un signal utile même à travers beaucoup de couches.
Comment les poids se règlent tout seuls
Reste la vraie question : d’où viennent les poids ? On part de poids quelconques, on mesure l’écart entre la sortie du réseau et la valeur attendue avec une fonction de perte (l’erreur quadratique pour prédire un nombre, l’entropie croisée pour classer), puis on corrige les poids dans la direction qui fait baisser cette perte le plus vite. C’est la descente de gradient.
Le gradient de la perte par rapport à chaque poids se calcule avec la rétropropagation, couche après couche, en partant de la sortie. En pratique, on met les poids à jour à partir de petits sous-échantillons des données, des lots, plutôt que de l’ensemble complet à chaque étape. Cela accélère considérablement l’entraînement de très grands réseaux.
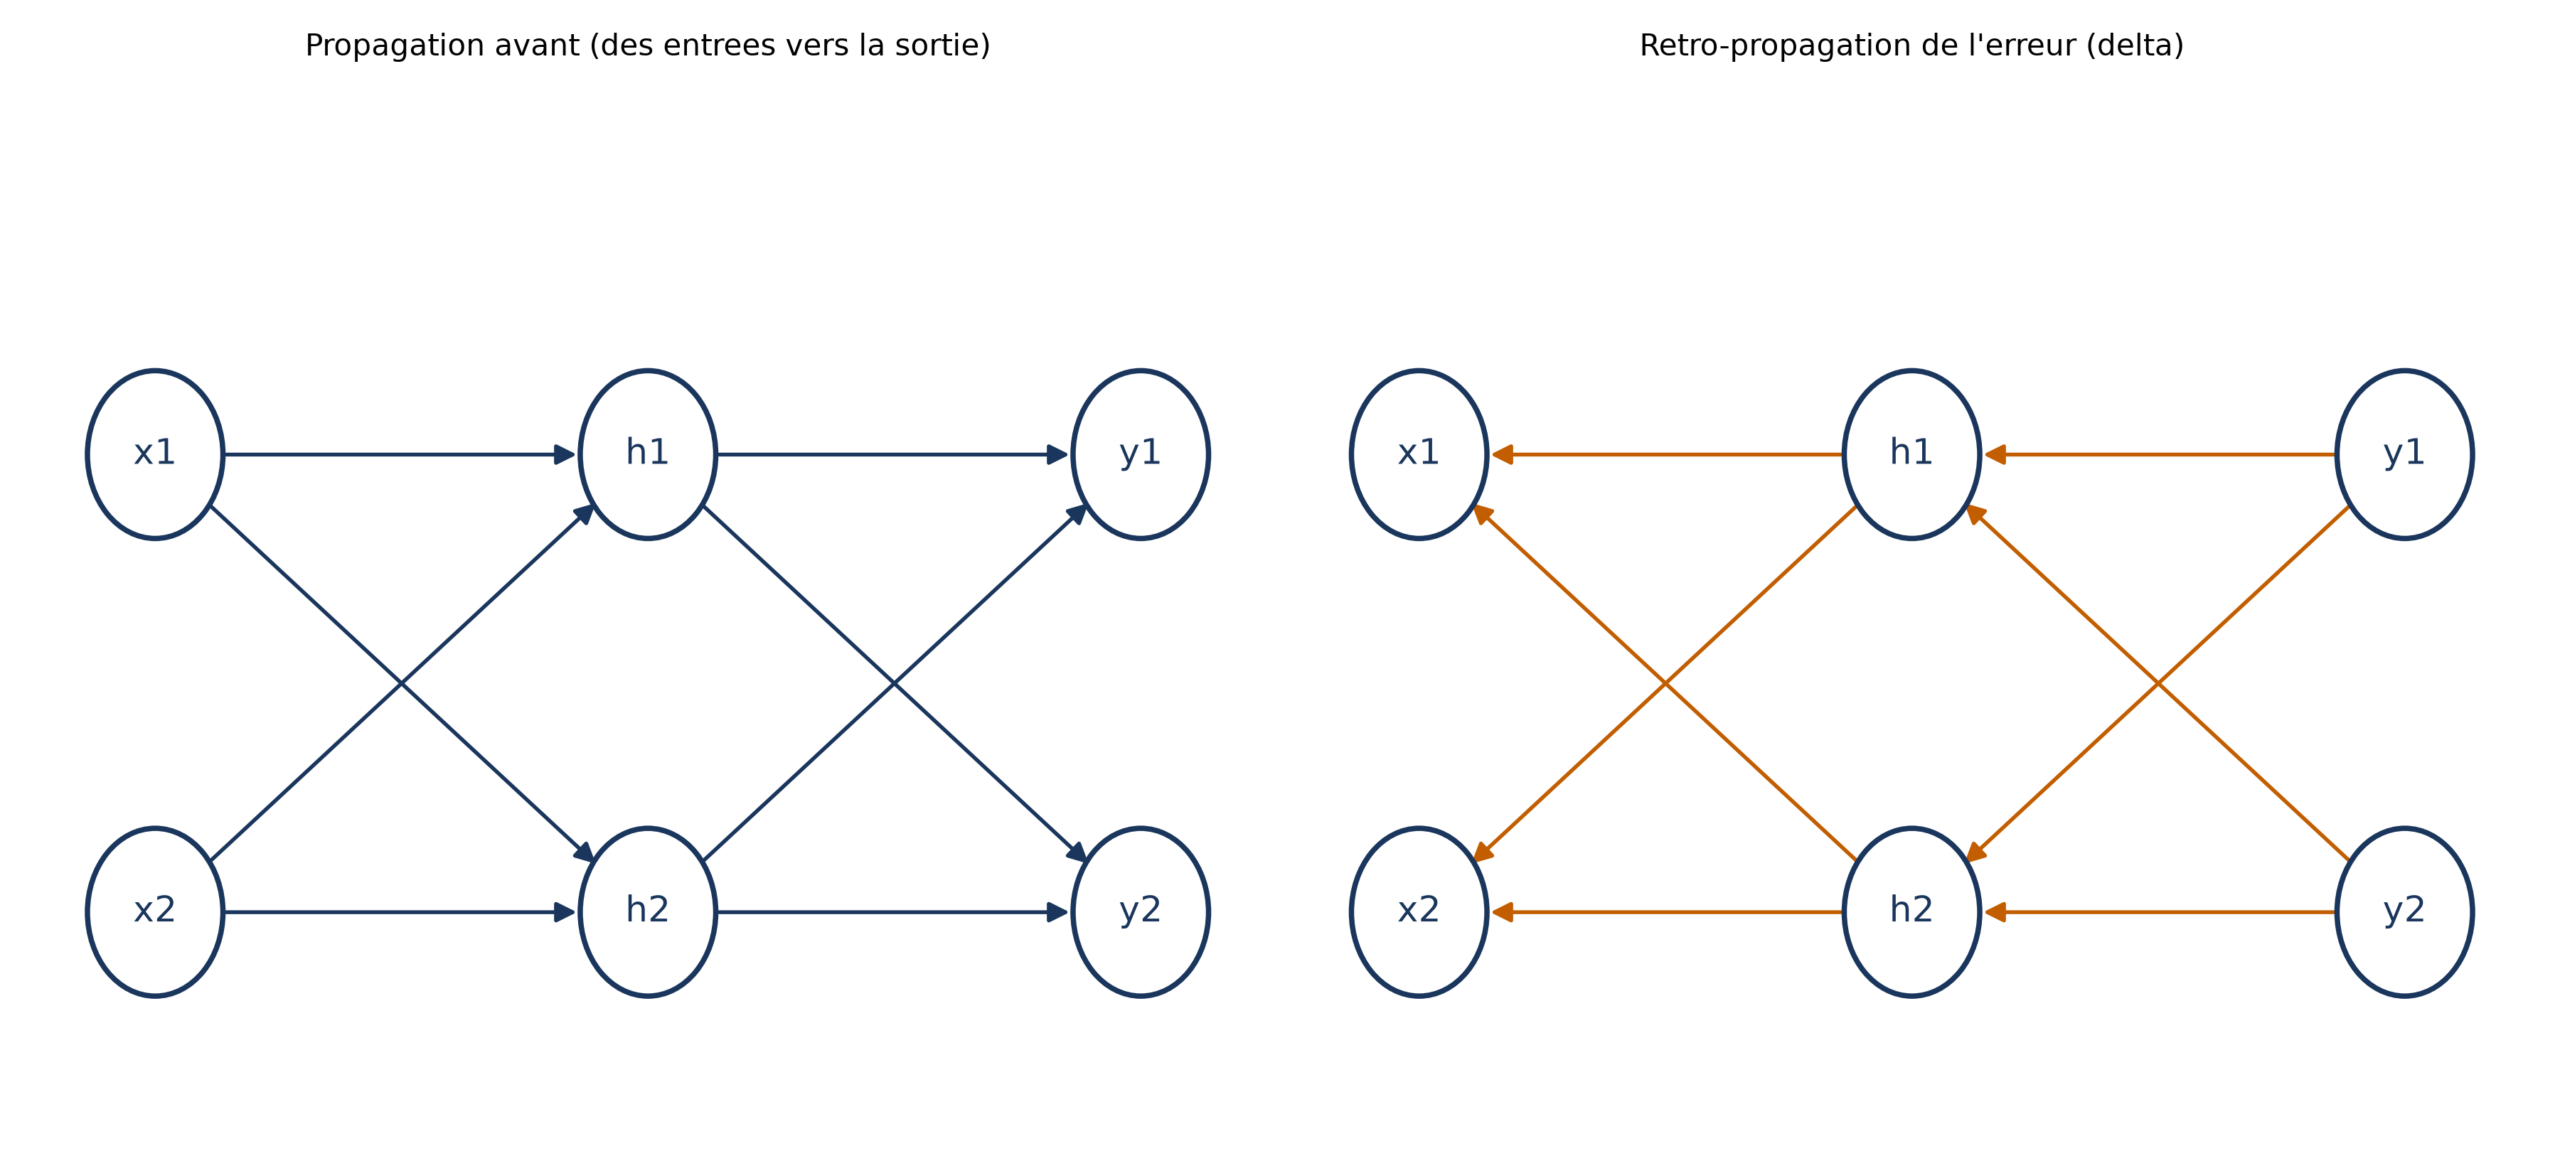
Au cœur de ce chemin inverse se trouve la règle delta. Notons  l’erreur locale attribuée à un neurone,
 son entrée pondérée et
 la dérivée de l’activation :
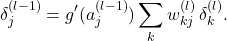
Elle se lit ainsi : l’erreur d’un neurone de la couche  est la combinaison pondérée des erreurs de la couche suivante, multipliée par la pente de l’activation. Appliquée couche après couche depuis la sortie, elle redistribue l’erreur vers l’arrière jusqu’aux poids de la première couche.
Un tour d’entraînement se résume donc en trois temps : propager les entrées vers l’avant pour obtenir sorties et erreur, calculer les de la sortie puis les faire remonter, enfin mettre à jour tous les poids. Une seule itération réduit déjà sensiblement l’erreur d’un petit réseau, mais un entraînement réaliste en demande typiquement des milliers.
Ce que ça donne en code
Comment dire tout cela à une bibliothèque ? Voici un petit réseau qui prédit une valeur numérique, écrit avec Keras. Les mentions In [n]: sont les numéros des cellules d’un notebook : ce qui suit est la commande saisie.
In [24]: model = keras.Sequential([
             layers.Dense(64, activation='relu'),
             layers.Dropout(0.4),
             layers.Dense(1)])
layers.Dense(64, activation='relu') crée une couche pleinement connectée de 64 neurones à activation ReLU. layers.Dropout(0.4) désactive 40 % des neurones de cette couche, au hasard, à chaque étape d’entraînement. La dernière couche n’a qu’un neurone, sans activation : elle produit la prédiction finale.
Il reste à choisir la façon d’apprendre, puis à lancer l’entraînement sur des données d’entraînement (X_train, Y_train) et de validation (X_valid, Y_valid) :
In [25]: model.compile(optimizer=RMSprop(),
                         loss='mse',
                         metrics=[metrics.RootMeanSquaredError()])

In [26]: history = model.fit(X_train,
                               Y_train,
                               epochs=1500,
                               batch_size=32,
                               validation_data=(X_valid, Y_valid))
compile fixe la variante de descente de gradient (RMSprop, adaptative), la perte (l’erreur quadratique moyenne) et les métriques à suivre. fit lance l’entraînement : lots de 32 exemples, 1500 passes sur les données, avec un jeu de validation qui permet de surveiller le surajustement au fil de la descente.
Ce que les couches finissent par savoir voir
Pourquoi un tel empilement marche-t-il si bien ? Parce que chaque couche travaille sur ce que la précédente a produit. Prends un réseau qui doit identifier ce que montre une photo : ses toutes premières couches repèrent le plus souvent des contours et des textures élémentaires, tandis que les couches situées plus loin assemblent ces indices en formes, puis en objets complets.
Ces sorties intermédiaires s’appellent des états cachés : une représentation interne des données, dont une caractéristique clé est la dimensionnalité, c’est-à-dire la taille des vecteurs employés.
💡 Intuition Du contour à la forme, de la forme à l’objet : chaque couche reformule l’image dans un langage un peu plus abstrait que la précédente. Le réseau invente lui-même ce vocabulaire intermédiaire pendant l’entraînement.
C’est ce qui le distingue des méthodes plus anciennes. Pour classer un texte, on fabriquait d’abord une représentation, puis on la donnait à un classifieur bayésien naïf ou à une régression logistique. Le succès des réseaux de neurones a rendu ces algorithmes largement obsolètes sur ce terrain. Là où les méthodes précédentes peinaient à extraire, seules, une structure assez riche des données brutes, un réseau profond la construit couche après couche.
Un avis de film, du texte brut au verdict
Revenons à nos avis de films. Sous sa forme naturelle, le langage est incompréhensible pour une machine, qui ne manipule que des nombres. Le texte devient donc numérique par paliers : one-hot, sac de mots, TF-IDF, puis embeddings denses qui encodent la proximité de sens.
Le jeu de données compte 50 000 avis, positifs et négatifs, de longueurs très hétérogènes, avec en moyenne 230 mots. Sans surprise, les mots les plus fréquents sont movie et film.
| Étape | Ce qui se passe |
|---|---|
| Entrée | un avis en texte brut, transformé en vecteurs numériques |
| Couche d’embedding | chaque mot devient un vecteur de dimension 300 |
| Trois couches récurrentes (GRU) | l’avis est lu mot après mot, avec un état caché de 256 unités |
| Sortie | un verdict à deux issues, positif ou négatif |
Deux catégories seulement : on choisit donc l’entropie croisée binaire, l’optimiseur Adam, et un entraînement par lots puisque l’on dispose de milliers d’avis.
On suit l’apprentissage sur des courbes d’exactitude et de perte, tracées pour l’entraînement et pour la validation. Le modèle atteint une bonne exactitude, que la matrice de confusion confirme sur le jeu de test. Mieux : en comparant la carte des avis dessinée avant et après l’apprentissage, on constate que la représentation s’est rangée par sentiment, les avis favorables d’un côté et les défavorables de l’autre. La démarche se transpose à n’importe quel autre jeu de données.
Une même famille, des formes différentes selon les données
Le réseau « tout connecté » vu jusqu’ici n’est qu’une forme parmi d’autres. L’architecture s’adapte à la structure des données.
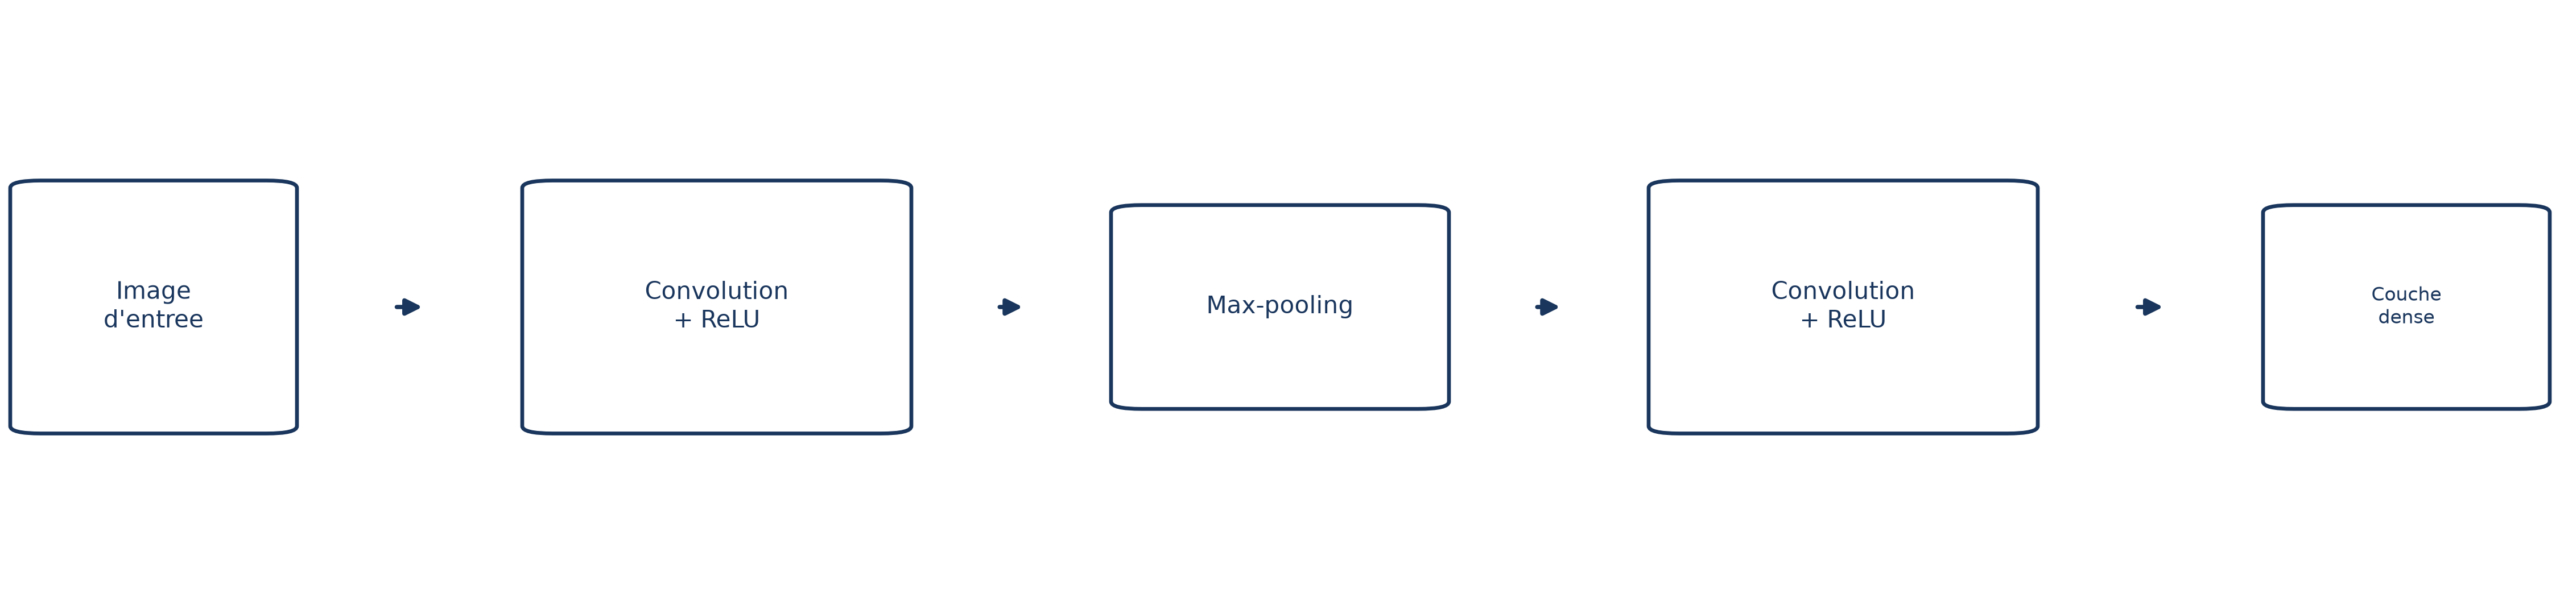
Les images : réseaux convolutifs. Ici, on ne relie pas chaque pixel à chaque neurone : une couche de convolution promène un petit filtre sur toute l’image. En chaque point, elle note si le motif qu’elle cherche s’y trouve, et l’ensemble de ces notes forme une carte d’activation. Vient ensuite le pooling, qui résume chaque petite zone par sa valeur maximale : le réseau tolère mieux qu’un motif se décale un peu, et les couches suivantes coûtent moins cher.
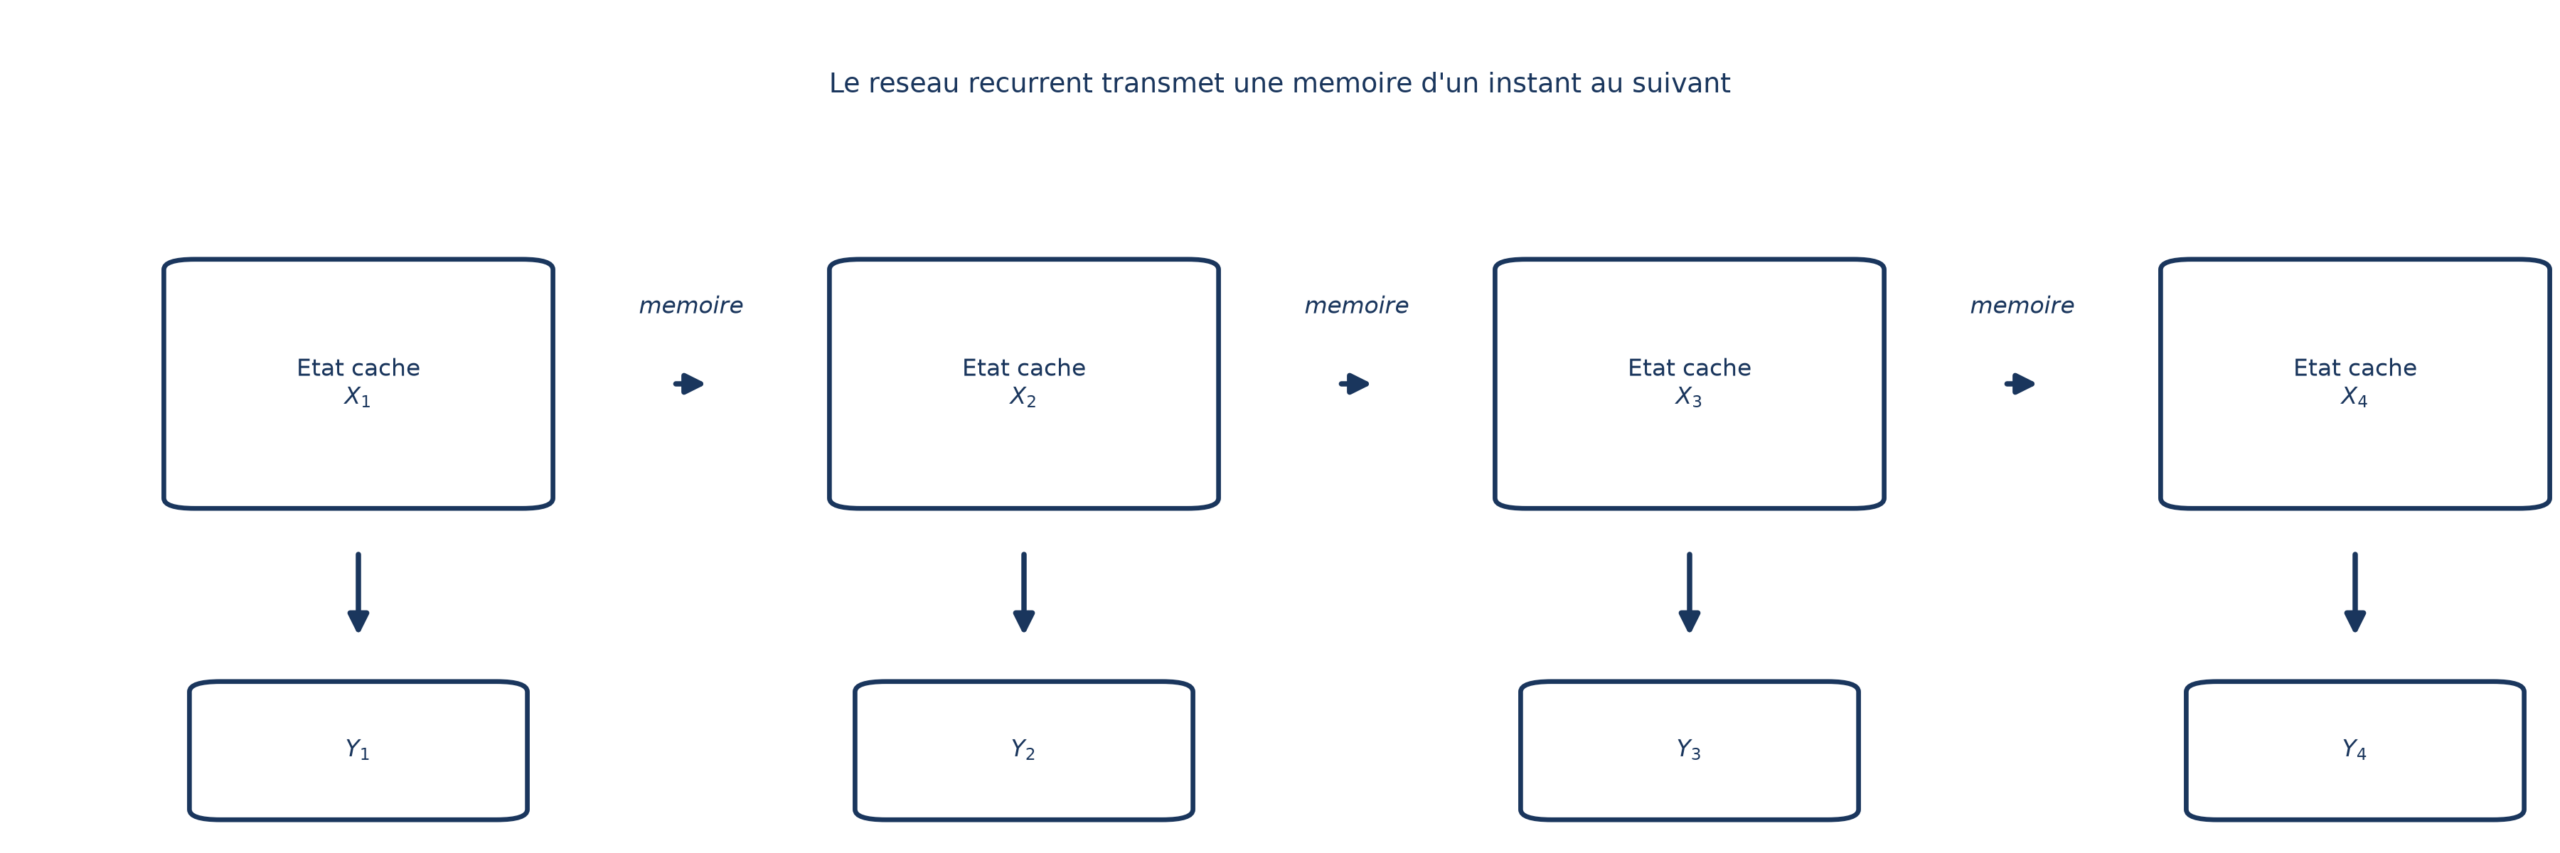
Les séquences : réseaux récurrents. Dans un texte, une série temporelle ou un signal audio, l’ordre compte et la longueur varie. À chaque pas de temps, le réseau reçoit la nouvelle entrée et un état caché, une mémoire qui résume ce qu’il a vu jusque-là. Comme les mêmes poids sont réutilisés à chaque pas, le nombre de paramètres reste fixe, que la séquence compte dix éléments ou dix mille.
Les séquences encore, avec l’attention : le Transformer. Les réseaux récurrents sont lents, séquentiels, et ils oublient. Un travail publié en 2017 sous le titre « Attention Is All You Need » y répond avec le transformeur : au lieu de transmettre une mémoire pas à pas, son mécanisme d’attention apprend directement comment les parties d’une séquence se répondent. Il sert de socle à l’IA générative, du texte jusqu’à la voix et à la génération d’images.
À quoi un modèle profond sert concrètement
Les réseaux de neurones ont largement révolutionné la reconnaissance d’image et la traduction automatique, deux domaines où les méthodes antérieures peinaient à extraire une structure assez riche des données brutes.
Les réseaux récurrents classent des documents (prédire le sentiment d’une critique, par exemple), et on les retrouve en traduction, en reconnaissance vocale ou en prévision de séries temporelles financières ou climatiques.
Les grands modèles de langage, eux, résument de longs documents, manipulent des données non structurées comme des courriels ou des journaux, écrivent du code et des tests unitaires, et analysent des images, des sons ou des vidéos. Un modèle préentraîné de haute qualité est aujourd’hui accessible par un simple appel à un service hébergé, sans entraînement ni hébergement de ta part.
D’où vient son succès : une vieille idée devenue praticable
L’histoire commence dans les années 1950, avec des perceptrons réalisés en matériel pour classer en deux catégories. Les décennies suivantes les ont d’abord abandonnés, puis réinventés grâce à la rétropropagation, qui a permis le perceptron multicouche.
Le premier engouement date des années 1980. La popularité a explosé récemment grâce à deux moteurs : le calcul massivement parallèle des processeurs graphiques (GPU) et la disponibilité de très grands jeux de données. Le tournant se situe en 2012 : AlexNet est le premier réseau à tenir ses promesses hors du laboratoire, et il révèle au passage ce que valent les GPU pour l’apprentissage profond.
Côté outils, les bibliothèques d’apprentissage profond servent aussi bien à l’entraînement qu’à l’inférence. PyTorch s’est imposé comme leader clair ; TensorFlow, soutenu par Google, était très présent dans les années 2010 mais est passé de mode, et JAX est un projet de recherche à l’interface plus simple. PyTorch calcule automatiquement les gradients de toute fonction dérivable grâce à son module autograd : on décrit le calcul, et l’on obtient le gradient nécessaire à l’entraînement.
Trois idées reçues à ranger
« Avec autant de paramètres, il surajuste forcément »
Un réseau profond compte des milliers, parfois des millions de paramètres : il semble condamné au surajustement total. Deux mécanismes de régularisation y remédient. Les pénalités ridge ou lasso s’appliquent telles quelles aux poids du réseau. Le dropout, plus spécifique, désactive aléatoirement une fraction des neurones cachés à chaque étape : le réseau ne peut plus dépendre excessivement d’un neurone particulier. C’est exactement ce que fait la ligne Dropout(0.4) de l’exemple Keras.
« C’est une boîte noire que personne ne comprend »
Un réseau profond est bien nettement plus difficile à interpréter qu’un modèle plus simple, comme une régression linéaire. Mais la recherche ne baisse pas les bras : on distingue l’interprétabilité comportementale (relier entrées et sorties), attributionnelle (suivre, grâce au gradient, la contribution de chaque composante de l’entrée), par concepts (des sondes lisent les représentations apprises) et mécaniste (une analyse fine des composants et de leur organisation).
Pour les très grands modèles, l’enjeu est réel : leurs capacités ne sont pas conçues a priori, elles viennent de la mise à l’échelle, et reconstituer comment elles apparaissent reste difficile.
« S’il répond avec assurance, c’est qu’il sait »
Un grand modèle de langage ne détient pas de faits comme un humain en détient : à chaque étape, il choisit le token le plus probable d’après son entraînement. Résultat : une réponse inventée, vraisemblable mais fausse, peut sortir sur le même ton assuré qu’une réponse exacte. Ses données d’entraînement reflètent aussi les biais des textes humains dont elles sont extraites, et son savoir s’arrête à la date où elles ont été figées.
📌 À retenir Un modèle profond, c’est des couches de neurones séparées par des activations non linéaires, dont une procédure d’optimisation règle les poids jusqu’à ce que les représentations intermédiaires servent la tâche visée.