Envoie à un assistant la photo d’une pizza, puis demande-lui : « peux-tu me dire quelle sorte de pizza tu vois ? ». Il répond : une pizza au pepperoni, posée sur une table en bois. Aucun mot de ta question ne contenait cette réponse : elle vient de l’image. Ce tour de passe-passe a un nom, et il repose sur un montage plus subtil qu’il n’y paraît. À la fin de cette lecture, tu sauras le décrire, comprendre comment on l’entraîne, et écarter trois idées reçues qui le concernent.
Sommaire
- L’essentiel en 30 secondes
- Une image et une question : ce que fait un VLM
- Un exemple pas à pas : la pizza
- Trois façons de faire voir un modèle de langage
- Comment on l’entraîne : relier d’abord, dialoguer ensuite
- Trois idées reçues à écarter
- Où il se place : un maillon d’un système
L’essentiel en 30 secondes
- Le modèle prend image et question en entrée, texte en sortie, et répond à ce qu’il voit.
- Il ne regarde pas l’image directement : un encodeur de vision traduit l’image en jetons que le modèle de langage lit ensuite.
- Son entraînement se fait en deux temps : relier image et légende, puis dialoguer.
- Il lit des images, il ne les crée pas : la génération d’images relève d’une autre famille de modèles.
- Ses limites sont concrètes : une vidéo coûte cher en jetons, et la lecture de texte reste en deçà d’un OCR dédié.
Une image et une question : ce que fait un VLM
Un modèle vision-langage (VLM, pour vision-language model) accepte une ou plusieurs images, ou une vidéo, accompagnées d’un prompt écrit, et génère une réponse en texte. Le mot « vision » désigne ce qui entre, le mot « langage » ce qui sort.
Dans la pratique, il sert à répondre à une question sur une photo, à décrire ce qu’elle montre, à lire un texte qui y figure ou à poursuivre un échange à son sujet. Il peut aussi enchaîner plusieurs questions sur la même image.
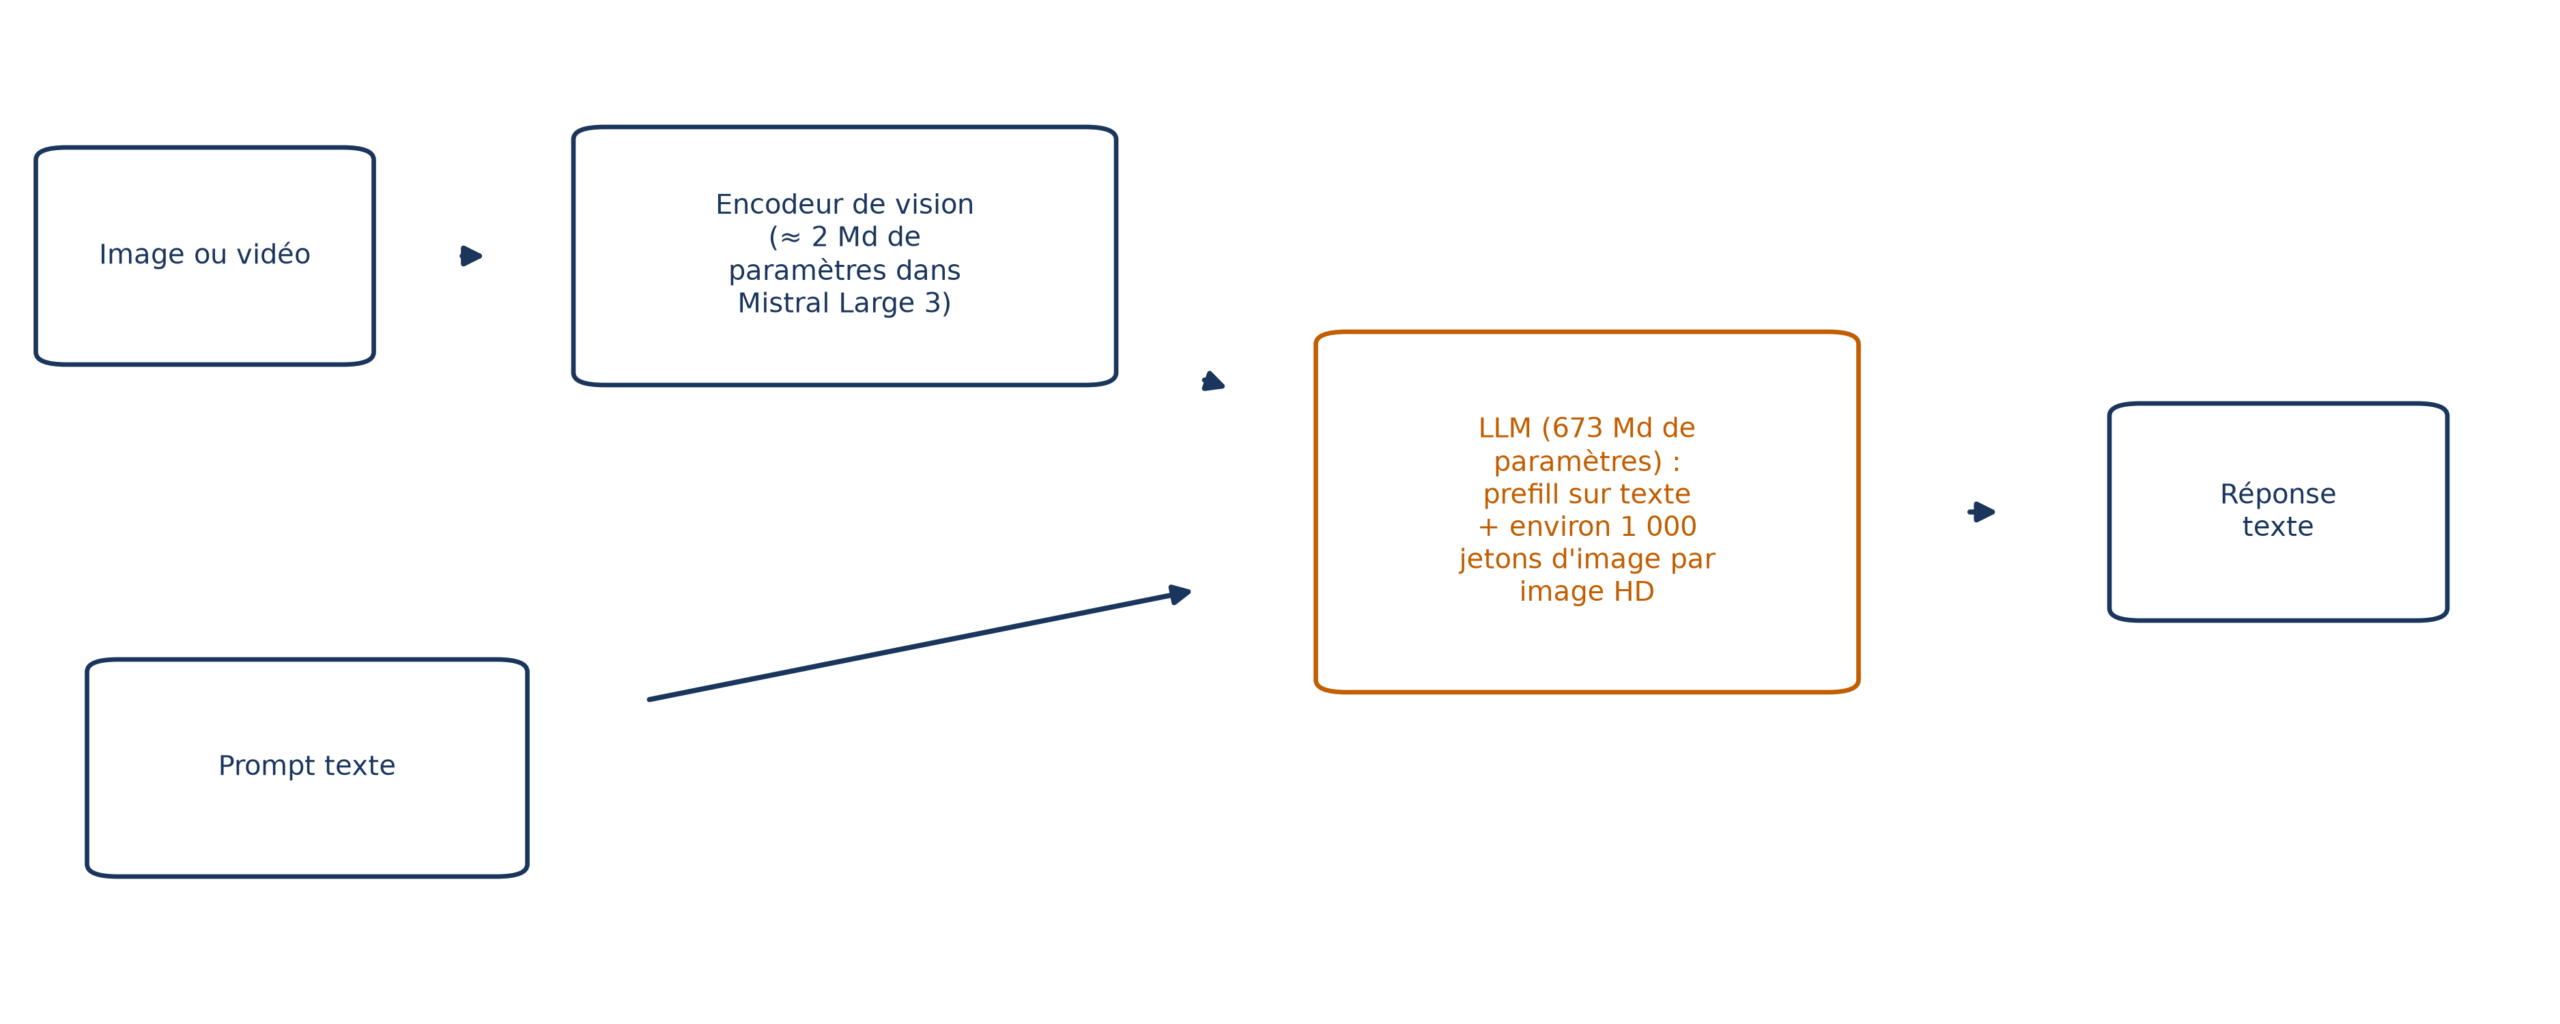
Le schéma ci-dessous montre le trajet complet. Suis la flèche qui part de l’encodeur de vision vers le LLM : c’est le seul endroit où l’image entre dans le modèle de langage. Tout le reste travaille ensuite sur des jetons, qu’ils viennent de ta question écrite ou de l’image.
Un exemple pas à pas : la pizza
Revenons à la photo de pizza. Dans la démonstration d’où vient cet exemple, la photo ne passe pas dans un seul modèle. Elle traverse une suite d’étapes, chacune confiée à un spécialiste.
- Un modèle image-vers-texte, ViT-GPT2, produit une légende en anglais : un Vision Transformer encode l’image, et GPT-2 rédige la phrase.
- Un détecteur d’objets, DETR, repère ce qui est présent : ici une pizza et une table à manger.
- Un modèle vision-et-langage, ViLT, répond à la question « quelle sorte de pizza ? » : pepperoni.
- Le LLM compare les trois réponses. Comme elles concordent, il répond avec assurance.
Le LLM ne reconnaît donc rien lui-même : il arbitre entre des spécialistes concordants. Dans cette démonstration, le modèle de langage sert de chef d’orchestre, et la vision reste confiée à des modèles dédiés.
Trois façons de faire voir un modèle de langage
Le problème est de choisir le canal par lequel l’image parvient au modèle. Trois solutions ont été essayées.
-
La première est la légende : un autre modèle décrit l’image, et la description est glissée dans le prompt. Elle est simple, car elle réutilise des modèles existants, mais la légende fait perdre de l’information et ne rend pas la complexité de ce qui est vu.
-
La deuxième consiste à plonger les images dans le même espace latent que les jetons de texte : PaLM-E les fait passer par les blocs du modèle traitées comme des entrées textuelles, puis ajuste l’ensemble pour relier les modalités.
-
La troisième, celle de BLIP-2, garde deux modèles déjà entraînés, laisse leurs poids gelés, et n’entraîne qu’un petit module entre deux modèles gelés. Le gain est un entraînement bien plus léger, et l’absence d’oubli catastrophique : le modèle ne perd pas ce qu’il savait faire, puisque le LLM n’a jamais été aligné sur la vision.
💡 Intuition La légende revient à décrire un paysage à quelqu’un au téléphone : l’essentiel passe, les nuances se perdent en route.
Les trois voies visent le même but : que le modèle de langage ait accès à l’image sous une forme qu’il exploite. Elles diffèrent surtout par le coût d’entraînement et par ce qui se perd en chemin.
Comment on l’entraîne : relier d’abord, dialoguer ensuite
Un VLM n’apprend pas à voir et à parler d’un seul coup. Dans la recette de BLIP-2, l’entraînement se fait en deux étapes. Le pont associe d’abord image et légende, à partir de paires image-légende.
La seconde étape transmet au LLM les représentations apprises, présentées comme un texte d’instructions : c’est ce qu’on appelle un soft prompt. Conditionné de la sorte, le modèle de langage produit du texte à propos d’images, et l’on peut ensuite lui poser plusieurs questions à la suite.
Il existe enfin un troisième type de données, l’affinage de vision, qui s’appuie sur des paires image-étiquette pour améliorer la compréhension multimodale.
📌 À retenir Un VLM apprend deux choses séparées : à associer une image à des mots, puis à utiliser ces mots pour répondre.
Trois idées reçues à écarter
Ces modèles attirent des contresens tenaces. Voici les trois qui reviennent le plus souvent.
Non, il ne fabrique pas d’images
Sa sortie est du texte, et rien d’autre. Les modèles qui fabriquent des images suivent un autre archétype : ils partent d’un bruit aléatoire et le raffinent étape après étape. Les modèles dits « omni », qui acceptent plusieurs types d’entrées et en produisent plusieurs, forment une catégorie à part, qui ne se confond pas avec la définition d’un VLM.
Non, il lit moins bien qu’un OCR dédié
Beaucoup de VLM savent reconnaître un texte dans une image, mais cette capacité intégrée reste en deçà des modèles d’OCR spécialisés, souvent d’une fraction de leur taille. Si ta tâche consiste uniquement à lire du texte, un modèle dédié est généralement plus rapide et plus précis.
⚠️ Piège Un VLM qui lit bien quelques panneaux n’est pas pour autant un OCR : sur des volumes importants, mesure les deux avant de choisir.
Non, une vidéo n’est pas juste beaucoup d’images
Une vidéo ne se réduit pas à la somme de ses images : c’est le mouvement qui relie les images, et il disparaît si on les regarde une à une. Les VLM sont donc entraînés sur des clips vidéo pour cette dimension temporelle.
Le coût, lui, explose. Une seconde de vidéo cinématographique compte 24 images ; un clip de quatre secondes, si l’on gardait chacune d’elles, atteindrait près de 100 000 jetons. Le sous-échantillonnage est presque obligatoire, en réduisant la résolution et la cadence. Enfin, beaucoup de VLM ne traitent pas l’audio : il faut le transcrire à part et l’ajouter au prompt.
Où il se place : un maillon d’un système
Un VLM s’insère volontiers dans un système plutôt qu’il ne le remplace. Imagine un PDF qui contient des tableaux et des graphiques : on peut retrouver le passage voulu, puis les graphiques qui l’accompagnent, et le modèle s’appuie sur texte et graphiques dans la même réponse. Pour changer de modèle dans un tel système, il suffit de remplacer le modèle d’embedding.
Ce confort a un prix : les modèles multimodaux coûtent plus cher que les LLM textuels. Pour un usage purement langagier, un modèle textuel reste plus simple et plus rapide. Le bon réflexe consiste donc à se demander si l’image est vraiment nécessaire.
⚠️ Piège Un VLM généraliste répond à tout, mais répondre à tout n’est pas répondre le mieux : pour une tâche précise, compare-le à un modèle spécialisé. Ces derniers sont souvent plus rapides et plus précis dans leur domaine.
📌 À retenir Un VLM répond à partir d’une traduction de l’image en jetons : c’est ce qui le rend polyvalent, et ce qui fixe ses limites.