Un modèle de crédit regarde un client au solde de 1 000 $ et répond : « 0,6 % de probabilité de défaut ». Si ce client fait défaut malgré tout, comment noter cette réponse ? La perte d’entropie croisée binaire répond à cette question, et PyTorch la range sous le nom BCELoss.
Sommaire
- L’essentiel en 30 secondes
- Une réponse à deux issues : d’où vient la formule
- Ce que la perte punit : la confiance fausse
- Un client à 0,6 % de risque : deux pertes très différentes
- Pourquoi ne pas garder l’erreur quadratique
- Où la perte se branche dans PyTorch
L’essentiel en 30 secondes
- Pour une réponse à deux issues, la perte compare une probabilité prédite p à une étiquette y valant 0 ou 1.
- Sa formule est la vraisemblance de Bernoulli passée au logarithme, changée de signe.
- Elle punit fortement une confiance fausse : une probabilité proche de 0 pour une issue qui arrive fait exploser la perte.
- La correction des coefficients se réduit à l’écart entre probabilité prédite et étiquette.
- Dans PyTorch, elle s’écrit
nn.BCELoss()et reçoit une sortie passée par une sigmoïde, qui ramène tout entre 0 et 1.
Une réponse à deux issues : d’où vient la formule
La réponse suit une loi de Bernoulli : deux issues possibles, 0 ou 1, et le modèle produit une probabilité p(X) de l’issue 1 . Pour que p reste entre 0 et 1, on la fabrique avec la sigmoïde :
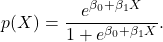
Pour une observation, la probabilité donnée à ce qui s’est réellement passé vaut p si l’étiquette est y = 1, et 1 − p si y = 0. Une seule écriture couvre les deux cas :  . Quand y vaut 1, le second facteur disparaît ; quand il vaut 0, c’est le premier qui disparaît.
On prend ensuite le logarithme de cette quantité et on la change de signe : l’entropie croisée binaire est la valeur à rendre petite. Pour une observation, elle vaut :
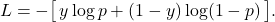
Ce que la perte punit : la confiance fausse
Regarde les deux termes séparément. Si y = 1, seul le terme  compte. Quand p vaut presque 1, le logarithme est presque nul et la perte aussi : le modèle a bien deviné. Quand p tombe vers 0, le logarithme plonge et la perte grimpe sans borne. Le second terme joue le même rôle pour y = 0, avec
 à la place de p.
Ce principe rappelle celui de l’entropie croisée des modèles de langage, où la perte se réduit à la probabilité du mot réellement observé . Ici, à deux issues, c’est la probabilité de l’issue réellement arrivée qui est jugée.
⚠️ Piège La perte ne compte pas les bonnes réponses : elle mesure la probabilité donnée à la bonne réponse. Deux modèles qui tranchent pareil peuvent avoir des pertes très différentes.
Cette perte sert aussi à corriger le modèle. Pour la régression logistique, la dérivée de la perte par rapport à un coefficient prend une forme très simple : l’écart entre la probabilité prédite et l’étiquette, multiplié par la valeur de la variable concernée.
Un client à 0,6 % de risque : deux pertes très différentes
Reprenons les données de défaut de carte de crédit. Un solde de 1 000 $ donne une probabilité de défaut de 0,6 %, un solde de 2 000 $ en donne 58,6 %. Prenons le client au solde de 1 000 $, avec p = 0,006 . Le log désigne ici le logarithme népérien.
Deux issues sont possibles :
- s’il n’a pas fait défaut (y = 0), la perte vaut
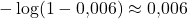 : presque rien ;
- s’il a fait défaut (y = 1), elle vaut
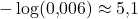 : une perte bien plus lourde.
Le modèle annonce la même probabilité dans les deux cas. La même probabilité, deux pertes, parce que la note dépend de ce qui est arrivé, pas seulement de la probabilité annoncée.
Pourquoi ne pas garder l’erreur quadratique
On pourrait croire que l’erreur quadratique, celle qui sert à prédire un nombre, ferait aussi bien. Elle est faite pour mesurer un écart entre deux valeurs numériques : c’est le choix naturel en régression, alors que l’entropie croisée est celui de la classification .
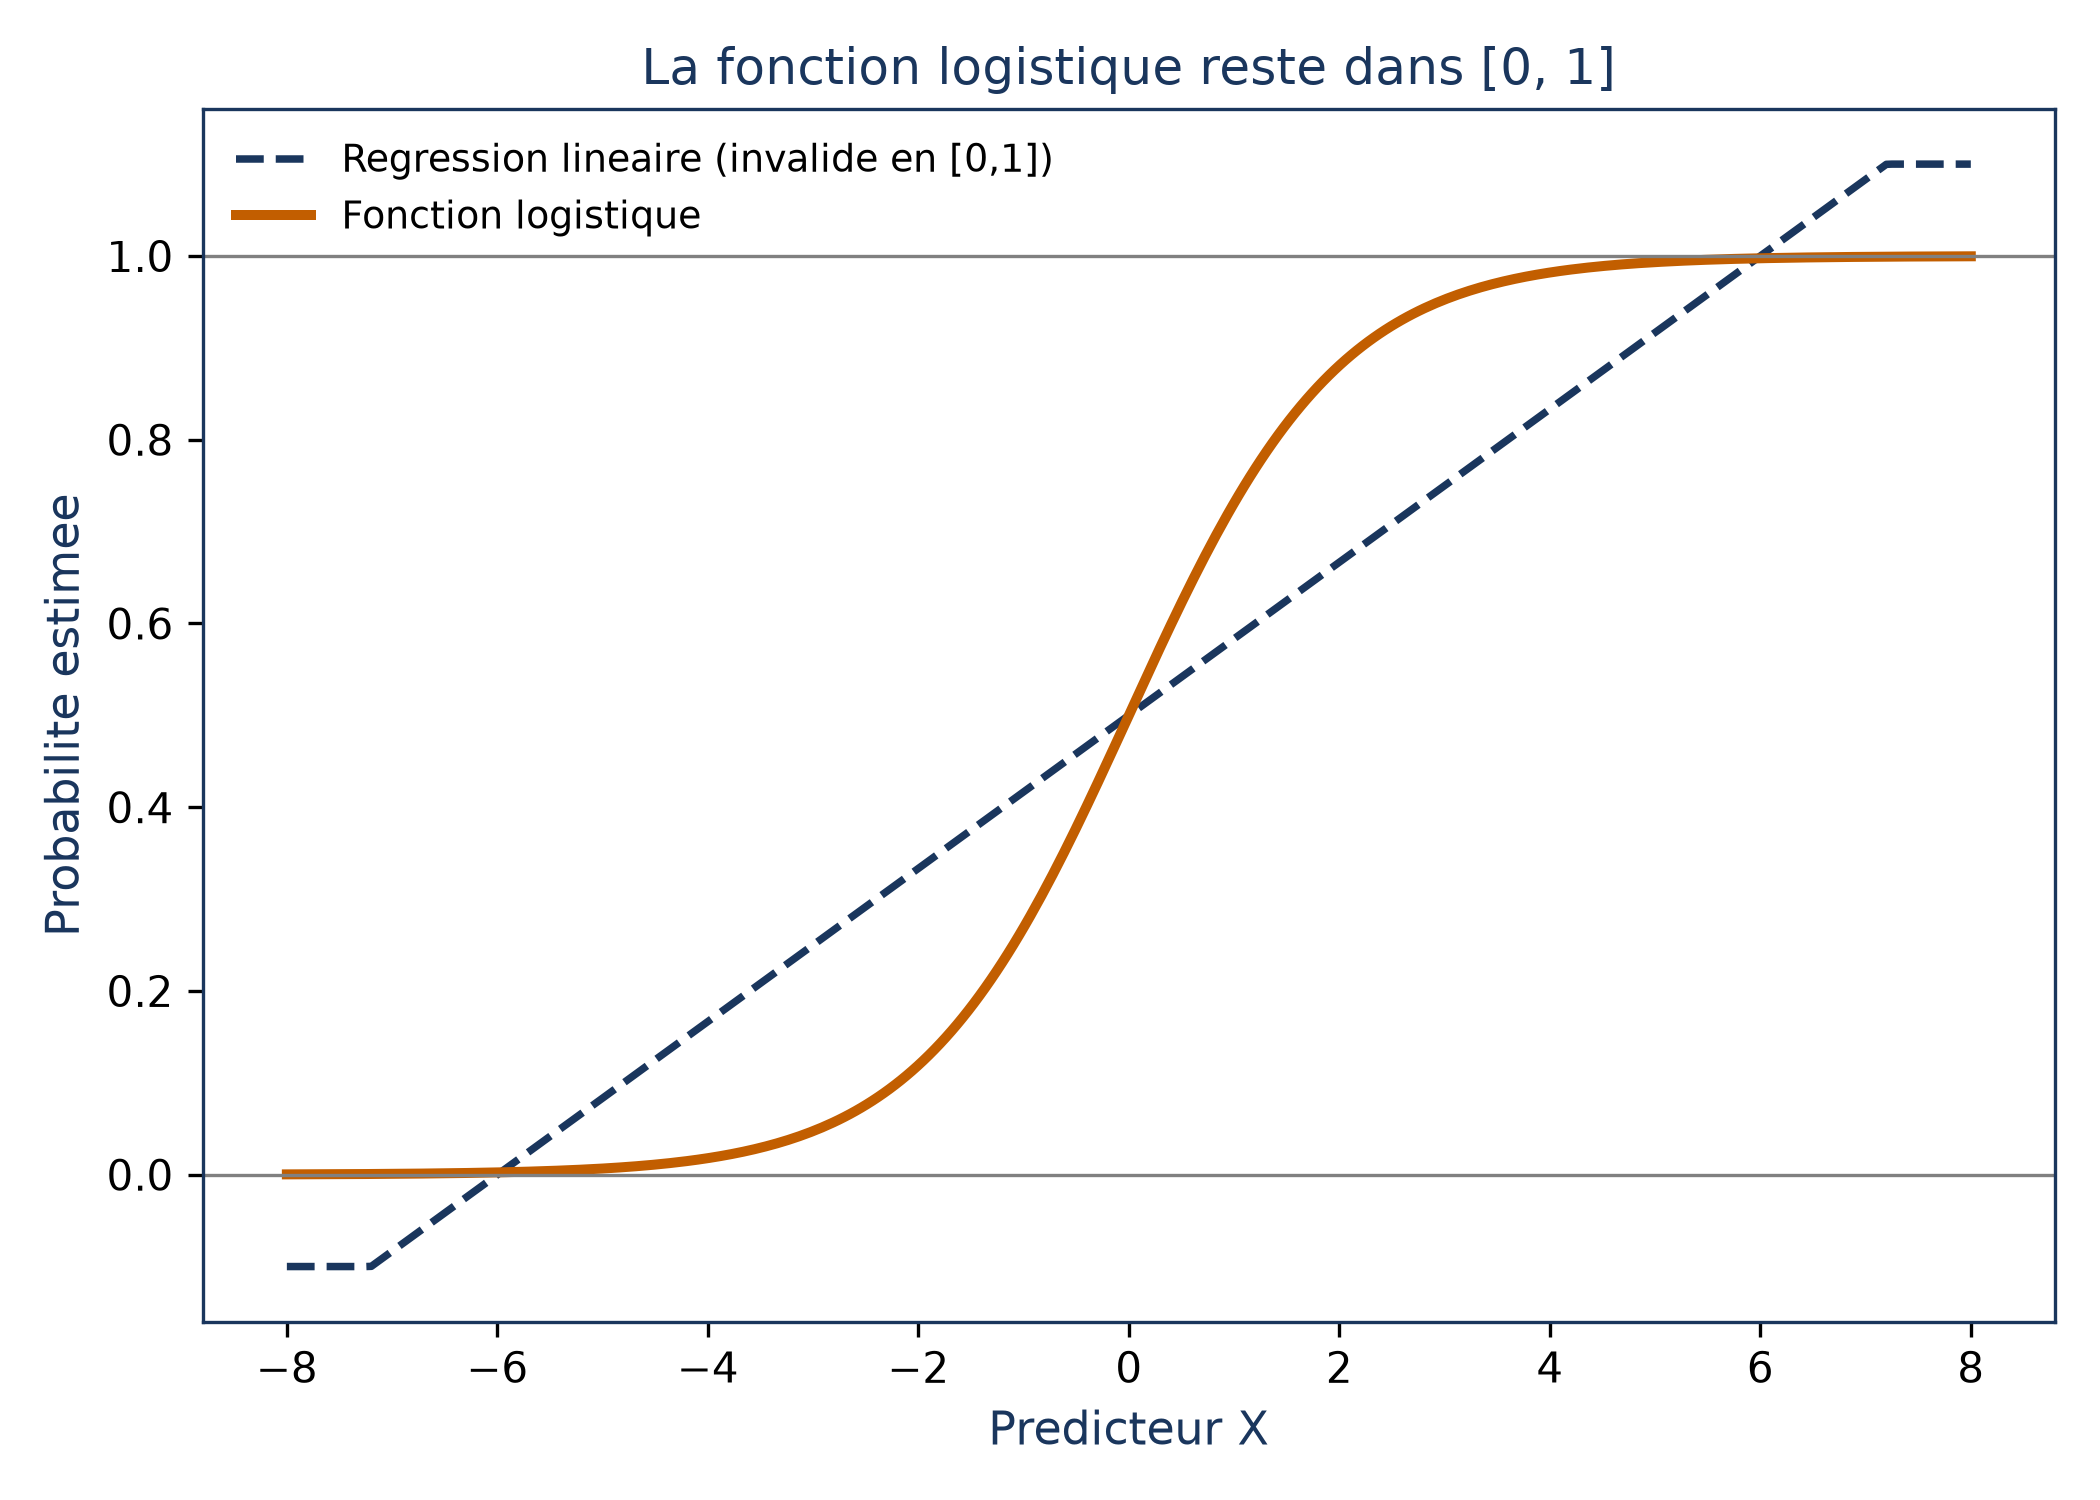
Quant à la régression linéaire appliquée directement à une réponse 0/1, elle ne tient pas : ses prédictions peuvent sortir de [0, 1], donc ne se lisent plus comme des probabilités .
💡 Intuition Si tu regardes la sigmoïde comme un traducteur qui transforme un score en probabilité, la perte est le juge qui note cette probabilité au regard de ce qui est arrivé. Les deux vont ensemble.
Où la perte se branche dans PyTorch
Dans un classifieur à deux catégories, la sortie passe par une sigmoïde avant d’arriver à la perte . La ligne qui fixe la perte tient en une instruction :
criterion = nn.BCELoss()
À chaque lot, la perte se calcule entre la sortie du modèle et les étiquettes. Dans la ligne suivante, output désigne la sortie du modèle pour ce lot et labels ses étiquettes ; labels.float() les convertit en nombres décimaux avant le calcul :
loss = criterion(output.squeeze(), labels.float())
loss.backward() déclenche ensuite la rétropropagation : PyTorch calcule les gradients automatiquement, grâce à son module autograd, pour toute fonction dérivable .
📌 À retenir L’entropie croisée binaire juge une probabilité à partir de l’issue réellement observée. Elle est presque nulle quand la probabilité donnée à la bonne issue est haute, et très lourde quand elle est basse.
BCELossen est la version PyTorch, à brancher après une sigmoïde.