Complète cette phrase : « elle n’aime pas les pommes de… ». Tu as pensé « terre » sans effort, parce que tu as retenu les mots qui précèdent. Un réseau de neurones classique, lui, ne retient rien d’un mot à l’autre. Tu vas voir comment on lui donne une mémoire, ce que cela change, et à quel endroit cette mémoire s’arrête.
Sommaire
- L’essentiel en 30 secondes
- Le problème : un réseau classique n’a aucune mémoire
- Une boucle et un état caché : ce qui définit un réseau récurrent
- Ce que calcule chaque pas de temps
- À quoi servent les réseaux récurrents
- Se souvient-il vraiment de tout ? Les limites du réseau simple
- LSTM : une mémoire longue protégée par des portes
- GRU : la même idée avec deux portes
- Les trois couches côte à côte dans PyTorch
- Face à l’attention : ce que les récurrents laissent ouvert
L’essentiel en 30 secondes
- Un réseau récurrent garde un état interne d’un élément de la séquence au suivant : ses sorties dépendent donc des entrées précédentes.
- À chaque pas, il applique la même opération, avec les mêmes poids : il lit des séquences de longueur quelconque avec un nombre fixe de paramètres.
- Il sert à classer un texte, traduire, reconnaître la voix ou prévoir une série temporelle.
- Sa mémoire est courte : le gradient évanescent l’empêche d’apprendre les dépendances lointaines.
- LSTM et GRU y répondent par des portes qui filtrent l’information : un LSTM se souvient jusqu’à 100 pas, un réseau simple commence à oublier après 7.
Le problème : un réseau classique n’a aucune mémoire
Une couche de réseau classique (on dit feedforward) traite chaque entrée pour elle-même. Pour un vecteur  qui représente l’élément à l’instant
 , elle calcule
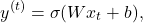
c’est-à-dire une somme pondérée de l’entrée, passée dans une fonction d’activation  . Rien de ce qui a précédé n’y apparaît.
Pour une image isolée, ce n’est pas grave. Pour une séquence de mots, c’est un handicap : le mot à l’instant dépend de celui qui le précède, et le dernier mot d’une phrase dépend souvent de plusieurs mots antérieurs. C’est ce qui te permet de finir « les pommes de… » sans connaître la suite. Il faut donc un réseau capable de conserver une trace des entrées passées.
Une boucle et un état caché : ce qui définit un réseau récurrent
Un réseau récurrent (RNN, pour recurrent neural network) maintient un état interne qui mémorise ce qu’il a déjà vu. On l’appelle l’état caché : une sorte de mémoire qui résume tout ce qui a été lu jusque-là.
À chaque pas de temps, le réseau reçoit deux choses : la nouvelle entrée, et l’état caché produit au pas précédent. Il en tire une sortie et un nouvel état caché, qu’il passera au pas suivant.
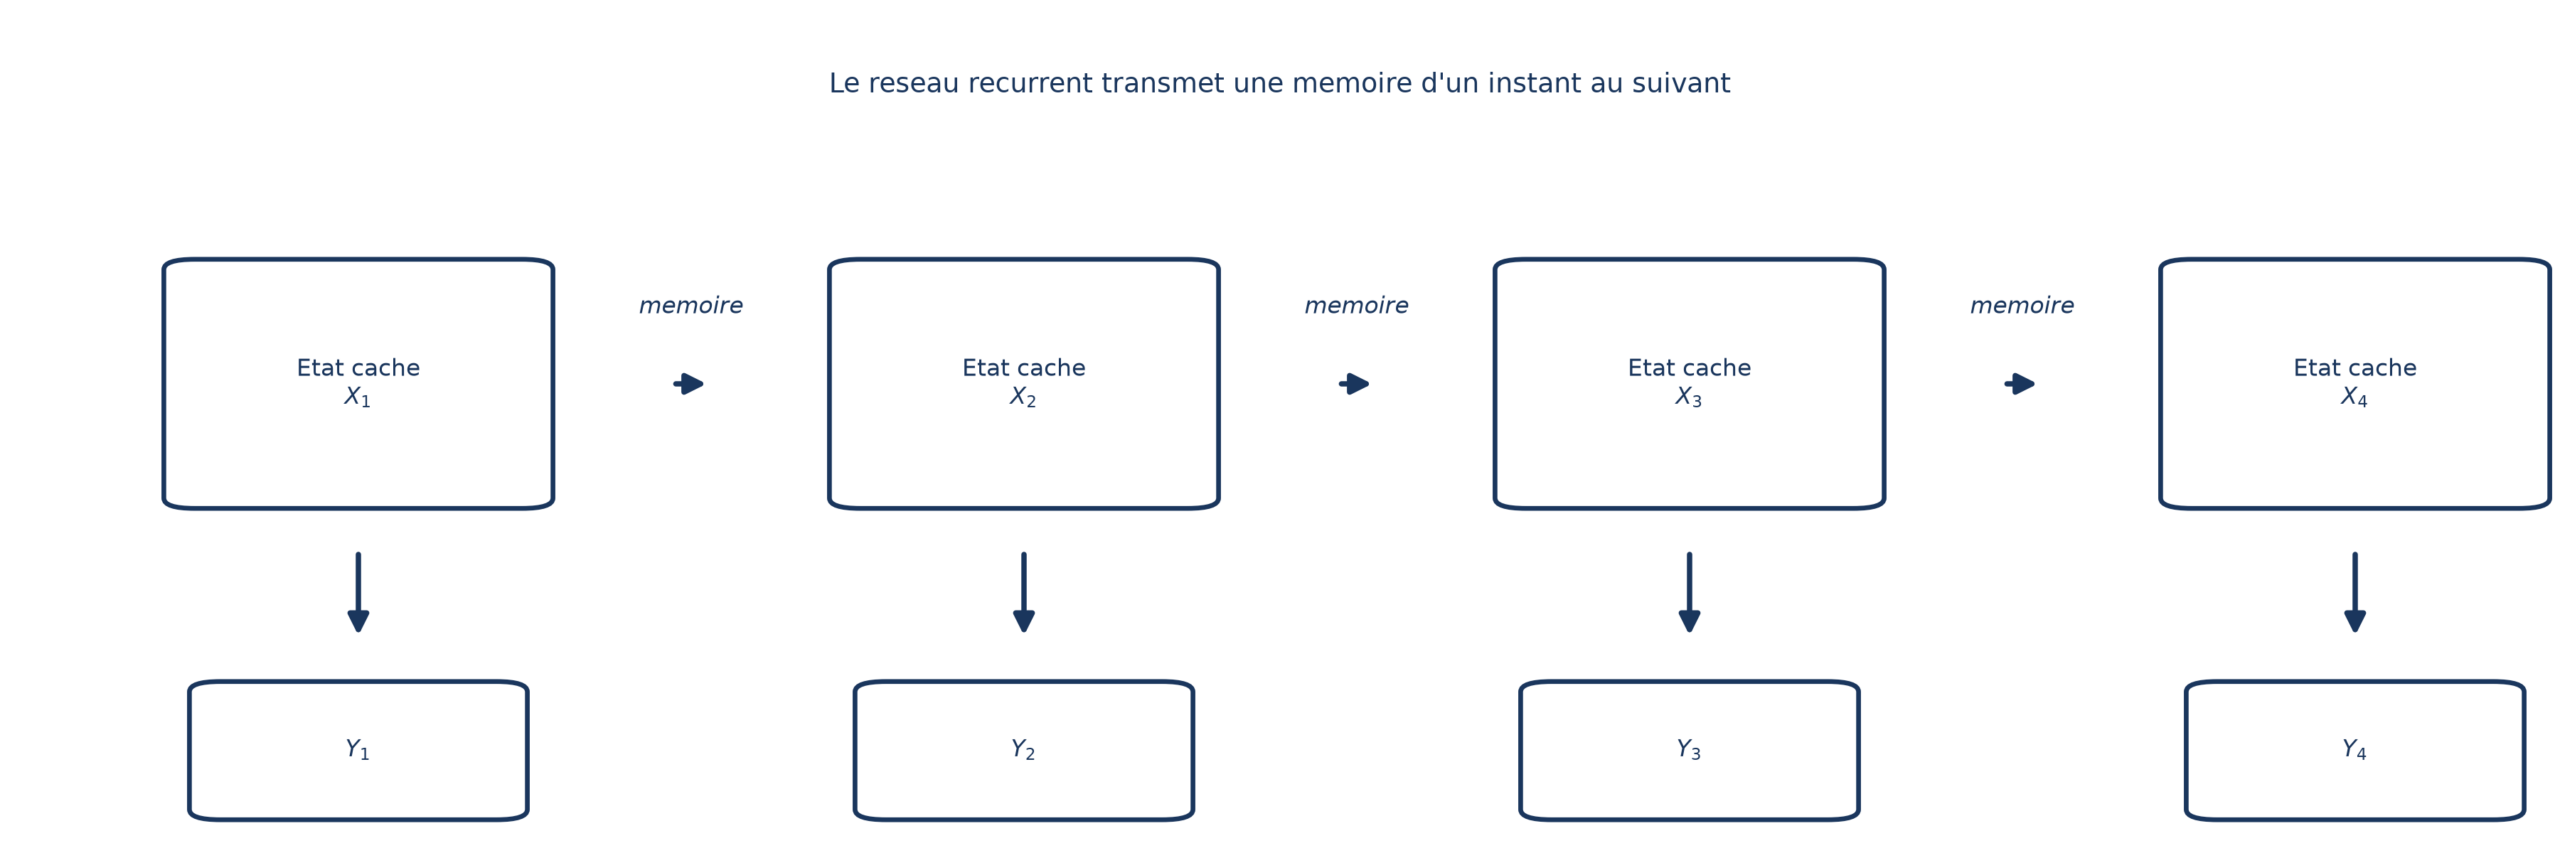
Le mot « récurrent » vient de là : la même opération est appliquée à chaque élément de la séquence. Le même jeu de poids se réutilise à l’identique à chaque pas, ce qui permet de traiter des séquences de longueur quelconque avec un nombre de paramètres fixe.
Ce que calcule chaque pas de temps
Voici le cœur d’un RNN simple, pas de temps par pas de temps :
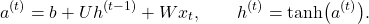
Lis-le de gauche à droite. est l’entrée courante,  l’état caché précédent,
 un biais. La matrice
 pondère l’entrée, comme dans un réseau classique ; la matrice
 pondère le passé et règle l’influence de l’historique sur l’instant présent. La somme passe dans la fonction
 et donne le nouvel état
 .
Ce nouvel état sert deux fois : il alimente le calcul du pas suivant, et il produit la sortie  , par une transformation linéaire puis une non-linéarité, comme dans le réseau classique du début.
Ces équations semblent compliquées, mais elles disent une chose simple : on entretient un état caché qui tient compte des itérations précédentes. Si tu déroules le réseau dans le temps, tu obtiens la même cellule répétée, exactement ce que montre le schéma plus haut.
L’entraînement suit le même chemin : la rétropropagation se fait à chaque pas de temps, et le réseau traite un mot à la fois.
À quoi servent les réseaux récurrents
Premier usage : lire une séquence entière et en tirer un verdict unique. Pour classer un document, chaque mot est converti en vecteur numérique (un embedding) puis présenté au réseau l’un après l’autre. L’état caché final résume l’ensemble du texte et sert de base à la classification, par exemple pour prédire le sentiment d’une critique de film.
On les retrouve aussi en traduction automatique, en reconnaissance vocale et en prévision de séries financières ou climatiques.
Deuxième usage : transformer une séquence en une autre, comme en traduction. Le système classique a deux étages, un encodeur et un décodeur. L’encodeur condense la séquence d’entrée en une représentation succincte, une sorte de bon résumé ; le décodeur reçoit ce vecteur de contexte et en tire la traduction.
Cette tâche pose un problème d’alignement : les deux séquences n’ont pas la même longueur. Une phrase de quatre mots peut en exiger six dans l’autre langue, et le réseau doit gérer cet écart.
Se souvient-il vraiment de tout ? Les limites du réseau simple
Sur le papier, un réseau récurrent pourrait lire des séquences infinies et se souvenir du début. En pratique, après quelques pas, il commence à oublier les premières entrées.
Une première raison tient à l’état caché lui-même : il doit remplir deux rôles à la fois, fournir l’information utile à la sortie du moment et garder de la mémoire pour les décisions futures. Son contenu est local plutôt que global : à l’instant , il reflète surtout les derniers pas, non la séquence entière.
La seconde raison est mathématique. Pour apprendre, les gradients doivent remonter de la dernière cellule vers la première, et ils peuvent rétrécir exponentiellement jusqu’à tendre vers zéro : c’est le gradient évanescent, qui empêche d’apprendre des dépendances à longue portée. À l’inverse, un gradient explosif croît sans contrôle et rend l’entraînement instable.
⚠️ Piège « Récurrent » ne veut pas dire « se souvient de tout ». La mémoire existe, mais sa portée est courte : le réseau simple convient à l’analyse de séries, pas aux phrases dont le sens tient à un mot lointain.
Troisième défaut, plus pratique : la nature séquentielle du calcul interdit la parallélisation. Il faut finir le pas pour commencer le pas  , ce qui rend l’entraînement coûteux.
LSTM : une mémoire longue protégée par des portes
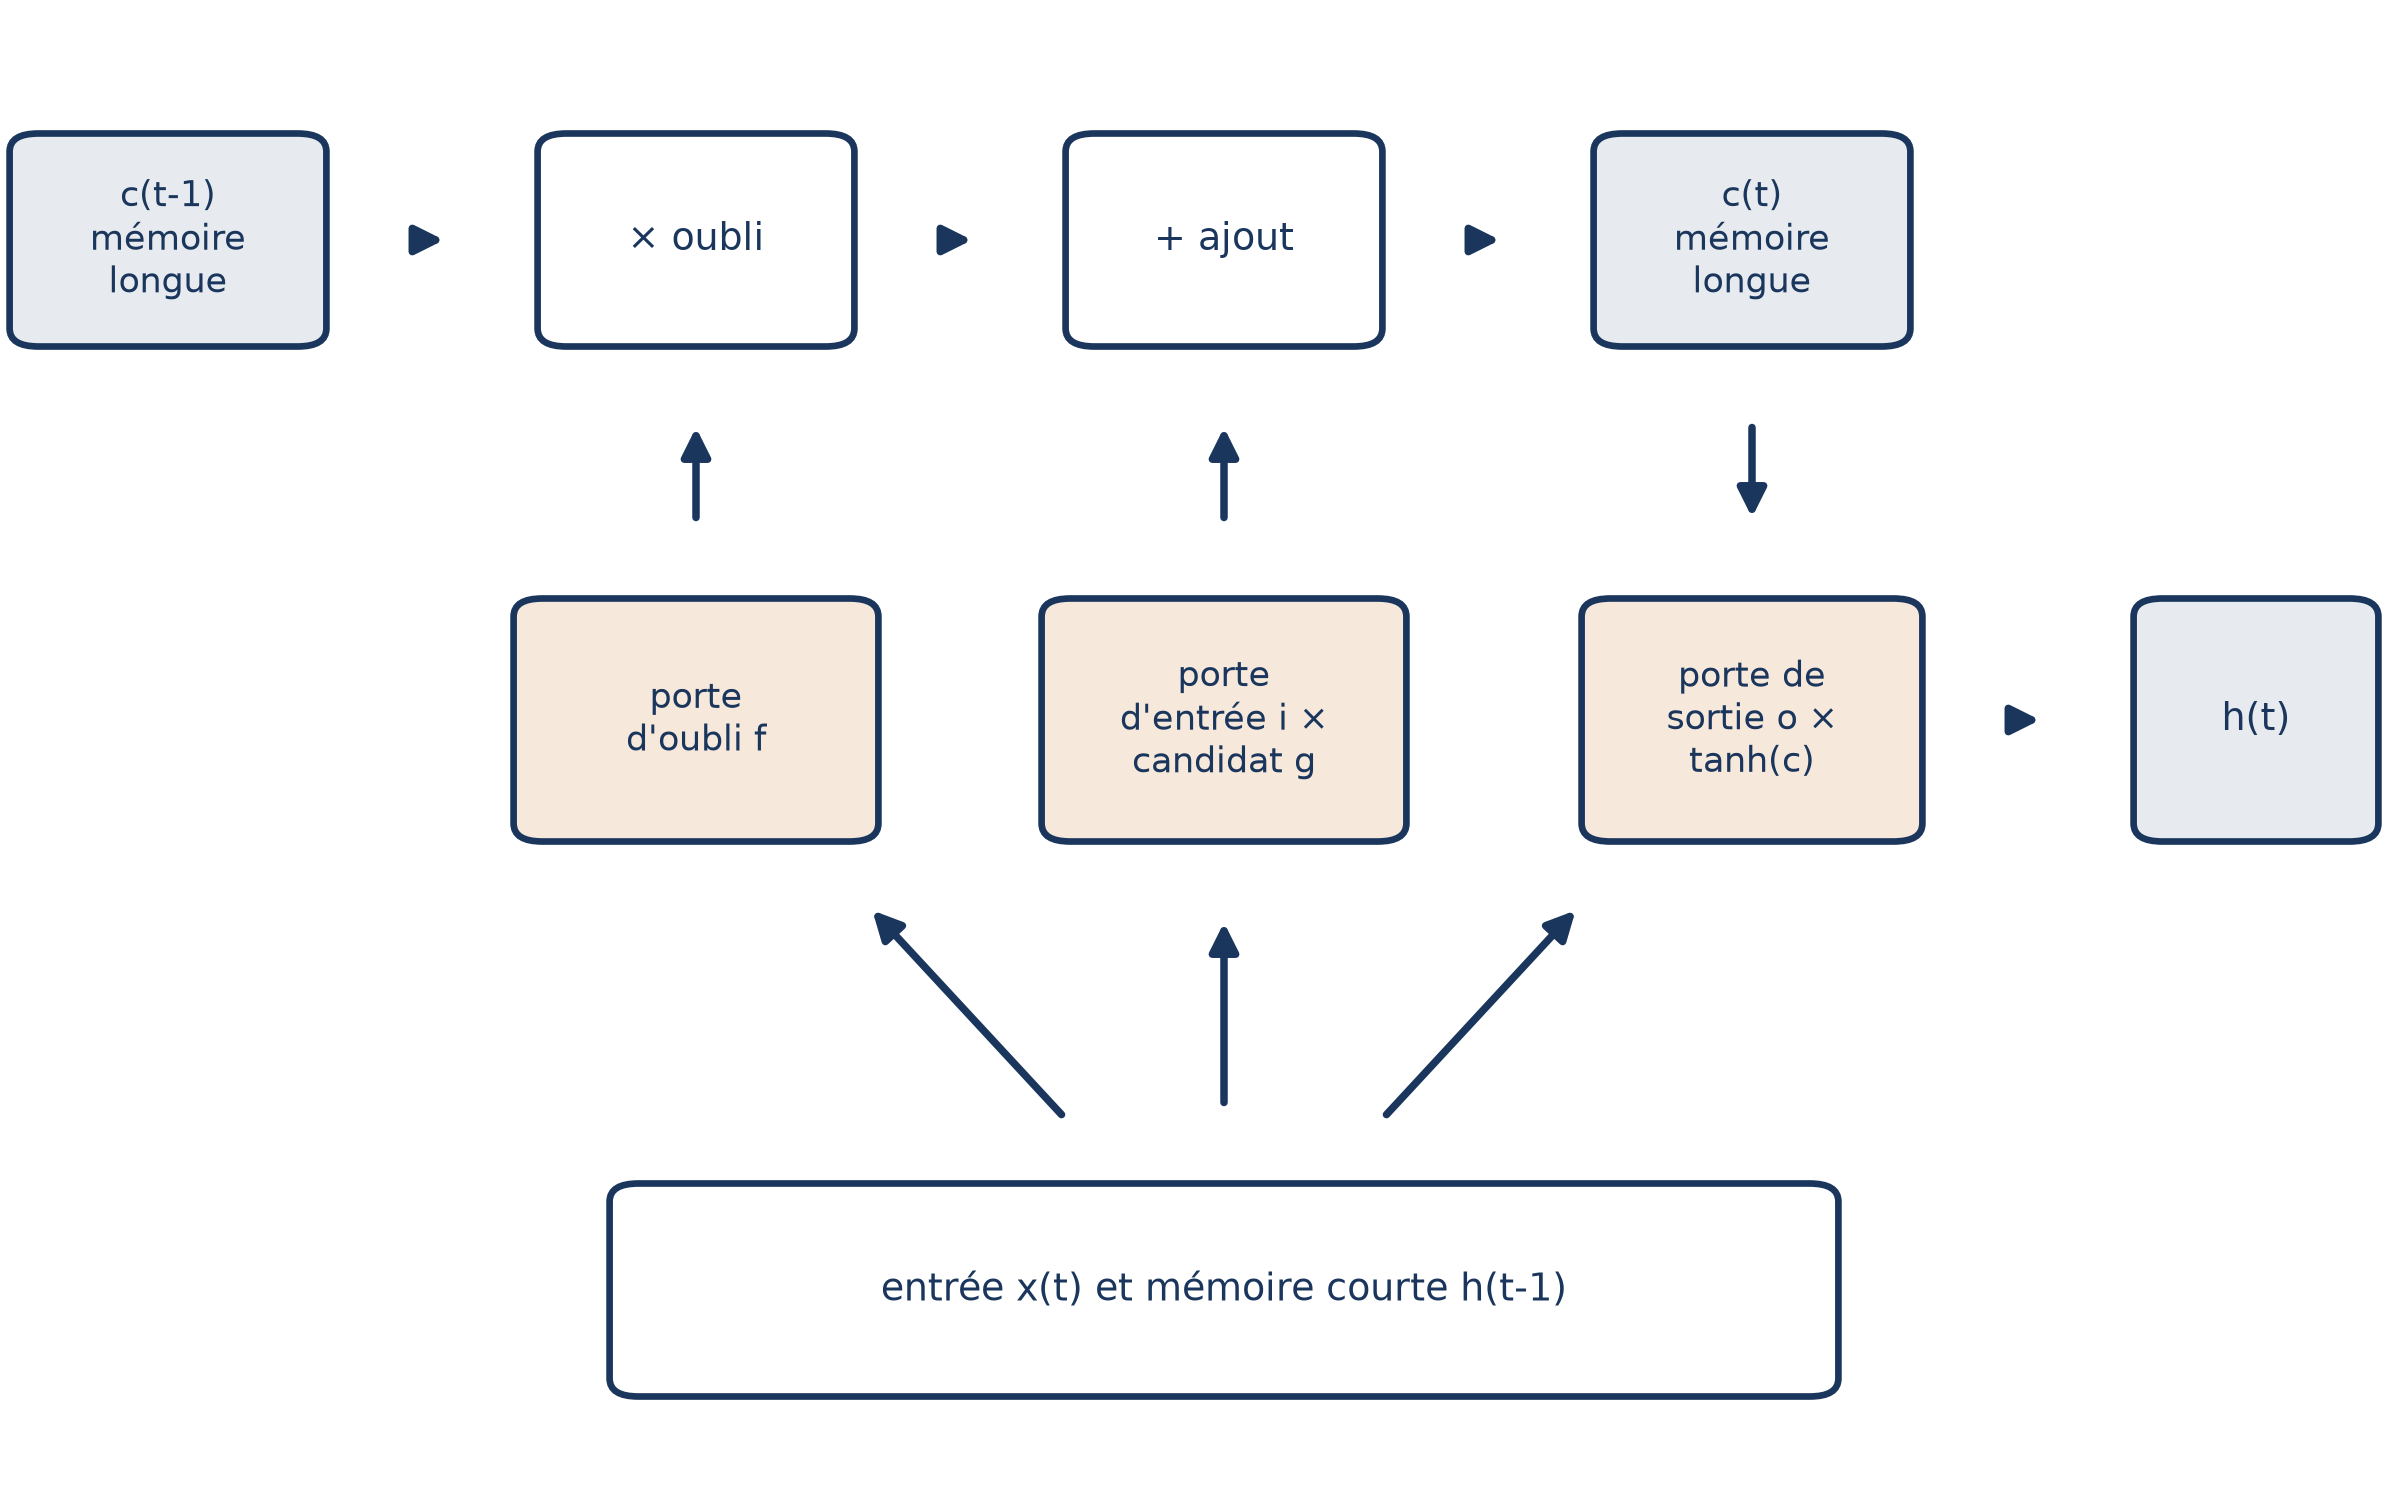
Le LSTM (long short-term memory) est une extension conçue pour oublier ce qui n’est pas important et ne garder que le contexte essentiel. Il ajoute deux ingrédients : des portes, qui contrôlent l’information, et une couche de contexte dédiée. Il porte donc deux états :  , la mémoire à court terme utile à l’instant , et
 , la mémoire à long terme.
Une porte est une couche à activation sigmoïde, qui écrase ses valeurs entre 0 et 1 : proche de 1, la porte est ouverte, proche de 0, elle est fermée. Le produit de Hadamard, la multiplication terme à terme, sert de filtre : il laisse passer l’information si la valeur est proche de 1 et la bloque si elle est proche de 0. À chaque pas, le LSTM décide ainsi ce qu’il garde et ce qu’il oublie.
Trois portes se succèdent. La première, la porte d’oubli, décide ce qui n’est plus utile dans le contexte ; on multiplie le contexte précédent  par sa sortie :
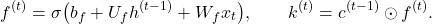
Chaque porte a ses propres poids (ici l’indice  ) et se nourrit de l’entrée courante et de l’état précédent.
 est la part du passé qui survit.
La porte d’entrée extrait de l’entrée l’information à ajouter ; le nouveau contexte  est la somme de ce que l’on ajoute et de ce que l’on a gardé. Enfin la porte de sortie produit la sortie et met à jour l’état caché :
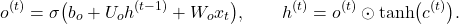
Le gain se mesure : un LSTM se souvient jusqu’à 100 pas, alors qu’un RNN simple commence à oublier après 7. L’opération d’addition rend moins probables les gradients évanescents ou explosifs.
GRU : la même idée avec deux portes
Les GRU (gated recurrent units) sont une autre variante contre le gradient évanescent. Très proches des LSTM, ils ont aussi des portes internes mais sont beaucoup plus simples, et peuvent converger plus vite pour des performances comparables. Ils gardent l’addition, le produit de Hadamard, la présence d’un contexte et le contrôle de l’information dans la couche.
Ici, la porte d’oubli devient la porte de mise à jour  : l’information importante est conservée (valeurs proches de 1), l’information sans importance est réécrite (valeurs proches de 0). La porte d’entrée devient la porte de réinitialisation
 ; elle n’est plus indépendante, mais reliée à la porte de mise à jour :

Ces deux portes contrôlent respectivement la part du passé conservée et la part de l’état précédent ignorée lors du calcul du nouvel état. La mise à jour finale combine l’ancien état et un état candidat, grâce à .
Les trois couches côte à côte dans PyTorch
Reste une question pratique : que change-t-on dans le code quand on passe d’un RNN simple à un LSTM ou à un GRU ? Les extraits supposent numpy et torch déjà importés. Le premier fabrique un tenseur aléatoire de dimensions 10, 5, 3 pour voir comment une couche récurrente le transforme :
array = np.random.random((10, 5, 3))
# Convert the numpy array to a PyTorch tensor
data_tensor = torch.tensor(array, dtype=torch.float32)
RNN = nn.RNN(input_size=3, hidden_size=10,
             num_layers=1, batch_first=True)
output, hidden = RNN(data_tensor)
output.shape
Voici le LSTM, sur le même type de tenseur :
data_tensor = torch.tensor(np.random.random((10, 5, 3)),
                           dtype=torch.float32)
LSTM =nn.LSTM(input_size=3, hidden_size=10,
              num_layers=1, batch_first=True)
output, (hidden, cell) = LSTM(data_tensor)
Le LSTM renvoie en plus de l’état caché un état de cellule (cell) : c’est la mémoire longue de la section précédente. Le calcul étant interne à la couche, on peut facilement remplacer un RNN par un LSTM.
Et le GRU, qui ne rend qu’un état caché, comme le RNN simple :
data_tensor = torch.tensor(np.random.random((10, 5, 3)),
                           dtype=torch.float32)
GRU =nn.GRU(input_size=3, hidden_size=10,
            num_layers=1, batch_first=True)
output, hidden = GRU(data_tensor)
Les trois appels ont la même forme : seuls changent le nom de la couche et ce qu’elle rend. L’intérieur de la cellule, lui, est ce que les sections précédentes ont détaillé.
Face à l’attention : ce que les récurrents laissent ouvert
Les défauts du réseau récurrent simple, l’alignement des séquences, les gradients qui s’évanouissent ou explosent, et l’impossibilité de paralléliser, ont poussé à chercher mieux. En 2017 est arrivé le Transformer, un réseau doté d’un mécanisme d’attention capable d’apprendre les relations entre les différentes parties d’une séquence.
L’attention résout l’alignement et le goulot d’étranglement de la traduction à deux étages, où tout un texte doit passer par un seul vecteur de contexte. L’auto-attention compare les éléments d’une même séquence en parallèle, ce qu’une boucle ne permet pas.
📌 À retenir Un réseau récurrent est un réseau dont l’état caché passe d’un pas au suivant. Simple, il oublie vite ; avec des portes (LSTM, GRU), sa mémoire tient bien plus longtemps.
Pour la phrase du début, la lecture est maintenant claire : le réseau lit « elle », « n’aime », « pas »… en gardant la trace de chaque mot dans son état caché. Reste à savoir jusqu’où cette trace survit, et c’est précisément ce que les portes ont changé.