Une phrase, c’est une file de mots. Pour y repérer « le chat mange » ou « mange des croquettes », il suffit de regarder trois mots à la fois, puis de décaler le regard d’un cran. Ce regard qui avance, c’est une convolution à une dimension. Tu vas voir ce qu’elle calcule, ce qu’elle apprend, comment on la demande à une bibliothèque, et ce qu’elle ne sait pas faire.
Sommaire
- L’essentiel en 30 secondes
- D’une grille de pixels à une simple ligne
- Un noyau de trois mots qui avance sur la phrase
- Plusieurs noyaux, plusieurs motifs
- Lire un appel à Conv1d ligne par ligne
- Ce que la convolution 1D ne fait pas
L’essentiel en 30 secondes
- Une convolution 1D fait glisser un filtre à une seule dimension, aussi appelé noyau, le long d’une séquence.
- À chaque position, les entrées sont multipliées par les poids du filtre puis additionnées, avec un poids appris par entrée du filtre.
- Pour du texte, le noyau couvre en général de trois à sept mots, voire plus.
- Plusieurs noyaux apprennent plusieurs motifs différents à la fois.
- Ce qu’elle apprend, ce sont des motifs entre les mots du noyau : une vision locale, rapide à calculer.
D’une grille de pixels à une simple ligne
La convolution est née pour trouver des motifs dans des images, ou dans toute matrice à deux dimensions. On y fait glisser un filtre, une petite matrice qu’on appelle aussi noyau : on le multiplie par les valeurs qu’il recouvre, puis on additionne les produits. Pendant l’entraînement, on apprend un poids pour chaque entrée du filtre.
Ce principe a si bien réussi en vision, parce qu’il extrait l’information locale et reconnaît des motifs complexes, qu’on l’a proposé pour les séquences. Une convolution à une dimension garde exactement la même idée, mais son filtre n’a plus qu’une direction : une rangée de poids qu’on fait glisser le long de la séquence.
Un noyau de trois mots qui avance sur la phrase
Prends « le chat mange des croquettes » et un noyau de taille 3. Il regarde d’abord « le chat mange », puis « chat mange des », puis « mange des croquettes », et ainsi de suite jusqu’au bout de la phrase. À chaque arrêt, chaque mot est multiplié par le poids qui lui correspond dans le noyau et le tout est additionné. Les mots entrent sous forme de vecteurs, ceux d’un embedding.
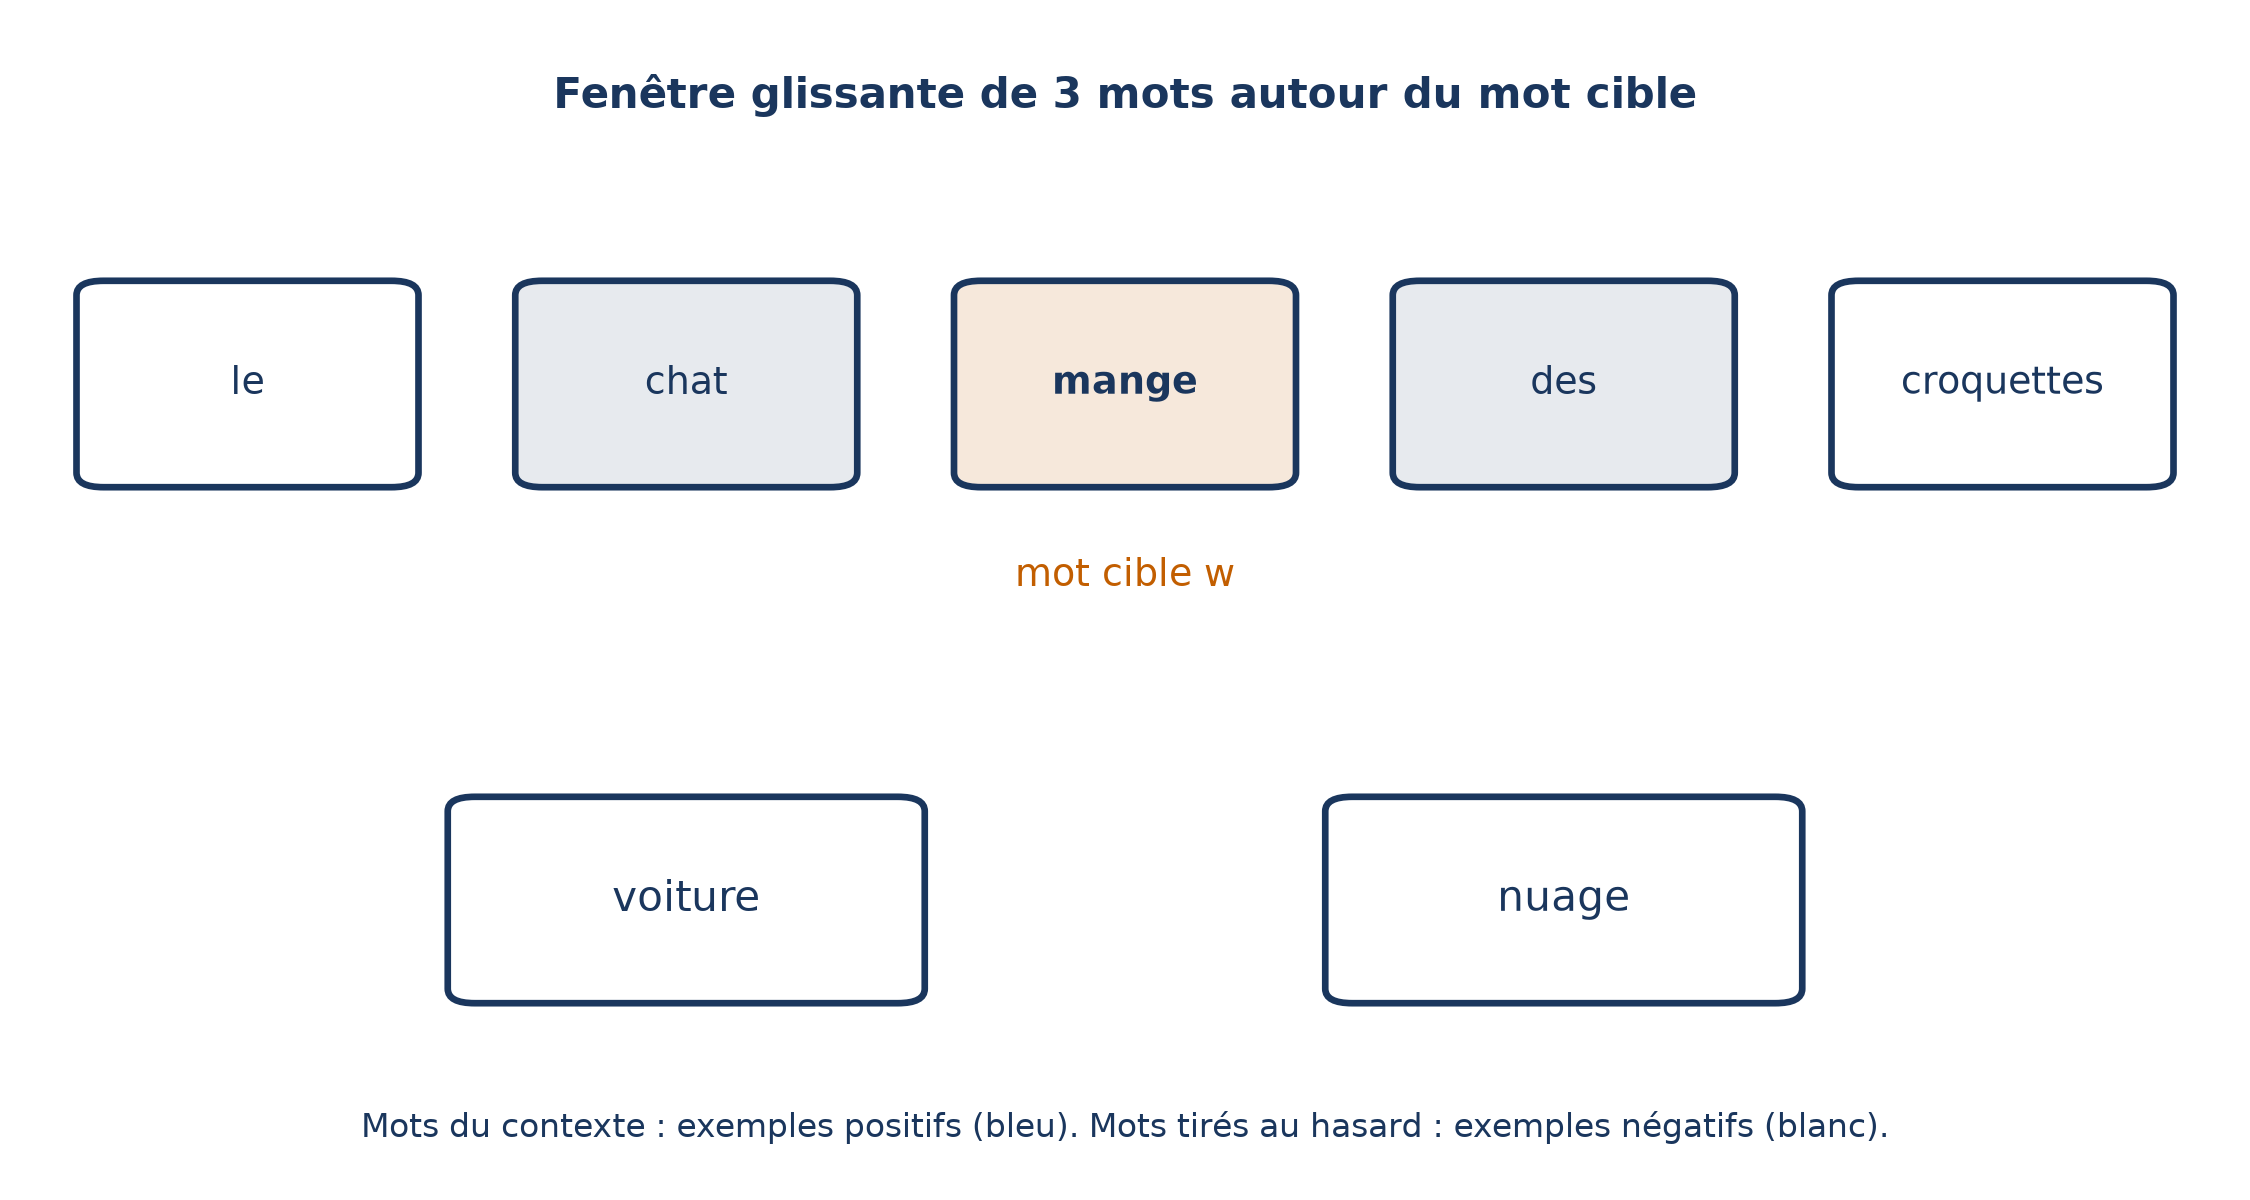
Cette fenêtre n’est pas figée à trois mots : le noyau peut avoir une taille arbitraire, souvent de trois à sept mots, davantage si on le souhaite. Et comme il ne fait que glisser, le calcul est très rapide.
💡 Intuition Pense à une loupe de trois mots qu’on promène sur la phrase. Ses poids disent quelles combinaisons de mots voisins la font réagir fort. Ces poids ne sont écrits par personne : ils s’apprennent à l’entraînement.
Plusieurs noyaux, plusieurs motifs
Un noyau ne cherche qu’un seul genre de motif. Pour en repérer plusieurs, on utilise plusieurs noyaux côte à côte : chacun donne un balayage différent de la séquence, que l’on peut visualiser comme une carte de caractéristiques.
Comme pour les images, on peut ensuite ajouter des opérations telles que le max pooling, qui ne retient que les caractéristiques les plus importantes.
Lire un appel à Conv1d ligne par ligne
Comment demander à PyTorch de faire glisser un noyau de taille 3 sur des données ? Voici un exemple, qui fabrique un tenseur de valeurs aléatoires puis lui applique une couche Conv1d.
data_tensor = torch.tensor(np.random.random((10, 5, 3)),
                           dtype=torch.float32)
Conv1d = nn.Conv1d(in_channels=5, out_channels=16,
                   kernel_size=3, stride=1, padding=1)
output = Conv1d(data_tensor)
output.shape
Les noms torch, nn et np viennent des importations habituelles de PyTorch et de NumPy, non reproduites ici. La première instruction crée un tenseur aléatoire de dimensions (10, 5, 3). La deuxième construit la couche : 5 canaux en entrée, 16 canaux en sortie, kernel_size=3 pour un noyau de taille 3, avec stride=1 et padding=1. La troisième applique la couche aux données, et output.shape affiche la forme du tenseur obtenu.
Ce que la convolution 1D ne fait pas
Elle ne sert pas qu’aux images. C’est même une idée reçue tenace : née pour la vision, la convolution a été reprise telle quelle pour les séquences, texte en tête.
Elle ne voit pas non plus toute la phrase d’un coup. Ce qu’elle apprend, ce sont des motifs entre les mots situés dans le noyau, donc dans une fenêtre de quelques mots. C’est la contrepartie de sa vitesse.
Et ses motifs ne sont pas choisis à la main : ses poids se règlent à l’entraînement, un par entrée du filtre.
📌 À retenir Une convolution 1D, c’est une fenêtre de poids apprise qu’on fait glisser sur une séquence pour y trouver des motifs locaux, un noyau par type de motif.