Tu connais des couples de mesures passées, une quantité  et le résultat
 qui l’a suivie, et on te demande de deviner le d’un cas que personne n’a encore observé. Tracer une droite à travers les cas connus, puis la lire au bon endroit : c’est la régression linéaire, sans doute l’outil le plus ancien et le plus utilisé de la statistique appliquée. Derrière ce geste de dessinateur se cachent une hypothèse, un critère de choix et deux façons de calculer. À la fin, tu sauras ce que la méthode cherche, comment elle le trouve et ce qu’elle ne peut pas te promettre.
Sommaire
- L’essentiel en 30 secondes
- Ce que le nom annonce : une cible numérique et une forme imposée
- Prédire ou comprendre : à quoi sert la droite
- Juger une droite : la moyenne des carrés des écarts
- Deux façons de calculer les coefficients
- Ce que la droite suppose sur le bruit
- Un modèle rigide face aux modèles souples
- Voir tourner une régression avec scikit-learn
- Quatre idées reçues sur la droite et ses chiffres
L’essentiel en 30 secondes
- La régression linéaire prédit une valeur numérique à partir d’une ou plusieurs variables, en supposant leur lien linéaire.
- Cette hypothèse réduit un problème sans limite à la recherche de p + 1 coefficients seulement.
- La droite retenue minimise la moyenne des carrés des écarts, qu’on trouve par une formule directe ou pas à pas.
- Même avec le meilleur modèle possible, il reste une erreur irréductible que rien ne supprime.
- Un modèle se juge sur des données jamais vues, pas sur celles qui l’ont formé.
Ce que le nom annonce : une cible numérique et une forme imposée
Dans l’apprentissage supervisé, chaque observation arrive avec sa réponse connue. Quand cette réponse est une valeur continue, on parle de régression ; quand c’est une catégorie, de classification. Dans le premier cas, tu cherches à traduire les caractéristiques d’une nouvelle observation en un nombre.
Pour écrire cela, on pose que la réponse se compose d’une partie systématique et d’une partie aléatoire :
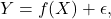
où  est une fonction fixe mais inconnue des prédicteurs
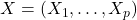 et
 un terme d’erreur aléatoire, indépendant de et de moyenne nulle. La fonction porte toute l’information que apporte sur ; c’est elle qu’il faut estimer.
Estimer une fonction entièrement arbitraire en  dimensions est un chantier sans fin. La régression linéaire le raccourcit par un pari : est linéaire.
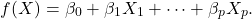
Il ne reste qu’à estimer  nombres : l’ordonnée à l’origine
 et les pentes
 (on les trouve aussi notées
 ).
Une méthode qui procède ainsi, en posant une hypothèse sur la forme de puis en ajustant ses coefficients sur des données d’entraînement, est dite paramétrique. Avec un seul prédicteur, le résultat s’écrit 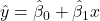 : les chapeaux signalent des estimations tirées des données, par opposition aux vrais coefficients, inconnus. Le prix du pari est clair : si la forme choisie s’écarte trop de la réalité, l’estimation sera mauvaise.
Prédire ou comprendre : à quoi sert la droite
On estime pour deux raisons, qui n’appellent pas le même modèle.
La première est de prédire. Les entrées sont faciles à mesurer, la sortie ne l’est pas : on calcule  et la forme exacte de
 importe peu, du moment que les prédictions sont précises. Imagine estimer, à partir de mesures sanguines faciles à obtenir, le risque d’une réaction indésirable grave à un médicament : l’objectif est de ne pas le prescrire aux patients à haut risque, sans se soucier du mécanisme biologique.
La seconde est de comprendre. Ici ne peut plus rester une boîte noire. Tu veux savoir quels prédicteurs sont réellement associés à la réponse parmi beaucoup de candidats, si l’association est positive ou négative, si elle dépend des autres prédicteurs, et si une équation linéaire suffit à la résumer.
Les deux objectifs se mélangent souvent. Le modèle linéaire offre alors une inférence simple et lisible, au prix d’une précision parfois inférieure à celle d’approches plus souples, dont l’interprétation est en retour bien plus difficile.
Même avec une estimation parfaite de , ta prédiction resterait fausse. L’erreur quadratique attendue se découpe en deux parts :
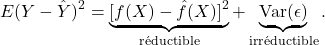
La première vient de l’écart entre la vraie et ton estimation : un meilleur modèle peut la réduire. La seconde est la variance du bruit : elle naît de variables utiles mais non mesurées, ou d’une variabilité intrinsèquement imprévisible, comme l’état de forme d’un patient un jour donné.
💡 Intuition L’erreur irréductible est un plancher : aucune droite, aucun modèle ne descendra en dessous, et sa valeur reste presque toujours inconnue en pratique.
Juger une droite : la moyenne des carrés des écarts
Pour choisir parmi toutes les droites possibles, il faut un score. En régression, la mesure de référence est l’erreur quadratique moyenne (MSE), la moyenne des carrés des écarts entre valeurs observées et valeurs prédites :
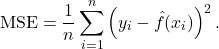
Chaque écart  porte le nom de résidu.
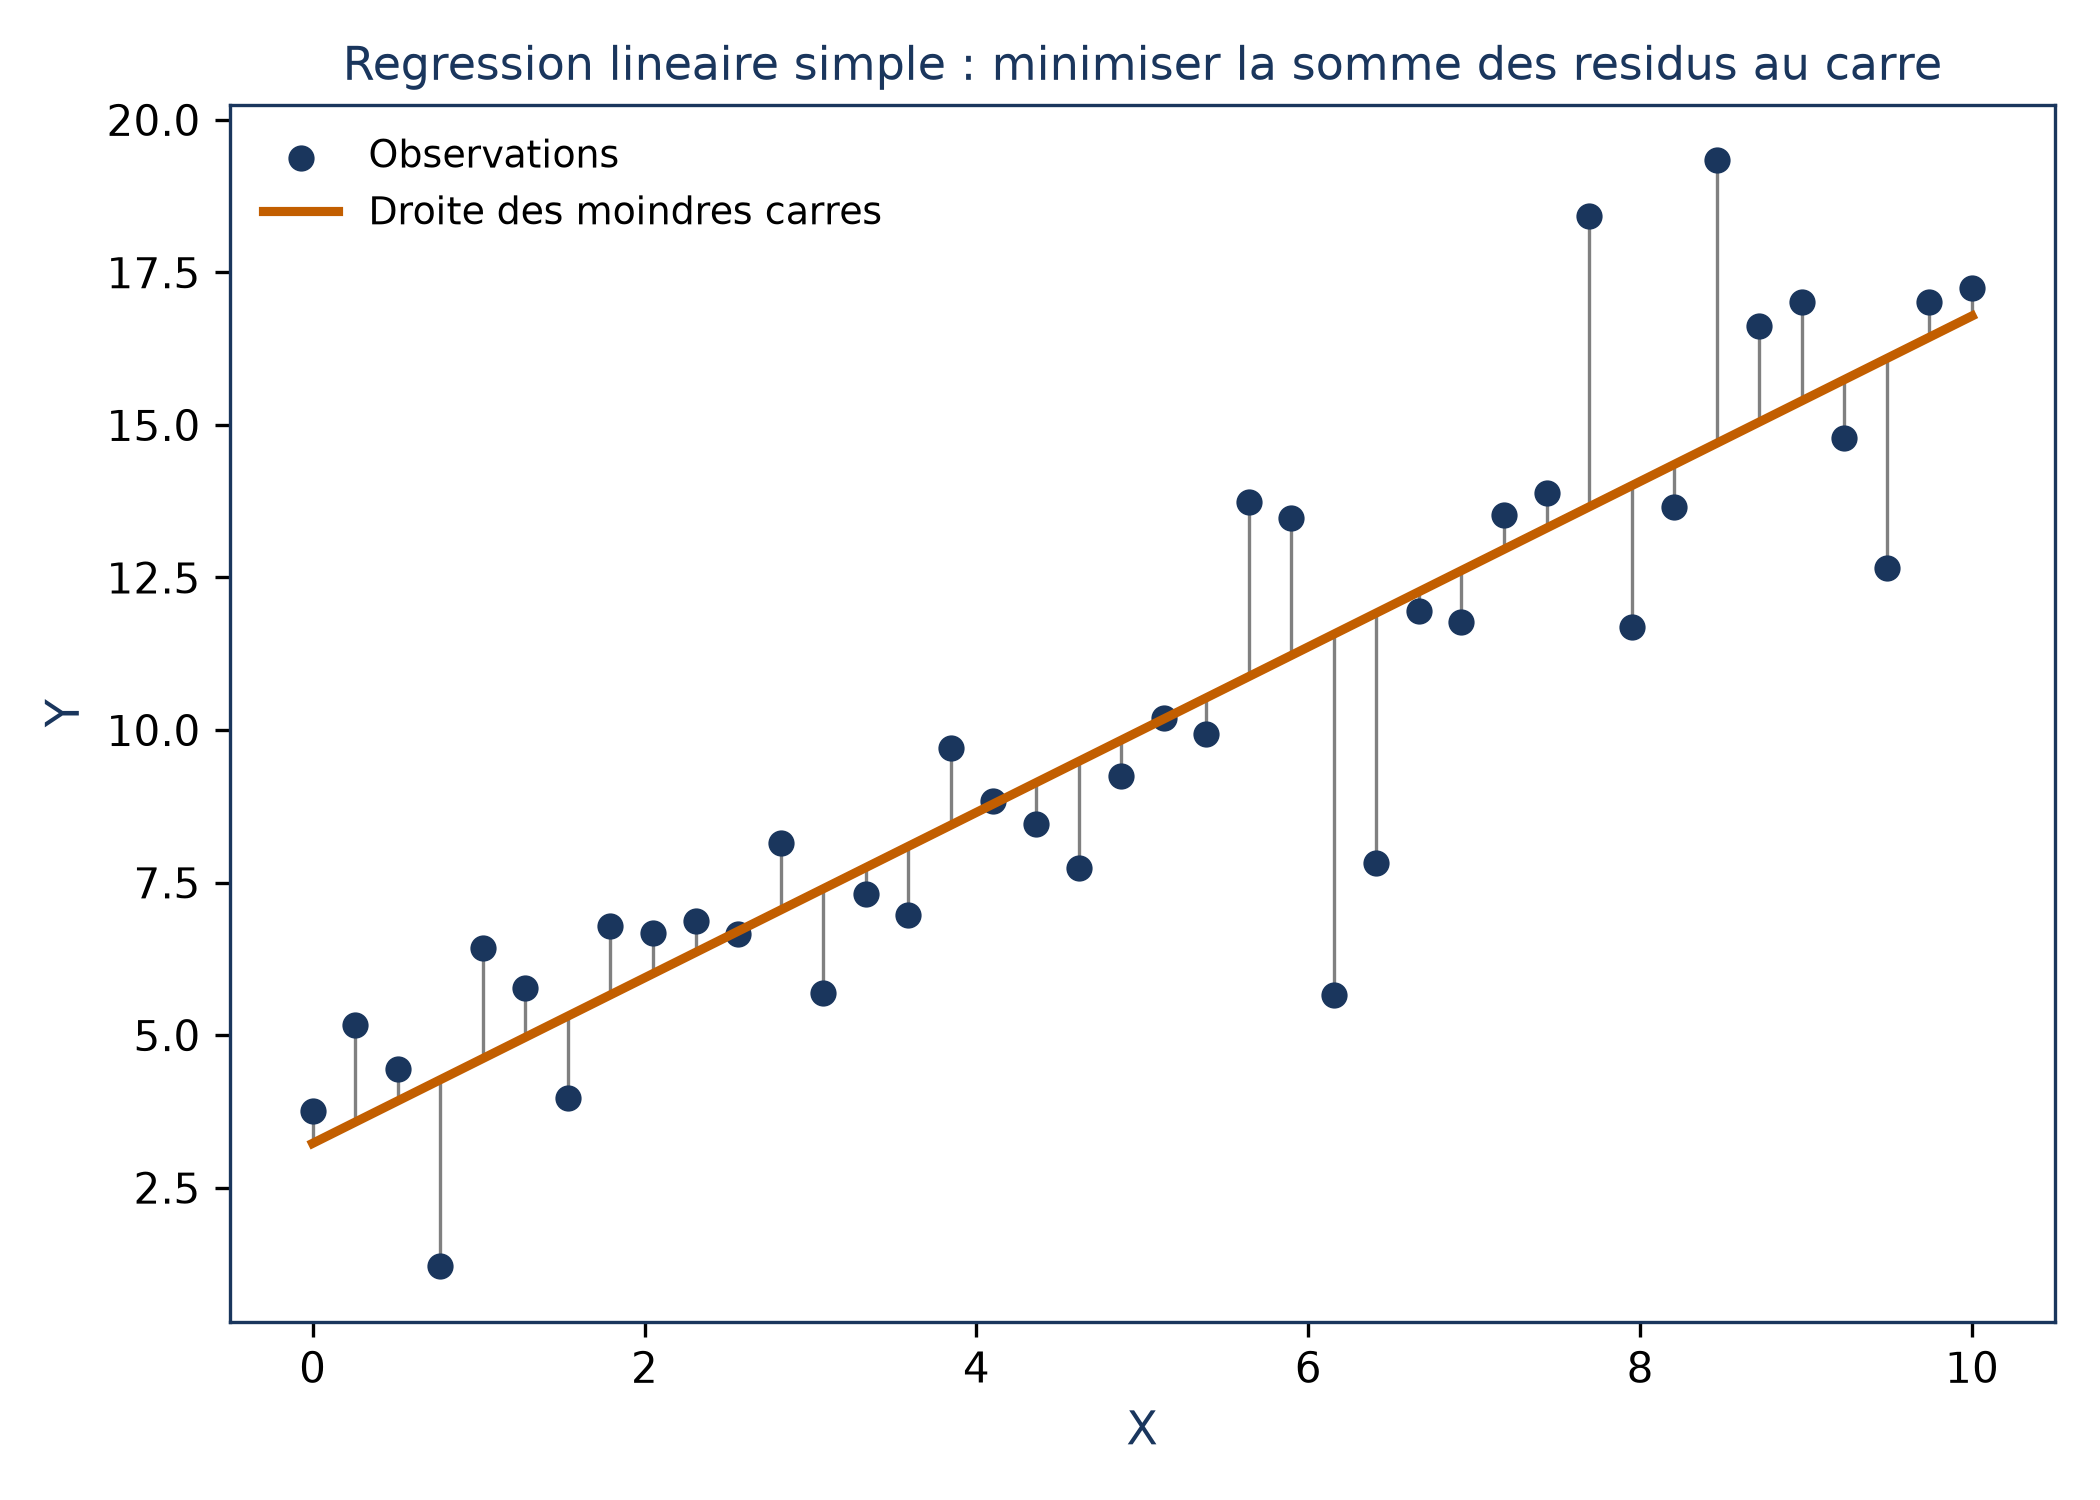
Pourquoi des carrés et pas des valeurs absolues ? Les deux sont envisageables, mais la valeur absolue n’est pas dérivable, ce qui gêne la suite du calcul. Le carré règle ce souci : c’est la méthode des moindres carrés.
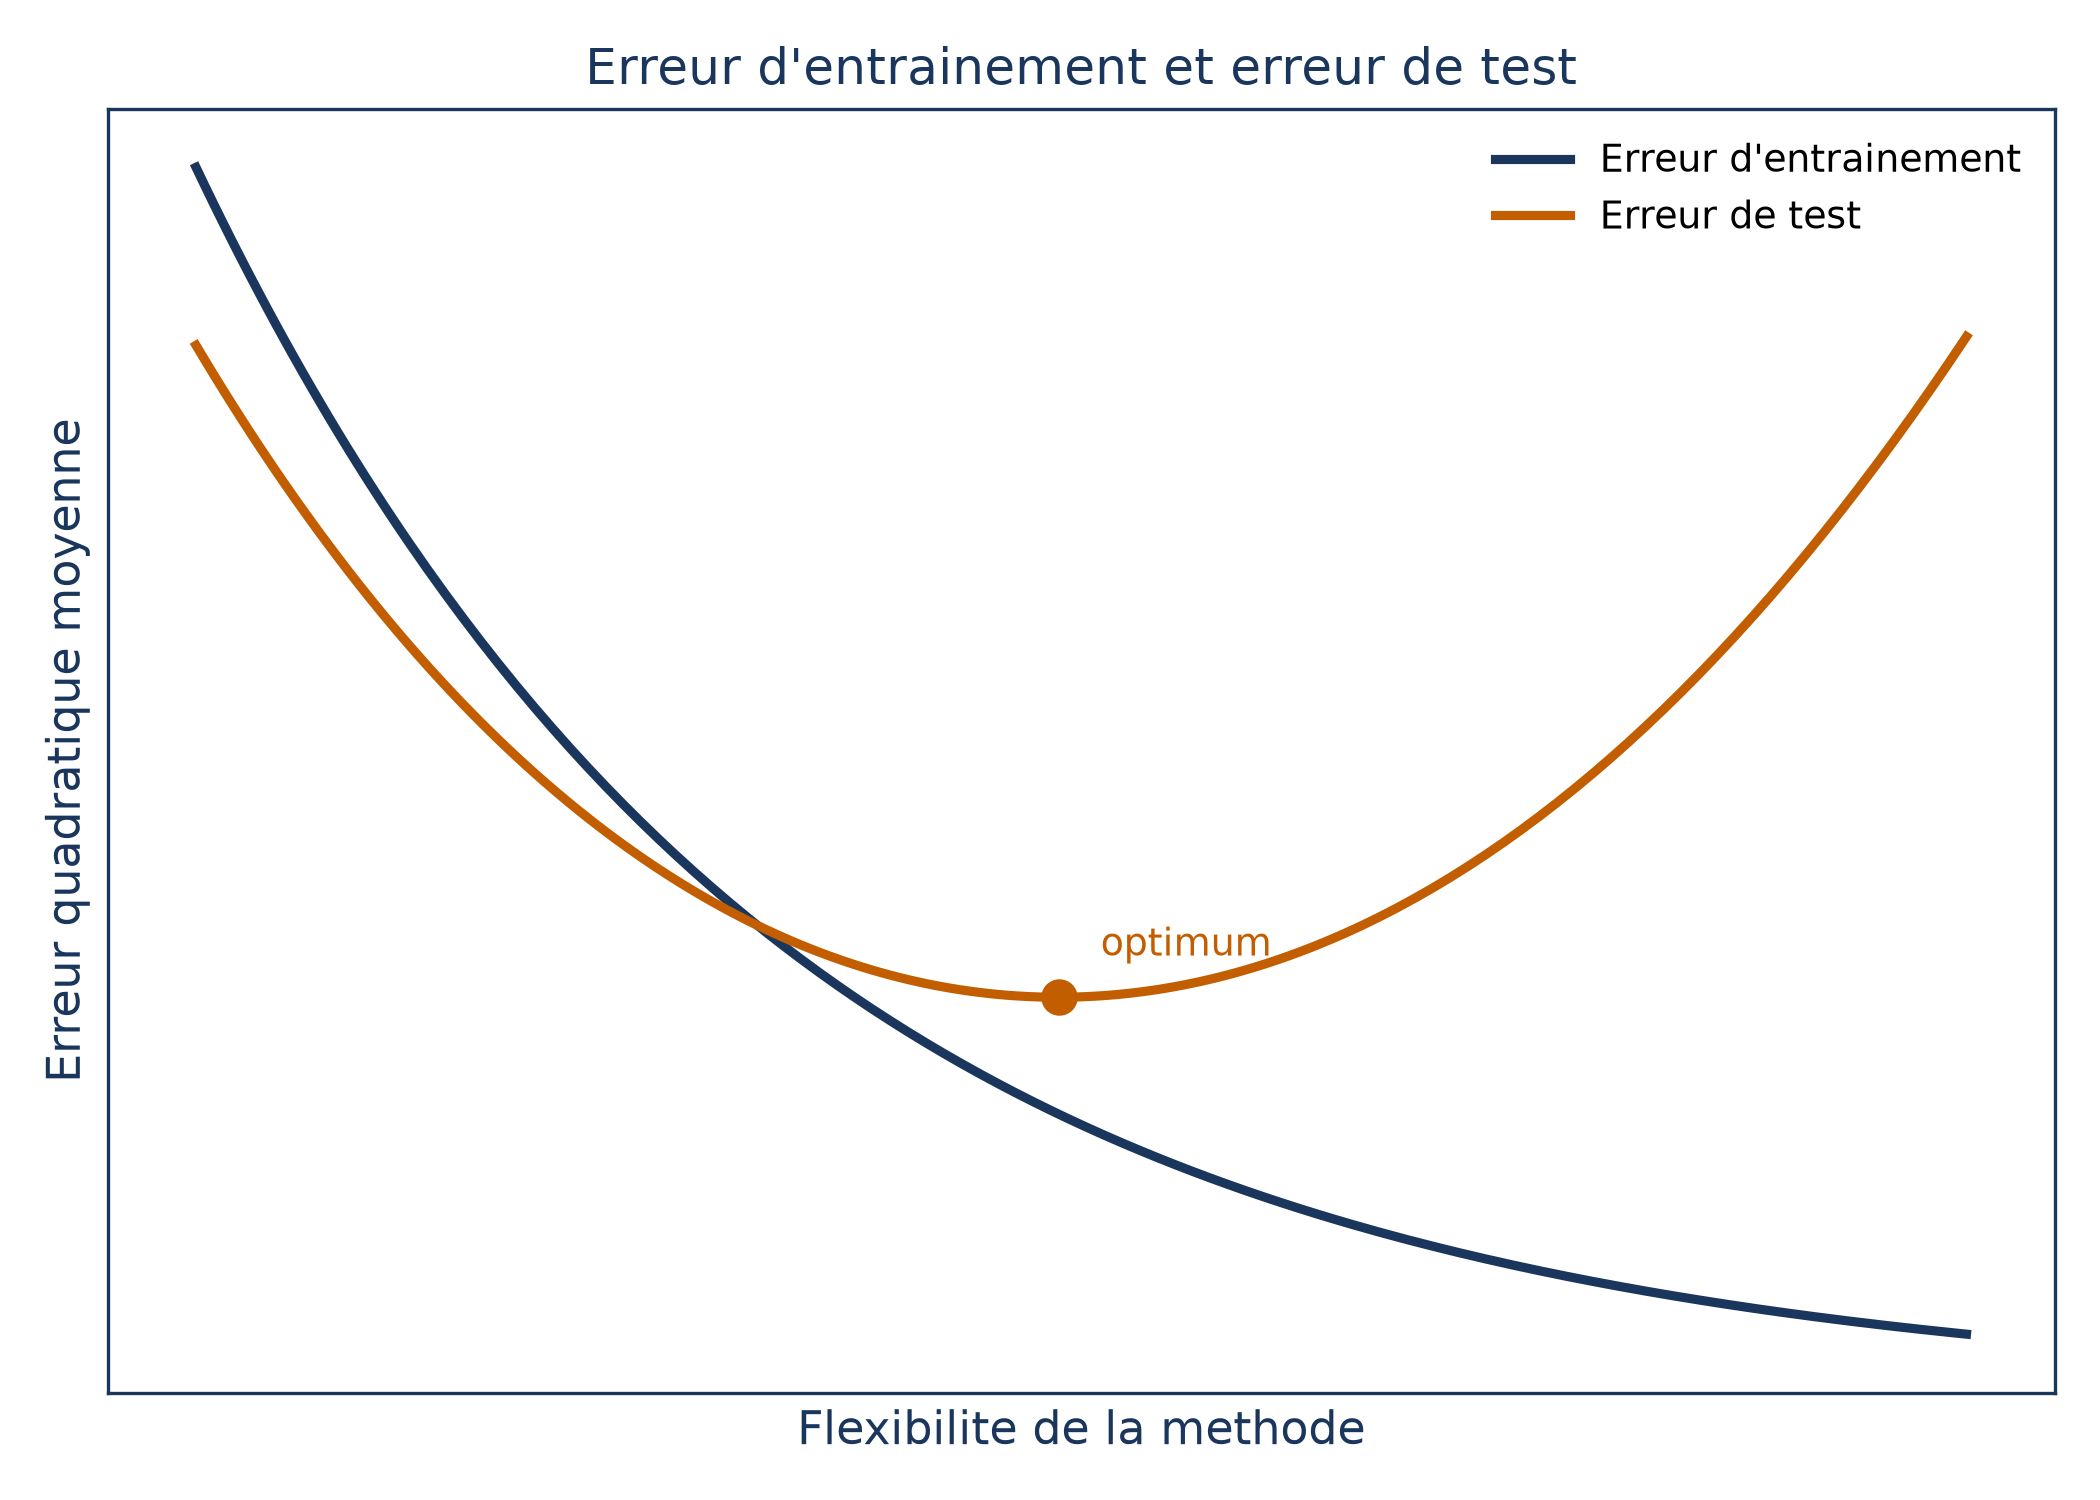
Reste un piège. Calculée sur les données qui ont servi à ajuster le modèle, la MSE s’appelle MSE d’entraînement ; or tu connais déjà ces réponses. Ce qui t’intéresse, c’est la capacité à prédire des observations nouvelles : la MSE de test. On en prend souvent la racine, qui s’exprime dans la même unité que la cible.
Deux façons de calculer les coefficients
Une fois le score choisi, il reste à trouver les coefficients qui le minimisent. Deux routes mènent au même point.
D’un seul coup : l’équation normale
Minimiser le coût revient à annuler ses dérivées partielles, c’est-à-dire sa pente par rapport à chaque coefficient, les autres étant tenus constants. Avec une seule variable, on obtient un système de deux équations linéaires, que l’on résout explicitement.
Une condition suffit pour que la solution existe : tes valeurs  ne doivent pas toutes coïncider. La matrice à inverser a pour déterminant
 fois une somme de carrés d’écarts à la moyenne, qui ne peut s’annuler que dans ce cas. Et c’est logique : sans variation de
 , aucune pente n’est mesurable.
Avec plusieurs variables, on range les observations dans une matrice de taille  , dont la première colonne ne contient que des 1 : elle absorbe l’ordonnée à l’origine. Annuler les dérivées donne l’équation normale,
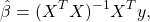
qui généralise à  dimensions les formules à une variable. Un logiciel l’applique sans effort sur des milliers, voire des millions d’observations.
Pas à pas : la descente de gradient
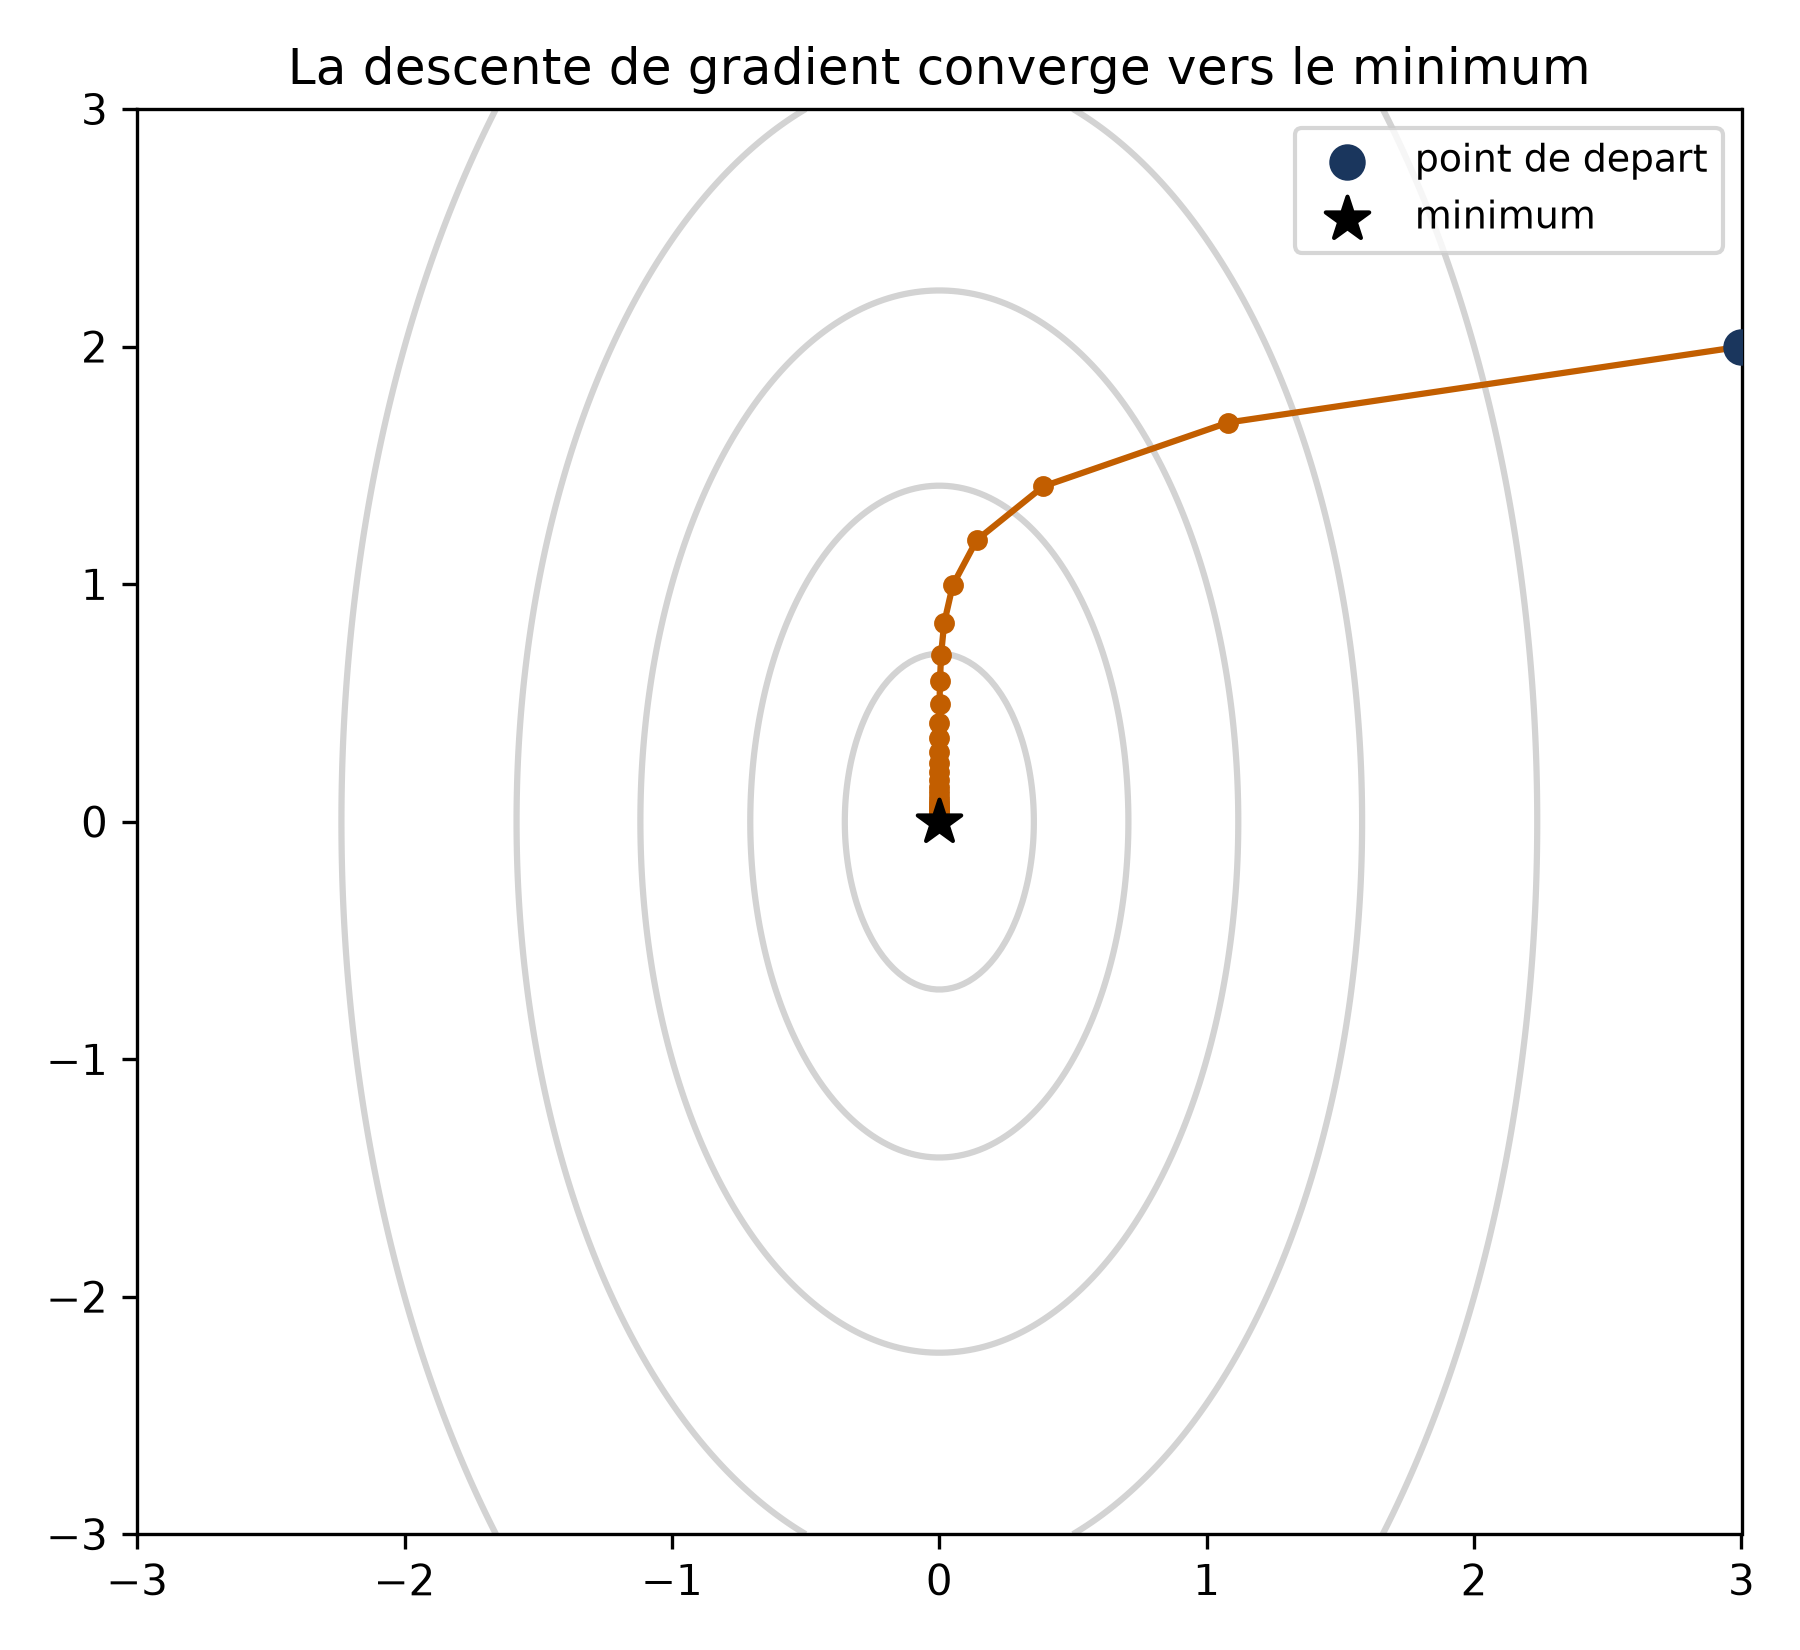
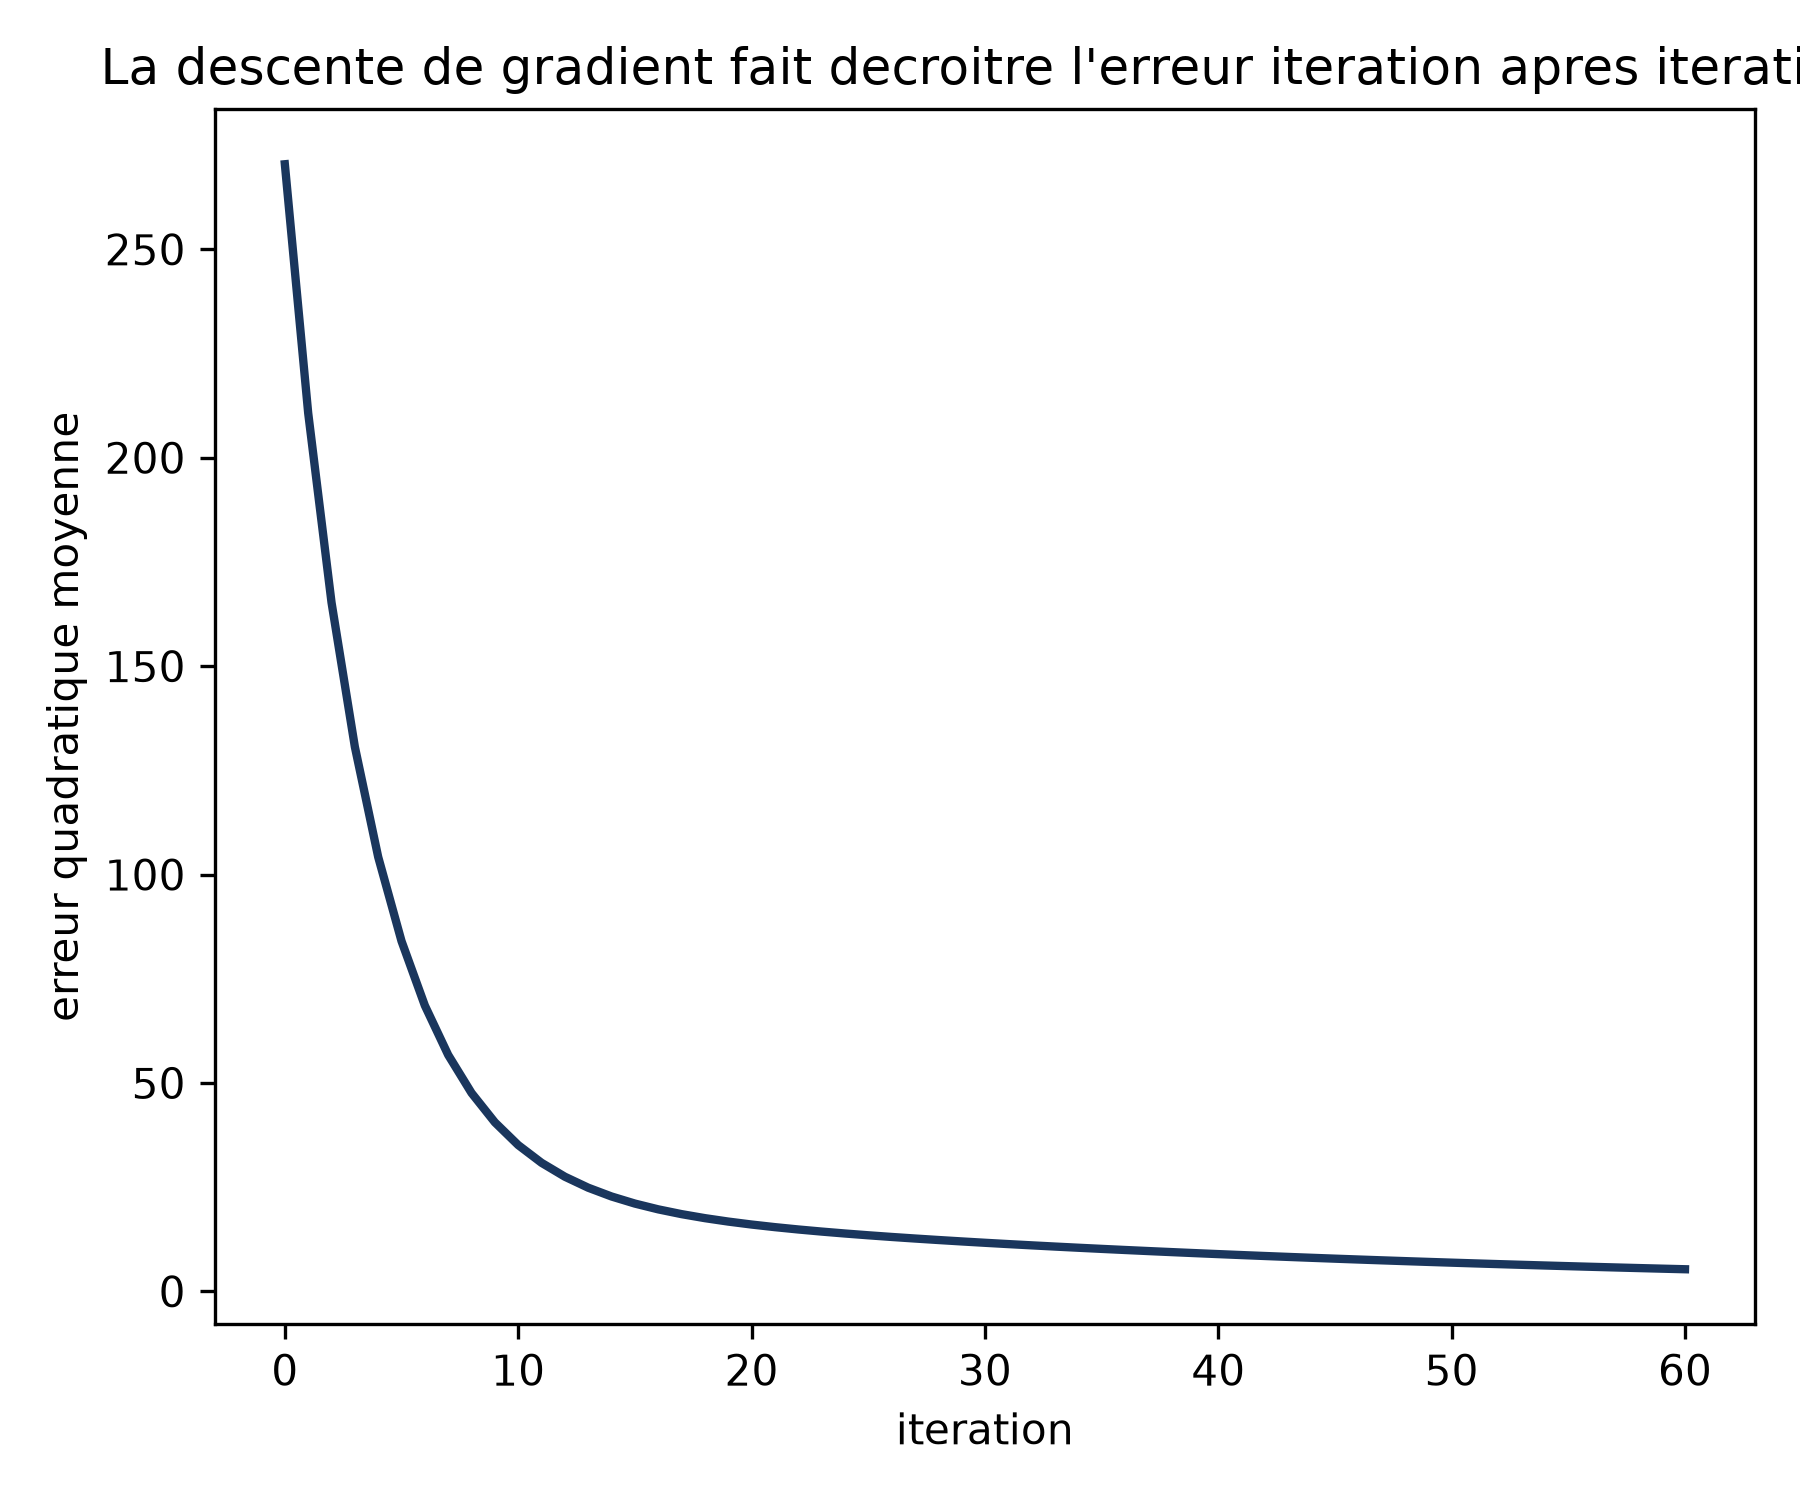
Cette solution exacte suppose de calculer  , opération coûteuse, voire impossible quand la matrice n’est pas inversible ou que les variables sont très nombreuses. On préfère alors une méthode itérative : partir de valeurs quelconques des coefficients, puis les mettre à jour en se déplaçant dans la direction opposée au gradient, jusqu’à ce que l’erreur devienne assez petite.
Le gradient pointe vers la plus forte augmentation de la fonction ; aller à l’opposé la fait donc décroître. Chaque pas a une taille, le taux d’apprentissage : trop grand, tu dépasses le minimum sans jamais t’en rapprocher ; trop petit, la convergence devient extrêmement lente.
⚠️ Piège Avant une descente de gradient, ramène tes variables à une même échelle, par exemple entre 0 et 1 : sans cela, une variable aux grandes valeurs domine le calcul du gradient du seul fait de son échelle.
Ce que la droite suppose sur le bruit
Le même problème se reformule avec des probabilités : 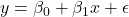 , avec trois hypothèses sur l’erreur. Pour chaque valeur de , les
 possibles suivent une loi normale ; sa moyenne se situe exactement sur la droite ; son écart-type, l’amplitude du bruit, reste constant quel que soit .
En maximisant la vraisemblance sous ces hypothèses, on retrouve exactement la même équation normale, et l’on obtient en prime un estimateur de la variance du bruit. Les coefficients ainsi calculés sont non biaisés : sur de nombreux échantillons, ils tombent en moyenne sur les vraies valeurs.
Un modèle rigide face aux modèles souples
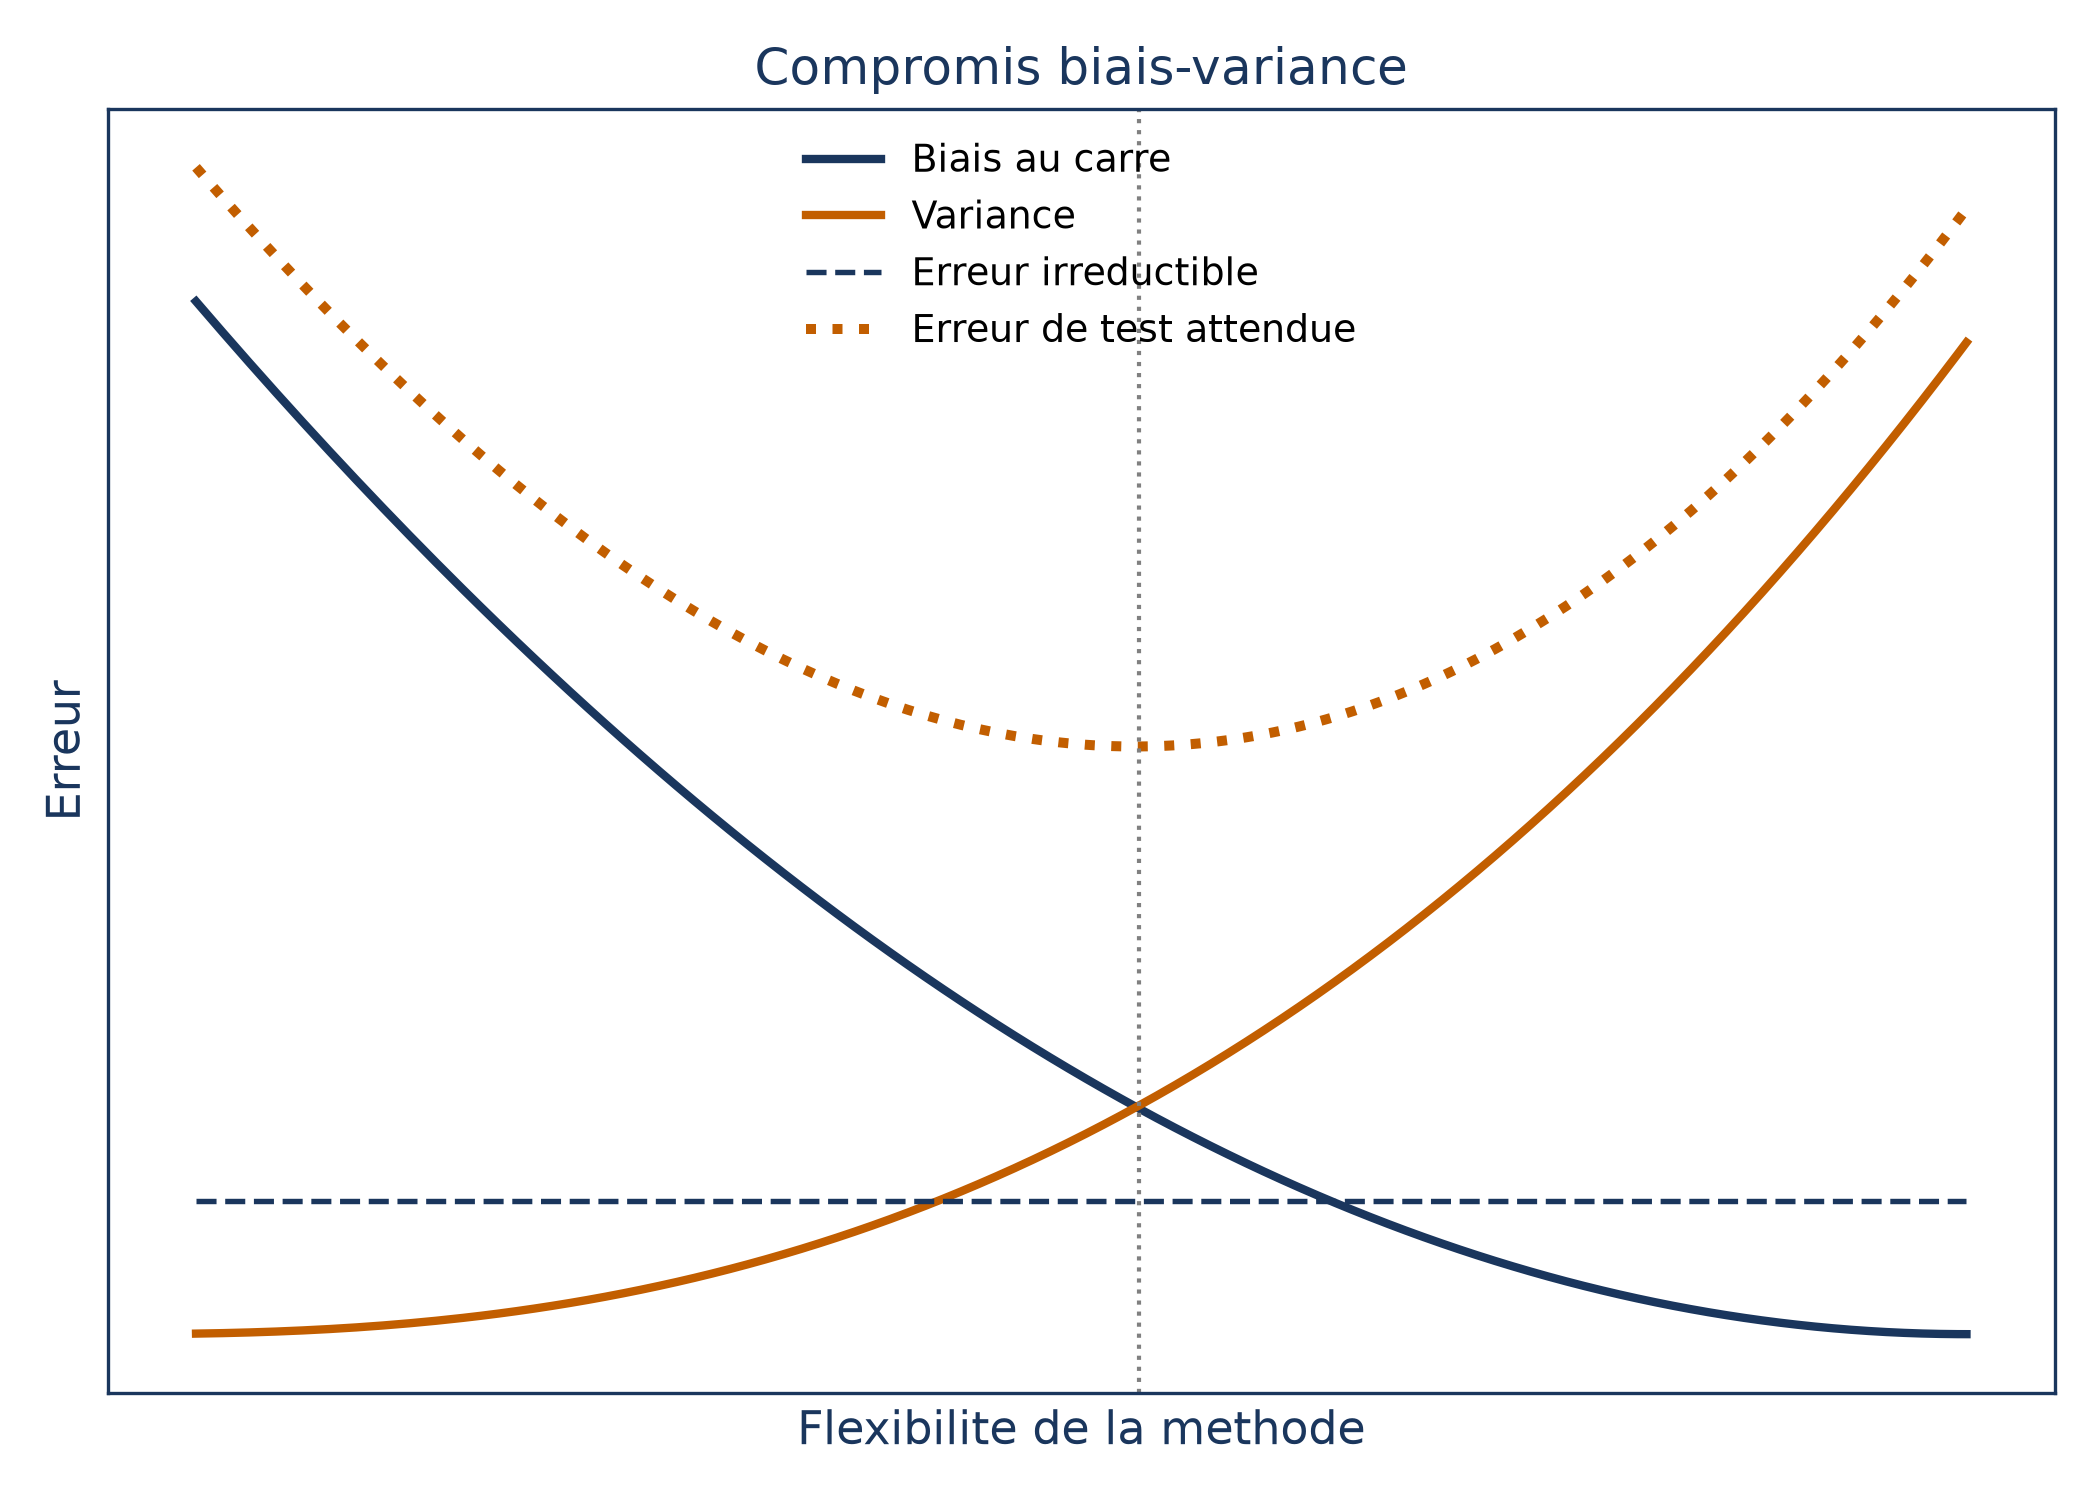
Cette hypothèse de droite a un coût, que le compromis biais-variance décrit bien. Le biais est l’erreur introduite quand on approxime un phénomène complexe par un modèle trop simple : la régression linéaire en introduit nécessairement dès que la vraie relation n’est pas linéaire. La variance mesure à quel point le modèle changerait si on l’estimait sur un autre échantillon.
Un test parlant : coupe un même jeu de données en deux moitiés et ajuste chacune. Une régression linéaire simple donne des droites quasi identiques, signe d’une faible variance. Un polynôme de degré 5 ajusté séparément produit des courbes sensiblement différentes : forte variance.
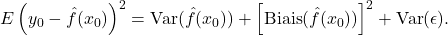
L’erreur de test attendue est la somme de la variance, du carré du biais et du bruit irréductible. Plus une méthode est flexible, plus son biais baisse et sa variance monte : au début le biais chute plus vite, puis l’inverse se produit, d’où le U de l’erreur de test.
Sa stabilité a pourtant une limite. Tant que  , le nombre d’observations, est bien plus grand que , le nombre de variables, la variance reste faible. Dès que n’est plus très supérieur à , elle explose ; et si
 , il existe une infinité de solutions qui collent parfaitement aux données d’entraînement, avec un RSS nul, mais dont les performances sur des données nouvelles sont en général catastrophiques.
Le remède classique est la régression ridge : on ajoute à l’objectif des moindres carrés une pénalité proportionnelle à la somme des carrés des coefficients, réglée par un paramètre  . Avec
 , tu retrouves les moindres carrés ordinaires ; en l’augmentant, les coefficients rétrécissent. L’estimateur devient légèrement biaisé, mais sa variance diminue parfois considérablement, et on choisit
 sur un ensemble de validation, jamais sur celui de test.
Voir tourner une régression avec scikit-learn
Passons à la pratique. Tu as un fichier de couples  déjà débarrassé de ses valeurs aberrantes, et tu veux la droite, mais aussi savoir si elle tient sur des points qu’elle n’a jamais croisés. Le script ci-dessous charge le fichier, répartit les données entre entraînement et test, ajuste un
LinearRegression de scikit-learn et mesure le coefficient de détermination  des deux côtés.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np

# Load cleaned dataset
cleaned_data = pd.read_csv('cleaned_data.csv')

X_clean = cleaned_data[['X']].values
y_clean = cleaned_data['Y'].values

# Split data (70% train, 30% test)
X_train, X_test, y_train, y_test = train_test_split(
X_clean, y_clean, test_size=0.3, random_state=42)

# Train model
model = LinearRegression()
model.fit(X_train, y_train)

# Predict and evaluate
y_pred = model.predict(X_test)

train_r2 = r2_score(y_train, model.predict(X_train))
test_r2 = r2_score(y_test, y_pred)

print("\nModel Report:")
print(f"Coefficient (slope): {model.coef_[0]:.4f}")
print(f"Intercept: {model.intercept_:.4f}")
print(f"Training R²: {train_r2:.4f}")
print(f"Test R²: {test_r2:.4f}")
X_clean contient le prédicteur et y_clean la réponse ; train_test_split en réserve 30 % pour le test. L’ajustement se fait sur l’entraînement seul (model.fit), puis model.predict produit les prédictions sur le test. Les lignes d’affichage te rendent la pente (coef_) et l’ordonnée à l’origine (intercept_) : ce sont  et
 de tout à l’heure. Le script trace ensuite la droite avec matplotlib, étape que je laisse de côté.
Le script applique une règle simple : un modèle s’entraîne sur l’ensemble d’entraînement, se règle sur un ensemble de validation et s’évalue enfin sur un ensemble de test que le modèle n’a jamais vu.
⚠️ Piège Un
Quatre idées reçues sur la droite et ses chiffres
« Mon R² a monté, mon modèle est meilleur. » Pas forcément : le augmente toujours quand tu ajoutes une variable, même sans lien avec la réponse, puisqu’un prédicteur de plus ne peut jamais faire remonter le RSS d’entraînement. À l’inverse, une hausse quasi nulle signale qu’on peut raisonnablement s’en passer.
« Ce coefficient est significatif : le lien est réel. » Avec un grand nombre de prédicteurs, tu t’attends à voir par pur hasard quelques p-valeurs individuelles sous 0,05, même sans aucune vraie association. La statistique  globale tient compte du nombre de prédicteurs et vaut environ 1 quand aucun n’est lié à la réponse.
« La prédiction est un chiffre exact. » Trois sources d’incertitude s’accumulent : l’imprécision des coefficients, l’approximation de supposer linéaire, et l’erreur irréductible . Sur un jeu de prix de logements, pour une valeur donnée du prédicteur (lstat = 10), la même prédiction de 25,05 est entourée d’un intervalle de confiance à 95 % de (24,47 ; 25,63) pour la réponse moyenne, mais d’un intervalle de prédiction bien plus large, (12,82 ; 37,28), pour une observation individuelle.
« Ce lien prouve une influence. » Une régression simple peut attribuer à une variable l’effet d’une autre qui lui est corrélée. C’est le mécanisme des ventes de glaces et des attaques de requins : ce n’est pas la glace qui attire les requins, mais la chaleur qui pousse à la fois à consommer des glaces et à se baigner.
📌 À retenir Une régression linéaire pose que la réponse est une combinaison linéaire des prédicteurs plus un bruit, cherche les coefficients qui minimisent la moyenne des carrés des écarts, et ne vaut que par ce qu’elle prédit sur des données nouvelles.