« L’animal n’a pas traversé la rue parce qu’elle était trop large. » Tu sais sans effort que « elle » désigne la rue, pas l’animal. Pour une machine, c’est un vrai casse-tête : il faut relier deux mots éloignés l’un de l’autre. Le Transformer est l’architecture qui sait le faire, et celle sur laquelle reposent presque tous les grands modèles de langage actuels. À la fin de cette lecture, tu sauras expliquer de quoi il est fait, comment il apprend et où il s’arrête.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi les réseaux récurrents ont atteint leur limite
- Ce qu’est un Transformer : une pile de blocs d’auto-attention
- L’auto-attention : chaque mot interroge tous les autres
- Un bloc, quatre pièces, et un détail d’ordre
- Encodeur, décodeur ou les deux ?
- Comment il apprend : deviner le mot suivant
- À quoi on l’utilise
- Ce qu’un Transformer ne fait pas : limites et idées reçues
L’essentiel en 30 secondes
- Un Transformer est une pile de blocs quasi identiques, tous construits autour de l’auto-attention : chaque mot pondère l’importance de tous les autres.
- Il a supprimé les réseaux récurrents : plus de lecture mot après mot, donc des calculs parallélisables sur GPU.
- Chaque bloc combine attention, réseau feedforward, raccourcis et normalisation, et un encodage positionnel rend à la phrase son ordre.
- Il existe encodeur seul, décodeur seul, ou les deux ; presque tous les modèles génératifs sont des décodeurs seuls.
- Son talon d’Achille est un coût quadratique avec la longueur du texte.
Pourquoi les réseaux récurrents ont atteint leur limite
Avant le Transformer, on lisait le texte comme on lit à voix haute : un mot après l’autre, en gardant en mémoire un résumé de ce qui précède. C’est le principe du réseau récurrent (RNN), qui maintient un état interne mis à jour à chaque mot.
Pour traduire, on branchait deux de ces réseaux bout à bout : un encodeur qui condense la phrase d’entrée en une représentation succincte, un décodeur qui s’en sert pour écrire la traduction.
Cette mécanique pose trois problèmes. D’abord l’alignement : traduire « she doesn’t like potatoes » par « elle n’aime pas les pommes de terre » fait passer de quatre à six mots, et il faut savoir quel mot répond à quel mot. Ensuite les gradients qui s’évanouissent ou explosent, ce qui empêche d’empiler beaucoup de couches. Enfin, un calcul impossible à paralléliser, avec un réseau qui oublie après quelques pas.
La première réponse a été le mécanisme d’attention. Au lieu de transmettre un seul état caché, on transmet un contexte qui se concentre, à chaque mot produit, sur les parties utiles de la phrase d’entrée.
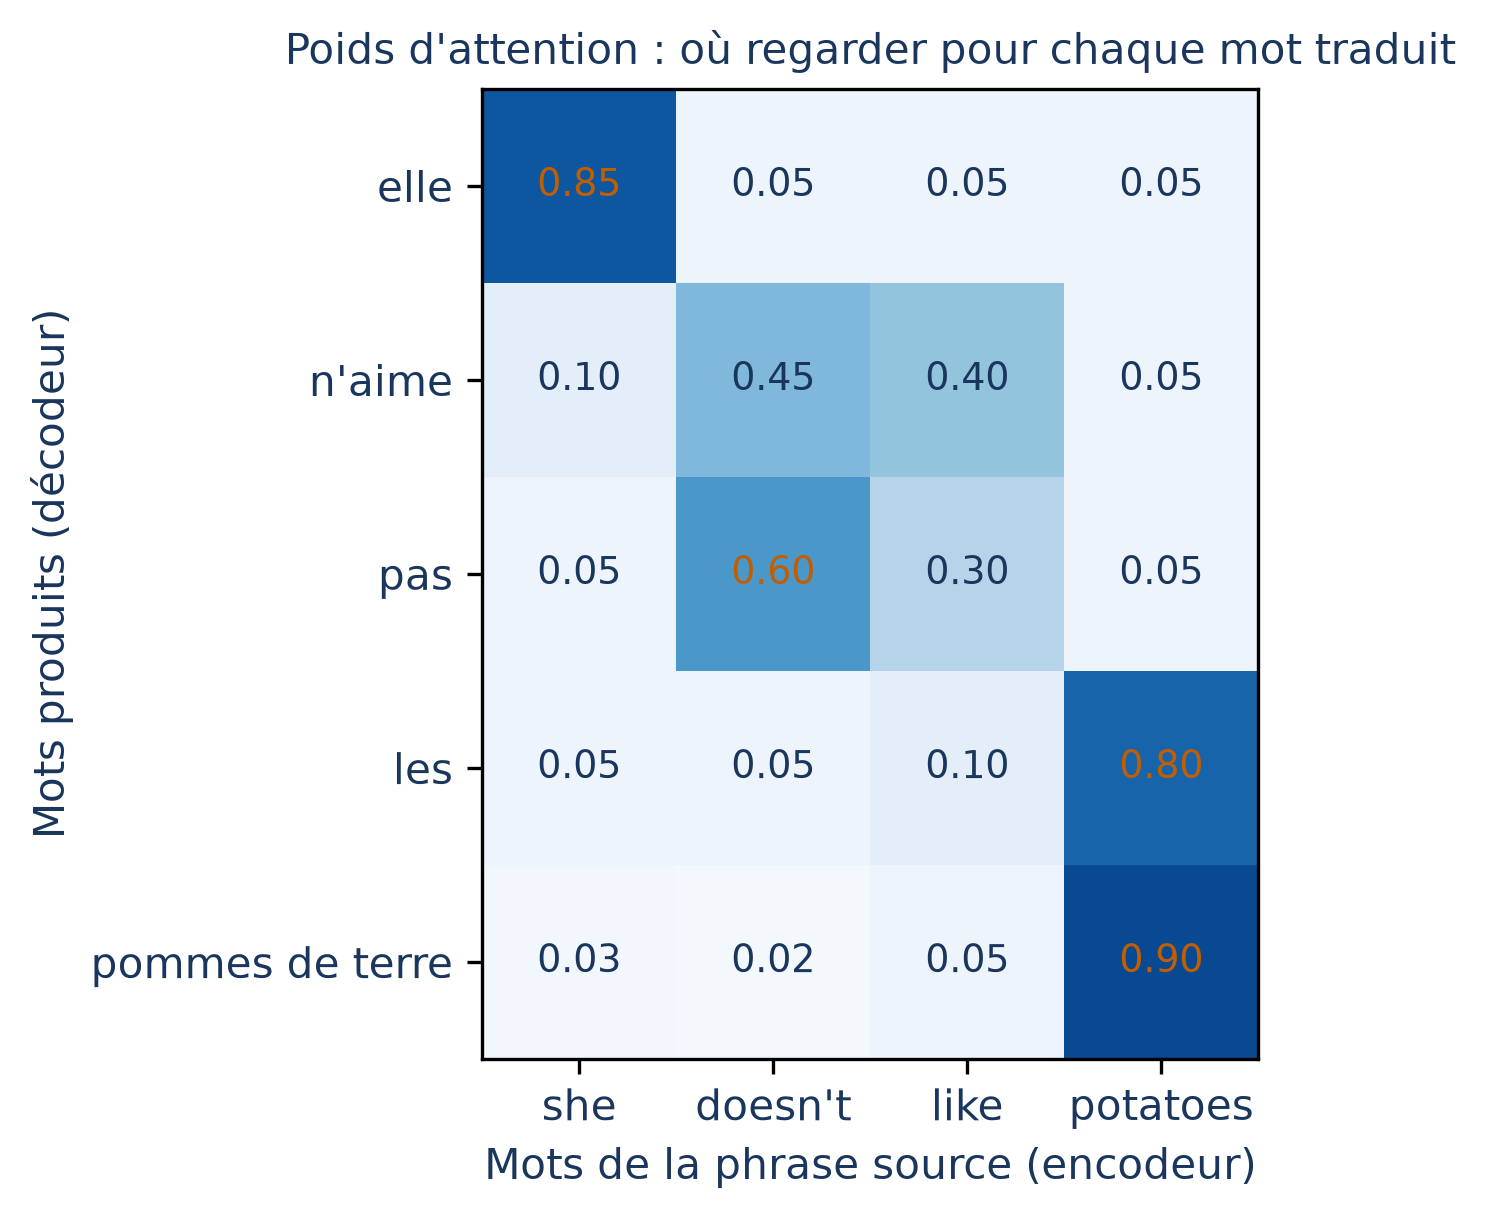
Cette idée a des bénéfices en cascade : elle offre un raccourci vers les états précoces (donc moins de gradient évanescent), supprime le goulot d’étranglement du résumé unique et laisse voir quels mots ont servi à l’alignement.
Des chercheurs de Google en ont tiré une conclusion radicale : plutôt que d’améliorer les réseaux récurrents, les supprimer purement et simplement. Le Transformer est né de ce pari, en 2017.
Ce qu’est un Transformer : une pile de blocs d’auto-attention
Un Transformer est un modèle d’apprentissage profond constitué de couches d’auto-attention multi-tête empilées, qui apprend ainsi une représentation du texte de plus en plus riche à mesure qu’on monte dans la pile.
Le texte y entre sous forme de nombres. Une première étape, la tokenisation, le découpe en jetons ; une seconde, l’embedding, associe un vecteur à chaque jeton.
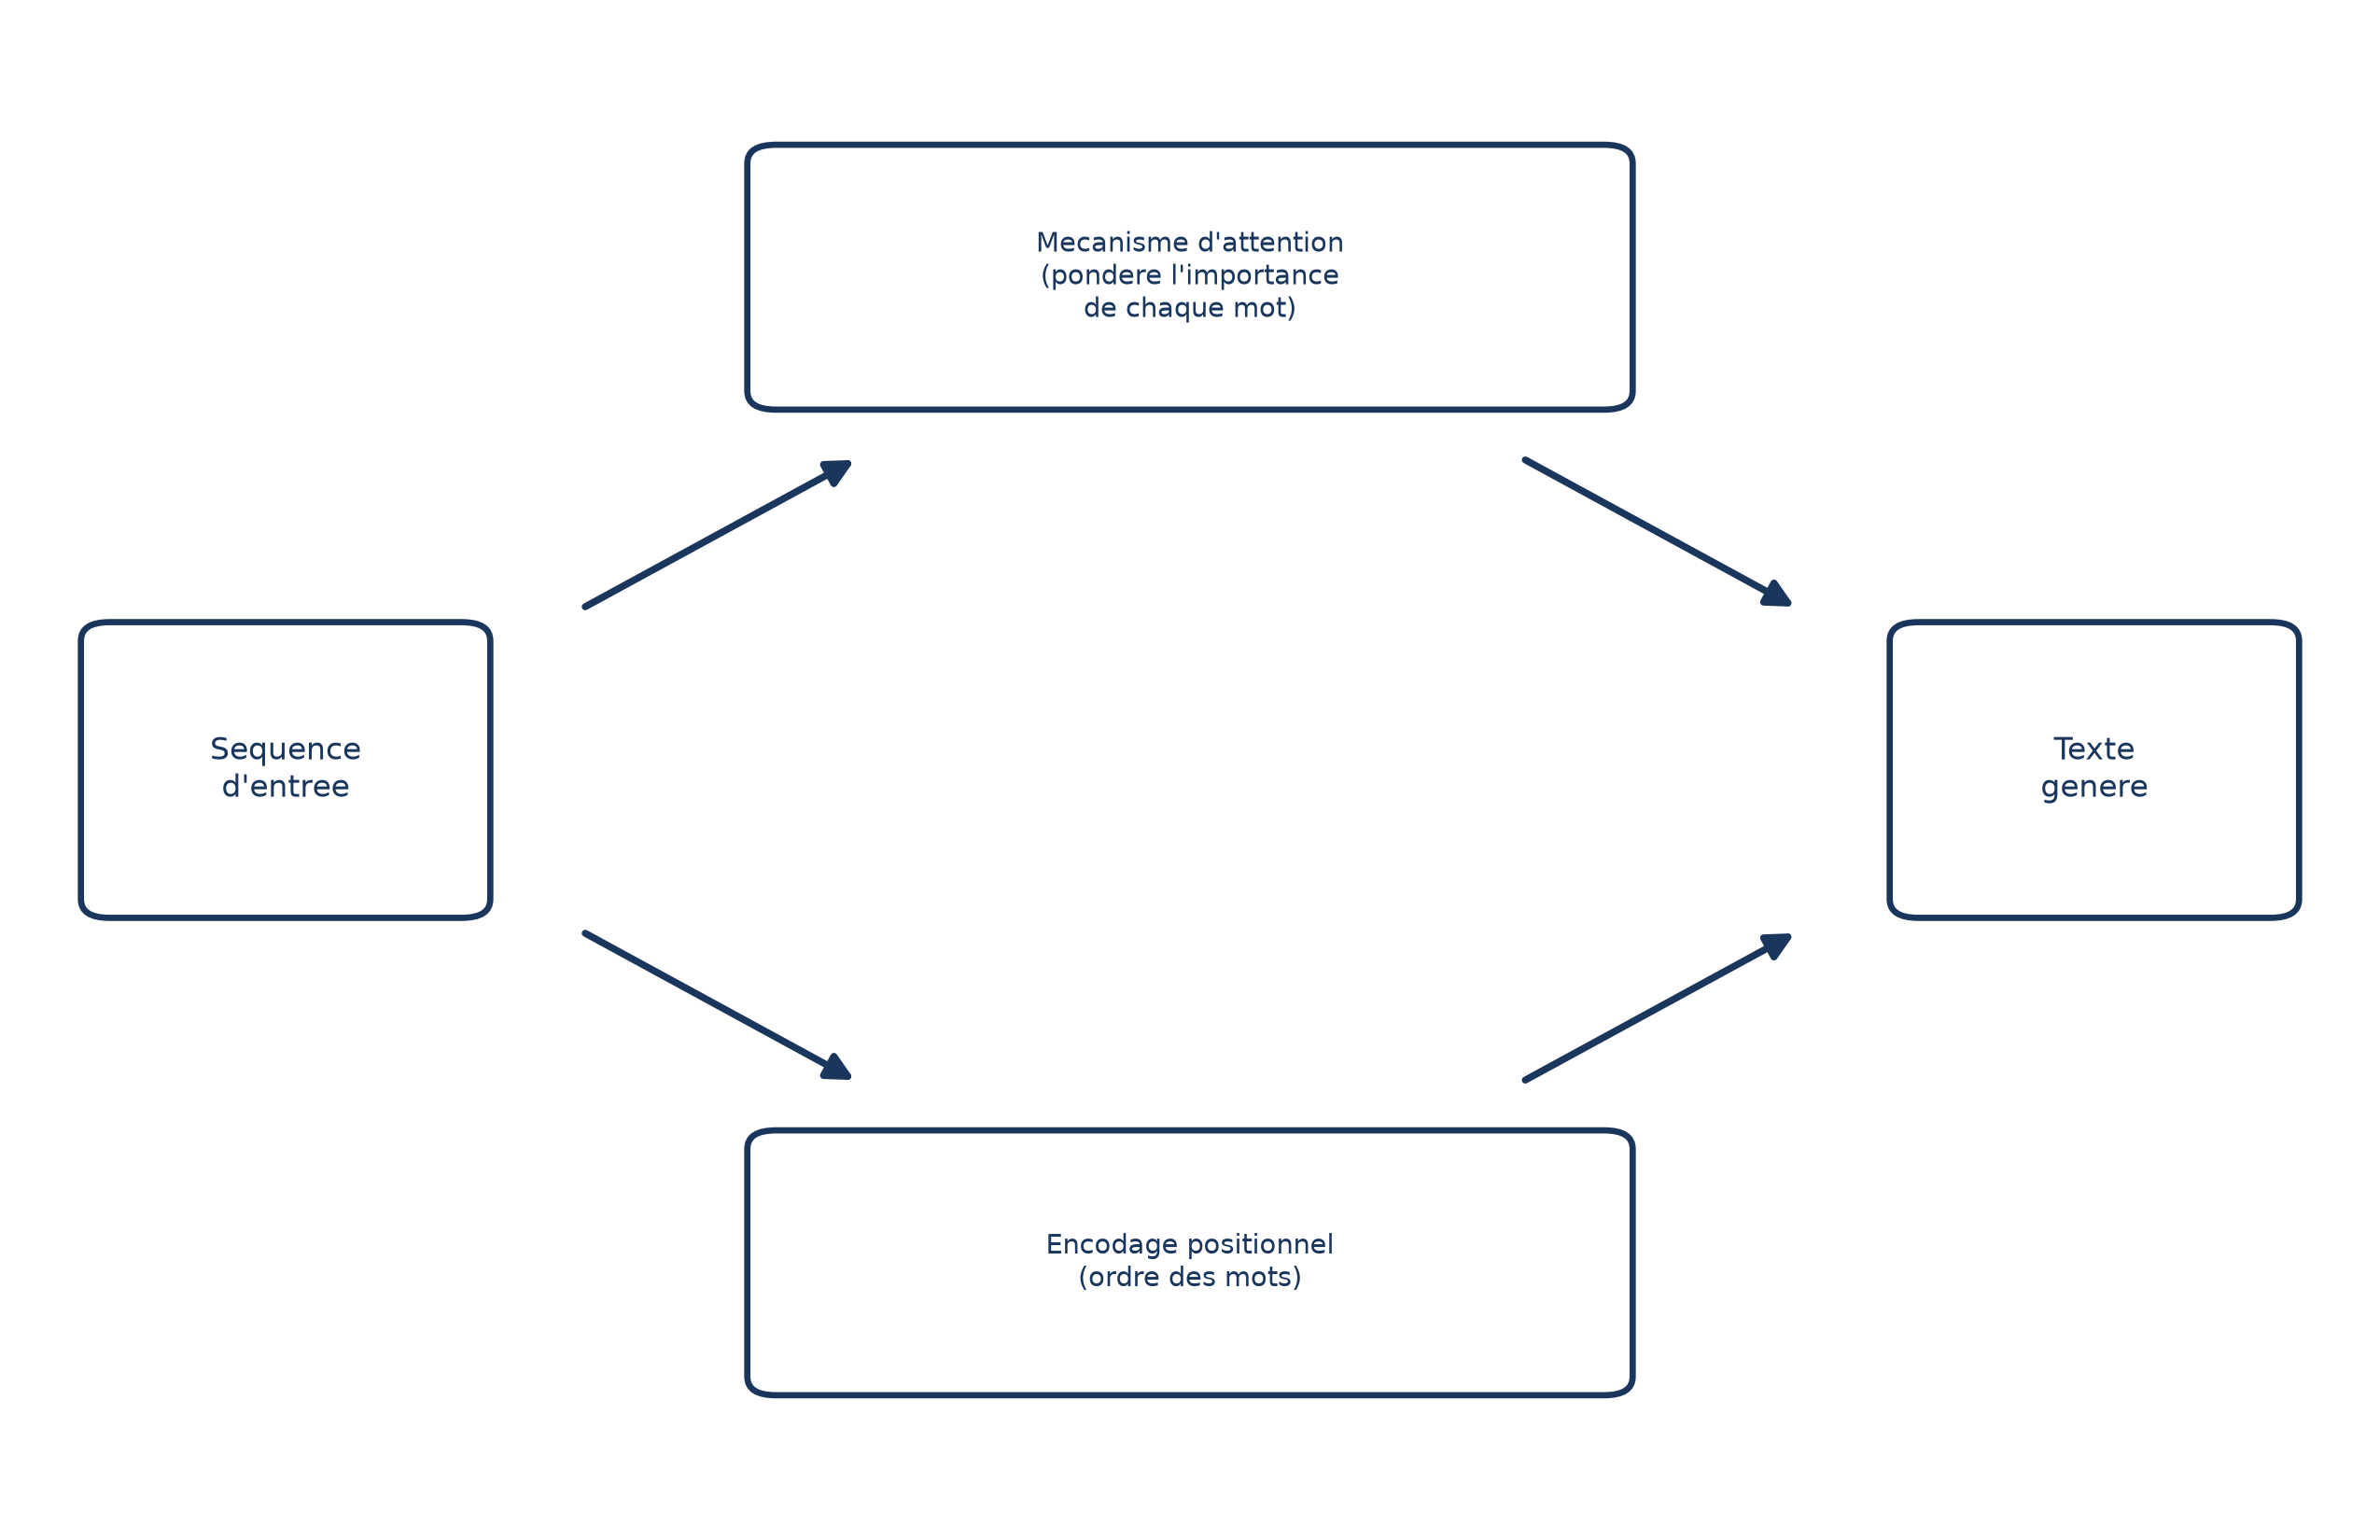
Deux mécanismes se partagent ensuite le travail : l’attention, qui pèse l’importance de chaque mot pour chaque autre, et l’encodage positionnel, qui garde la trace de l’ordre des mots.
Un point de vocabulaire : un LLM est simplement un Transformer de plus de 10 milliards de paramètres, entraîné sur d’énormes quantités de texte à prédire le mot suivant.
L’auto-attention : chaque mot interroge tous les autres
Pour saisir le principe, pense à une bibliothèque. Tu prépares un essai sur la Révolution française : c’est ta requête. Tu ne lis pas tous les volumes ; tu parcours les dos (les clés) pour repérer ceux d’histoire de France, dont le contenu (la valeur) t’intéresse. L’auto-attention, c’est cette recherche menée par chaque mot dans son propre contexte.
Concrètement, l’entrée  est un tableau qui contient un vecteur par jeton. On la multiplie par trois matrices de poids, apprises pendant l’entraînement :
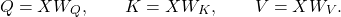
 est le centre d’attention du moment,
 renseigne le modèle sur les autres entrées, et
 sert à extraire l’information finale.
Il reste à comparer et à mélanger :
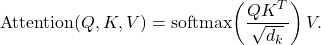
Le produit  compare chaque requête à chaque clé, la softmax transforme ces scores en poids compris entre 0 et 1, et ces poids servent à faire une moyenne pondérée des valeurs .
Le diviseur  n’est pas décoratif : quand les vecteurs s’allongent, le produit scalaire devient très grand, la softmax concentre alors toute la probabilité sur quelques éléments et les gradients deviennent minuscules. Diviser par la racine de la dimension corrige cela.
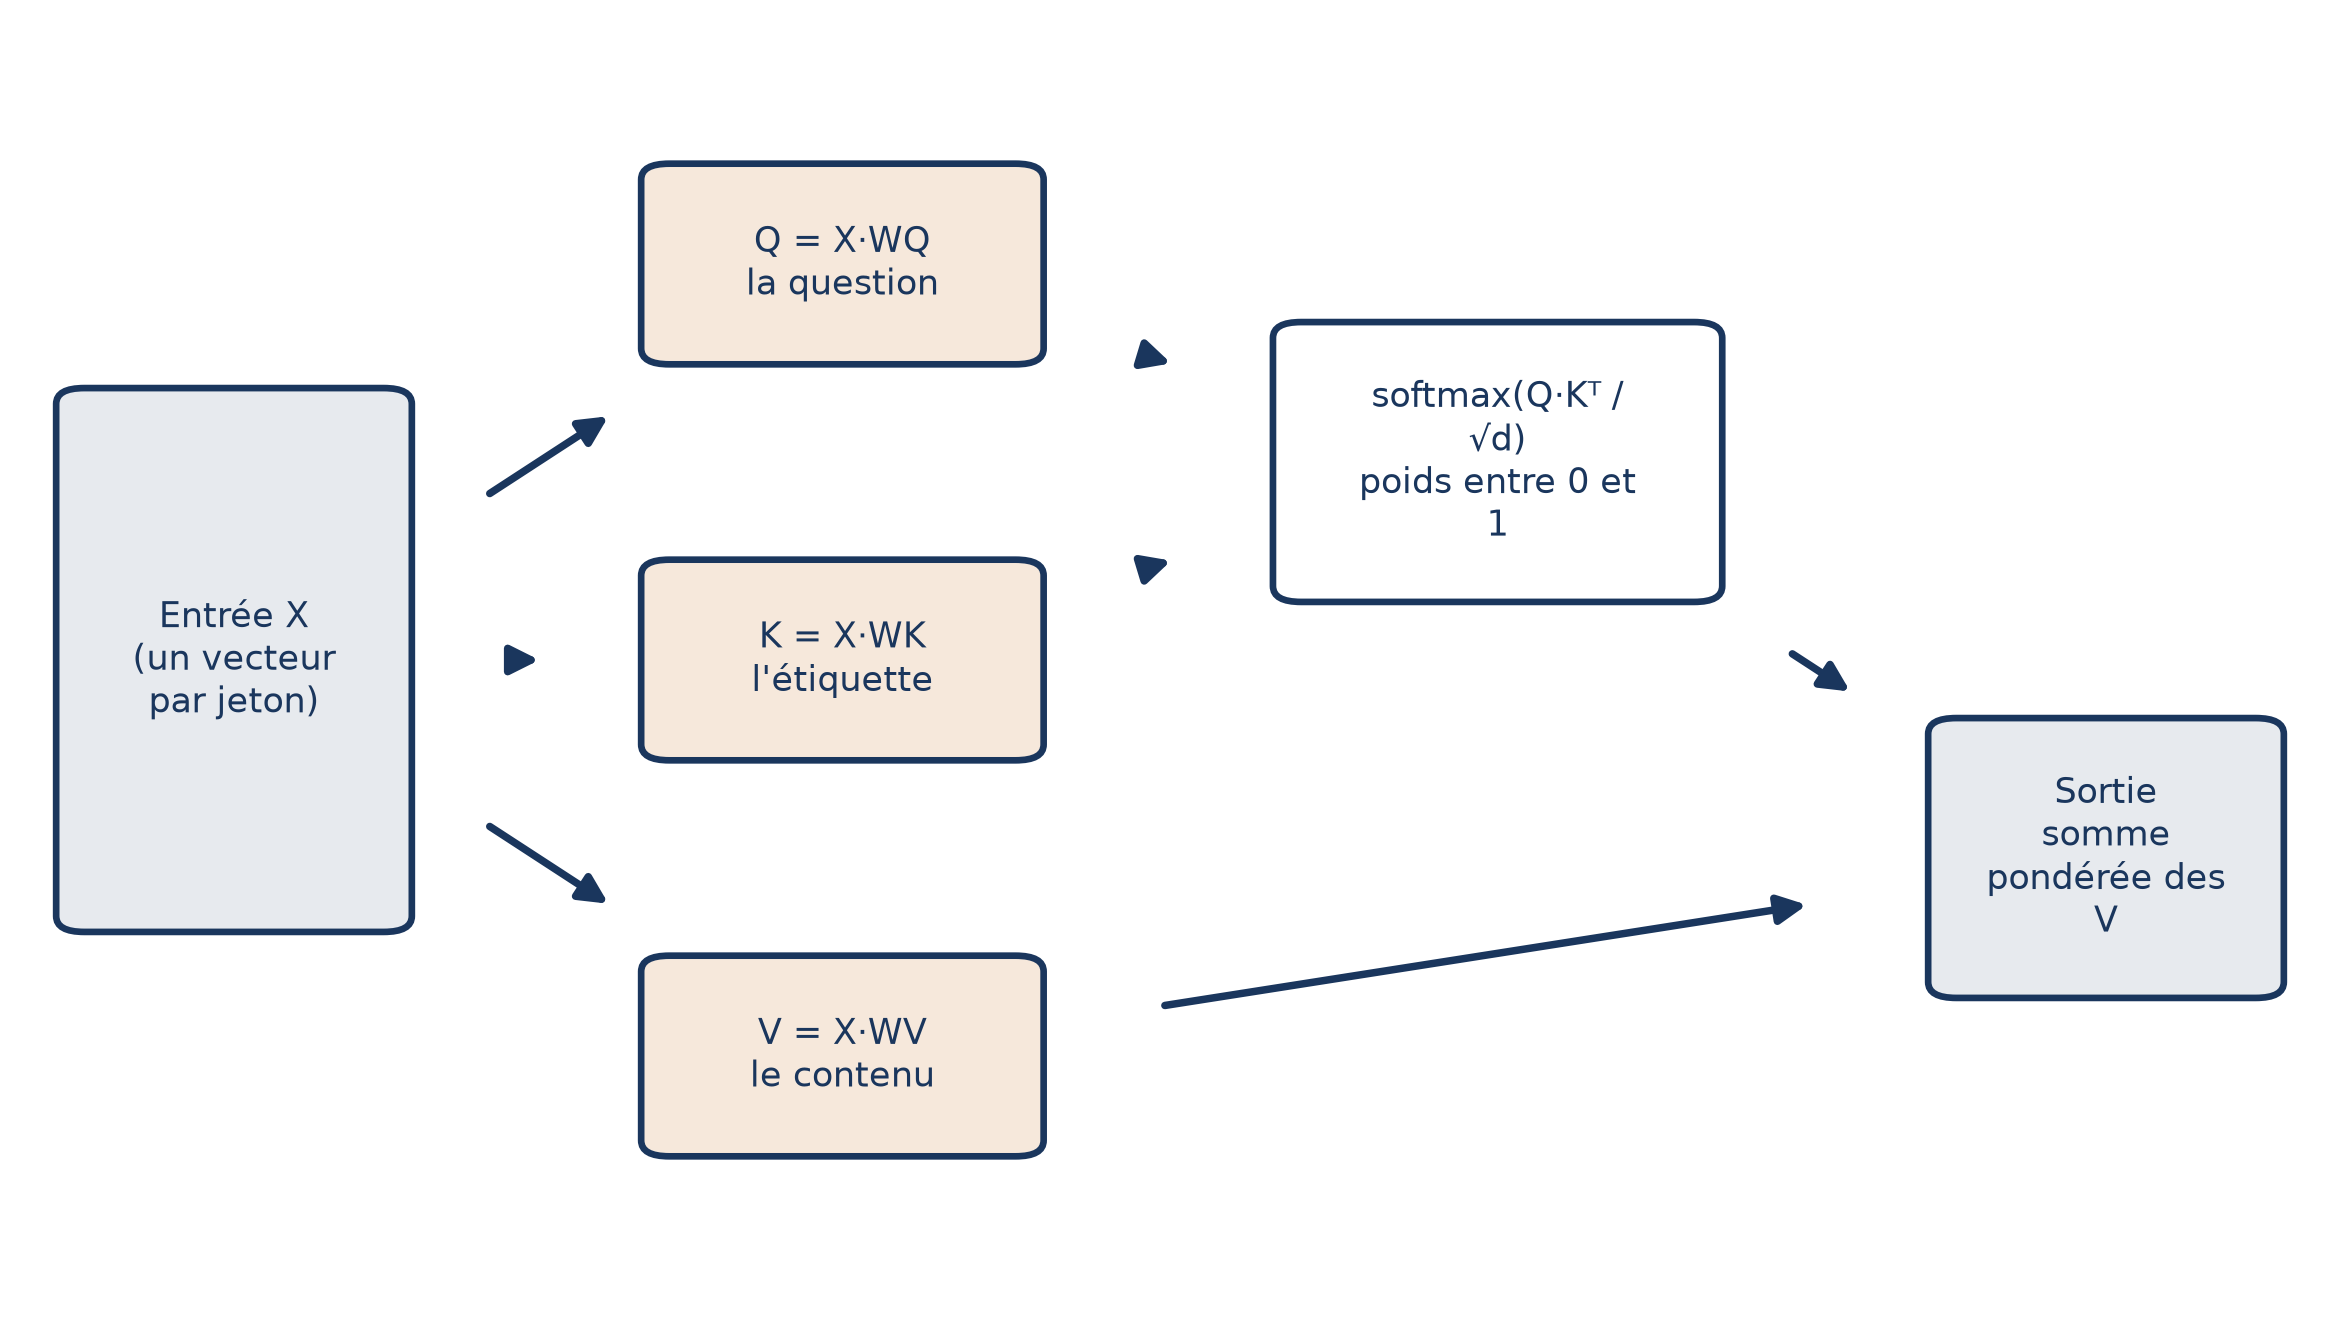
Un seul calcul de ce genre ne capte qu’un type de lien. L’attention multi-tête en lance plusieurs en parallèle : un même mot peut être relié à plusieurs autres, chacun sous un angle différent. À l’entraînement, les matrices et de chaque tête se spécialisent dans des relations distinctes ; les sorties sont concaténées puis ramenées à la taille d’entrée par une projection linéaire.
On peut regarder ces têtes travailler. Avec la bibliothèque BERTviz, une seule ligne ouvre une vue interactive des poids d’attention :
head_view(attention, tokens, sentence_b_start)
Ici, attention, tokens et sentence_b_start viennent d’un modèle BERT déjà passé sur une paire de phrases. Ce modèle compte 12 têtes dans chacune de ses 12 couches, soit 144 têtes d’attention, donc plus de cent lectures différentes d’une même phrase.
💡 Intuition L’auto-attention n’a pas besoin qu’on lui dise quoi regarder : elle apprend, pour chaque mot, quels autres mots méritent d’être consultés.
Un bloc, quatre pièces, et un détail d’ordre
L’auto-attention ne connaît pas l’ordre des mots : « le chien mord l’homme » et « l’homme mord le chien » lui paraissent identiques. D’où l’encodage positionnel, une fonction qui s’ajoute aux embeddings pour inscrire la position de chaque jeton :
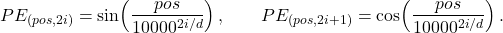
Pour chaque position  et chaque dimension (paire ou impaire), on obtient une valeur de sinus ou de cosinus ; cette fonction n’a aucun paramètre à apprendre.
Le vecteur ainsi enrichi entre dans un bloc transformer, composé de quatre éléments : l’attention multi-tête, une couche feedforward, des connexions résiduelles et une normalisation de couche.
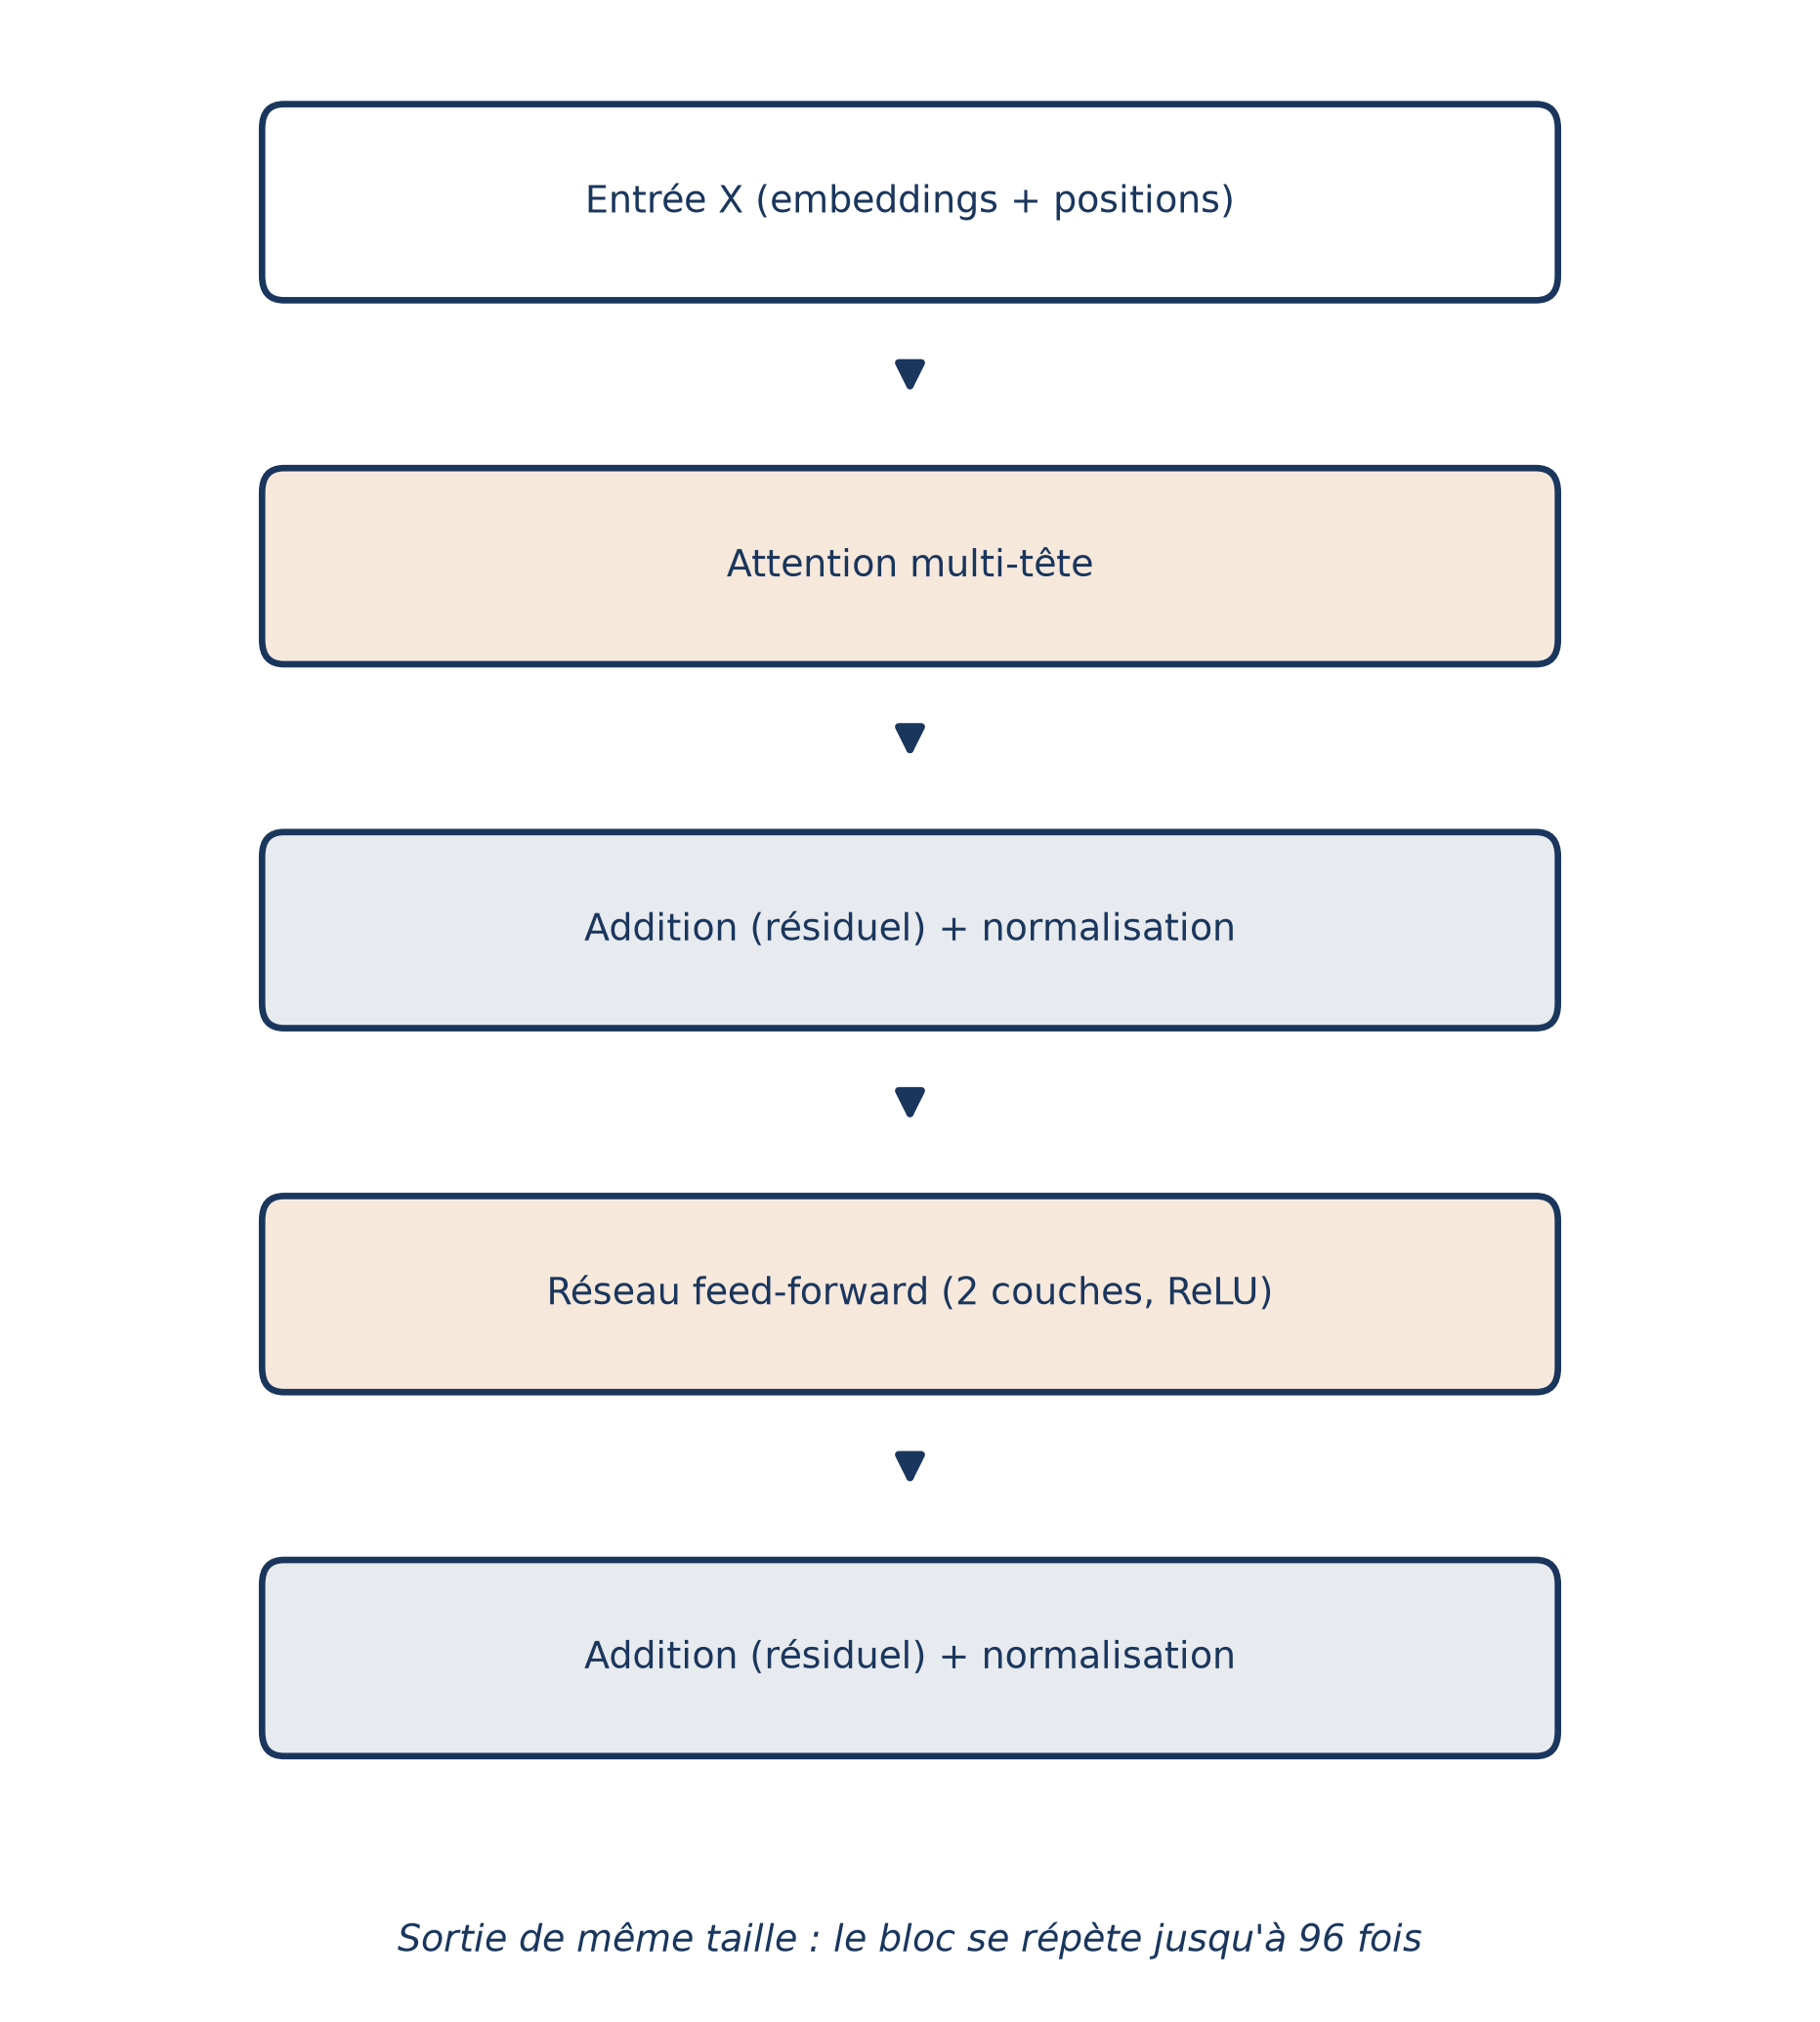
Le réseau feedforward est formé de deux couches linéaires séparées par une activation ReLU, avec des poids propres à chaque position :
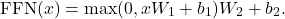
Il ajoute de la non-linéarité à l’attention et se parallélise facilement. Il pèse aussi lourd : environ 66 % des paramètres du bloc.
Les connexions résiduelles additionnent l’entrée d’une sous-couche à sa sortie, ce qui crée un raccourci par lequel le gradient redescend vers les couches basses. Il y en a deux par bloc, autour de l’attention et autour du feedforward.
La normalisation de couche garde les valeurs cachées dans une plage stable en centrant et réduisant chaque vecteur :
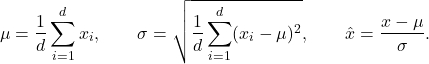
Ici  est la moyenne du vecteur
 de dimension
 ,
 son écart-type, et
 le vecteur recentré ; deux paramètres appris (
 et
 ) remettent ensuite le résultat à l’échelle. Cela réduit la variabilité sans intérêt pour l’apprentissage.
Reste à empiler. Un modèle moderne enchaîne jusqu’à 96 blocs de structure presque identique, et le texte gagne en contexte à chaque étage.
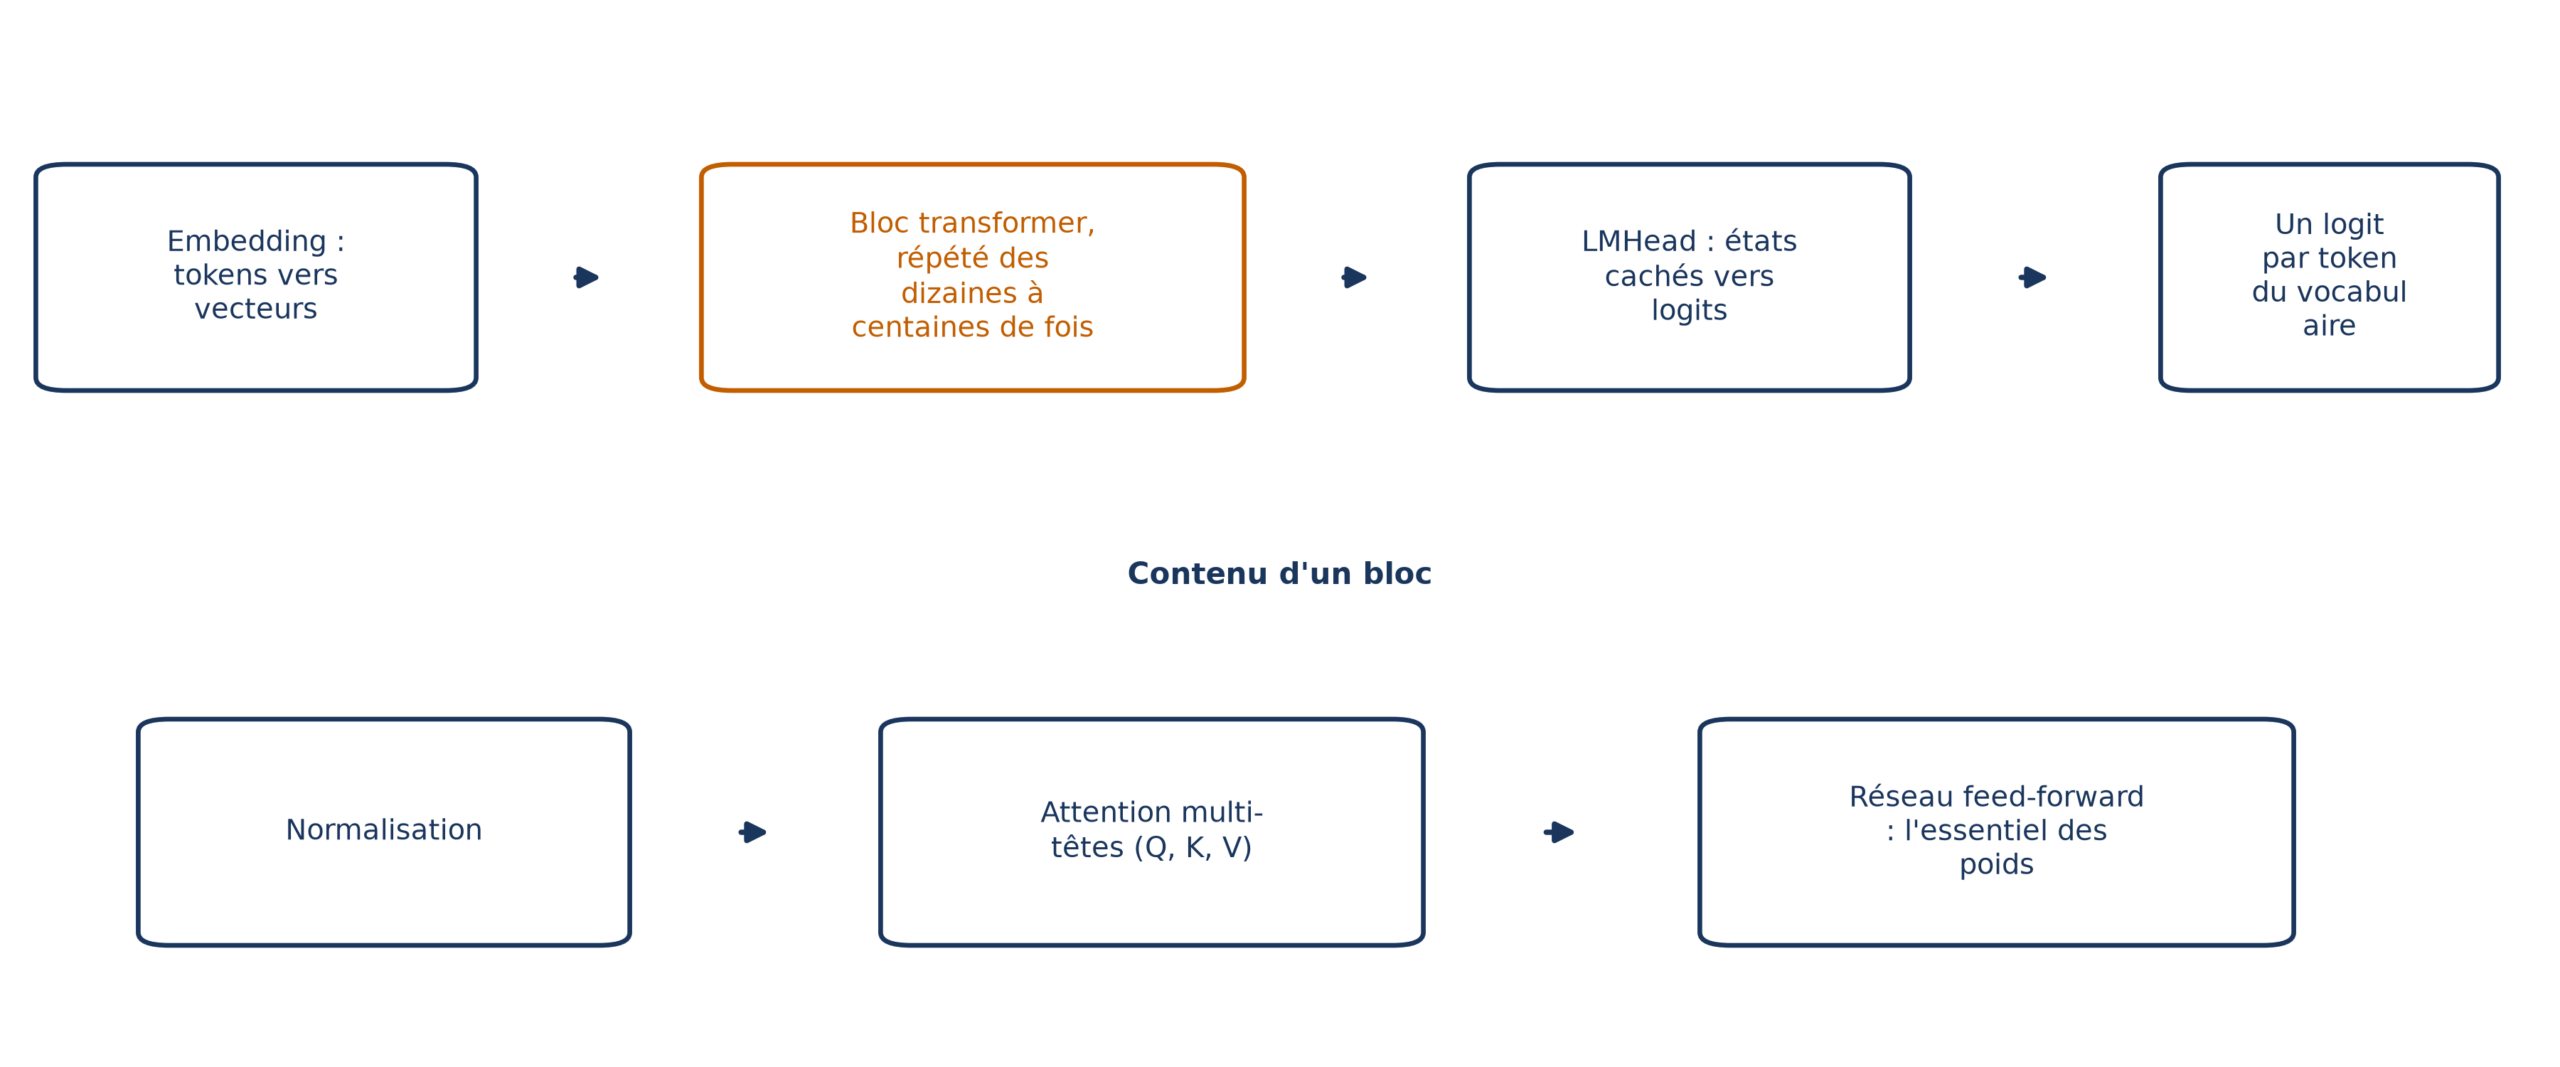
📌 À retenir Les modèles actuels n’inventent pas de nouvelle pièce à chaque étage : ils répètent le même bloc, et c’est la profondeur qui fait monter la sophistication.
Encodeur, décodeur ou les deux ?
Le Transformer d’origine, conçu pour la traduction, associe deux moitiés. L’encodeur reçoit le texte à traduire ; le décodeur produit la traduction. Dans le décodeur, une attention croisée fait le pont : ses requêtes viennent du décodeur, le reste vient de l’encodeur, pour que la génération soit conditionnée par l’entrée.
Le décodeur porte aussi un masque qui lui interdit de regarder le futur. Si le modèle voyait déjà le mot à prédire, il y aurait fuite de données ; la partie triangulaire supérieure de la matrice d’attention est donc remplacée par  .
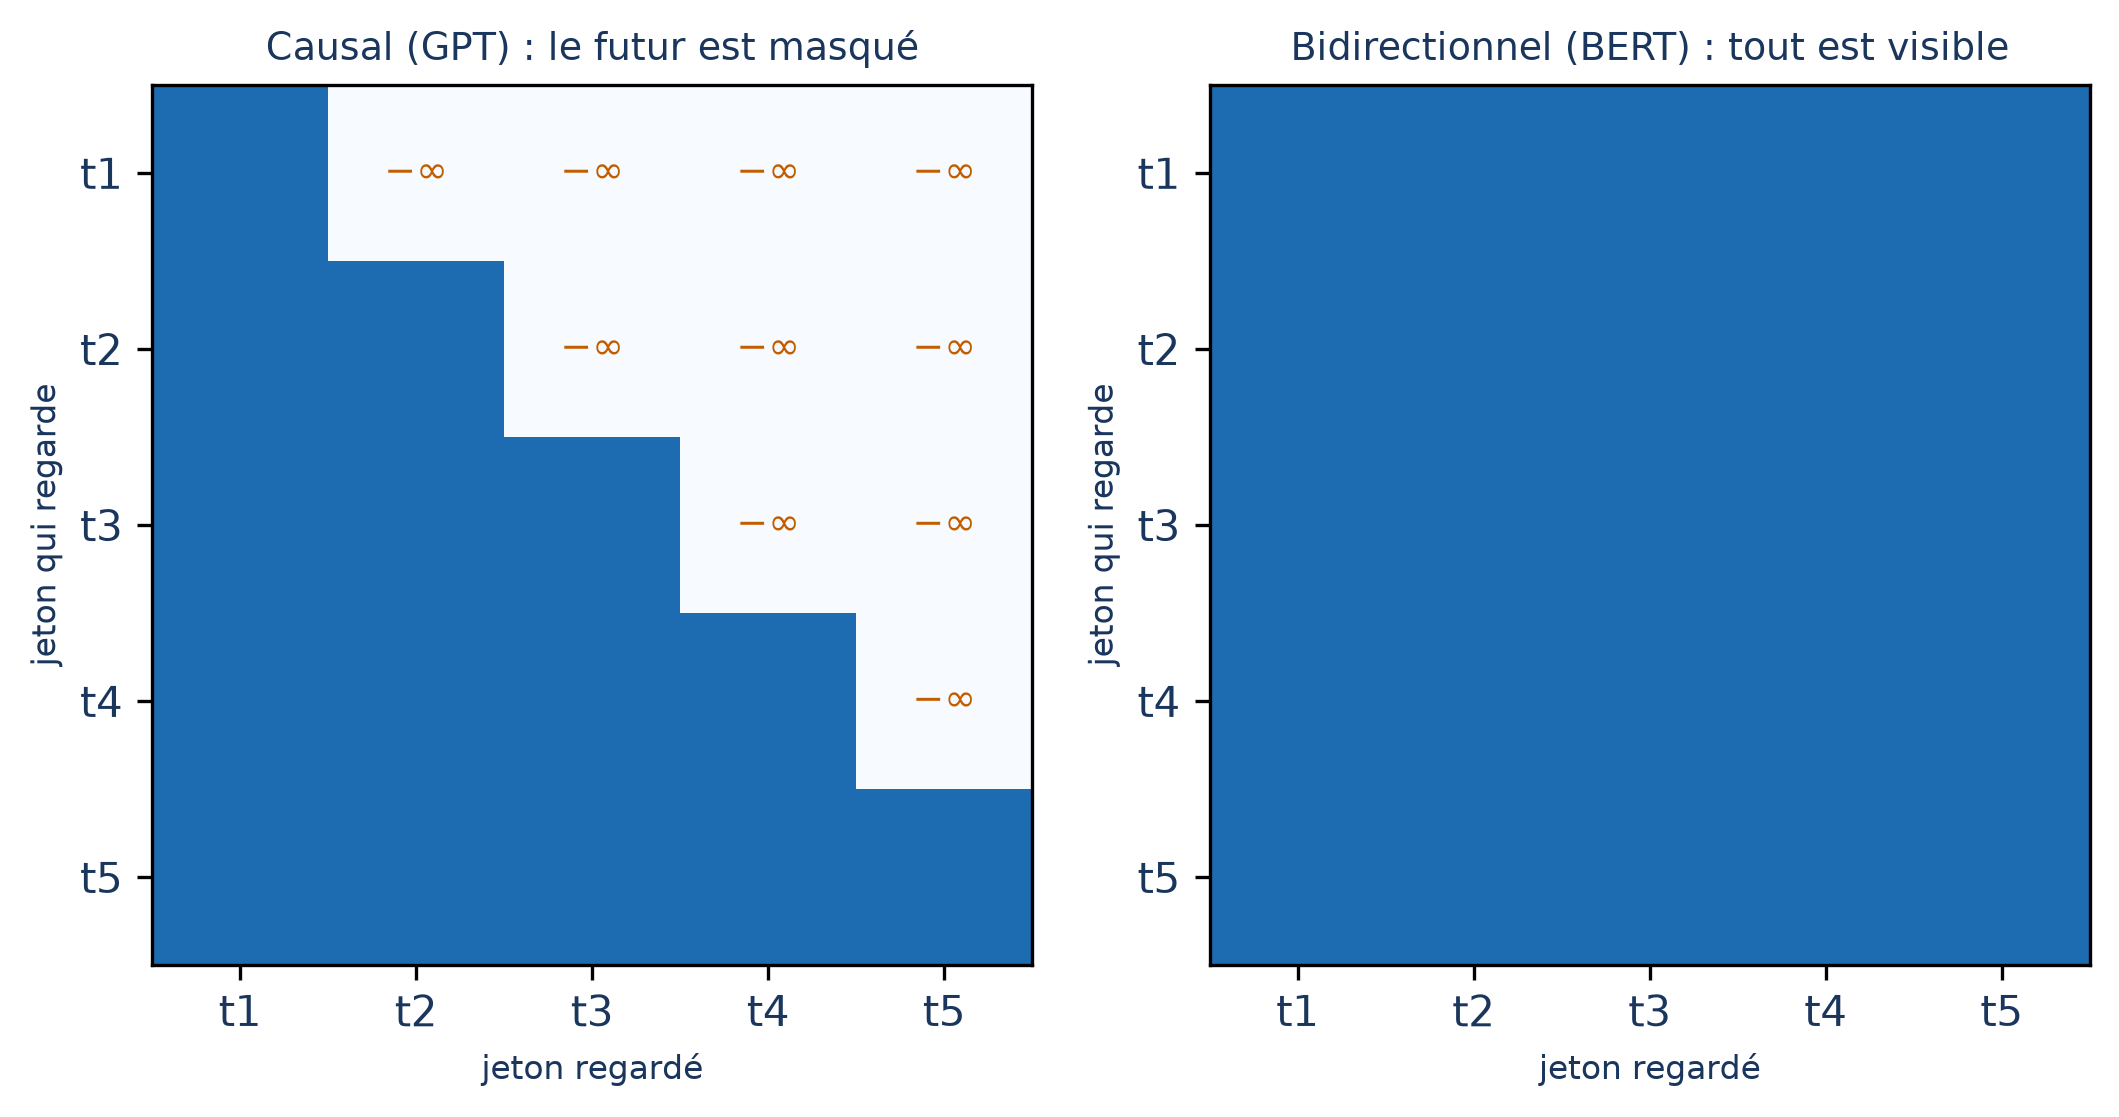
BERT garde uniquement l’encodeur et lit toute la séquence d’un coup. Comme le mot suivant serait trop facile à deviner, on le dresse autrement : environ 15 % des jetons sont cachés derrière un jeton <MASK> et il doit les retrouver. Deux jetons spéciaux aident : [CLS] ouvre l’entrée, [SEP] sépare deux phrases.
BERT existe en deux tailles : 12 couches et 110 millions de paramètres pour BERT-BASE, 24 couches et 340 millions pour BERT-LARGE.
GPT-2 prend le parti inverse : un décodeur seul, causal, pré-entraîné sur environ 40 Go de texte pour prédire le jeton suivant, de 12 couches (petite version) à 48 (version XL). Il produit un jeton à la fois, qu’il rajoute à l’entrée pour produire le suivant.
Les encodeurs ne sont pas faits pour générer, justement à cause de l’entraînement par masquage ; les décodeurs, si. Pour l’IA générative, ce sont pratiquement tous des décodeurs seuls.
Comment il apprend : deviner le mot suivant
On pourrait croire qu’un tel système exige des montagnes d’exemples annotés. Il n’en est rien : le modèle apprend par lui-même, de façon auto-supervisée, à partir de texte brut.
Le principe est de calculer la probabilité d’un mot sachant ceux qui précèdent. Par la règle de la chaîne, celle d’une séquence se décompose en produit :
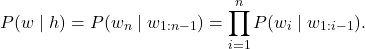
Autrement dit, la probabilité d’une phrase est le produit des probabilités de chaque mot compte tenu de son historique.
Exemple : on donne to be or not to et on demande au modèle d’estimer la probabilité que le mot suivant soit be. La séquence d’entrée s’appelle le contexte, long de 512 jetons pour les premiers Transformers. En sortie, une projection linéaire puis une softmax donnent un vecteur de taille (celle du vocabulaire), le vecteur de logits.
L’erreur se mesure par l’entropie croisée entre la distribution prédite et la distribution réelle, un vecteur valant 1 pour le vrai mot et 0 ailleurs :
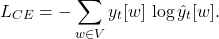
Concrètement, cela revient à regarder la probabilité que le modèle donnait au mot réellement observé.
Comme tous les calculs se parallélisent, on n’avance pas mot après mot : toute la séquence est donnée d’un coup, ce qui était impossible avec un réseau récurrent.
Une fois entraîné, il reste à choisir le mot à écrire. Prendre toujours le plus probable (décodage glouton) donne un texte prévisible et répétitif ; on lui préfère des tirages au sort encadrés. L’échantillonnage top-k garde les  mots les plus probables, le top-p un pourcentage cumulé, et la température divise les scores avant la softmax : proche de 0, on se rapproche du glouton.
À quoi on l’utilise
La force du Transformer tient à sa capacité à digérer d’énormes quantités de texte pendant une phase de pré-entraînement, où il apprend les règles générales d’une langue. On exploite ensuite ce savoir par apprentissage par transfert : pour apprendre à rédiger des articles scientifiques, inutile de réapprendre l’anglais, il suffit d’adapter ce qu’on sait.
Ce fine-tuning garde la plupart des couches gelées et n’entraîne que une ou deux couches posées au sommet. Pour classer des avis en trois catégories avec BERT, on prend le vecteur final du jeton [CLS], qui a vu toute la séquence, et on lui applique une softmax :
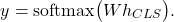
La matrice  , seule apprise au départ, sépare les classes.
Avec Hugging Face, le réglage tient en quelques lignes. On suppose ici que model, train_dataset et val_dataset sont déjà préparés (un petit défaut s’est glissé dans le bloc : il manque une virgule après per_device_eval_batch_size=16, à ajouter avant de lancer).
training_args = TrainingArguments(
    output_dir='./results',
    num_train_epochs=3,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=16
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir='./logs',
    logging_steps=10,
    evaluation_strategy="epoch"
)
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=val_dataset
)
trainer.train()
Le contraste de coût est parlant : l’entraînement de BERT a mobilisé 64 TPU pendant quatre jours, hors de portée de la plupart des utilisateurs, alors que son fine-tuning se fait sur un seul GPU, voire un CPU. À sa sortie, il a atteint l’état de l’art sur la détection de paraphrases, les questions-réponses et l’analyse de sentiments.
Même un décodeur seul se règle ainsi. Pour traduire avec GPT-2, on construit des exemples de la forme « phrase anglaise, jeton spécial <to-fr>, phrase française » et on poursuit la prédiction du jeton suivant.
Quand la puissance de calcul est la contrainte, on recourt à la distillation : un petit modèle élève cherche à imiter les prédictions d’un grand modèle enseignant, avec des performances proches pour un coût bien moindre.
Le Transformer ne se limite pas au texte. Le Vision Transformer découpe une image en patches (par exemple 16×16), chacun jouant le rôle d’un jeton. Pour une image de hauteur  et de largeur , avec des patches de côté
 , on obtient :

Une fois les patches projetés en vecteurs, ils entrent dans les mêmes blocs que le texte.
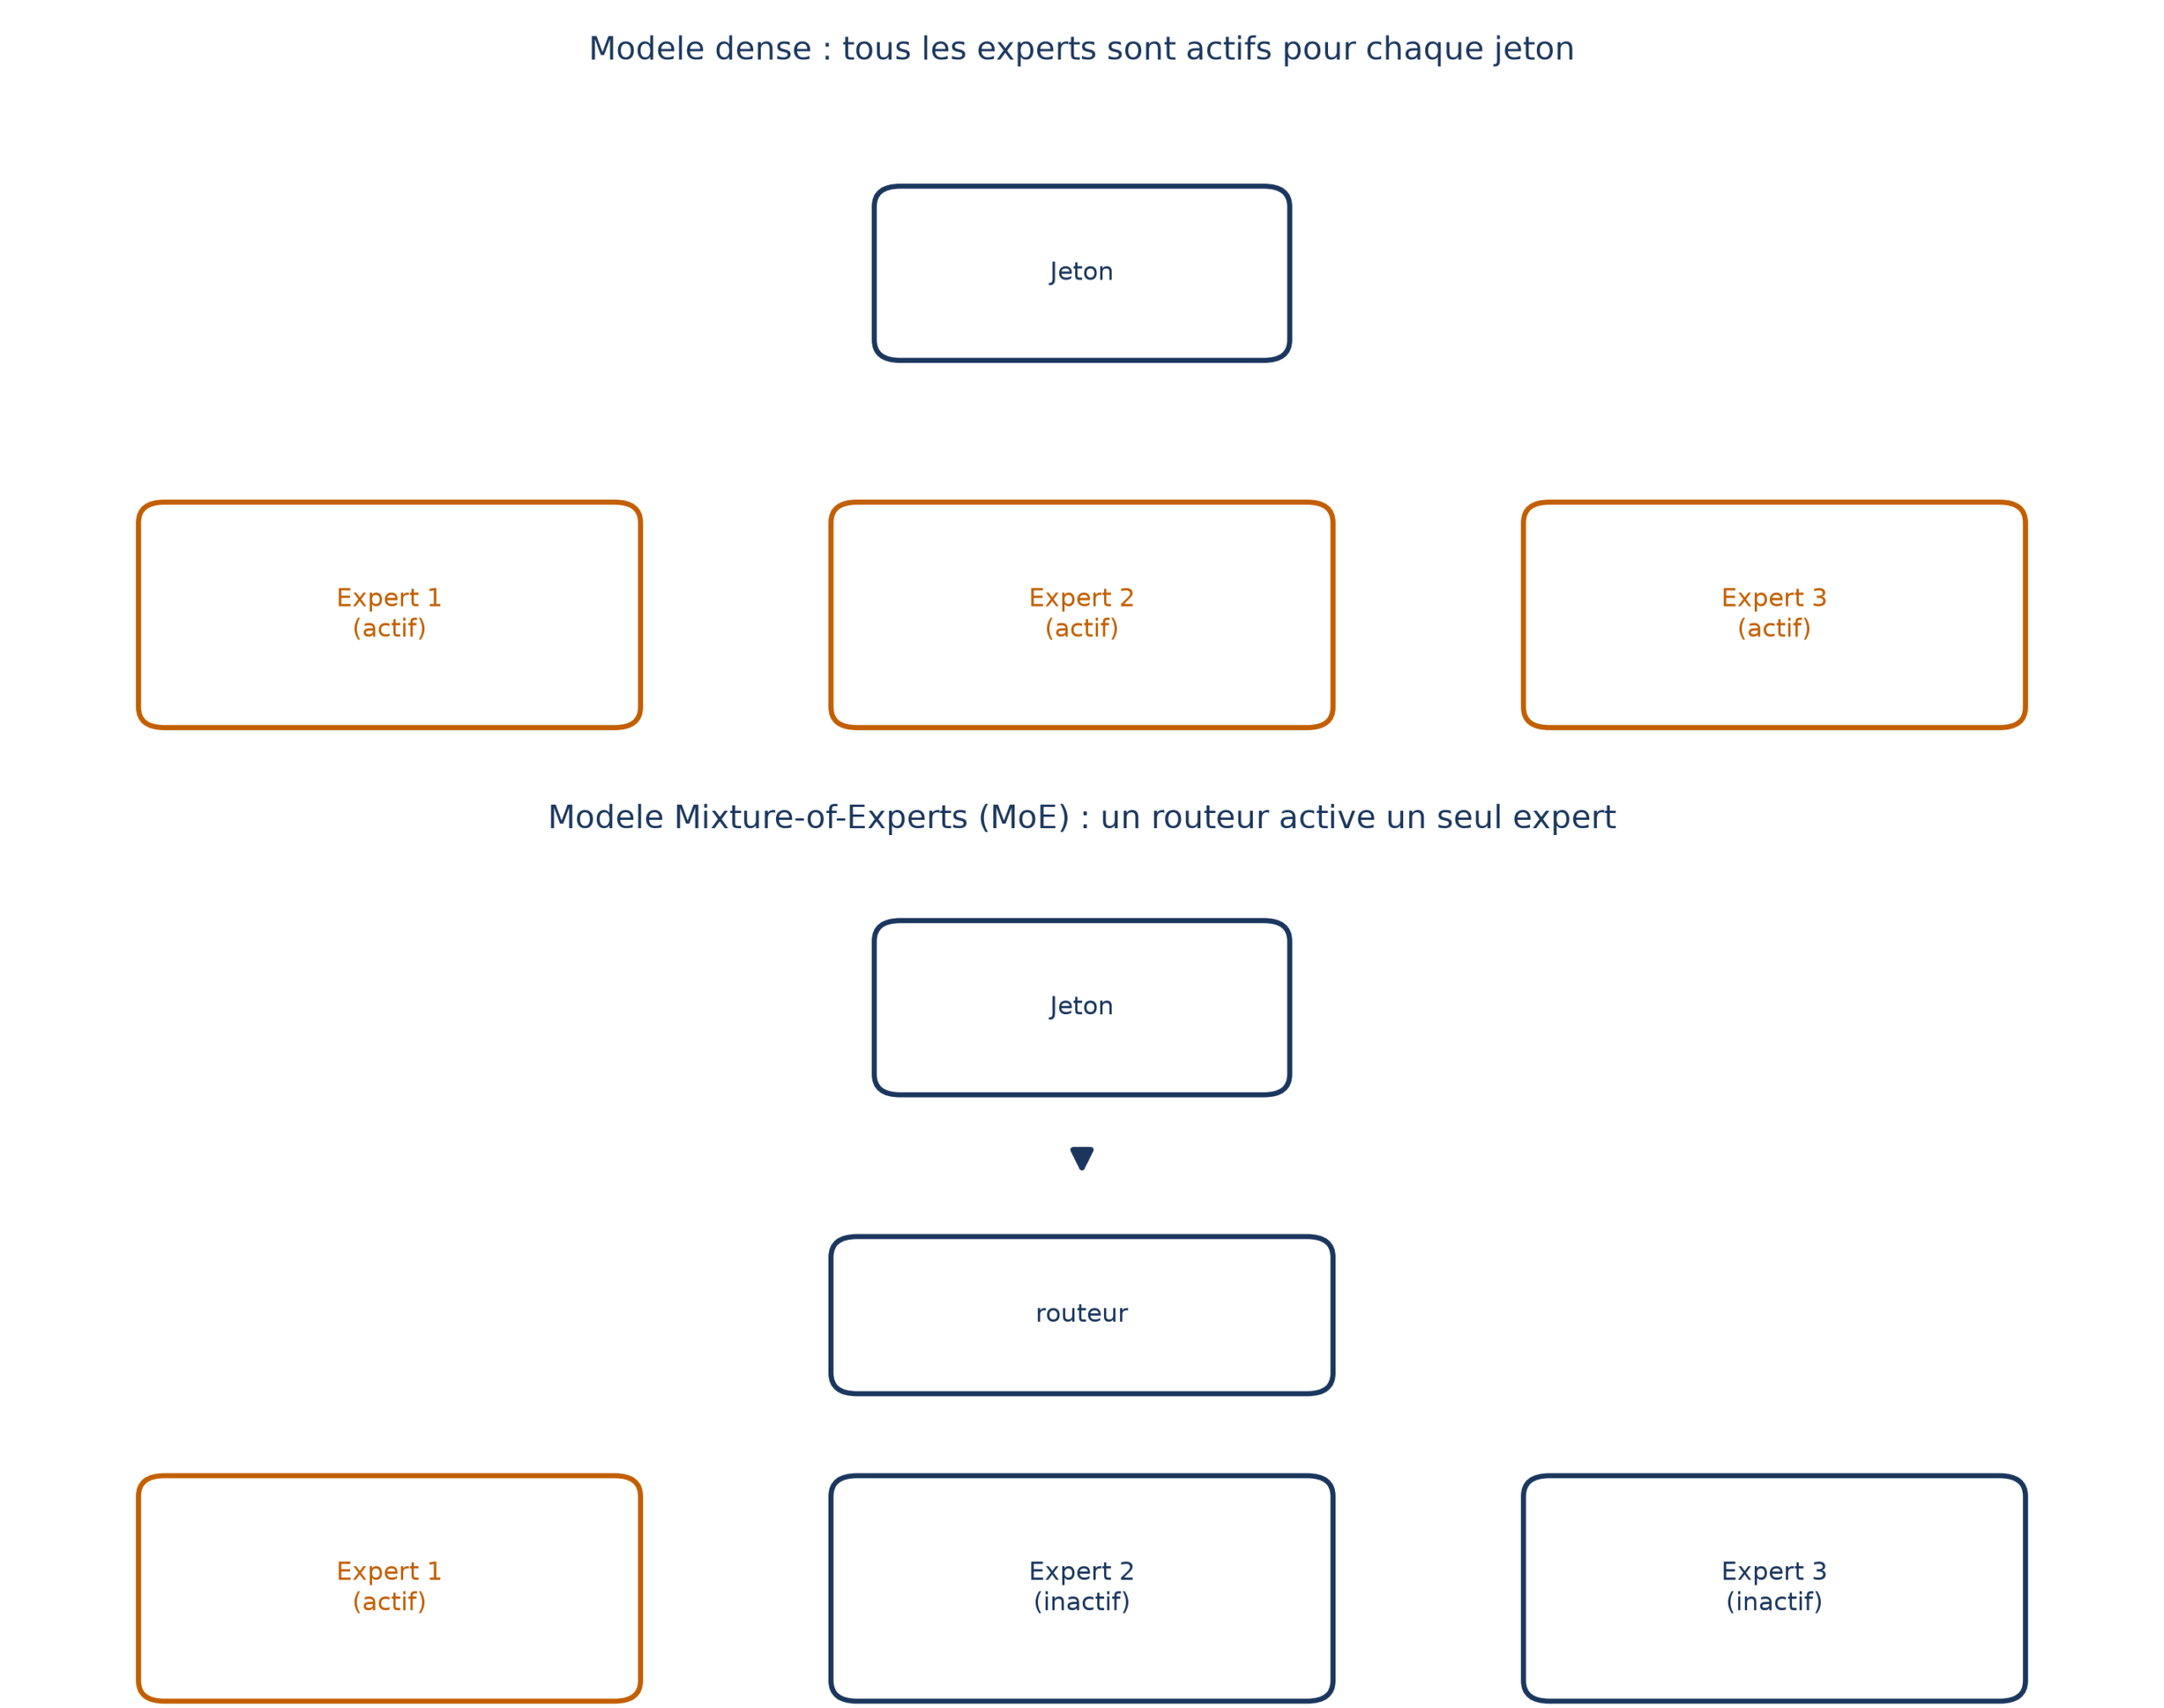
Enfin, une variante réduit le coût de calcul : le Mixture-of-Experts. Au lieu de faire travailler tous les paramètres pour chaque jeton, un routeur apprend à n’activer que quelques experts (deux sur huit, par exemple).
Ce qu’un Transformer ne fait pas : limites et idées reçues
« Transformer » ne veut pas dire « ChatGPT ». Le Transformer est l’architecture ; un LLM est cette architecture poussée à plus de 10 milliards de paramètres. Et tous ne sont pas bâtis comme l’original : l’encodeur-décodeur d’origine n’est plus qu’une option parmi trois.
« BERT ne peut pas écrire. » C’était vrai de la pratique courante jusqu’en 2024, quand deux études ont montré qu’en adaptant le modèle, une suite de jetons [MASK] permet de générer du texte.
L’attention a un prix. Le coût de calcul croît avec le carré du nombre de jetons, car chaque jeton se compare à tous les autres ; ce produit scalaire freine le passage à l’échelle et beaucoup de variantes tentent de le réduire. L’attention n’a de plus aucune notion intrinsèque d’ordre, d’où l’encodage positionnel, dont la version absolue surreprésente d’ailleurs les mots du début : on lui préfère aujourd’hui des variantes relatives.
⚠️ Piège Un Transformer ne « sait » pas des faits au sens humain : il prédit le jeton le plus probable. Il peut donc inventer une réponse plausible mais fausse, avec la même assurance qu’une réponse exacte.
Les limites qui en découlent sont bien connues. Ses connaissances sont figées à la date de fin d’entraînement : un modèle entraîné avant la cession des Dallas Mavericks par Mark Cuban continuera à le présenter comme seul propriétaire. Pour compenser, on le couple à des outils externes comme la génération augmentée par récupération.
Reste la question de la compréhension. Des travaux suggèrent que ces modèles forment un modèle du monde rudimentaire, mais ce n’est pas établi : dans une étude de 2024, des transformers n’ont pas su construire une carte fiable de New York utilisable pour des prédictions. La question reste ouverte.
Au bout du compte, un Transformer, c’est une idée simple répétée à grande échelle : laisser chaque mot choisir, parmi tous les autres, ceux qui l’aident à se comprendre. Tout le reste (encodage de position, raccourcis, normalisation) sert à rendre cette idée entraînable.