Ton réseau de neurones vient de terminer son calcul et il rend trois nombres : 2, 1 et 0. Tu voudrais savoir quelle chance a chaque option, mais ces trois nombres ne sont pas des chances : rien ne dit qu’ils totalisent 100 %. Une petite fonction se charge de cette conversion, et elle apparaît dans presque tous les modèles modernes. Tu vas apprendre à lire sa formule, à la calculer à la main et à repérer les endroits où elle travaille.
Sommaire
- L’essentiel en 30 secondes
- Des scores bruts à une distribution
- La formule, morceau par morceau
- Le calcul sur trois scores
- Choisir une action au hasard, pas toujours la meilleure
- Un score ou toute une liste : softmax et sigmoïde
- Dans l’attention : un budget de 1 par mot
- Adoucir une distribution avec la température
- Deux idées reçues à écarter
L’essentiel en 30 secondes
- Softmax prend une liste de scores bruts (les logits) et rend une liste de probabilités.
- Chaque probabilité est comprise entre 0 et 1, et l’ensemble des sorties totalise 1.
- Elle se calcule avec l’exponentielle de chaque score, divisée par la somme de toutes ces exponentielles.
- Elle sert à classer, à choisir une action, à pondérer l’attention : la même opération, quatre métiers.
- Elle ne choisit rien : elle fournit la distribution, le tirage ou le maximum viennent après.
Des scores bruts à une distribution
Un réseau qui doit départager plusieurs options ne produit pas directement des probabilités. Sa dernière couche rend un vecteur de logits, avec un score par option ; pour un modèle de langage, ce vecteur a la longueur du vocabulaire. C’est seulement après une normalisation que ces scores représentent la probabilité que chaque option soit la bonne réponse.
Cette normalisation, c’est la softmax. Elle écrase les scores entre 0 et 1 et attribue à chacun une importance relative par rapport aux autres.
💡 Intuition Imagine un gâteau à partager entre les options. Les logits disent qui mérite la plus grosse part ; la softmax découpe le gâteau pour qu’il ne reste aucune miette en trop ni en moins.
La formule, morceau par morceau
Pour un vecteur de scores  qui compte plusieurs entrées, la softmax de la i-ème entrée s’écrit :

En pratique, on la calcule d’un coup sous forme vectorielle : 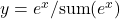 .
Lis-la en deux temps. Au numérateur,  est l’exponentielle du score de l’option
 . Au dénominateur, la somme de toutes les exponentielles joue le rôle de total à partager : c’est elle qui garantit que les poids d’une même position somment à 1.
Le même motif apparaît quand on l’applique à des scores d’alignement  :
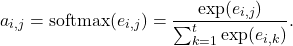
Ici le dénominateur additionne les  scores de la ligne , et chaque
 en est la part.
Le calcul sur trois scores
Prenons un agent qui apprend à jouer à un jeu vidéo, avec trois actions possibles : gauche, droite, saut. Son réseau rend les logits 2, 1 et 0 (valeurs choisies pour l’illustration). Applique la formule :
| Action | Score | Exponentielle | Probabilité |
|---|---|---|---|
| gauche | 2 | 7,39 | 66,5 % |
| droite | 1 | 2,72 | 24,5 % |
| saut | 0 | 1,00 | 9,0 % |
La somme des exponentielles vaut 11,11. Chaque exponentielle divisée par ce total donne la dernière colonne, qui totalise bien 100 %.
Regarde l’écart entre les scores : un point de score de plus multiplie la probabilité par  , il ne l’augmente pas d’un même nombre de points. « Gauche » gagne de peu au score et nettement en probabilité. Le saut, avec un score nul, garde pourtant 9 % de chance : aucune option n’est éliminée.
Choisir une action au hasard, pas toujours la meilleure
Cet agent n’est pas imaginaire. Dans l’algorithme A3C, qui apprend à jouer à un jeu vidéo, le modèle local produit pour chaque état un ensemble de probabilités, dont on tire une action par échantillonnage.
for _ in range(opt.num_local_steps):
            curr_step += 1
            logits, value, h_0, c_0 = local_model(state, h_0, c_0)
            policy = F.softmax(logits, dim=1)
            log_policy = F.log_softmax(logits, dim=1)
            entropy = -(policy * log_policy).sum(1, keepdim=True)
            m = Categorical(policy)
            action = m.sample().item()
            state, reward, done, _ = env.step(action)
            ...
Suis la chaîne. opt regroupe les réglages de l’entraînement, env est l’environnement du jeu et F vient de PyTorch. local_model rend les logits (et d’autres sorties dont on ne se sert pas ici) ; F.softmax en fait la policy, c’est-à-dire la distribution sur les actions ; Categorical(policy) permet de tirer une action selon ces probabilités ; env.step(action) l’exécute dans le jeu. À chaque pas, on enregistre le logarithme de la probabilité de l’action choisie et l’entropie de la politique, calculés à partir de policy et de log_policy.
Avec nos trois actions, le tirage donne « saut » environ une fois sur onze. Cette part de hasard permet à l’agent d’essayer d’autres actions que la plus probable.
Un score ou toute une liste : softmax et sigmoïde
Une autre fonction transforme elle aussi un score en probabilité : la sigmoïde. Elle prend un seul nombre et le place entre 0 et 1.
Dans l’apprentissage de représentations de mots, elle répond à une question à deux issues : le mot  est-il attendu dans le contexte du mot
 , oui ou non ? Le score est le produit scalaire
 de leurs vecteurs, et la sigmoïde le convertit en probabilité :
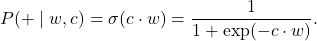
Un seul score entre, une seule probabilité sort.
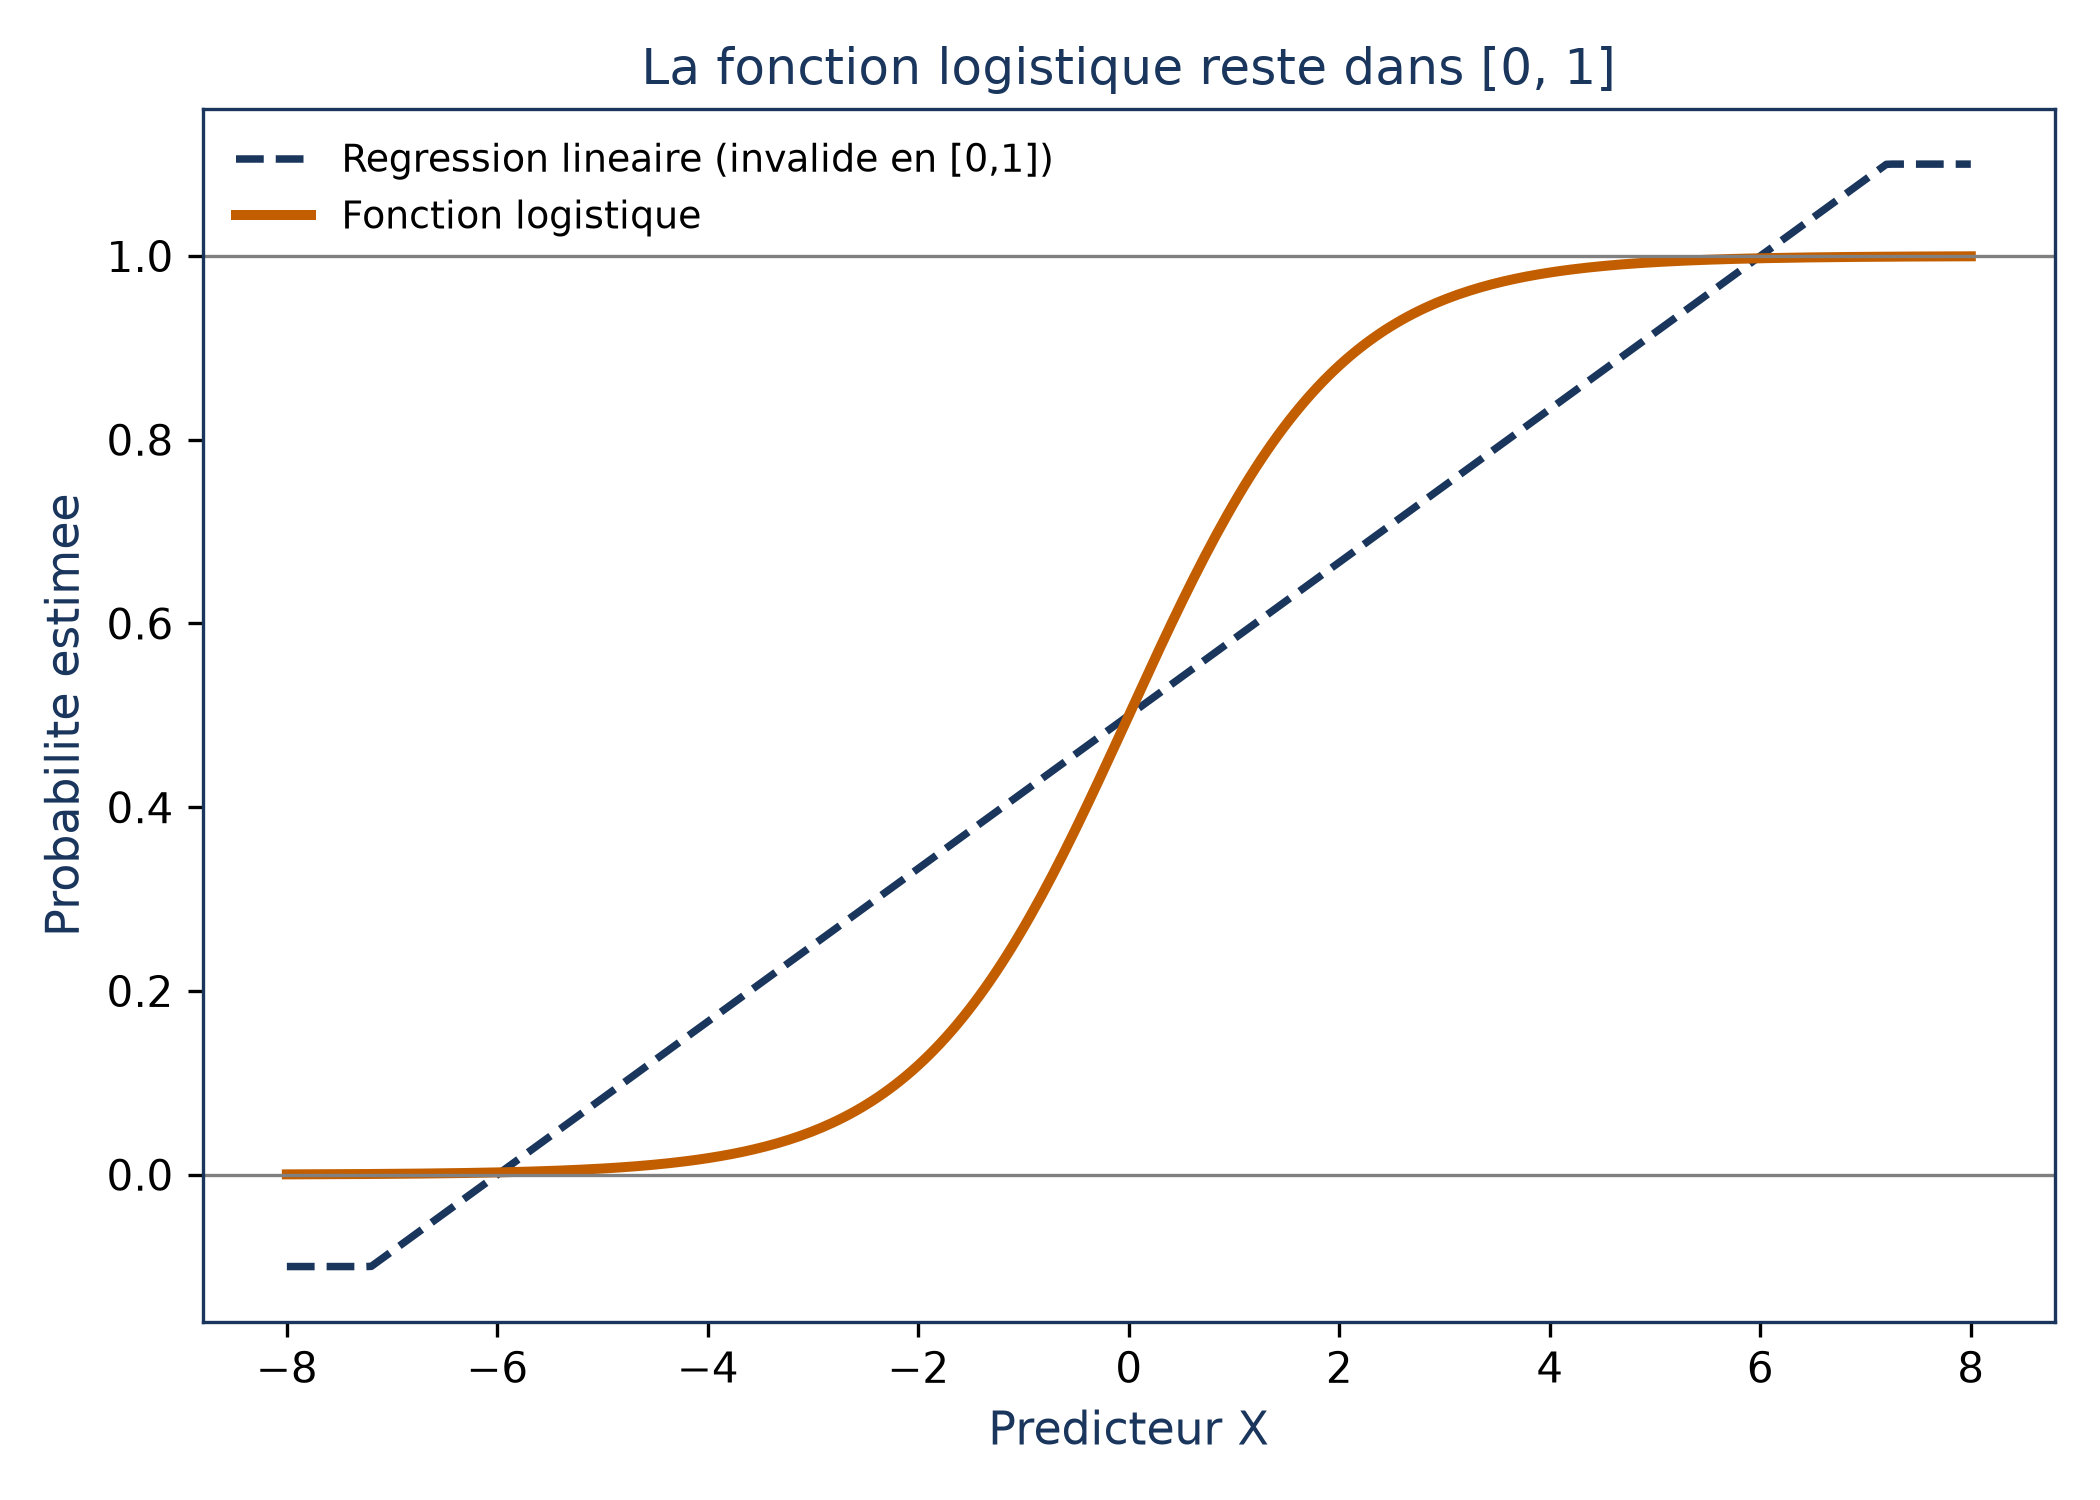
Le choix entre les deux dépend du nombre d’issues. Un classifieur de sentiments qui ne distingue que « positif » et « négatif » se contente d’une seule sortie suivie d’une sigmoïde. Dès qu’il y a trois classes (positif, neutre, négatif), on applique une softmax au résultat de  pour obtenir une probabilité par classe.
Dans l’attention : un budget de 1 par mot
La softmax ne se cache pas seulement en sortie de réseau. Dans l’attention, les scores sont des produits scalaires entre requêtes et clés, et la softmax les convertit en poids entre 0 et 1 :
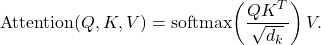
Les poids obtenus pour une même position somment à 1 : ils fonctionnent comme un budget d’attention que le mot répartit entre les autres. Le produit par  en fait une moyenne pondérée des valeurs.
Adoucir une distribution avec la température
Il arrive qu’on veuille comparer deux distributions de probabilités plutôt qu’en tirer une action. C’est le cas de la distillation, où un petit modèle élève cherche à imiter un grand modèle enseignant : la perte compare leurs logits à l’aide de la divergence de Kullback-Leibler, qui mesure la différence entre deux distributions.
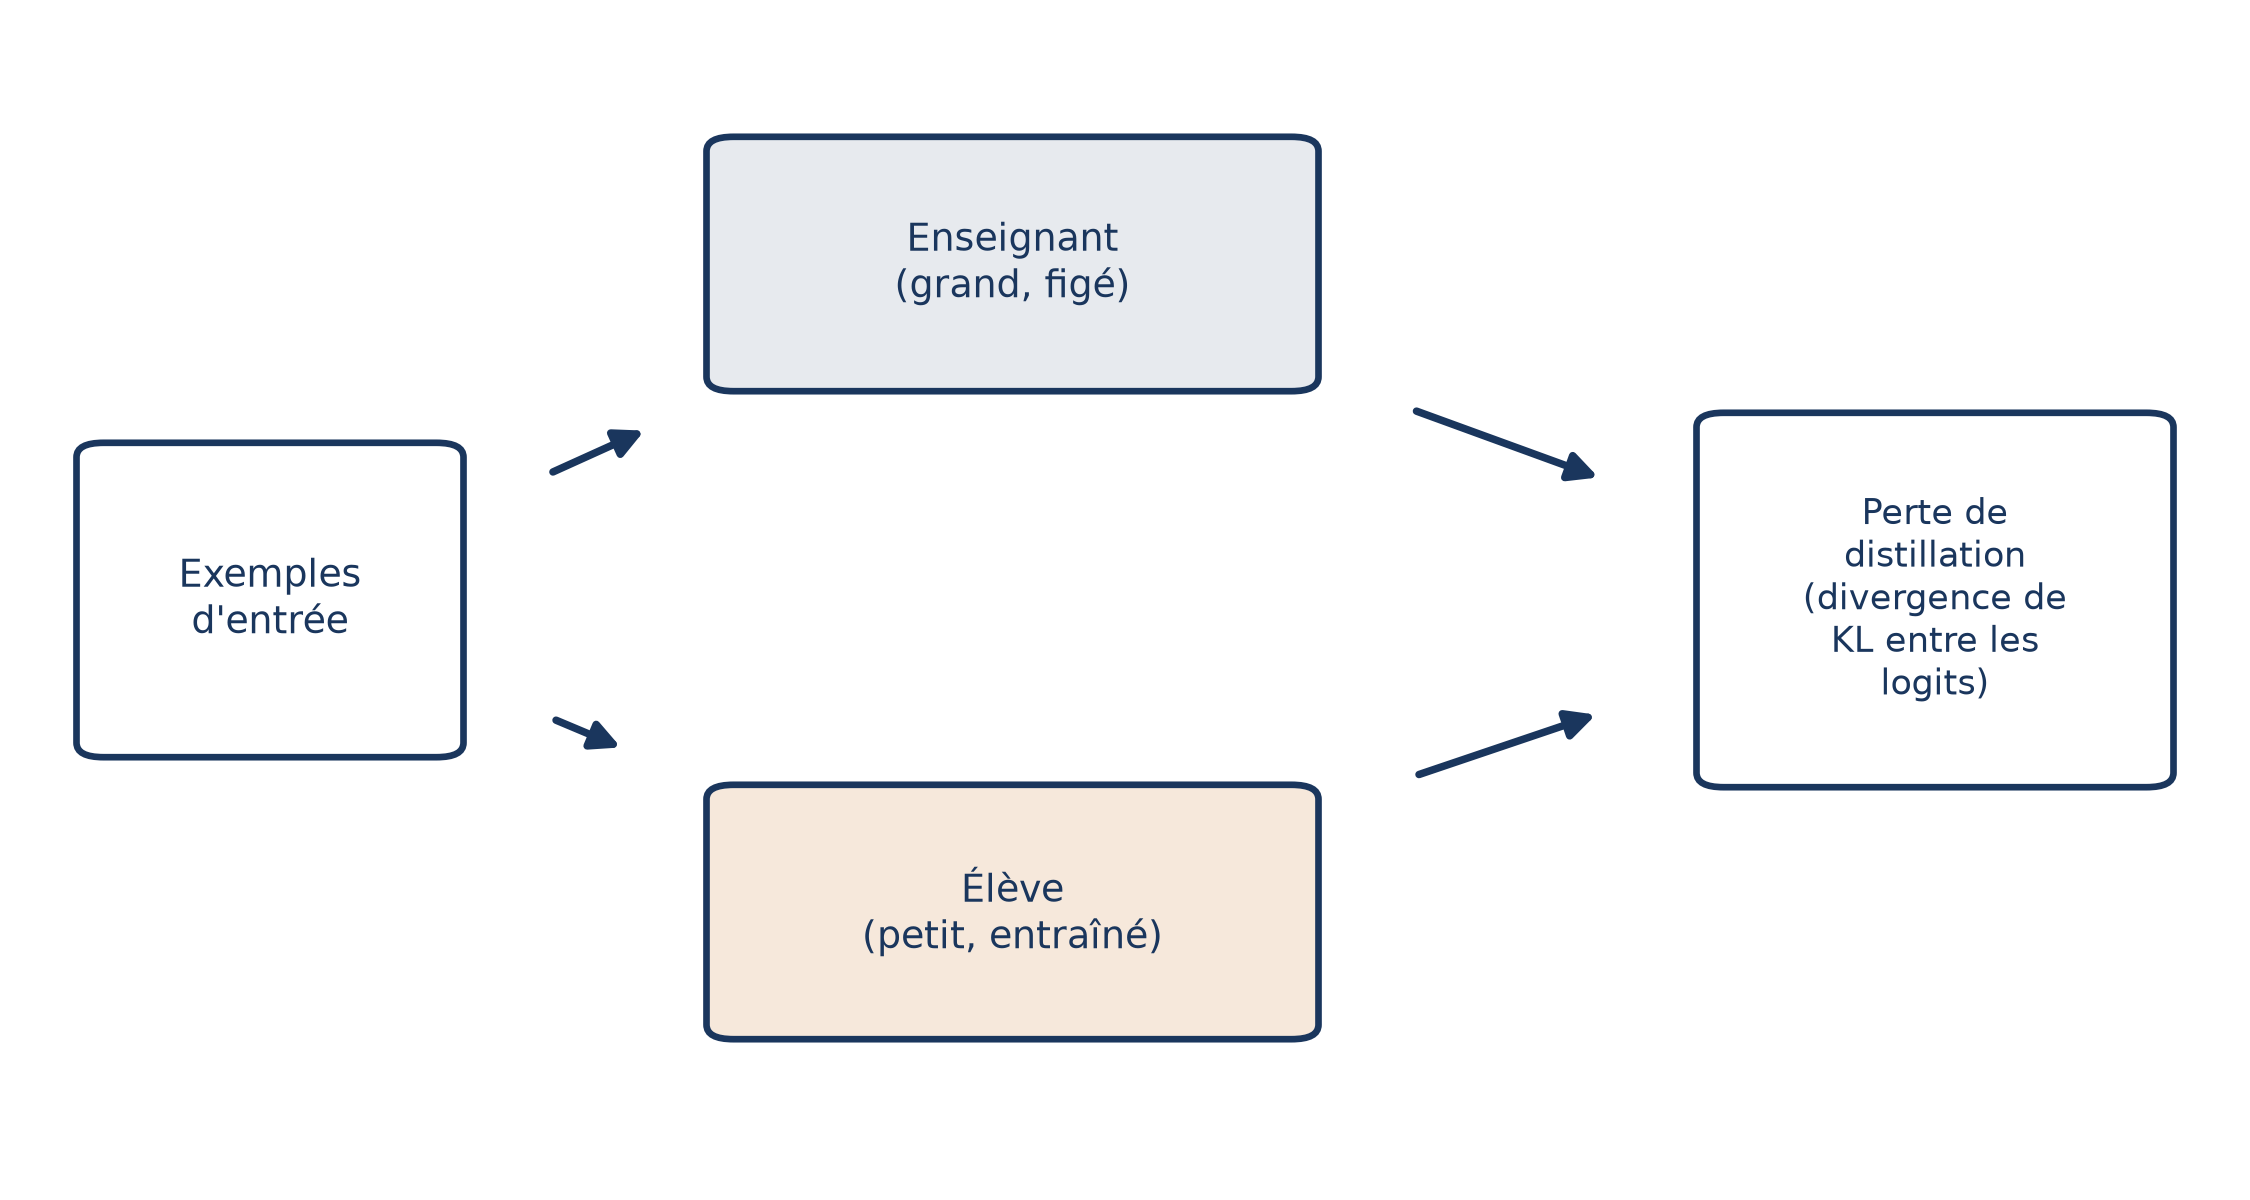
Le code la calcule ainsi :
def distillation_loss(outputs_student, outputs_teacher,
                      temperature=2.0):
    log_prob_student = F.log_softmax(
        outputs_student / temperature, dim=-1)
    prob_teacher = F.softmax(
        outputs_teacher / temperature, dim=-1)
    loss = KLDivLoss(reduction='batchmean')(
        log_prob_student, prob_teacher)
    return loss
Les logits des deux modèles sont divisés par la température avant d’entrer dans la softmax : l’élève passe par log_softmax, l’enseignant par softmax, et KLDivLoss compare les deux. La température adoucit les distributions avant comparaison.
Reprends nos scores avec la valeur par défaut temperature=2.0 : ils deviennent 1, 0,5 et 0, ce qui donne environ 50,7 %, 30,7 % et 18,6 %. Le saut passe de 9 % à près de 19 % : la distribution est plus plate, plus indulgente.
Deux idées reçues à écarter
« Softmax choisit la réponse »
Non : elle rend une distribution, rien de plus. Pour un modèle de langage, une étape ultérieure pioche le token au sort en donnant à chacun le poids que la distribution lui accorde ; dans l’exemple de l’agent, c’est l’échantillonnage de Categorical qui désigne l’action. Le choix est une étape distincte.
« Softmax sert à classer des images ou du texte, et c’est tout »
La même opération revient avec des sens différents :
- sur une classe, dans la couche de classification d’un modèle de type BERT ;
- sur un mot du vocabulaire, à la sortie d’un modèle de langage ;
- sur une action, dans la politique d’un agent ;
- sur un autre mot de la phrase, dans l’attention.
Ce qui change, c’est la signification des scores qui entrent. La softmax, elle, se contente de les convertir en parts d’un total égal à 1.