Un modèle de langage te rend une réponse, jamais ses hésitations. Pourtant, quand BERT lit ta phrase, plus d’une centaine de têtes d’attention pèsent chacune les mots les uns par rapport aux autres. BERTviz est la bibliothèque qui met ces pesées sous tes yeux. Tu vas voir ce qu’elle affiche, comment l’appeler en deux lignes, et comment lire le résultat sans te perdre.
Sommaire
- L’essentiel en 30 secondes
- Un outil pour regarder, pas pour entraîner
- Deux appels, deux grossissements
- Lire les couleurs, parcourir les têtes
- Voir l’attention, ce n’est pas tout voir
L’essentiel en 30 secondes
- BERTviz est un outil de visualisation, pas un outil d’entraînement : il affiche les poids d’attention d’un modèle BERT.
- Il propose deux vues :
head_viewpour regarder les têtes,model_viewpour embrasser le modèle entier. - La vue est interactive : tu changes de phrase, tu choisis la couche dans un menu, tu survoles un mot.
- Dans ces vues, une couleur sombre signale un poids d’attention proche de 1.
- Elle montre qui regarde qui, mais d’autres méthodes répondent à d’autres questions, comme l’influence d’un mot sur la sortie.
Un outil pour regarder, pas pour entraîner
BERTviz est un paquet Python de visualisation. On le croise dans des exemples écrits avec la bibliothèque Transformers de Hugging Face, aux côtés d’un autre outil du même genre, Ecco.
Son terrain, c’est le mécanisme d’attention, qui a une particularité : on peut en visualiser les relations. Dans chaque couche d’un modèle BERT vivent plusieurs têtes, et chacune apprend une représentation différente des données. BERTviz t’en montre une à la fois, ou toutes ensemble.
Ce qu’il te donne n’est donc pas une explication toute faite, mais un tableau de poids que tu lis toi-même : quel mot consulte quel autre mot, et avec quelle intensité.
Deux appels, deux grossissements
Première question concrète : comment regarder ce que fait une seule tête sur une paire de phrases ? Un seul appel suffit.
head_view(attention, tokens, sentence_b_start)
L’extrait suppose que trois objets existent déjà : les poids d’attention (attention), la liste des jetons (tokens) et l’indice où commence la seconde phrase (sentence_b_start), car BERT lit ses entrées par paires, séparées par un jeton [SEP].
La vue qui s’ouvre se manipule. Tu peux essayer d’autres phrases, ouvrir le menu déroulant pour passer d’une couche à l’autre, et survoler un mot pour voir les poids que lui accorde chaque tête.
Pour prendre du recul, même signature, autre fonction :
model_view(attention, tokens, sentence_b_start)
Elle affiche tout d’un coup, couches et têtes réunies, là où head_view te laisse choisir. Pense à une carte routière : model_view te donne le plan de la ville, head_view le zoom sur une rue.
💡 Intuition Les deux fonctions reçoivent exactement les mêmes trois arguments. Changer de grossissement ne coûte donc que le nom de la fonction : tu peux enchaîner la vue large pour repérer une zone intéressante, puis la vue par tête pour la lire de près.
Lire les couleurs, parcourir les têtes
Tout repose sur une seule convention : sombre veut dire proche de 1, et plus clair veut dire plus faible. Pour te faire l’œil, regarde ce genre de tableau, ici celui d’une traduction.
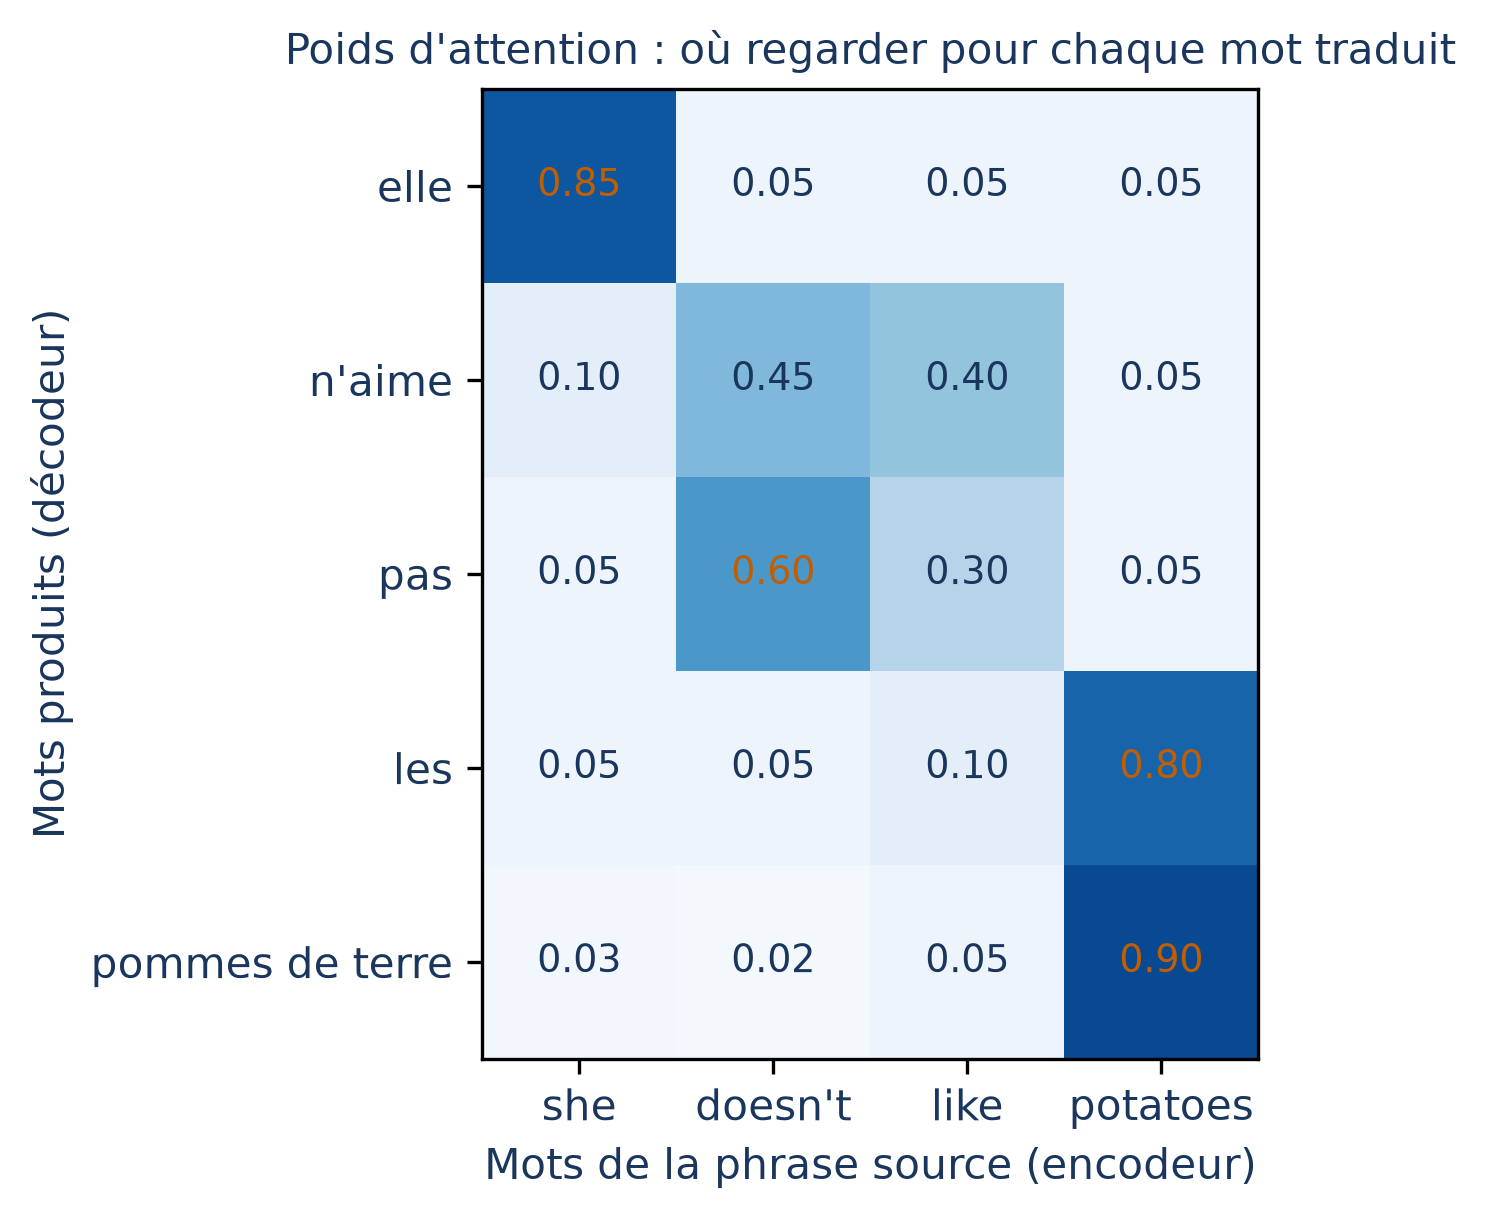
Reste à savoir où regarder. Un BERT à 12 couches de 12 têtes te propose autant de petits tableaux de ce genre pour une même phrase, soit plus de cent lectures différentes. C’est ce qui fait la capacité du modèle, et c’est aussi ce qui rend model_view précieux pour s’y retrouver.
Un conseil de lecture découle d’un fait : ces représentations ne sont pas indépendantes. Ce que les premières couches ont appris peut resservir plus haut, donc mieux vaut parcourir les couches dans l’ordre que de juger une tête isolée.
Voir l’attention, ce n’est pas tout voir
BERTviz répond à une question précise : qui regarde qui ? D’autres questions existent, avec d’autres outils. Pour savoir quels jetons comptent le plus quand un modèle génère le suivant, on utilise la méthode gradient × entrée : à un pas de temps donné, elle calcule le gradient des probabilités de sortie des jetons les plus probables par rapport aux jetons d’entrée.
Le raisonnement est simple : de petits changements sur les jetons d’entrée les plus importants provoquent les plus grands changements de sortie.
Autre angle, les neurones. On capture l’activation des neurones des couches feedforward, on la décompose en quelques facteurs que l’utilisateur choisit, puis on observe de façon interactive les facteurs les plus actifs quand un jeton est généré. Certains se concentrent sur une portion du texte (début, milieu, fin), d’autres sur des structures grammaticales comme les conjonctions ou les articles.
⚠️ Piège Une vue d’attention ne remplace pas ces analyses. Elle décrit les relations entre mots à l’intérieur des têtes ; l’influence d’un mot d’entrée sur la sortie, ou ce que code un neurone, se mesure autrement.
Retiens donc le rôle de BERTviz : une loupe sur l’attention de BERT, simple à lancer, qui te donne envie de poser la question suivante.