« J’ai décidé d’écrire un roman parce que je pensais que cela serait facile, mais cela s’est révélé difficile. » À quoi renvoie ce « cela » ? Tu le sais sans y penser, mais un modèle de langage doit le calculer, et la pièce qui s’en charge s’appelle une couche d’auto-attention. Tu vas voir ce qu’elle reçoit, ce qu’elle rend, ce qu’elle apprend, et ce que le préfixe « auto » vient faire là.
Sommaire
- L’essentiel en 30 secondes
- Un tableau entre, un tableau de même taille sort
- Le mot « cela » : à quoi sert cette couche
- Pourquoi on dit « auto »
- Trois matrices apprises, puis une moyenne pondérée
- Des têtes en parallèle, des couches en série
- Trois idées reçues sur la couche d’auto-attention
L’essentiel en 30 secondes
- Une couche d’auto-attention prend un tableau de vecteurs, un par jeton, et en rend un de même taille, où chaque jeton a consulté les autres.
- « Auto » veut dire que requêtes, clés et valeurs viennent de la même séquence ; avec l’attention croisée, les requêtes viennent d’ailleurs.
- Ce qu’elle apprend tient dans trois matrices de poids (plus une projection finale quand il y a plusieurs têtes), qui fabriquent Q, K et V.
- Une couche réelle lance plusieurs têtes en parallèle, et un modèle empile des dizaines à des centaines de blocs qui en contiennent.
- Ce n’est pas elle qui pèse le plus : les sous-couches linéaires portent plus de poids qu’elle.
Un tableau entre, un tableau de même taille sort
Avant de parler d’attention, un mot sur le mot « couche ». Dans un réseau de neurones, l’unité de base est le nœud : un petit programme qui prend une entrée, la multiplie par des poids, ajoute un biais et renvoie le résultat. Un groupe de nœuds forme une couche, et chaque couche lit la sortie de la précédente.
Les sorties des couches intermédiaires s’appellent des états cachés : des représentations internes des données, dont une caractéristique clé est la taille des vecteurs, ou dimensionnalité. Pour du texte, ces vecteurs comptent des centaines ou des milliers de nombres, afin de capter le sens.
Une couche d’auto-attention est l’une de ces couches intermédiaires. Elle reçoit la matrice  issue de l’embedding :
 lignes (une par jeton) et
 colonnes (les dimensions de l’embedding). Elle en ressort avec exactement les mêmes dimensions.
Dans un bloc, la sortie de la couche est ajoutée à l’entrée, puis normalisée :
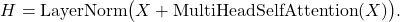
est le tableau d’entrée ; 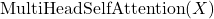 est ce que rend la couche, de même taille, d’où la possibilité de l’additionner à ;
 garde les valeurs dans une plage stable ; et
 est le nouveau tableau, toujours de taille
 .
💡 Intuition Imagine le tableau comme une feuille de calcul : une ligne par mot. En entrée, chaque ligne ne décrit que son mot. En sortie, la feuille a la même forme, mais chaque ligne est réécrite en tenant compte des autres lignes.
Le mot « cela » : à quoi sert cette couche
Reprends la phrase d’ouverture. Pris isolément, « cela » ne veut rien dire : son sens vient du reste de la phrase. L’attention est le mécanisme qui relie un jeton aux autres jetons de la séquence, et elle montre ici que « cela » renvoie à l’écriture du roman.
Un humain interprète sans effort ces relations entre les mots ; l’attention donne la même capacité aux LLM.
Pour y parvenir, la couche réalise une série de comparaisons entre les composantes de la séquence, ici les jetons. Elle obtient ainsi une séquence de sortie, réutilisable ensuite pour des tâches très diverses. Le vecteur de « cela » repart donc enrichi des mots qui l’éclairent, au lieu de rester une représentation isolée.
Pourquoi on dit « auto »
Le préfixe ne se comprend que par contraste. Le mécanisme d’attention est né en traduction, avec deux séquences : pour écrire un mot français, le modèle compare l’état courant du décodeur  à chaque état
 de l’encodeur. Premier geste, mesurer leur ressemblance :
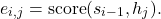
Le score peut être un produit scalaire, une similarité cosinus ou un petit réseau feedforward.
Deuxième geste, passer tous ces scores dans une softmax, qui les écrase entre 0 et 1 et donne à chaque état une importance relative :
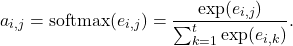
Troisième geste, faire la somme des états pondérée par ces poids :
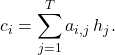
Le résultat  est un vecteur de contexte de longueur fixe, qui informe sur l’ensemble des états cachés.
L’auto-attention est la variante qui extrait l’information directement de l’entrée, sans forcément la comparer à autre chose. Q, K et V viennent de la même séquence. Dans l’attention croisée, au contraire, Q vient d’une autre séquence que K et V, ce qui conditionne Q par une information externe.
Les LLM emploient l’auto-attention. Les modèles de génération d’images et les modèles multimodaux emploient aussi l’attention croisée, par exemple entre l’image en cours de génération et le prompt associé.
📌 À retenir Avec « auto », la séquence joue les deux rôles à la fois : elle pose la question et fournit la réponse. Les tableaux
et
de l’attention sont alors carrés, de taille
, au lieu d’être rectangulaires comme dans la traduction.
Trois matrices apprises, puis une moyenne pondérée
La couche part de et en tire trois versions, chacune par une matrice de poids qui lui est propre :
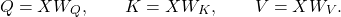
Ces matrices  ,
 et
 sont les poids de la couche : on les initialise au hasard et l’entraînement les apprend. Chaque jeton se retrouve ainsi décrit trois fois : par
 , les requêtes, vers lesquelles se centre l’attention du moment ; par
 , les clés, qui situent les autres entrées ; et par
 , les valeurs, dont on tire l’information finale.
Les trois gestes vus plus haut sont toujours là. Le produit scalaire  remplace la fonction de score, la softmax donne les poids, et le produit par fait la somme pondérée :
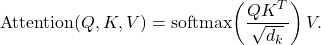
Ici  est la dimension des clés : diviser par sa racine carrée stabilise les gradients. Pour une couche, c’est donc la formule complète, avec une softmax et un produit de matrices.
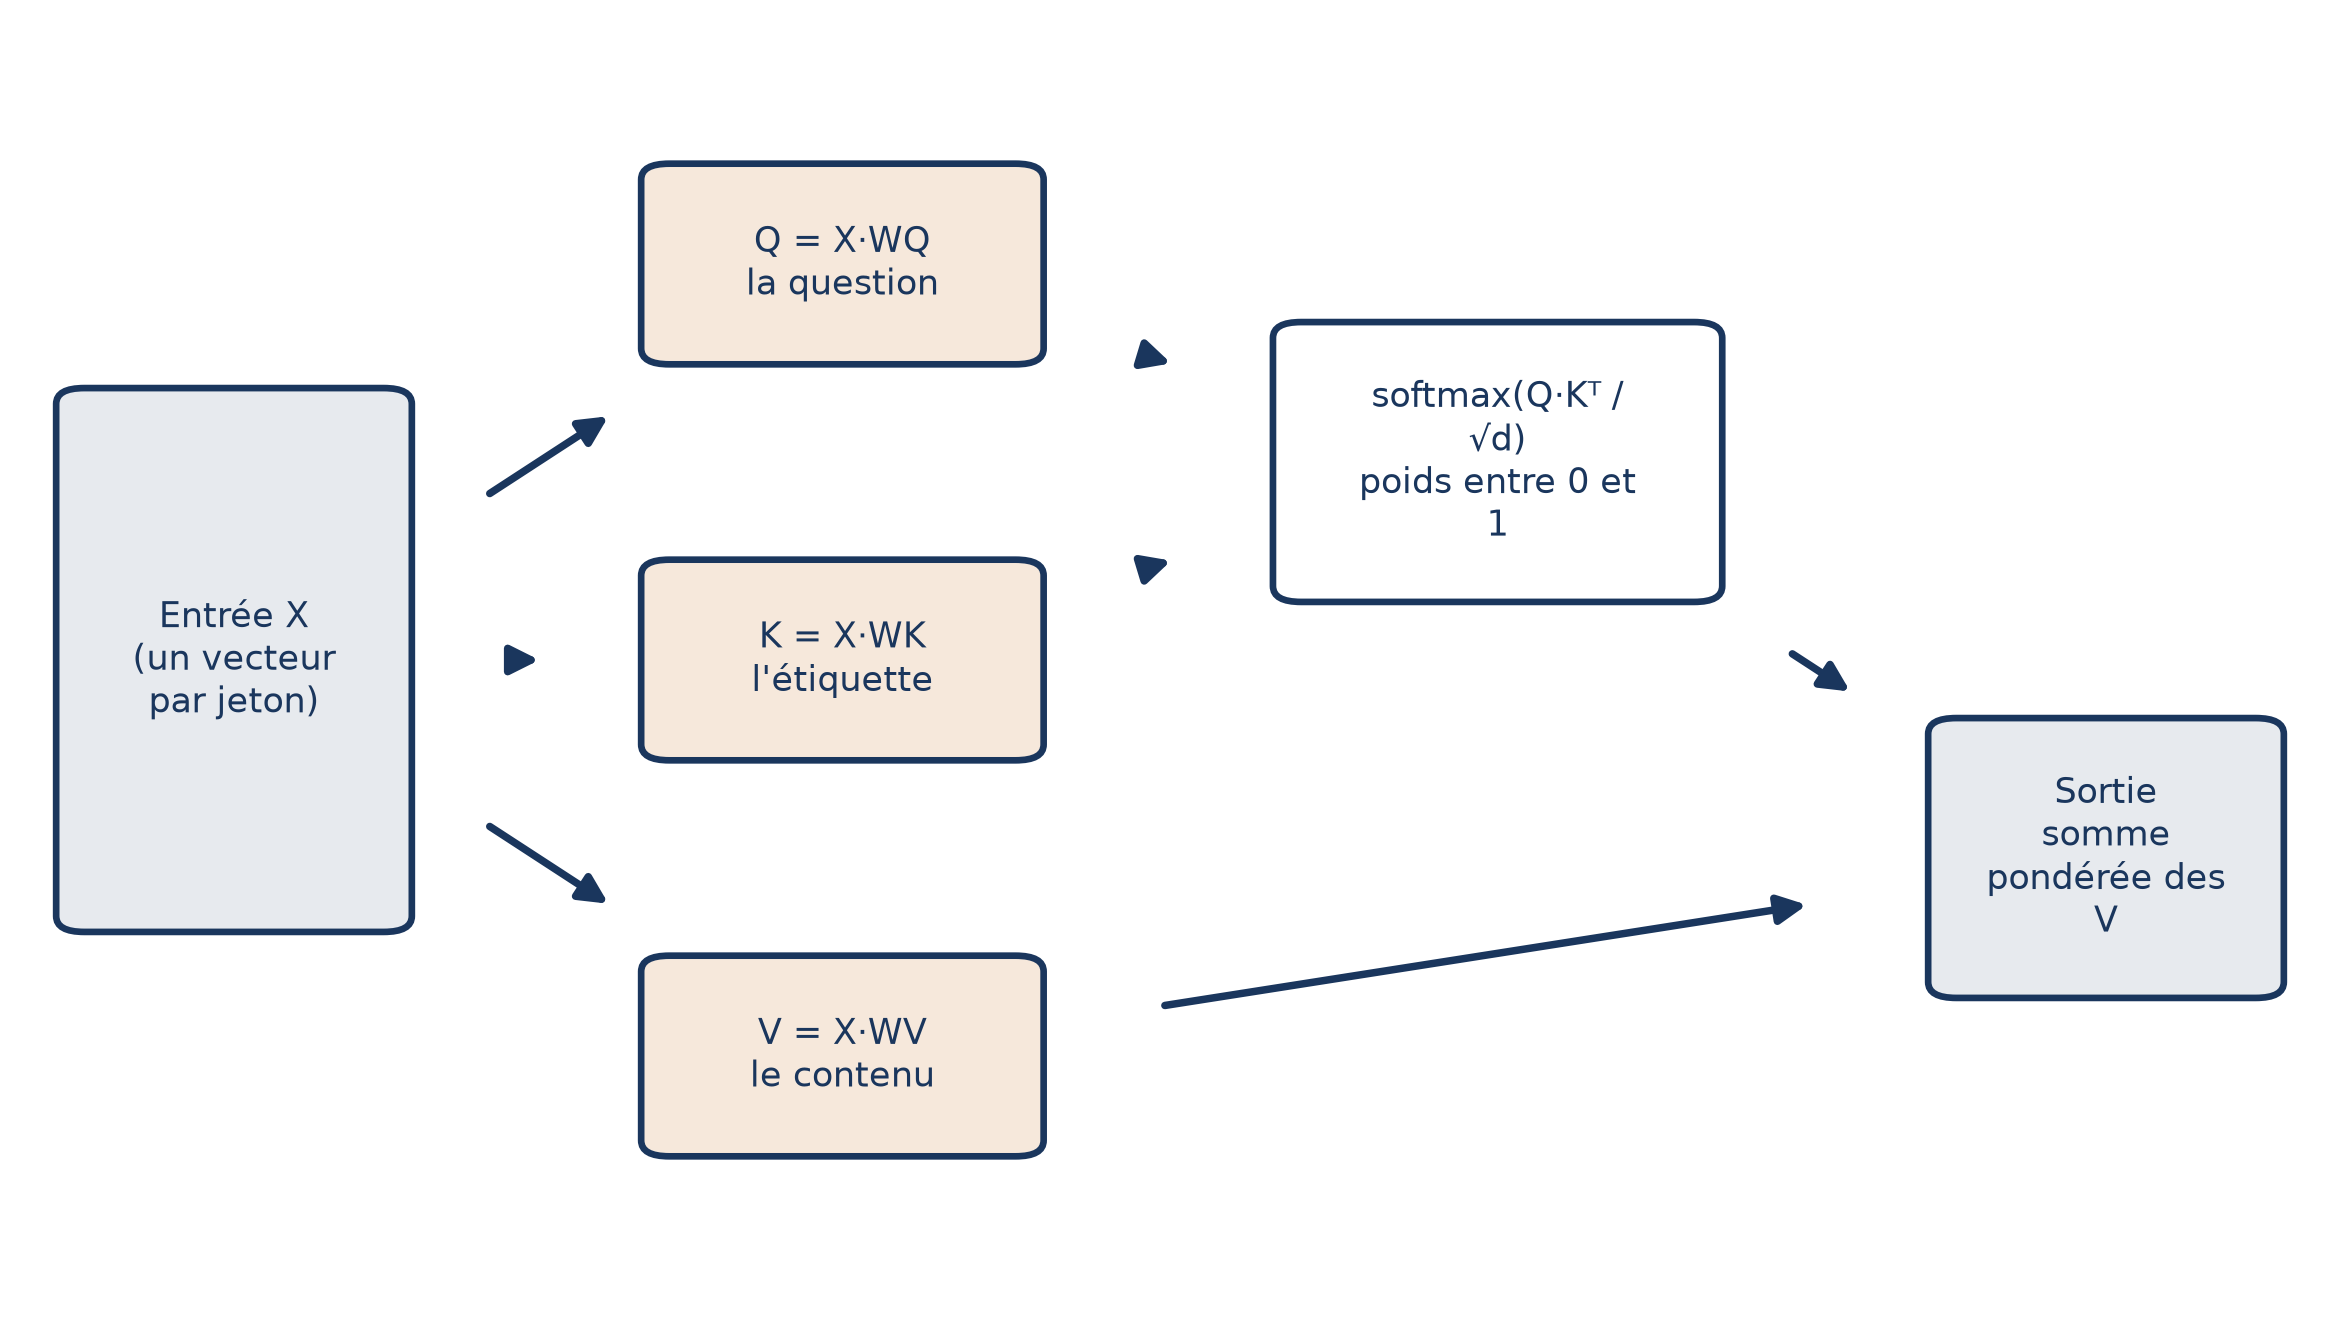
Ce dispositif a un avantage : il extrait plusieurs représentations de la même entrée, puisque rien n’empêche de poser plusieurs questions à la même séquence.
Des têtes en parallèle, des couches en série
Une couche réelle ne lance pas un seul calcul de ce genre, mais plusieurs. Chaque tête est une opération d’attention complète, et les têtes tournent en parallèle dans la même sous-couche. Chacune peut se charger de relations différentes, comme l’accord sujet-verbe ou la résolution de coréférence, le cas de notre « cela ».
Au fil de l’entraînement, chaque tête voit ses matrices et se spécialiser sur un type de relation. Les têtes donnent sorties, concaténées puis passées dans une projection linéaire finale qui ramène la dimension à celle de l’entrée : c’est elle qui garantit la forme du début.
Ensuite, on empile. Le corps d’un LLM est une série de dizaines à centaines de blocs transformeurs, entre une couche d’embedding qui transforme les tokens en vecteurs et une couche de sortie qui convertit les états cachés en un score par token du vocabulaire.
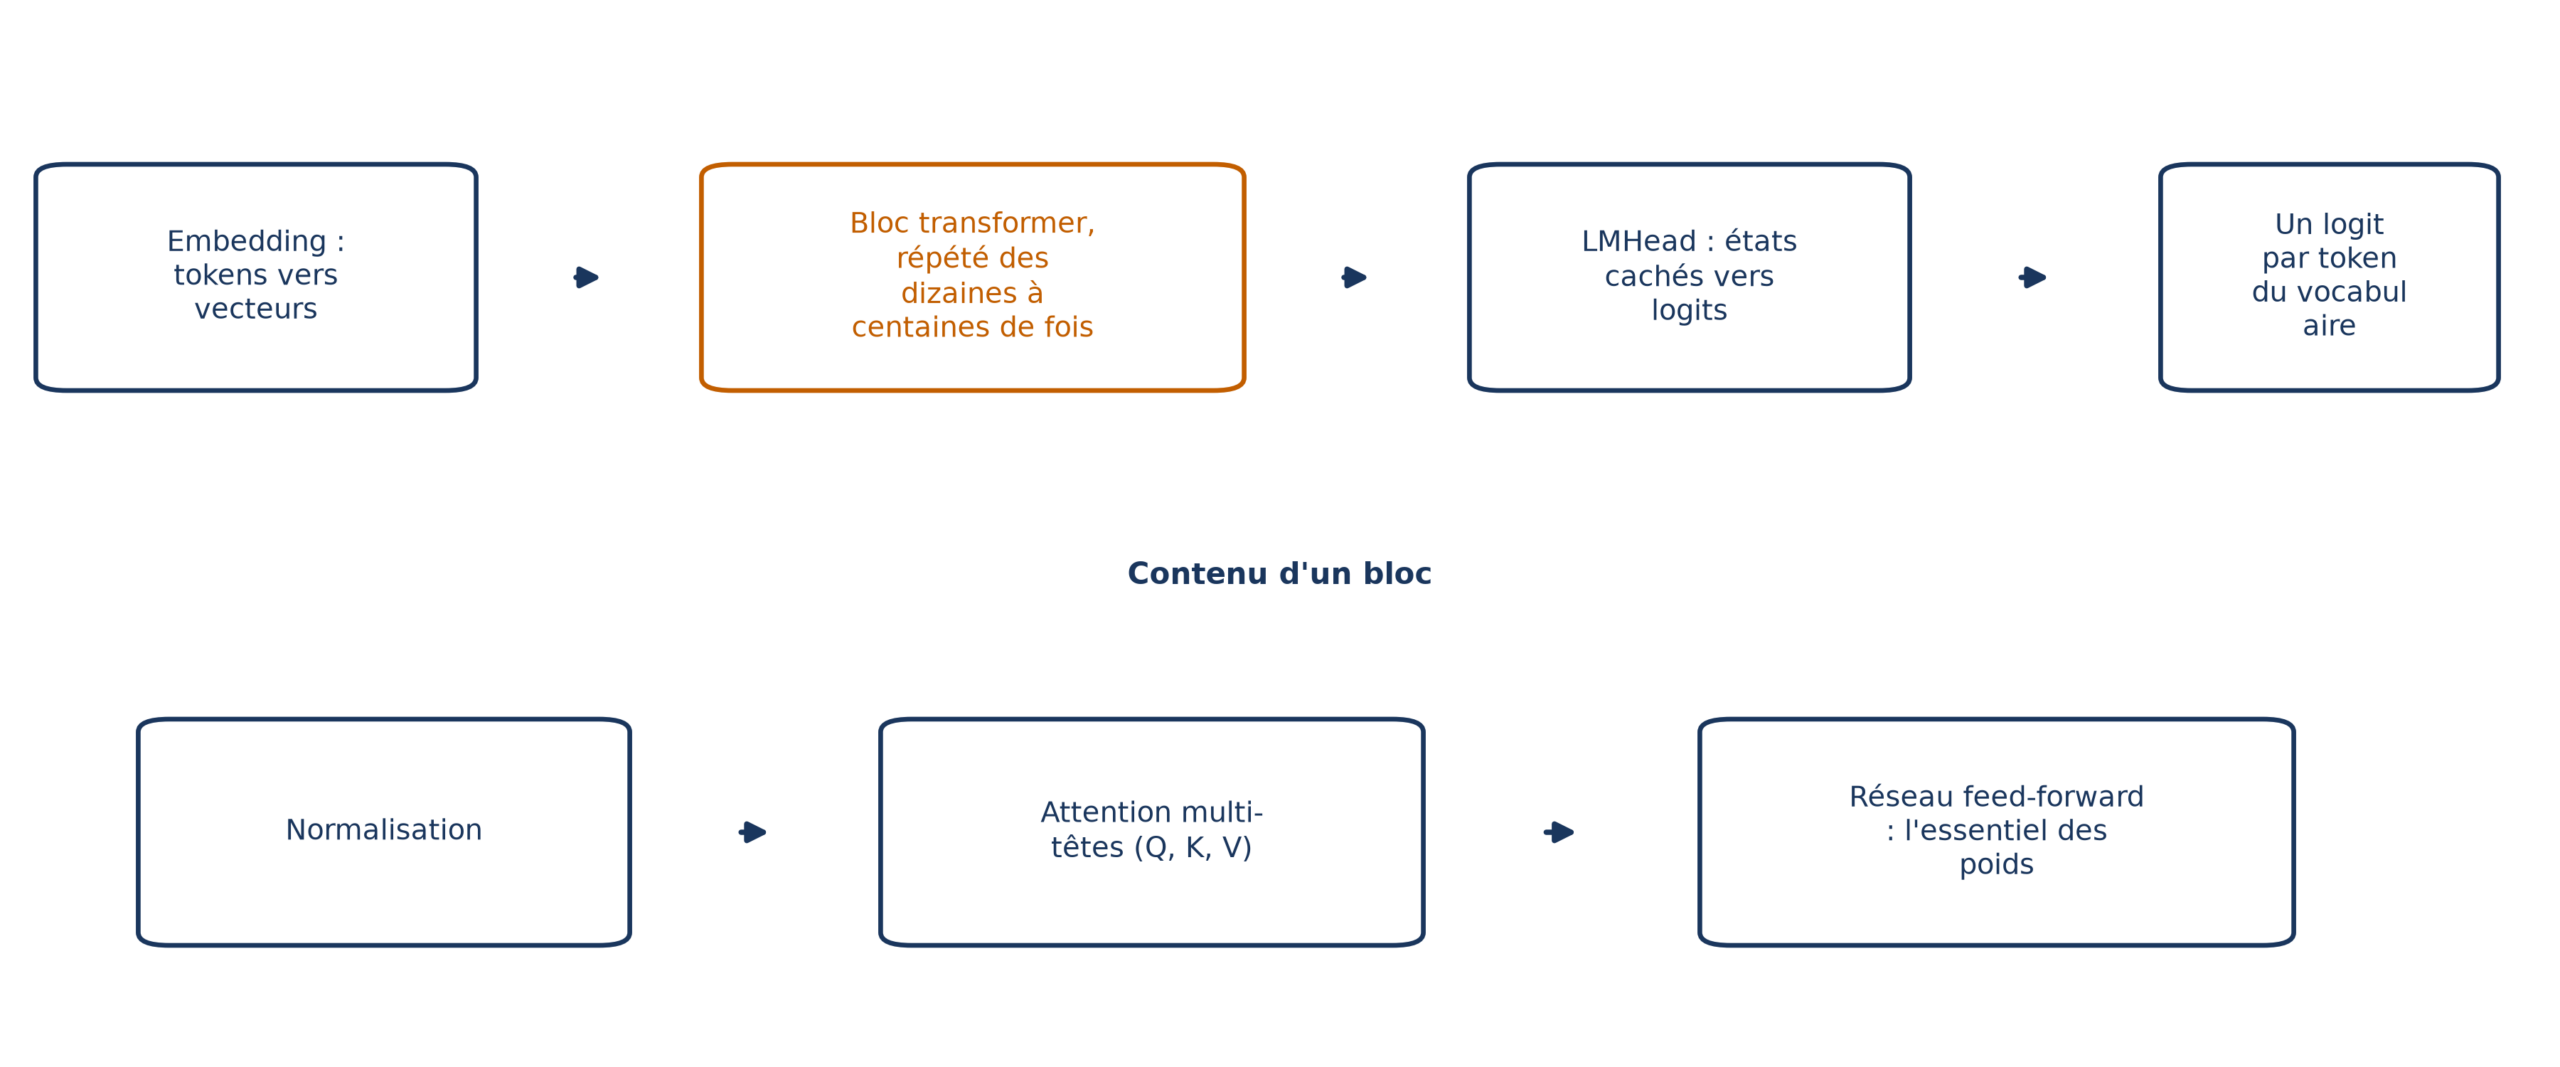
Chaque étage s’appuie sur le précédent : l’information apprise par les premières couches peut servir aux suivantes, et en avançant dans le modèle, les couches apprennent des représentations différentes.
Comment regarder ce travail ? Avec BERTviz, une vue d’ensemble affiche l’attention de toutes les couches et de toutes les têtes d’un modèle BERT. Elle attend trois objets déjà prêts : les poids d’attention, la liste des jetons, et l’indice où commence la seconde phrase d’une paire. Puis un seul appel suffit :
model_view(attention, tokens, sentence_b_start)
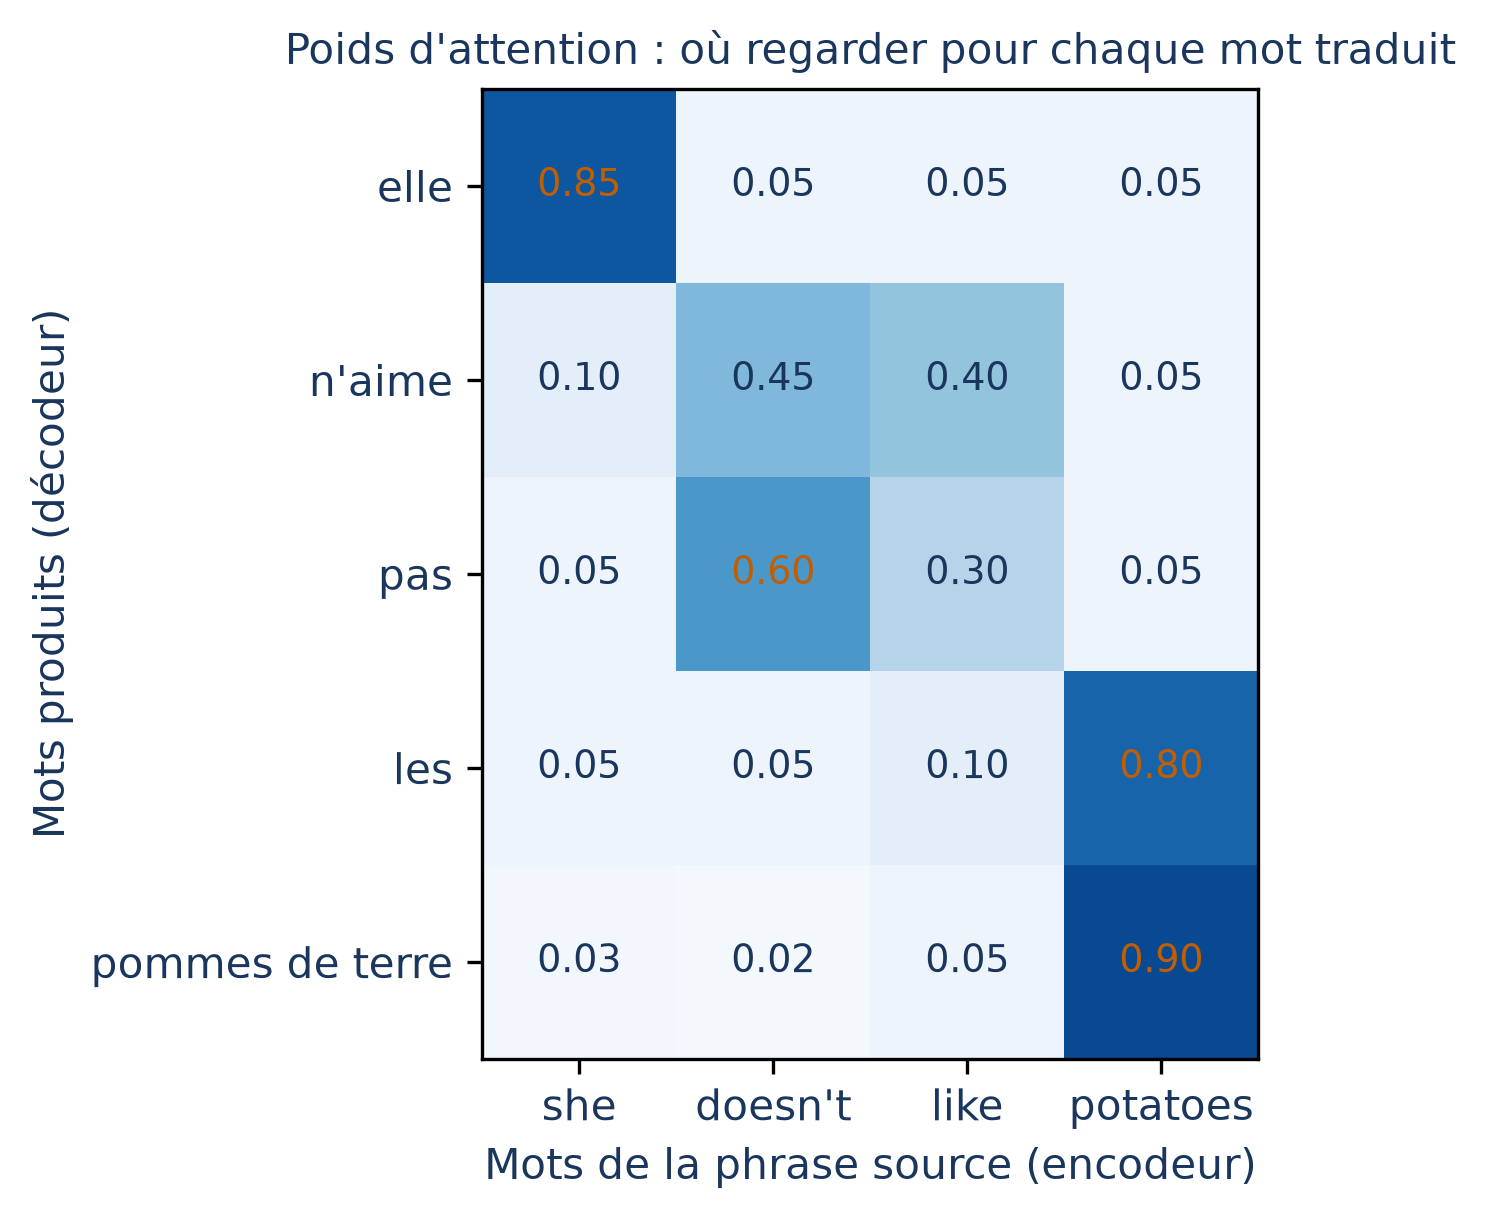
Dans cette vue, l’intensité de la couleur indique un poids d’attention plus fort : les couleurs sombres sont des poids proches de 1.
Trois idées reçues sur la couche d’auto-attention
« C’est la couche d’attention qui porte l’essentiel des poids »
Non. Dans un LLM, les sous-couches linéaires forment la majorité des poids entraînables, devant les sous-couches d’attention, deuxième composant en taille. Normalisations et fonctions d’activation sont une erreur d’arrondi dans la taille du modèle.
Le nombre de paramètres dépend de trois facteurs : la couche d’embedding, le mécanisme d’auto-attention (plusieurs matrices de poids, éventuellement plusieurs têtes) et la profondeur, car chaque bloc de plus ajoute des paramètres.
« Elle sait dans quel ordre sont les mots »
Pas du tout : l’auto-attention n’a aucune notion intrinsèque d’ordre. Cette information est ajoutée avant la couche : une fonction enregistre la position de chaque jeton, et son résultat s’additionne aux vecteurs d’embedding.
« Sans auto-attention, pas de modèle de langage »
C’est moins sûr. Elle a un coût quadratique en fonction du nombre de jetons, et on cherche donc à s’en passer. Mamba, un modèle d’espace d’états sélectif, remplace l’auto-attention par une mise à jour d’état récurrente, avec une croissance linéaire en longueur de séquence.
Les applications de ces modèles restent limitées, mais des modèles hybrides, qui mélangent blocs de type Mamba et blocs transformeurs, gagnent du terrain, avec des modèles ouverts comme NVIDIA Nemotron 3 Nano.
⚠️ Piège Parler de « la » couche d’auto-attention d’un modèle est trompeur : il y en a des dizaines, avec des poids différents. Chacune reçoit un tableau et en rend un de même taille, mais aucune ne calcule la même chose que sa voisine.