Prends le salaire d’un individu en fonction de son âge : la relation est manifestement non linéaire, et pourtant rien ne t’empêche de poser une droite dessus et d’obtenir des coefficients, des p-valeurs, un diagnostic en bonne et due forme. La régression linéaire répond toujours ; la vraie question est de savoir quand sa réponse mérite ta confiance. À la fin de cet article, tu sauras quels symptômes te font garder la droite, lesquels t’obligent à l’assouplir, et quelle variante répond à chacun.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi la droite bat souvent des méthodes bien plus souples
- Trois lectures chiffrées avant de croire ta droite
- Trop de variables pour trop peu d’observations
- Quand la relation courbe : sortir de la droite par paliers
- Le verdict en un tableau
L’essentiel en 30 secondes
- Si la relation est à peu près droite, la droite l’emporte presque toujours sur des méthodes plus souples, surtout quand les prédicteurs sont nombreux.
- Trois lectures chiffrées valident ton modèle : l’erreur résiduelle, l’intervalle de confiance de la pente et les résidus studentisés.
- Dès que le nombre d’observations n’est plus très supérieur à celui des variables, passe à ridge, lasso ou PCR.
- Pour une relation courbe, monte la souplesse par paliers : polynôme, escalier, splines, régression locale, puis modèle additif.
- Plus tu gagnes en souplesse, plus tu perds en lisibilité : choisis la variante la plus simple qui règle ton symptôme.
Pourquoi la droite bat souvent des méthodes bien plus souples
Devant un nuage de points, le réflexe est de croire qu’une méthode plus souple fera forcément mieux. Mets-la à l’épreuve avec son concurrent le plus naturel, les K plus proches voisins : pour prédire la réponse en un point  , on moyenne les réponses des
 observations d’entraînement les plus proches de .
Le réglage de dose la souplesse. Un petit épouse des relations très irrégulières, mais la prédiction change beaucoup d’un échantillon à l’autre (variance élevée). Un grand lisse tout : la prédiction se stabilise, au prix d’un biais plus grand, c’est-à-dire d’une simplification plus grossière.
Voici le verdict. Quand la vraie relation est à peu près linéaire, la droite gagne presque toujours contre les voisins, même avec un bien choisi : en imposant la bonne forme dès le départ, elle garde un biais quasi nul sans payer le coût en variance d’une méthode non paramétrique.
💡 Intuition Les voisins cherchent la forme sans la présupposer ; la droite la devine d’avance. Si ton pari est bon, tu as économisé des données ; s’il est mauvais, c’est toi qui paies.
Les voisins ne reprennent la main que si la vraie relation s’écarte nettement de la droite, et cet avantage fond quand le nombre de prédicteurs  grandit. C’est le fléau de la dimension : avec beaucoup de prédicteurs, même un très grand jeu de données n’offre plus de voisins réellement proches. Un modèle paramétrique correctement spécifié reste alors souvent préférable dès que n’est plus tout petit.
La droite a son prix, naturellement : elle repose sur une hypothèse forte sur la forme de la relation. Elle est simple à ajuster, facile à interpréter et offre des tests de significativité directs, mais si l’hypothèse s’éloigne trop de la réalité, sa précision prédictive en pâtit. Une méthode non paramétrique évite l’hypothèse, à condition de disposer d’un très grand nombre d’observations.
Trois lectures chiffrées avant de croire ta droite
Garder la droite ne dispense pas de la jauger. Trois lectures te disent vite si elle tient.
L’erreur résiduelle : de combien te trompes-tu ?
L’erreur type résiduelle (RSE) est la racine carrée de  et estime l’écart-type de l’erreur
 : grossièrement, l’écart moyen entre la réponse observée et la vraie droite. Sur un jeu de ventes publicitaires, elle vaut 3,26 : même en connaissant les coefficients exacts, chaque prédiction resterait fausse d’environ 3 260 unités, soit près de 23 % des ventes moyennes.
Comme la RSE se mesure dans les unités de la cible, son verdict dépend du domaine. Un modèle de physique en attendrait une quasi nulle ; en sciences sociales, une RSE bien plus élevée peut rester honorable.
Le  lève ce problème d’échelle en exprimant la qualité comme une proportion entre 0 et 1. Avec un seul prédicteur, c’est exactement le carré du coefficient de corrélation entre
 et
 ; l’équivalence ne se transpose plus telle quelle dès que les prédicteurs se multiplient.
La pente se distingue-t-elle de zéro ?
Pour savoir si une pente existe vraiment, on divise l’estimation par son erreur type :

Cette statistique  compte combien d’écarts-types séparent la pente estimée
 de zéro. La p-valeur en tire la probabilité d’observer, par pur hasard, une association aussi forte que celle mesurée si la vraie pente valait zéro.
Un intervalle de confiance à 95 % s’écrit 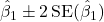 : en répétant l’échantillonnage un grand nombre de fois, il contiendrait la vraie valeur dans 95 % des cas. Pour la pente liée au budget télévisé des mêmes ventes, il vaut [0,042 ; 0,053] : zéro est loin, la relation est bien là.
Les points qui tirent la droite
Un point aberrant est une observation dont la réponse s’écarte fortement de la valeur prédite. Il bouge souvent peu la droite, mais il dégrade nettement la RSE et le . Divise son résidu par son erreur type estimée : un résidu studentisé au-delà de 3 en valeur absolue signale un point suspect.
Le point à fort levier, lui, a une valeur de prédicteur inhabituelle, sans réponse forcément aberrante, et il peut modifier substantiellement la droite. Avec plusieurs prédicteurs il se cache : un point peut paraître ordinaire sur chaque variable prise seule tout en étant atypique une fois toutes considérées ensemble. La statistique de levier  le quantifie.
⚠️ Piège Regarder chaque colonne l’une après l’autre ne suffit pas pour détecter un point à fort levier : c’est leur combinaison qui le rend atypique.
Trop de variables pour trop peu d’observations
Imagine quelques centaines de patients et, pour chacun, des centaines de milliers de mutations génétiques mesurées. Ou quelques milliers de documents décrits par des dizaines de milliers de termes. Les méthodes statistiques classiques, dont la droite des moindres carrés, ont été pensées pour  (beaucoup plus d’observations
 que de variables ) ; ici, c’est le contraire, et l’on parle de haute dimension.
Deux raisons de quitter les moindres carrés ordinaires
La première touche à la précision. Tant que la relation est à peu près linéaire et que dépasse largement , les moindres carrés ont un faible biais et une faible variance. Quand cesse de dominer nettement , la variance explose ; et si dépasse , il n’existe plus de solution unique.
La seconde touche à la lisibilité. Beaucoup de prédicteurs d’un modèle multiple ne sont en réalité pas associés à la réponse, et les moindres carrés ordinaires ne mettent presque jamais un coefficient exactement à zéro. Le modèle reste donc inutilement complexe.
Rétrécir les coefficients : ridge ou lasso
Au lieu de laisser les coefficients libres, on les contraint. La régression ridge minimise le RSS augmenté d’une pénalité qui punit les gros coefficients :
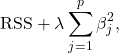
où  règle la sévérité de la contrainte. La pénalité épargne l’ordonnée à l’origine
 , qui n’est que la moyenne de la réponse. Contrairement aux moindres carrés, les coefficients ridge dépendent fortement de l’échelle des prédicteurs : standardise-les (moyenne nulle, écart-type un) avant d’ajuster.
Le lasso remplace la somme des carrés par la somme des valeurs absolues :
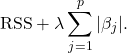
Ce détail change tout : dès que  est assez grand, certains coefficients deviennent exactement nuls. Le lasso fait donc de la sélection de variables et produit des modèles parcimonieux, bien plus lisibles qu’un ridge qui garde systématiquement les prédicteurs.
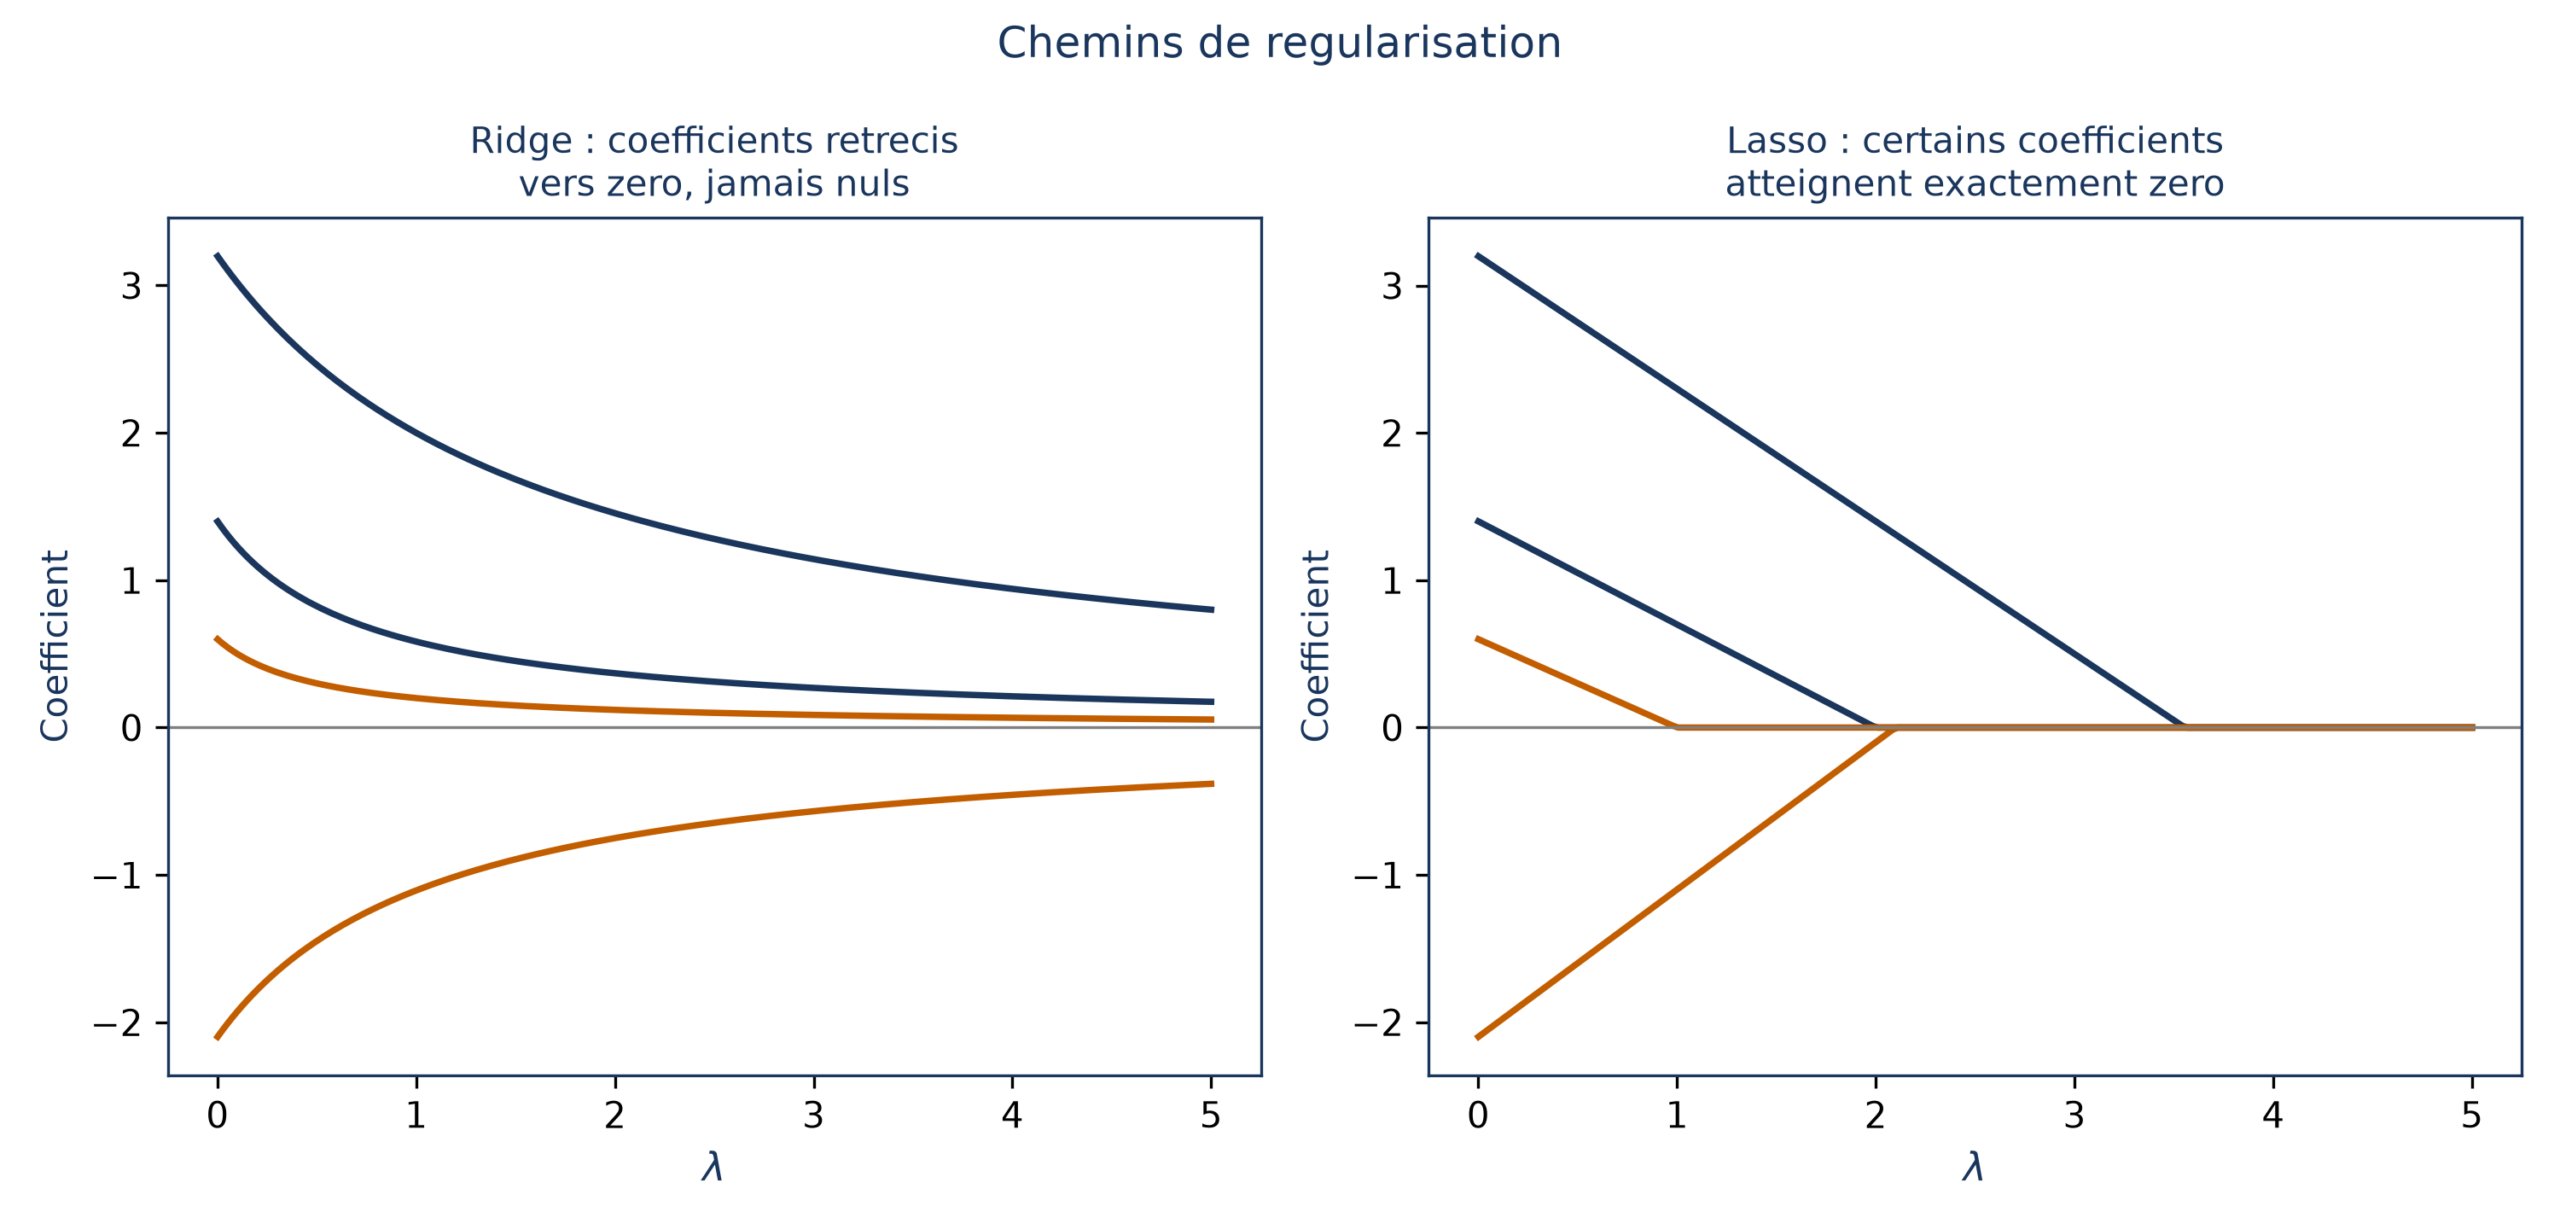
Reste à choisir. Ni l’un ni l’autre ne domine : le lasso l’emporte typiquement quand peu de prédicteurs ont un effet substantiel et que les autres coefficients sont proches de zéro ; le ridge reste préférable quand la réponse dépend, de façon comparable, d’un grand nombre de prédicteurs. Dans les deux cas, on ajuste le modèle sur une grille de valeurs de , on estime l’erreur de test de chacune par validation croisée et l’on retient celle qui la minimise.
Un jeu simulé le montre bien. Avec  prédicteurs et seulement
 observations, la variance chute très vite pour de petites valeurs de alors que le biais augmente à peine. L’erreur de test atteint son minimum pour un intermédiaire, nettement meilleur que les moindres carrés purs (
 ), dont l’erreur de test est presque aussi mauvaise que celle du modèle nul.
Voici comment cela s’écrit avec scikit-learn, pour choisir (nommé alpha dans son API) par validation croisée. Les lignes In [n]: sont des commandes saisies dans une session interactive ; ici lambdas est la grille de valeurs de à essayer, kfold le découpage en blocs de la validation croisée et scaler l’étape de standardisation.
In [17]: ridgeCV = skl.ElasticNetCV(alphas=lambdas,
                                      l1_ratio=0,
                                      cv=kfold)
         pipeCV = Pipeline(steps=[('scaler', scaler),
                                    ('ridge', ridgeCV)])
         pipeCV.fit(X, Y)
         tuned_ridge = pipeCV.named_steps['ridge']
         tuned_ridge.alpha_
L’argument l1_ratio=0 sélectionne une pénalité purement quadratique, donc un ridge ; l1_ratio=1 donnerait un lasso pur. Le Pipeline garantit que les prédicteurs sont standardisés avant chaque ajustement de la validation croisée, et la dernière ligne te rend la valeur de retenue.
Trier les variables plutôt que les rétrécir
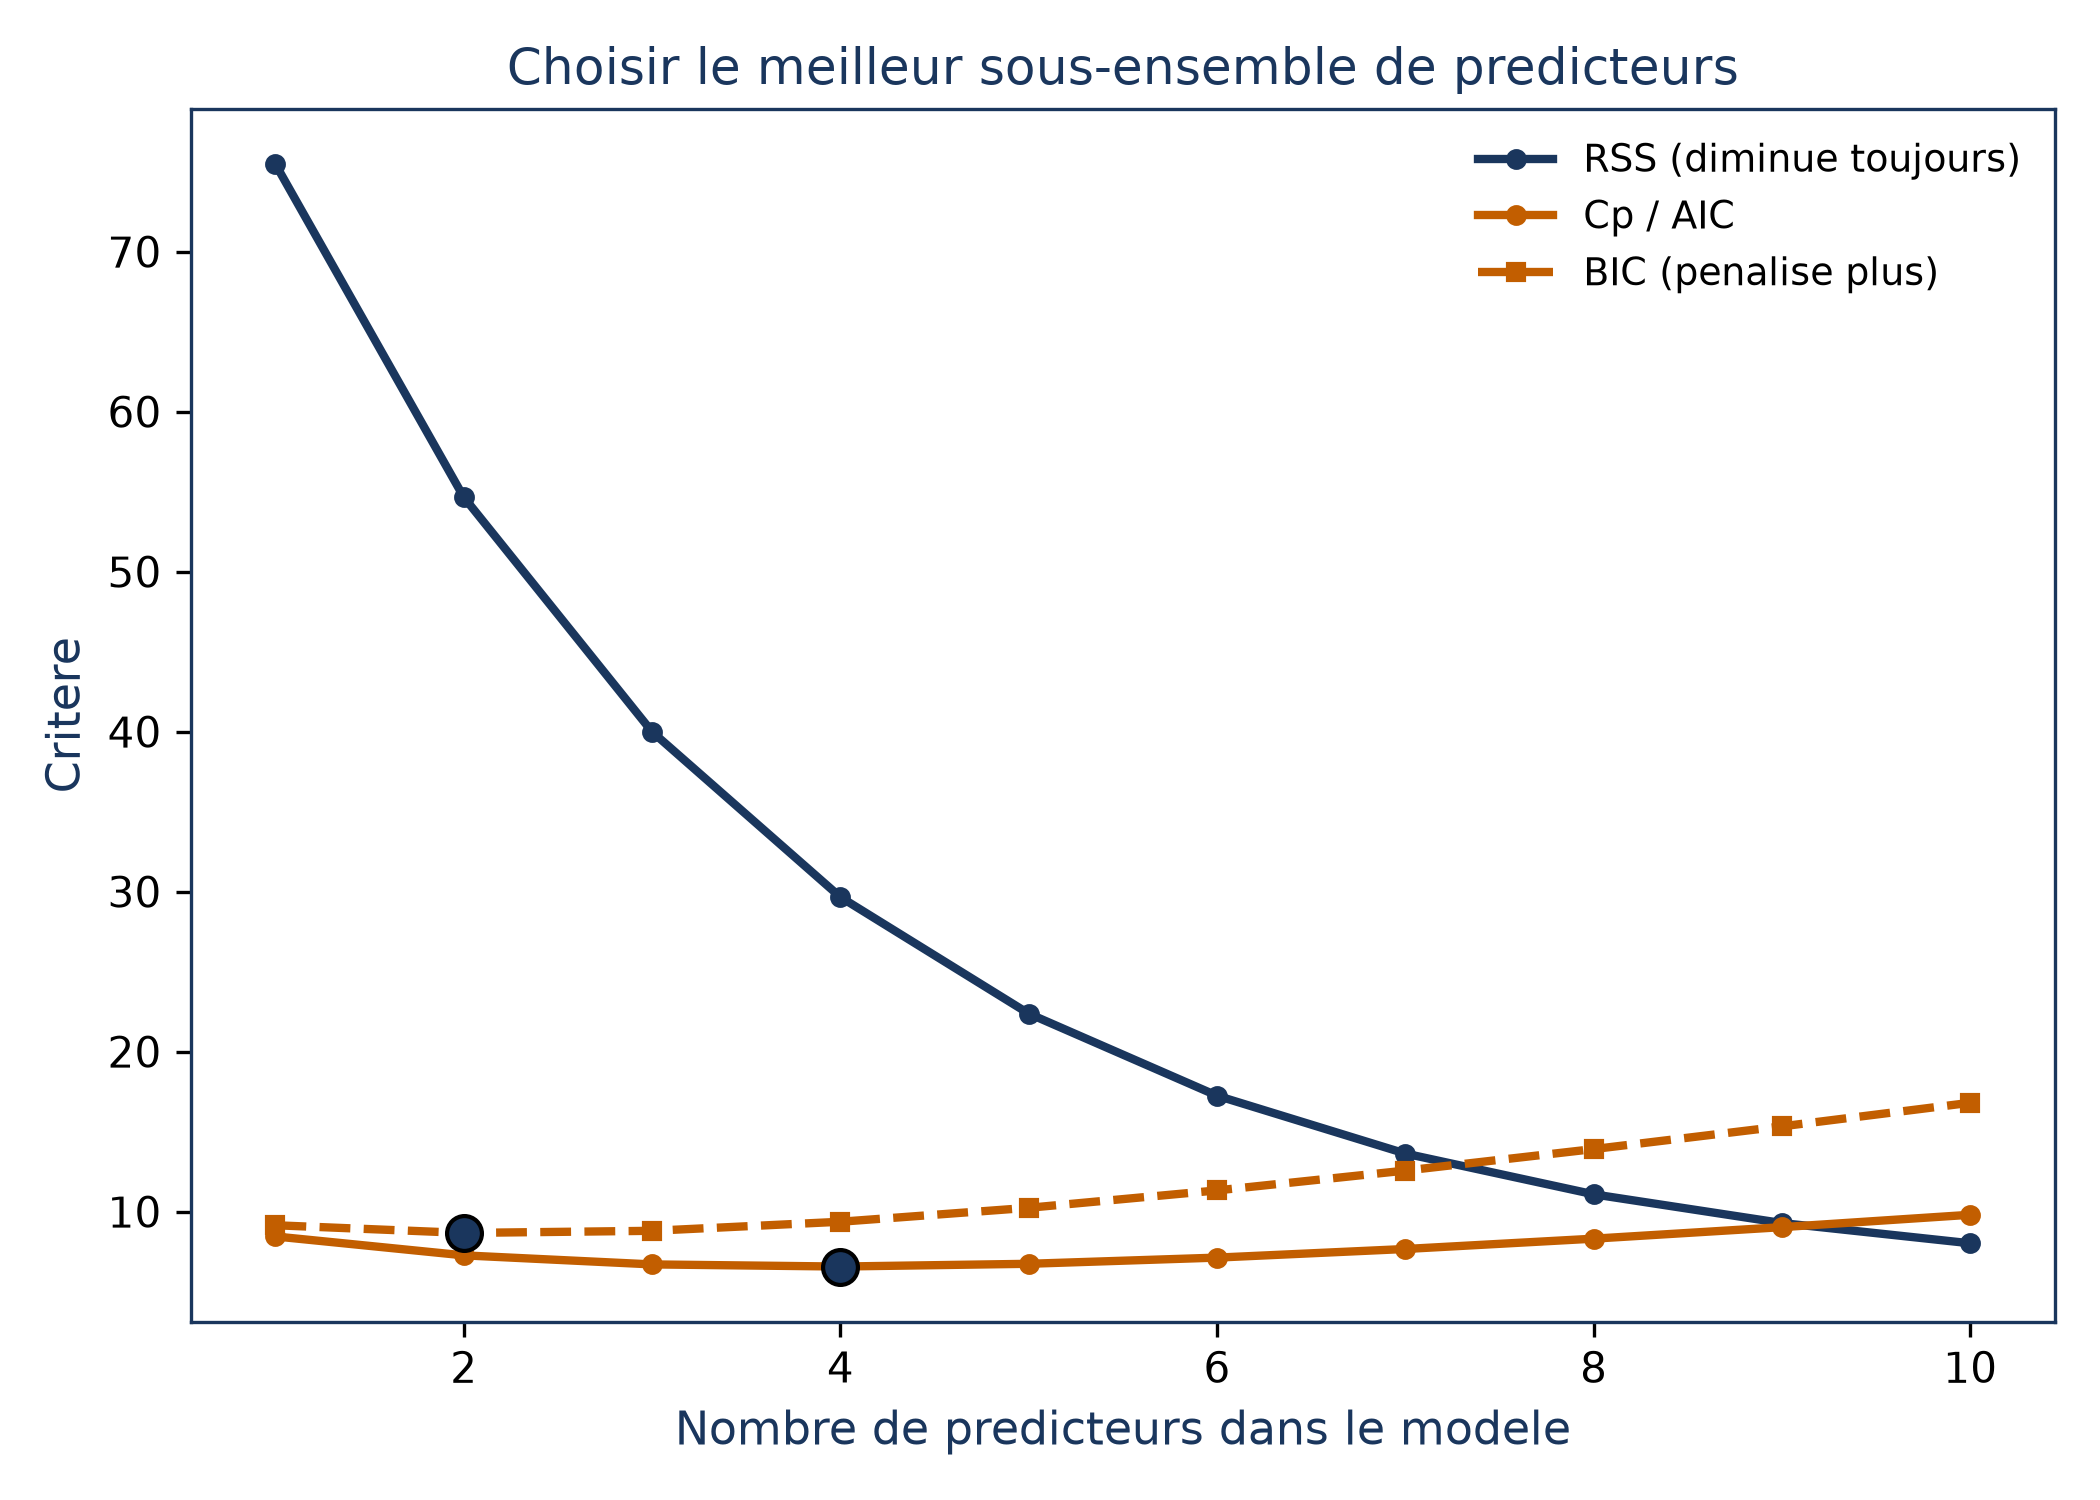
Tester tous les sous-ensembles de prédicteurs devient impraticable dès que dépasse une vingtaine, puisqu’il y en a  . On procède alors pas à pas : la sélection ascendante part du modèle vide et ajoute à chaque étape la variable qui améliore le plus l’ajustement ; la sélection descendante part du modèle complet et retire la moins significative.
Pour comparer les candidats, n’utilise pas le RSS d’entraînement : il baisse chaque fois que tu ajoutes un prédicteur. Appuie-toi sur une erreur de test estimée par validation croisée, ou sur un critère qui pénalise la complexité (Cp, AIC, BIC, ajusté).
Condenser les variables : PCR et PLS
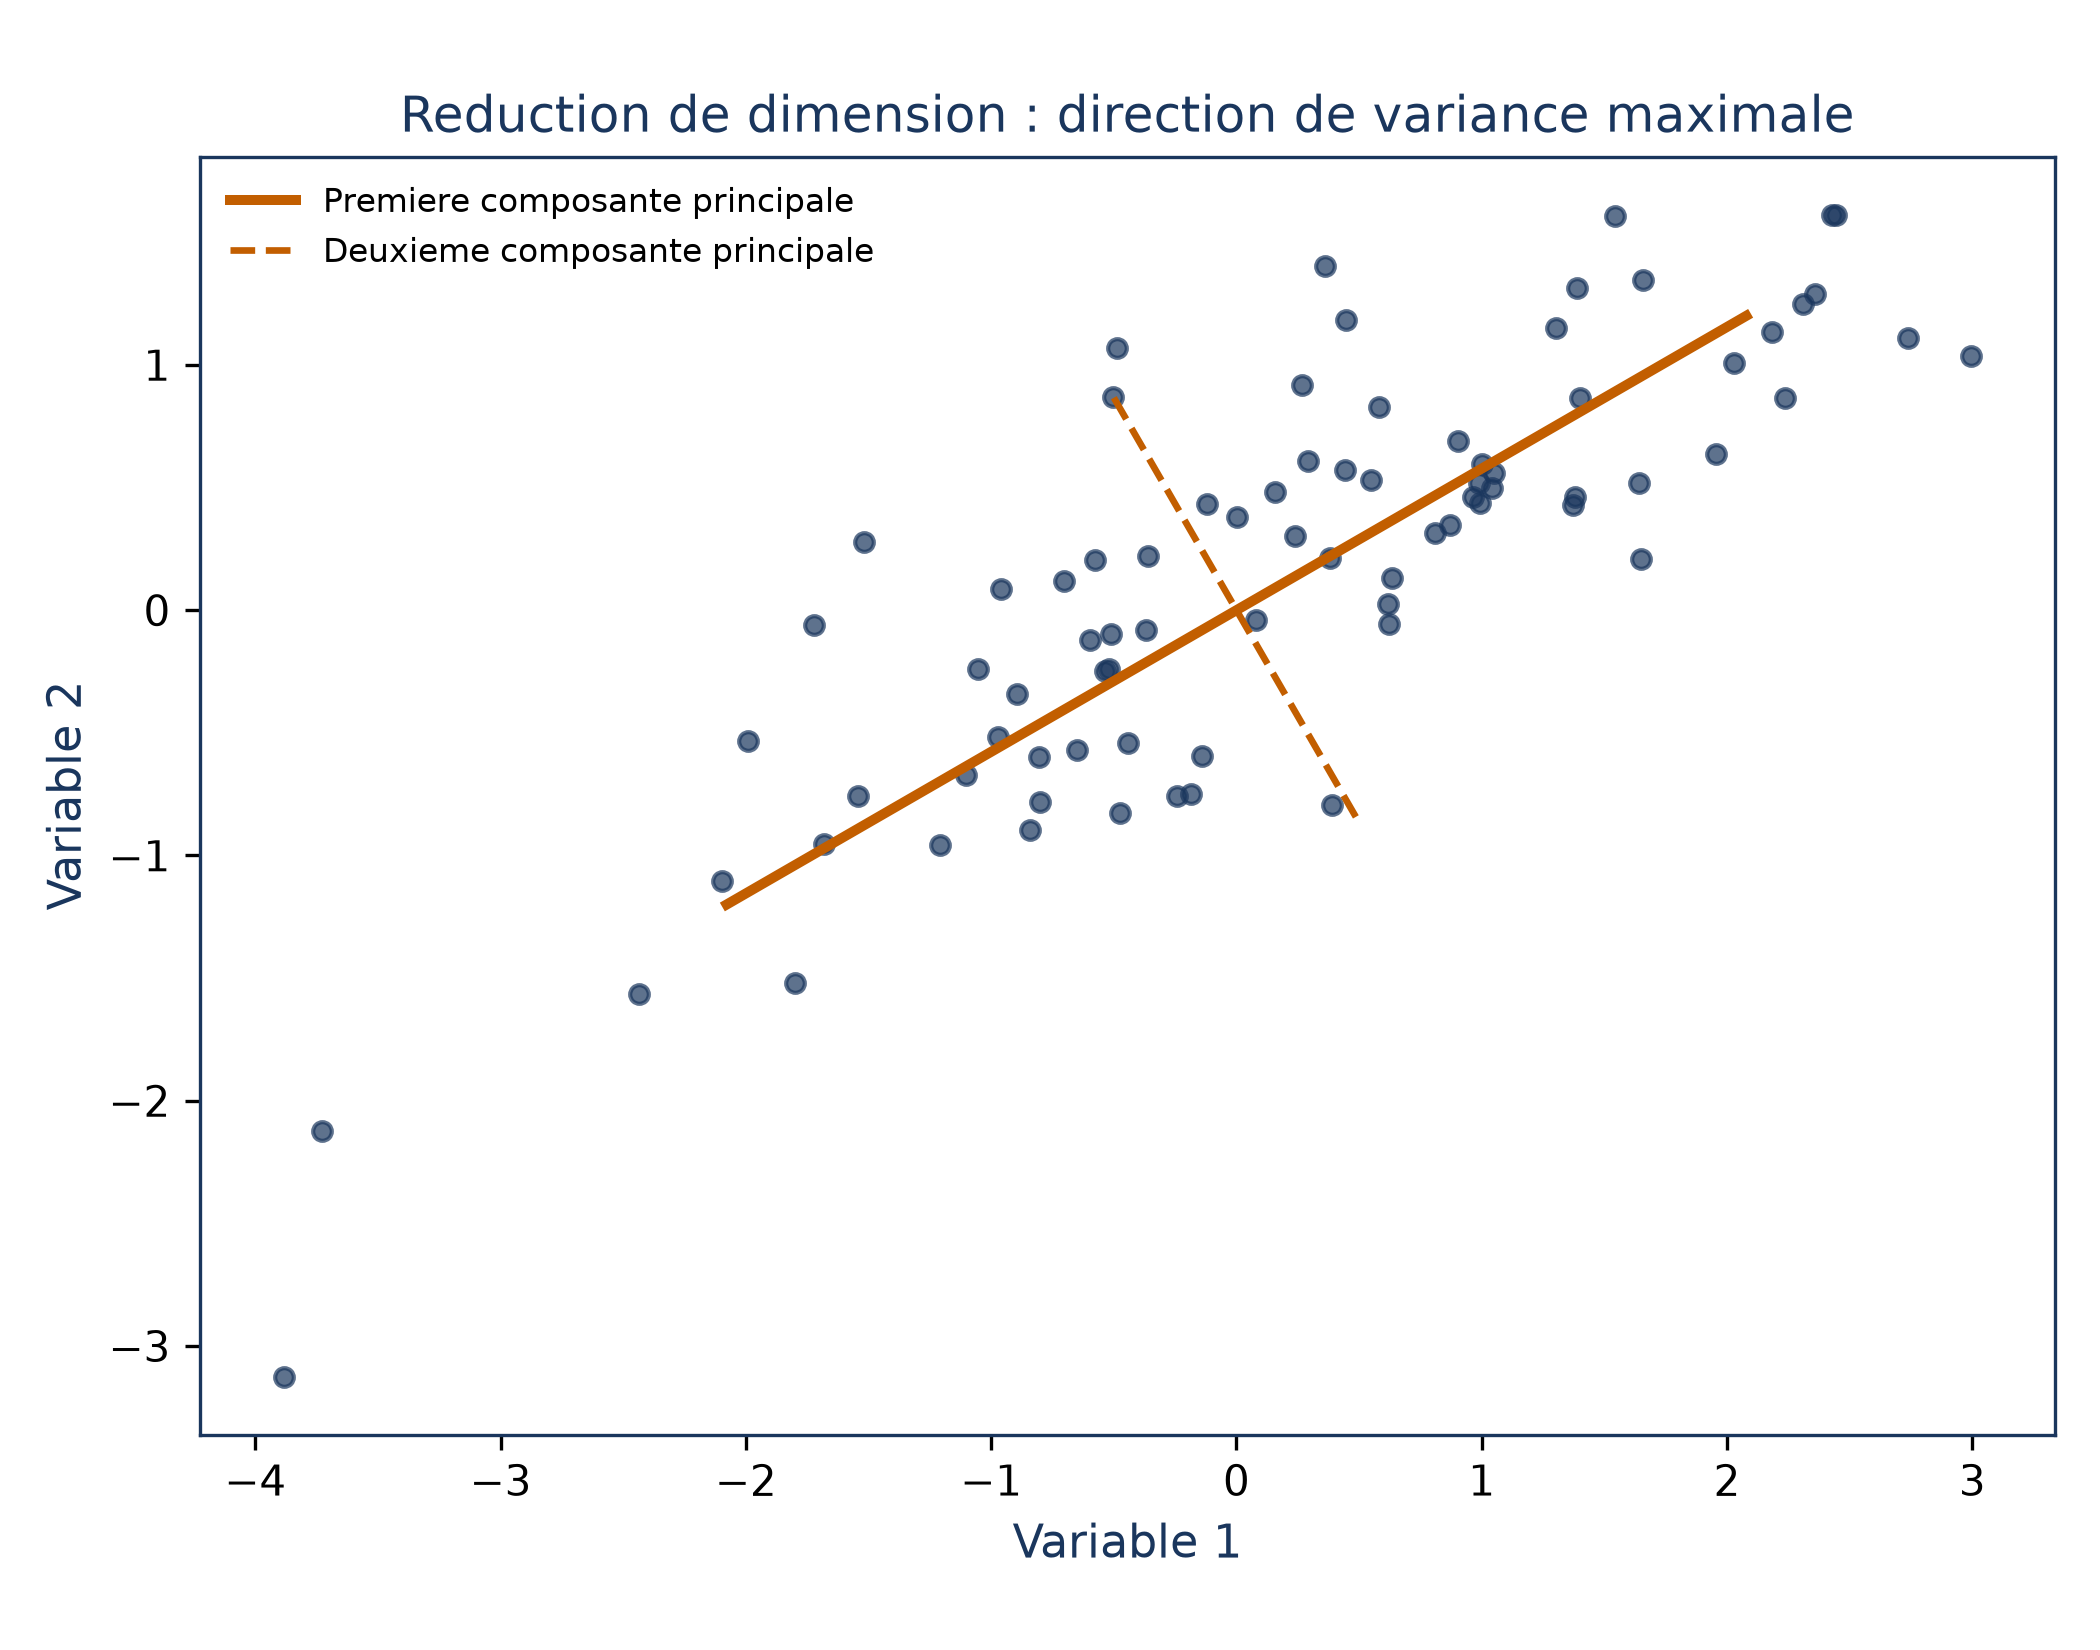
Une troisième voie ne trie ni ne rétrécit : elle fabrique  combinaisons linéaires des prédicteurs d’origine, puis les donne à une régression ordinaire. La régression sur composantes principales (PCR) retient les directions de plus forte variance, et le nombre
 se choisit par validation croisée, comme .
Deux limites s’imposent. Les composantes sont construites sans regarder la réponse, donc rien ne garantit qu’elles soient les plus utiles à la prédiction. Et la PCR ne sélectionne pas de variables, puisque chaque composante mélange tous les prédicteurs : elle ressemble bien plus au ridge qu’au lasso, au point qu’on peut voir le ridge comme sa version continue.
Les moindres carrés partiels (PLS) corrigent le premier défaut en construisant les combinaisons de façon supervisée. En pratique, ils ne font pas nécessairement mieux que la PCR ou le ridge : ce qu’on gagne en biais se paie souvent en variance, et le bénéfice net reste à peu près nul.
Quand les prédicteurs se recoupent, les coefficients flottent
Le ridge brille précisément quand les moindres carrés ont une forte variance : grand devant , ou prédicteurs fortement colinéaires. Le graphique ci-dessous donne la raison.
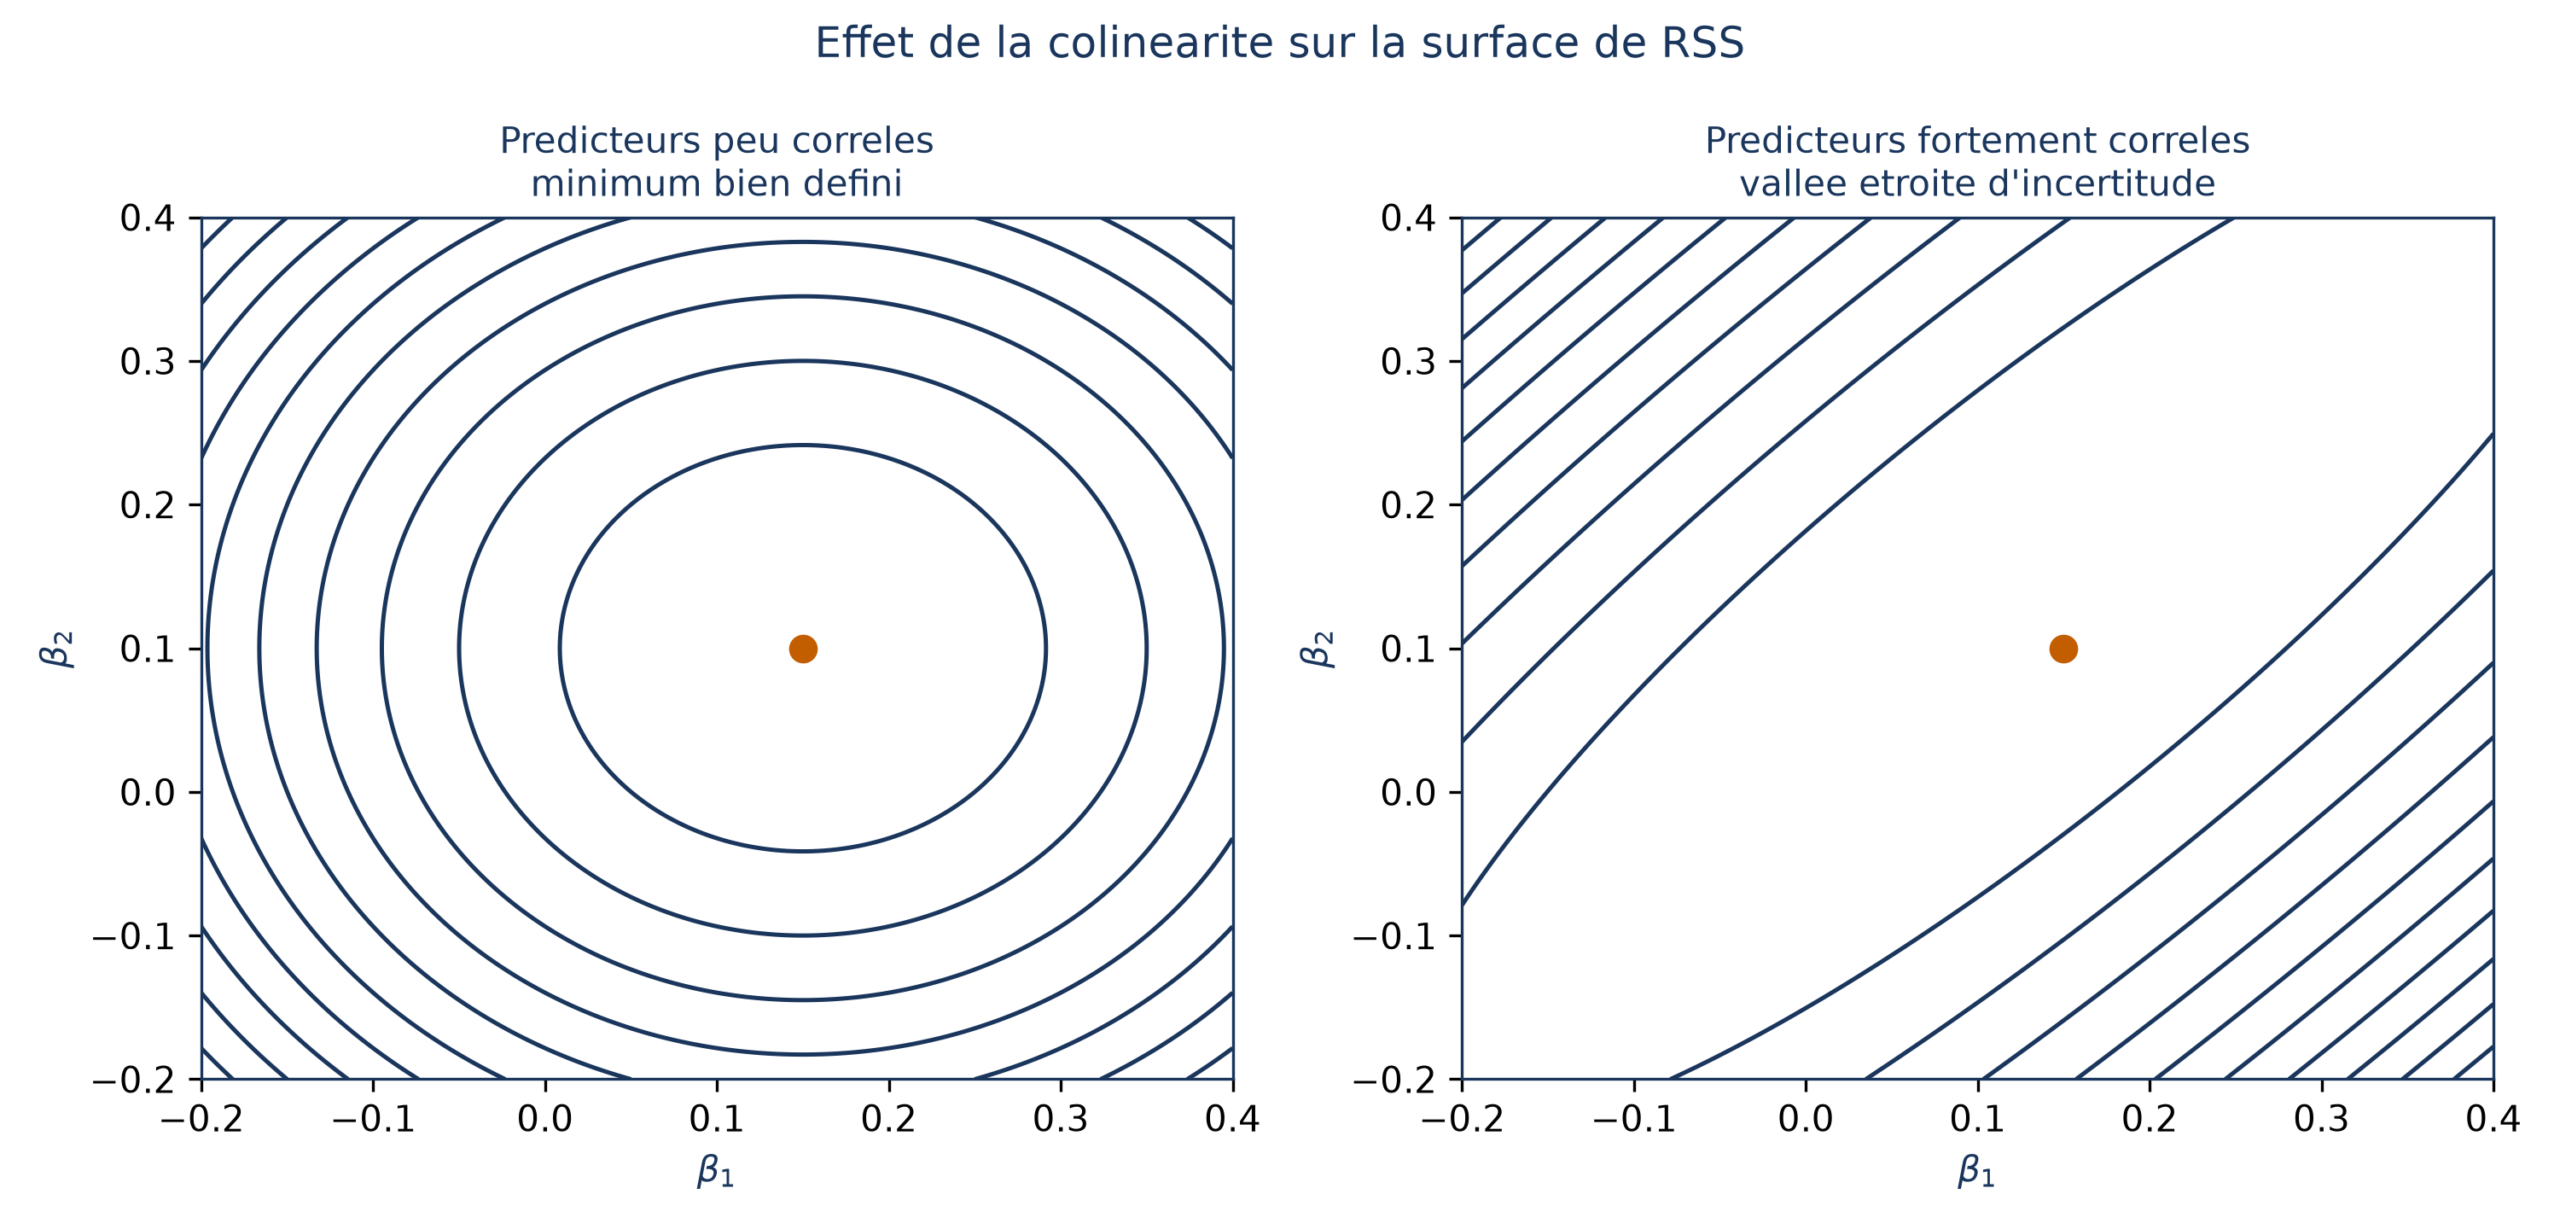
En haute dimension, ce phénomène devient extrême : chaque prédicteur s’écrit à peu près comme une combinaison des autres. On ne peut alors jamais savoir quelles variables sont vraiment associées à la réponse ; on peut seulement affirmer qu’un sous-ensemble, parmi peut-être plusieurs aussi valables, prédit bien les données observées.
⚠️ Piège Dans ce régime, lis le modèle comme un outil de prédiction, pas comme une liste de causes : la variable retenue par le lasso n’est pas forcément « la » variable qui compte.
Quand la relation courbe : sortir de la droite par paliers
Reviens au salaire et à l’âge. Même avec interactions, puissances et rétrécissement, un modèle linéaire reste une approximation linéaire de la vraie relation. Une série de méthodes assouplit cette contrainte tout en restant simples à ajuster et à interpréter, du plus rigide au plus souple.
Le polynôme. Remplacer par ses puissances 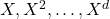 se fait avec les mêmes outils d’inférence (erreurs types, intervalles de confiance). On dépasse rarement le degré 3 ou 4 : au-delà, la courbe devient irrégulière, surtout près des bords, où elle prend des valeurs extrêmes et peu fiables.
La fonction en escalier. On découpe le domaine de en intervalles par des points de coupure et l’on ajuste une constante par intervalle. Plus de structure globale rigide, mais une discontinuité à chaque coupure et une sensibilité au choix, souvent arbitraire, de leur nombre et de leur emplacement.
Les splines. Une spline de régression ajuste un polynôme de bas degré sur chaque intervalle entre des points de raccordement appelés nœuds, avec des contraintes qui garantissent une courbe lisse. Près des bords, là où les données sont les plus rares, sa variance devient très instable ; la spline naturelle corrige ce défaut en restant linéaire au-delà des nœuds extrêmes, au prix de deux degrés de liberté « consommés ».
La spline de lissage évite le choix délicat des nœuds en le remplaçant par un unique paramètre de pénalité , qu’on sélectionne par validation croisée leave-one-out. Un raccourci de calcul rend cette sélection presque aussi rapide qu’un seul ajustement.
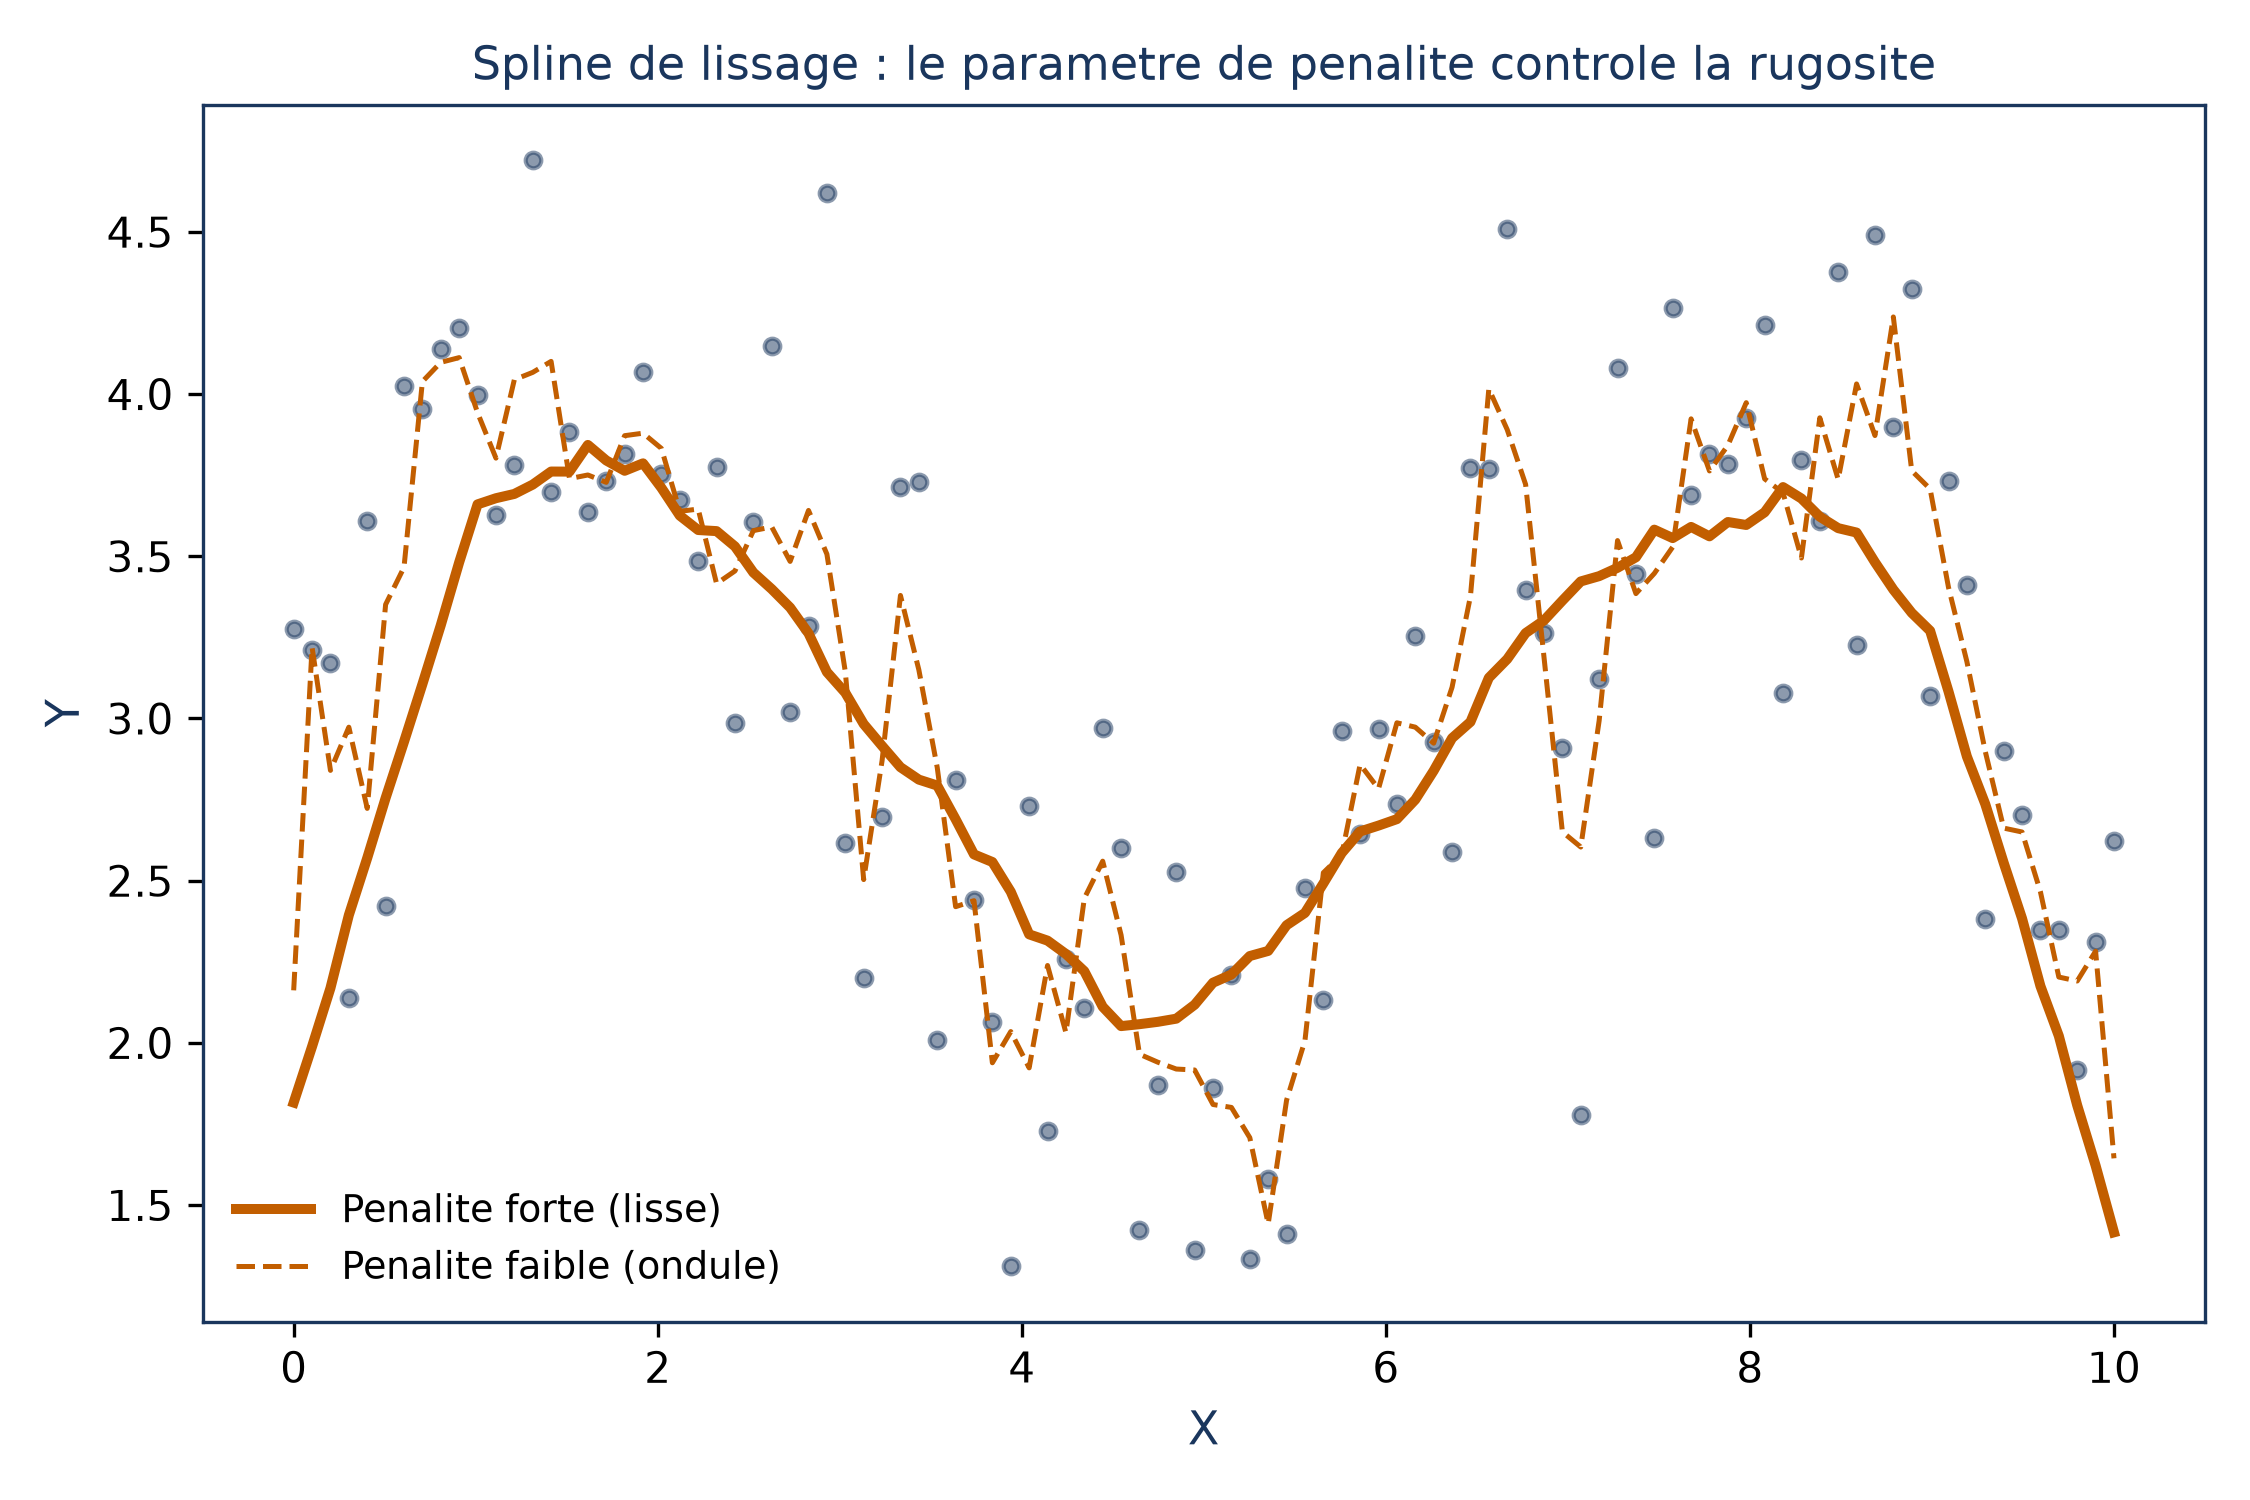
La régression locale. Pour estimer la relation en un point , on n’ajuste pas un modèle global mais une droite (ou un polynôme de bas degré) sur le seul voisinage de , en donnant plus de poids aux points proches. Un voisinage étroit donne une courbe flexible mais bruitée ; un voisinage large, une courbe lisse mais peut-être trop rigide.
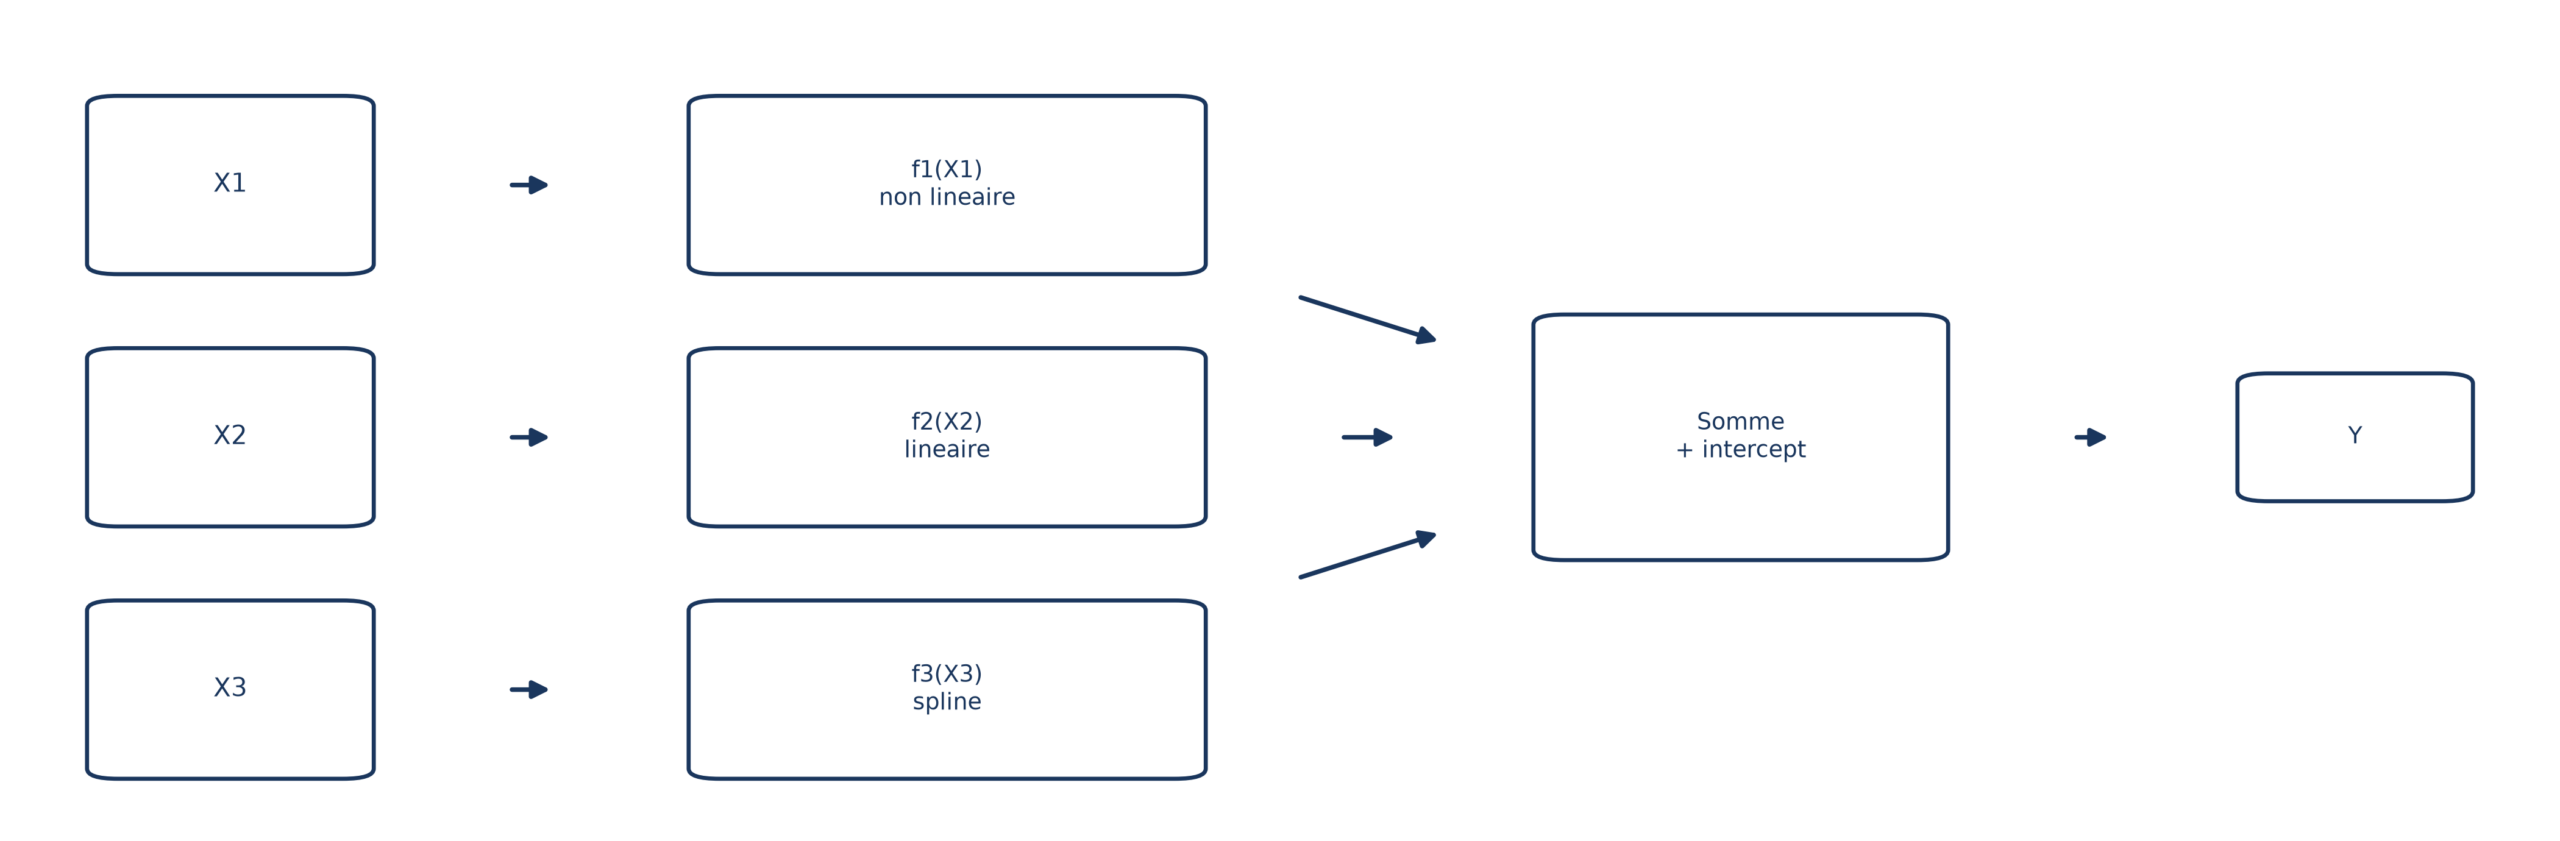
Toutes ces méthodes ne traitent qu’un prédicteur à la fois. Pour en combiner plusieurs, le modèle additif généralisé (GAM) remplace chaque terme  par une fonction propre à chaque variable :
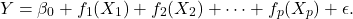
Les effets s’additionnent simplement, chaque  ne dépendant que de son prédicteur. Tu gardes donc l’essentiel de la lisibilité de la droite : tracer la courbe montre l’effet de chaque variable, toutes choses égales par ailleurs, un luxe qu’un modèle autorisant des interactions arbitraires ne permet plus.
Le verdict en un tableau
Repère ton symptôme dans la colonne de gauche, la réponse suit.
| Ce que tu observes | Ce que tu fais | Ce qui le justifie |
|---|---|---|
| Relation à peu près droite, petit devant |
Garde la droite | Biais quasi nul sans coût en variance ; elle bat les voisins |
| Relation très éloignée d’une droite, peu de prédicteurs, beaucoup de données | Passe aux voisins | Ils reprennent l’avantage seulement dans ce cas |
pas très supérieur à , ou  |
Rétrécis ou condense : ridge, lasso, PCR | La variance des moindres carrés explose |
| Peu de prédicteurs comptent vraiment | Lasso | Coefficients mis exactement à zéro |
| Beaucoup de prédicteurs comptent de façon comparable | Ridge | Tous restent, rétrécis |
| Un prédicteur, relation courbe | Polynôme (degré 3-4 au plus), escalier, splines, régression locale | Souplesse par paliers |
| Plusieurs prédicteurs, relations courbes | GAM | Une courbe par variable, effets additifs |
| Résidu studentisé au-delà de 3 | Examine le point | Il dégrade la RSE et le |
| Prédicteurs très corrélés | Ne lis pas les coefficients un à un | Seule leur combinaison est bien déterminée |
📌 À retenir La droite est un excellent point de départ, pas un réflexe : mesure son erreur, vérifie la pente, traque les points qui la tirent. Puis choisis la variante la plus simple qui règle ton symptôme, car chaque degré de souplesse gagné se paie en lisibilité.