Tu veux expliquer un salaire par l’année, l’âge et le niveau d’études. Une droite par variable est trop raide ; un modèle libre de tout croiser avec tout perd sa lisibilité. Entre les deux, il existe un compromis : laisser chaque variable dessiner sa propre courbe, puis tout additionner. À la fin, tu sauras ce qu’est un modèle additif généralisé (GAM), ce que le mot « généralisé » y ajoute, et ce que ce compromis t’interdit.
Sommaire
- L’essentiel en 30 secondes
- Les deux hypothèses cachées dans une droite
- Une courbe par variable, puis on additionne
- Pourquoi on dit « généralisé »
- Trois briques pour fabriquer une courbe
- Le GAM sur un cas : salaire, année, âge, études
- Ce que le GAM ne voit pas
L’essentiel en 30 secondes
- Un GAM remplace chaque terme linéaire d’une régression multiple par une fonction lisse propre à la variable.
- Les effets s’additionnent, donc le modèle reste lisible variable par variable.
- Comme la régression logistique, un GAM peut modéliser le logit d’une probabilité : il sert alors à classer.
- Chaque courbe peut se construire à partir d’une spline, d’un terme linéaire ou, pour une variable qualitative, d’un terme facteur.
- Contrepartie : les interactions entre variables passent inaperçues, sauf à les ajouter à la main.
Les deux hypothèses cachées dans une droite
Un modèle linéaire standard repose sur deux hypothèses discrètes. La première est l’additivité : l’effet d’une variable ne dépend pas des valeurs des autres. La seconde est la linéarité : une unité de plus produit toujours le même effet sur la réponse, quel que soit le point de départ.
On peut assouplir la première en ajoutant un terme d’interaction, le produit de deux variables. On peut contourner la seconde avec des puissances, comme dans la régression polynomiale, qui reste un modèle linéaire en ses coefficients et s’ajuste donc par les mêmes moindres carrés.
Un GAM prend un autre chemin : il lâche la linéarité mais garde l’additivité. Chaque variable peut agir de façon très courbe, à condition que son effet s’ajoute à celui des autres plutôt que de s’y mêler. Tout ce qui suit découle de ce choix.
Une courbe par variable, puis on additionne
Voici le modèle, écrit pour  variables explicatives :
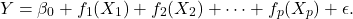
Lis-le terme à terme.  est la réponse à prédire,
 une constante,
 l’erreur. Chaque
 est une fonction non linéaire, une spline par exemple, appliquée à la seule variable
 : c’est elle qui remplace le terme
 de la régression multiple.
Pense à une note de restaurant. Chaque ligne est calculée à part, selon le plat commandé, et le total est la somme des lignes. Cela marche tant que le prix d’un plat ne dépend pas de ce que tu as pris à côté ; si une formule changeait le prix du dessert selon l’entrée, il faudrait un modèle qui sait croiser les variables. C’est exactement la frontière du GAM.
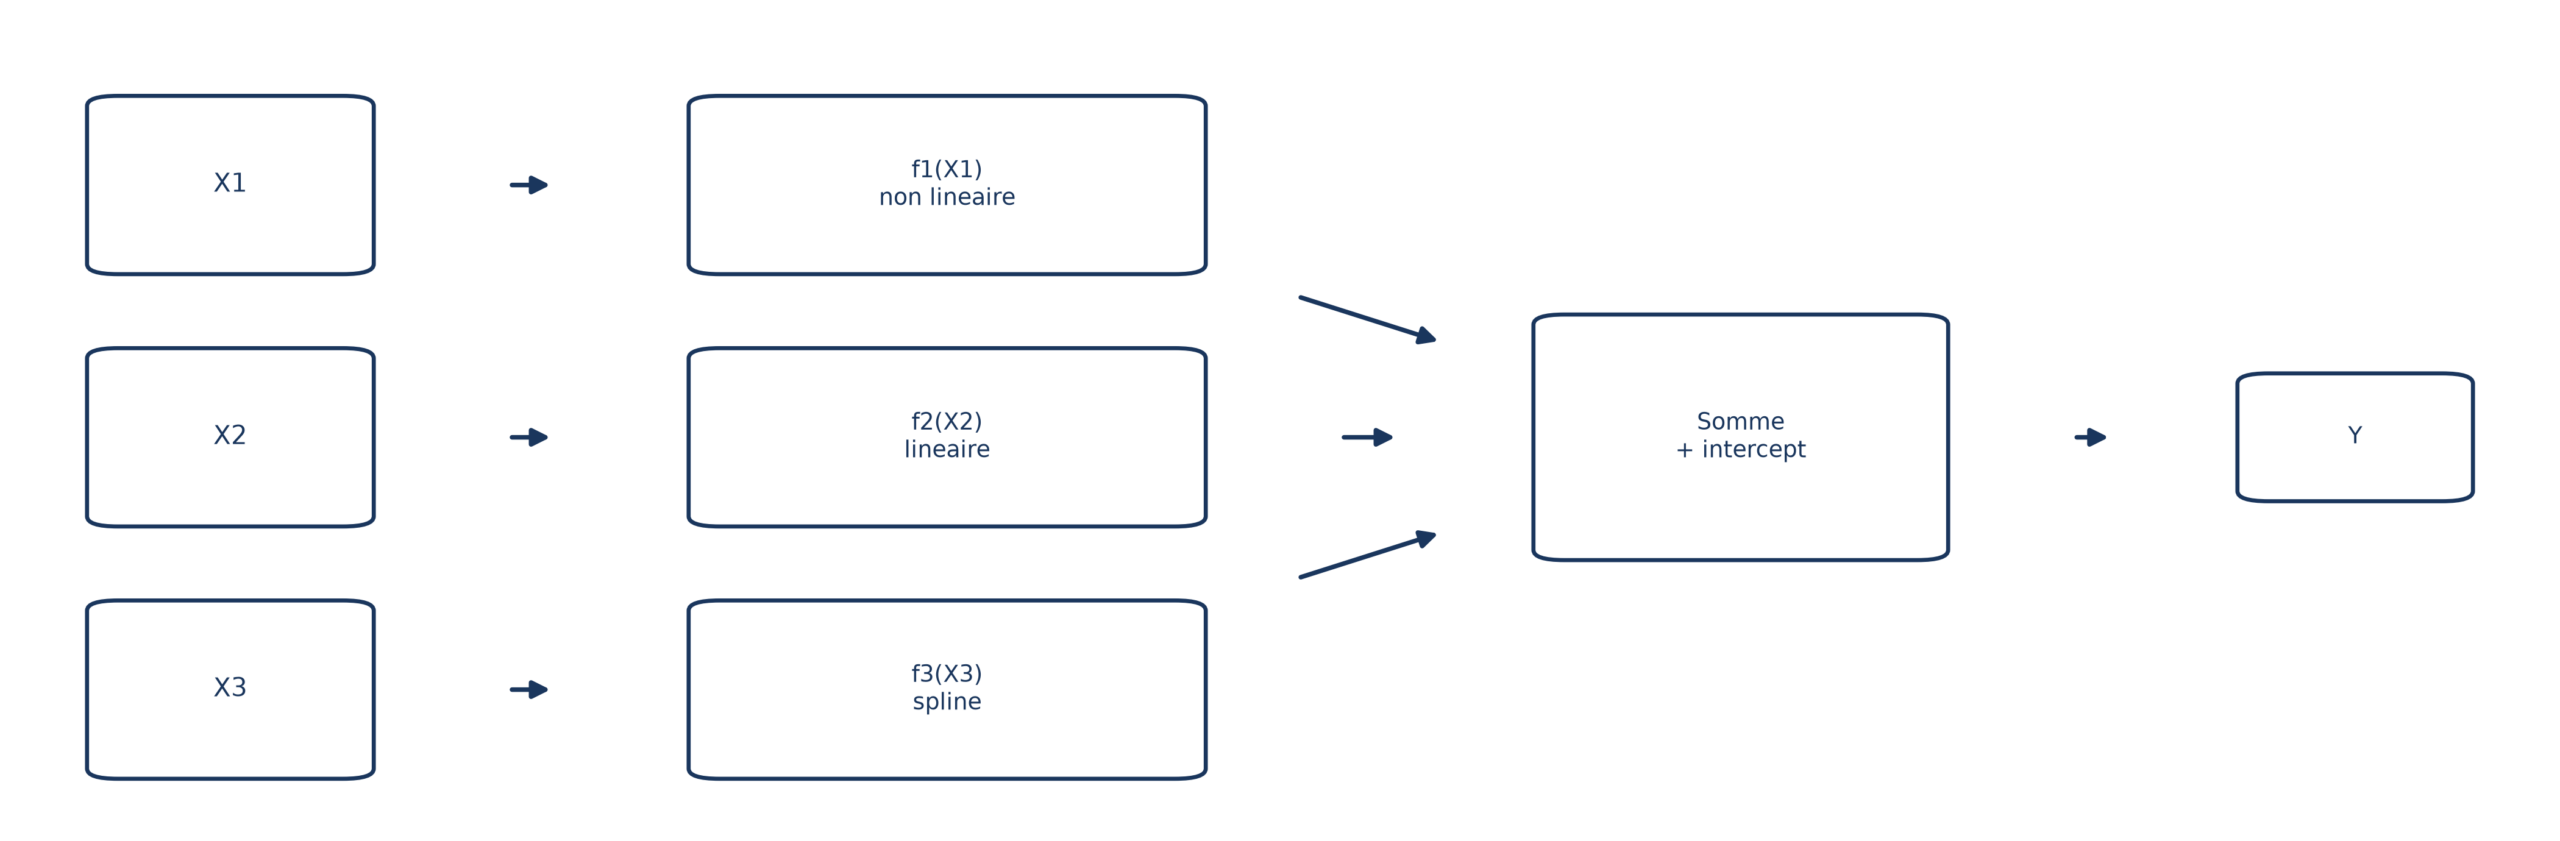
Ce que tu y gagnes tient en une phrase : la structure additive préserve la lecture de chaque variable isolément. Tu isoles l’effet d’une variable en traçant sa courbe , les autres étant maintenues constantes. Un modèle non linéaire pleinement libre te ferait perdre cette lecture.
Pourquoi on dit « généralisé »
Le mot vient d’une famille plus large, les modèles linéaires généralisés. Un tel modèle se définit par trois éléments : une distribution pour la réponse (gaussienne pour la régression linéaire classique, de Bernoulli pour la régression logistique), une combinaison linéaire des variables, et une fonction de lien qui relie l’espérance de la réponse à cette combinaison.
Le lien s’adapte à la nature de la réponse. En régression linéaire, c’est l’identité. En régression logistique, c’est le logit, qui garde les probabilités entre 0 et 1. Pour un comptage, comme le nombre de clients servis en une heure, la régression de Poisson utilise le logarithme : les prédictions restent positives, alors qu’une droite pourrait en produire de négatives.
Le GAM reprend le même geste. Pour classer plutôt que mesurer, on remplace la réponse numérique par le logit d’une probabilité  :
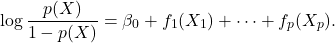
Le membre de droite est inchangé : toujours une somme de courbes. Seul le membre de gauche change, et c’est lui qui garantit une probabilité valide. On retrouve ainsi, côté classification, la même extension que celle qui mène de la régression linéaire à la régression logistique.
💡 Intuition « Additif » dit comment les variables se combinent ; « généralisé » dit comment la somme se relie à la réponse. Deux réglages indépendants, que tu peux lire séparément.
Trois briques pour fabriquer une courbe
Le GAM n’impose pas de recette pour chaque : c’est une fonction non linéaire « arbitraire », et la spline n’en est qu’un exemple. Tu choisis la brique selon la variable, et tu peux mélanger les trois dans un même modèle.
- La spline pour une variable numérique dont tu ne veux pas fixer la forme d’avance.
- Le terme linéaire pour une variable dont la relation est bien droite, comme dans la boîte du milieu du schéma.
- Le terme facteur, adapté à une variable qualitative comme un niveau d’études.
Chaque brique est traitée pour elle-même, puis la somme les réunit : c’est la structure additive qui rend ce mélange possible.
Le GAM sur un cas : salaire, année, âge, études
Reprenons la question de départ : comment un salaire (wage) varie-t-il avec l’année, l’âge et le niveau d’études ? Tu laisses l’année et l’âge dessiner chacune leur courbe, et tu traites le niveau d’études comme une variable à catégories. Dans l’extrait ci-dessous, le préfixe In [24]: marque la 24ᵉ cellule exécutée d’une session interactive.
La bibliothèque pyGAM écrit chaque terme du modèle noir sur blanc.
In [24]: gam_full = LinearGAM(s_year + s_age + f_education)
         gam_full = gam_full.fit(X, Wage['wage'])
s_year et s_age sont des termes lisses, des splines, appliqués à l’année et à l’âge ; f_education est un terme facteur, adapté à la variable qualitative. Leur somme, passée telle quelle à LinearGAM, reproduit exactement la structure 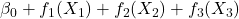 vue plus haut.
X regroupe les prédicteurs, et la seconde ligne ajuste le modèle pour prédire wage.
📌 À retenir Une ligne de code, trois termes séparés par des
+: le code a la même forme que la formule. C’est la meilleure preuve que « additif » n’est pas une image, mais la structure même du modèle.
Ce que le GAM ne voit pas
La contrepartie de l’additivité est nette : le modèle suppose que l’effet d’une variable ne bouge jamais avec la valeur d’une autre. Si cette hypothèse est fausse, aucune courbe ne peut le dire. Tu peux réparer à la main, avec une fonction non linéaire de deux variables  , mais tu sacrifies alors la simplicité de lecture qui faisait l’intérêt du GAM.
Pour mesurer ce que cela peut coûter, regarde une régression linéaire sur des données de publicité. Quand on ajoute un terme d’interaction entre télévision et radio, le  passe de 89,7 % à 96,8 % : les deux médias se renforcent, et répartir un budget entre les deux rapporte plus que le concentrer sur un seul. Un modèle purement additif passerait à côté de cette synergie.
Les arbres de décision partent d’une tout autre logique : ils découpent l’espace des variables en régions rectangulaires et prédisent une valeur constante dans chacune. Ils captent donc nativement des interactions complexes, au prix d’une interprétabilité moindre.
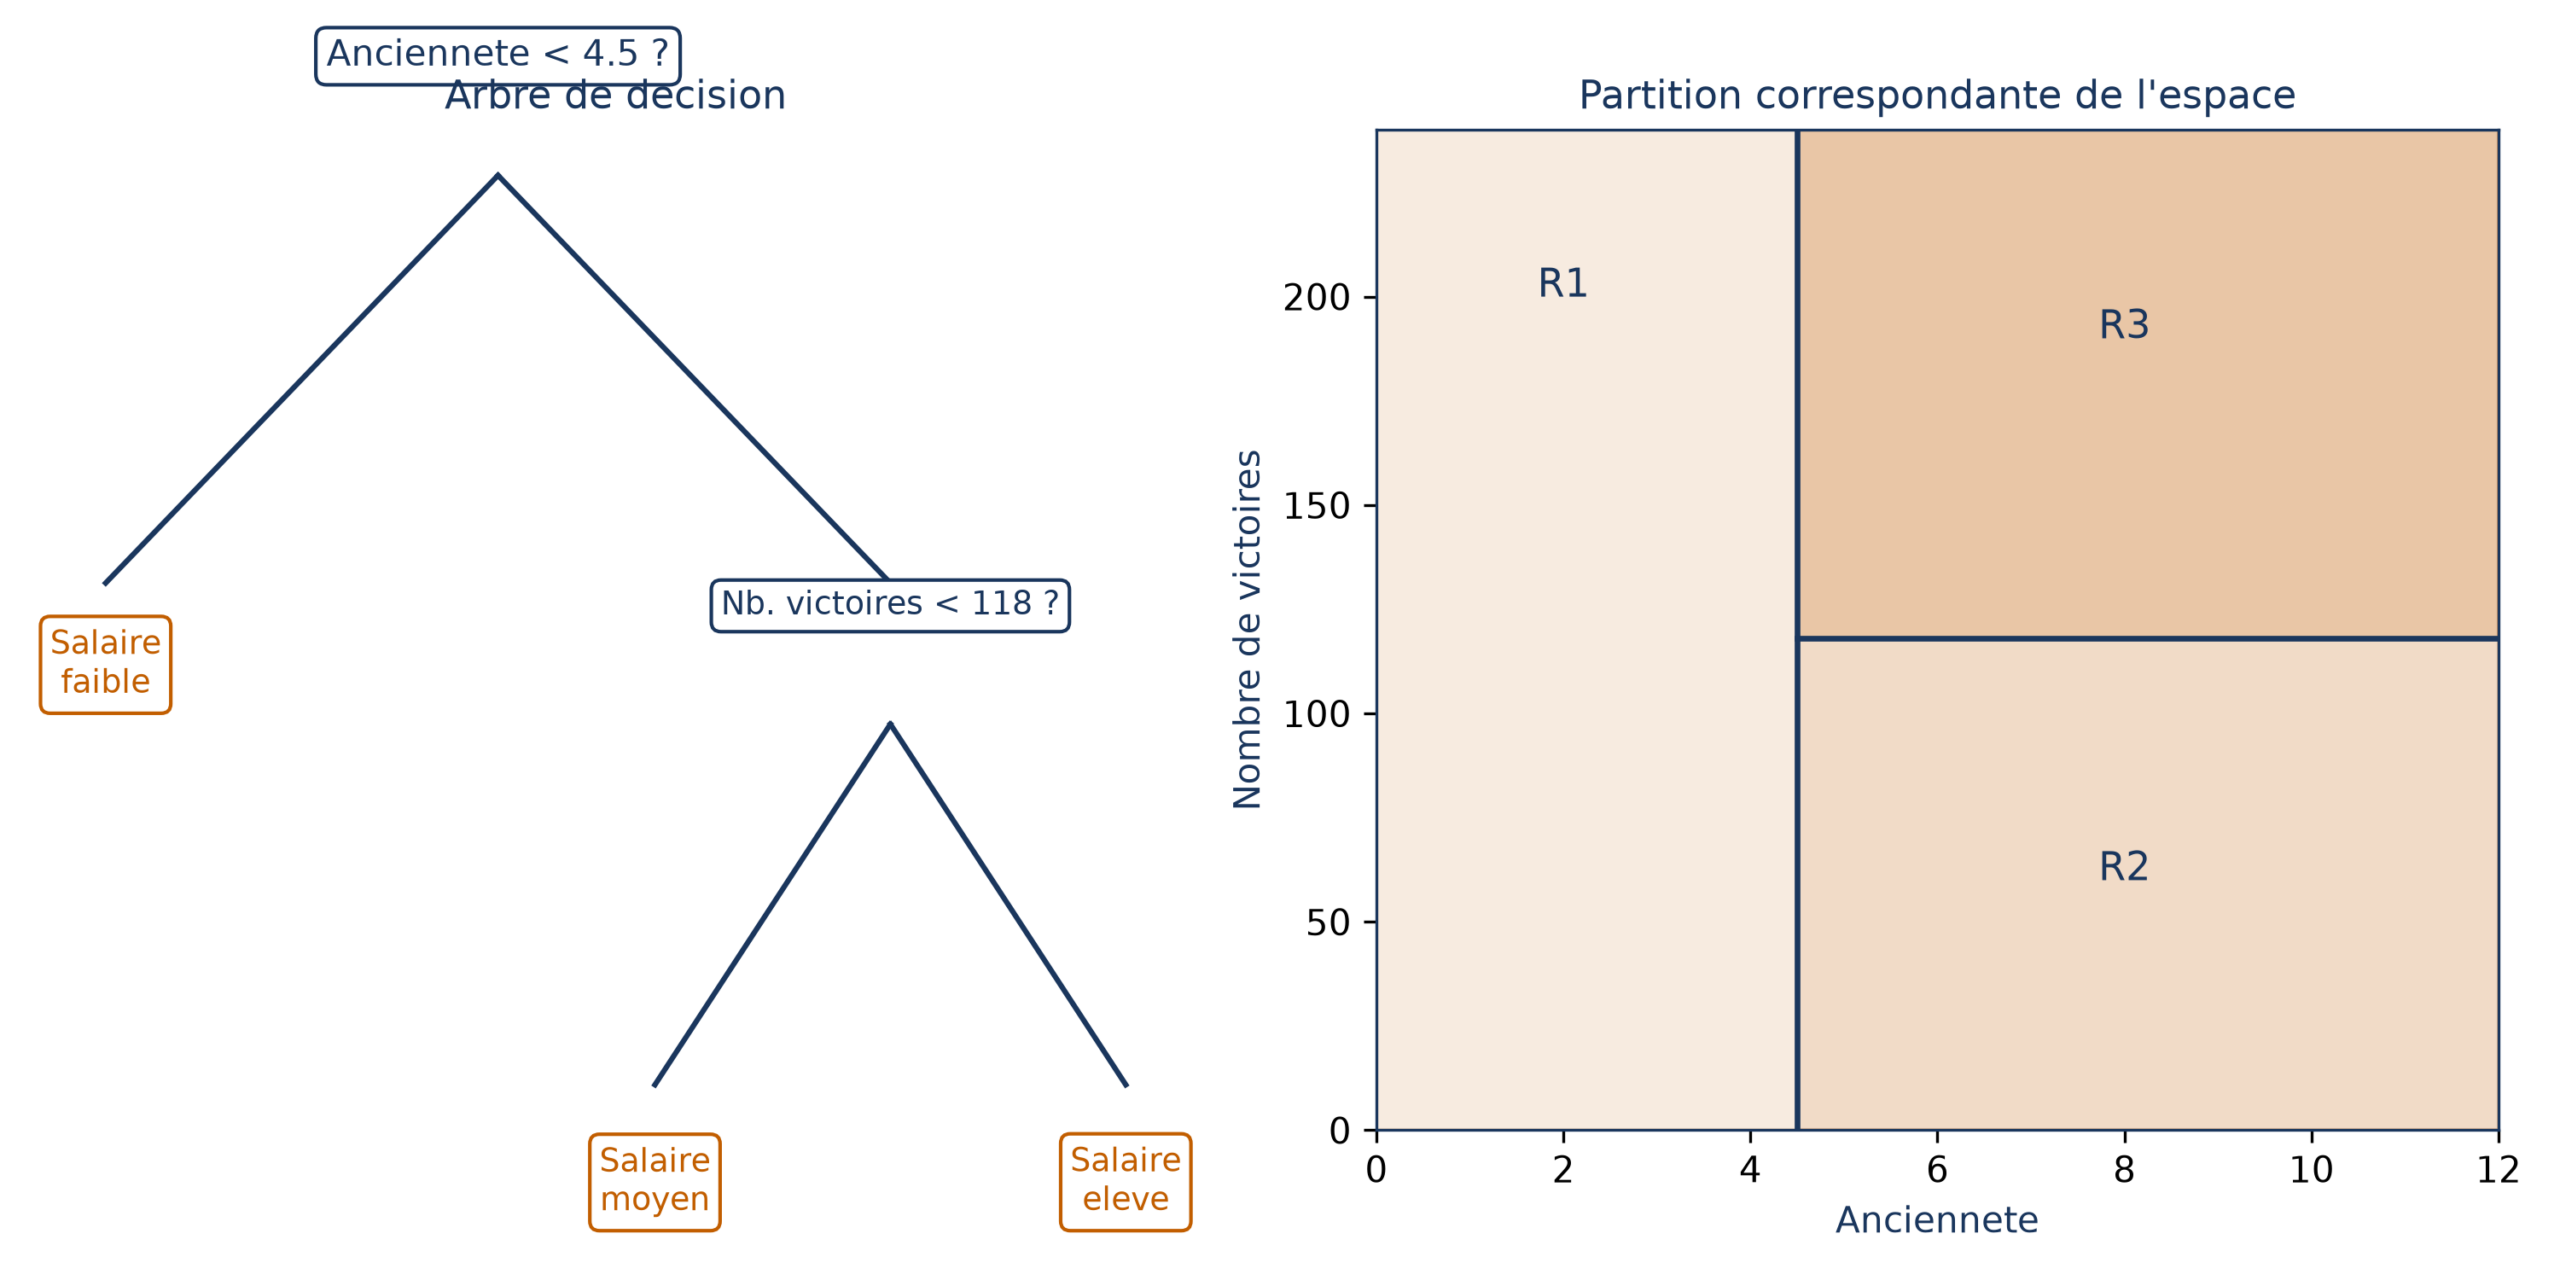
| Régression linéaire | GAM | Arbre de décision | |
|---|---|---|---|
| Effet d’une variable | proportionnel | courbe lisse libre | paliers constants |
| Variables combinées | par somme | par somme | par régions croisées |
| Interactions | seulement si ajoutées | seulement si ajoutées | captées nativement |
| Lecture | coefficient | courbe de chaque variable | règles successives |
⚠️ Piège Un GAM se lit variable par variable, mais cette lecture suppose l’additivité. Si l’effet réel d’une variable dépend de la valeur d’une autre, le modèle n’a aucun moyen de le représenter, et ses courbes ne te préviendront pas.