Un nouveau point arrive dans ton nuage de données et tu ignores à quelle catégorie il appartient. Au lieu de chercher une règle, tu poses une seule question : qui se trouve juste à côté de lui ? Toute la méthode des K plus proches voisins tient dans ce réflexe, et tu vas voir comment une idée aussi frugale vient se mesurer à la référence théorique de la classification.
Sommaire
- L’essentiel en 30 secondes
- Une méthode qui ne présuppose aucune forme
- Trois gestes pour classer un point
- Classer une catégorie ou chiffrer une valeur
- Pourquoi une idée si simple approche l’idéal
- Des cousines qui regardent aussi leur voisinage
- Ce que cette simplicité ne te donne pas
L’essentiel en 30 secondes
- Les K plus proches voisins (KNN) sont une méthode non paramétrique : aucune forme de fonction n’est supposée d’avance.
- Pour classer un point, on prend ses K voisins d’entraînement les plus proches et on lui donne la classe la plus représentée.
- La proportion de voisins de chaque classe fournit aussi une estimation de probabilité.
- La méthode s’applique indifféremment à une réponse qualitative ou à une réponse numérique.
- Elle approche le classifieur de Bayes, un idéal inatteignable, mais ne s’interprète pas et réclame beaucoup de données.
Une méthode qui ne présuppose aucune forme
Beaucoup de modèles procèdent en deux temps : on décide d’abord de la forme de la fonction à retrouver (une droite, par exemple), puis on ajuste ses coefficients sur les données. Le problème se réduit alors à quelques nombres à estimer.
Les K plus proches voisins prennent l’autre chemin. Cette méthode ne pose aucune hypothèse explicite sur la forme de la fonction : elle s’appuie directement sur les points observés pour prédire.
Cette liberté a un prix. Comme le problème n’est jamais ramené à un petit nombre de paramètres, il faut beaucoup d’observations pour obtenir une estimation précise.
Trois gestes pour classer un point
Pars d’un point  dont tu veux deviner la classe et d’un entier positif
 que tu choisis. La méthode enchaîne trois gestes.
- Repérer : on identifie les points d’entraînement les plus proches de .
- Compter : pour chaque classe, on mesure la proportion de ces voisins qui lui appartiennent.
- Trancher : reçoit la classe la plus représentée parmi eux.
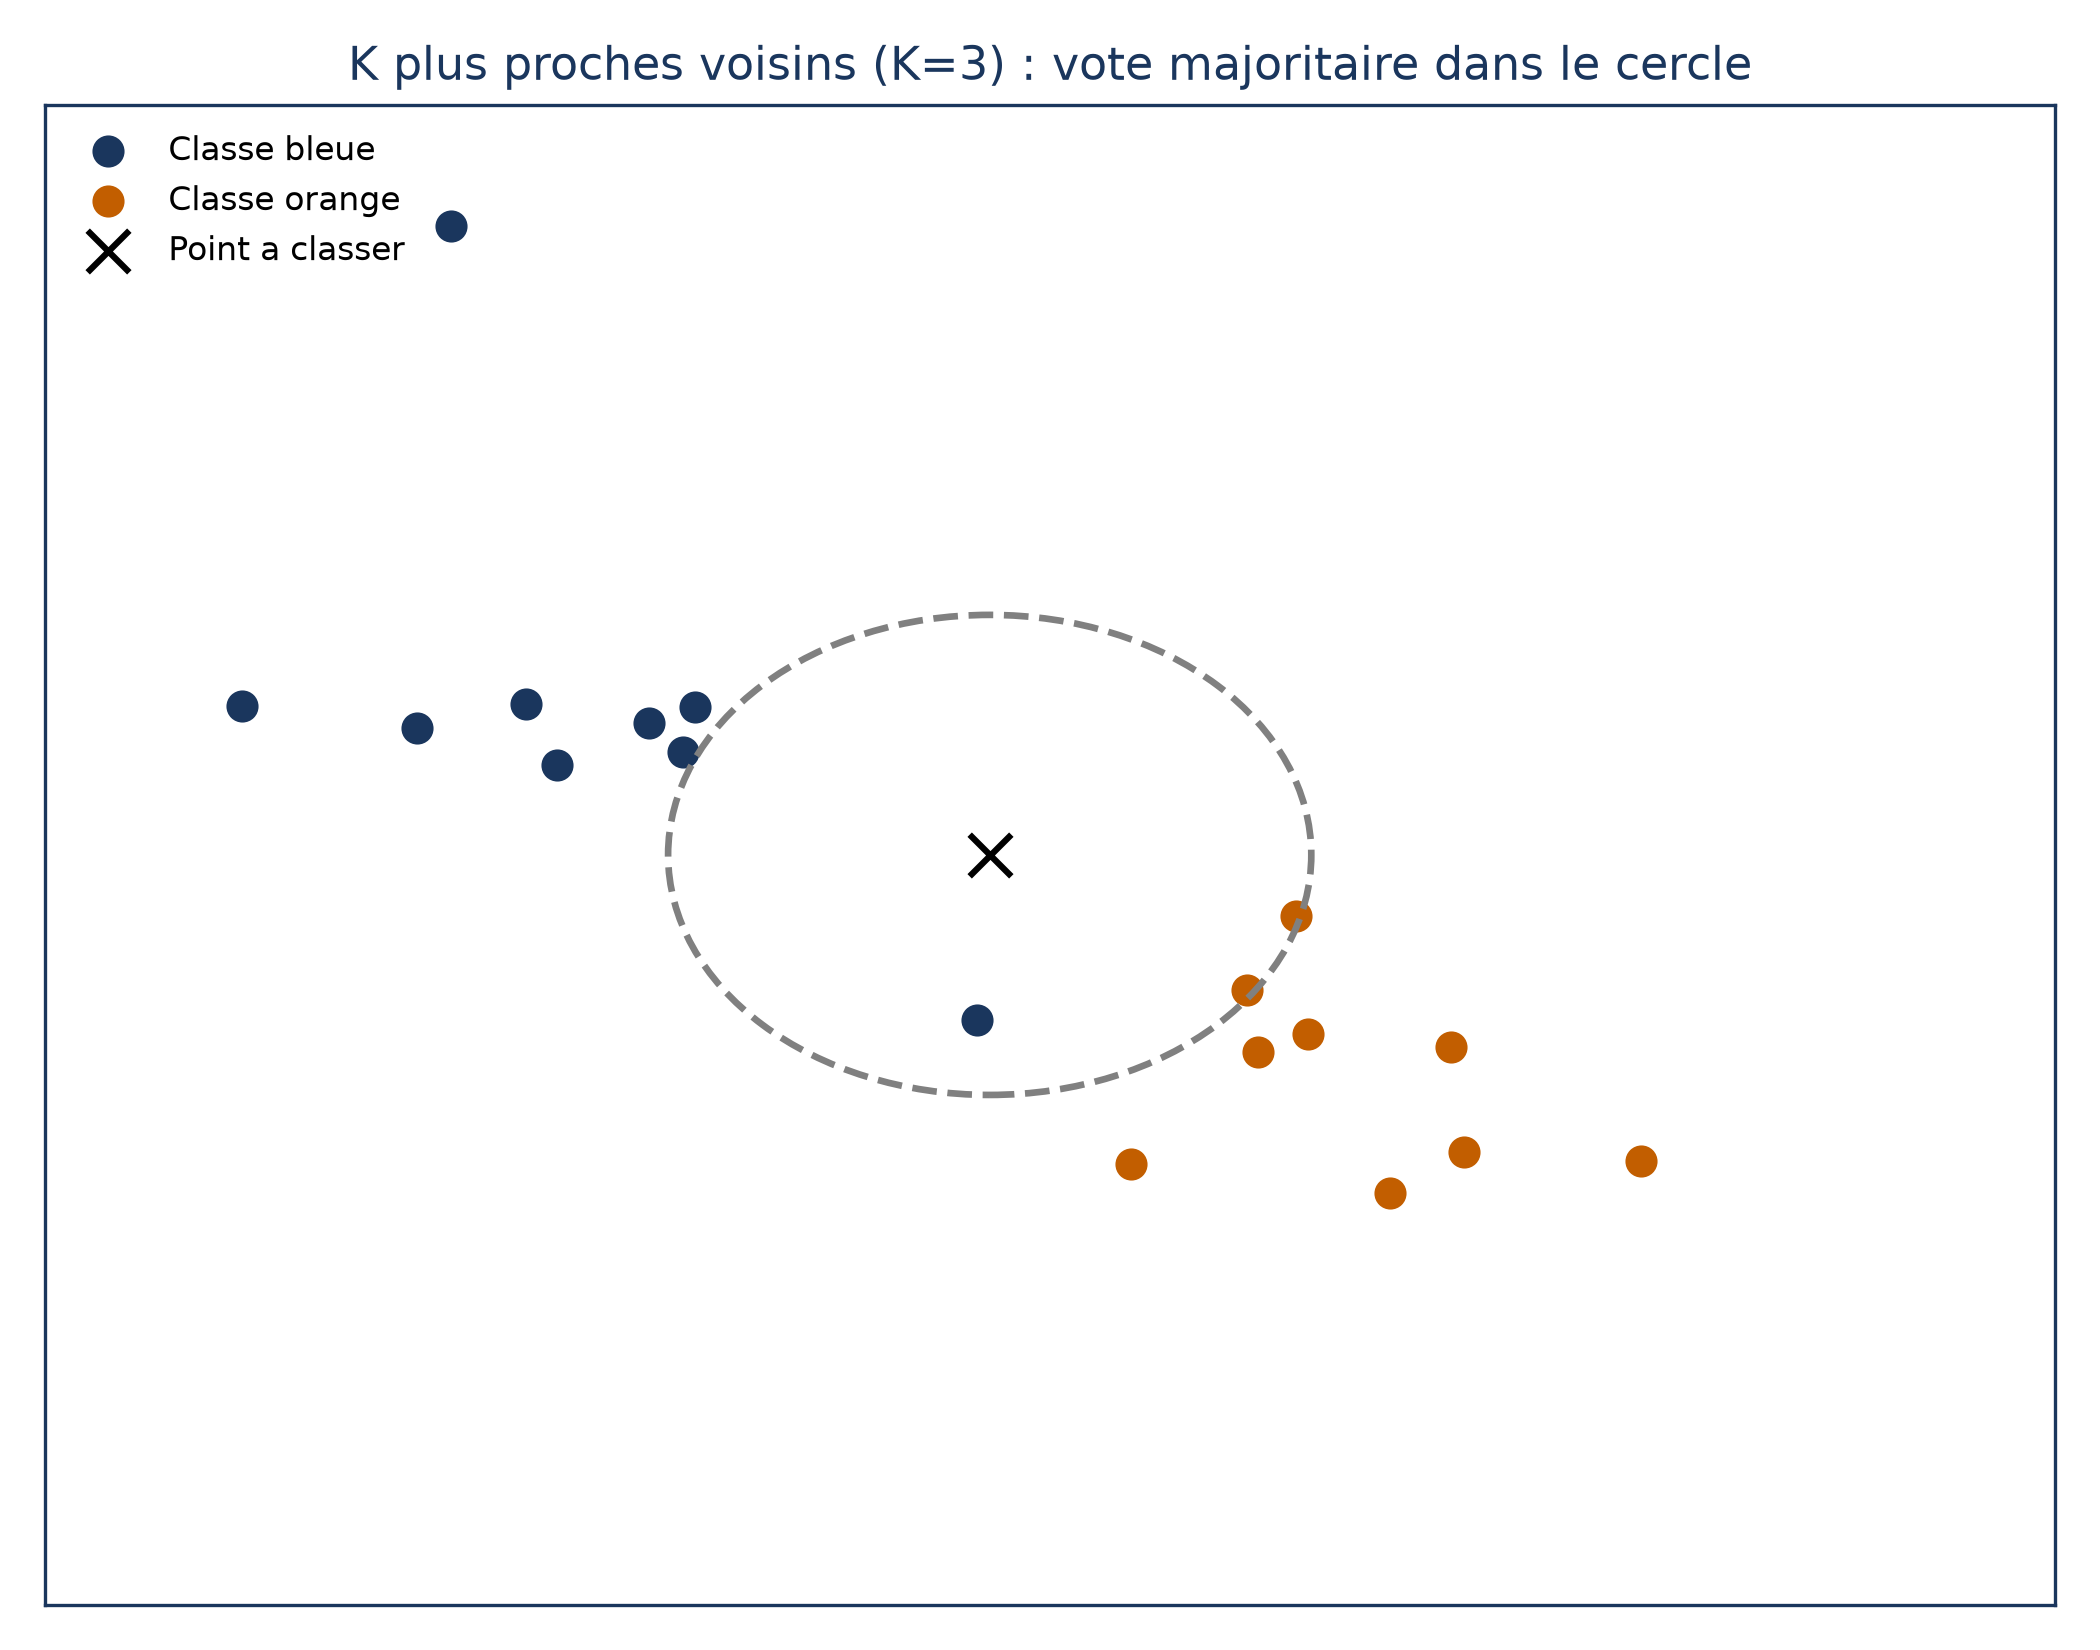
Le deuxième geste a une conséquence que l’on oublie souvent : tu n’obtiens pas seulement une étiquette, tu obtiens une probabilité par classe. Avec  et quatre voisins bleus pour un orange, le calcul donne 80 % pour le bleu et 20 % pour l’orange, et le point est classé bleu.
💡 Intuition Aucune phase d’apprentissage ne produit de coefficients : pour répondre, la méthode consulte directement les points d’entraînement les plus proches du cas à traiter.
Classer une catégorie ou chiffrer une valeur
La méthode n’est pas réservée aux catégories. Elle fait partie des approches qui s’appliquent aux deux types de réponse, qualitative comme quantitative.
Pour une réponse numérique, le deuxième geste change de nature : plus de comptage, on moyenne simplement les réponses observées chez les voisins les plus proches de .
Pourquoi une idée si simple approche l’idéal
Pour classer le mieux possible, la règle théorique est limpide : donner à chaque observation la classe la plus probable compte tenu de ses prédicteurs. C’est le classifieur de Bayes. La ligne qui sépare les régions où chaque classe domine est sa frontière de décision, et son taux d’erreur est le plus bas qu’on puisse espérer, l’erreur de Bayes.
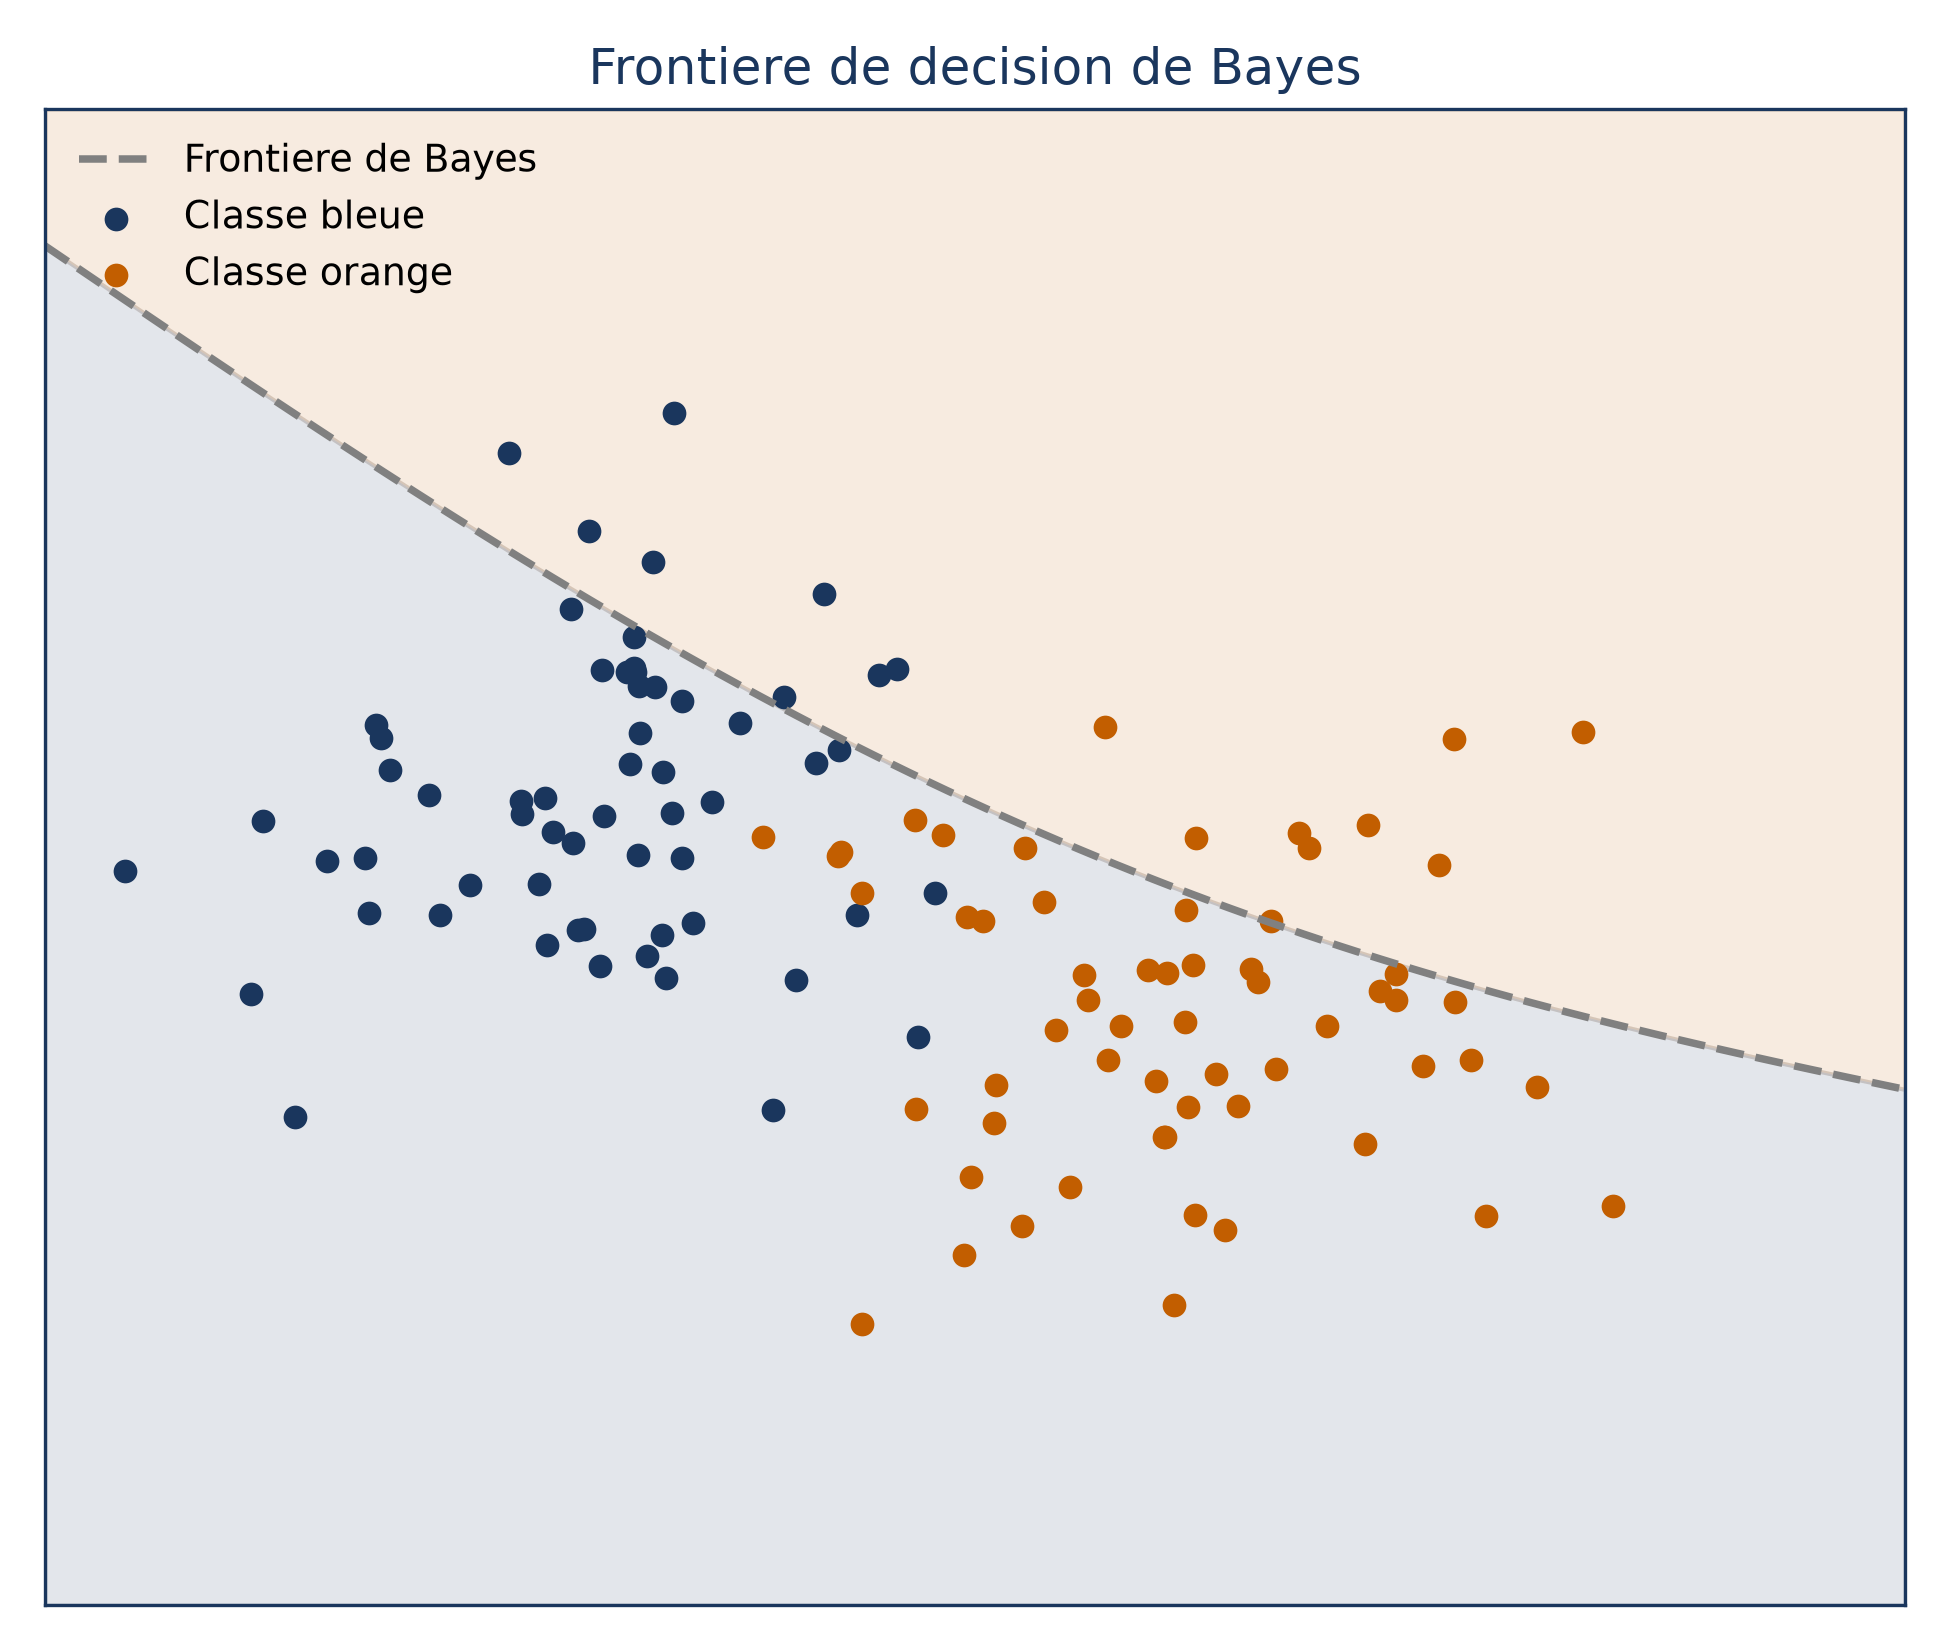
Le piège est que cette règle demande de connaître la distribution de  sachant
 , ce qui n’arrive jamais en pratique. Le classifieur de Bayes reste donc un étalon inatteignable, auquel on compare les méthodes utilisables.
C’est ici que les K plus proches voisins prennent leur intérêt. Ils remplacent la probabilité inconnue par une proportion mesurée sur les voisins, et produisent ainsi des frontières souvent étonnamment proches de celles de Bayes. Le paramètre règle directement l’équilibre entre une frontière trop nerveuse et une frontière trop raide.
Des cousines qui regardent aussi leur voisinage
L’esprit « seul le voisinage compte » revient dans d’autres méthodes, avec des variantes.
Le noyau radial des machines à vecteurs de support donne à chaque observation d’entraînement une contribution qui s’évanouit quand le point de test s’éloigne d’elle : seul son voisinage immédiat pèse. Cela rappelle, par certains aspects, les K plus proches voisins.
La régression locale ajuste, autour du point visé, une droite ou un polynôme de bas degré sur un voisinage, en donnant plus de poids aux points proches. Les K plus proches voisins, eux, se contentent de moyenner.
Ce que cette simplicité ne te donne pas
Avant d’adopter la méthode, garde trois limites en tête. Elle a une interprétabilité nulle : tu peux voir quels voisins ont voté, mais aucun coefficient n’explique la décision. Elle a un besoin en données plus important que les approches paramétriques. Et son avantage s’amenuise quand les variables se multiplient, car les voisins finissent par n’être plus vraiment proches (c’est le fléau de la dimension).
⚠️ Piège Ne confonds pas le
📌 À retenir Face à un point inconnu, les K plus proches voisins comptent leurs voisins les plus proches et suivent la majorité. Simple, sans hypothèse de forme, assez proche de l’idéal de Bayes, mais opaque et gourmand en données.