Demandez à un assistant IA qui a remporté la Coupe du monde masculine de cricket 2023. Deux issues sont possibles : soit il admet qu’il ne sait pas, soit — pire — il répond avec aplomb que c’est l’Inde. C’est faux, c’est l’Australie.
Pourtant, la bonne réponse tient dans un paragraphe de Wikipédia. Il suffirait de le glisser dans la conversation, à côté de la question. Un système RAG, c’est exactement cette idée, automatisée : à la fin de cet article, vous saurez de quelles pièces il est fait, dans quel ordre elles travaillent, et à quels endroits il peut se tromper.
L’essentiel en 30 secondes
- Le RAG (génération augmentée par récupération) va chercher, au moment de la question, l’information utile dans une source externe, l’ajoute à la question, puis laisse le LLM répondre à partir de là.
- Un système RAG repose sur deux pipelines : l’indexation, qui prépare la base de connaissances à l’avance, et la génération, qui répond en temps réel.
- L’indexation enchaîne quatre gestes : charger les données, les découper, les convertir en vecteurs de nombres (des embeddings), les stocker.
- Le composant le plus critique est le retriever, celui qui retrouve les bons passages : la qualité de toute la réponse en dépend.
- Le RAG réduit considérablement les hallucinations, mais ne les supprime pas.
Pourquoi un LLM seul ne suffit pas
On imagine volontiers qu’un LLM consulte une réserve de faits pour répondre. Ce n’est pas le cas : il ne mémorise ni faits ni événements précis. Il a appris des poids dans un réseau de neurones, et quand vous l’interrogez, il génère une réponse à partir de ces poids, exactement comme il prédit le mot suivant d’une phrase.
De là découlent trois limites. La première est la date de coupure : entraîner un modèle prend des semaines, voire des mois, si bien que son savoir n’est jamais parfaitement à jour (GPT-4.1, sorti en avril 2025, ne connaît le monde que jusqu’au 1er juin 2024). La deuxième est l’hallucination : des avocats américains ont ainsi soumis à un tribunal des citations juridiques entièrement fictives, générées par ChatGPT. La troisième est l’absence d’accès aux données privées : documents internes, dossiers clients, tout ce qui n’a jamais fait partie de l’entraînement.
On pourrait réentraîner un modèle, ou l’affiner avec de nouvelles données. Mais ces deux voies exigent des volumes de données et des ressources de calcul considérables, et le remettre à jour régulièrement reste prohibitivement coûteux.
L’intuition : un examen à livre ouvert
Un LLM seul passe un examen de mémoire. Un système RAG lui autorise le livre ouvert : avant qu’il réponde, on lui glisse les pages qui comptent.
Les chercheurs distinguent deux mémoires. La mémoire paramétrique est ce que le modèle a appris pendant l’entraînement, stocké dans ses poids : elle est nécessairement limitée. La mémoire non paramétrique est l’information qu’on lui fournit de l’extérieur, et qu’on peut étendre autant qu’on veut. Dans l’article fondateur du RAG, Patrick Lewis et ses coauteurs ont stocké des données Wikipédia, y ont donné accès au modèle grâce à un retriever, et obtenu un langage plus précis, plus varié et plus factuel qu’avec un modèle purement paramétrique.
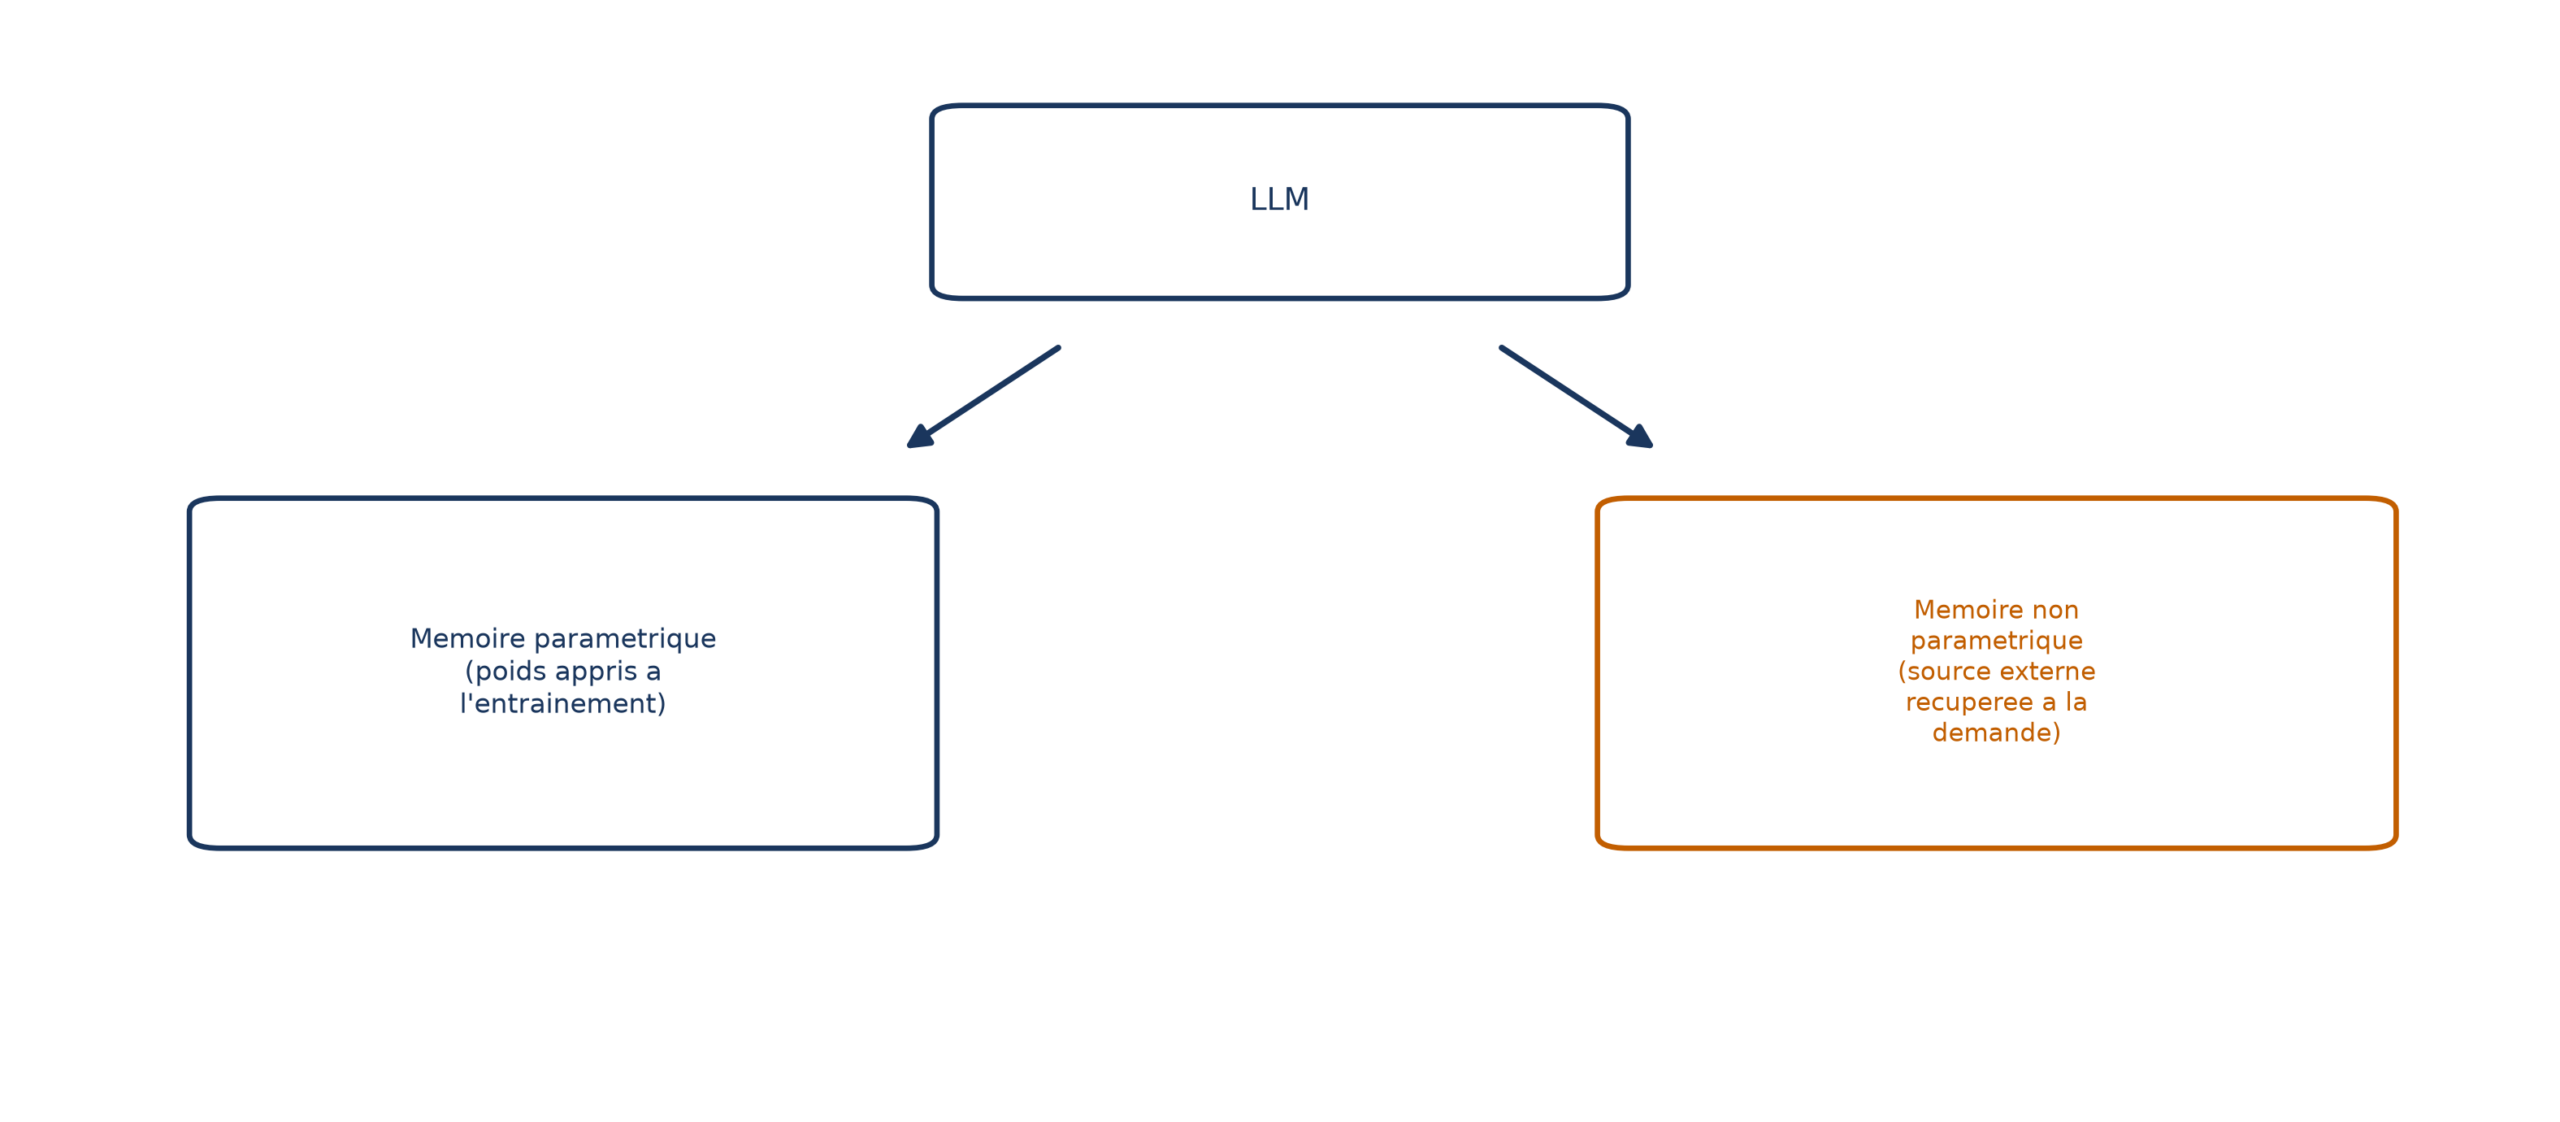
💡 Intuition Le RAG ne rend pas le modèle plus savant : il lui apporte, à chaque question, la documentation qui lui manque. Trois bénéfices concrets : des réponses ancrées dans l’information fournie, des sources qu’on peut citer et vérifier, et moins d’hallucinations.
Concrètement, le système fait à votre place ce que vous feriez à la main dans l’exemple du cricket : il comprend la question, cherche l’information pertinente, identifie une source, et la transmet au LLM avec la question d’origine. Vous n’avez rien à faire, tout est invisible pour l’utilisateur.
Sous le capot : deux pipelines
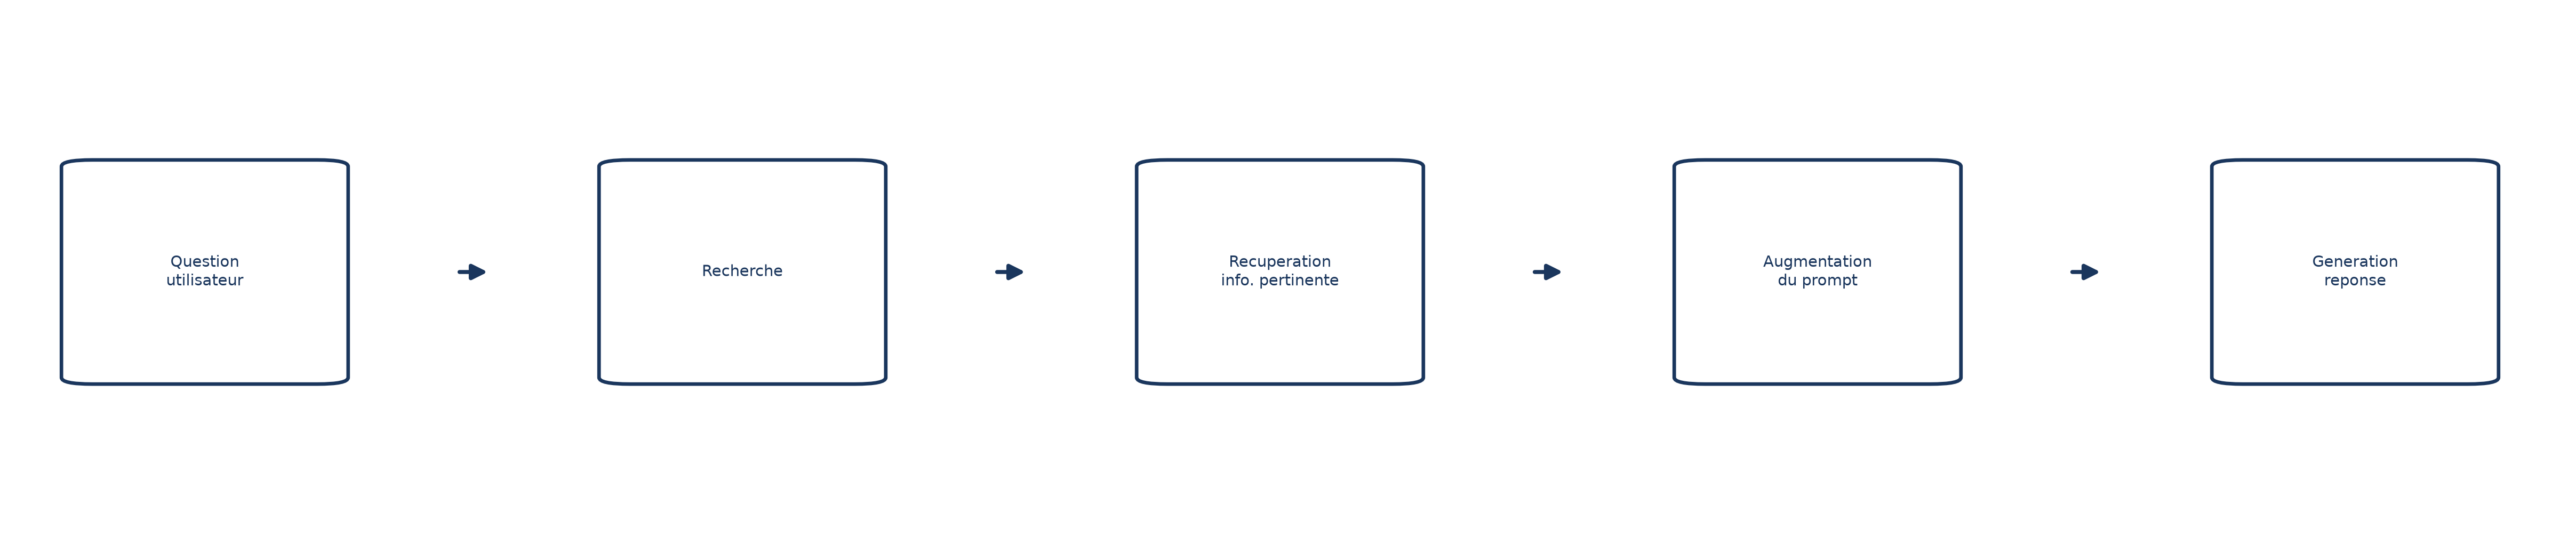
Côté question, cela donne cinq étapes : l’utilisateur pose sa question, le système cherche l’information pertinente, la récupère, l’ajoute à la question (on dit qu’il augmente le prompt), et le LLM répond de façon contextuelle. Ce parcours s’appelle le pipeline de génération.
D’où le second pipeline, celui de l’ombre.
Le pipeline d’indexation : préparer le terrain
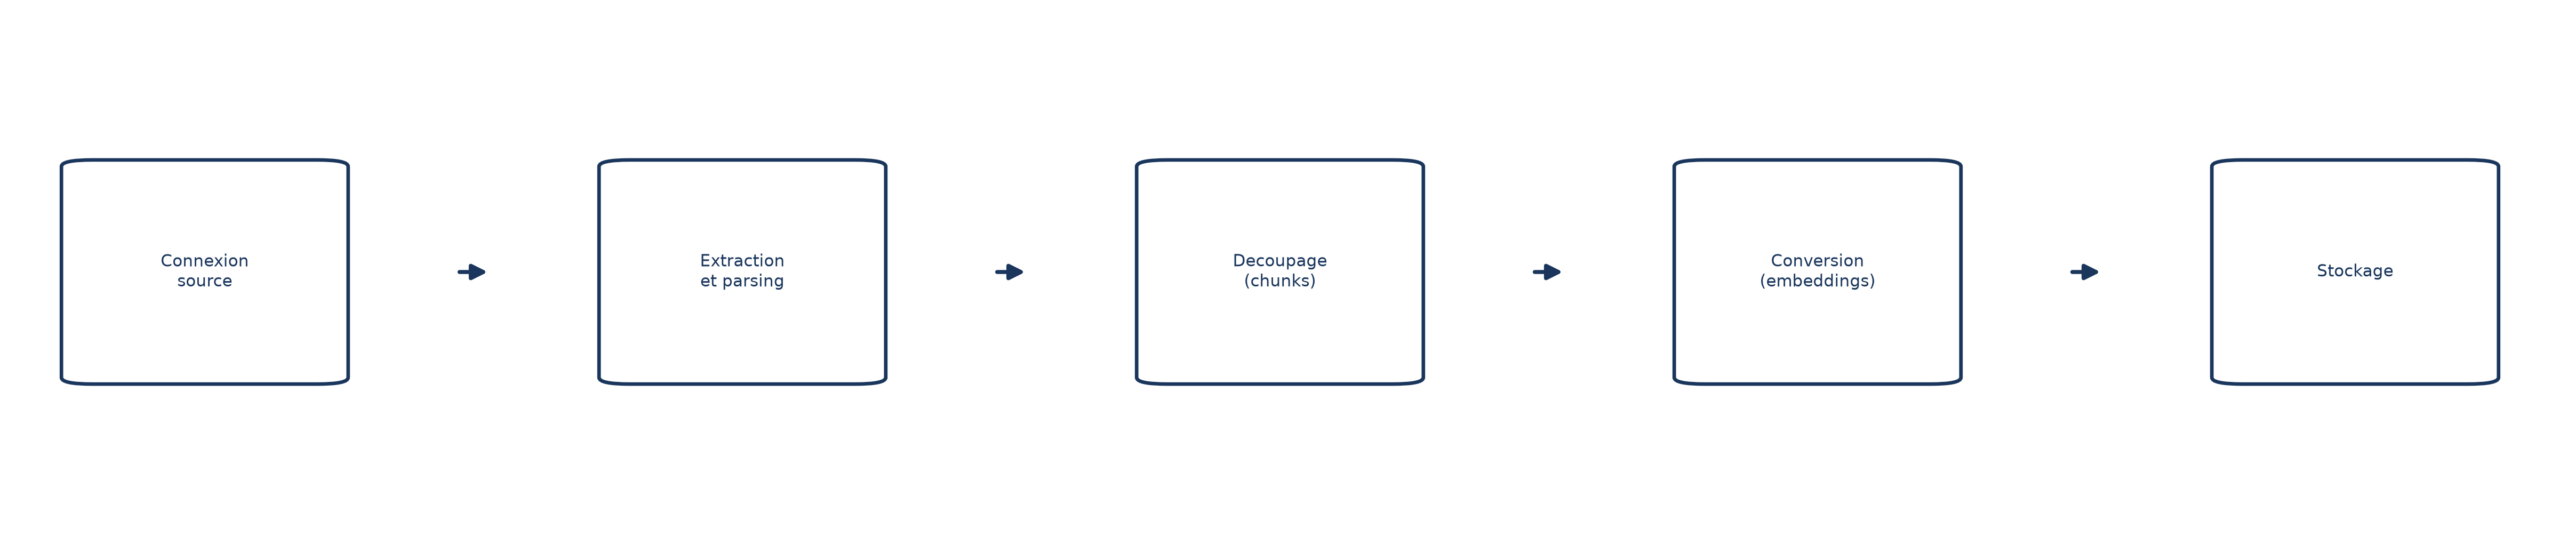
Le pipeline d’indexation construit la base de connaissances à l’avance et la met à jour à intervalles réguliers. Il ne s’active pas quand l’utilisateur pose sa question : il tourne hors ligne, ou de façon asynchrone.
⚠️ Piège Tous les systèmes n’ont pas besoin de ce pipeline. Une application de conseil de voyage qui interroge une API météo délègue entièrement la recherche à cette API : aucune base de connaissances à construire.
Voyons les quatre gestes un par un.
1. Charger. On se connecte aux sources, on lit les fichiers et on en extrait le texte. Ce composant fait aussi un prétraitement essentiel : suppression de l’information non pertinente, masquage des données confidentielles, gestion des métadonnées — ces dernières aideront plus tard à trancher entre plusieurs informations concurrentes selon leur origine ou leur ancienneté.
2. Découper. Une page Wikipédia de plus de 8 000 mots est trop longue à traiter telle quelle. Découper en fragments apporte trois avantages : respecter la fenêtre de contexte du LLM (tout texte qui la dépasse est simplement ignoré), atténuer le problème du « perdu au milieu » (la précision baisse quand l’information utile est noyée au milieu d’un long prompt), et faciliter la recherche, plus efficace sur de petits textes.
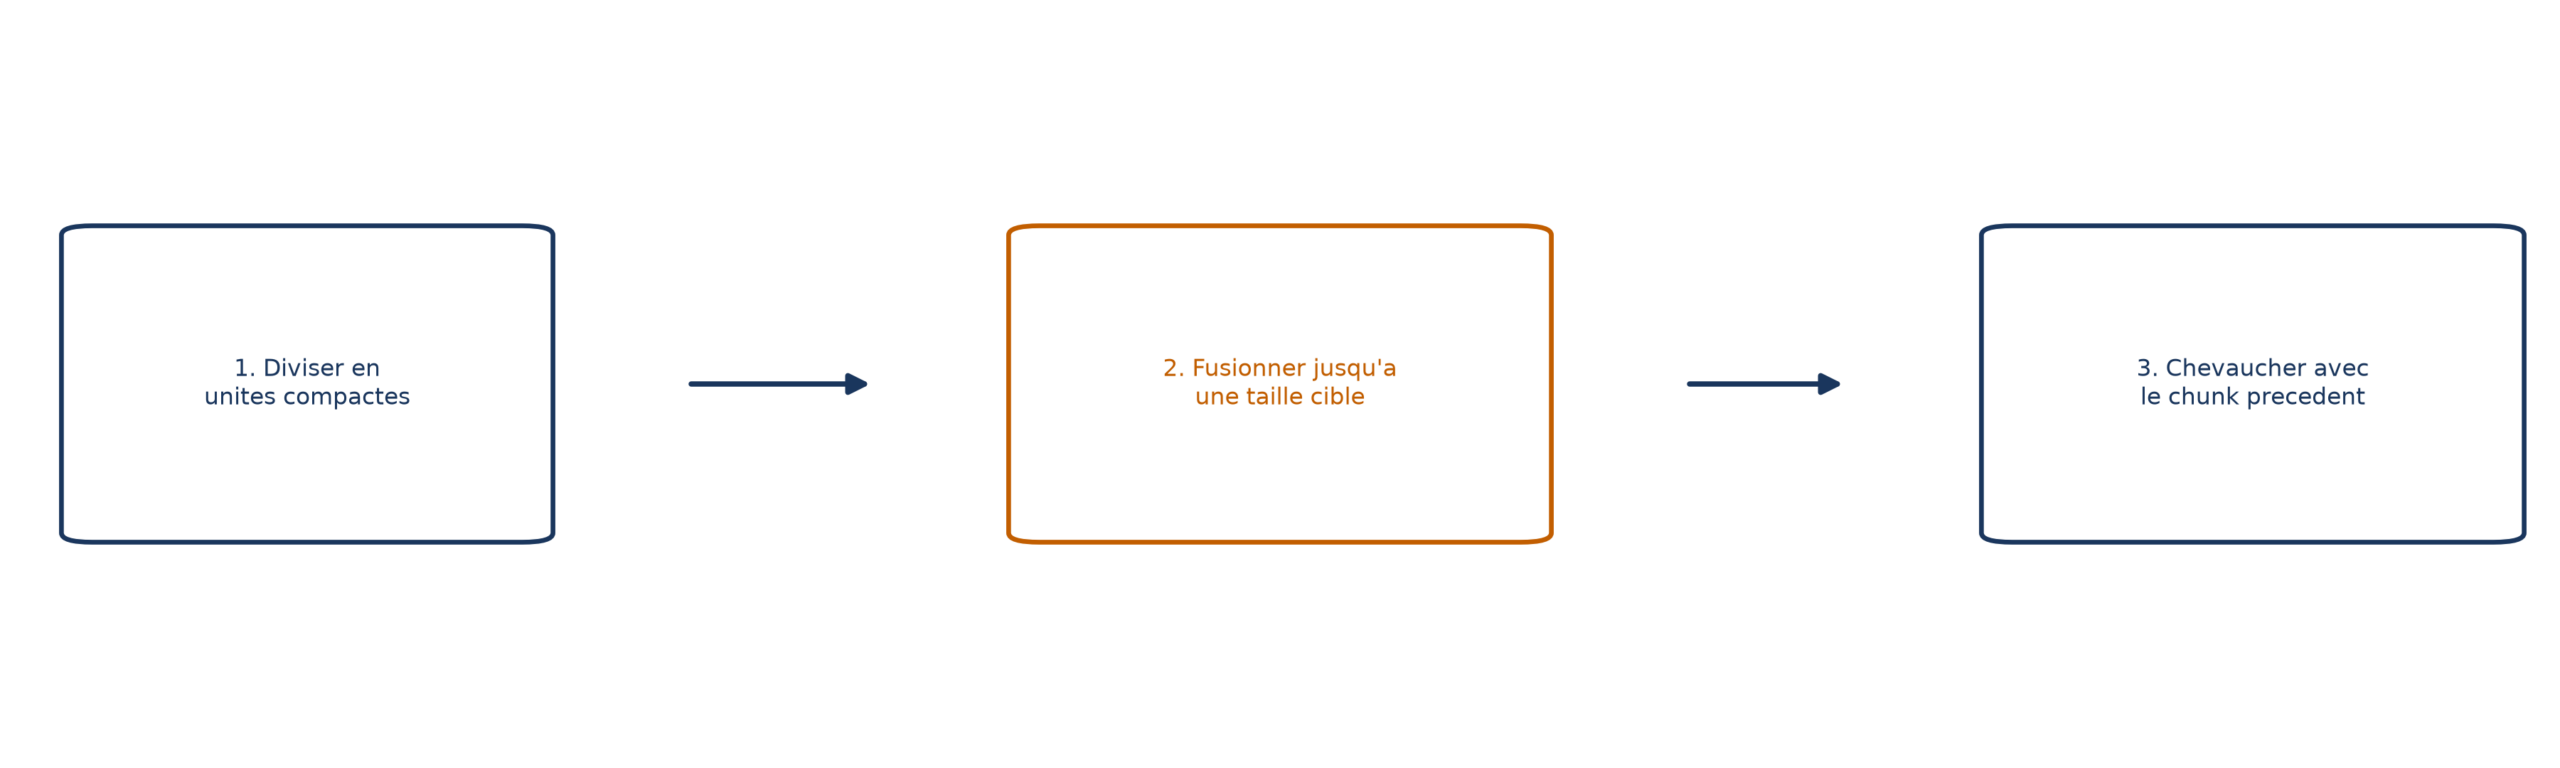
⚠️ Piège La taille des fragments est un arbitrage sans réponse universelle. Un contrat de 10 000 mots découpé en segments de 1 000 mots mélangera plusieurs clauses ; en segments de 200 mots, chaque clause sera isolée, au risque de perdre le contexte des clauses voisines. Il faut expérimenter selon vos données.
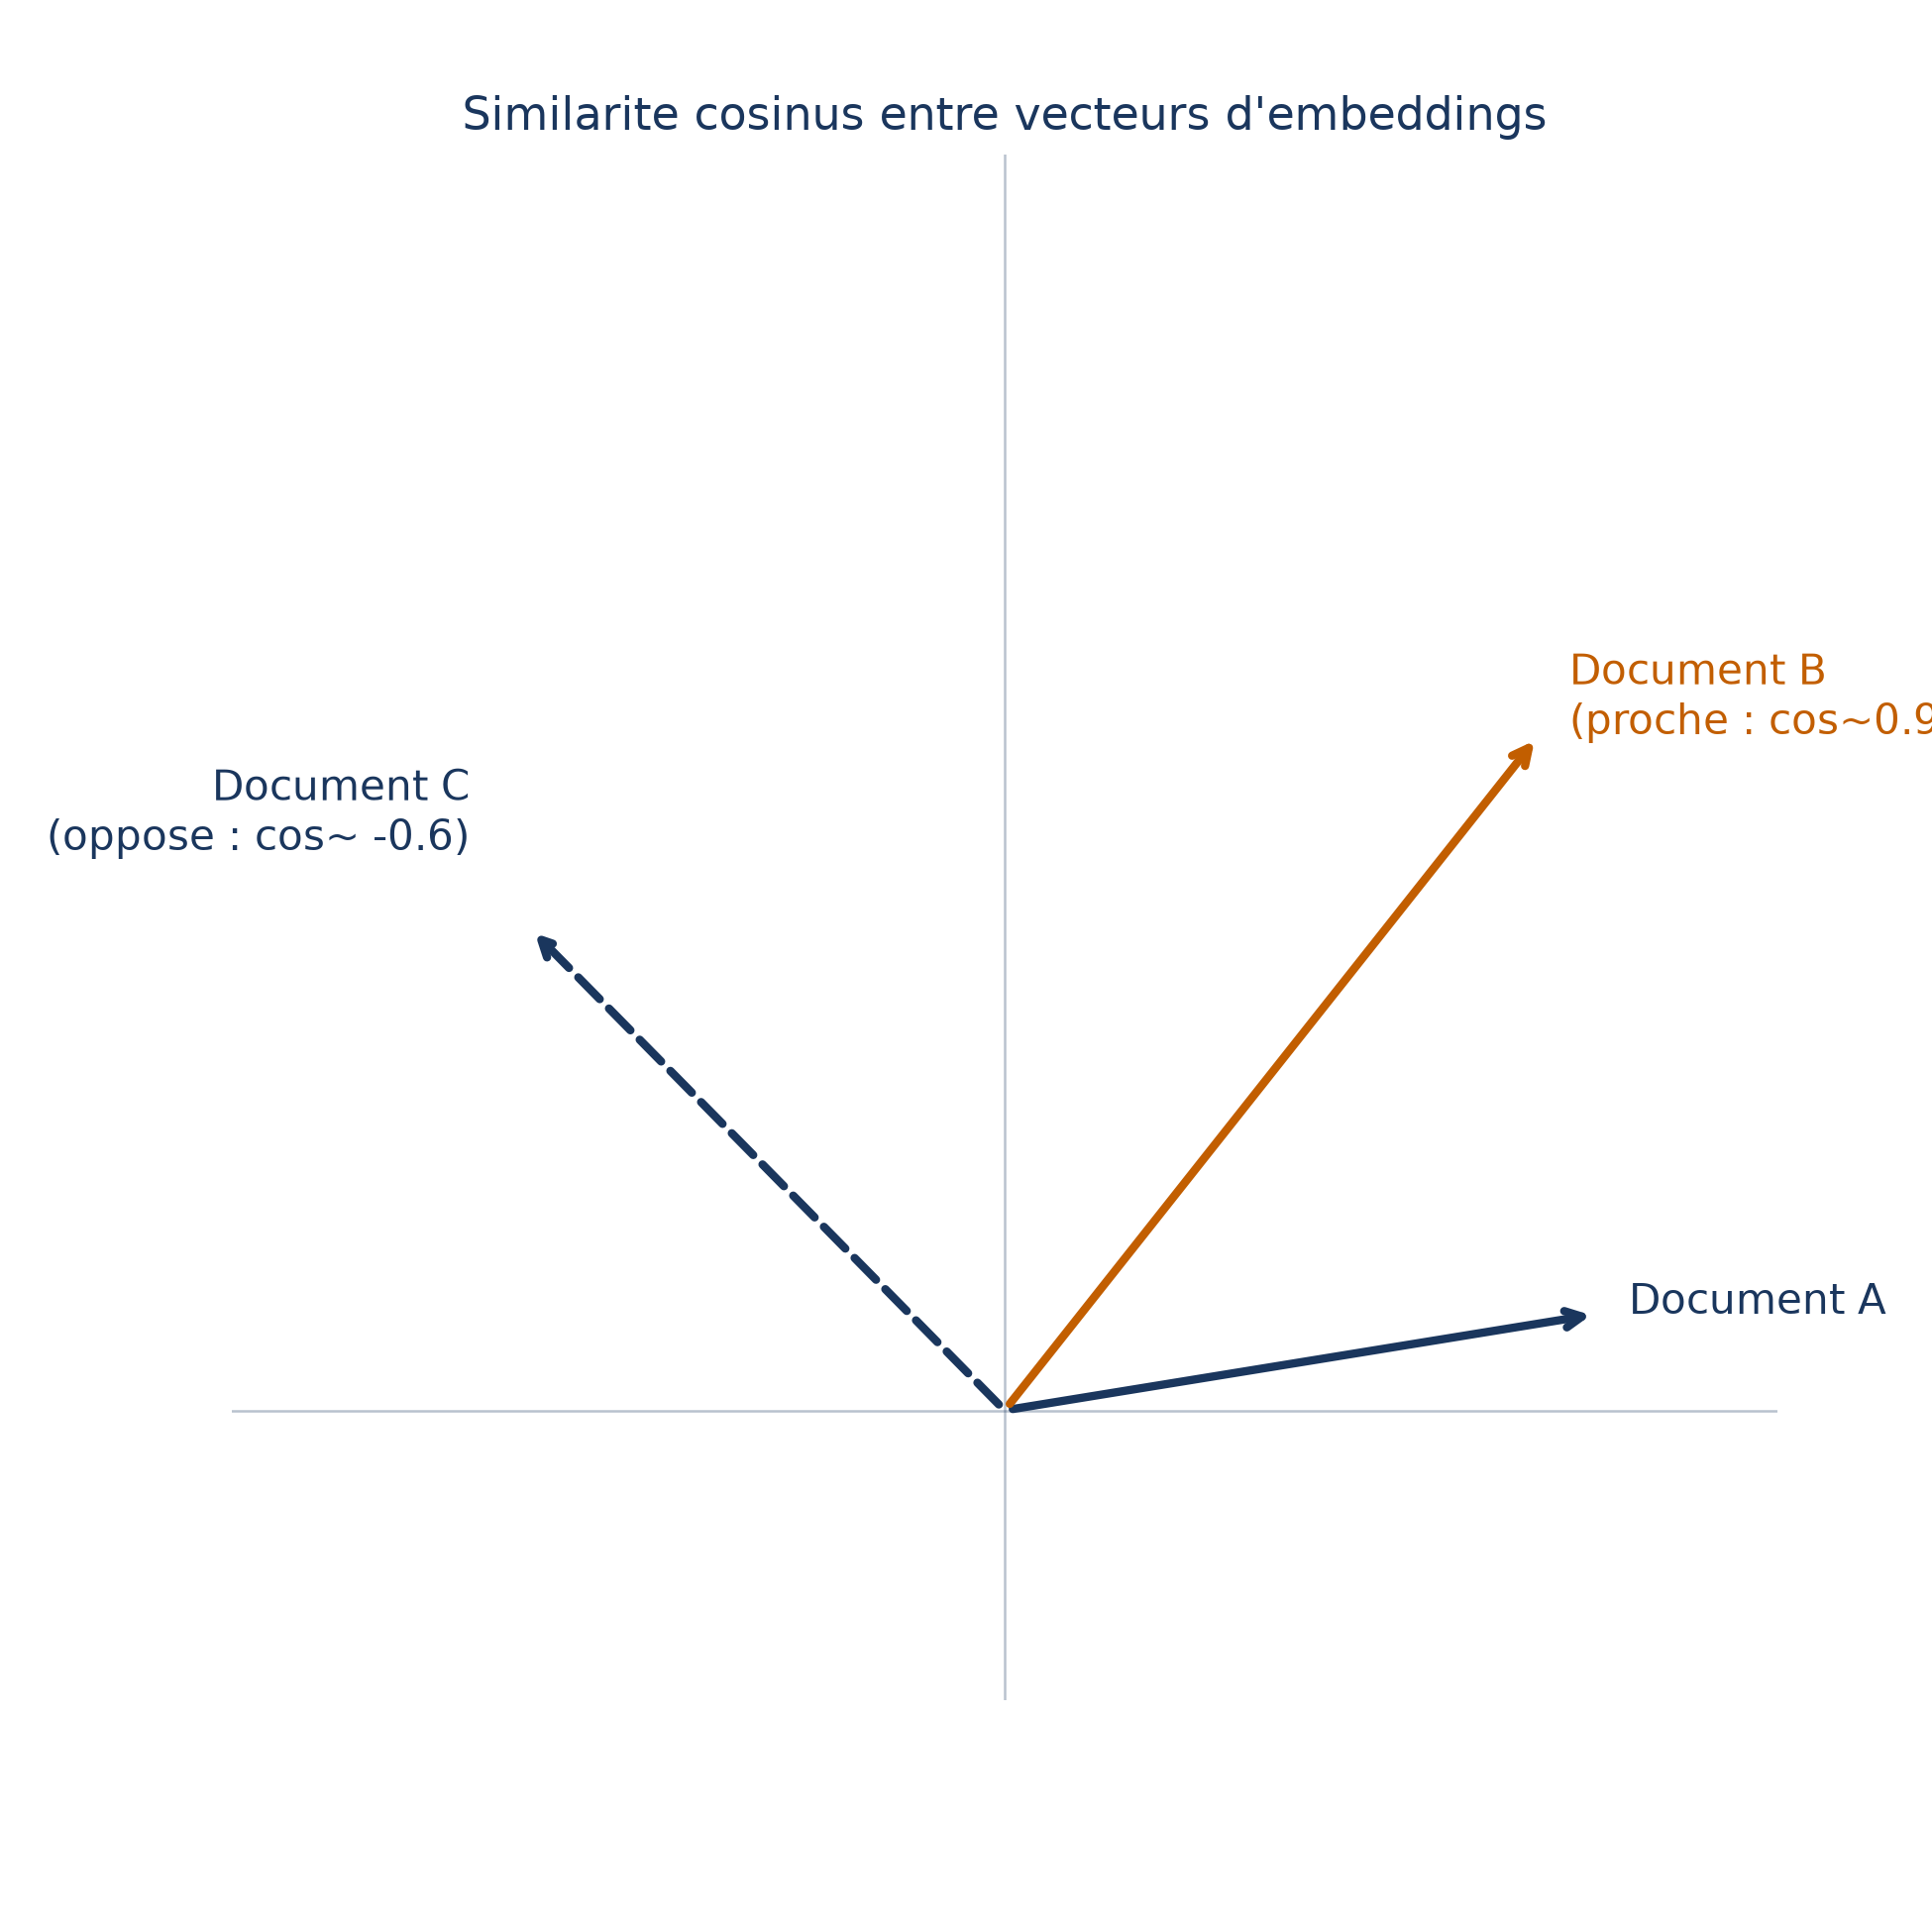
3. Convertir en embeddings. Un ordinateur ne traite que des nombres. Un embedding est une liste de nombres qui représente un mot, une phrase ou un document, construite pour que les textes proches en signification soient proches dans l’espace vectoriel. Plus la liste est longue (on parle de dimension), plus elle peut porter d’information, au prix d’un calcul plus coûteux.
Pour mesurer cette proximité, on utilise le plus souvent la similarité cosinus : le cosinus de l’angle entre deux vecteurs. Des vecteurs parallèles donnent 1 (sens très proches), un angle droit donne 0 (termes non reliés), un angle de 180° donne −1 (sens opposés).
⚠️ Piège Le modèle d’embeddings doit rester strictement le même dans toute l’application, pour les fragments comme pour les questions. En changer implique de recalculer tout l’index.
4. Stocker. Les vecteurs sont conservés dans une base de données vectorielle, conçue pour rechercher efficacement des vecteurs de grande dimension. On y trouve des index purs (FAISS), des bases spécialisées (Pinecone, ChromaDB, Milvus, Qdrant…), mais aussi des bases SQL, NoSQL ou de graphes qui ont ajouté cette capacité. L’index retrouve un voisin très proche plutôt que le voisin exact : un compromis entre vitesse et précision.
Le pipeline de génération : répondre en direct
Une fois la base prête, le pipeline de génération prend le relais, et son cœur est le retriever. Il convertit la question en embedding avec le même modèle que celui des fragments, puis retrouve les embeddings les plus proches. C’est sans doute le composant le plus critique de tout le système ; comme la recherche coûte cher en calcul, il pèse aussi lourd dans la latence.
Vient ensuite l’augmentation : combiner la question et l’information récupérée dans un prompt. Cela paraît trivial, mais c’est de l’ingénierie de prompt, et la façon de construire ce texte influence considérablement la réponse. Le prompting contextuel ajoute une consigne du type « répondez uniquement à partir du contexte fourni ci-dessous ». Le prompting à génération contrôlée va plus loin : il demande au modèle de répondre « Je ne sais pas » si le contexte ne suffit pas.
Reste la génération. Puisque le retriever a déjà trouvé l’information, le LLM n’a plus qu’à s’en servir pour rédiger : c’est une tâche bien plus légère que de tout savoir par cœur. On peut donc employer des modèles plus petits, plus rapides et moins coûteux, tout en gagnant en fiabilité.
Le voir tourner
Reprenons notre question sur le cricket, avec LangChain, un framework open source lancé en octobre 2022 par Harrison Chase pour construire des applications à base de LLM. Première étape : au lieu de copier le paragraphe à la main, on se connecte à la page Wikipédia du tournoi et on en extrait les données par programmation.
%pip install langchain==0.3.19
%pip install langchain-community
%pip install bs4==0.0.2 --quiet

from langchain_community.document_loaders import AsyncHtmlLoader

url = "https://en.wikipedia.org/wiki/2023_Cricket_World_Cup"
loader = AsyncHtmlLoader(url)
html_data = loader.load()
On obtient une liste de documents, chacun avec deux éléments : page_content, le texte brut (encore chargé de balises HTML), et metadata, qui contient la source, le titre, la langue. Une fois le HTML nettoyé, il faut découper. Ici, un découpage par caractère, en morceaux de 1 000 caractères qui se recouvrent sur 200.
from langchain.text_splitters import CharacterTextSplitter

text_splitter = CharacterTextSplitter(
    separator="\n",  # caractere utilise pour le decoupage
    chunk_size=1000,  # nombre de caracteres par chunk
    chunk_overlap=200,  # nombre de caracteres de chevauchement
)
chunks = text_splitter.create_documents(
    [html_data_transformed[0].page_content]
)
print(f"Nombre de chunks crees : {len(chunks)}")
Sur cette page, on obtient 67 fragments, et l’on peut vérifier que les 200 derniers caractères de l’un recoupent les 200 premiers du suivant. Pour les textes génériques, on recommande plutôt RecursiveCharacterTextSplitter, qui retente le découpage avec un séparateur de repli tant que la taille voulue n’est pas atteinte.
Place aux embeddings. Ici, avec un modèle open source hébergé sur Hugging Face.
from langchain_huggingface import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(
    model_name="sentence-transformers/all-mpnet-base-v2"
)
hf_embeddings = embeddings.embed_documents(
    [chunk.page_content for chunk in final_chunks]
)
len(hf_embeddings[0])
Ce modèle produit des embeddings de 768 dimensions : la liste contient 285 listes de 768 nombres, une par fragment. Avec text-embedding-3-small d’OpenAI, ce serait 1 536 dimensions. Le choix se fait selon le cas d’usage, le classement MTEB et le coût : créer des embeddings pour des milliers de documents peut représenter des millions de tokens facturés.
Une fois les vecteurs stockés dans un index FAISS et sauvegardés, le pipeline de génération peut les recharger et interroger la base. Le paramètre k=2 demande les deux fragments les plus proches.
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings
import os
os.environ["OPENAI_API_KEY"] = "<YOUR_API_KEY>"

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vector_store = FAISS.load_local(
    folder_path="../../Assets/Data",
    index_name="CWC_index",
    embeddings=embeddings,
    allow_dangerous_deserialization=True
)
query = "Who won the 2023 Cricket World Cup?"
retrieved_docs = vector_store.similarity_search(query, k=2)
Interrogé ainsi, l’index renvoie les fragments classés par similarité décroissante, et celui qui parle de la finale arrive en tête. Le vector store joue ici lui-même le rôle de retriever : c’est l’implémentation la plus simple possible.
Dernière pièce, l’augmentation. Voici comment se construit un prompt qui contraint le modèle à s’en tenir aux documents récupérés (l’exemple vient d’un corpus sur Einstein).
system_message = "You're an Einstein expert, but can only use the provided documents to respond to the
    questions."
user_message = f"""
Use the following documents to answer the question that will follow:
{[doc["text"] for doc in similar_records]}
---
The question to answer using information only from the above documents:
{question}
"""
Le message système fixe la règle du jeu ; le message utilisateur insère les fragments retrouvés, puis la question. Envoyé à GPT-4, ce prompt renvoie la réponse attendue : le retriever a fait son travail, et le générateur s’est contenté d’en tirer la conclusion.
Lire les résultats : comment savoir si ça marche ?
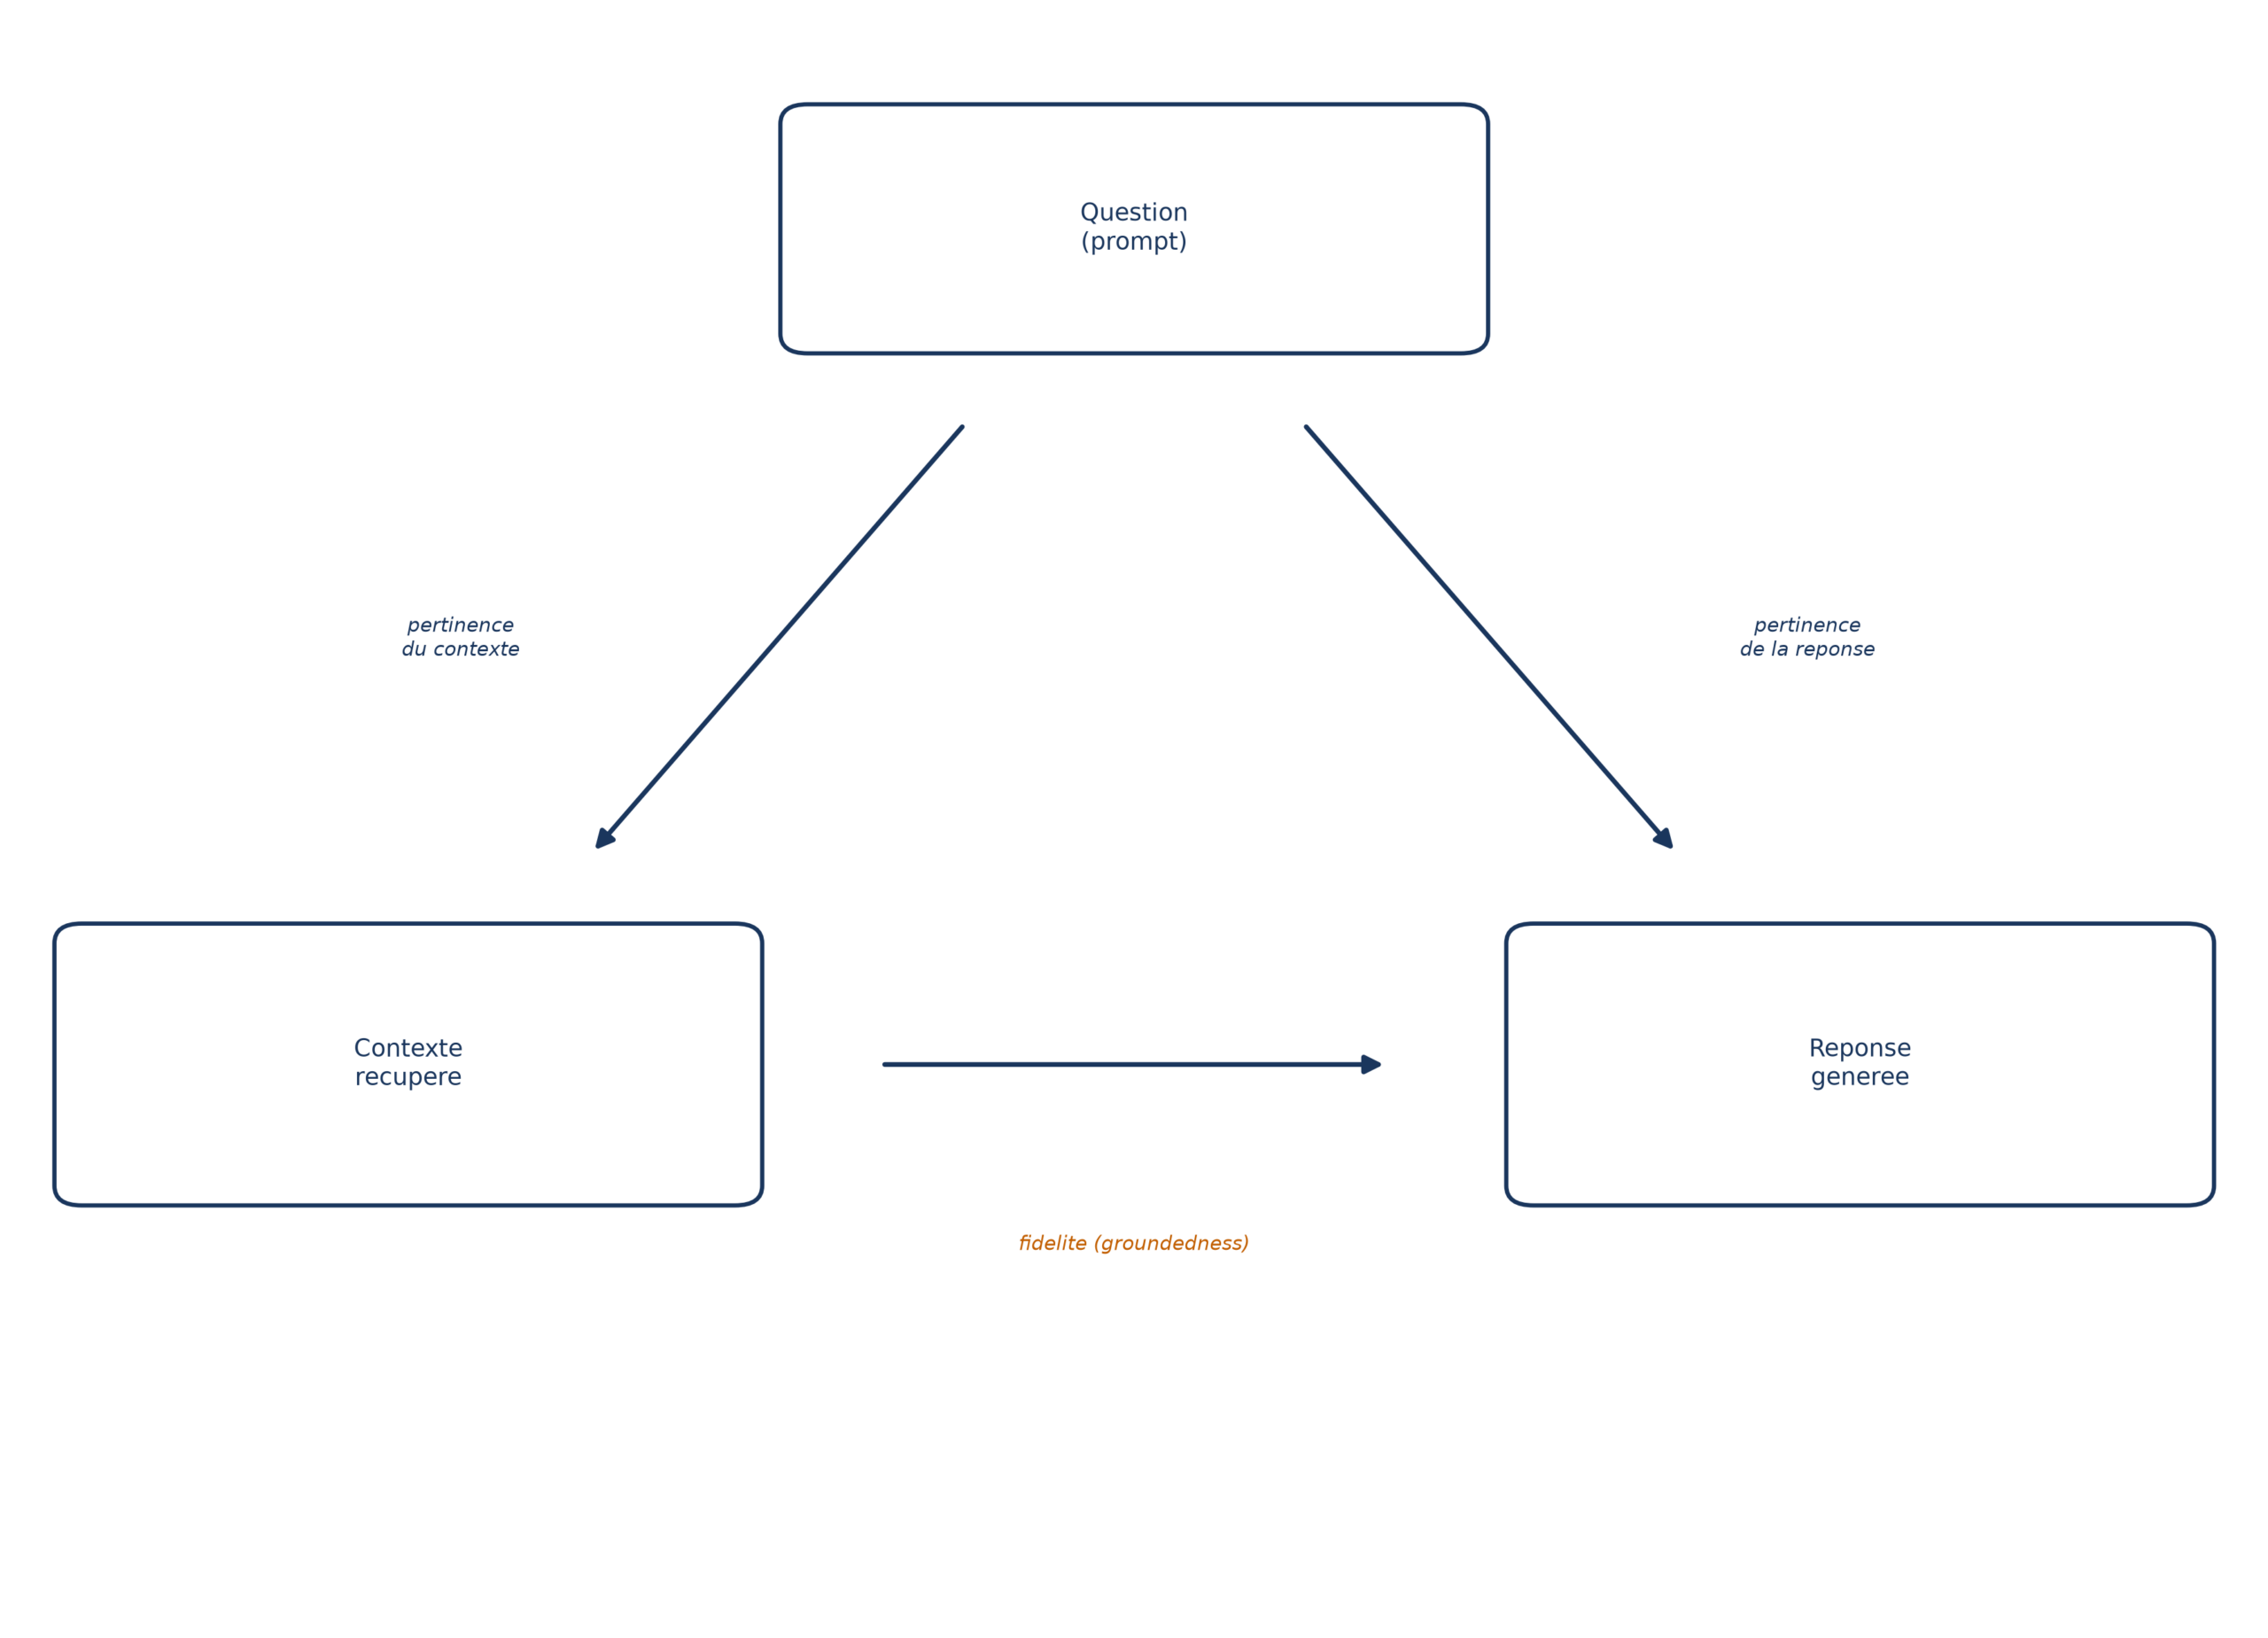
Sans mesure, impossible de dire si le système fonctionne ou s’il hallucine encore. Les chercheurs retiennent trois relations à examiner, la « triade » proposée par TruEra : entre la question et le contexte récupéré (l’information est-elle la plus pertinente ?), entre le contexte et la réponse (le modèle s’appuie-t-il vraiment dessus ?), entre la réponse et la question (répond-elle à ce qui était demandé ?).
Côté récupération, deux questions simples. La précision : parmi les documents récupérés, combien étaient pertinents ? Le rappel : parmi tous les documents pertinents, combien ont été récupérés ? Un rappel parfait s’obtient trivialement en récupérant toute la base, ce qui montre pourquoi on ne le lit jamais seul.
Pour se faire une idée des ordres de grandeur, un benchmark sur un système à base de graphe a donné une fidélité de 0,97, un rappel de contexte de 0,79 et une exactitude de 0,78. Lecture : le modèle invente rarement, mais la récupération ne capture pas toujours toute l’information nécessaire, et c’est là qu’il faut travailler.
Pièges et limites
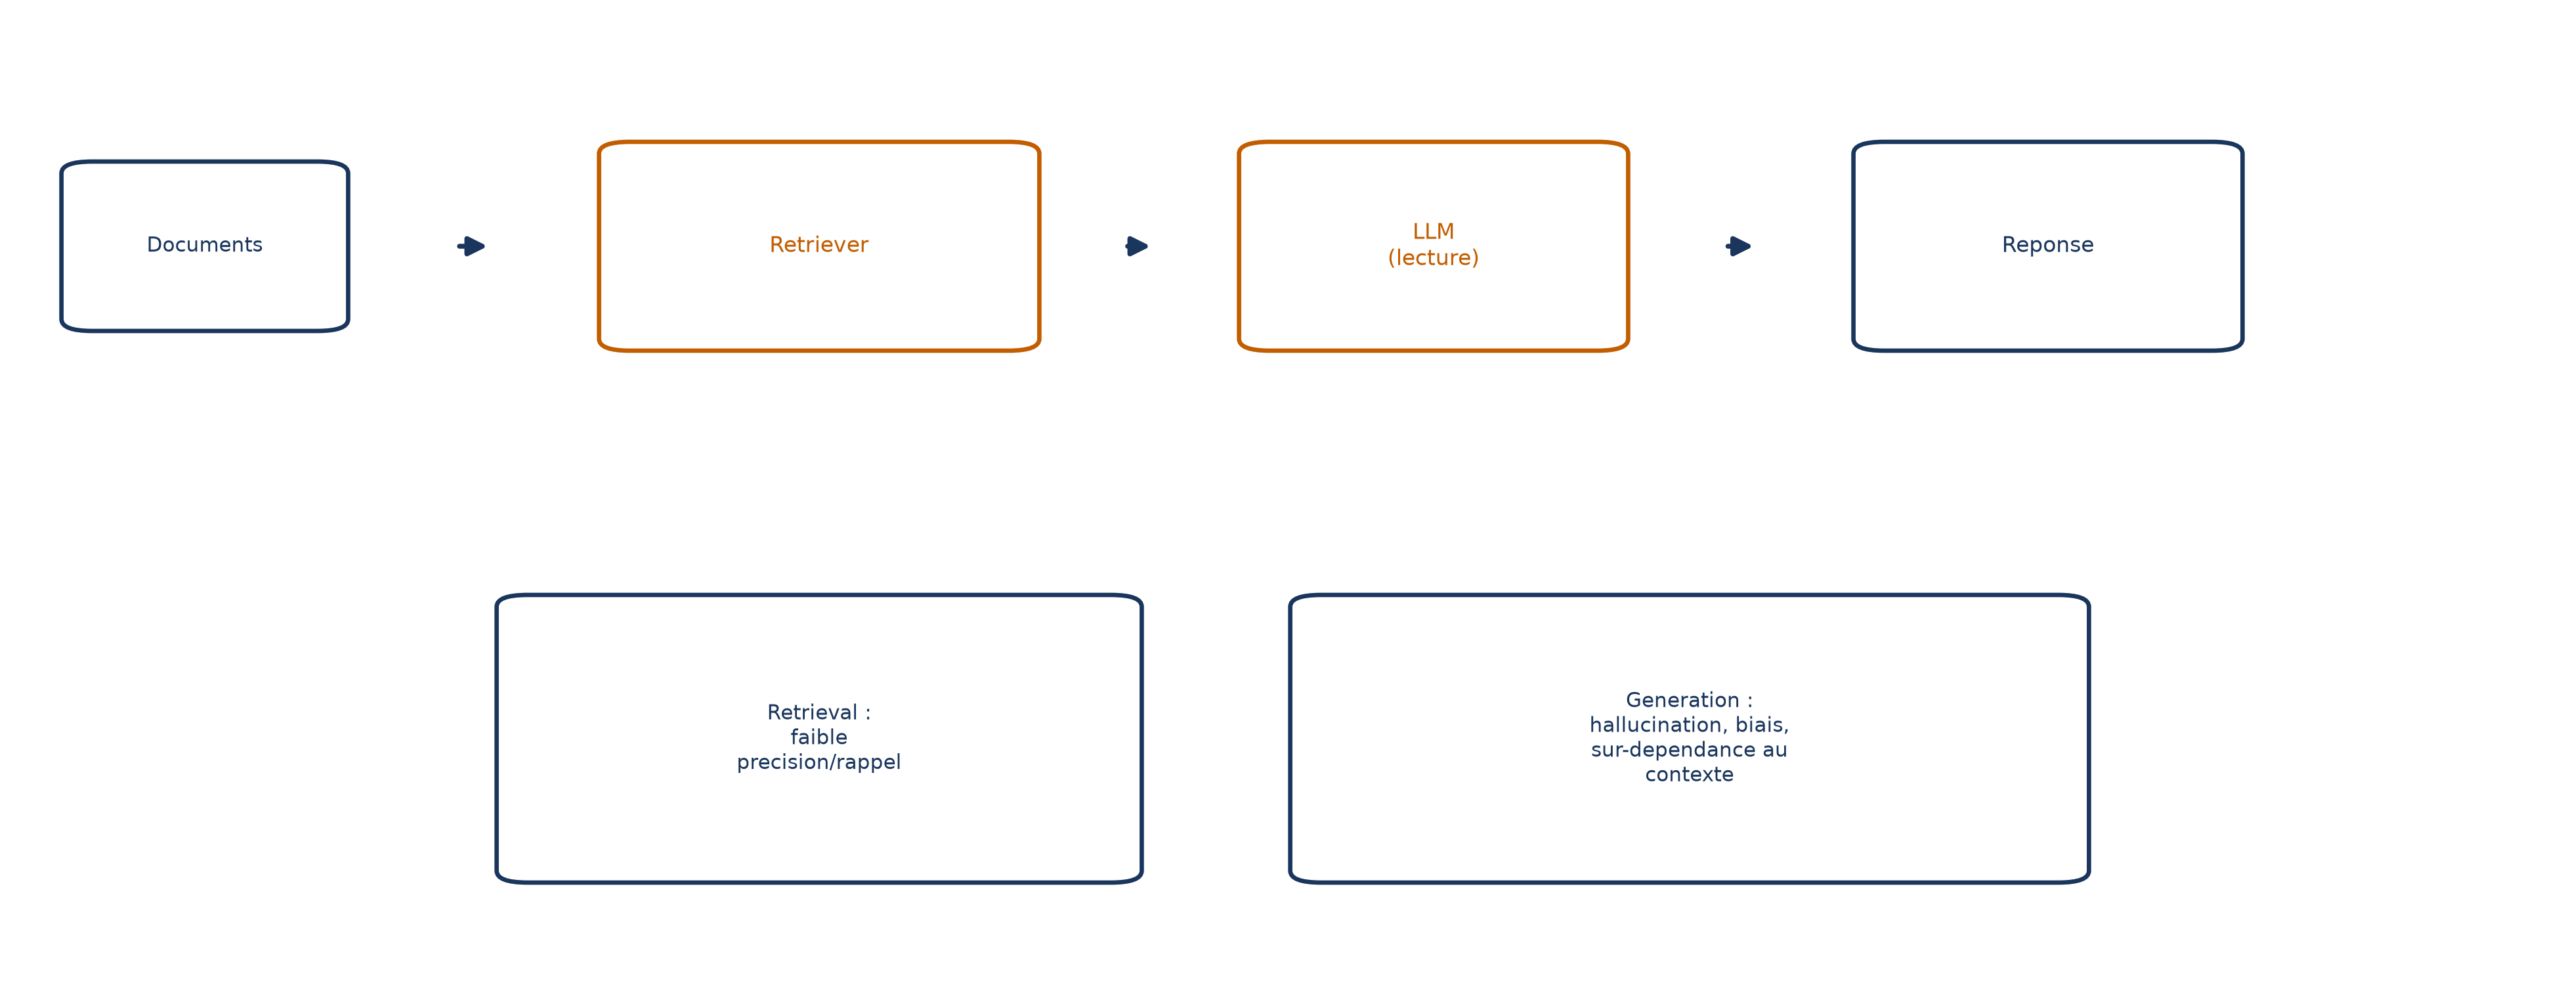
Un système RAG peut lui-même halluciner, pour trois raisons : le retriever ne ramène pas tout le contexte pertinent (ou ramène du hors-sujet), le LLM ne tient pas compte du contexte fourni, ou il puise dans les éléments non pertinents du contexte plutôt que de répondre à la question.
Le RAG « naïf », qui se contente de récupérer puis de lire, souffre à chaque étape. À la récupération, la précision et le rappel sont souvent faibles. À l’augmentation, des documents similaires créent de la redondance et des contextes venus de sources différentes deviennent décousus. À la génération, ces insuffisances se traduisent par des hallucinations, un manque d’ancrage, ou une dépendance excessive au contexte.
⚠️ Piège Les embeddings sont faits pour retrouver du contenu sémantiquement proche, pas pour filtrer, trier ou compter. Demandez les conditions de paiement d’un contrat précis : les fragments les plus similaires peuvent venir de contrats différents, et le modèle en tire une réponse fragmentée, voire trompeuse. Demandez « combien de contrats actifs avons-nous avec ACME Inc. ? » : l’approche par embeddings échoue, faute de pouvoir filtrer puis compter.
Certaines requêtes restent des points faibles récurrents : celles qui demandent un raisonnement en plusieurs étapes, les requêtes générales ou vagues (difficiles à faire correspondre à un fragment précis), les requêtes longues ou complexes, et les requêtes implicites, qui exigent une compréhension que le RAG seul ne fournit pas.
Enfin, chaque étape ajoute du temps de calcul : récupération, re-classement et génération s’additionnent, ce qui peut dégrader l’expérience dans les applications temps réel.
Aller plus loin
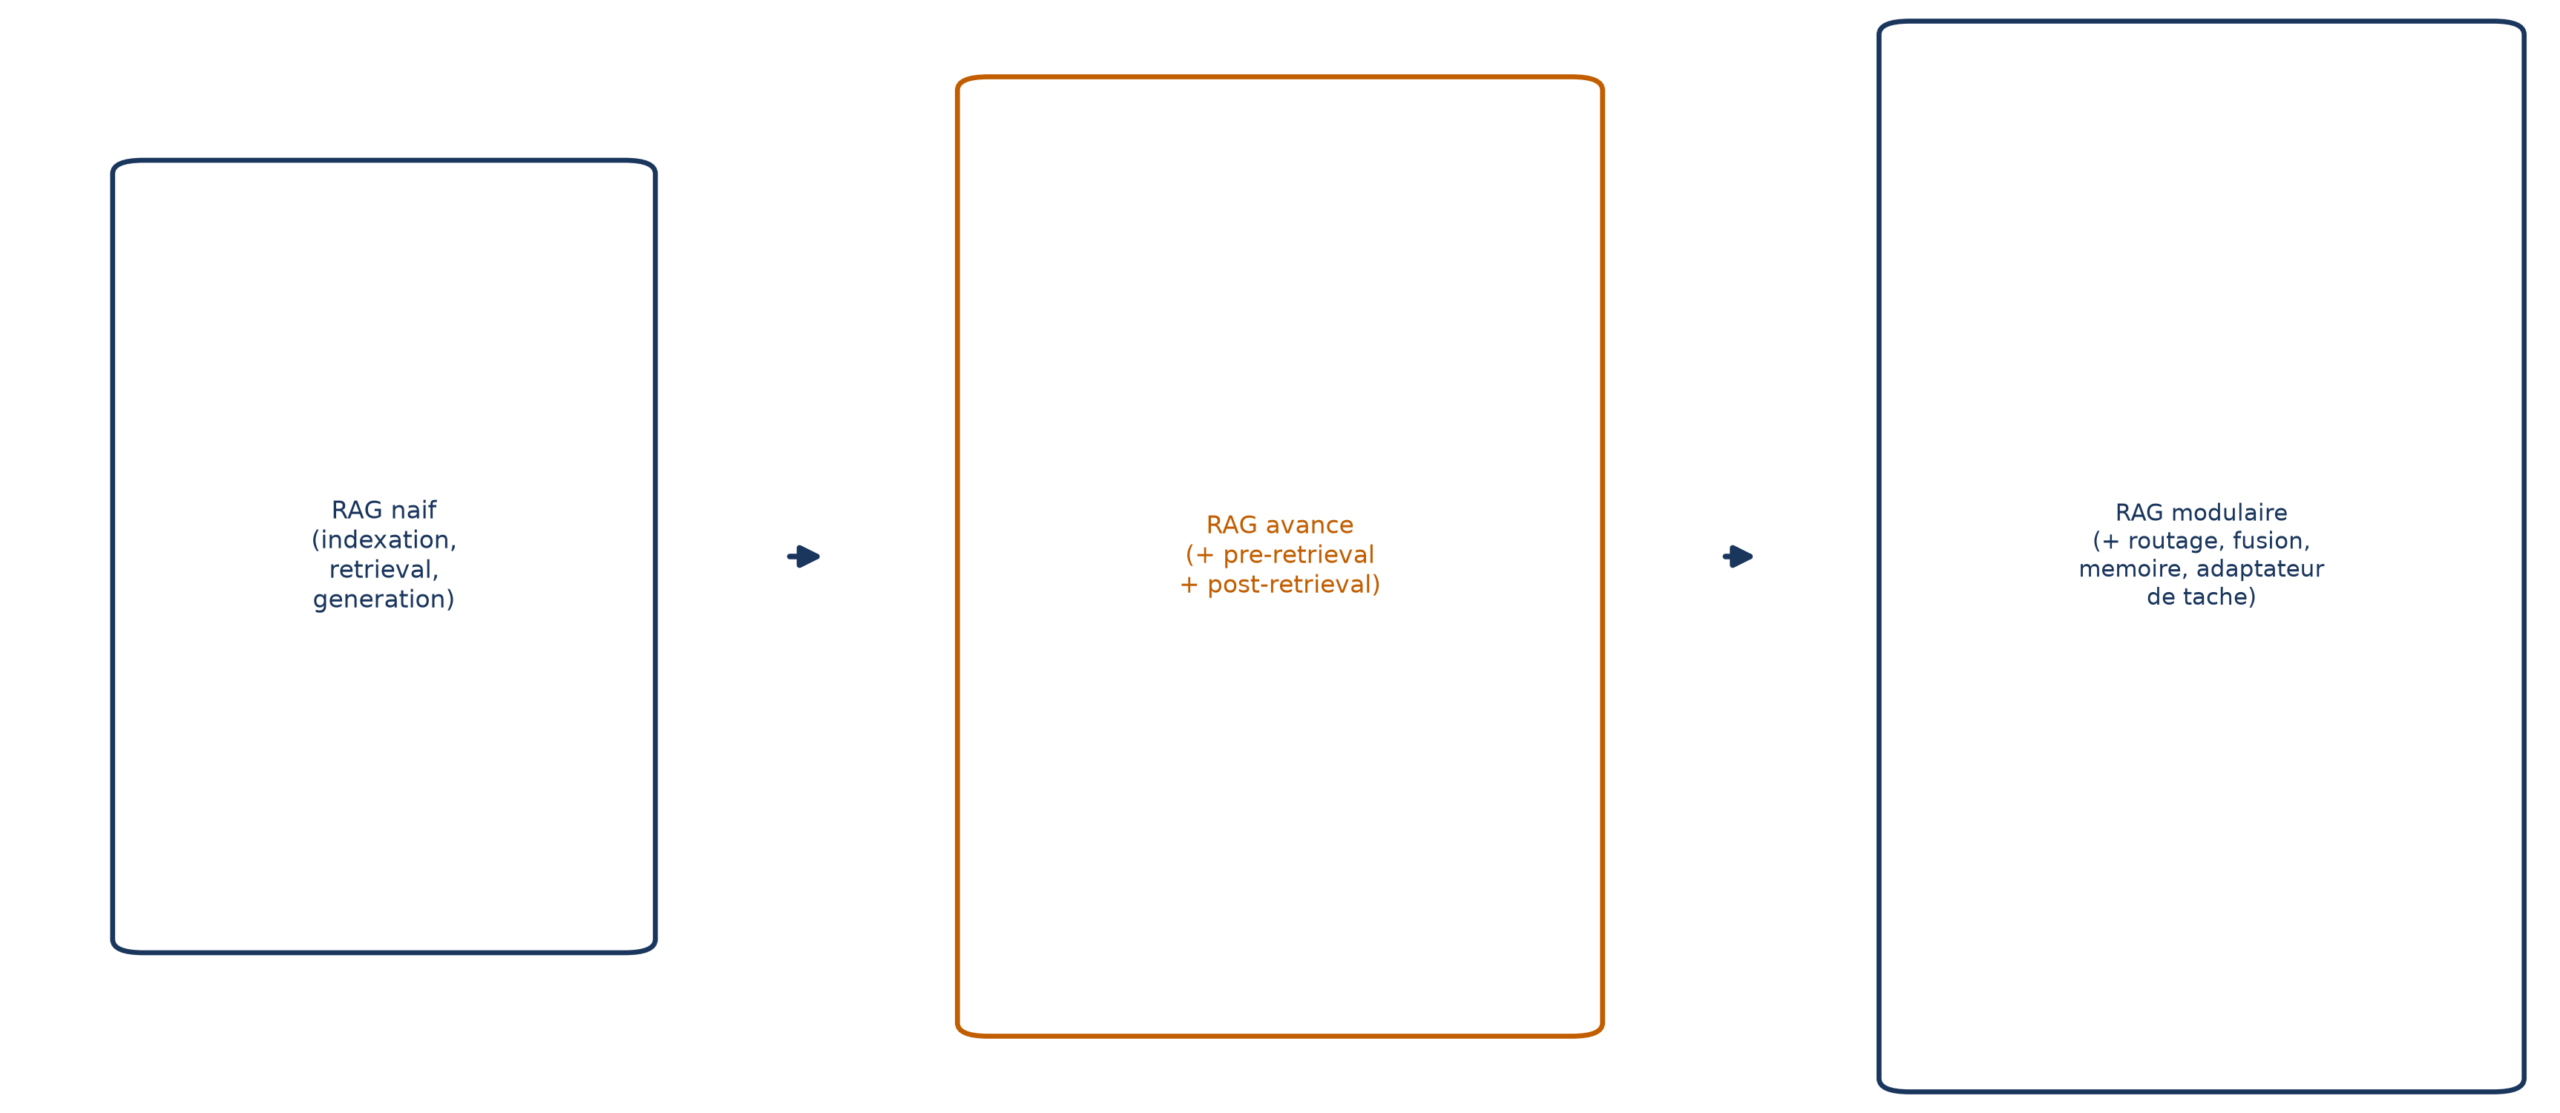
Le RAG naïf suffit rarement en production. Le RAG avancé y ajoute des techniques avant la récupération (réécrire la requête, optimiser l’index) et après (compresser ou re-classer le contexte) ; le RAG modulaire découpe le tout en composants interchangeables. Ce ne sont pas des concurrents mais une progression : le RAG naïf est un cas particulier du RAG avancé, lui-même un cas particulier du modulaire.
-
La recherche hybride combine recherche par mots-clés et recherche sémantique, puis fusionne les résultats selon une pondération adaptée.
-
Le re-classement réordonne les documents récupérés pour prioriser les plus pertinents avant la génération, surtout utile quand plusieurs méthodes de recherche doivent être arbitrées.
-
Le RAG par graphe de connaissances représente l’information en entités et relations, pour les questions dont la réponse n’est dans aucun fragment isolé (« quels sont les thèmes principaux de ce rapport ? »).
-
Le RAG agentique confie à un ou plusieurs agents LLM la décision de quelle source interroger, et si l’information trouvée suffit.
-
Self-RAG entraîne le modèle à émettre des « jetons de réflexion » qui décident s’il faut récupérer davantage, jugent un passage, ou vérifient que la réponse s’appuie bien sur lui.
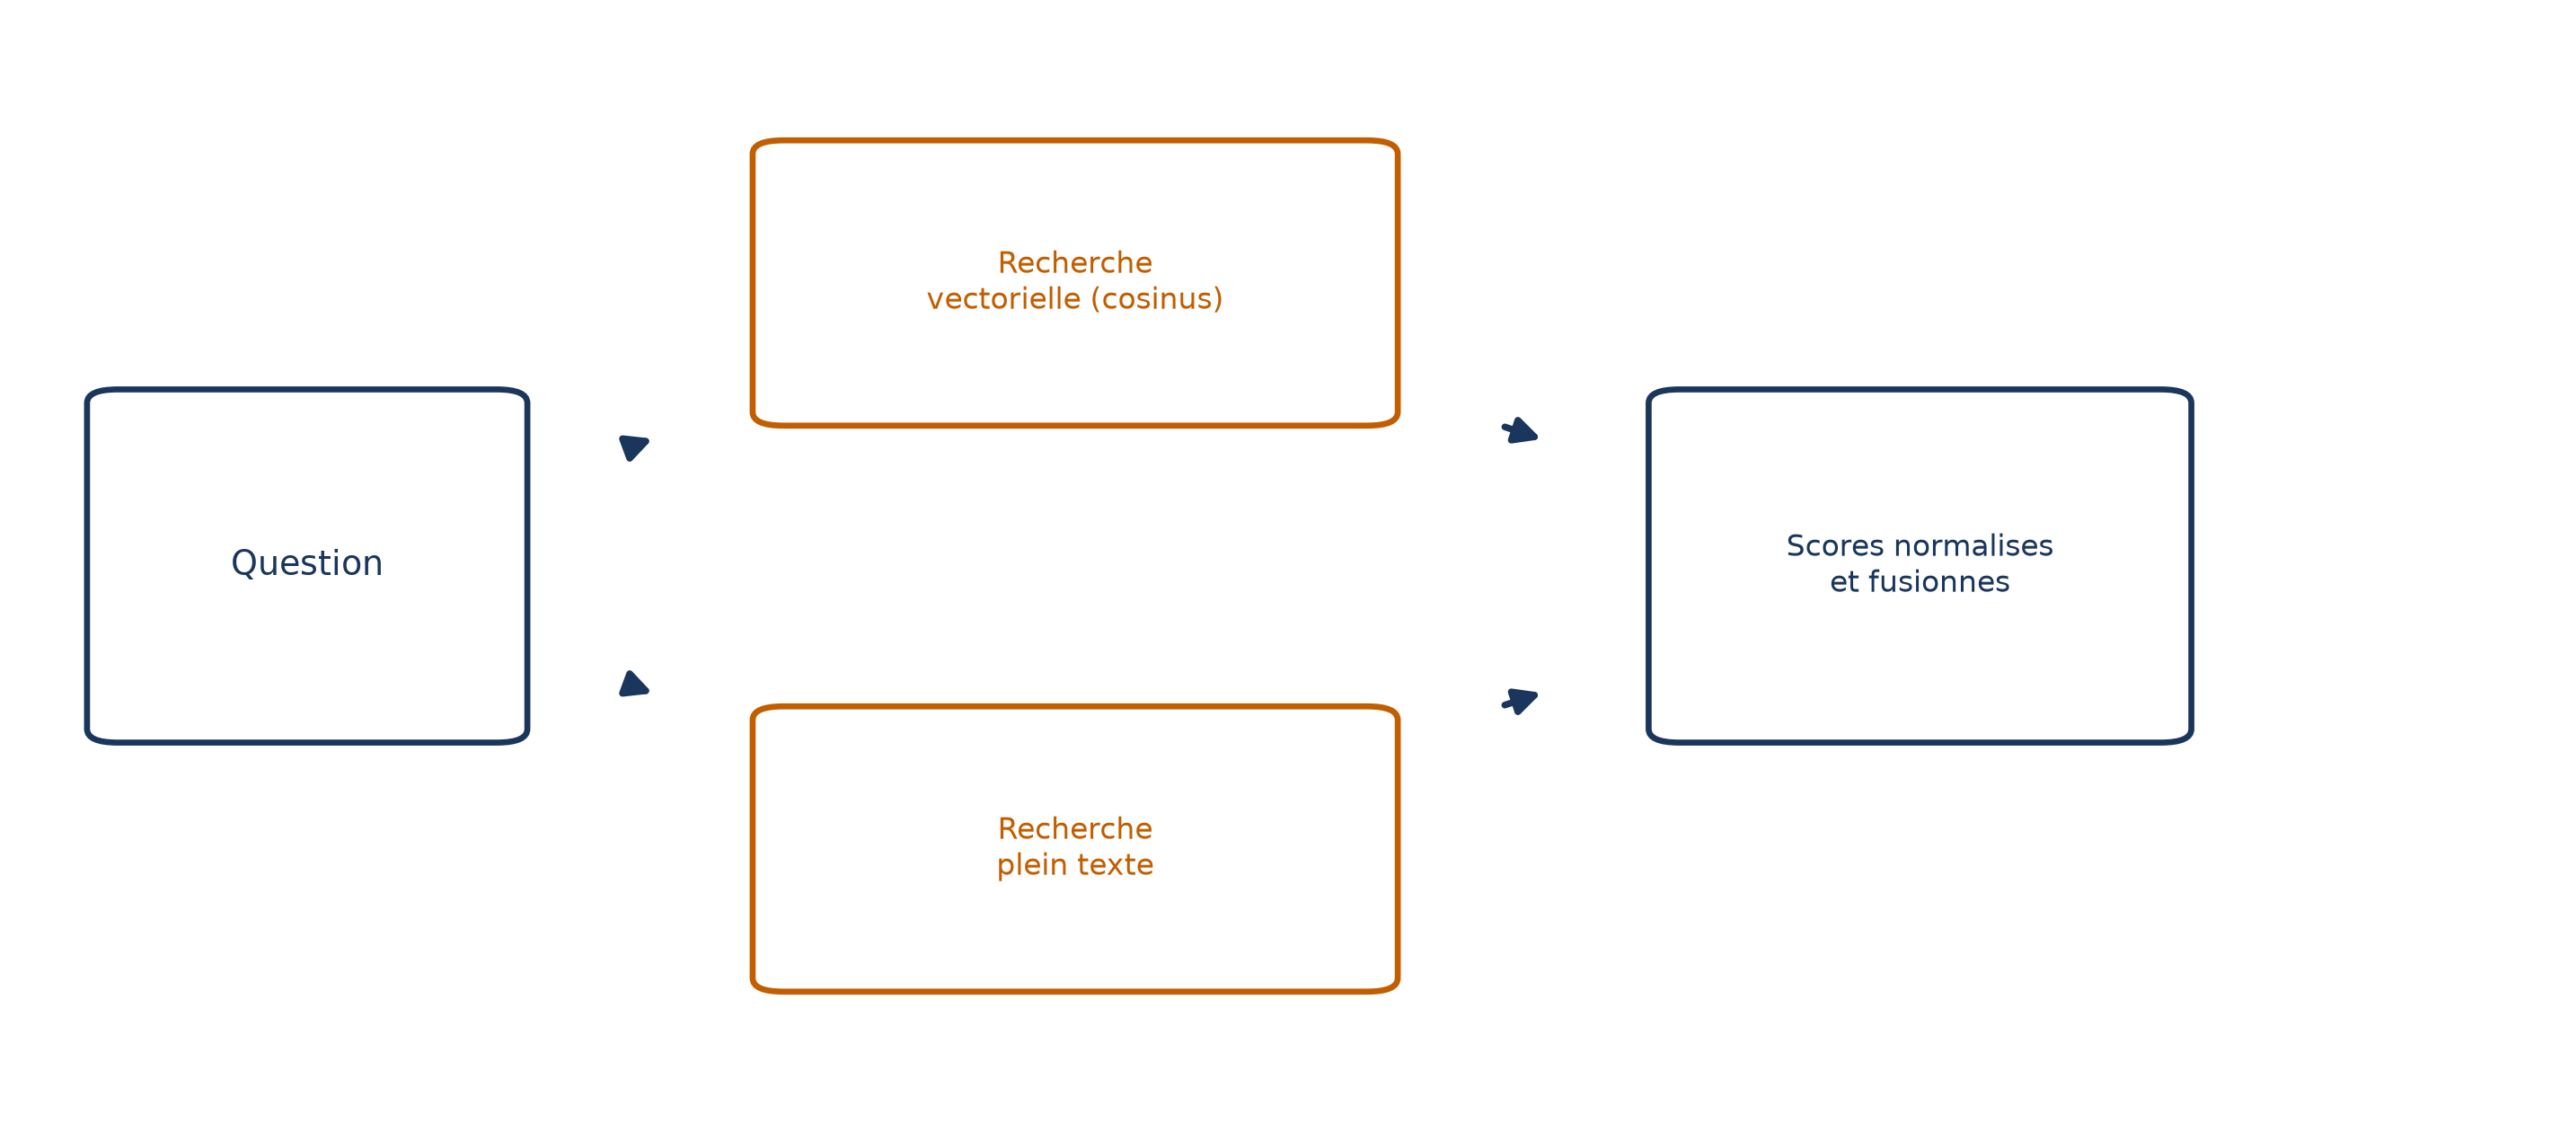
La recherche hybride, par exemple, lance une recherche vectorielle et une recherche plein texte en parallèle, normalise leurs scores, puis fusionne les résultats.
À retenir
- Un système RAG, ce sont deux temps : une base de connaissances préparée hors ligne, puis une chaîne de réponse en direct.
- Le LLM ne « sait » pas : il génère à partir de ses poids. Le RAG lui apporte, question par question, la documentation qui lui manque.
- Tout se joue à la récupération : fragments bien découpés, même modèle d’embeddings partout, et retriever évalué séparément du LLM.
- Mesurez trois relations (question–contexte, contexte–réponse, réponse–question) plutôt qu’un score global.
- Commencez simple : on peut partir d’une implémentation naïve et évoluer vers une architecture modulaire à mesure que les besoins se précisent.
Questions fréquentes
Le RAG remplace-t-il l’affinage (finetuning) d’un modèle ? Non, les deux sont complémentaires. Le RAG enrichit la mémoire non paramétrique sans modifier les poids ; l’affinage supervisé modifie la mémoire paramétrique, et convient surtout pour ajuster le style, le ton ou le vocabulaire des réponses. On peut aussi les combiner.
Avec des fenêtres de contexte géantes, à quoi sert encore le RAG ? Pour une base de connaissances modeste, on peut transmettre tout le document dans le prompt, sans découpage ni indexation. Des études montrent que les LLM à contexte long dépassent souvent le RAG en exactitude, mais à un coût de calcul nettement supérieur : le RAG reste plus économique car il traite des entrées plus courtes. Une approche hybride, SELF-ROUTE, laisse le modèle décider s’il peut répondre avec les fragments récupérés ou s’il a besoin du document complet.
Faut-il forcément construire sa propre infrastructure ? Non : des solutions gérées se multiplient (Amazon Bedrock Knowledge Bases, Azure AI Search, Google Vertex AI RAG Engine), au prix des arbitrages habituels entre coût, flexibilité et contrôle.