Un client d’un groupe qui vend de la banque, de l’assurance et des placements demande à son chatbot où en est son sinistre. Si le système fouille toutes les bases à chaque question, il perd du temps, remonte du hors-sujet et risque de toucher aux données d’un autre service. Rien, dans un RAG de base, n’aiguille la question.
Le RAG avancé répond à ce genre de situation, et à quelques autres. Tu trouveras ici de quoi le définir, situer chacune de ses briques, juger lesquelles valent leur prix et savoir ce qui change quand le système grossit.
Sommaire
- L’essentiel en 30 secondes
- Du RAG de base au RAG avancé : trois moments, pas une liste d’outils
- Chercher petit, lire grand : le grain de l’index
- Aiguiller chaque question vers la bonne base
- Après la recherche : le contexte est un budget
- Empiler les techniques : l’idée reçue qui coûte cher
- Passer à l’échelle : volume, doublons et parallélisme
- Un vecteur n’est pas un coffre-fort
L’essentiel en 30 secondes
- Un RAG avancé, c’est le RAG de base auquel on ajoute des modules avant et après la récupération.
- Il sert à passer du prototype à la production, où la précision ne suffit plus : la latence et le coût comptent aussi.
- Avant la recherche, on règle le grain de l’index et on aiguille les questions ; après, on trie, on ordonne et on comprime le contexte.
- Chaque module a un prix : dans une étude de 2024, sans reranking la baisse est sensible, alors que HyDE coûte plus qu’il ne rapporte.
- En production, il faut aussi protéger les vecteurs : ils peuvent être décodés en texte, et les doublons comme le volume pèsent sur la qualité.
Du RAG de base au RAG avancé : trois moments, pas une liste d’outils
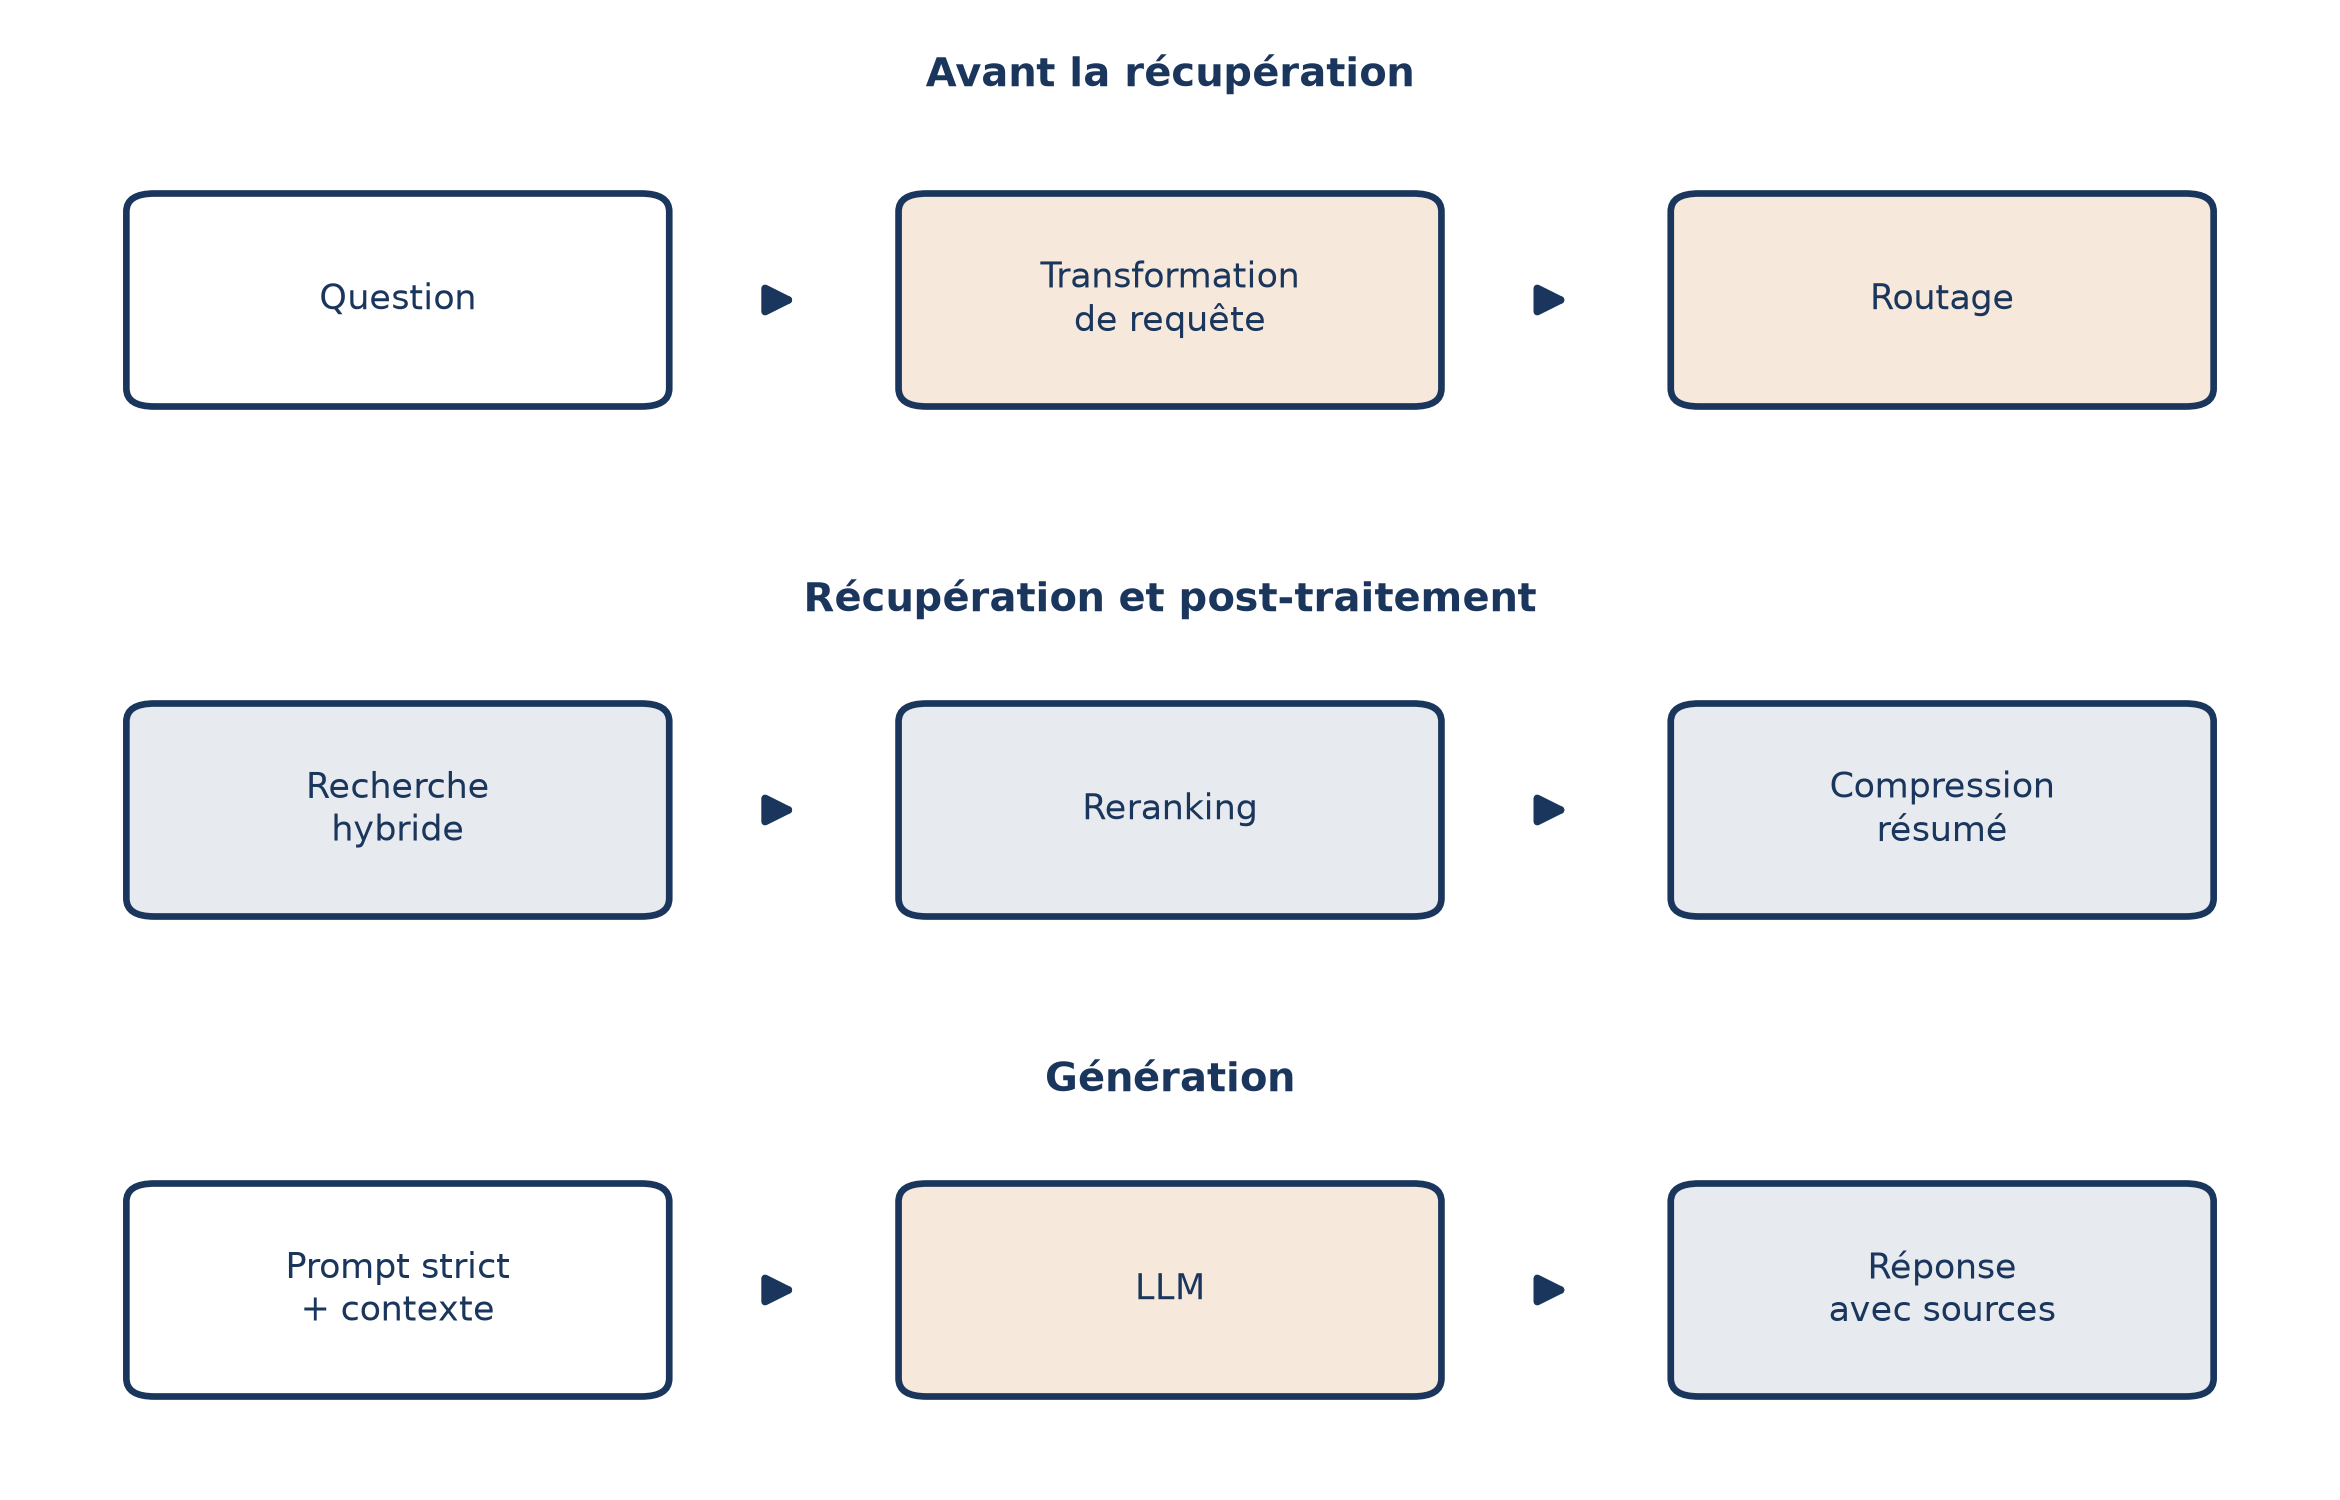
Un RAG avancé est un RAG dont on a modifié ou amélioré les étapes pour résoudre une partie des problèmes de la version de base, et pour garder plus de contrôle sur l’ensemble. On conserve les modules de base et on y ajoute des modules de pré-récupération et de post-récupération ; le RAG de base devient alors un cas particulier du RAG avancé.
Ces ajouts se rangent selon le moment où ils interviennent. Avant la recherche, on optimise l’indexation et la requête. Pendant, on emploie des stratégies de récupération plus fines que les algorithmes de base. Après, on prépare le contexte avant de le confier au LLM.
Pourquoi s’en soucier ? Parce que pour des applications industrielles, médicales, juridiques ou financières, la version de base ne suffit pas. Et la règle du jeu change : pendant le développement, la précision est peut-être la métrique la plus importante ; en production, il faut équilibrer performance et coût.
Voici la carte que suivra cet article. Elle retient les cinq compléments les plus courants : un reranker, une transformation de requête simple, un routage, une recherche hybride et un résumé du contexte.
Chercher petit, lire grand : le grain de l’index
Un petit fragment se retrouve avec précision, mais il n’explique plus grand-chose au LLM. Un gros fragment l’éclaire, mais il noie la recherche. Les techniques qui suivent cherchent à avoir les deux.
Chercher à la phrase, lire autour
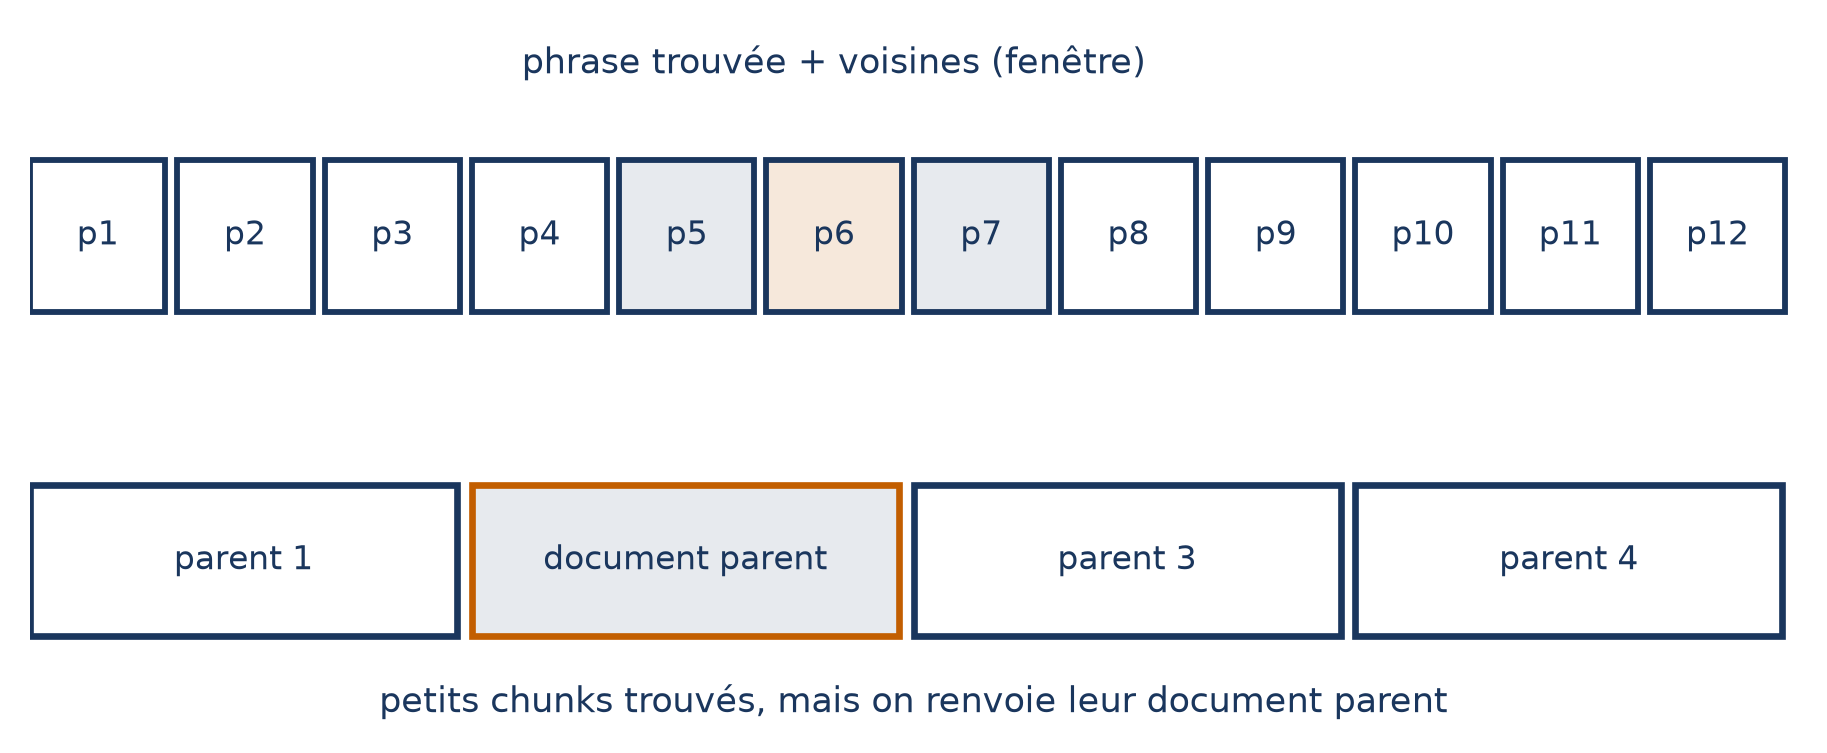
La récupération par fenêtre de phrases plonge chaque phrase séparément. L’unité est plus petite, donc la recherche plus précise, mais le LLM risque de manquer de contexte pour raisonner. Le remède : une fois la phrase x trouvée, on prend aussi les k phrases qui l’entourent, avant et après.
Le récupérateur de document parent fait le chemin inverse. On découpe en petits fragments « enfants » tout en gardant le lien avec leurs documents « parents » ; on plonge les enfants, qui répondent précisément à la requête, puis on donne au LLM les parents, pour la profondeur. Pour ne pas ramener trop de parents, on n’ajoute un document que si plus de n fragments parmi les k meilleurs en proviennent.
Chercher dans un arbre de résumés
Imagine un document découpé en grandes parties, elles-mêmes découpées en sections. Plonger une grande partie telle quelle donne un embedding bruité, qui représente mal son sens. L’index hiérarchique crée donc un résumé à chaque niveau : au sommet, les points clés de grands segments ; plus bas, des résumés de plus en plus proches de la section utile.
À la question, on compare la requête aux embeddings des résumés, puis les métadonnées associées permettent de retrouver les fragments qui correspondent au résumé retenu. Les résumés s’écrivent à la main ou avec un LLM.
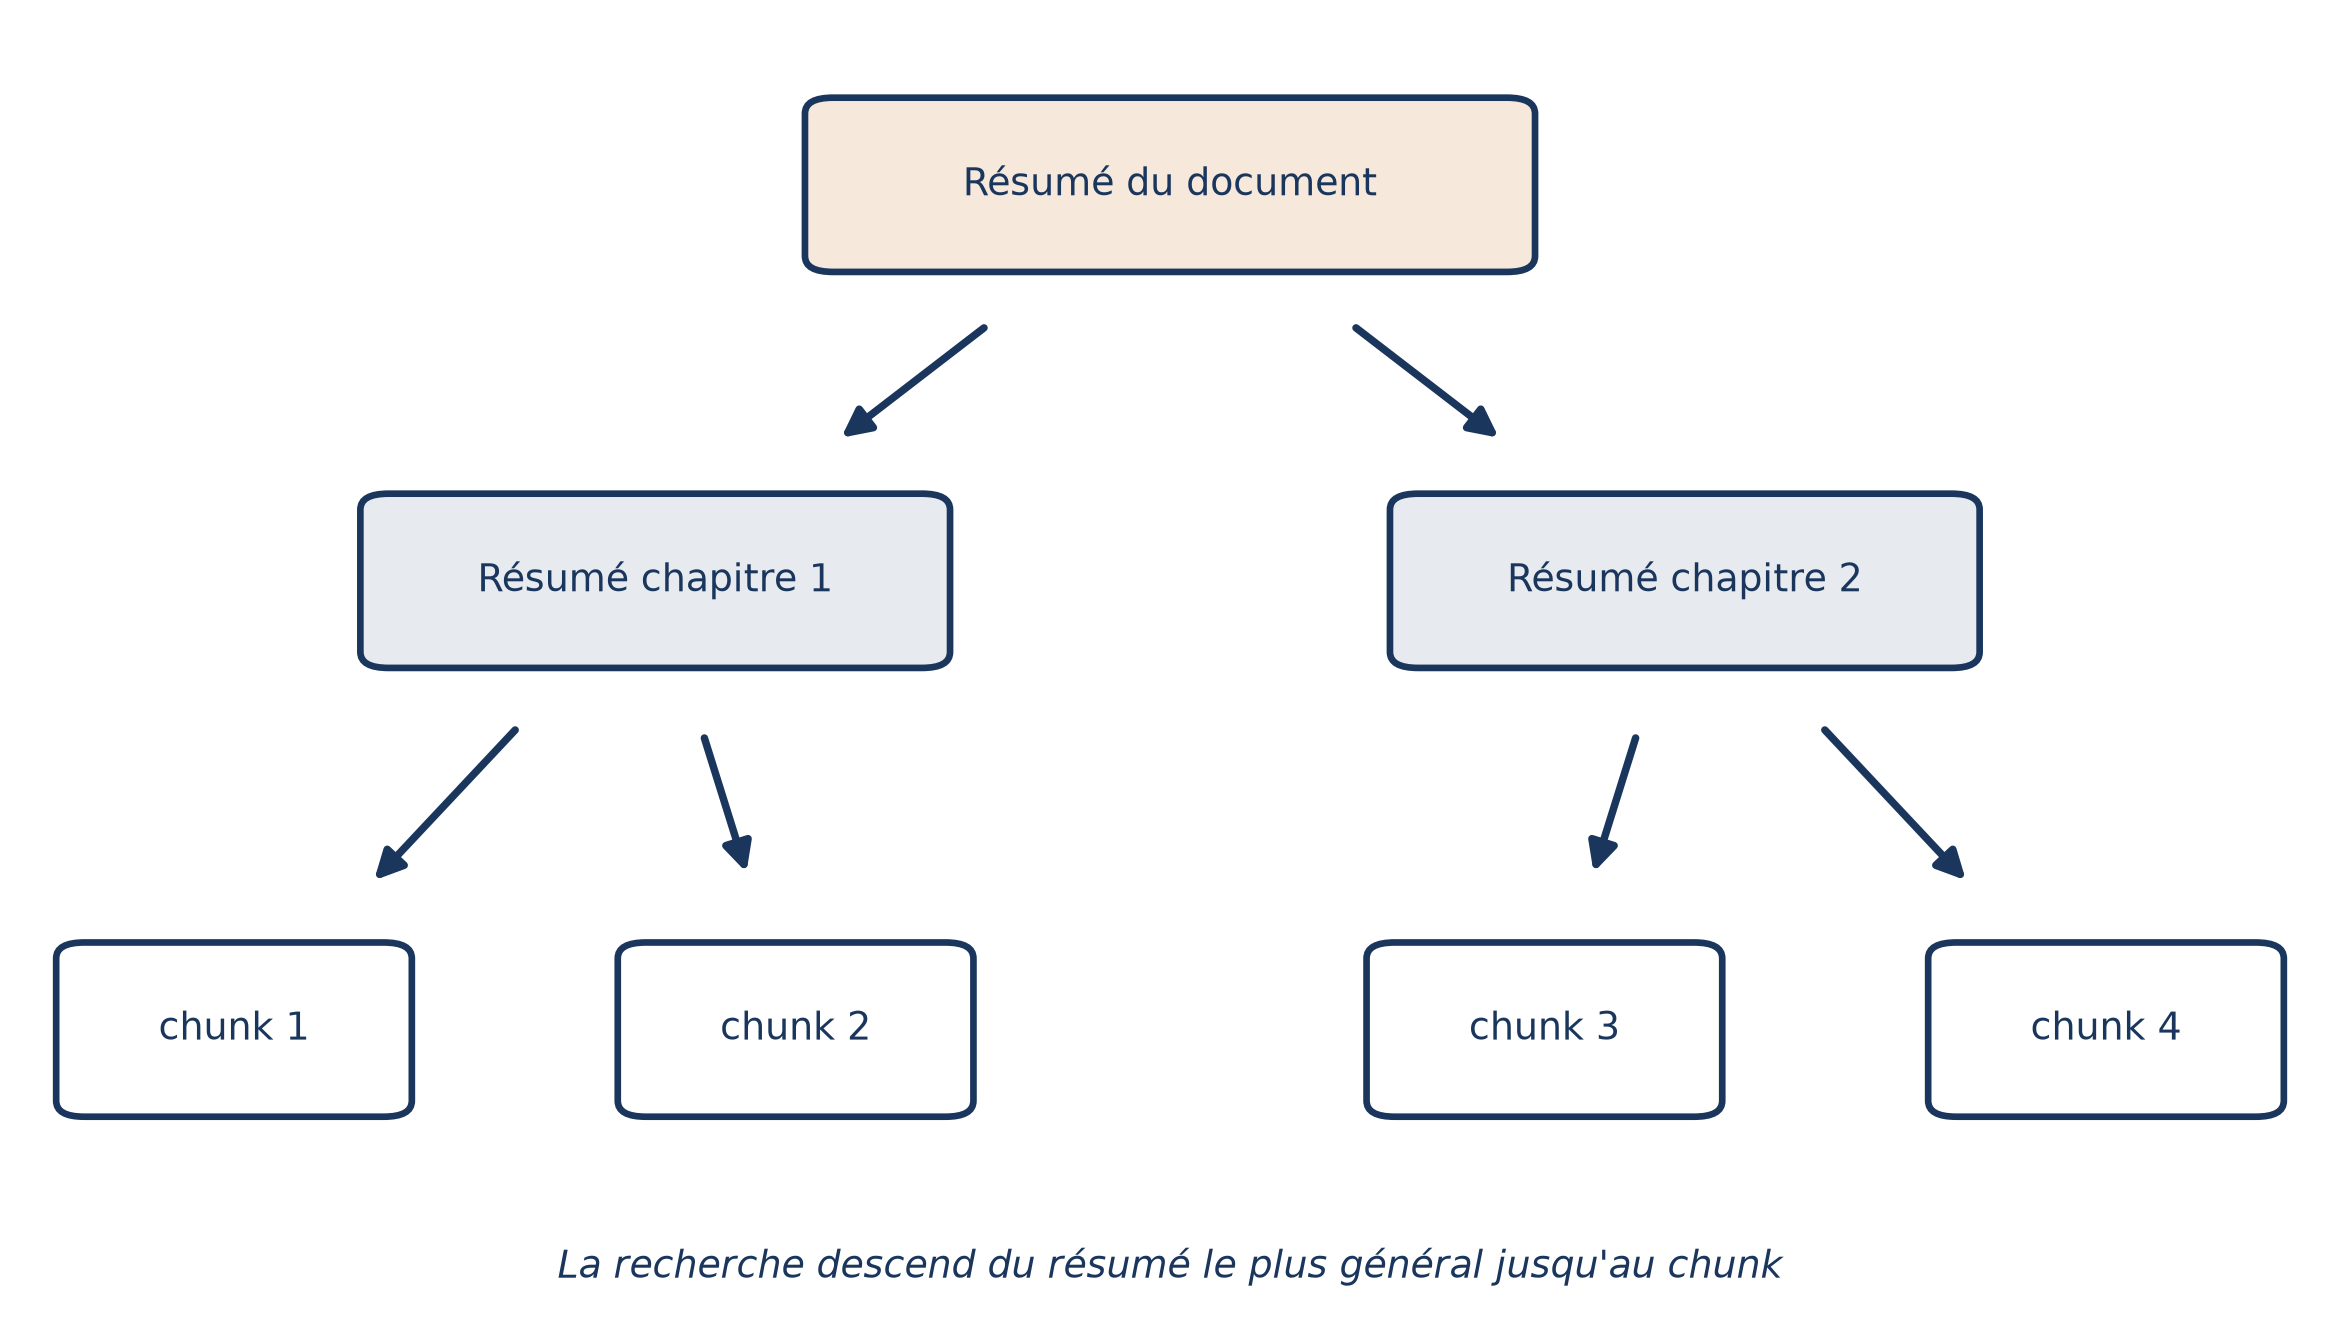
💡 Intuition C’est le zoom d’une carte : on repère d’abord le pays, puis la ville, puis la rue. Chaque résumé est un niveau de zoom, et les métadonnées sont les liens qui permettent de descendre d’un niveau à l’autre.
Trois variantes existent. On peut rendre le résumé spécifique au type de fichier (HTML, PDF, dépôt de code). Quand le document dépasse ce que le LLM résumeur peut lire, le map-reduce résume d’abord les parties, puis résume les résumés. Et si le document brasse trop de sujets, on écrit plusieurs résumés par document, par exemple un par tranche de 10 000 jetons ou de 10 pages.
Indexer des questions plutôt que des réponses
Dernière idée : rapprocher les fragments des questions qu’on va poser. Un LLM génère une ou plusieurs questions hypothétiques pour chaque fragment ; on plonge ces questions, pas les fragments. À l’arrivée d’une vraie requête, on cherche les questions les plus proches, puis on remonte au fragment d’origine grâce aux métadonnées.
Le réglage est simple : davantage de questions par fragment, c’est plus de précision et plus de calcul. Et tu n’as pas besoin de garder le texte des questions, seulement leurs vecteurs, pourvu qu’on puisse les rattacher à leur fragment.
Aiguiller chaque question vers la bonne base
Reviens au chatbot du groupe. Ses utilisateurs l’interrogent sur leurs comptes et transactions (banque), leurs polices et sinistres (assurance), leurs conseils et placements (finance). Chercher dans toutes les bases à chaque requête serait inefficace et créerait de la latence et des résultats hors sujet.
Il y a plus grave : pour des raisons de réglementation et de vie privée, on veut empêcher le chatbot de chercher dans les détails d’un client d’un autre service. Un routeur règle les deux problèmes en décidant, avant toute recherche, vers quelle base partira la question.
⚠️ Piège Ici, la route ne sert pas seulement à aller plus vite : elle décide aussi de ce que le système a le droit de lire. Un routeur mal réglé est donc un défaut de confidentialité autant que de performance.
Comment le routeur choisit-il ? Il existe plusieurs mécanismes : des règles logiques, des mots-clés, une classification zero-shot, un appel de fonction ou un routeur sémantique. Ce dernier garde une liste de requêtes d’exemple, chacune avec sa route ; ces exemples sont plongés et rangés dans une base. Dès qu’une question arrive, on retient la route de l’exemple qui lui ressemble le plus.
Après la recherche : le contexte est un budget
Quand les fragments reviennent, le travail n’est pas fini. Le LLM a une fenêtre limitée et gère mal une grande quantité d’information ; il faut donc décider quoi lui donner, dans quel ordre et sous quelle forme.
Trier : un modèle qui lit la question et le fragment ensemble
Le re-classement réordonne les fragments retrouvés avant de les passer au LLM. Voici une version complète, avec un modèle BERT pré-entraîné.
def rerank_documents(query, documents):
    """
    Reranks the retrieved documents based on their relevance to the
query using a pre-trained
    BERT model.
    Args:
        query (str): The user's query.
        documents (list): A list of documents retrieved from the
search.
    Returns:
        list: A list of reranked documents, sorted by relevance.
    """
    inputs = [rerank_tokenizer.encode_plus(query, doc, return_
tensors='pt', truncation=True, padding=True) for doc in documents]
    scores = []
    for input in inputs:
        outputs = rerank_model(**input)
        logits = outputs.logits
        probabilities = F.softmax(logits, dim=1)
        positive_class_probability = probabilities[:, 1].item()
        scores.append(positive_class_probability)
    ranked_docs = sorted(zip(documents, scores), key=lambda x: x[1],
reverse=True)
    return [doc for doc, score in ranked_docs]
rerank_tokenizer et rerank_model sont le tokenizer et le modèle BERT, chargés avant l’appel. Pour chaque document, encode_plus fabrique une seule entrée : requête et document, tronquée si elle est trop longue. Le modèle en tire des scores bruts, que softmax transforme en probabilités ; celle de la classe positive devient le score de pertinence. sorted range les documents du plus au moins pertinent, et la fonction rend les documents seuls.
Ordonner : le milieu du contexte est mal exploité
Une étude de 2023 montre que le LLM donne ses meilleurs résultats quand l’information importante se situe au début ou à la fin du contexte. Au milieu, la performance baisse, surtout si le contexte est long.
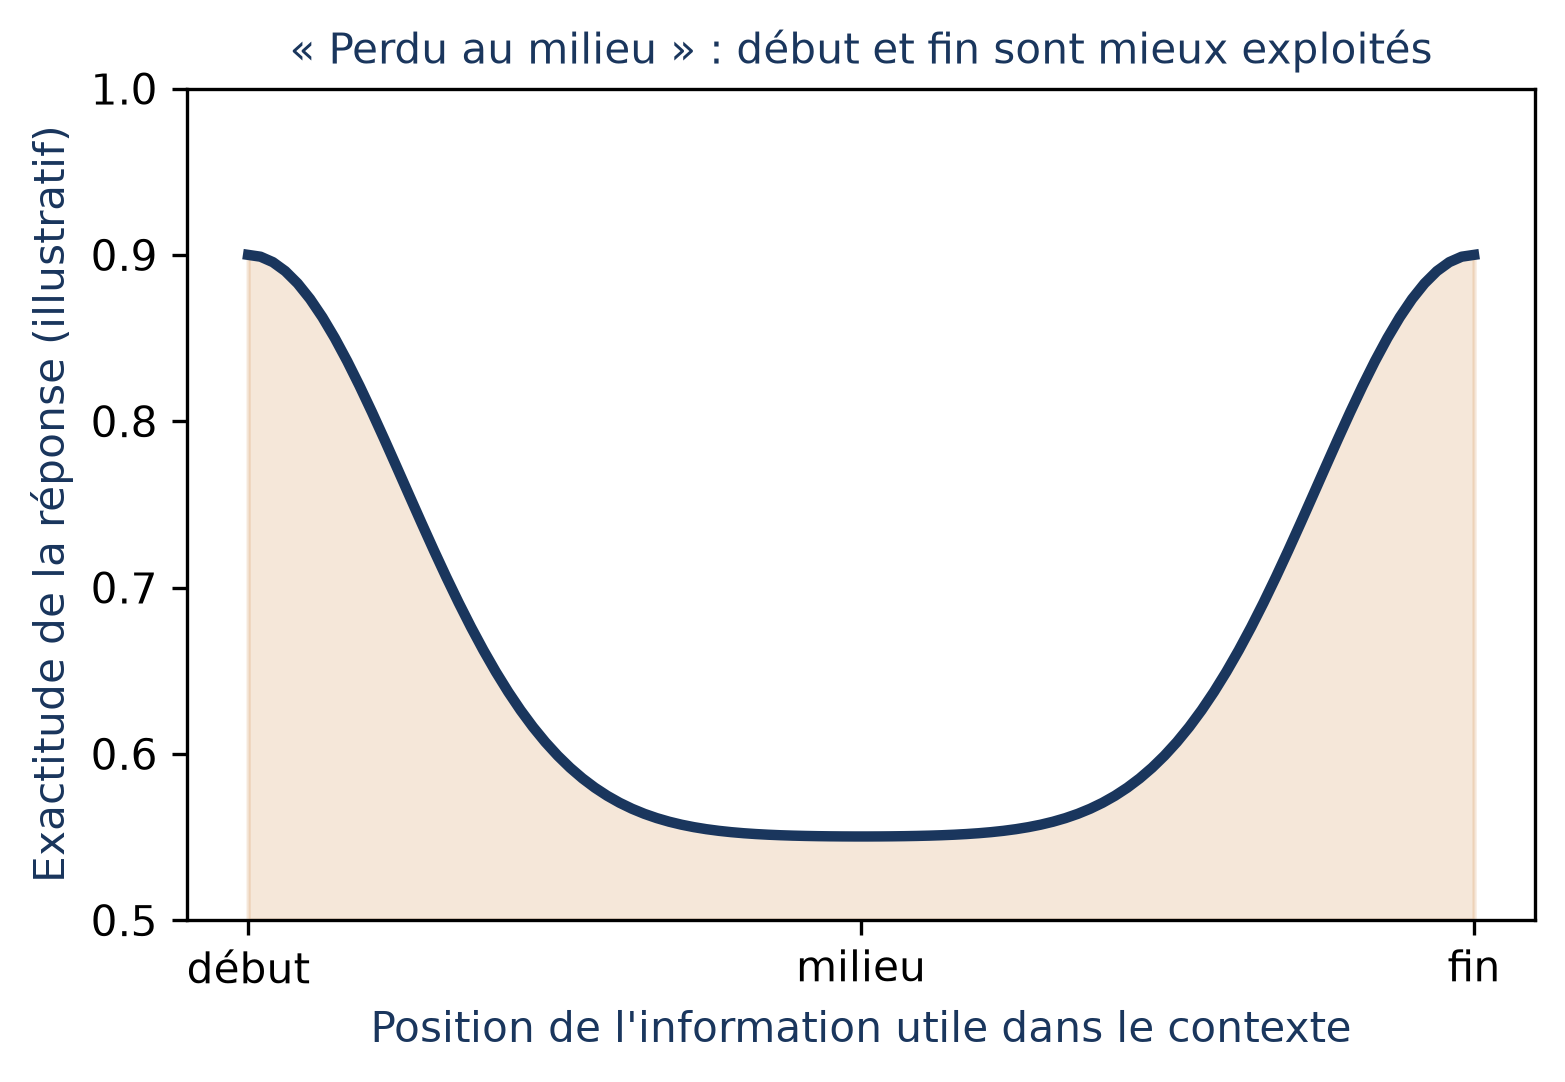
D’où l’idée de réordonner, soit par ordre de pertinence, soit en motif alterné : les fragments d’indice pair en tête de liste, ceux d’indice impair en queue. Les plus pertinents se retrouvent aux deux extrémités, les moins pertinents au milieu, ce qui sert surtout avec un grand top-k.
Comprimer : retirer ce que le modèle devinerait
Le contexte contient souvent des informations sans rapport avec la requête, voire des répétitions. Et la plupart des mots d’une phrase pourraient être prédits par ce qui les entoure : ils n’apportent rien au LLM. La compression contextuelle garde l’utile et économise du calcul, ou de l’argent si tu passes par une API.
Trois stratégies :
- le filtrage du contexte : un LLM attribue une valeur d’information à chaque jeton (dans quelle mesure il s’attendait à le voir), on les classe par ordre décroissant et l’on ne garde que ceux du premier centile p ;
- LongLLMLingua, fondé sur la même idée d’entropie, mais attentif à la question posée : il comprime dynamiquement et réordonne les documents ;
- les autocompresseurs, qui résument un long texte en vecteurs de résumé servant de soft prompts ; les poids du LLM restent gelés et seuls des jetons entraînables sont ajoutés au prompt.
La version la plus simple demande à un LLM de résumer chaque fragment, avec une longueur maximale pour ne pas perdre trop d’information.
Prouver et synthétiser
Garder la trace des sources n’est pas une technique d’amélioration, mais c’est fortement recommandé, surtout quand la réponse mêle plusieurs sources. Il suffit de conserver les documents associés aux fragments utilisés, ou de les mentionner dans le prompt. Plus sophistiqué : le moteur de requête à citation floue, qui apparie la réponse générée aux fragments retrouvés par correspondance floue (n-grammes puis TF-IDF).
Reste la dernière marche, le synthétiseur de réponse. Sa version de base concatène prompt, contexte et requête. Les versions plus fines multiplient les appels au LLM : raffiner la réponse fragment après fragment, fusionner plusieurs réponses issues de fragments différents, ou résumer hiérarchiquement jusqu’à une réponse unique. La qualité monte, mais elles exigent bien plus d’appels au LLM : c’est coûteux en calcul comme en argent.
Empiler les techniques : l’idée reçue qui coûte cher
Face à cette liste, la tentation est de tout brancher. Or peu d’études de référence ont mesuré avec rigueur le rapport entre performance et coût de calcul. L’une des plus récentes, de 2024, signée Wang, donne tout de même des repères.
| Module | Ce que l’étude observe |
|---|---|
| Reranking | Il augmente le coût, mais son absence entraîne une baisse sensible |
| Résumé du contexte | Il aide à atteindre l’exactitude optimale ; son coût se justifie si la latence n’est pas un problème |
| HyDE | Meilleur score de performance, mais un coût de calcul notable qui ne justifie pas l’amélioration |
La meilleure performance vient d’une combinaison : classification des requêtes, HyDE, reranking, reconditionnement du contexte et résumé. Si c’est trop lourd en calcul ou en latence, mieux vaut écarter HyDE et garder les autres modules, en choisissant des variantes moins chères, par exemple un reranker avec moins de paramètres.
Le coût varie aussi d’une variante à l’autre pour un même module. Parmi les rerankers, les multi-vecteurs ont le coût de calcul le plus faible et une performance discrète ; ceux qui s’appuient sur un LLM peuvent être les meilleurs, mais à un coût élevé.
📌 À retenir Un module ne se juge pas à ce qu’il promet, mais à ce qu’il rapporte pour ce qu’il coûte. Comme certaines de ces techniques sont complexes, teste-les et mesure-les avant la mise en production.
Passer à l’échelle : volume, doublons et parallélisme
Un prototype indexe quelques documents. Une organisation qui veut appliquer le RAG à de grandes masses de données se heurte au volume, à la vitesse et à la variété.
La variété d’abord. Dans un PDF, le découpage peut séparer un tableau en plusieurs fragments, ce qui rend la récupération inefficace, et les tableaux compliquent la recherche de similarité. Une alternative : extraire les tableaux pour les transformer en texte, ou les ranger dans une base compatible, comme une base SQL.
Le volume ensuite. Plus la base grossit, plus les doublons s’y multiplient : le risque de duplication augmente linéairement avec le volume. Trouvés au moment de la génération, ils risquent de produire des sorties inexactes, biaisées ou de mauvaise qualité ; la correspondance floue et la déduplication par hachage permettent de les éliminer.
Reste la vitesse. Pour les gros volumes, on s’appuie sur des méthodes d’indexation spécialisées (Apache Lucene, Elasticsearch), on met en cache les données les plus utilisées et l’on distribue la récupération pour réduire les goulots d’étranglement quand les utilisateurs sont nombreux.
Le traitement parallèle réduit notablement la latence, même avec de grands jeux de données ; Apache Spark et Dask comptent parmi les solutions les plus utilisées. Il touche trois étapes. Au stockage, chaque nœud peut exécuter tout le pipeline de prétraitement, jusqu’à l’embedding, sur une partie des données. À la récupération, moins intuitif, on peut répartir le jeu de données entre les nœuds, chacun cherchant dans sa partition. La génération se parallélise aussi, parce que le Transformer a été conçu pour paralléliser l’entraînement comme l’inférence.
⚠️ Piège Paralléliser a ses propres difficultés et un risque d’erreurs. Il faut superviser le système, prévoir une tolérance aux pannes (points de sauvegarde) et un ordonnancement dynamique des tâches, et surveiller non seulement l’exactitude, mais aussi la mémoire, les coûts et l’usage du réseau.
Avec des API externes, les erreurs d’exécution arrivent : il est bon de prévoir des modèles de repli. Un routeur de LLM peut même diriger chaque requête vers le modèle qui convient le mieux à un prompt donné, selon la précision attendue ou le coût.
Un vecteur n’est pas un coffre-fort
Dernière idée reçue, et la plus dangereuse : les vecteurs ressemblent à de simples nombres, donc ils ne garderaient que le sens du texte et protégeraient les données sensibles. C’est faux. L’embedding est une compression avec perte, ce qui n’empêche pas de le décoder : dans certaines études, on a retrouvé plus de 70 % des mots du texte d’origine, sans technique extrêmement sophistiquée.
Dans une attaque par inversion d’embedding, on acquiert les vecteurs, puis on les décode. Les vecteurs se protègent donc comme le texte lui-même. D’autres attaques visent le reste du système :
- l’injection de prompt glisse des instructions malveillantes dans ce qui ressemble à un prompt légitime ;
- l’empoisonnement introduit des données erronées que le LLM utilisera ensuite pour générer des sorties faussées ;
- l’inférence d’appartenance cherche à savoir si une donnée figure dans la base : si elle y est, elle sera probablement retrouvée pour une requête donnée, puis insérée dans le contexte, d’où l’on peut tenter de l’extraire.
Les protections existent : chiffrement (AES-256, TLS/SSL), gestion rigoureuse des clés, authentification multifacteur, supervision des intrusions, respect du RGPD et du CCPA, confidentialité différentielle, calcul multipartite sécurisé, tests de robustesse avant déploiement. Mais de nouvelles méthodes d’attaque sont décrites en permanence, et les précautions deviennent vite obsolètes.
📌 À retenir Un RAG avancé n’est pas un RAG qu’on charge de modules : c’est un RAG dont chaque ajout répond à une panne précise et à un budget de latence et de coût. Devant chaque brique, demande-toi quelle étape elle répare et ce qu’elle te prend en échange.