Pose cette question à un assistant : « Quels produits du catalogue sont recommandés par les mêmes célébrités ? » Aucun paragraphe, pris seul, ne contient la réponse : elle se trouve dans les liens entre des entités éparpillées dans tes documents. Un graphe de connaissances existe pour ce genre de question. À la fin de cet article, tu sauras le lire, comprendre comment on le fabrique et juger s’il vaut son prix.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi un paragraphe seul ne suffit pas
- Un tableau de faits que l’on dessine
- Nœuds, relations, propriétés : les pièces du graphe
- Le même graphe écrit en Cypher
- D’où viennent les triplets ?
- Ce que le graphe change quand on cherche
- Où on s’en sert
- Les limites à connaître avant de te lancer
L’essentiel en 30 secondes
- Un graphe de connaissances est un ensemble de faits en triplets (tête, relation, queue), comme (Napoléon, né à, Ajaccio).
- Les entités deviennent des nœuds, les relations des arêtes orientées, et chacun peut porter des propriétés (date, identifiant…).
- Un schéma, appelé ontologie, fixe les types d’entités et de relations autorisés.
- On le remplit en extrayant entités et relations d’un texte, aujourd’hui souvent grâce à un LLM.
- Il brille sur les questions à plusieurs sauts, mais sa construction et sa maintenance ont un coût réel.
Pourquoi un paragraphe seul ne suffit pas
La recherche par similarité vectorielle retrouve les passages dont le sens ressemble à ta question. Elle excelle pour un fait simple ou une question directe. Elle peine dès que la réponse exige de relier des informations dispersées dans plusieurs documents, ou de dégager des thèmes de haut niveau sur tout un jeu de données.
Un exemple : « Qu’a fait Geoffrey Hinton ? » Si aucun passage retrouvé ne couvre toutes ses actions, la réponse reste incomplète. Ajouter davantage de passages n’arrange rien : plus il y en a, plus l’information redondante s’accumule et plus la performance baisse.
Une autre lecture du problème : le texte mélange l’information utile et du bruit de fond. Pour certains chercheurs, ce qui compte, ce sont les entités présentes et leurs relations. On pense aux fiches de révision et aux cartes mentales, qui gardent l’essentiel et les liens entre les idées.
💡 Intuition Un graphe de connaissances, c’est la carte mentale d’un corpus : compacte, parcourue par des algorithmes, et lisible comme un ensemble d’entités reliées.
Un tableau de faits que l’on dessine
L’idée est née bien avant les LLM. Elle est entrée dans la recherche web en 2012, quand Google a commencé à ajouter des fiches de connaissances pour chaque concept recherché. Le terme désigne depuis tout graphe qui relie des entités par des relations porteuses de sens.
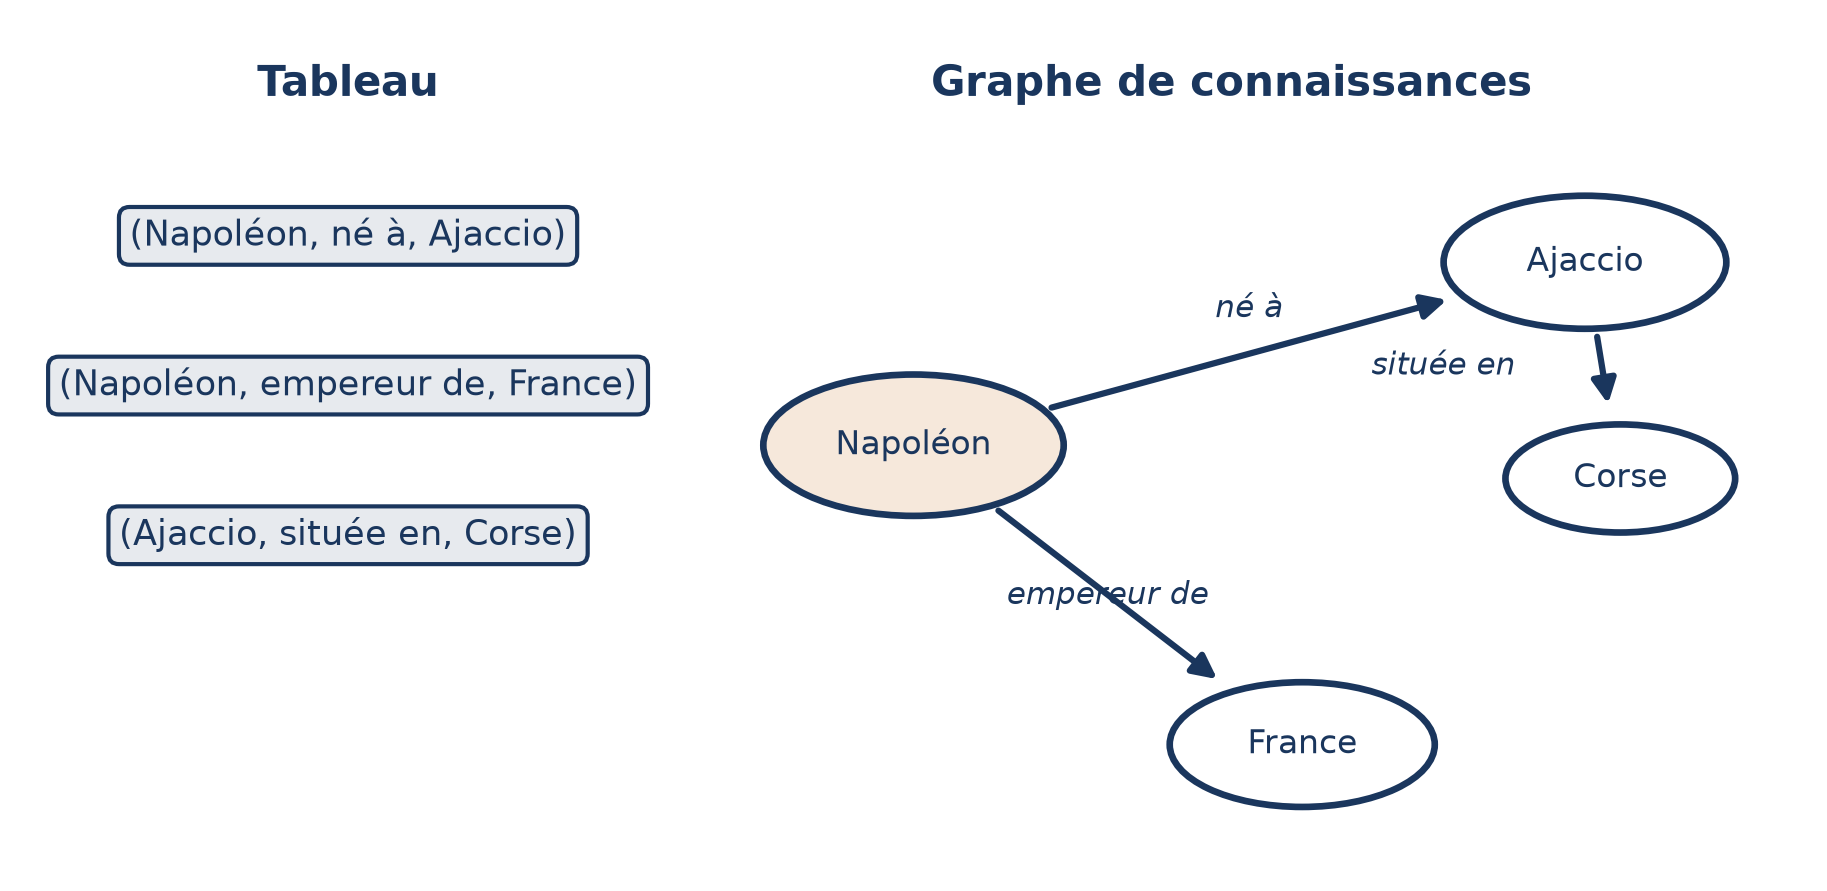
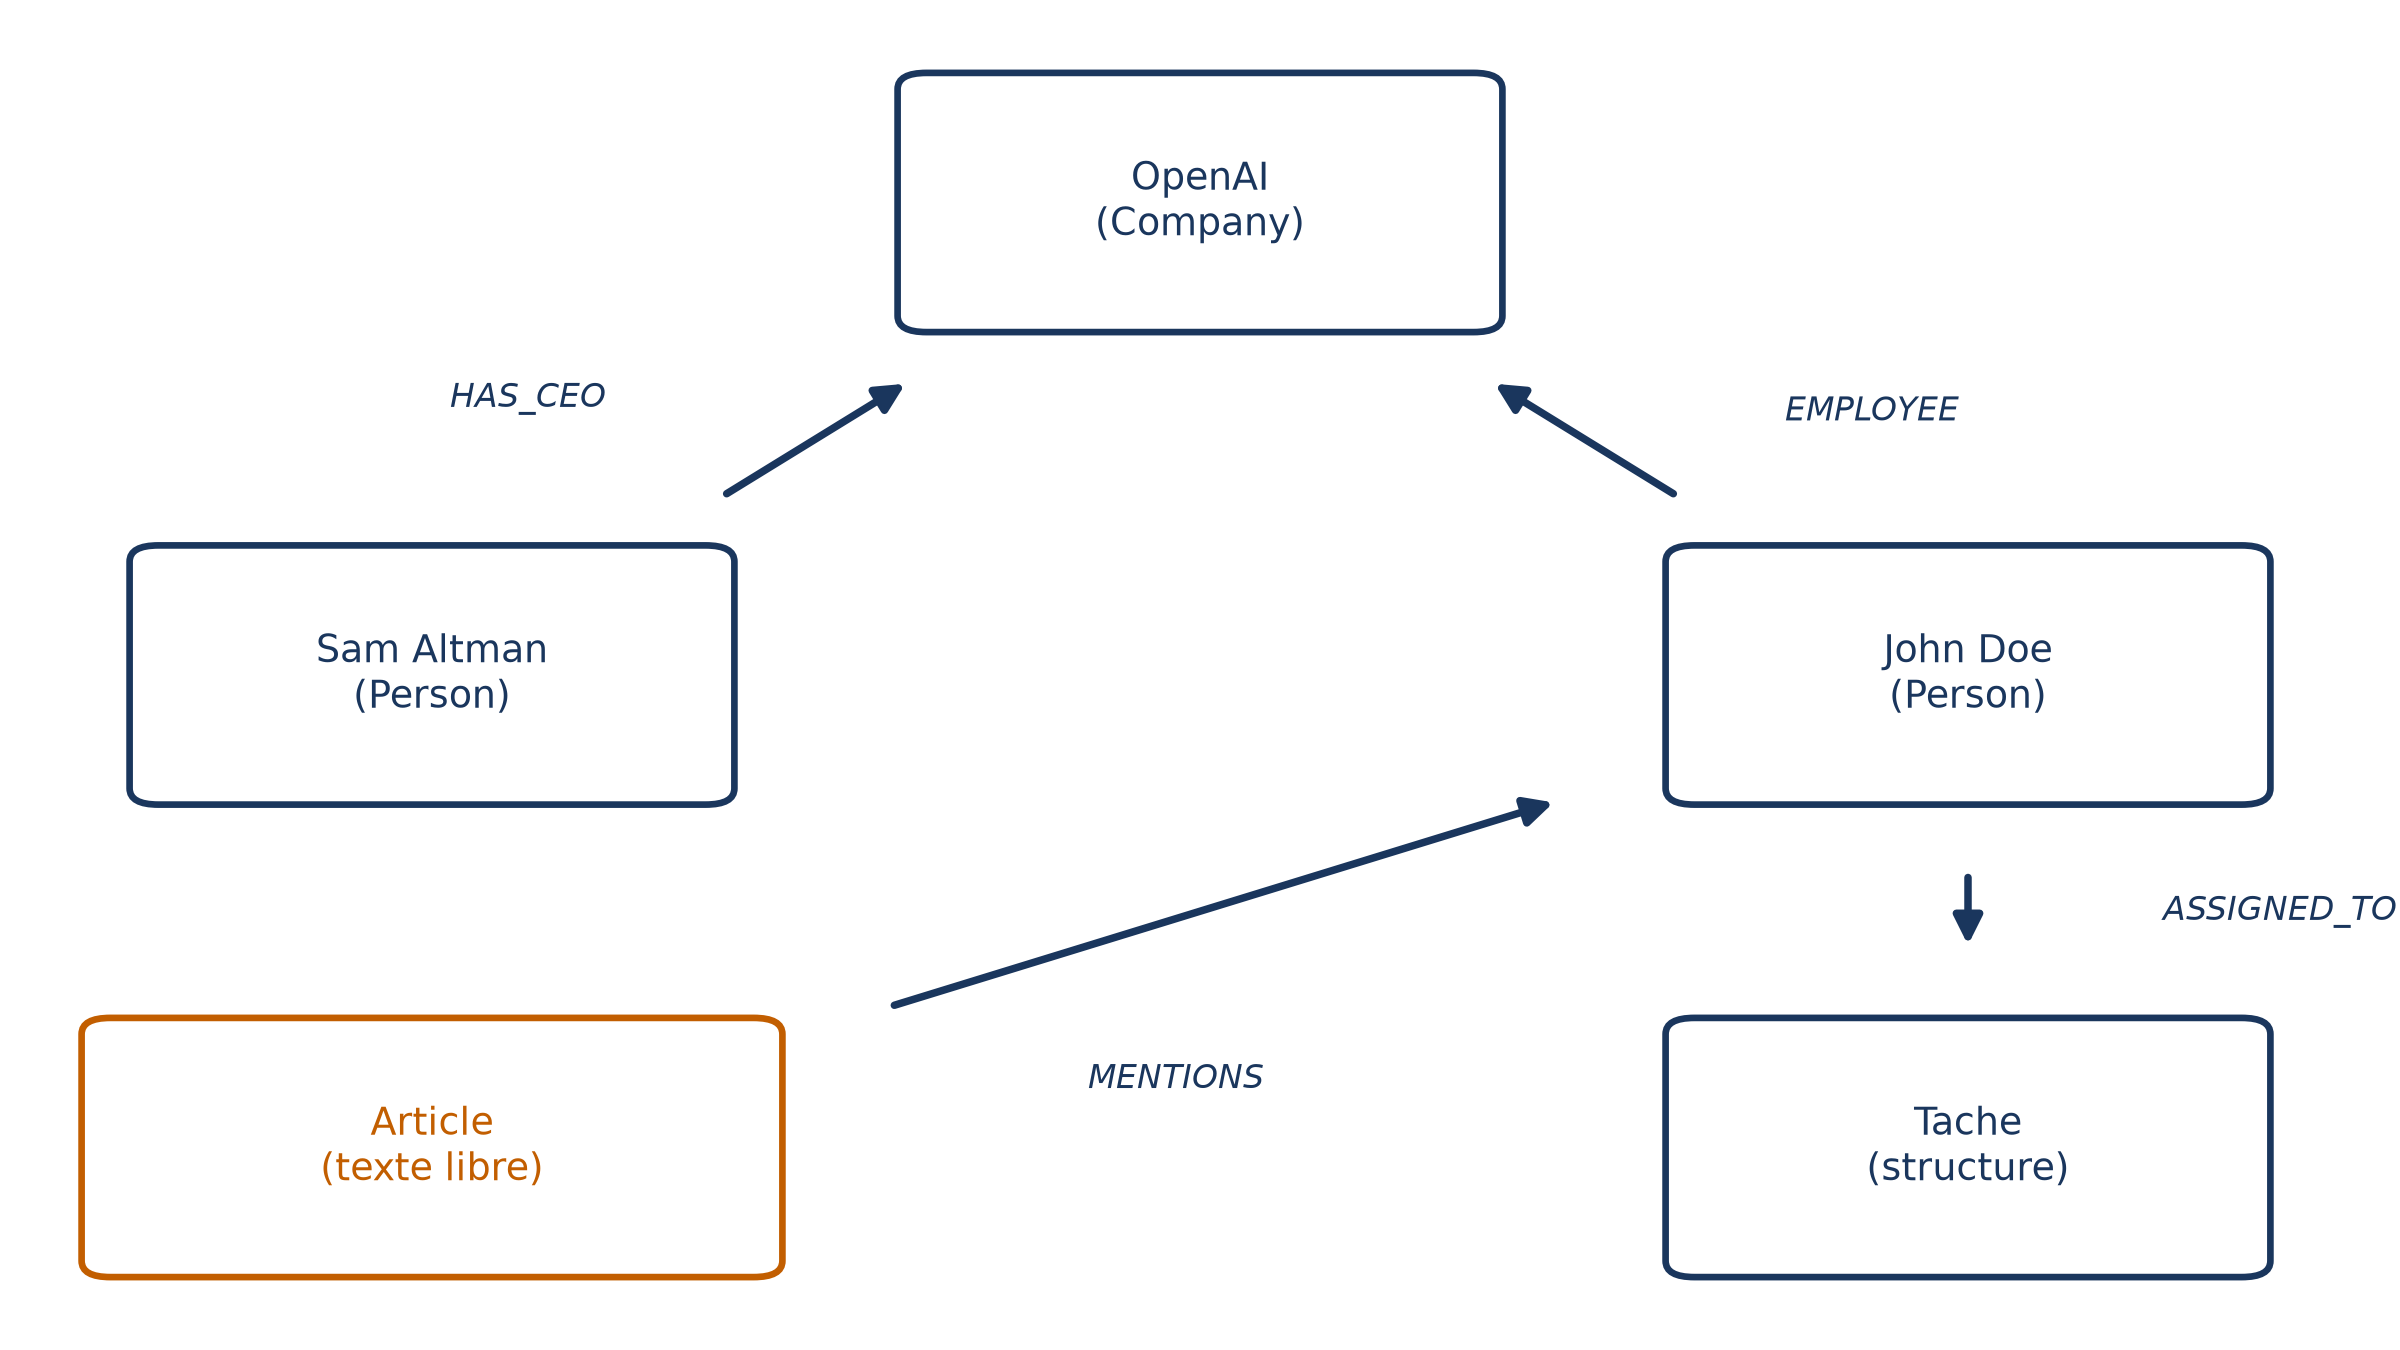
Le principe tient en une brique, le triplet : (tête, relation, queue), ou, dit autrement, (sujet, prédicat, objet). Par exemple (Napoléon, né à, Ajaccio). Un graphe de connaissances n’est rien d’autre qu’un ensemble de tels faits, vu comme un graphe orienté : les entités en sont les nœuds, les relations les arêtes.
En notation compacte, le graphe se définit ainsi :

Lis-la ainsi :  est formé d’un ensemble d’entités
 , d’un ensemble de relations
 et d’un ensemble de faits
 . Chaque fait
 est un triplet
 : une relation
 entre une entité de départ
 (la tête) et une entité d’arrivée
 (la queue).
Pourquoi ne pas garder un simple tableau ? Les mêmes données s’écrivent dans les deux formes, mais le graphe a des atouts. Quand une information manque pour une propriété, le tableau se remplit de valeurs vides, alors que le graphe n’a tout simplement pas l’arête. Fusionner deux graphes de triplets est très simple, alors que fusionner deux tableaux oblige à choisir les colonnes et à éviter les doublons.
Le graphe permet aussi de déduire des faits manquants. Si A est le mari de B et le père de C, une règle logique en tire que B est la mère de C : une relation absente est inférée à partir de relations présentes.
Nœuds, relations, propriétés : les pièces du graphe
Un graphe de connaissances se compose de trois sortes d’éléments. Les nœuds représentent des entités du monde réel : personnes, lieux, ou objets propres à un domaine (gènes, protéines, maladies, produits financiers). Les relations relient ces nœuds par un lien sémantique : une amitié entre deux personnes, ou l’association d’un gène à une maladie. Les propriétés décrivent nœuds et relations : une étiquette (« être humain »), une date de naissance, un identifiant.
Les relations ont un sens (une arête a un début et une fin) et peuvent porter un poids, qui exprime la force ou le coût du lien. Deux nœuds peuvent même être reliés par plusieurs relations à la fois.
Qui décide de ces types et de ces noms ? L’ontologie, colonne vertébrale du graphe : un schéma des types d’entités et des types de relations possibles. Pour un domaine spécialisé comme la finance ou la médecine, on peut partir d’ontologies déjà construites, ce qui assure une meilleure interopérabilité.
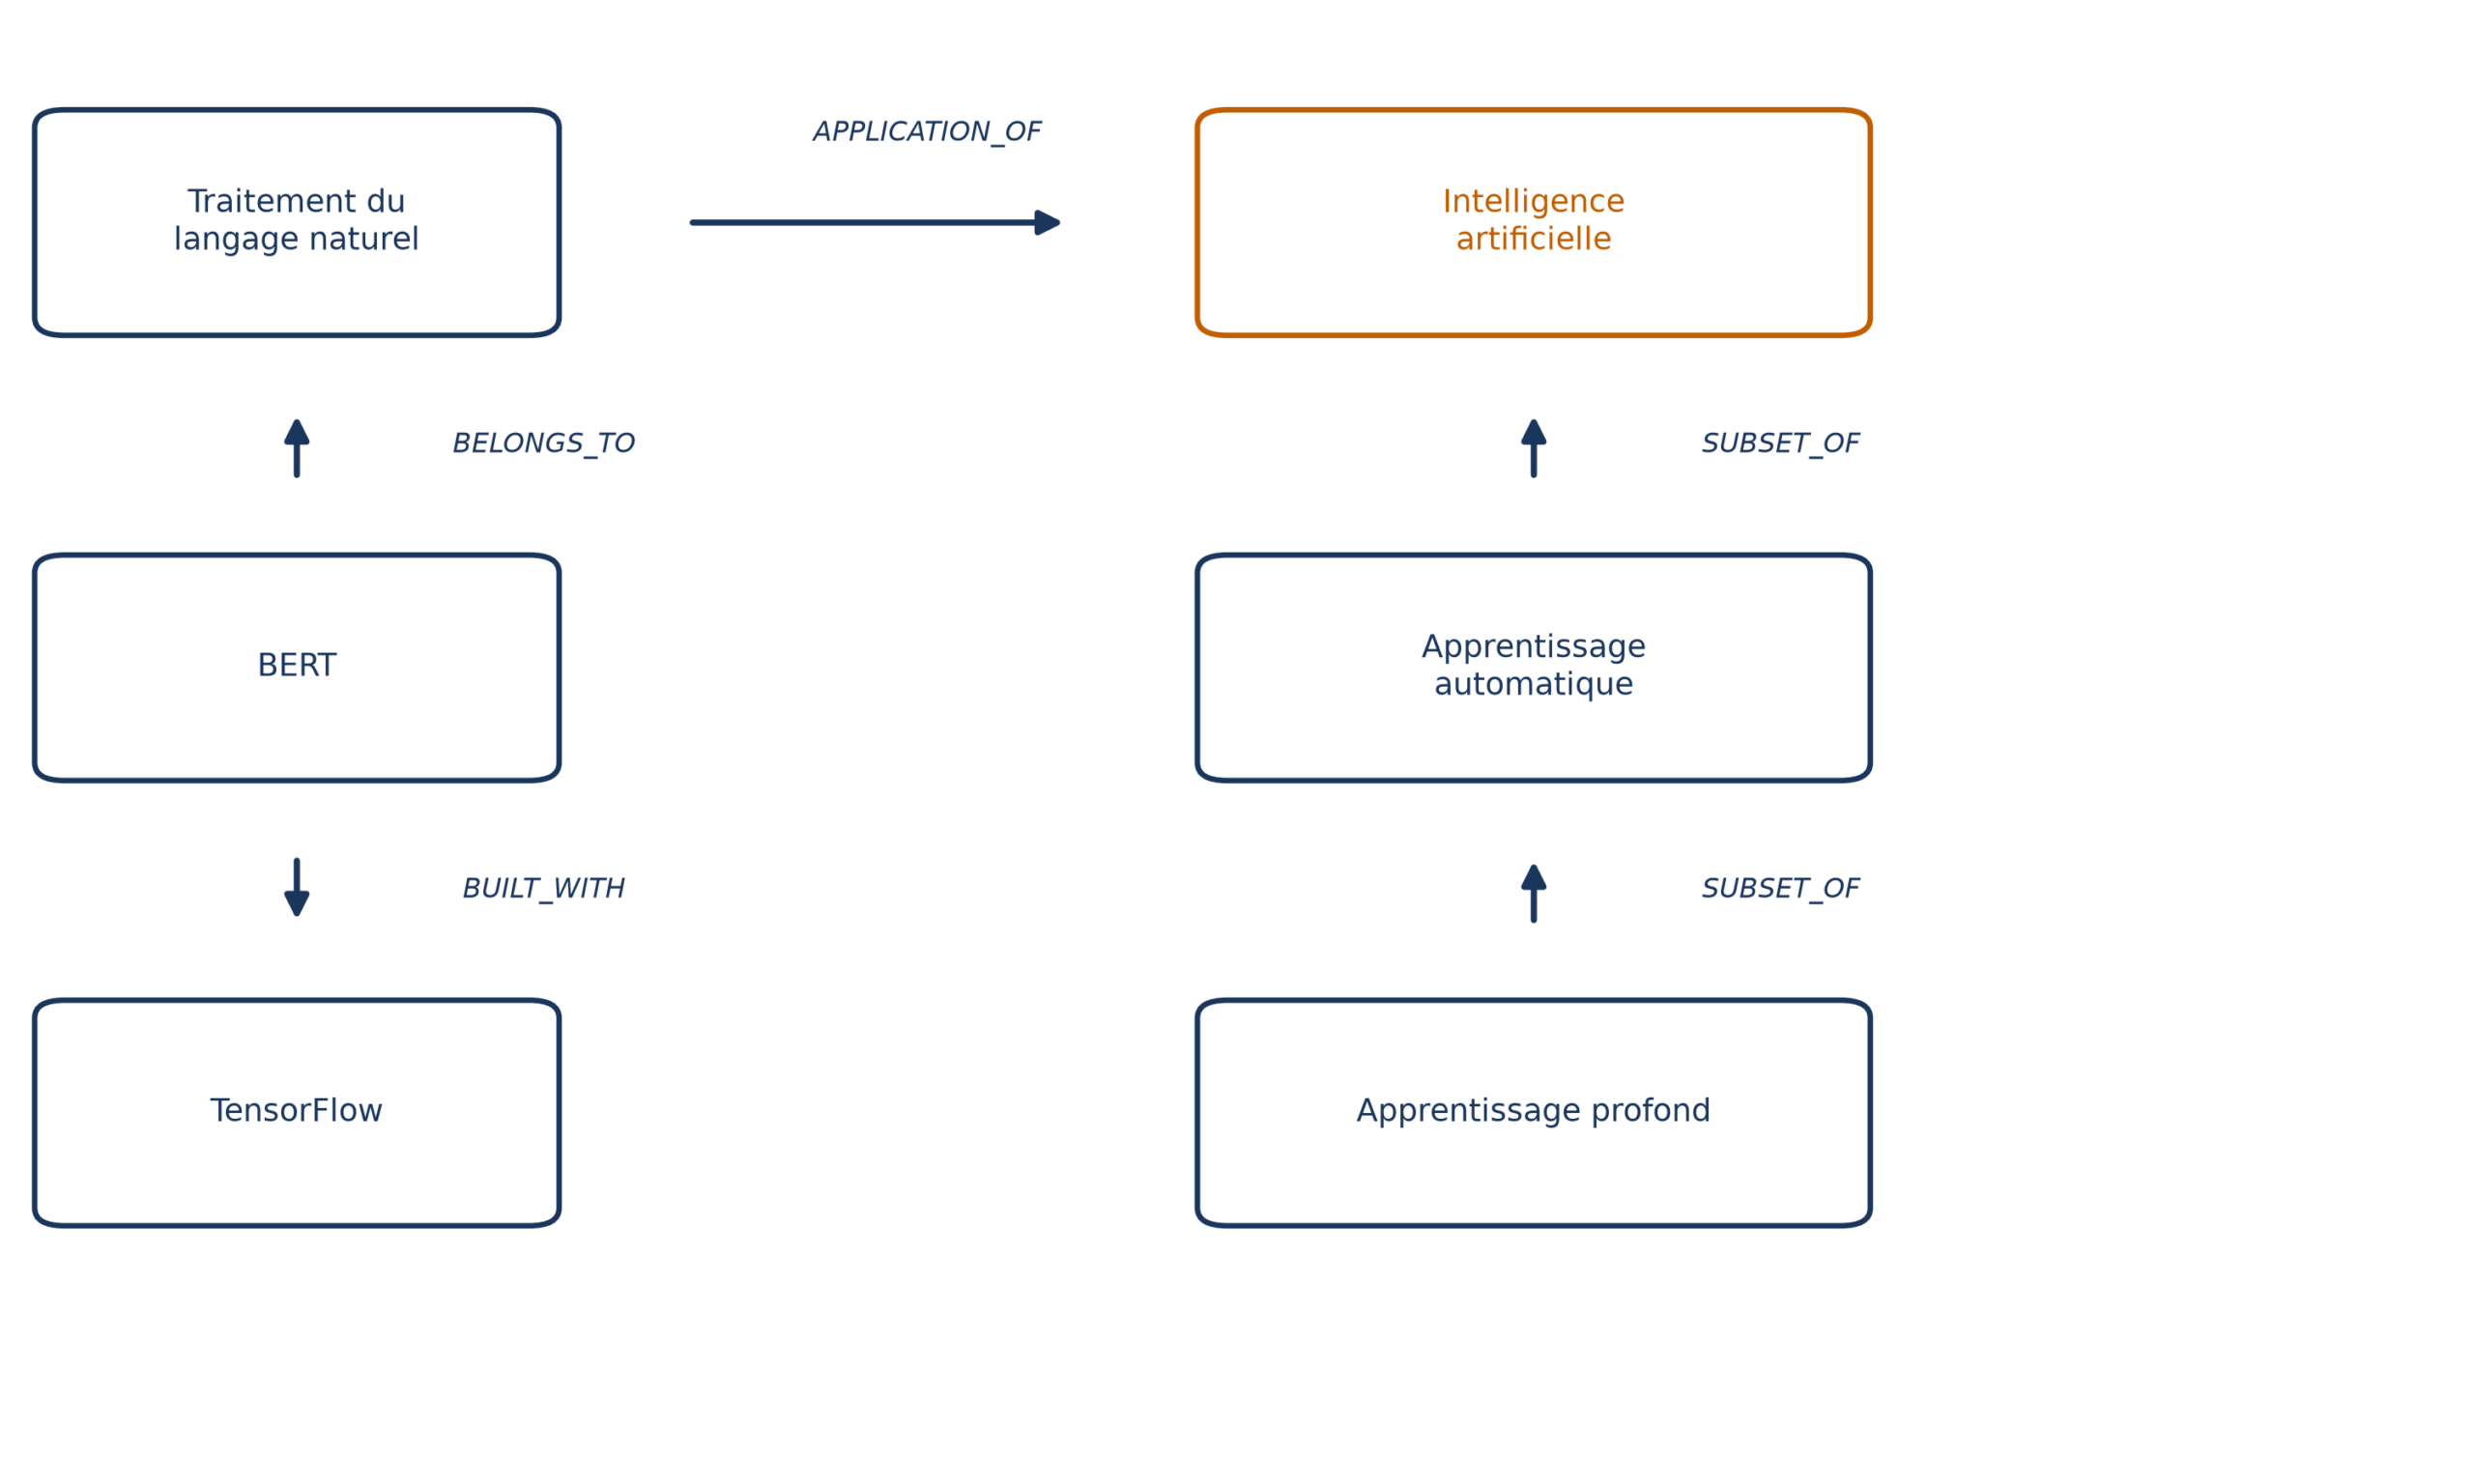
Un exemple de schéma, pour des contrats : trois types de nœuds, Contract (identifiant, type, dates, montant, portée), Organization (nom, rôle) et Location (ville, pays), reliés par HAS_PARTY et HAS_LOCATION. Les localisations forment des nœuds à part, car une même organisation peut avoir plusieurs adresses.
Le modèle de base s’étend aussi. Un graphe hiérarchique relie les entités d’un niveau à celles du niveau suivant, ce qui sert beaucoup avec les ontologies. Un nœud peut représenter une image, reliée à d’autres entités textuelles. Un graphe temporel ajoute une dimension de temps, utile à l’analyse prédictive.
Le même graphe écrit en Cypher
Un graphe de connaissances vit dans une base de données. Neo4j est l’une des plus utilisées : elle emploie Cypher, un langage de requête adapté à cette structure et vaguement proche de SQL. D’autres bases stockent directement des triplets, ou s’appellent Amazon Neptune et TigerGraph.
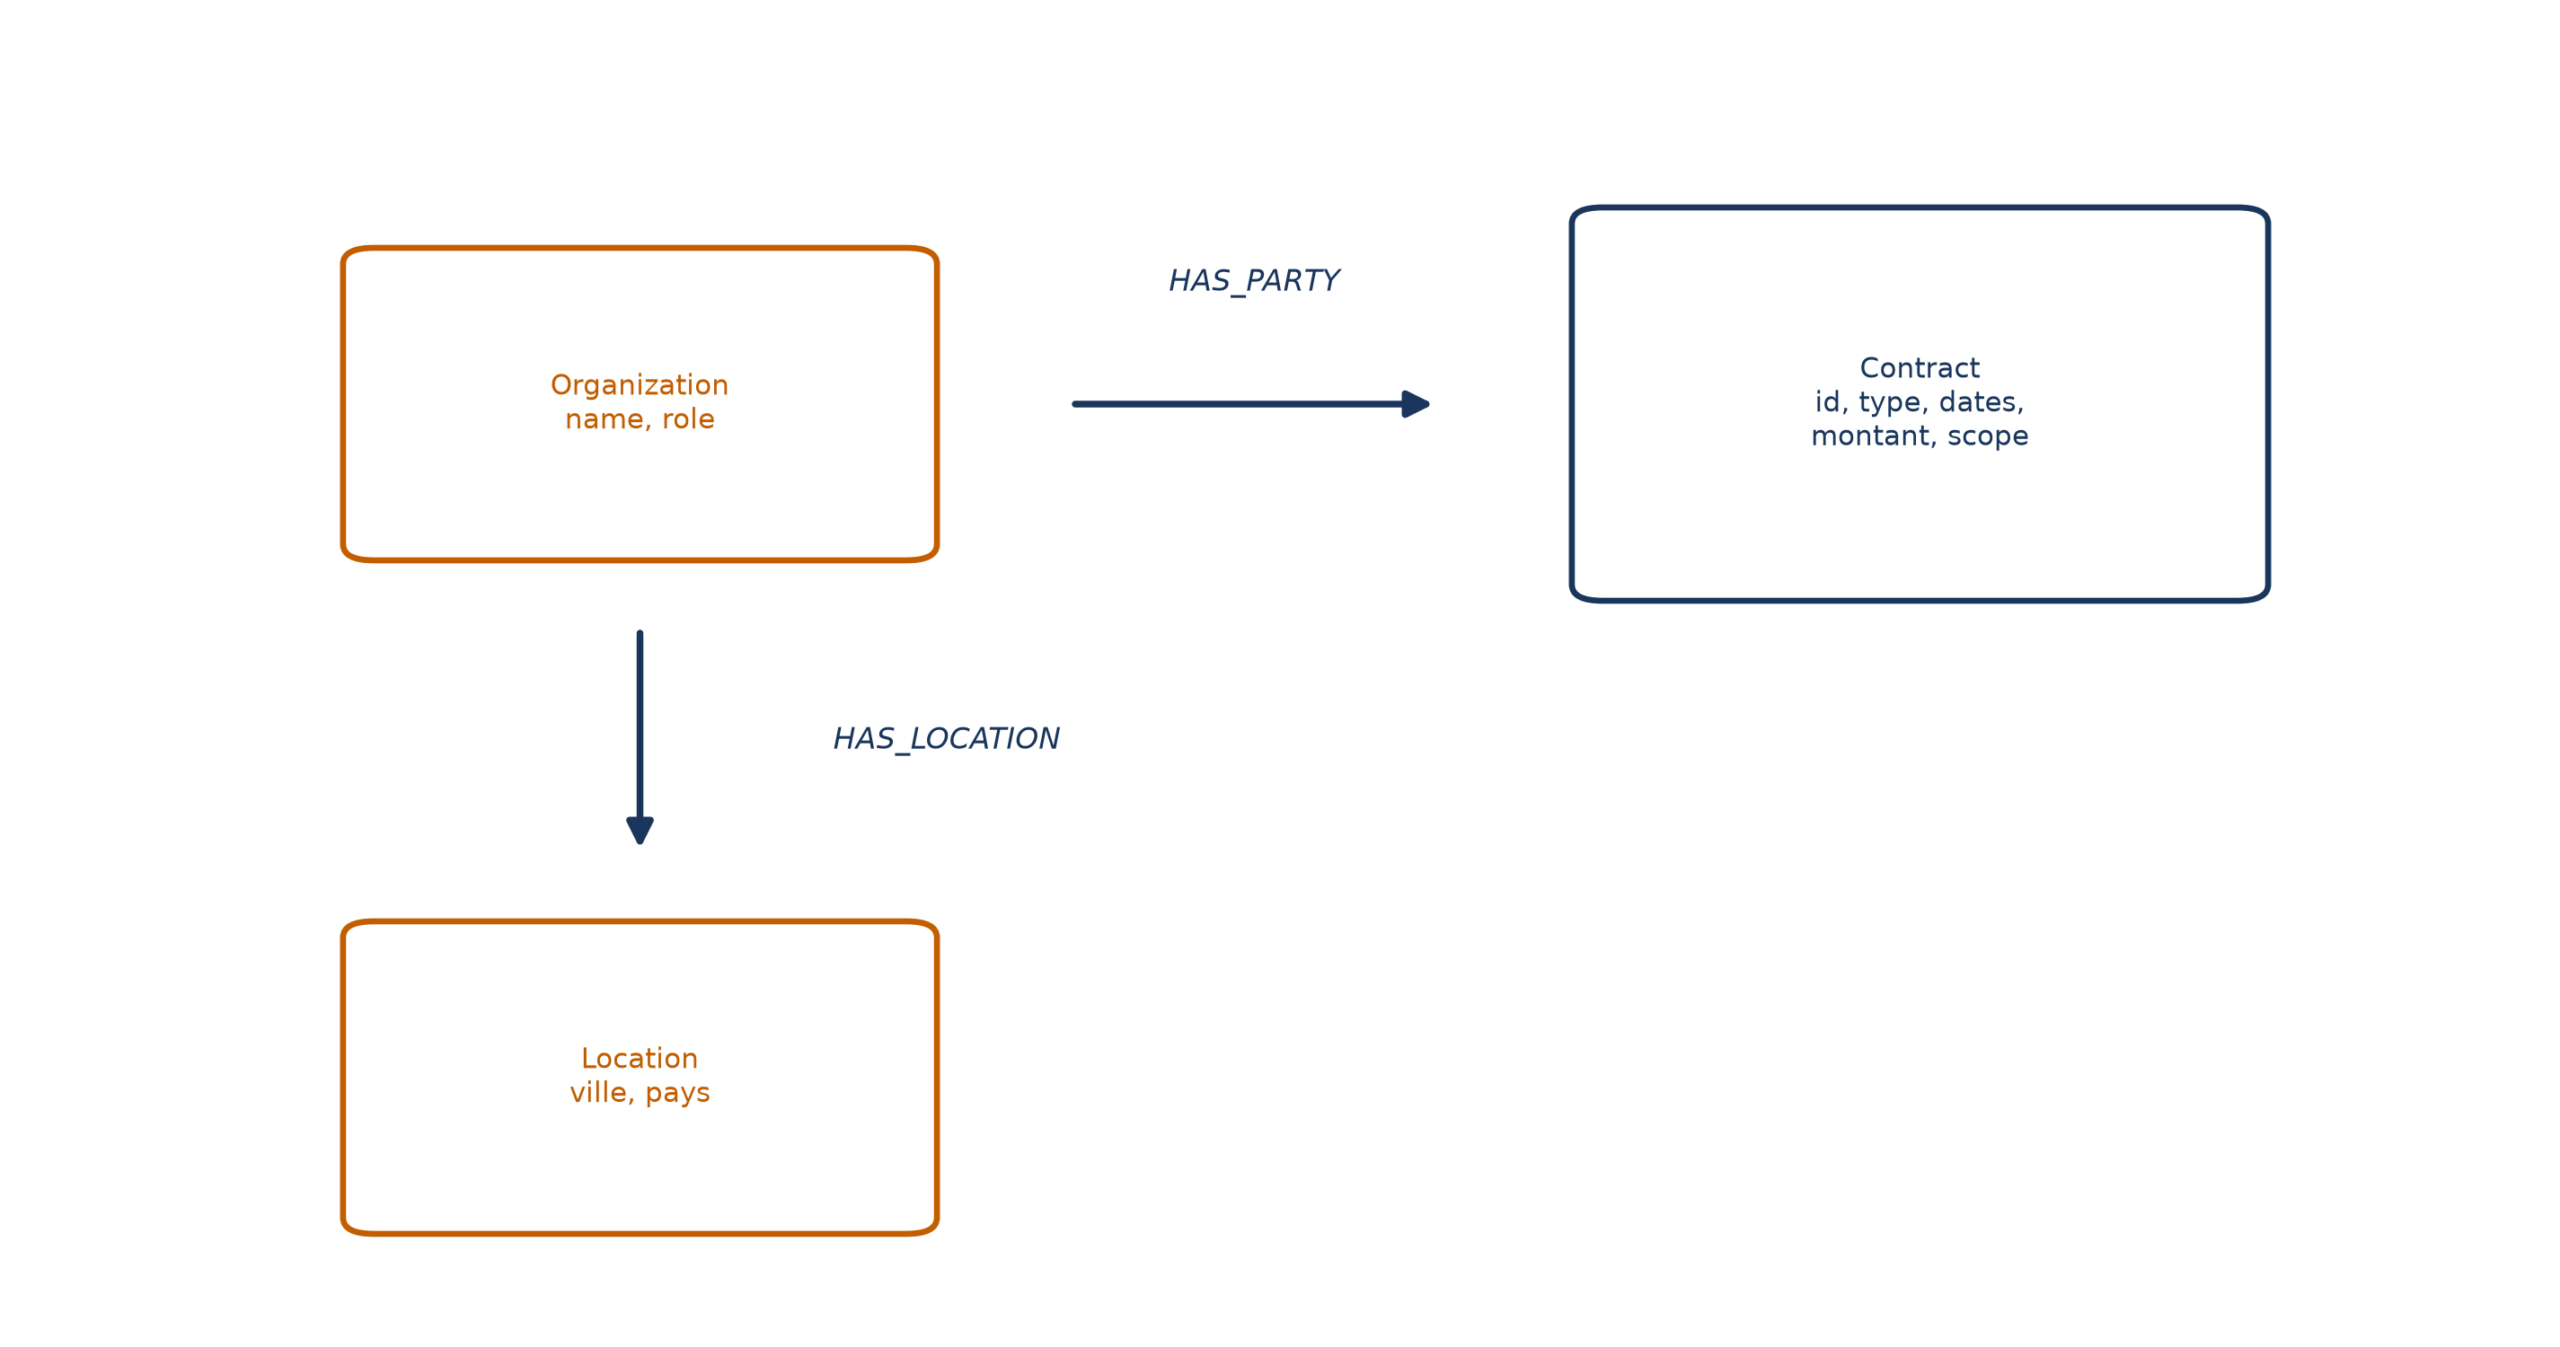
Une fois l’ontologie définie, on peuple le graphe avec la clause CREATE : on crée les nœuds avec leurs étiquettes et leurs propriétés, puis on les retrouve, puis on crée chaque relation dirigée séparément. Voici le petit graphe d’IA vu plus haut, en extrait :
// Create nodes for concepts and entities
CREATE (:Concept {name: 'Artificial Intelligence'});
CREATE (:Concept {name: 'Machine Learning'});
...
CREATE (:Model {name: 'BERT', year: 2018});
CREATE (:Model {name: 'ResNet', year: 2015});

// Create relationships between concepts
MATCH
  (ai:Concept {name:'Artificial Intelligence'}),
  (ml:Concept {name:'Machine Learning'})
CREATE (ml)-[:SUBSET_OF]->(ai);
Les deux premières lignes créent des nœuds étiquetés Concept, dotés d’une propriété name. MATCH retrouve deux nœuds par leur nom et CREATE (ml)-[:SUBSET_OF]->(ai) trace la flèche : exactement le triplet (apprentissage automatique, sous-ensemble de, intelligence artificielle).
Une fois les relations en place, une requête peut chercher le chemin le plus court entre deux concepts :
MATCH path = shortestPath(
  (concept1:Concept {name: 'Natural Language Processing'})-[*]-(concept2:Concept
      {name: 'Deep Learning'})
)
RETURN path;
Elle renvoie la chaîne de nœuds et de relations qui relie le traitement du langage naturel à l’apprentissage profond, en passant par l’intelligence artificielle et l’apprentissage automatique. Aucune similarité de texte ici : on suit des liens.
D’où viennent les triplets ?
On ne les écrit pas à la main : on les extrait de sources, textes, bases ou données structurées. Le chemin complet se fait en cinq étapes : création de l’ontologie avec extraction des entités et relations, évaluation de la qualité, nettoyage des erreurs et doublons, enrichissement par de nouvelles sources, déploiement dans une base de graphes.
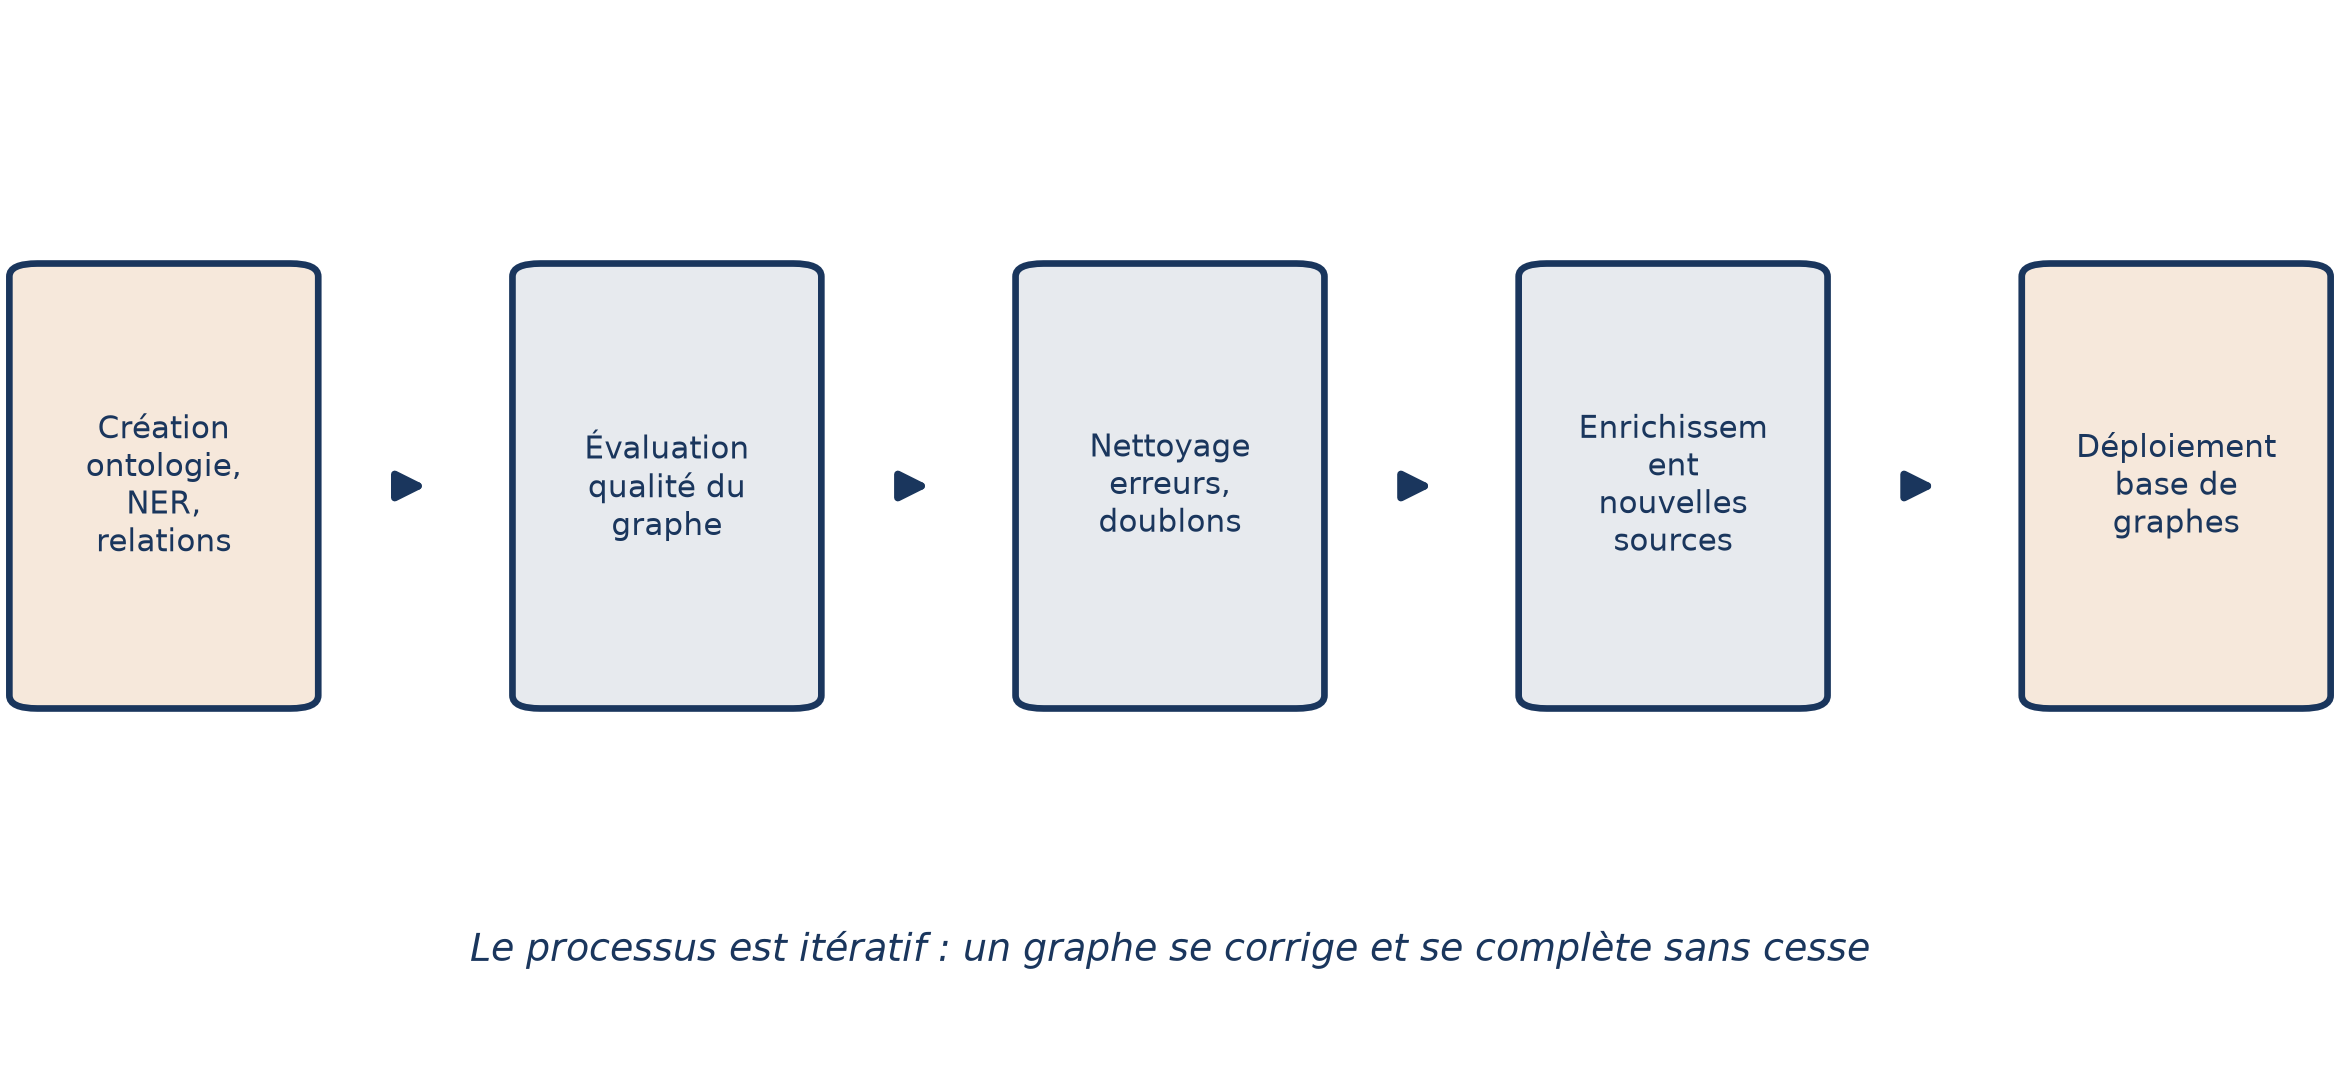
Le cœur du travail repose sur deux tâches. La reconnaissance d’entités nommées extrait les entités du texte et les classe (personne, organisation, lieu). L’extraction de relations identifie les liens entre elles : dans « Bob travaille chez Apple », on extrait la relation « travaille chez ».
La difficulté, c’est l’ambiguïté. « Apple » désigne-t-il le fruit ou l’entreprise ? En musique, le mot peut renvoyer à Apple Music, à un groupe de rock psychédélique britannique ou à la chanteuse Fiona Apple. Le contexte tranche.
Les méthodes ont évolué. Les plus anciennes reposaient sur des règles, par exemple des majuscules ou des titres de civilité : elles marchaient bien sur des documents standardisés mais passaient mal à l’échelle. Les méthodes statistiques et supervisées ont fait mieux, mais demandaient des étiquettes coûteuses, vite obsolètes quand apparaissent de nouvelles entreprises ou de nouveaux produits.
Aujourd’hui, un LLM peut extraire directement les entités du texte, sans étiquettes, et les rendre dans le format voulu : une liste de triplets, par exemple. Il peut mener l’extraction d’entités et de relations en une seule étape, à condition de soigner son prompt, qui précise la tâche et le format de sortie.
Des bibliothèques automatisent cette étape en quelques lignes :
from langchain_core.documents import Document
from langchain_experimental.graph_transformers import
LLMGraphTransformer
llm_transformer = LLMGraphTransformer(llm=llm)
documents = [Document(page_content=content)]
graph_documents = llm_transformer.convert_to_graph_
documents(documents)
Ici, llm est le modèle de langage que tu as déjà configuré et content le texte à transformer : on le place dans un Document, puis convert_to_graph_documents renvoie un résultat déjà structuré en nœuds et relations. On peut ensuite le visualiser et l’interroger dans Neo4j.
⚠️ Piège L’extraction produit des doublons et des erreurs. L’étape d’intégration et de validation résout les doublons d’entités et vérifie que le graphe représente fidèlement le domaine, par des tests utilisateur ou des contrôles automatisés.
Ce que le graphe change quand on cherche
Avec une recherche vectorielle, tu retrouves des passages proches de ta question. Avec un graphe, tu repères d’abord les entités de la question, puis tu parcours leurs voisins. Pour « où est né Obama ? », on part du nœud Obama et on prend ses voisins directs (un saut), voire les voisins de ses voisins (deux sauts).
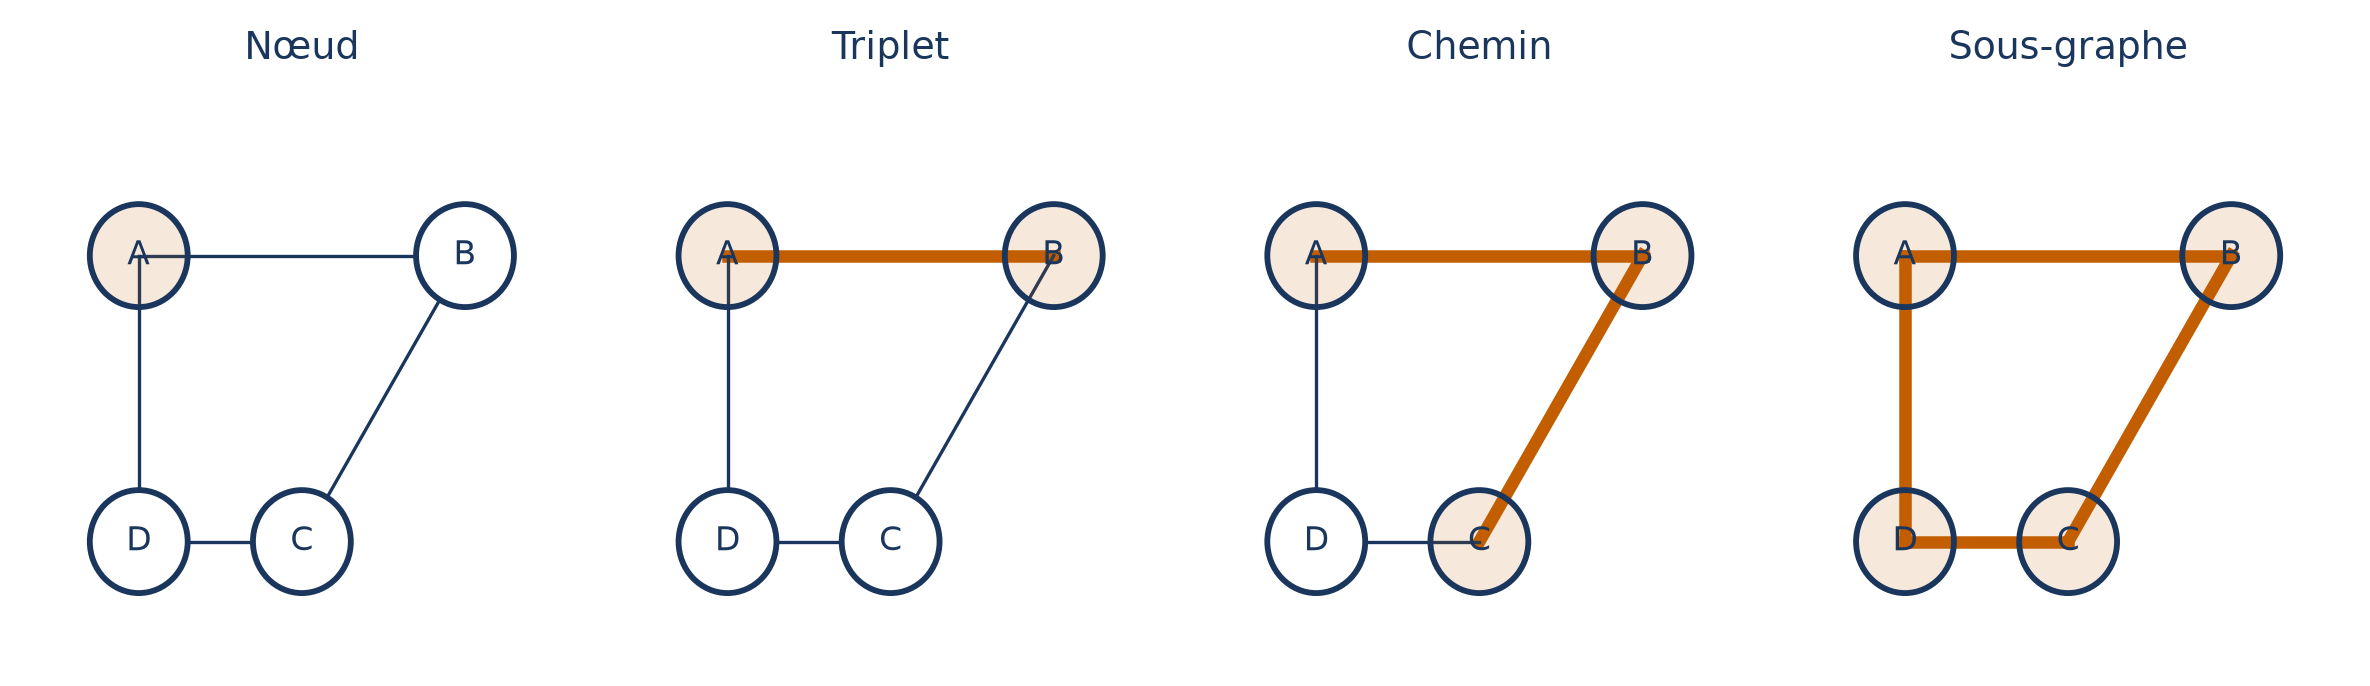
Contrairement au découpage en passages, qui se règle par leur taille, la granularité se choisit à la récupération. On peut ramener un nœud, un triplet, un chemin ou un sous-graphe entier : de plus en plus de contexte, de plus en plus de relations.
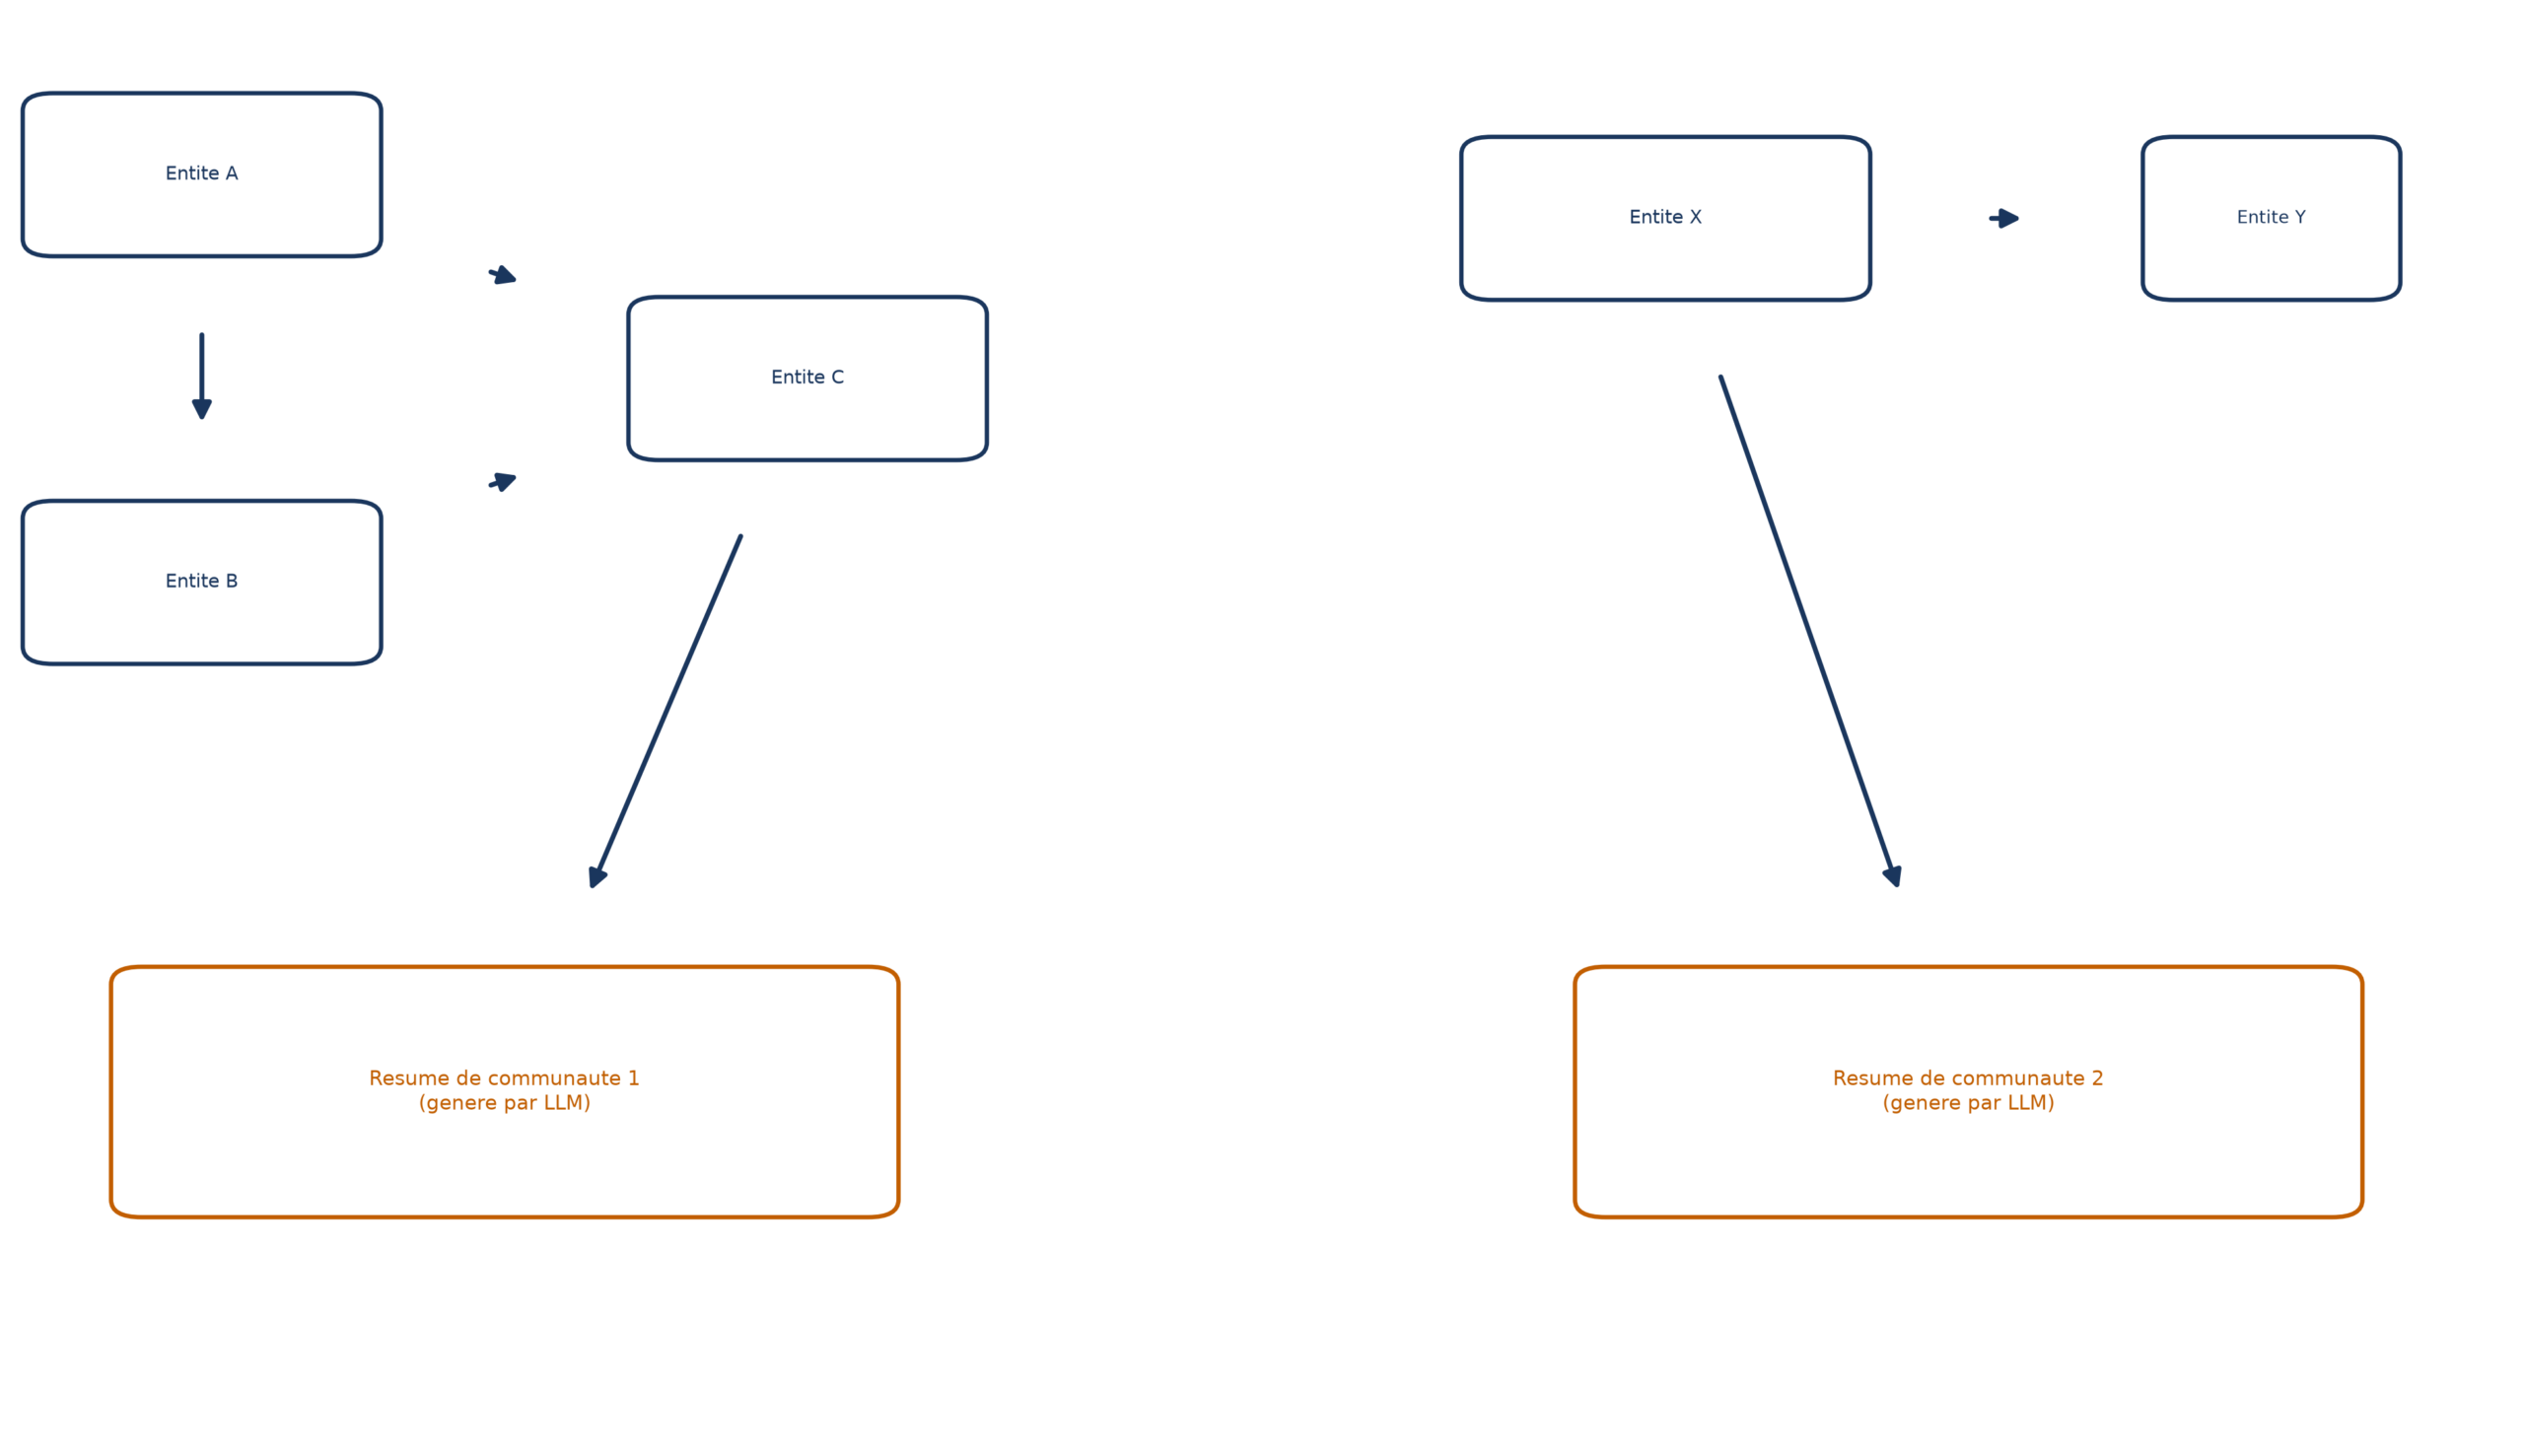
On peut aussi combiner les deux mondes. Une approche extrait entités et relations des passages avec un LLM, retrouve d’abord des passages par similarité, puis parcourt le graphe pour récupérer ceux qui partagent leurs entités. Une autre détecte des communautés d’entités densément connectées, avec des algorithmes comme Leiden ou Louvain, et fait résumer chacune par un LLM.
Pour interroger le graphe en langage naturel, la question doit devenir une requête Cypher. Deux voies : des modèles de requête prédéfinis, rigides mais fiables, ou la génération par un LLM, plus flexible mais moins fiable à 100 %.
📌 À retenir Le graphe ne remplace pas la recherche vectorielle : il la complète. La recherche va même vers des systèmes qui emploient les deux, avec éventuellement un routeur qui choisit entre le graphe et la base vectorielle.
Où on s’en sert
La santé croise médicaments, pathologies et interactions. La recommandation de produits suit le parcours d’un client sur plusieurs sauts. L’analyse de contrats repère des dépendances et des risques de conformité entre documents liés.
Le droit, avec ses nombreuses citations entre affaires, se modélise naturellement en graphe : pour une affaire donnée, on peut suggérer des affaires antérieures. Il en va de même pour un article de recherche, avec ses signataires, ses institutions et son réseau de citations. Des agents ont ainsi proposé de nouvelles hypothèses de recherche à partir d’un graphe construit sur 1 000 articles.
Un graphe est aussi un recueil de faits, d’où une piste pour limiter les hallucinations d’un LLM : lui donner des faits vérifiables, ce qui compte en biomédecine.
Les limites à connaître avant de te lancer
Le coût de construction est le premier obstacle : utiliser un LLM pour extraire des triplets d’un grand corpus peut coûter cher et exiger une infrastructure adaptée. Une fois le graphe bâti, il faut encore l’évaluer et le nettoyer, manuellement ou par calcul.
L’échelle pose un deuxième problème. Les graphes industriels peuvent contenir des milliards d’entités et de relations, alors que beaucoup d’algorithmes sont conçus pour des graphes allant jusqu’à quelques milliers d’entités. Retrouver de l’information dans un très gros graphe reste difficile.
Troisième limite : un graphe est notoirement incomplet et le plus souvent statique, ce qui gêne dans des domaines comme la finance où le marché change vite. Les graphes dynamiques corrigent cela, mais deviennent plus durs à maintenir : l’afflux de données peut introduire des erreurs qui se propagent. Ils sont gourmands en ressources, soumis à des normes strictes quand ils contiennent des données sensibles, et une confiance excessive peut faire négliger des facteurs que le graphe ne capture pas.
Pour en profiter malgré ces risques, on met en place des mécanismes de validation robustes, une architecture évolutive, des mesures de sécurité (chiffrement, contrôles d’accès, anonymisation) et une supervision humaine pour les décisions critiques.
Reste la question du choix. Si ton jeu de données est grand et que la recherche vectorielle classique atteint ses limites, l’approche par graphe est plus coûteuse et plus complexe, mais donne fréquemment de meilleurs résultats. Pour une question directe sur un fait simple, la recherche vectorielle seule suffit.