Tu poses une question précise à ton agent. La réponse tient en une phrase, quelque part dans une page de plus de 8 000 mots. Avant même que le modèle ne lise quoi que ce soit, tout s’est déjà joué : comment ce texte a-t-il été découpé, la veille, en morceaux que l’on peut retrouver ?
Un mauvais découpage coupe la réponse en deux, la noie dans du bruit ou la rend introuvable. Un bon découpage la place, entière, en tête des résultats. Voici comment choisir le tien, méthode après méthode, chiffres à l’appui.
L’essentiel en 30 secondes
- Découper sert à trois choses : tenir dans la fenêtre de contexte, limiter le « perdu au milieu », faciliter la recherche.
- Pas de réponse universelle : cela dépend du contenu, des questions attendues et du modèle d’embeddings.
- Point de départ raisonnable : un découpage récursif pour un texte générique, ou un découpage qui suit la structure du document quand il en a une.
- Pour trouver précisément et lire avec du contexte, on peut chercher sur de petits fragments et renvoyer le grand bloc dont ils sont issus.
- Combiner plusieurs méthodes est courant et souvent bénéfique ; c’est ensuite la mesure sur tes propres questions qui tranche.
L’intuition : un fragment, c’est une étiquette qui doit ressembler à la question
Imagine une bibliothèque où chaque fiche résume un seul passage. Si la fiche décrit un chapitre entier, elle ressemble un peu à toutes les questions et à aucune en particulier. Si elle décrit une demi-phrase, elle ressemble à la question mais ne contient pas de quoi répondre. Le bon découpage se situe entre les deux.
Cette intuition est celle du retriever : un fragment plus étroit produit un embedding plus spécifique, donc plus facile à faire correspondre précisément à une question.
Le revers, c’est le contexte. De grands fragments apportent du contexte mais aussi du bruit ; de petits fragments sont précis mais peuvent perdre le contexte. Prends un document juridique de 10 000 mots : découpé en segments de 1 000 mots, il mélange plusieurs clauses ; en segments de 200 mots, chaque clause est isolée, au risque de perdre le contexte des clauses voisines.
💡 Intuition Découper, c’est arbitrer entre deux erreurs : un fragment trop large qui dilue la réponse, un fragment trop étroit qui l’ampute. Toutes les méthodes ci-dessous sont des façons de placer ce curseur.
Il y a une raison mathématique simple à la dilution : embedder un document entier revient à faire une moyenne de ses idées distinctes, ce qui rend la correspondance avec une question précise plus difficile. Découper en fragments plus petits permet une correspondance plus fine.
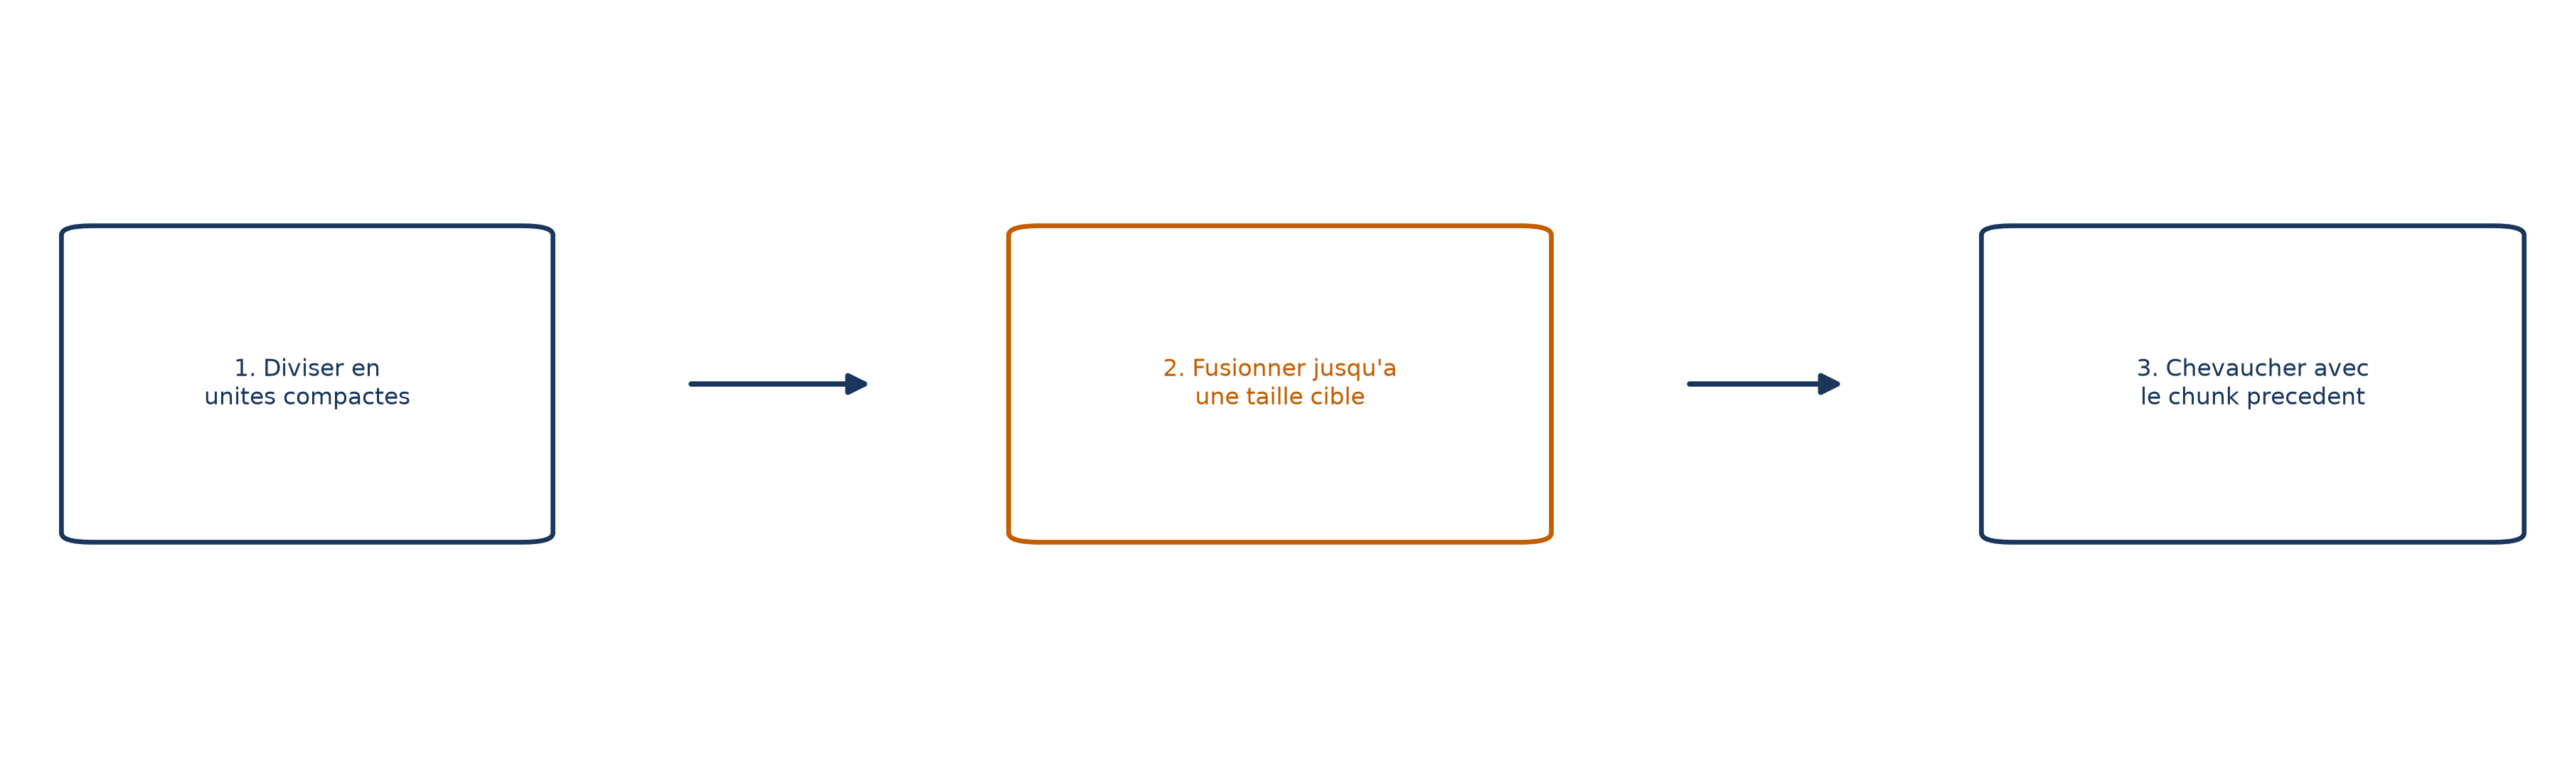
Ce bout repris, c’est le chevauchement (overlap). Il sert à ne pas perdre les réponses qui s’étendent sur plusieurs fragments.
Sous le capot : quatre familles de découpage
Taille fixe : simple, mais aveugle au sens
Le découpage à taille fixe prédétermine la taille des fragments et le chevauchement. La version la plus simple coupe à chaque occurrence d’un caractère donné, par exemple un saut de ligne. La taille peut se mesurer en caractères ou, plus fidèlement au modèle, en tokens.
Sa limite est qu’il ignore le sens du texte. Il convient surtout aux données intrinsèquement uniformes : séquences génétiques, manuels techniques, réponses d’enquête.
Quand le caractère de séparation est trop rare pour tenir la taille cible, on passe au découpage récursif : il reçoit une liste de séparateurs de repli (paragraphe, ligne, point, espace) et retente avec le suivant tant que la taille voulue n’est pas atteinte. C’est la méthode recommandée pour des textes génériques.
Spécialisé : suivre la structure du document
Le découpage spécialisé tient compte de la structure : en-têtes Markdown, classes et fonctions d’un fichier de code, sections HTML. LangChain propose des classes dédiées, comme MarkdownHeaderTextSplitter, HTMLHeaderTextSplitter ou RecursiveJsonSplitter. Son avantage est de préserver la structure inhérente des données, d’où son autre nom : chunking adaptatif.
Sémantique : laisser le sens décider
Une approche plus récente, proposée par Greg Kamradt, questionne l’idée même d’une taille prédéfinie. Elle regroupe d’abord des groupes de trois phrases, puis fusionne ceux dont le sens est proche, à l’aide d’embeddings de similarité (classe SemanticChunker). Le livre la présente encore comme une technique expérimentale.
Enrichir et hiérarchiser : ne pas se limiter au texte brut
Une fois découpé, un fragment peut être aidé. Le chunking enrichi de contexte ajoute le résumé du document entier à chaque fragment : meilleure cohérence sémantique, au prix d’un coût de calcul et de stockage supplémentaire.
On peut aussi récupérer les fragments voisins d’un fragment pertinent (utile quand l’information se déploie sur plusieurs paragraphes), filtrer par métadonnées (date, auteur, catégorie) avant la recherche, ou générer pour chaque fragment des questions synthétiques qu’il permettrait de résoudre.
Enfin, la structure parent-enfant : les enfants portent le détail, les parents portent le thème ou le contexte, et la récupération cible d’abord les enfants avant de remonter au parent.
| Méthode | Ce qu’elle apporte | Sa limite |
|---|---|---|
| Taille fixe | Simplicité, taille maîtrisée | Ignore le sens du texte |
| Récursif | Repli sur des séparateurs naturels | Reste indépendant du contenu |
| Spécialisé | Respecte titres, sections, code | Suppose un document structuré |
| Sémantique | Taille dictée par le sens | Encore expérimental |
| Parent-enfant | Précision de la recherche + contexte de lecture | Deux niveaux à gérer |
Le voir tourner
Une même page, plusieurs découpages
Question concrète : combien de morceaux donne la page Wikipédia de la Coupe du monde de cricket 2023 (plus de 8 000 mots), selon la méthode ? On commence par le découpage par caractère. Le code coupe sur les sauts de ligne, vise 1 000 caractères par fragment, avec 200 caractères de chevauchement. Repère html_data_transformed[0].page_content : c’est le texte de la page, déjà nettoyé de ses balises HTML.
from langchain.text_splitters import CharacterTextSplitter

text_splitter = CharacterTextSplitter(
    separator="\n",  # caractere utilise pour le decoupage
    chunk_size=1000,  # nombre de caracteres par chunk
    chunk_overlap=200,  # nombre de caracteres de chevauchement
)
chunks = text_splitter.create_documents(
    [html_data_transformed[0].page_content]
)
print(f"Nombre de chunks crees : {len(chunks)}")
Résultat : 67 fragments, et l’on peut vérifier que les 200 derniers caractères de l’un recoupent bien les 200 premiers du suivant.
Changeons de méthode : un découpage par sections HTML donne 231 fragments. Si on les redécoupe ensuite à taille fixe, on obtient 285 fragments finaux. Cette combinaison est présentée comme courante et souvent bénéfique, avec un principe d’équilibre : plus de fragments, c’est une information plus précise pour le modèle, mais au risque de perdre la cohérence d’ensemble.
📌 À retenir Sur la même page : 67 fragments avec une coupe par caractère, 285 avec sections puis taille fixe. Le nombre de fragments n’est pas un détail technique, c’est le résultat direct de ta stratégie.
Ne jamais couper un mot en deux
Autre corpus, autre question : un article sur les brevets d’Einstein, découpé en fenêtres glissantes de 500 caractères avec 40 caractères de recouvrement. Le livre écrit sa propre fonction, dont la logique garantit qu’on ne coupe jamais au milieu d’un mot.
Dans le code, text est l’article complet, chunk_size la taille visée et overlap le recouvrement. Avec split_on_whitespace_only=True, on ne coupe que sur des espaces ; sinon, on découpe brutalement par index.
def chunk_text(text, chunk_size, overlap, split_on_whitespace_only=True):
    chunks = []
    index = 0
    while index < len(text):
        if split_on_whitespace_only:
            prev_whitespace = 0
            left_index = index - overlap
            while left_index >= 0:
                if text[left_index] == " ":
                    prev_whitespace = left_index
                    break
                left_index -= 1
            next_whitespace = text.find(" ", index + chunk_size)
            if next_whitespace == -1:
                next_whitespace = len(text)
            chunk = text[prev_whitespace:next_whitespace].strip()
            chunks.append(chunk)
            index = next_whitespace + 1
        else:
            start = max(0, index - overlap + 1)
            end = min(index + chunk_size + overlap, len(text))
            chunk = text[start:end].strip()
            chunks.append(chunk)
            index += chunk_size
    return chunks

chunks = chunk_text(text, 500, 40)
print(len(chunks)) # 89 chunks in total
L’article donne 89 fragments. Ce nombre est ensuite confirmé par le calcul des embeddings : chaque fragment devient un vecteur de 1536 dimensions, et l’on retrouve exactement autant de vecteurs que de fragments.
Découper d’abord selon les titres
Plutôt qu’une taille arbitraire, on peut s’appuyer sur la structure. L’article d’Einstein a des sections numérotées ; une expression régulière repère chaque titre (un chiffre, un point, quelques mots) et coupe juste avant.
import re
def split_text_by_titles(text):
    # A regular expression pattern for titles that
    # match lines starting with one or more digits, an optional uppercase letter,
    # followed by a dot, a space, and then up to 60 characters
    title_pattern = re.compile(r"(\n\d+[A-Z]?\. {1,3}.{0,60}\n)", re.DOTALL)
    titles = title_pattern.findall(text)
    # Split the text at these titles
    sections = re.split(title_pattern, text)
    sections_with_titles = []
    # Append the first section
    sections_with_titles.append(sections[0])
    # Iterate over the rest of the sections
    for i in range(1, len(titles) + 1):
        section_text = sections[i * 2 - 1].strip() + "\n" + sections[i * 2].strip()
        sections_with_titles.append(section_text)
    return sections_with_titles

sections = split_text_by_titles(text)
print(f"Number of sections: {len(sections)}")
# Number of sections: 9
On obtient neuf sections : quatre principales, quatre sous-sections décrivant des brevets, et le résumé initial. Mais une mesure en tokens révèle un problème : la plupart des sections restent sous les 600 tokens, une taille raisonnable pour la plupart des prompts, alors que l’une d’elles dépasse les 4 000 tokens et risquerait de provoquer une erreur de dépassement de contexte.
Le découpage par structure ne suffit donc pas toujours : il faut ensuite redécouper les sections trop longues, exactement comme dans l’exemple de la page Wikipédia.
Chercher petit, lire grand : le parent document retriever
C’est ici que la stratégie parent-enfant prend tout son sens. Le document parent est découpé en enfants plus petits, chacun embeddé séparément ; mais c’est le parent entier qui est retourné une fois la correspondance trouvée, pour garder tout le contexte utile au modèle.
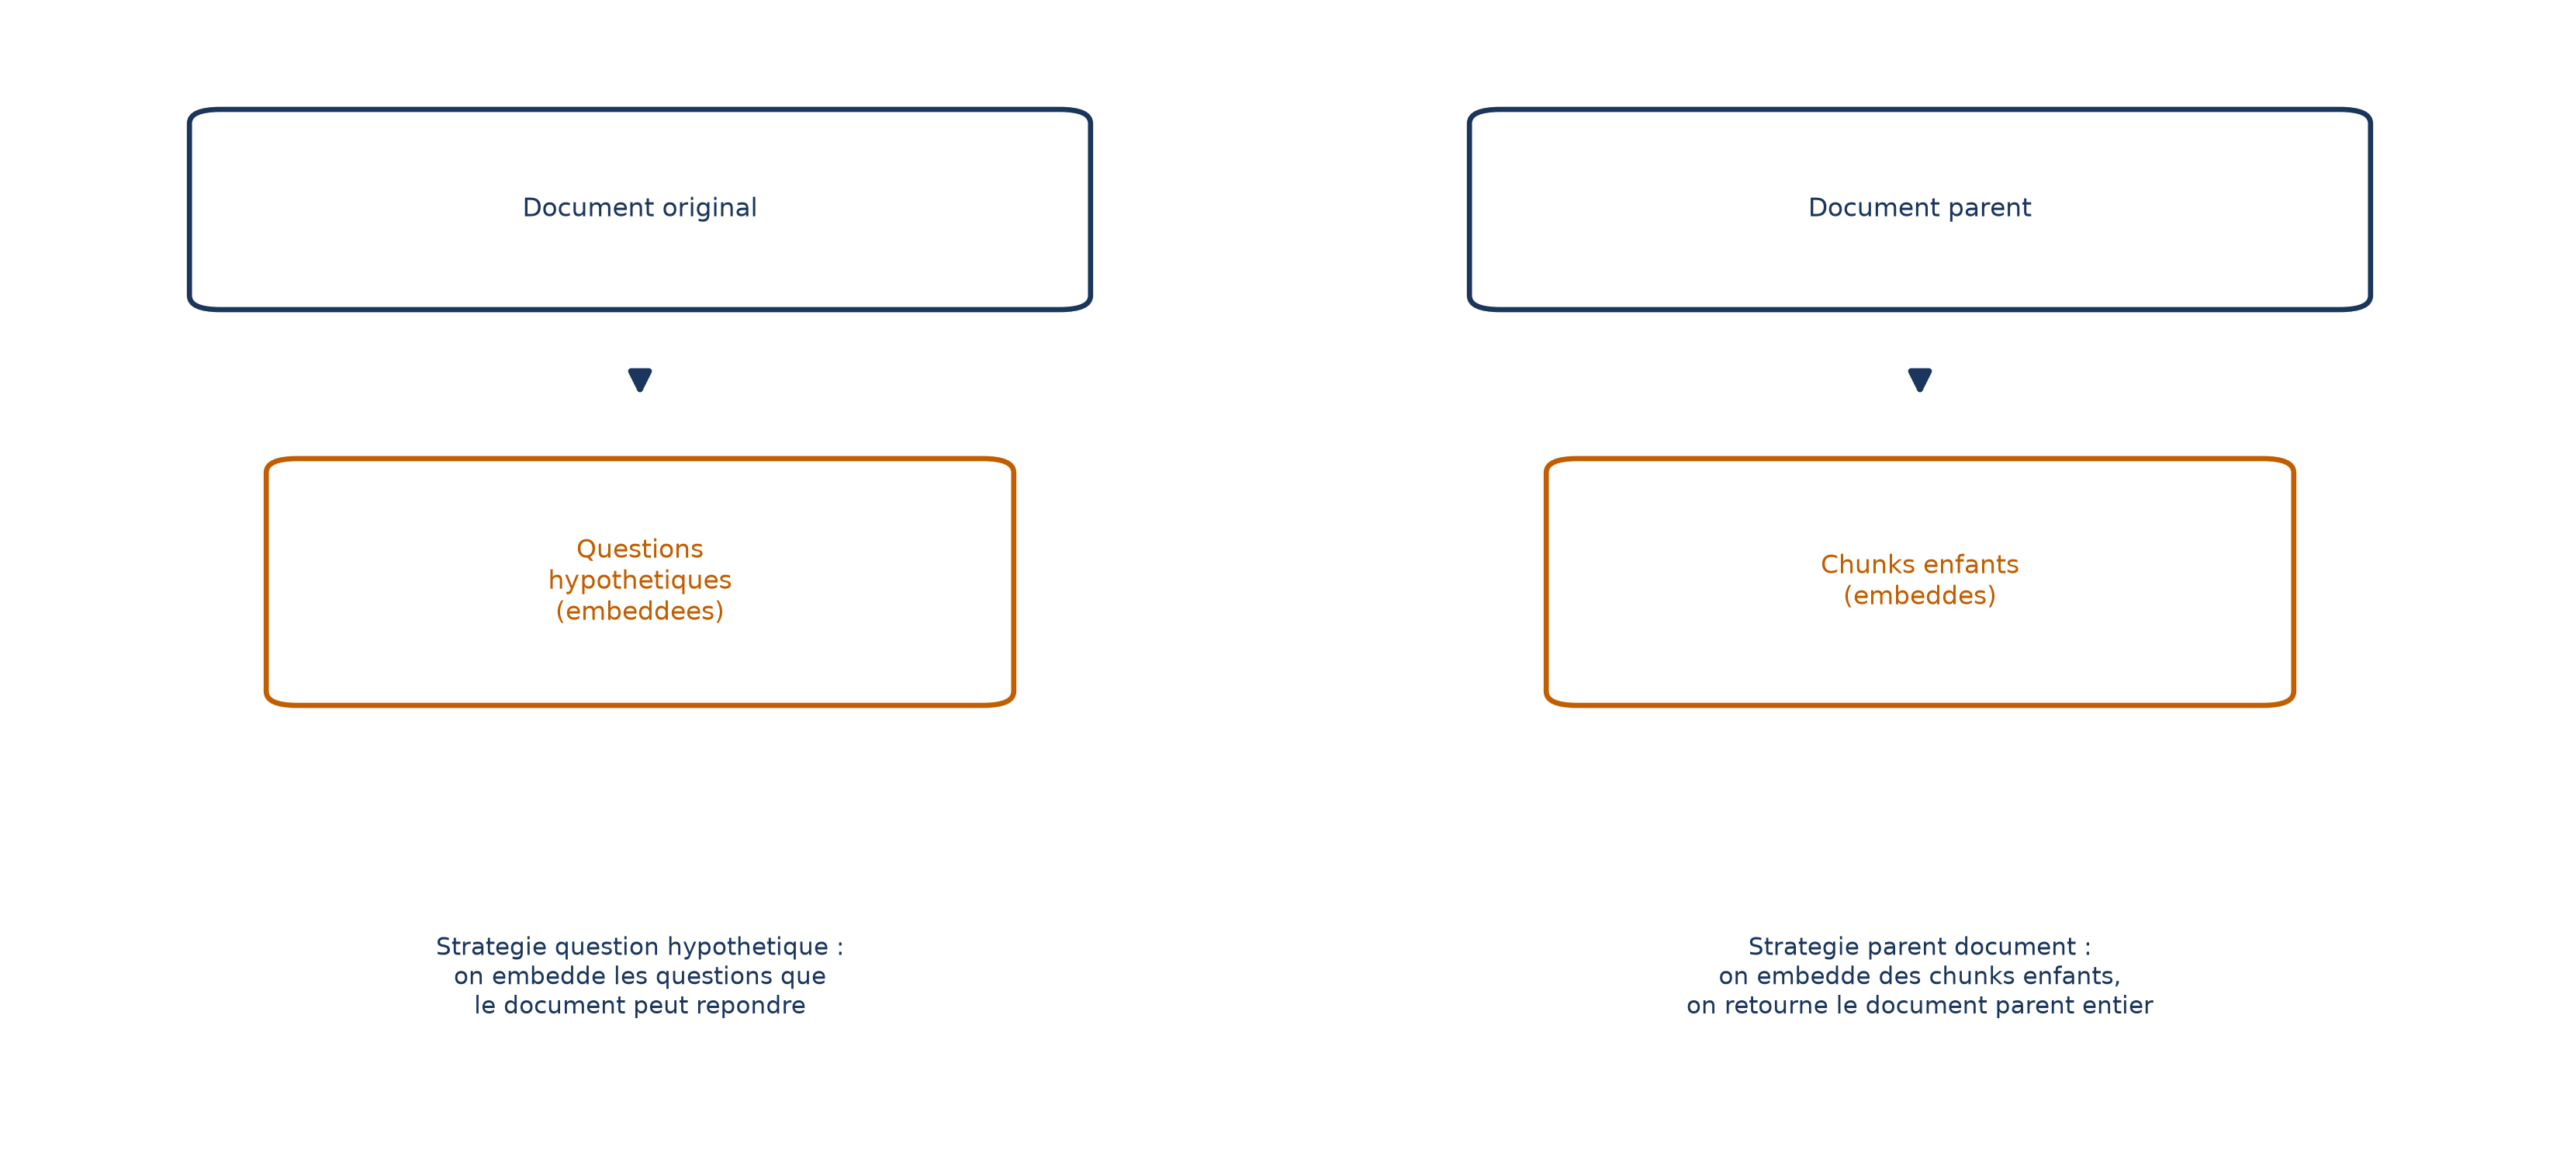
Dans l’exemple, les sections trop longues sont redécoupées en parents d’au plus 2 000 caractères, avec la fonction chunk_text vue plus haut ; sections est la liste obtenue à l’étape précédente.
parent_chunks = []
for s in sections:
    parent_chunks.extend(chunk_text(s, 2000, 40))
Chaque parent est ensuite découpé en enfants de 500 caractères, embeddés et importés dans un graphe où le PDF est relié à ses parents, eux-mêmes reliés à leurs enfants.
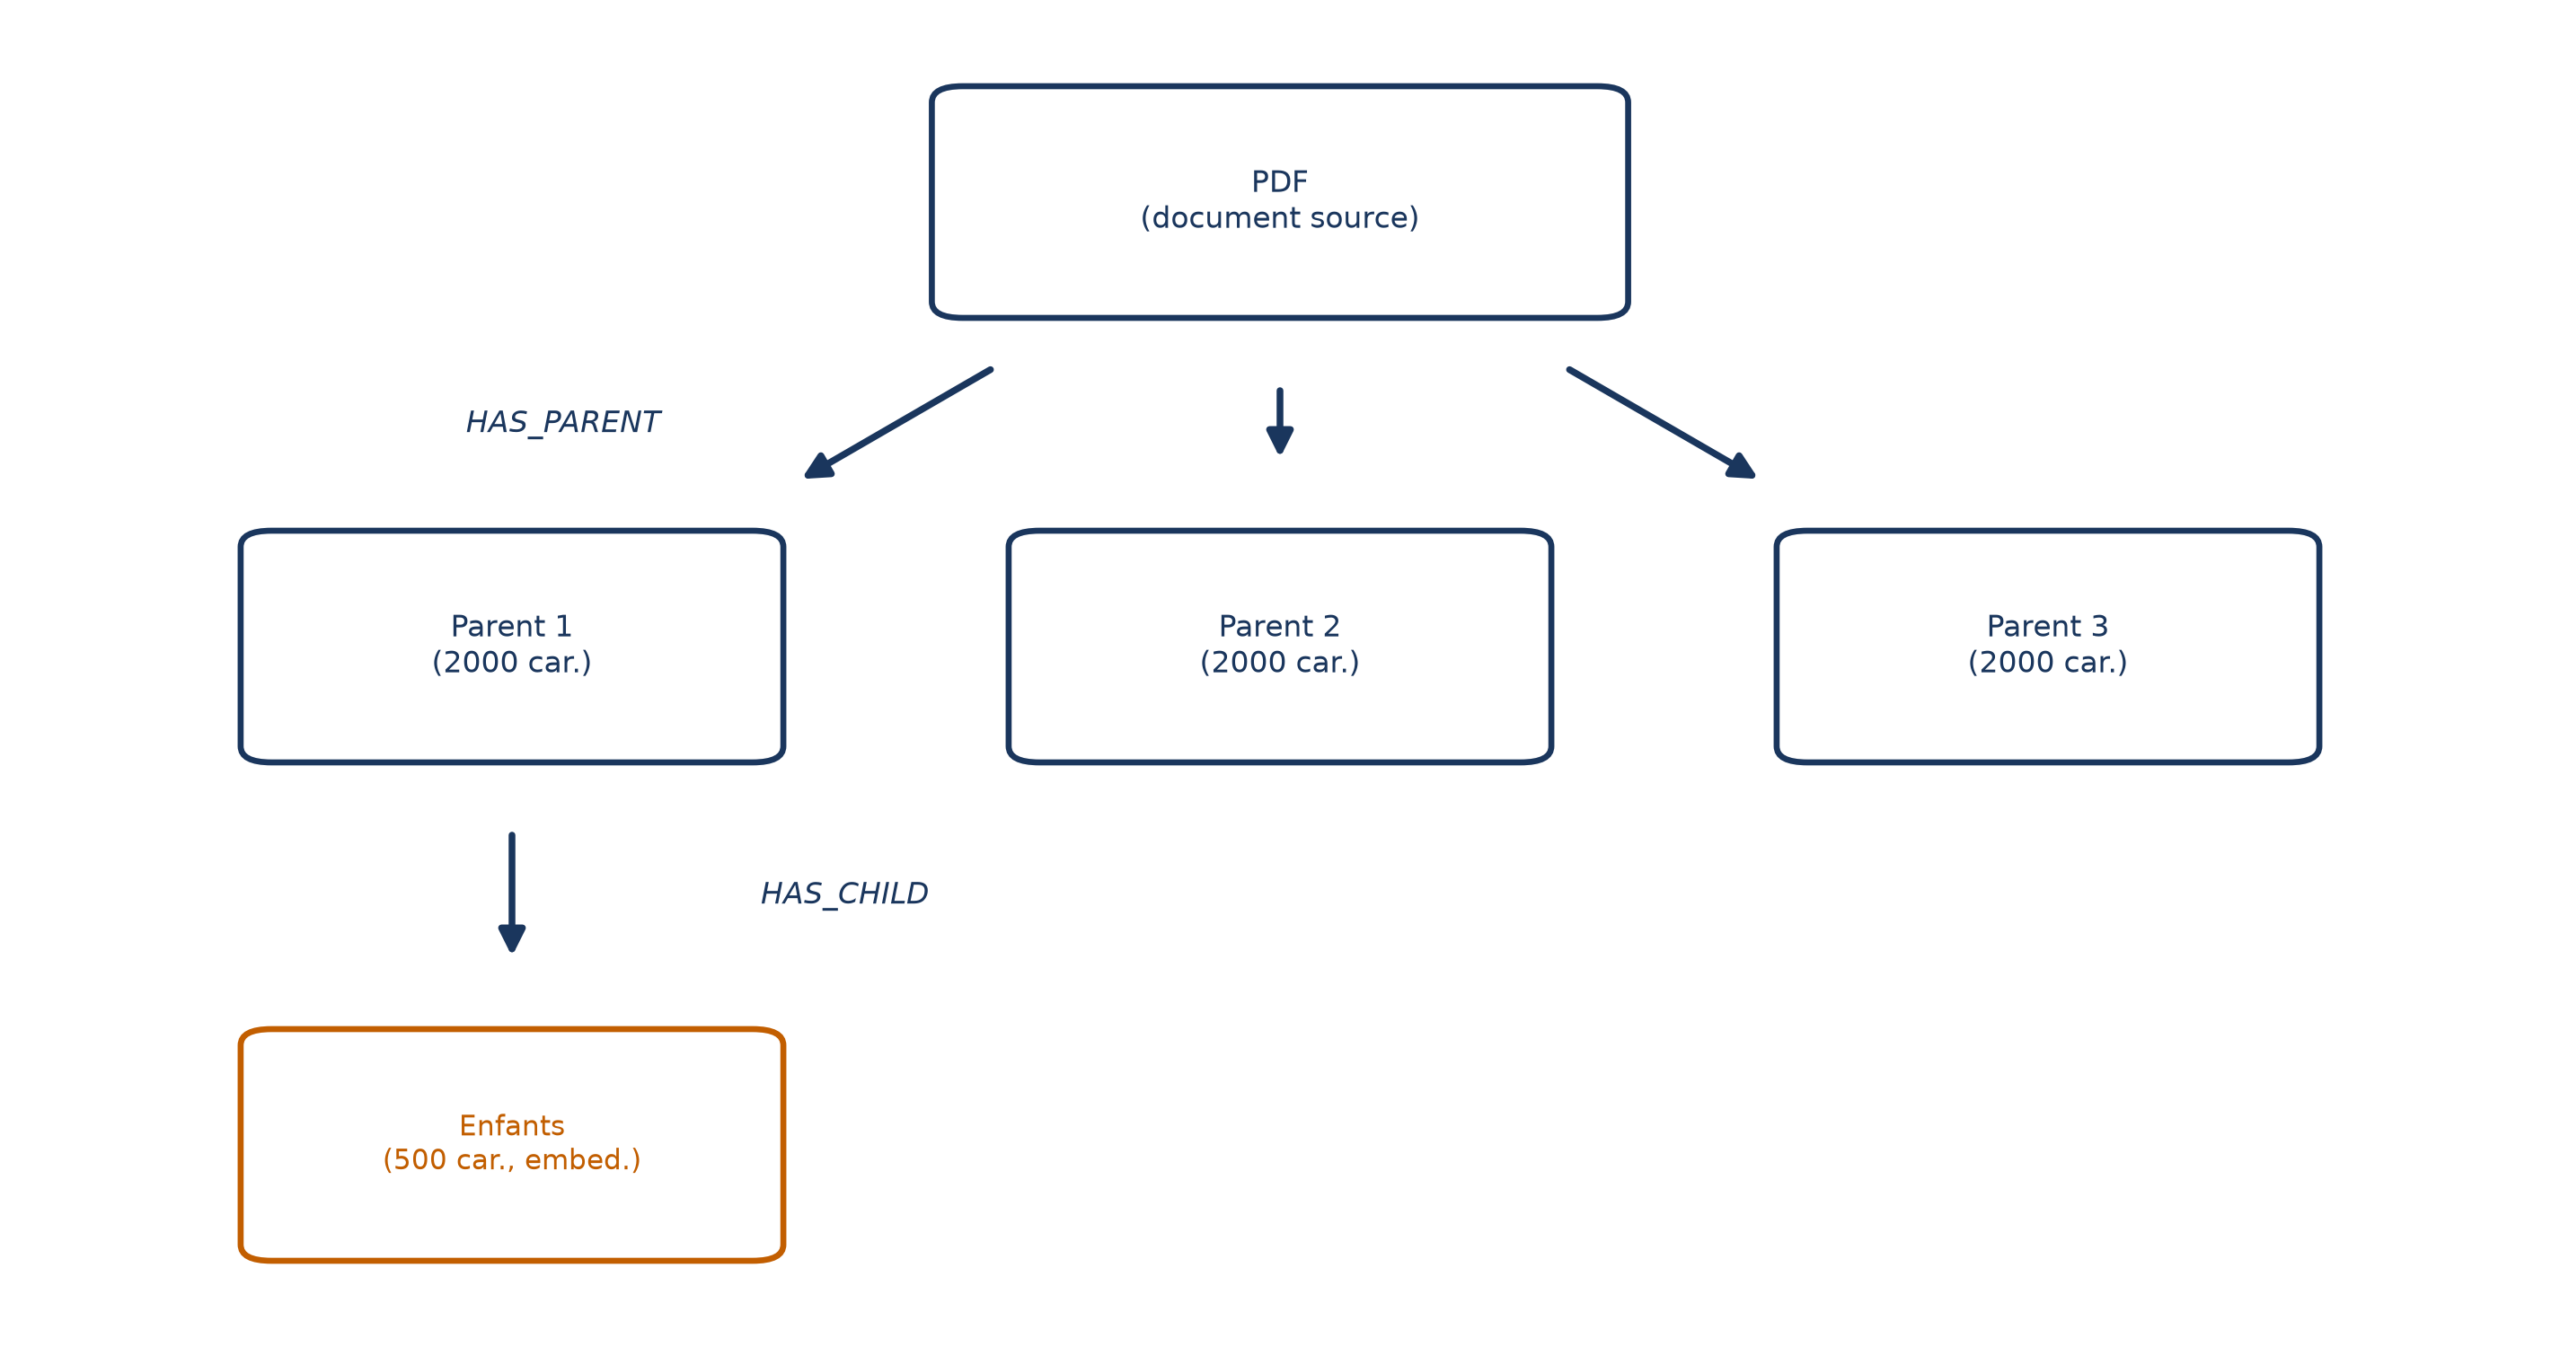
À la question, la recherche vectorielle part des enfants, mais en demandant volontairement quatre fois plus de résultats que nécessaire : plusieurs enfants pertinents peuvent appartenir au même parent, il faut donc une marge avant de dédupliquer et de ne garder que les k meilleurs parents.
CALL db.index.vector.queryNodes($index_name, $k * 4, $question_embedding)
YIELD node, score
MATCH (node)<-[:HAS_CHILD]-(parent)
WITH parent, max(score) AS score
RETURN parent.text AS text, score
ORDER BY score DESC
LIMIT toInteger($k)
Retiens la ligne max(score) : chaque parent est classé selon son enfant le plus proche de la question, et non selon une moyenne diluée. C’est la traduction concrète de « chercher petit, lire grand ».
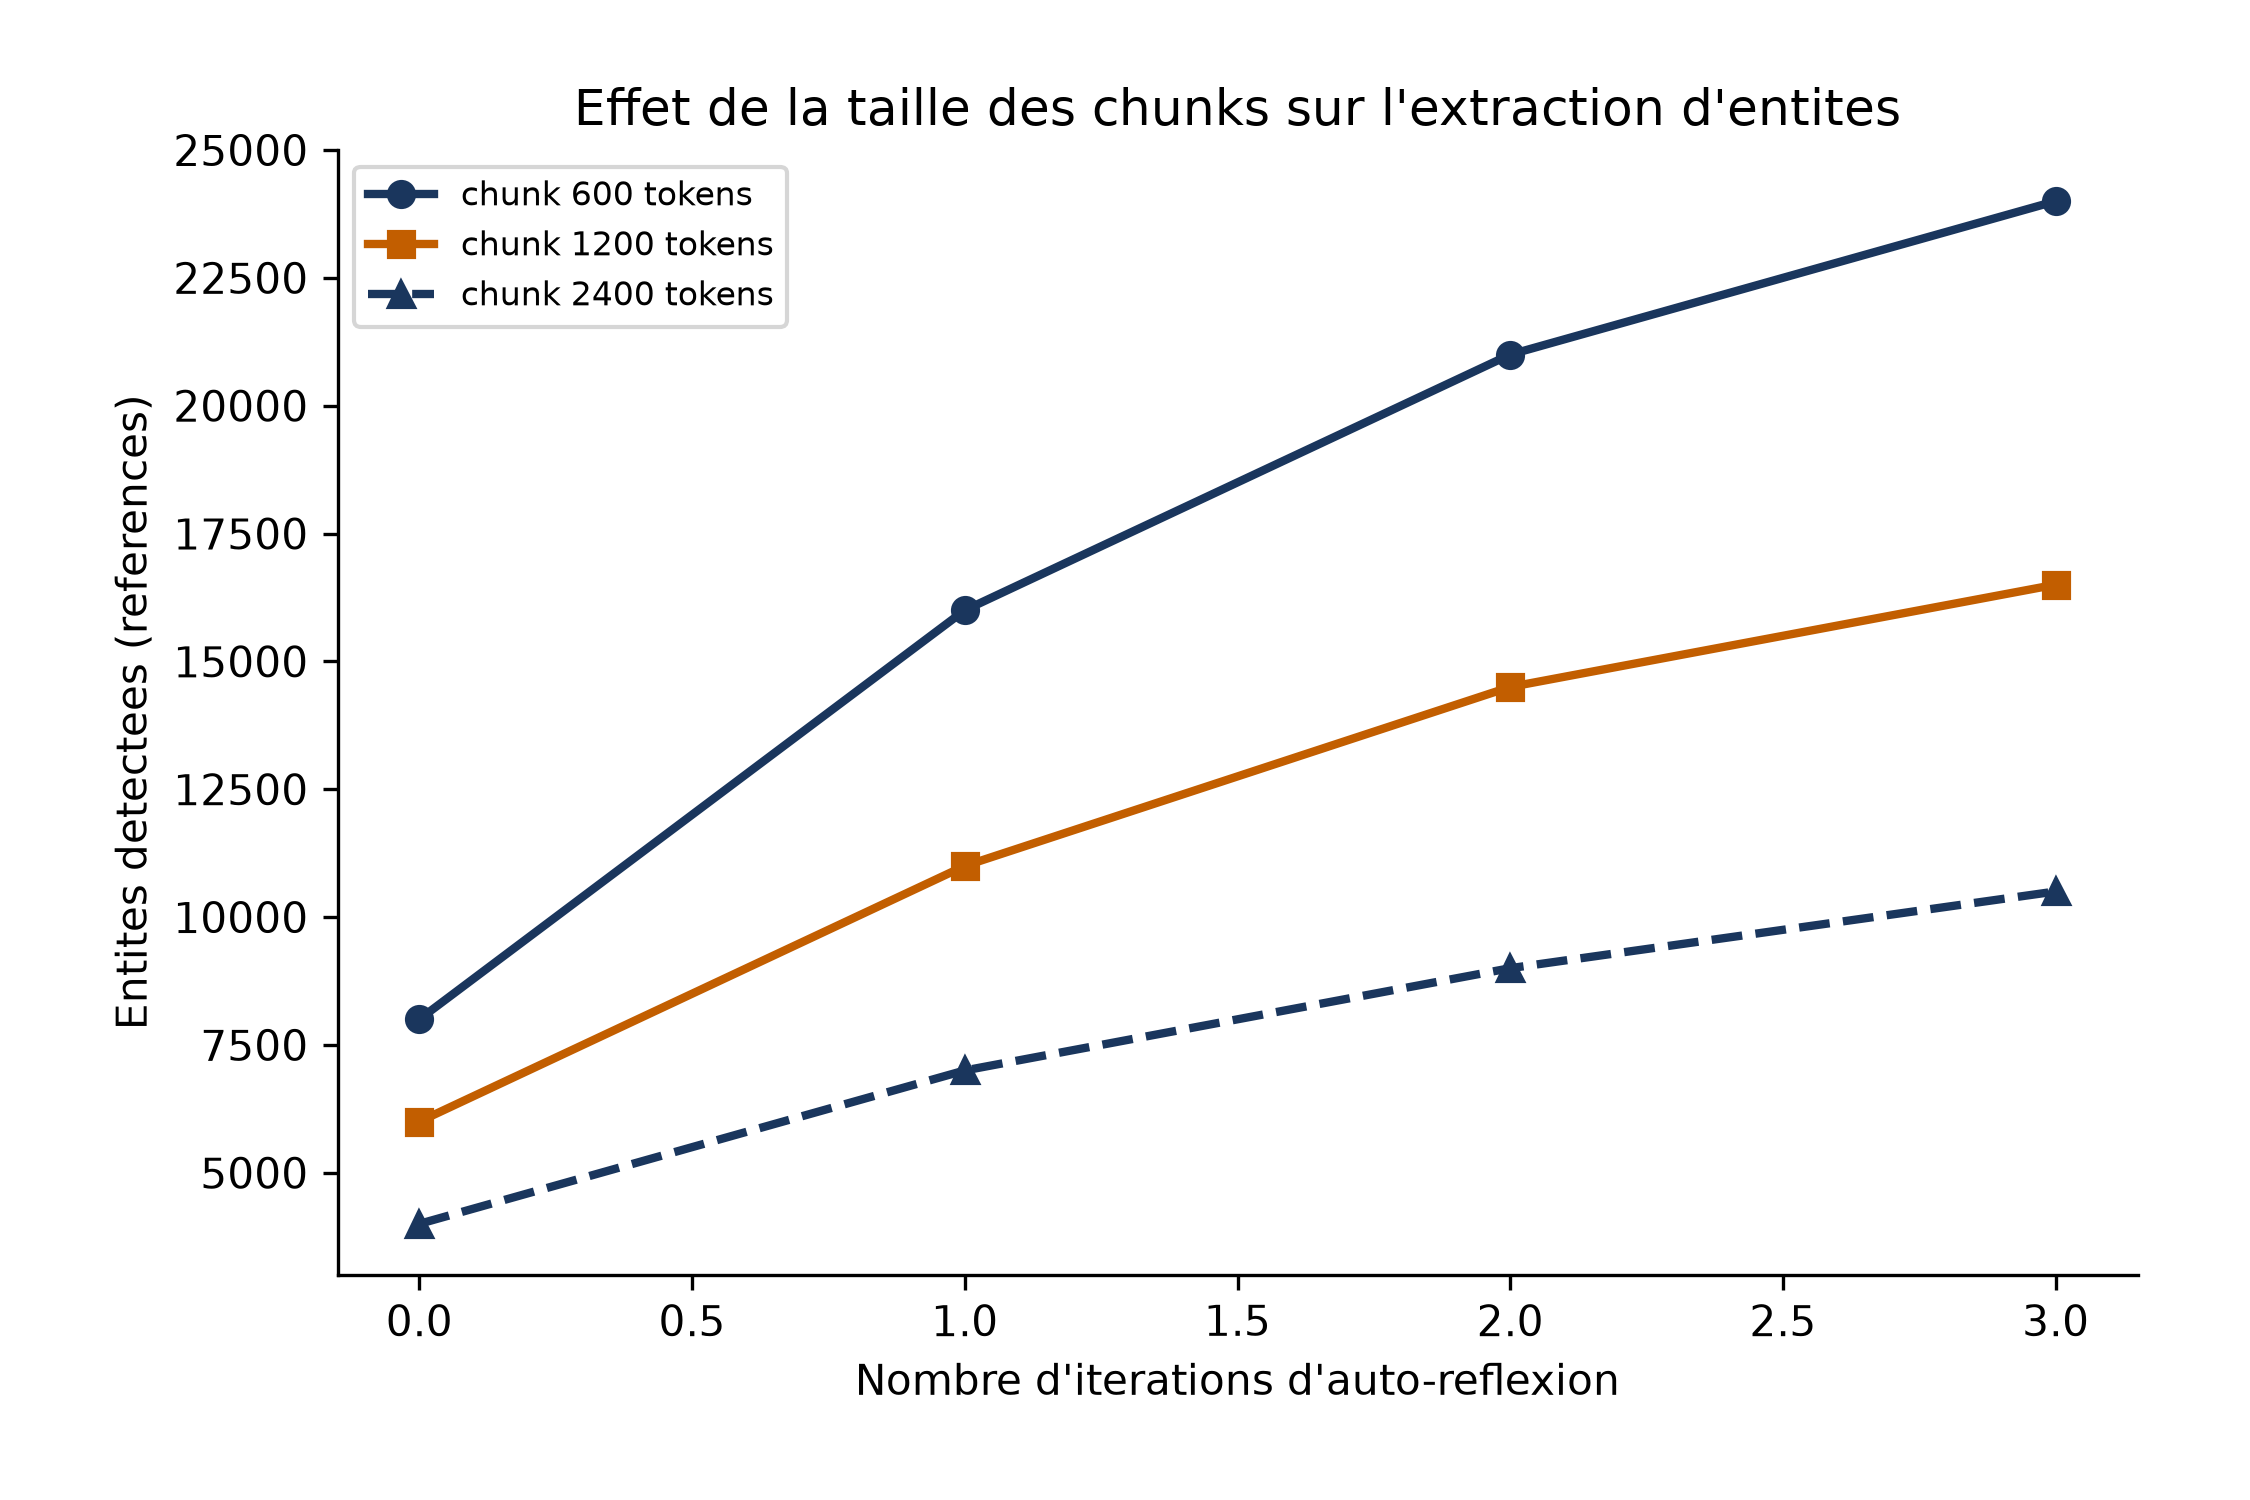
Quelle taille choisir ? Un exemple chiffré
Le livre sur GraphRAG rapporte une expérience de chercheurs de MS GraphRAG qui comparent plusieurs tailles de fragments. Attention au contexte : la mesure porte sur l’extraction d’entités, pas sur la récupération d’une réponse.
Lire les résultats : comment savoir si ton découpage est le bon
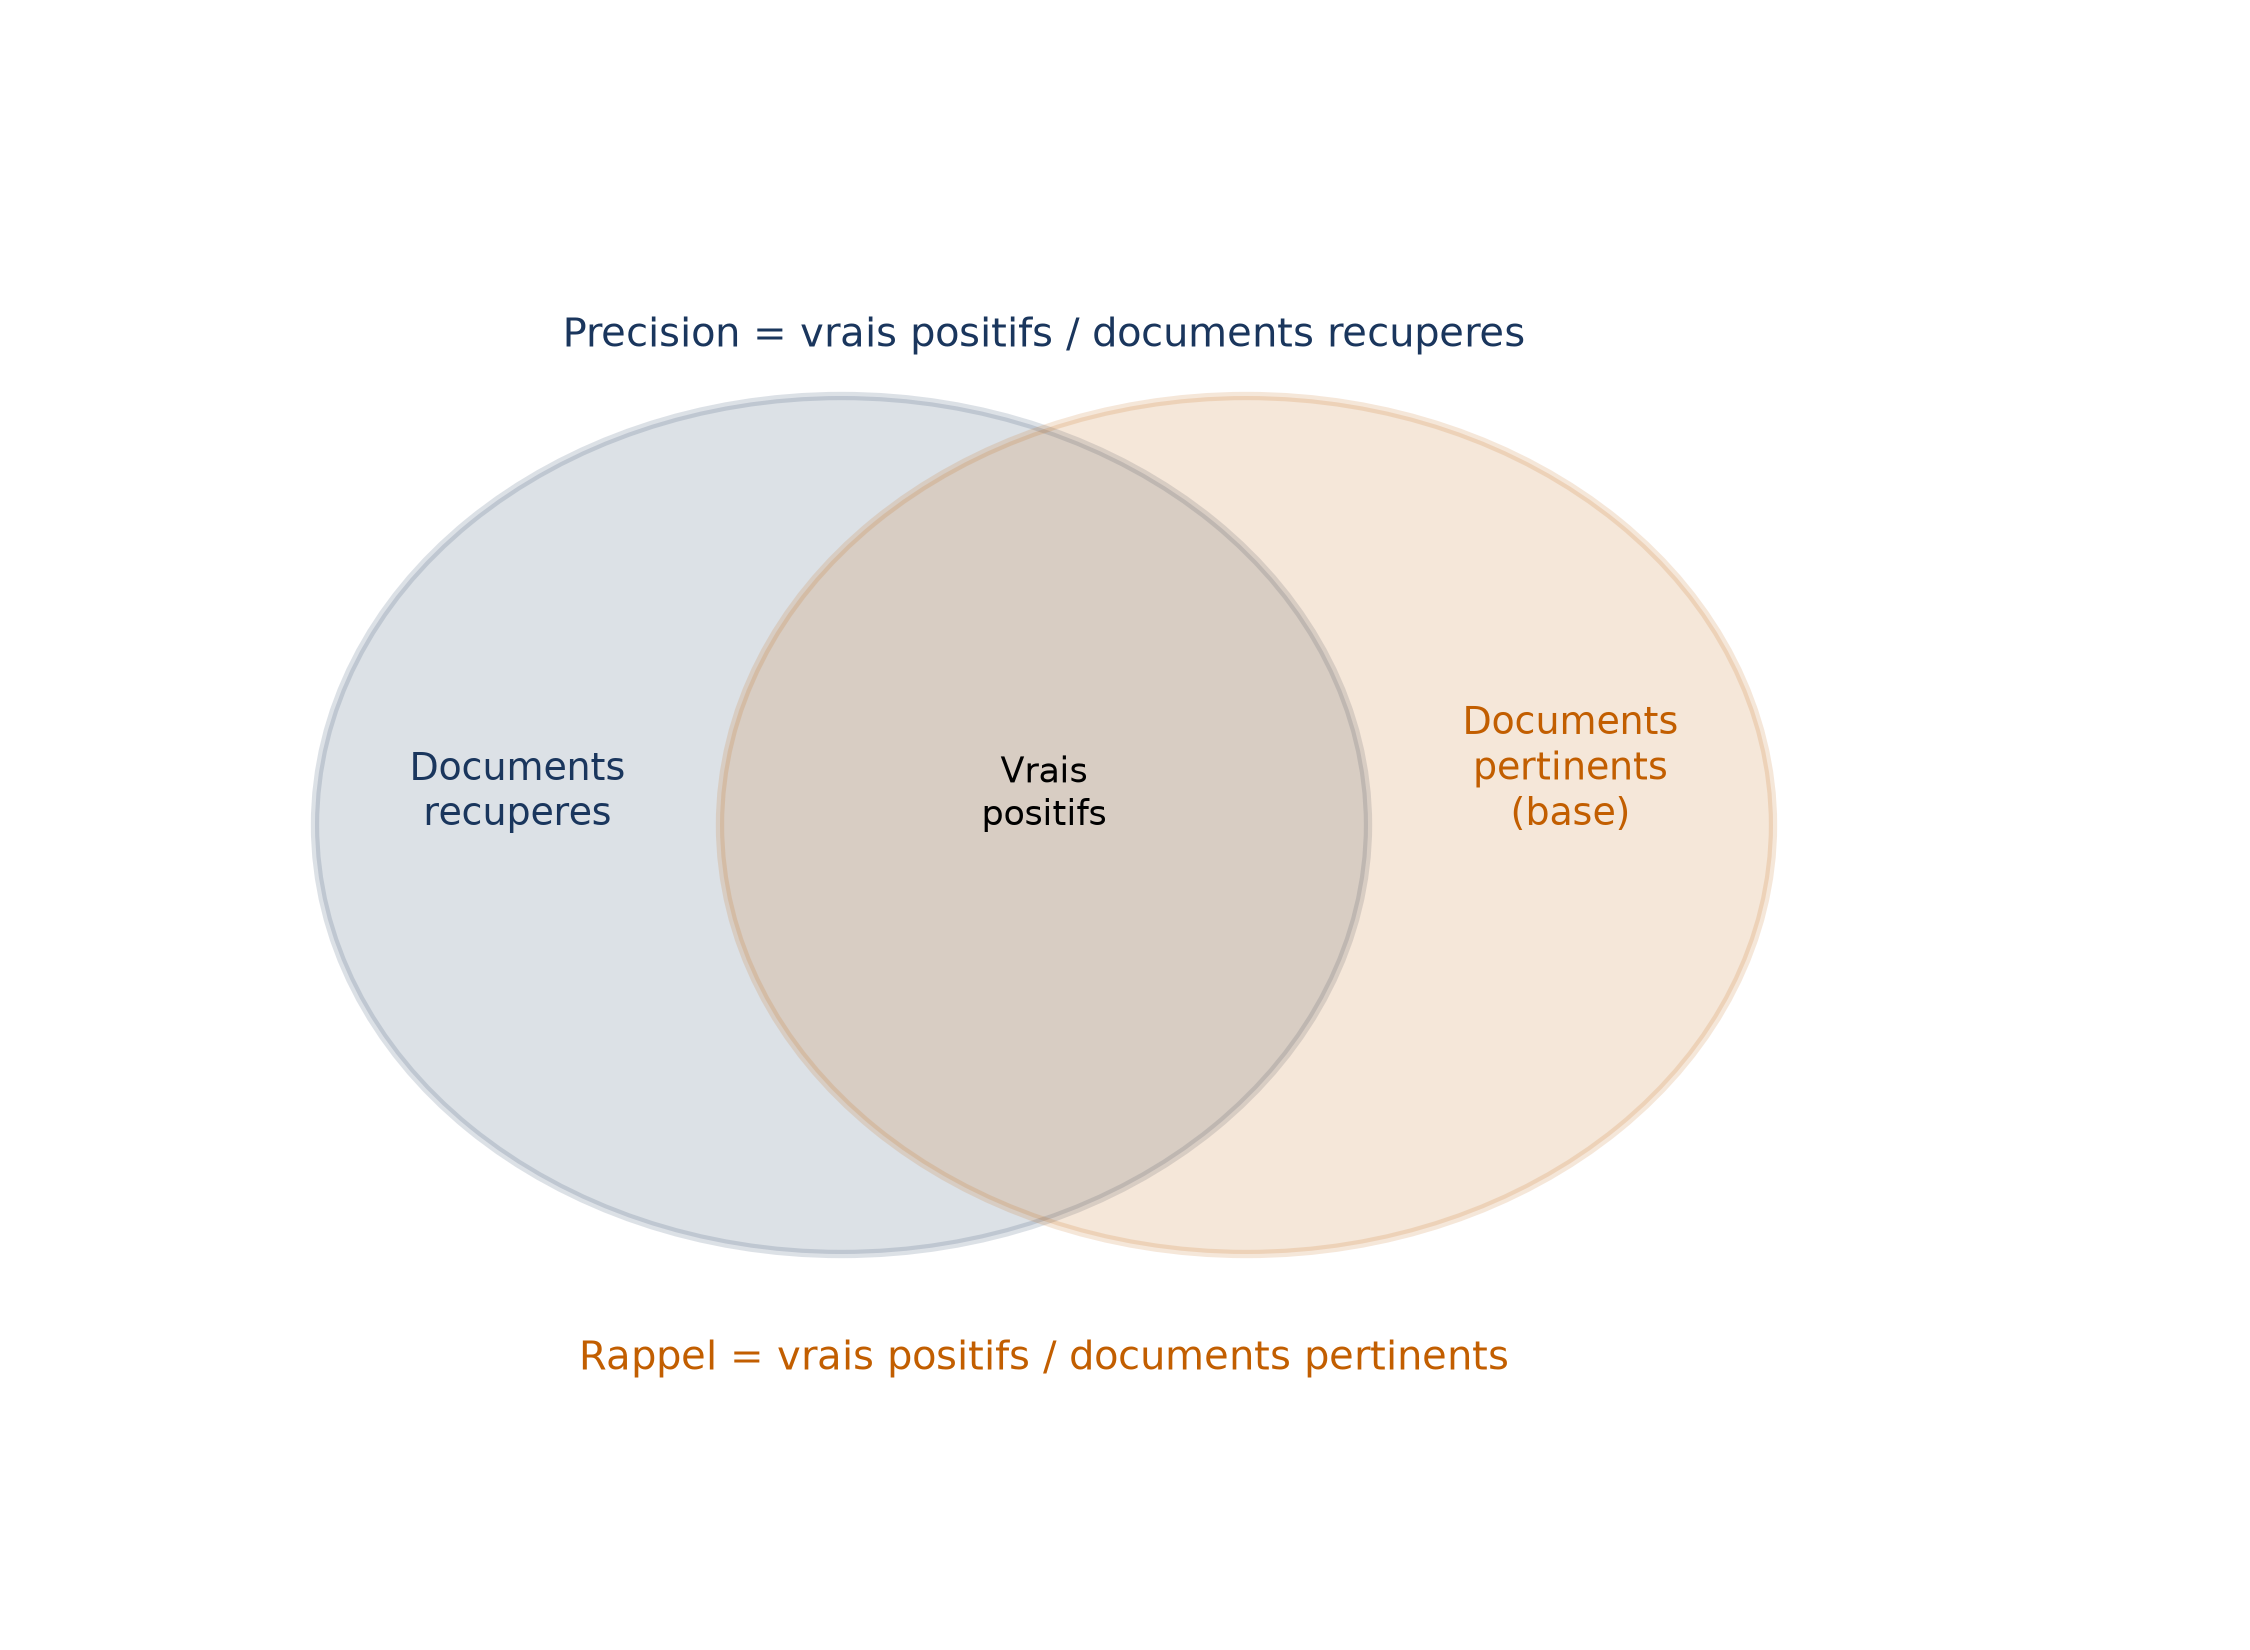
Choisir sans mesurer, c’est deviner. Le livre distingue deux métriques de récupération que tu connais peut-être : la précision (parmi les documents récupérés, combien étaient pertinents ?) et le rappel (parmi tous les documents pertinents, combien ont été récupérés ?). En RAG, la précision@k est la plus parlante, puisque seuls les tout premiers résultats servent à l’augmentation.
Pour ton objectif « du premier coup », une troisième mesure est décisive : le rang de réciprocité moyen (MRR), qui moyenne sur un ensemble de requêtes l’inverse du rang du premier document pertinent. Il dit à quelle vitesse le système trouve un résultat pertinent, mais ignore tout ce qui suit ce premier résultat.
💡 Intuition Une bonne réponse en position 1 vaut plus qu’une bonne réponse en position 5 : c’est exactement ce que capture le MRR. Compare deux découpages sur les mêmes questions et garde celui dont le MRR est le meilleur.
Sépare aussi les deux sources d’erreur. Sur un banc d’essai, le livre GraphRAG obtient une exactitude de 0,7774, un rappel de contexte de 0,7941 et une fidélité de 0,9657 : le modèle invente rarement, mais la récupération ne capture pas toujours toute l’information. Quand le rappel est le maillon faible, c’est le découpage et la récupération qu’il faut travailler, pas le modèle.
Enfin, garde un jeu de questions qui évolue : il devient une spécification vivante de ce que l’agent doit savoir gérer, et permet de détecter les régressions quand tu changes de découpage.
Pièges et limites
Le contexte de l’agent est un budget. Un contexte non pertinent ou mal structuré distrait le modèle ou dépasse les budgets de jetons sans bénéfice ; il vaut mieux ne retrouver que les informations les plus utiles plutôt que d’ajouter de gros blocs de texte. Plus tes fragments sont ciblés, mieux ce budget est employé.
Un fragment peut mélanger des sources. Des fragments partageant des mots-clés comme « payment » ou « terms » mais appartenant à des contrats différents peuvent se mélanger, et conduire le modèle à une réponse fragmentée, voire trompeuse. Le filtrage par métadonnées (horodatage, auteur, catégorie) restreint la recherche aux fragments pertinents avant même de la lancer.
⚠️ Piège Un découpage parfait ne répond pas à toutes les questions. Une question qui demande de filtrer, trier ou compter (« combien de contrats actifs avec tel client ? ») échoue avec de simples embeddings de texte, conçus pour retrouver du contenu proche, pas pour agréger.
Certaines questions résistent au découpage. Les requêtes à raisonnement multi-étapes, les requêtes vagues (difficiles à faire correspondre à des fragments précis), les requêtes longues ou complexes et les requêtes implicites restent des points faibles récurrents. Le chunking n’y change pas grand-chose ; il faut plutôt agir sur la requête ou le raisonnement.
Une taille, un modèle. Certains modèles d’embeddings fonctionnent mieux avec des fragments d’une taille précise, et le modèle doit rester strictement le même tout au long de l’application : en changer implique de recalculer tout l’index.
Les enrichissements se paient. Le résumé ajouté à chaque fragment et les techniques de pré-récupération introduisent un surcoût de calcul, de latence et de stockage à mettre en balance avec le gain attendu.
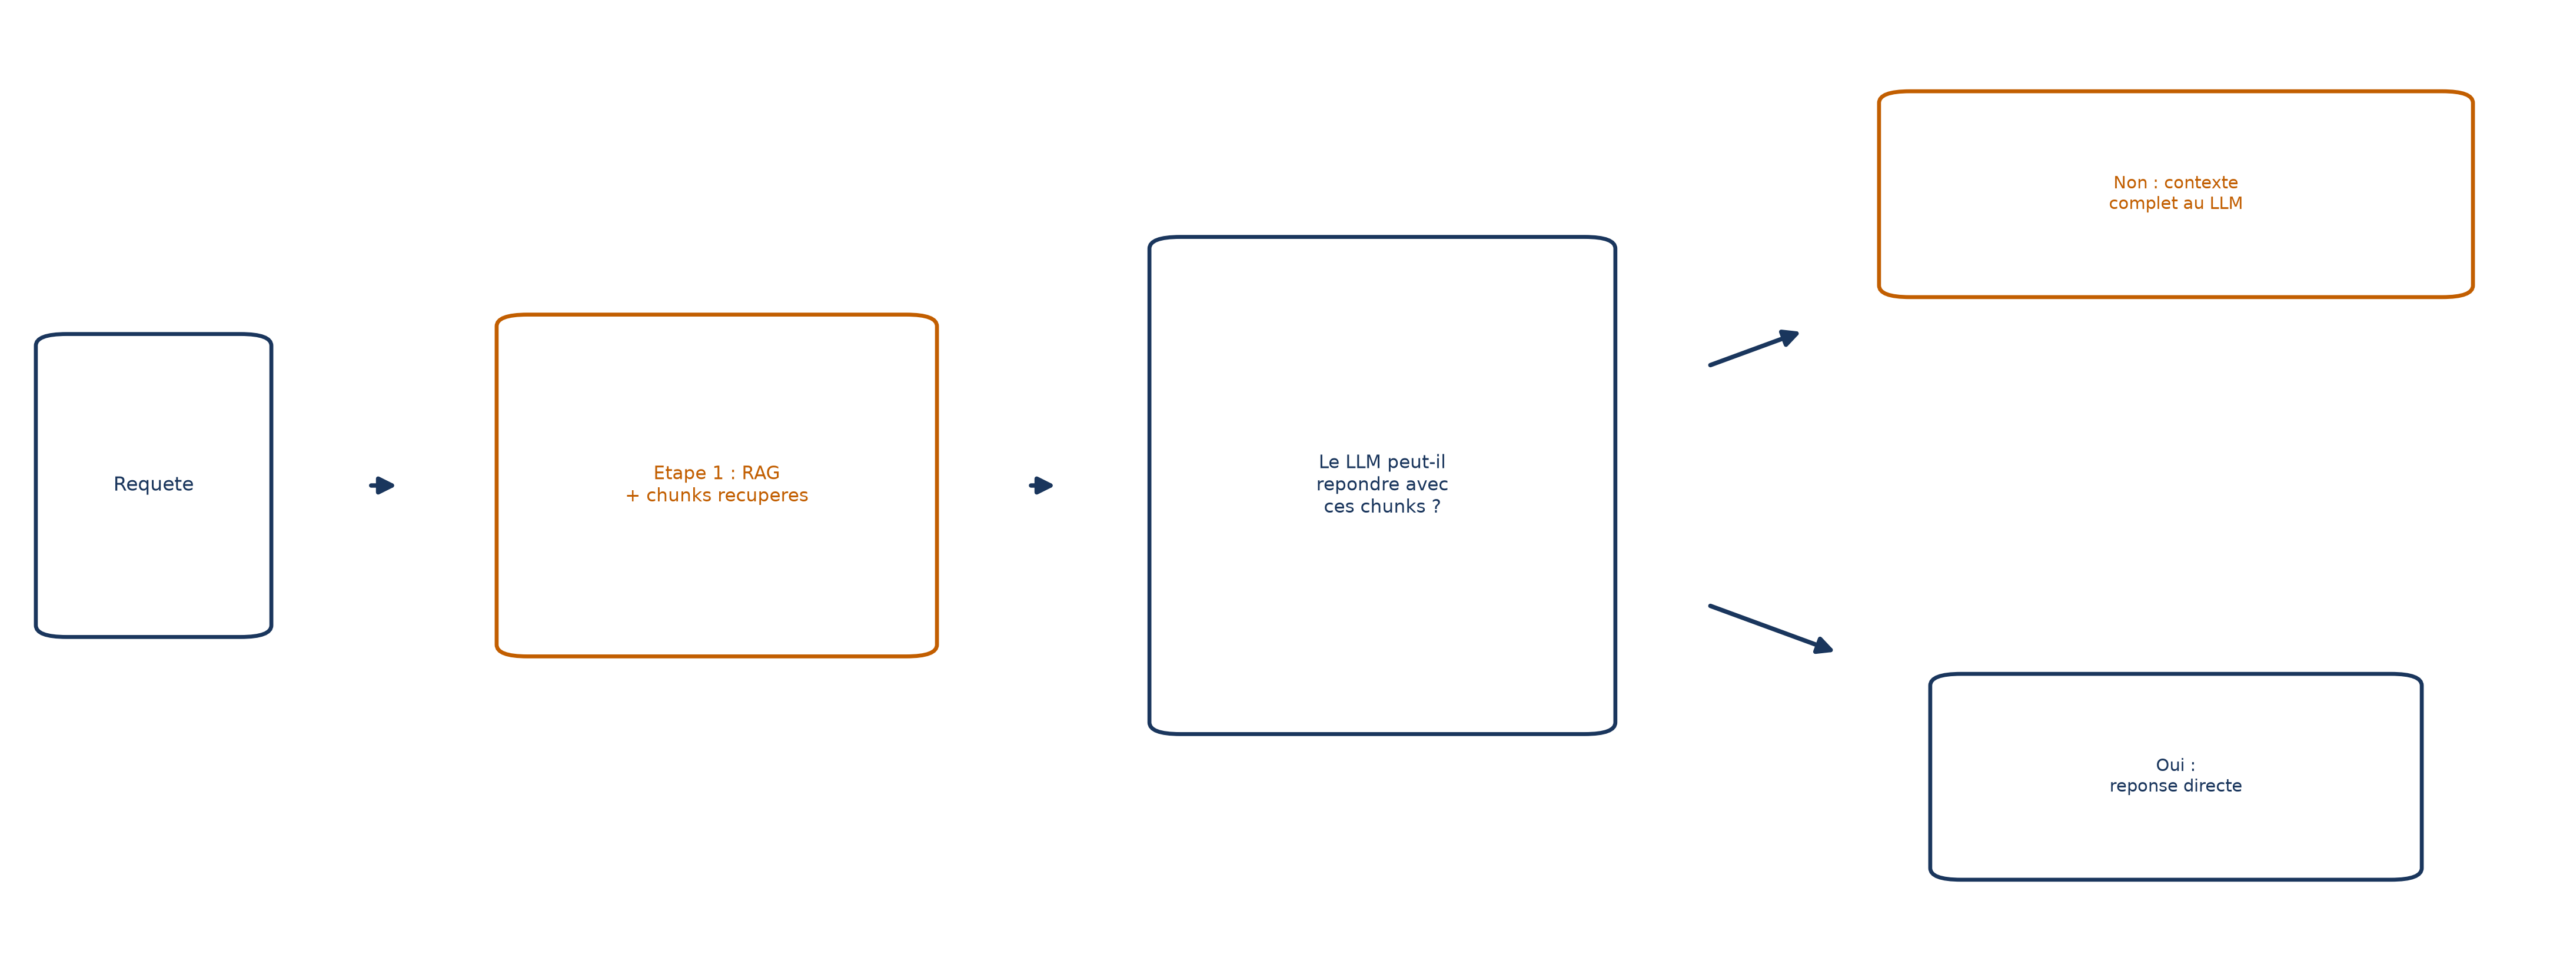
Et les très grandes fenêtres de contexte ? Elles permettent, pour des bases modestes, de transmettre tout le document sans découpage. Mais les études citées montrent un coût de calcul nettement supérieur, et rien ne garantit qu’un modèle repère l’unique élément pertinent dans une telle fenêtre. Le consensus décrit est qu’une architecture hybride garde sa valeur.
Aller plus loin
- Embedding : la représentation vectorielle qui rend un fragment comparable à une question ; sa qualité conditionne celle de ton découpage.
- Filtrage par métadonnées : restreindre la recherche par date, auteur ou catégorie avant la similarité, pour réduire le bruit.
- Re-classement : réordonner les documents récupérés pour prioriser les plus pertinents, utile en récupération hybride.
- Step-back prompting : élargir une question trop pointue pour améliorer le rappel de la recherche vectorielle.
Questions fréquentes
Faut-il encore découper avec des fenêtres d’un million de jetons ? Oui dans la plupart des cas : même quand le contexte peut absorber un article entier, on obtient de meilleurs résultats en le découpant en fragments de quelques centaines de caractères avec recouvrement.
Quel chevauchement choisir ? Il n’y a pas de règle chiffrée. Les exemples vus varient : 200 caractères pour 1 000, 40 pour 500 avec coupe sur les espaces, 40 mots pour des fragments de 1 000 mots.
Et pour l’audio, la vidéo, les images ? Après transcription en texte, le découpage reste proche de celui du texte. Sinon : détection d’activité vocale pour segmenter l’audio selon les silences, détection de changement de scène pour la vidéo, et les images ne sont généralement pas découpées.
À retenir
- Le bon découpage est celui qui place la réponse entière dans un fragment que le retriever peut faire ressembler à la question.
- Pars d’un découpage récursif ou structurel, puis redécoupe ce qui reste trop long : c’est ce que montrent les 231 puis 285 fragments de la page cricket.
- Si le contexte manque, cherche sur des fragments étroits et renvoie le parent.
- Mesure avec précision@k, rappel et surtout MRR, sur un jeu de questions qui grandit avec ton agent.
- Ne demande pas au découpage ce qu’il ne sait pas faire : filtres, comptages et raisonnements multi-étapes se règlent ailleurs.