Tu écris « merci, à demain » à un assistant documentaire, et il fouille toute sa base avant de te répondre. Un RAG de base cherche systématiquement, puis rédige sans évaluer ce qu’il a trouvé. Self-RAG confie ces deux décisions au modèle lui-même. À la fin, tu sauras le définir, nommer ses quatre jetons de réflexion et dire ce qu’il rapporte et ce qu’il coûte.
Sommaire
- L’essentiel en 30 secondes
- Un modèle qui se relit pendant qu’il écrit
- Quatre jetons, quatre questions
- Trois messages, quatre verdicts
- Ce que ça rapporte, ce que ça coûte
- Juge interne ou juge externe : Self-RAG et ses voisins
- Trois malentendus à écarter
L’essentiel en 30 secondes
- Self-RAG, ou RAG auto-réflexif, entraîne le LLM lui-même à se critiquer pendant qu’il répond.
- Le modèle émet quatre jetons de réflexion : récupération, pertinence, support, utilité.
- Gain annoncé : moins de recherches superflues et une meilleure précision factuelle.
- Contrepartie : plus de calcul et des seuils de décision à régler finement.
- Il appartient à la récupération adaptative, avec un juge intégré au modèle plutôt qu’un module à part.
Un modèle qui se relit pendant qu’il écrit
Dans un RAG de base, les deux composants principaux, l’embedder et le LLM, restent gelés : ce sont des modèles pré-entraînés dont on exploite les capacités telles quelles. Self-RAG fait le contraire sur un point précis. Il entraîne le LLM à utiliser des « jetons de réflexion », des jetons qui servent à surveiller son propre processus et qui l’obligent à une forme d’introspection.
Le préfixe Self désigne celui qui fait la critique : c’est le modèle qui réfléchit à ce qu’il génère et juge sa sortie sous deux angles, la factualité et la qualité globale.
Cette idée s’inscrit dans la récupération adaptative, où le LLM décide lui-même du moment et du contenu de la recherche. Ici, les jetons lui permettent de trancher s’il a besoin de récupérer davantage d’information.
Quatre jetons, quatre questions
Chaque jeton porte une question que le modèle se pose à un moment précis de son travail :
| Jeton | La question que le modèle se pose | Ce qu’il juge |
|---|---|---|
| Récupération | Ai-je besoin d’aller chercher quelque chose ? | La nécessité d’une recherche |
| Pertinence | Ce passage m’aide-t-il vraiment ? | Un passage récupéré |
| Support | Ma réponse s’appuie-t-elle sur ce passage ? | Le lien entre la réponse et le contenu récupéré |
| Utilité | Cette réponse est-elle bonne ? | La réponse elle-même |
Quatre jetons, donc deux pour la recherche, deux pour la réponse. Les deux premiers demandent s’il faut la lancer et si ce qui revient en vaut la peine. Les deux derniers demandent si la réponse est ancrée dans un passage et si elle sert celui qui a posé la question.
💡 Intuition Le jeton de support pose en cours de route la question que l’évaluation d’un RAG pose après coup sous le nom de fidélité : ce qui est écrit repose-t-il bien sur les passages retenus ? Self-RAG fait entrer ce contrôle dans la génération elle-même.
Trois messages, quatre verdicts
Prenons un assistant interne d’entreprise et trois messages du même utilisateur. Cette scène est inventée pour fixer les idées ; ce n’est pas la trace d’une exécution réelle.
« Merci, à demain »
Rien à chercher ici. Le jeton de récupération est celui qui indique si une récupération est nécessaire : le modèle peut répondre directement, et il n’y a aucun passage à juger.
« Comment demander le remboursement d’une note de frais ? »
Cette fois, une recherche s’impose, et deux passages reviennent : l’un décrit la procédure de remboursement, l’autre parle des congés. Le jeton de pertinence évalue chaque passage et peut écarter le second. Le modèle rédige alors sa réponse, le jeton de support vérifie qu’elle s’appuie sur le passage retenu, et le jeton d’utilité note le résultat.
Une question dont la base ne dit rien
La recherche remonte des passages voisins mais sans rapport. C’est le cas où le jeton de pertinence et le jeton de support servent le plus : le premier juge que le contexte ne convient pas, le second signale toute réponse qui ne reposerait sur rien de ce qui a été récupéré.
Ce que ça rapporte, ce que ça coûte
Cette auto-critique en continu réduit les récupérations superflues : le modèle ne cherche que lorsque le jeton de récupération le demande. Elle améliore aussi la précision factuelle, puisque chaque passage et chaque réponse passent au crible.
La facture a deux lignes. La première est une demande de calcul plus élevée, car le modèle produit des jugements en plus de sa réponse. La seconde est un réglage fin des seuils de décision : le gain ne vient pas tout seul, il se règle.
Reste un coût moins visible : l’entraînement du LLM lui-même. Les approches de base y échappent en gardant embedder et LLM gelés.
Juge interne ou juge externe : Self-RAG et ses voisins
Pour situer Self-RAG, regarde qui tient le rôle de juge. Les trois façons de répéter une recherche se distinguent par ce critère.
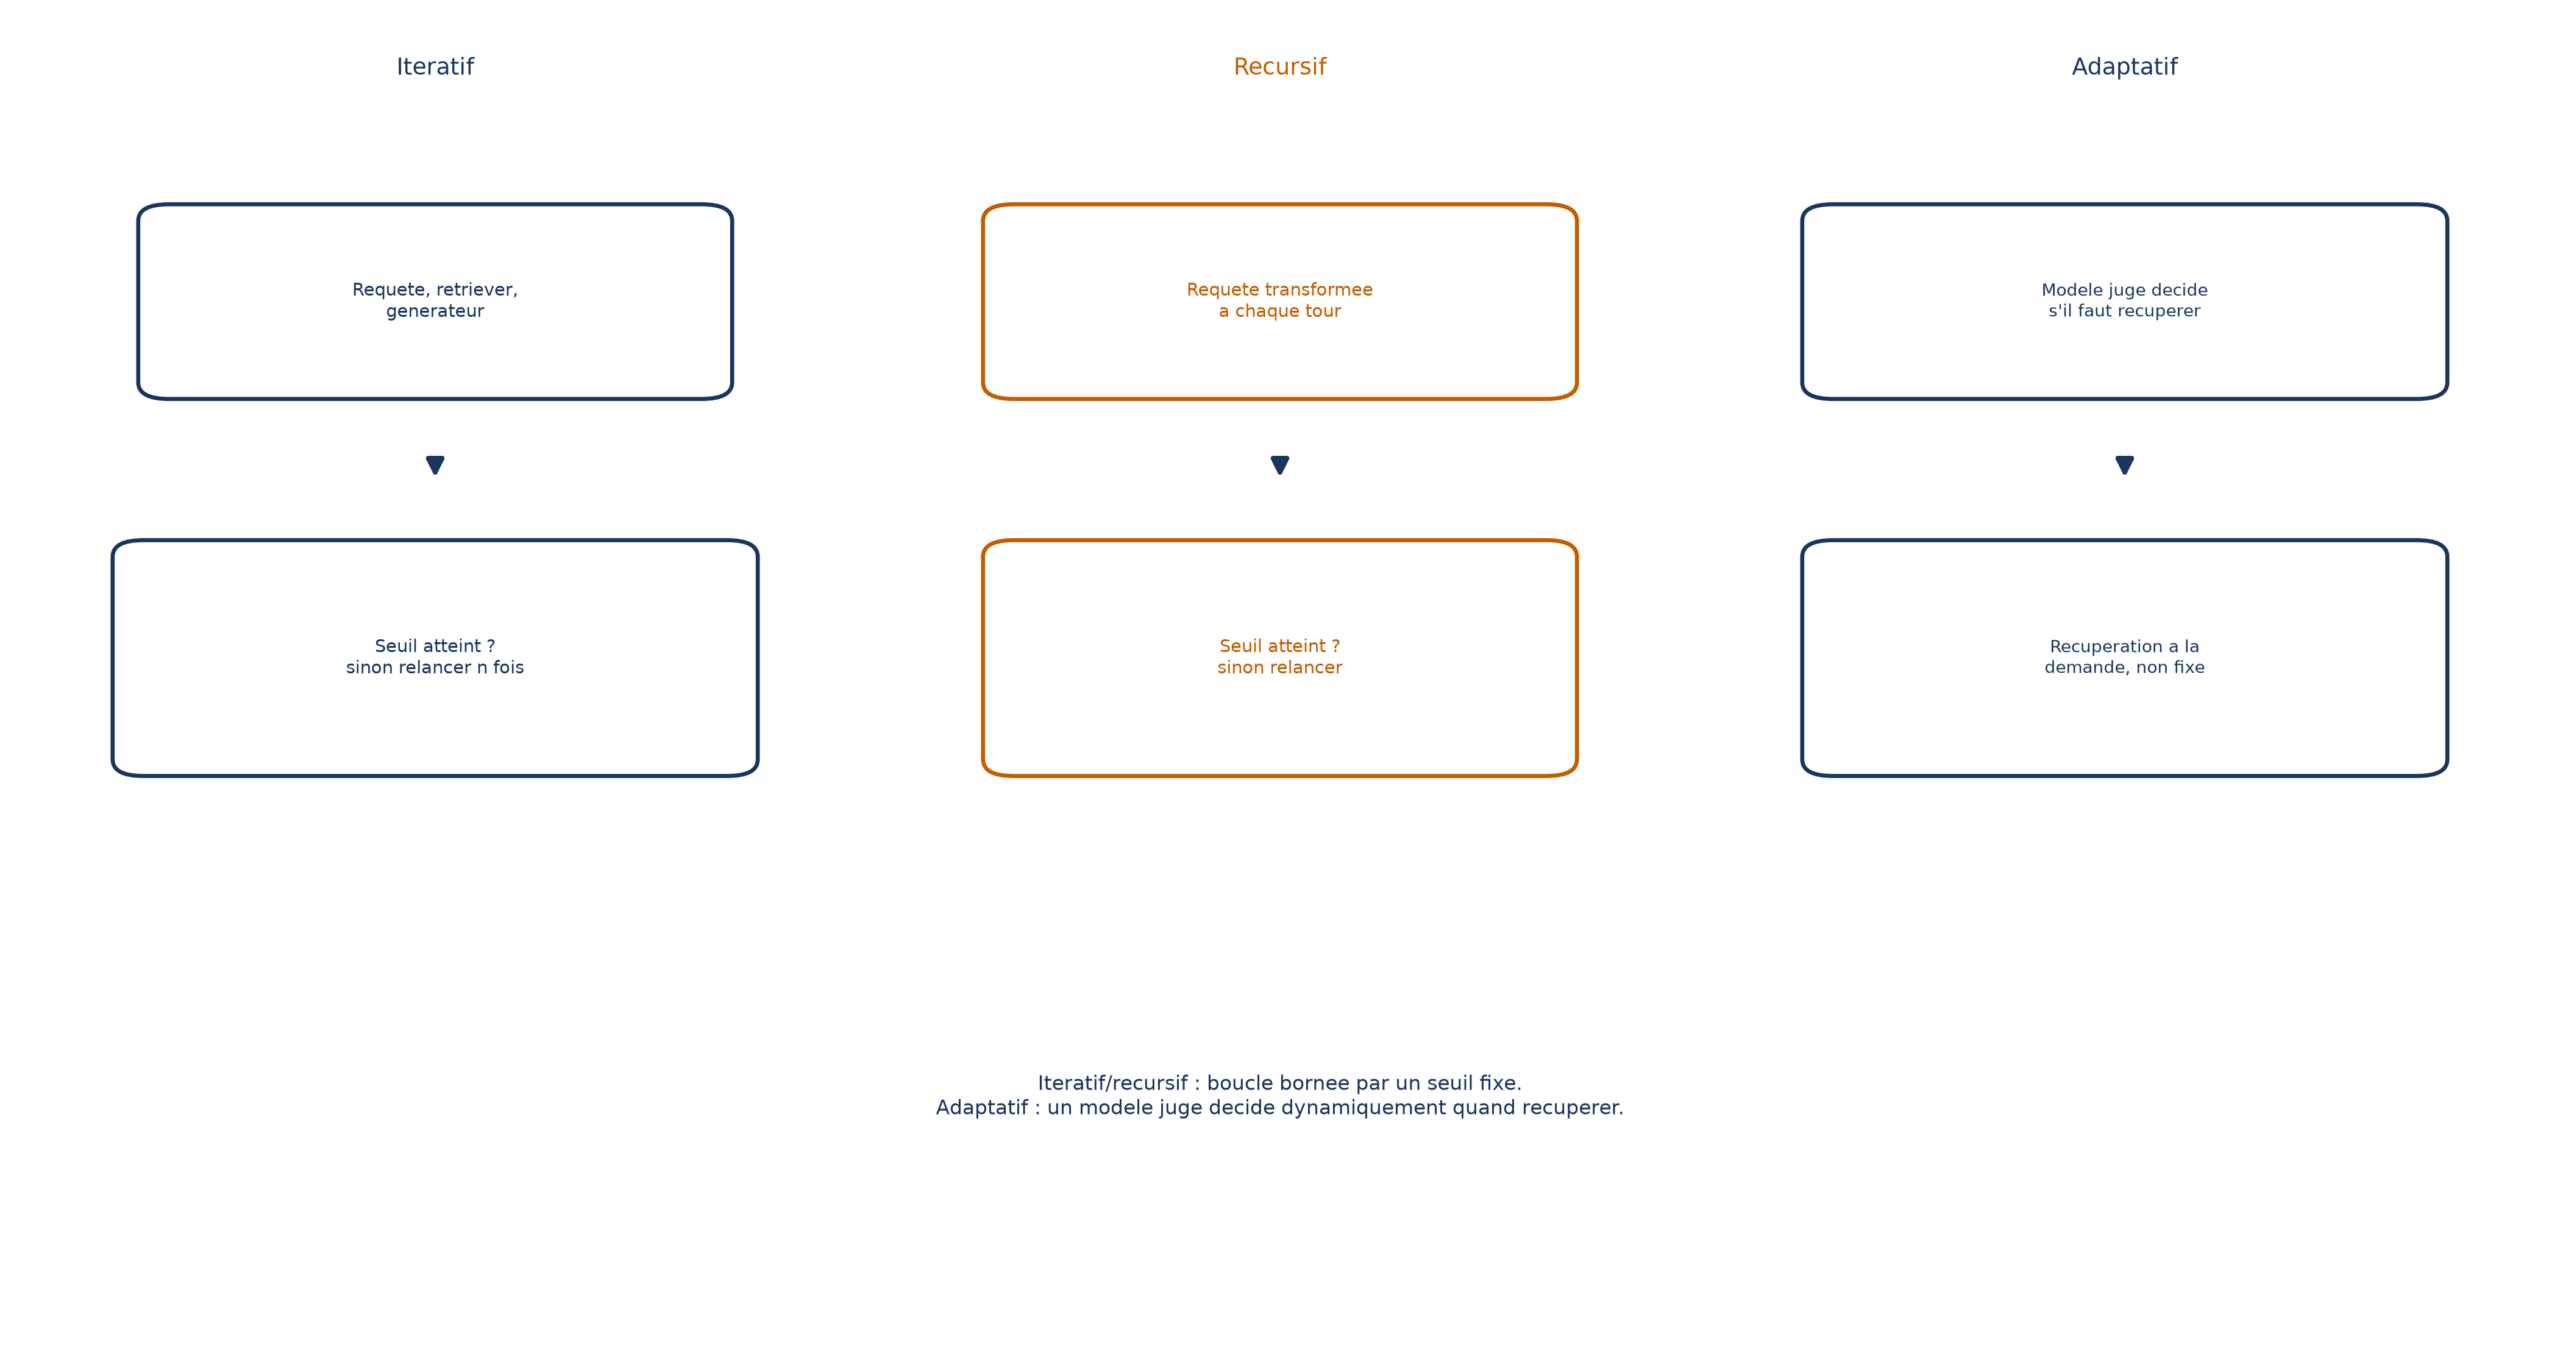
FLARE suit une autre piste dans la même colonne : il analyse la confiance du modèle pendant la génération et déclenche la recherche quand elle tombe sous un certain seuil. Self-RAG, lui, demande au modèle de dire explicitement ce qu’il décide.
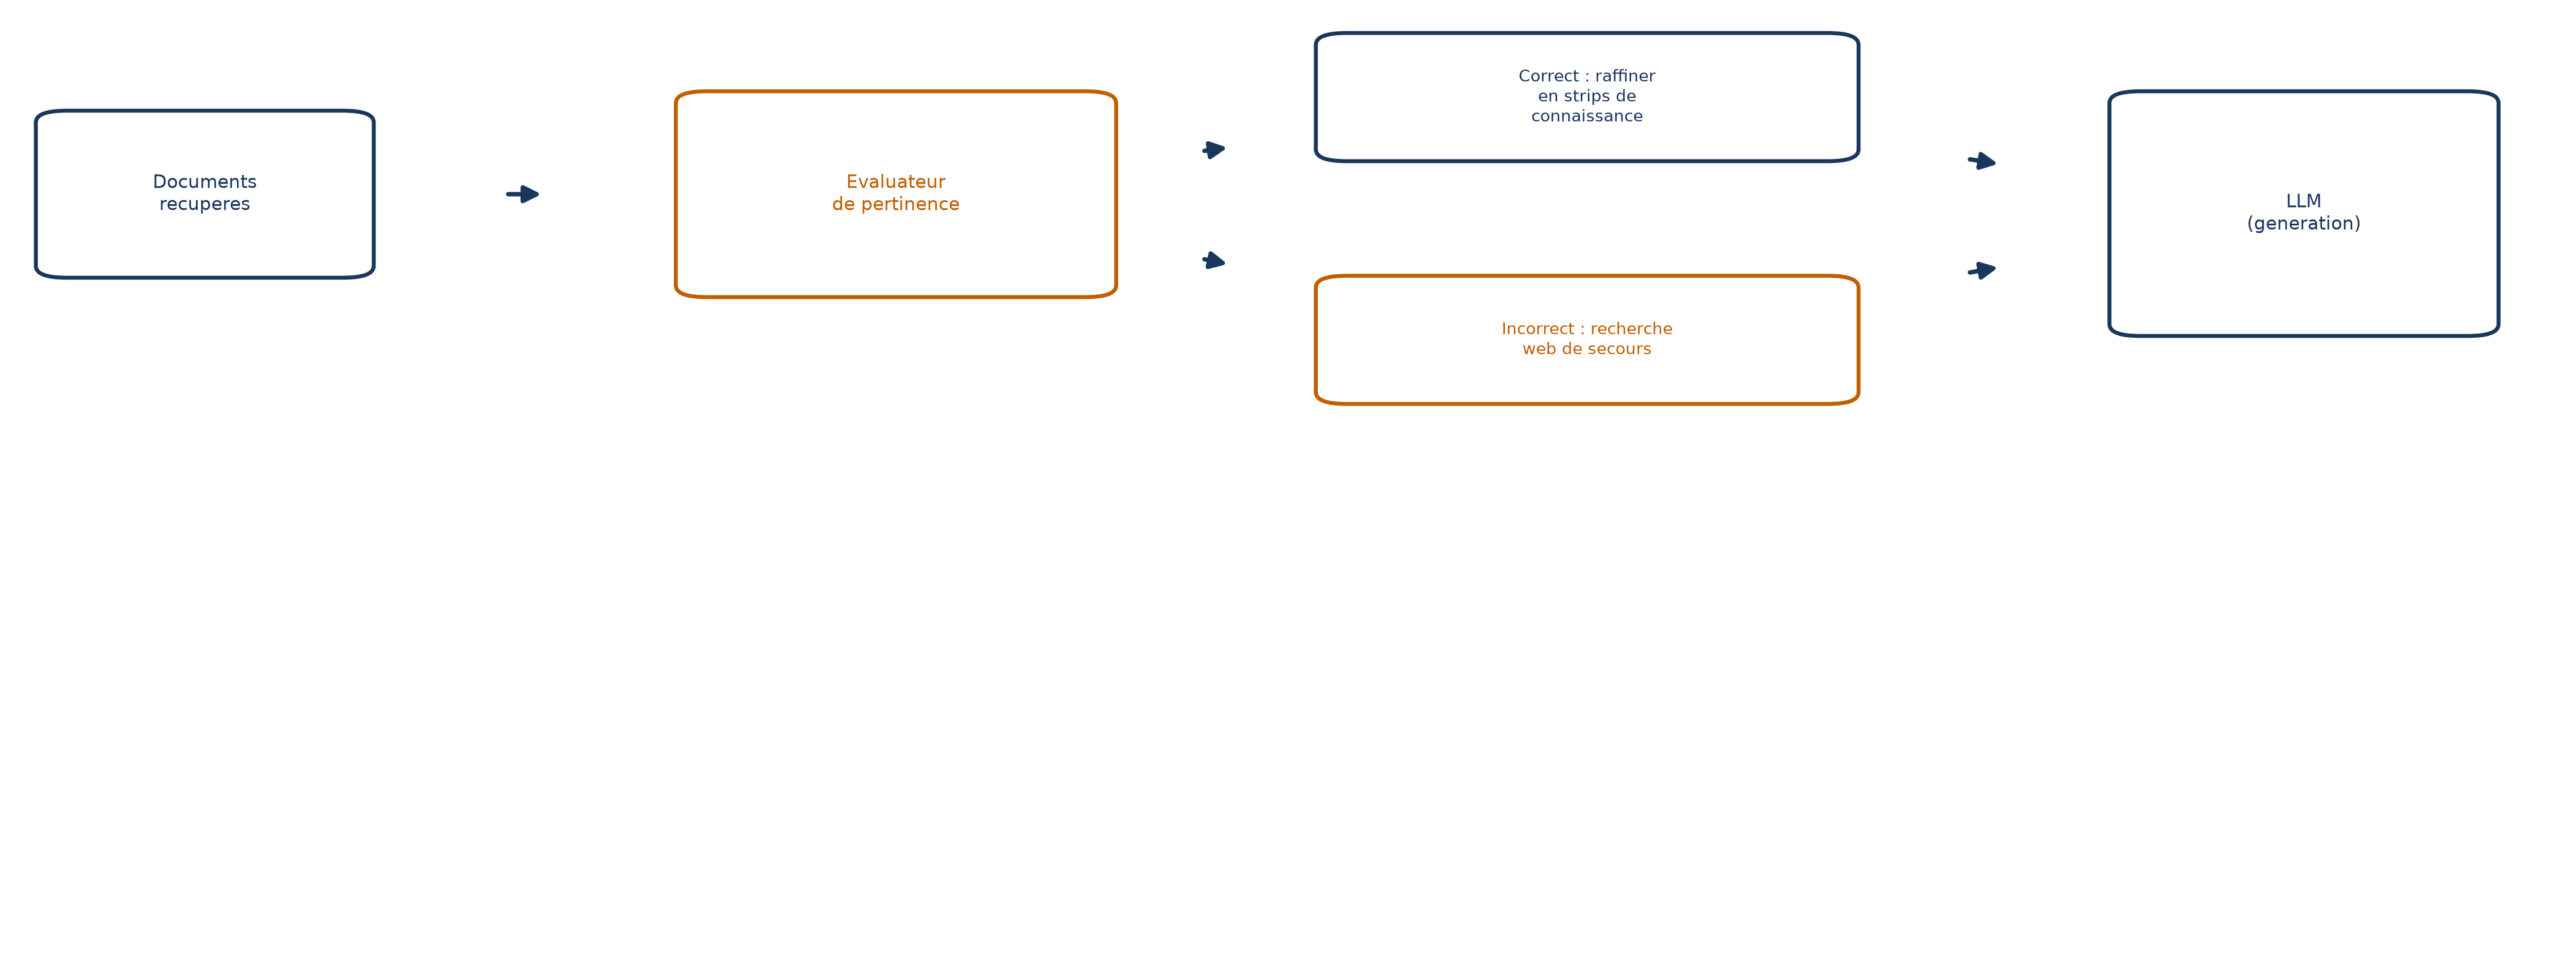
Le contraste le plus net est avec CRAG, qui cible la fiabilité factuelle là où Self-RAG vise l’adaptabilité. CRAG place un évaluateur léger, un modèle T5 ajusté, entre la recherche et la génération : chaque document est classé correct, incorrect ou ambigu, et un document incorrect déclenche une recherche web de secours.
| Self-RAG | CRAG | |
|---|---|---|
| Qui juge | Le LLM lui-même, entraîné à émettre des jetons | Un évaluateur léger, séparé du générateur |
| Ce qui est jugé | Le besoin de chercher, chaque passage, le soutien et l’utilité de la réponse | Chaque document récupéré (correct, incorrect, ambigu) |
| Contrepartie signalée | Plus de calcul, seuils à régler finement | Latence accrue, dépendance à la qualité de l’évaluateur |
Trois malentendus à écarter
« C’est un RAG avec une consigne plus maline »
Non : Self-RAG touche au modèle. Il entraîne le LLM à produire ses jetons de réflexion, alors qu’un RAG de base laisse ses composants gelés. Ce n’est donc pas une astuce de formulation qu’on ajoute au prompt.
« Le modèle cherche toujours, ou ne cherche jamais »
Ni l’un ni l’autre. C’est le jeton de récupération qui indique, au cas par cas, si une recherche est nécessaire. Cette décision est l’une des quatre que le modèle exprime.
« S’auto-critiquer garantit une réponse juste »
Le gain annoncé est une amélioration de la précision factuelle, pas une garantie. Il s’accompagne d’une demande de calcul plus élevée et de seuils qu’il faut régler finement.
📌 À retenir Self-RAG se résume à une phrase : un LLM entraîné à dire, par quatre jetons, s’il doit chercher, si le passage sert, si sa réponse est soutenue et si elle est utile. Son atout est la décision prise par le modèle lui-même ; son prix, l’entraînement et le réglage.