Un directeur marketing te demande si augmenter le budget publicitaire fait vraiment vendre plus, et de combien exactement. Pas une impression, un chiffre. Tu as des données : les budgets télé, radio et presse de 200 marchés, et les ventes qui en ont résulté dans chacun. À la fin de cet article, tu sauras reconnaître, face à un problème comme celui-ci, si la régression linéaire est le bon outil — et repérer les cas où t’y accrocher te ferait dire n’importe quoi.
L’essentiel en 30 secondes
- La régression linéaire répond à une question précise : prédire une valeur numérique continue (des ventes, un prix, une consommation) à partir d’une ou plusieurs variables.
- Elle suppose qu’il existe, au moins approximativement, une relation linéaire entre la variable à prédire et ses prédicteurs.
- Elle s’étend sans peine à plusieurs prédicteurs, aux variables qualitatives, et même aux interactions entre eux.
- Elle ne convient pas à une réponse qualitative (oui/non, catégorie) ni à un comptage : d’autres membres de la même famille de modèles prennent alors le relais.
- Elle repose sur des hypothèses (linéarité, indépendance, variance constante, absence de colinéarité extrême) qu’il faut vérifier avant de faire confiance aux résultats.
L’intuition : la question à laquelle répond une droite
Reprends les données du directeur marketing : 200 marchés, chacun avec un budget télé, radio, presse, et des ventes observées. La régression linéaire simple pose une question précise : existe-t-il une droite qui, à partir d’un seul de ces budgets — la télé, disons — permet de prédire les ventes ?
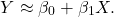
Ici  représente les ventes,
 le budget télé,
 l’ordonnée à l’origine (les ventes qu’on prédirait à budget nul) et
 la pente (le supplément de ventes pour chaque dollar de budget en plus). On dit qu’on « régresse Y sur X » (certains ouvrages notent ces coefficients
 et
 , mais l’idée reste identique).
💡 Intuition La méthode des moindres carrés date du début du dix-neuvième siècle, appliquée d’abord à des problèmes d’astronomie : ce n’est pas une invention récente du machine learning, mais l’un des outils les plus anciens de la statistique.
Sous le capot : une droite, plusieurs prédicteurs
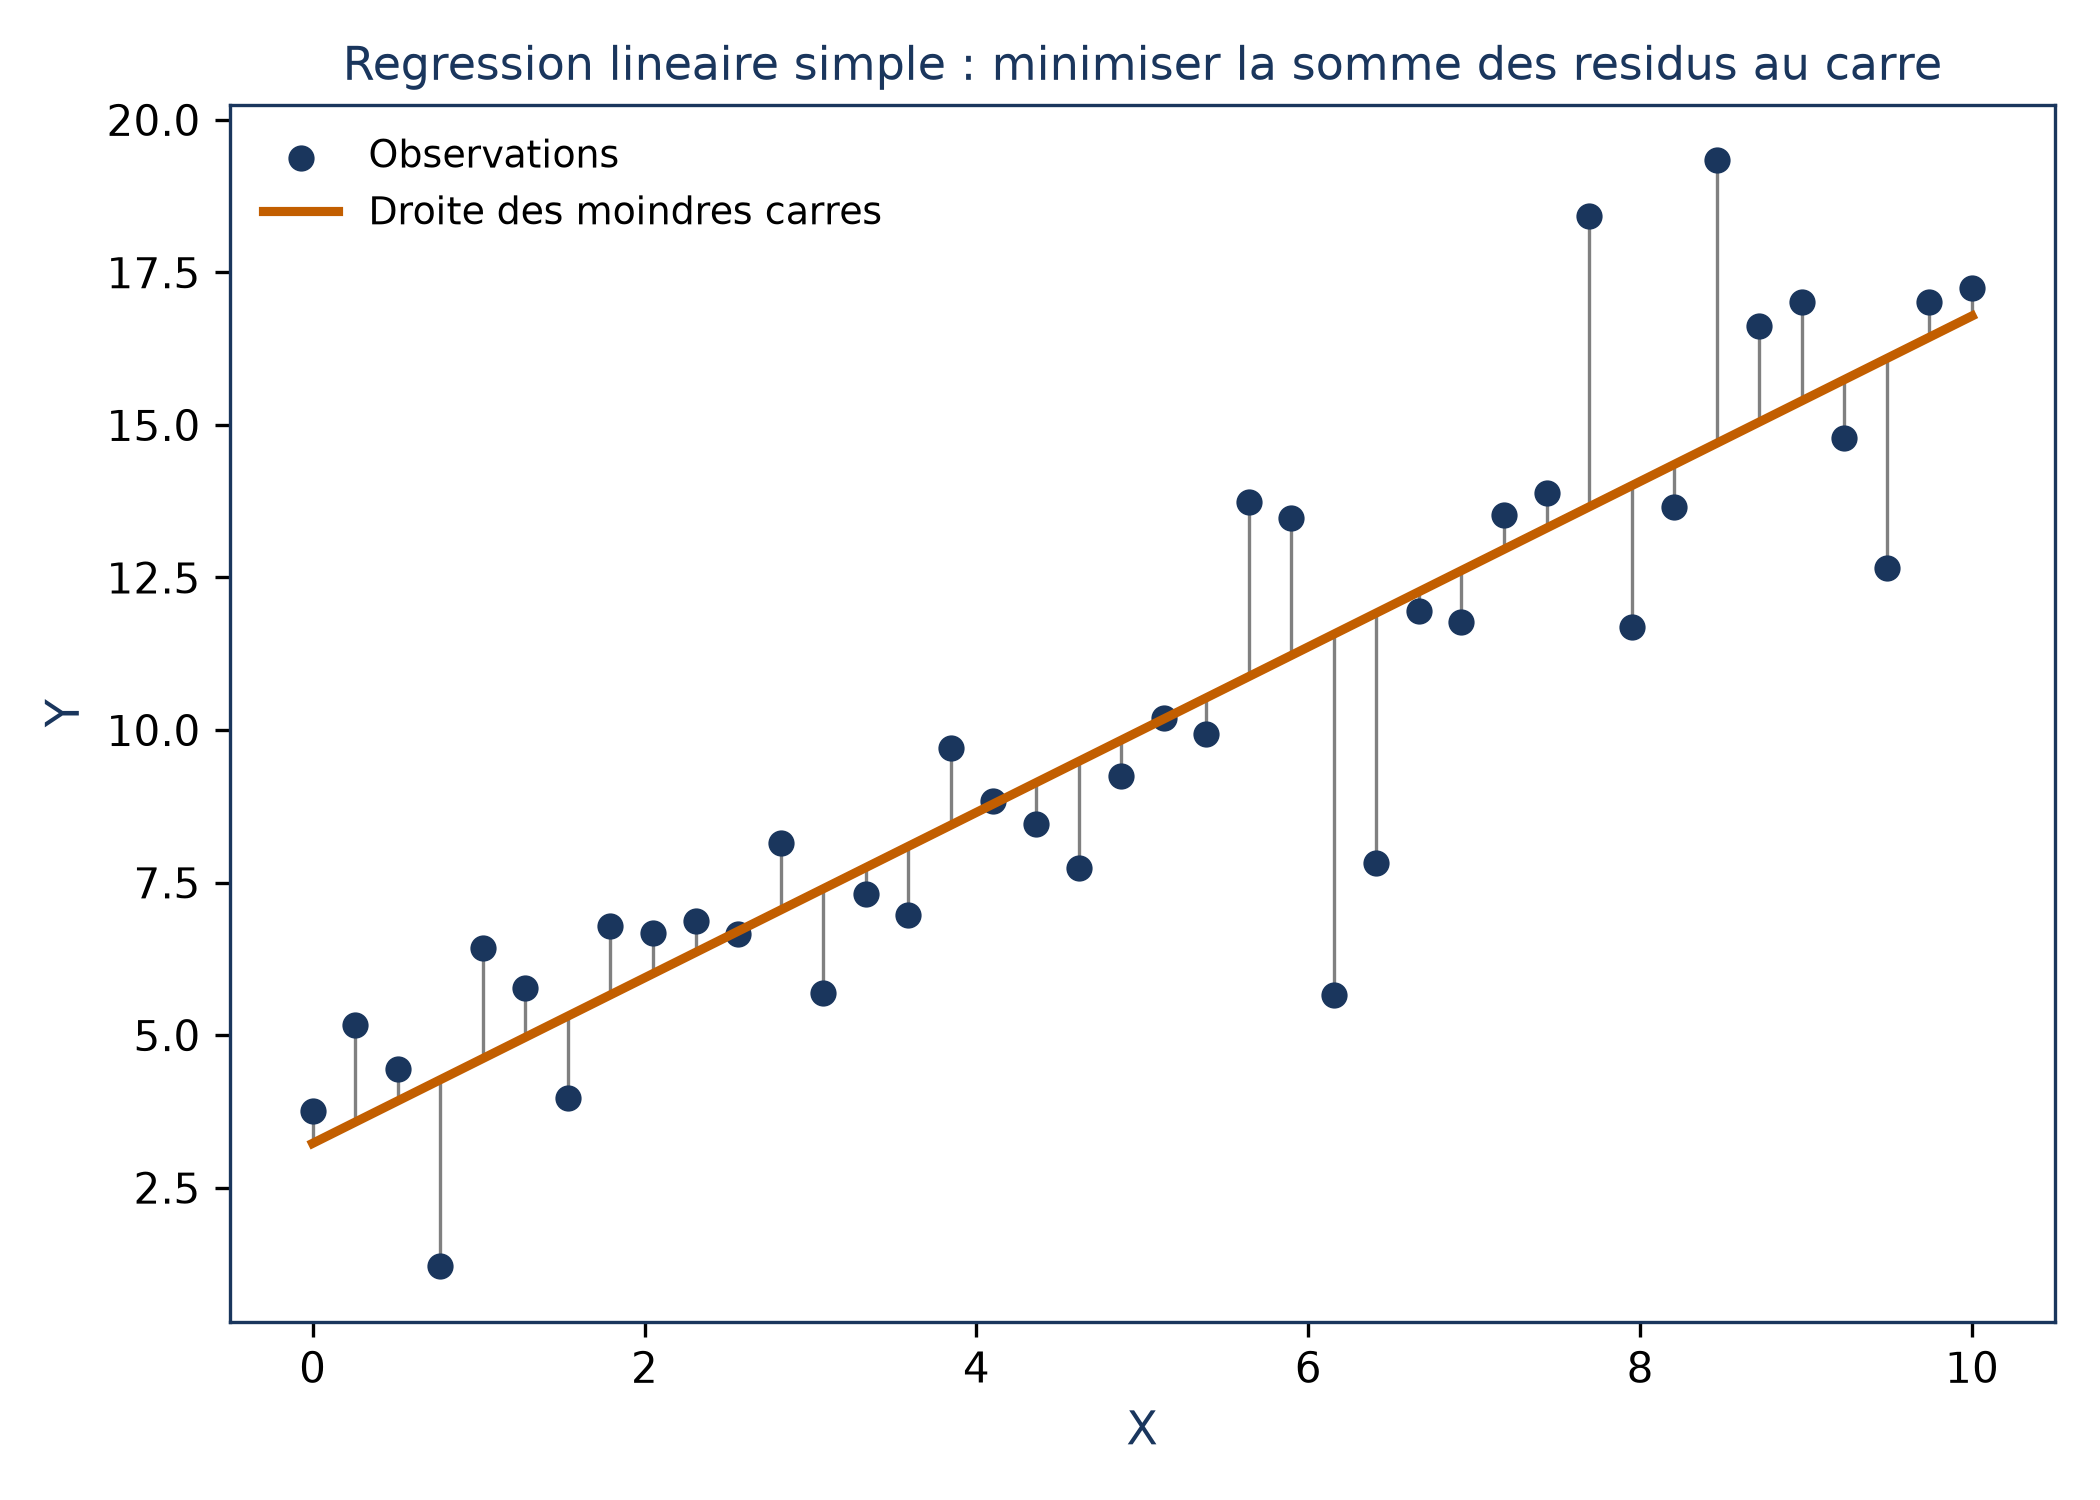
Pour départager les droites possibles, on ne peut pas simplement sommer les écarts signés (les erreurs positives et négatives s’annuleraient, masquant un mauvais ajustement). La solution retenue consiste à sommer leurs carrés :
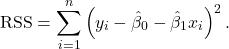
RSS (residual sum of squares) mesure l’écart total entre les ventes observées  et celles que prédit le modèle. La minimiser donne des formules explicites pour les coefficients :
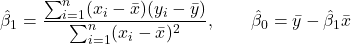
La pente  est le rapport entre la covariance de et et la variance de ; l’ordonnée
 s’en déduit à partir des moyennes. Pour les données publicitaires, cette procédure donne
 et
 : chaque tranche de 1 000 $ dépensée en télé est associée, en moyenne, à environ 47,5 unités de ventes supplémentaires.
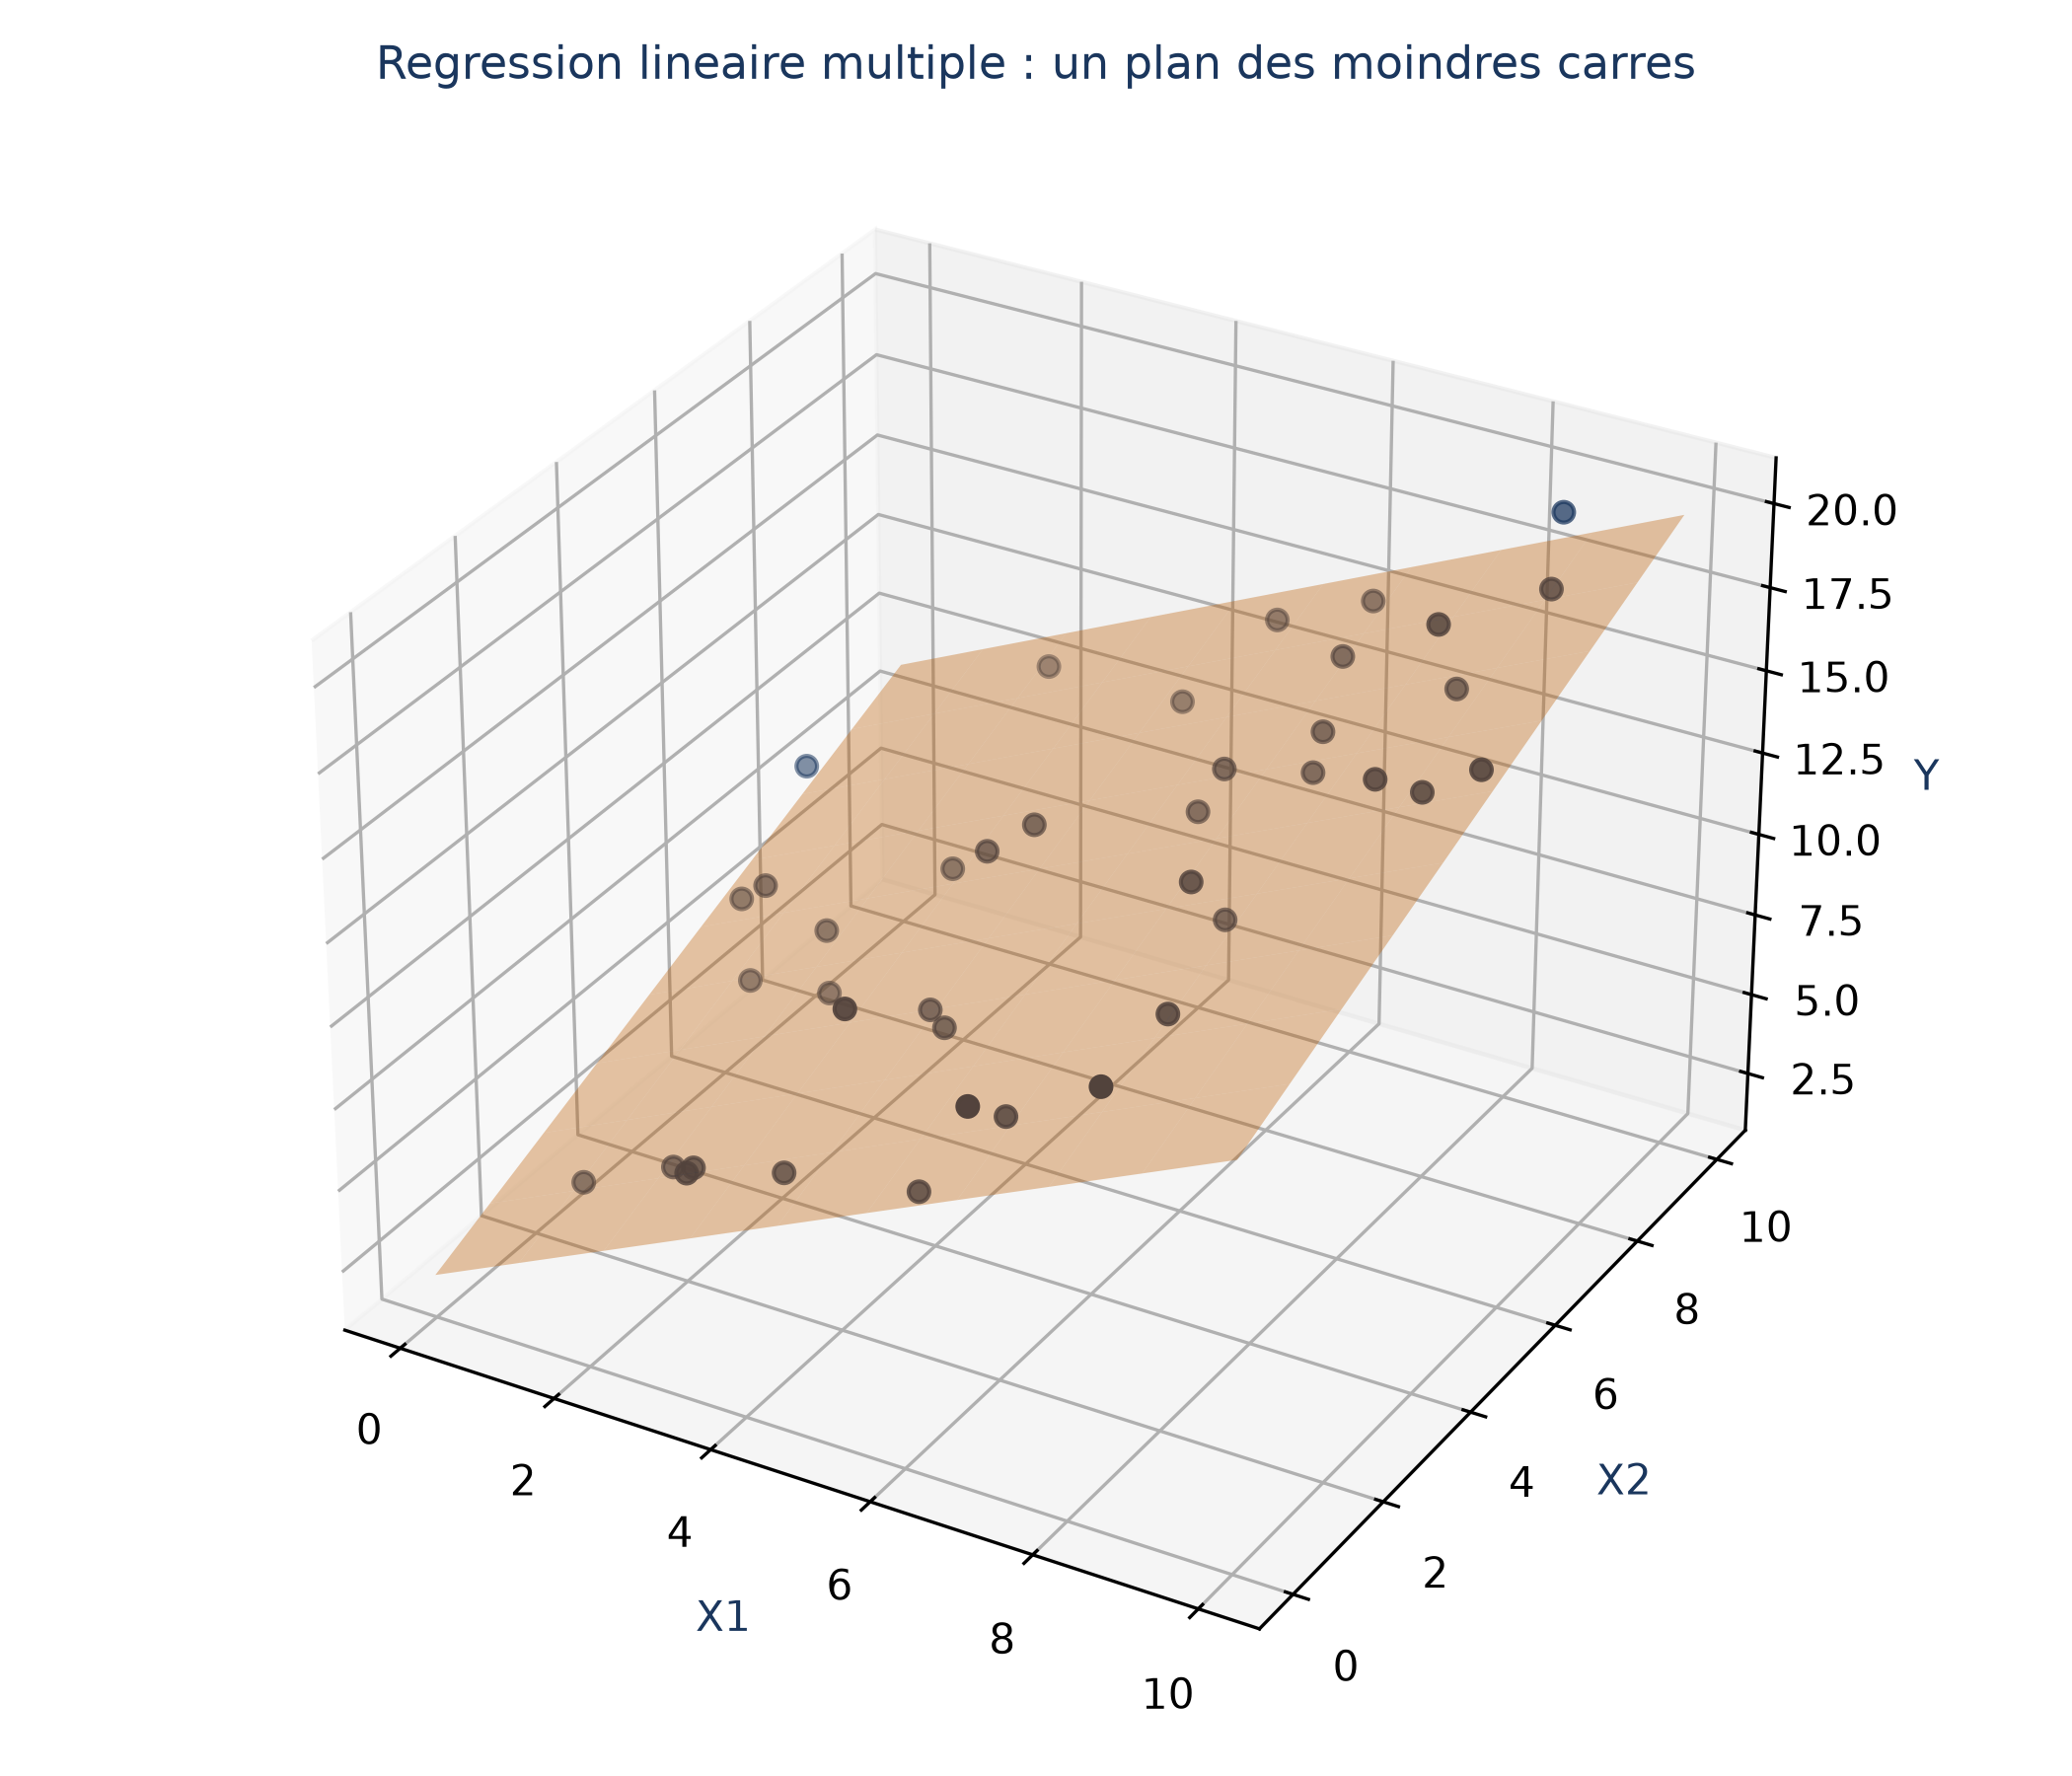
Rien n’empêche d’ajouter les autres budgets à la même équation, chacun avec sa propre pente :
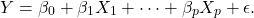
Chaque  s’interprète comme l’effet moyen d’une hausse d’une unité de
 , toutes choses égales par ailleurs. En pratique, un logiciel calcule toujours ces coefficients : la formule explicite devient vite complexe au-delà d’un ou deux prédicteurs.
Le voir tourner : prédire un prix immobilier
Un acheteur te demande si un quartier plus pauvre se traduit vraiment par des logements moins chers, et de combien exactement — la même question que le directeur marketing, posée cette fois sur l’immobilier plutôt que sur la publicité. Les données Boston recensent la valeur médiane des logements (medv) dans 506 quartiers, avec des prédicteurs comme lstat (le pourcentage de ménages à statut socio-économique modeste dans le quartier) ou age (la proportion de logements construits avant 1940).
Le code ci-dessous vient d’une session Jupyter : chaque In [n]: est une commande tapée, chaque Out[n]: le résultat que Python renvoie. On charge d’abord les données, puis on construit la matrice X que le modèle va ajuster — avec, en première colonne, une colonne de 1 qui joue exactement le rôle de l’ordonnée à l’origine vue plus haut.
In [8]: Boston = load_data("Boston")
        Boston.columns
Out[8]: Index(['crim', 'zn', 'indus', 'chas', 'nox', 'rm', 'age', 'dis',
        'rad', 'tax', 'ptratio', 'black', 'lstat', 'medv'],
       dtype='object')

In [9]: X = pd.DataFrame({'intercept': np.ones(Boston.shape[0]),
                            'lstat': Boston['lstat']})
        X[:4]

In [10]: y = Boston['medv']
         model = sm.OLS(y, X)
         results = model.fit()

In [11]: summarize(results)
Out[11]:
                    coef  std err  t  P>|t|
intercept  34.5538  0.563  61.415  0.0
lstat  -0.9500  0.039 -24.528  0.0
sm.OLS() spécifie le modèle avec la variable réponse y et la matrice X construite juste avant, model.fit() réalise l’ajustement — exactement les mêmes moindres carrés que pour le budget publicitaire, appliqués cette fois à lstat et medv. Réponse à la question de l’acheteur : chaque point de pourcentage supplémentaire de ménages modestes dans le quartier est associé à une baisse d’environ 0,95 point de la valeur médiane du logement.
Le taux de pauvreté du quartier n’est sans doute pas le seul facteur en jeu — l’ancienneté du bâti pourrait aussi compter. Passer à plusieurs prédicteurs ne change presque rien à la syntaxe :
In [25]: X = MS(['lstat', 'age']).fit_transform(Boston)
         model1 = sm.OLS(y, X)
         results1 = model1.fit()
         summarize(results1)
Out[25]:
                coef  std err  t  P>|t|
intercept  33.2228  0.731  45.458  0.000
lstat  -1.0321  0.048 -21.416  0.000
age  0.0345  0.012  2.826  0.005

In [29]: vals = [VIF(X, i)
                  for i in range(1, X.shape[1])]
         vif = pd.DataFrame({'vif':vals},
                              index=X.columns[1:])
Résultat : le coefficient de lstat bouge légèrement une fois age pris en compte (de −0,95 à −1,03) — signe que les deux prédicteurs se recoupent partiellement. Le facteur d’inflation de la variance (VIF) calculé ici sert justement à diagnostiquer ce problème classique quand on ajoute des prédicteurs réels : la colinéarité, sur laquelle on revient plus bas.
Lire les résultats : R² et effets croisés
Pour juger la qualité d’un ajustement, le coefficient de détermination exprime la part de variabilité expliquée, toujours entre 0 et 1 :
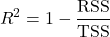
Pour les données publicitaires, le R² de la régression des ventes sur le seul budget télé vaut 0,61 : un peu moins des deux tiers de la variabilité des ventes s’expliquent par la seule télévision.
📌 À retenir Un R² proche de 1 signifie un modèle qui explique bien les données observées ; proche de 0, un modèle qui ne fait guère mieux que de prédire systématiquement la moyenne.
C’est là qu’un second prédicteur devient intéressant. Le modèle linéaire standard suppose l’additivité : l’effet d’un budget ne dépend pas des autres. Ajouter un terme d’interaction assouplit cette hypothèse — et change tout : sur les données publicitaires, ajouter une interaction entre télévision et radio fait grimper le R² de 89,7 % à 96,8 %. C’est le signe d’une réelle synergie entre les deux médias : répartir un même budget entre les deux rapporte davantage que de le concentrer sur un seul.
Le même mécanisme se retrouve dans un tout autre domaine, le crédit : le revenu et le statut étudiant interagissent sur le solde de carte de crédit d’un client.
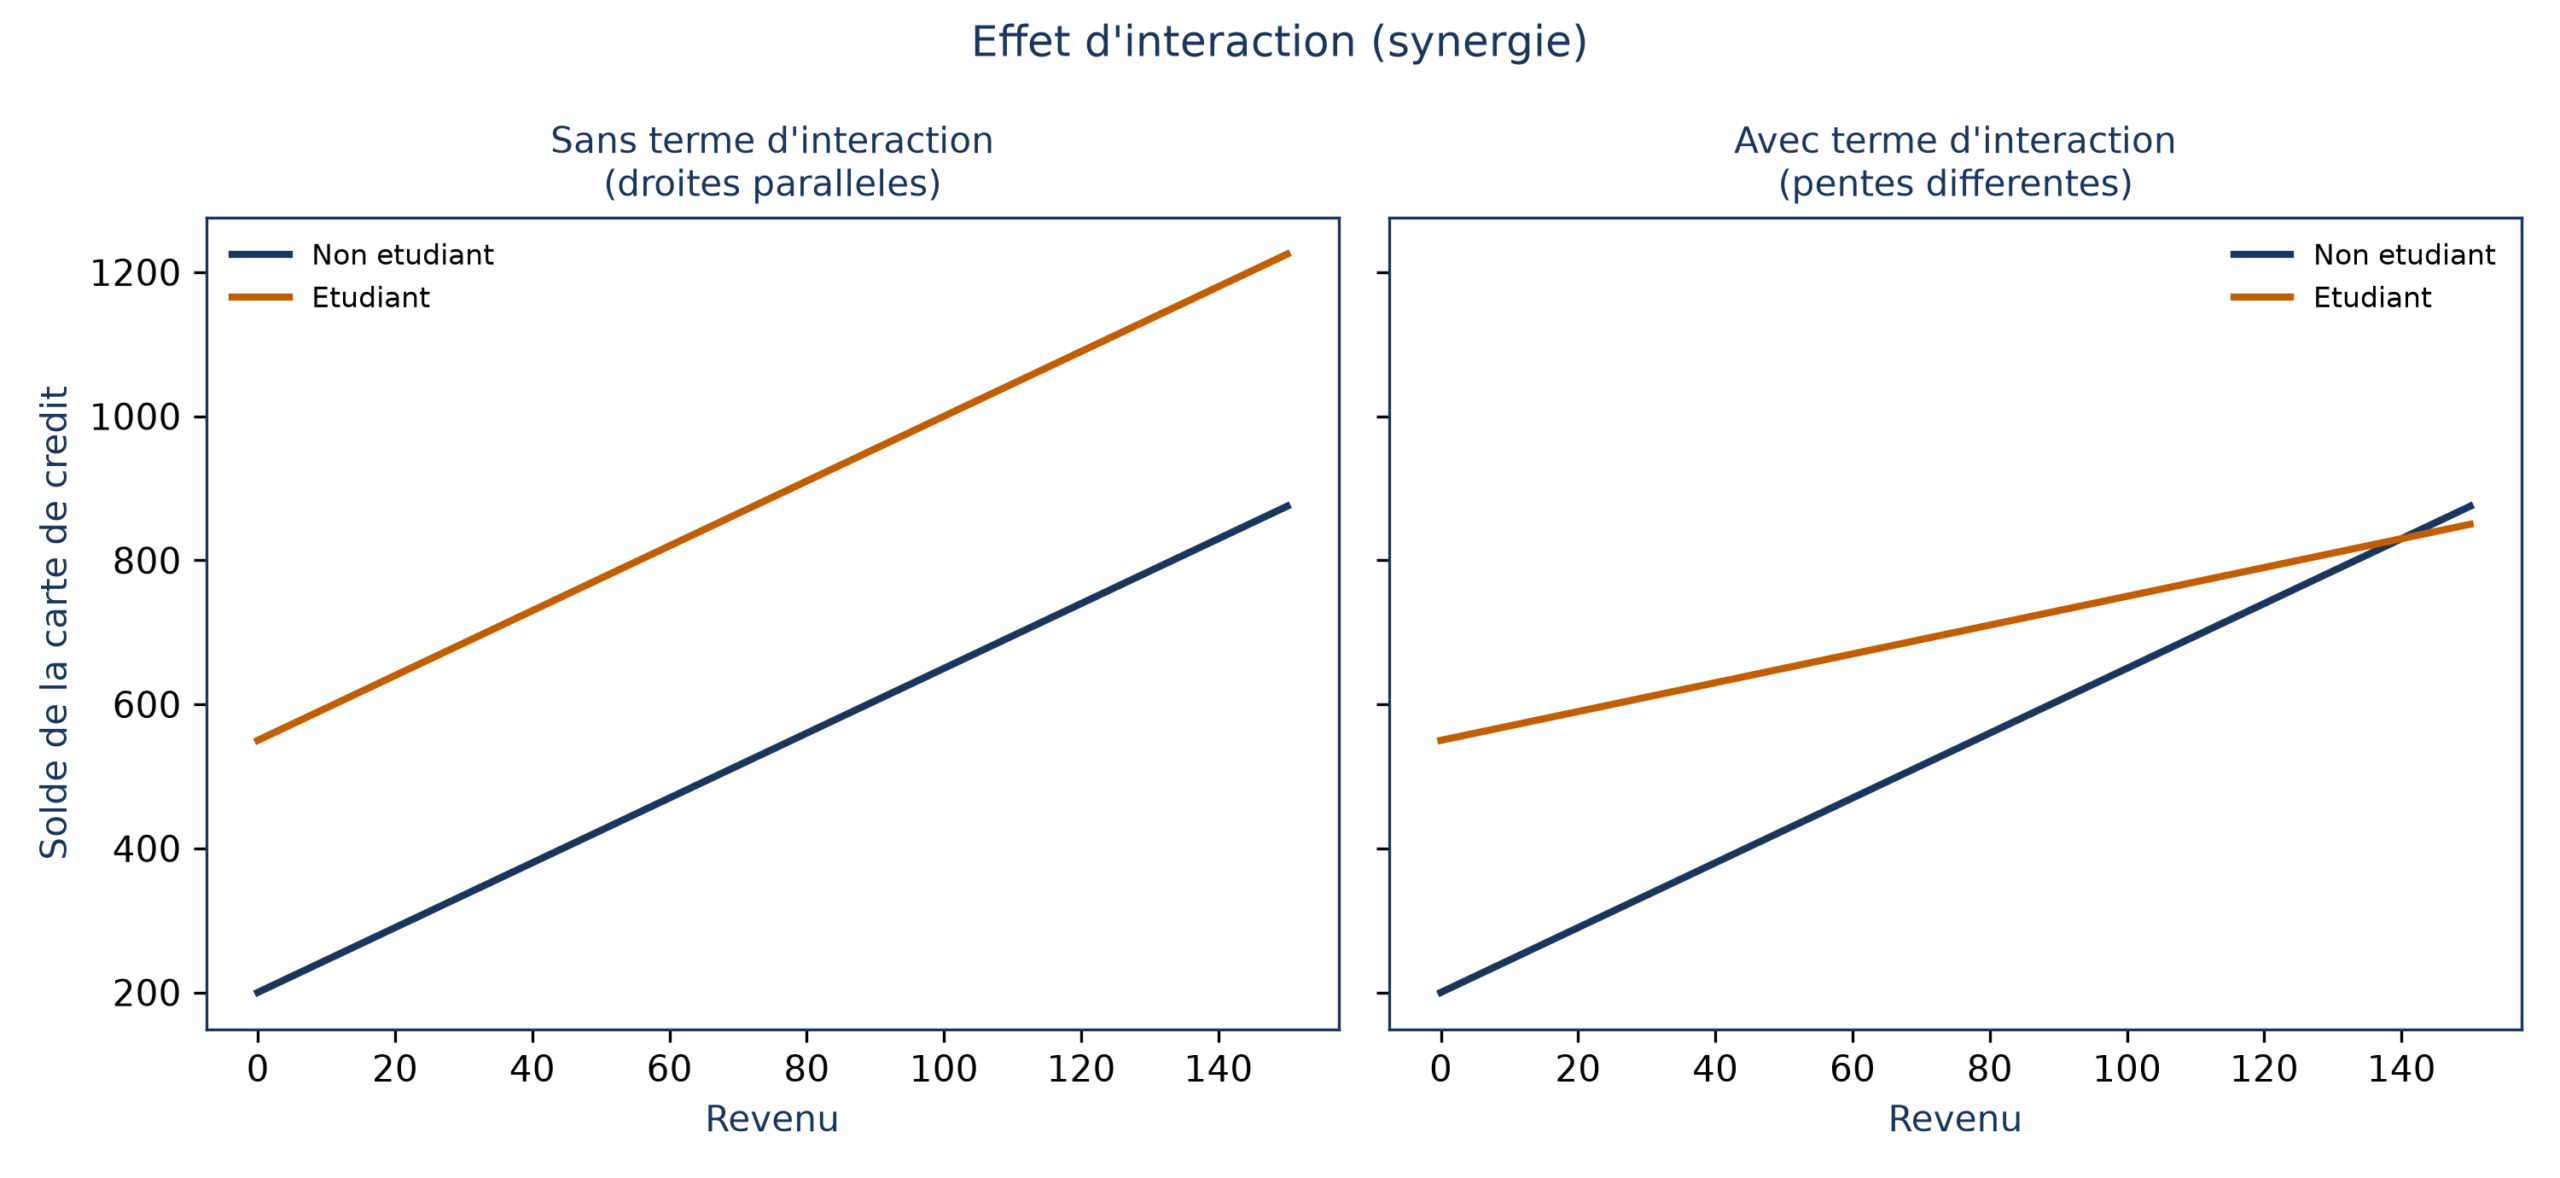
Le même principe s’applique à des prédicteurs qualitatifs (un statut, une catégorie) via des variables indicatrices, sans changer la mécanique du modèle.
Le vrai test : ta variable à prédire est-elle continue ?
C’est la question qui décide de tout, avant même le domaine. Regarde les données Default, qui recensent si des clients ont fait défaut sur leur carte de crédit (Oui/Non) selon leur solde. On pourrait coder la réponse en 0 et 1 et appliquer une régression linéaire directement — rien ne l’empêche techniquement.
⚠️ Piège Rien n’empêche alors les prédictions de sortir de l’intervalle [0, 1], ce qui les rend impossibles à interpréter comme de véritables probabilités. Et si la réponse compte plus de deux catégories, un codage numérique impose un ordre arbitraire entre elles.
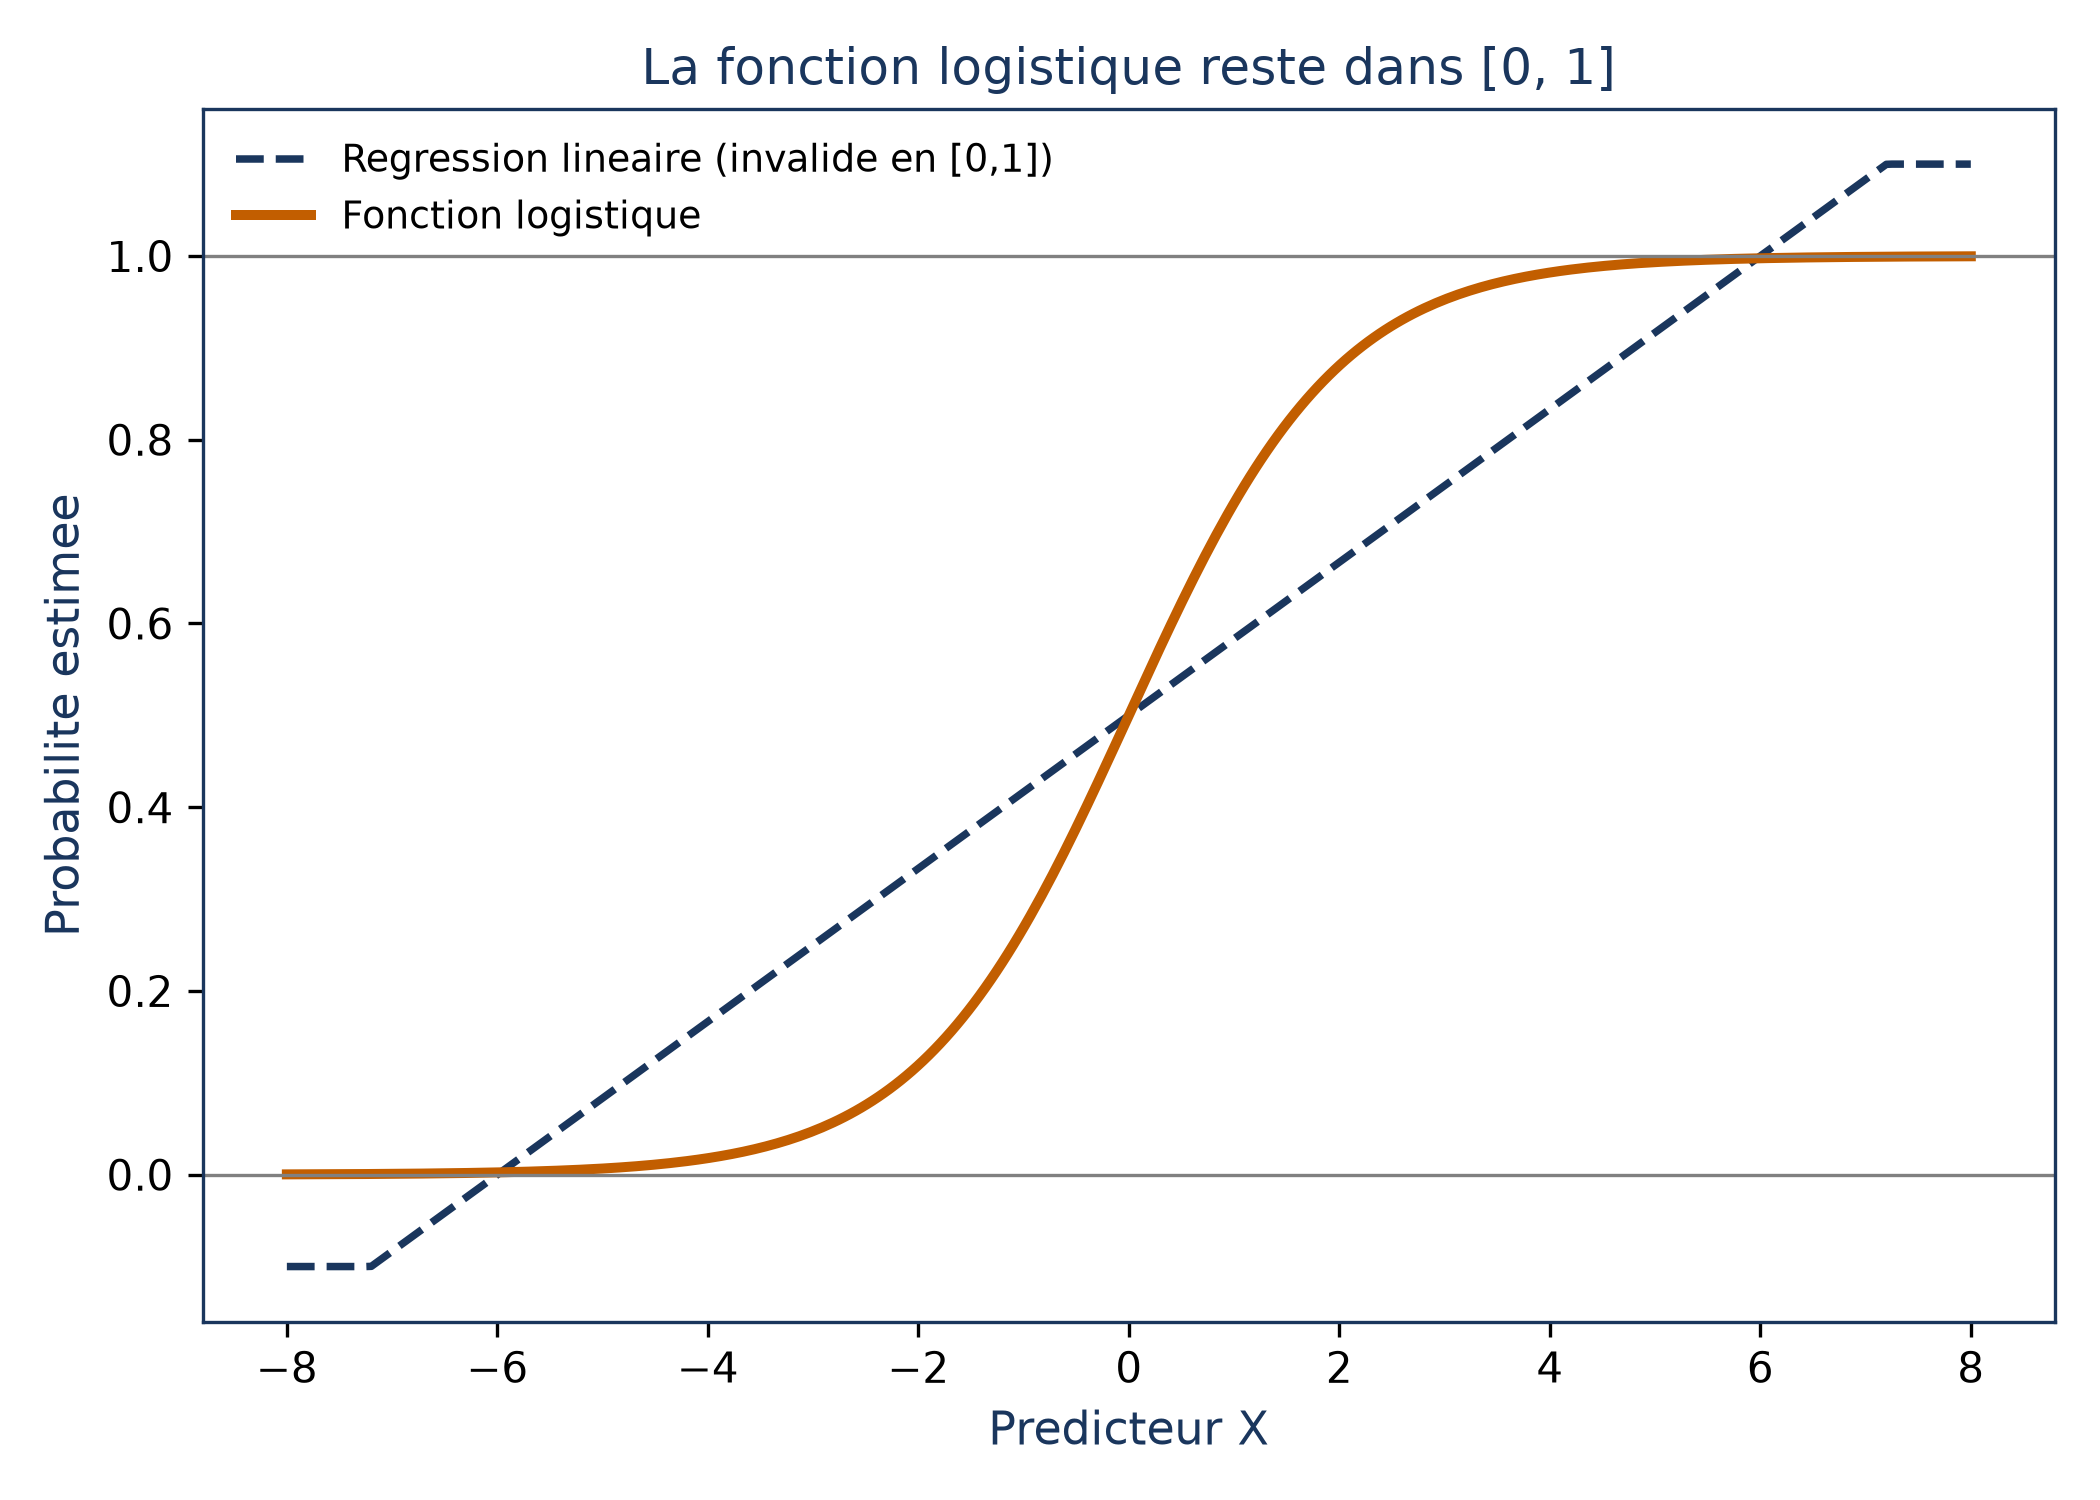
Une troisième famille de problèmes existe : compter — combien de clients seront servis dans un magasin en une heure ? Une régression linéaire classique pourrait prédire un nombre négatif, ce qui n’a pas de sens ; la régression de Poisson garantit des prédictions toujours positives, via une fonction de lien adaptée à la réponse. Linéaire, logistique et Poisson sont en réalité des cas particuliers d’une même famille, les modèles linéaires généralisés.
Pièges et limites : quand la droite ment
Même quand ta variable à prédire est bien continue, quatre vérifications s’imposent avant de faire confiance au modèle.
La colinéarité. Deux prédicteurs fortement corrélés (radio et presse écrite, par exemple) rendent difficile de séparer leurs effets ; le VIF le quantifie, une valeur au-delà de 5 ou 10 signalant un problème. On y remédie en retirant une variable redondante ou en les combinant.
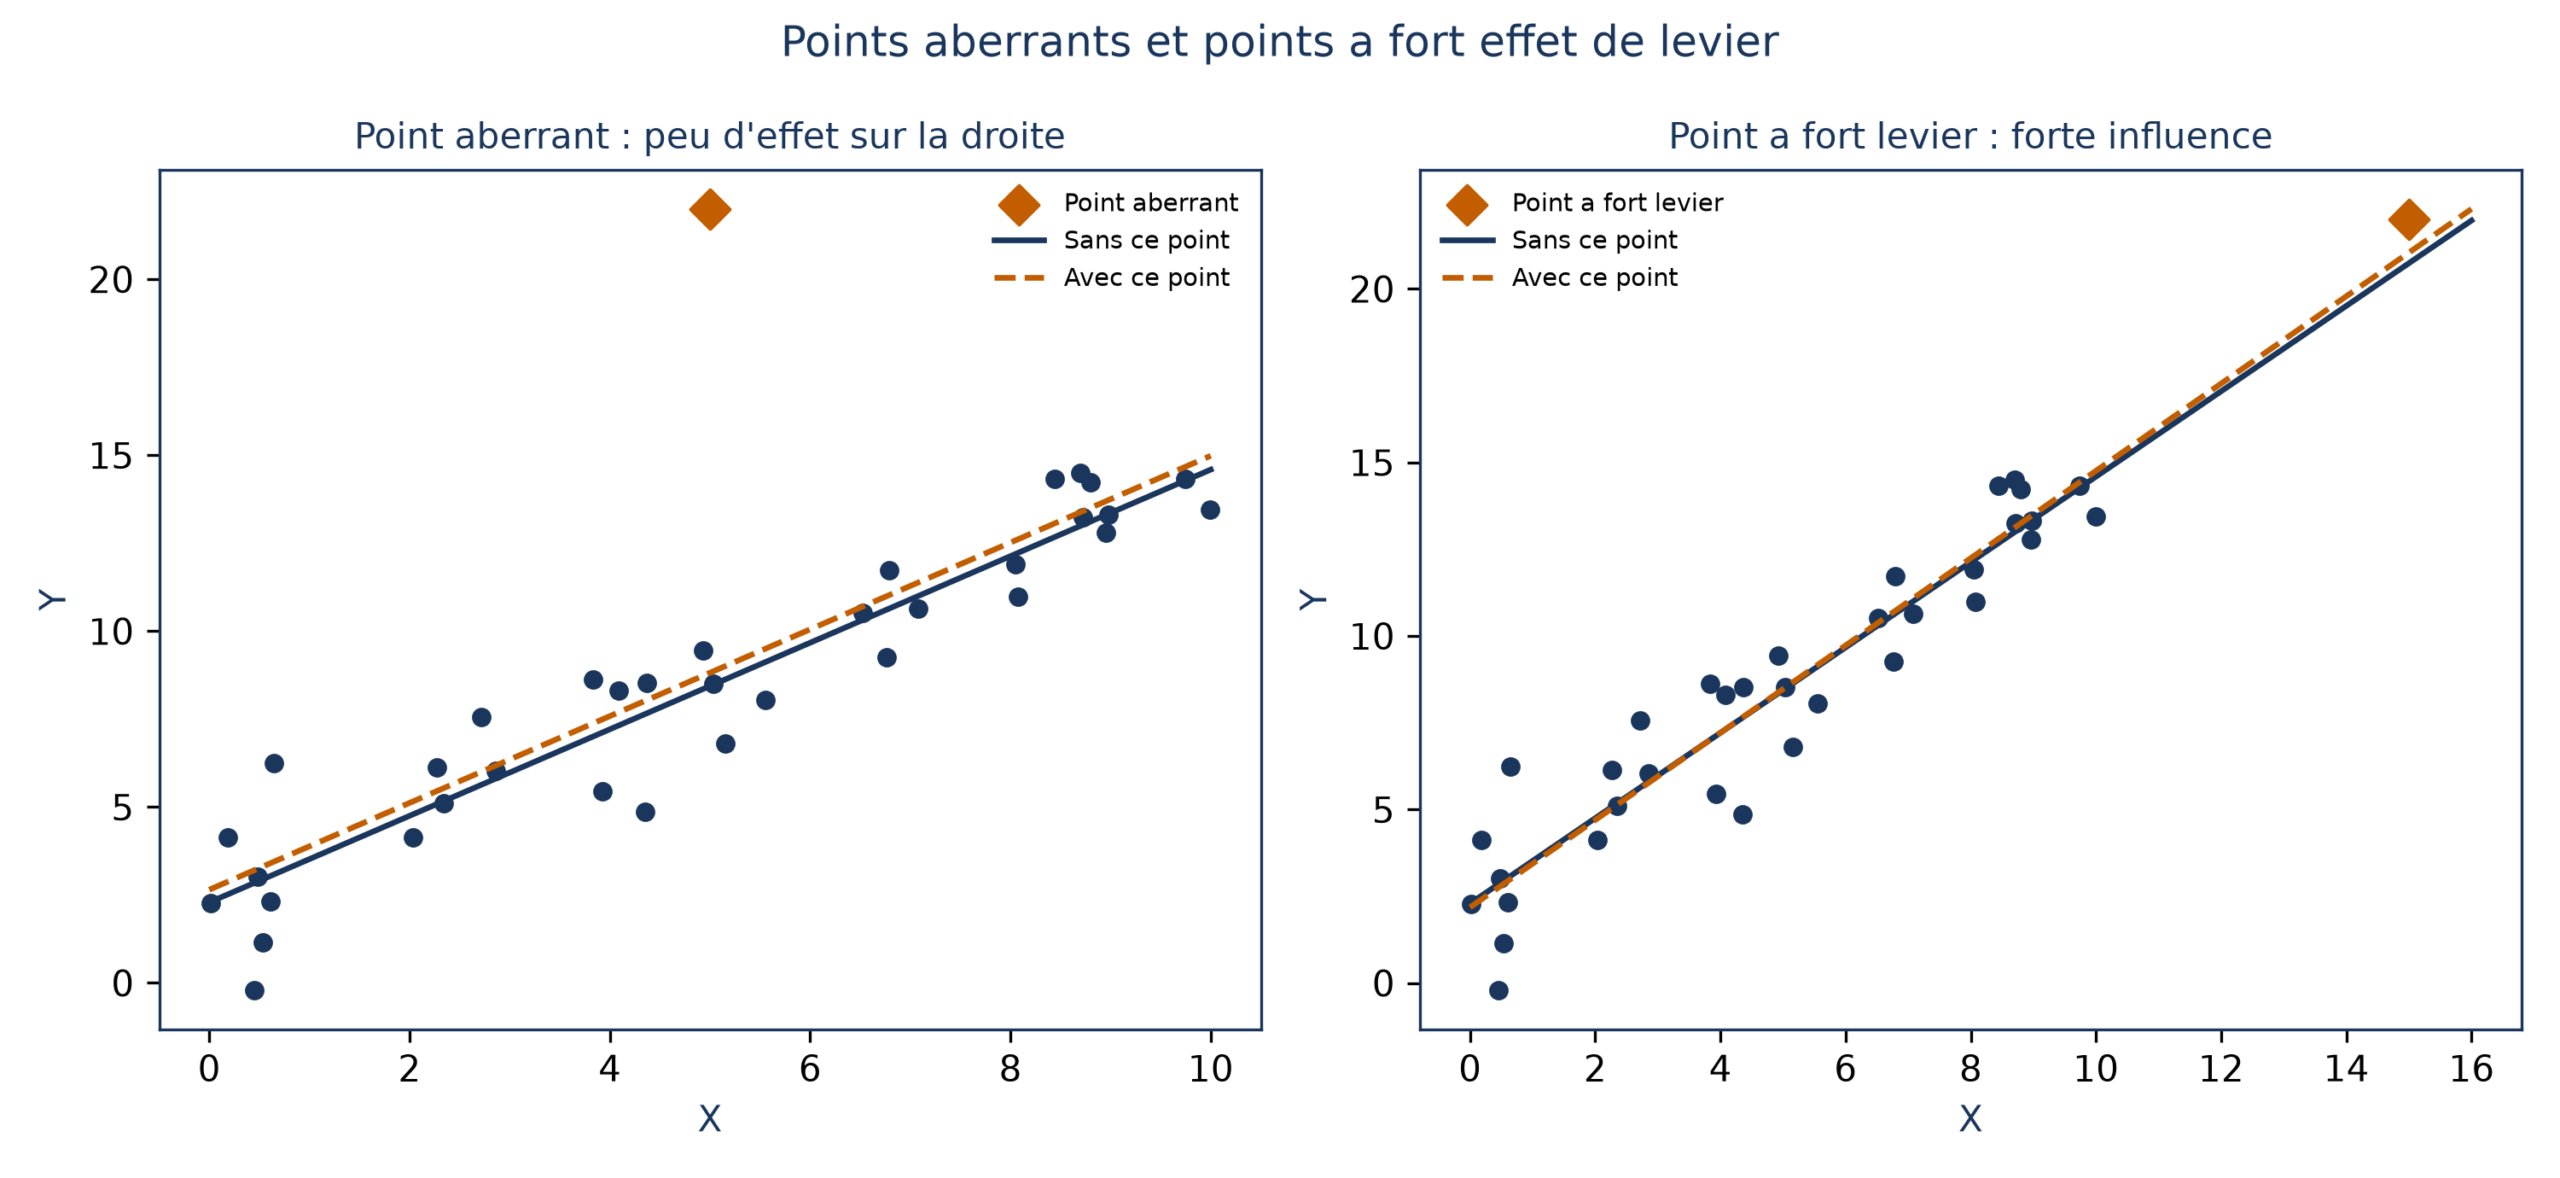
Les points aberrants et les points à fort effet de levier. Un point aberrant (réponse inhabituelle) déplace peu la droite ajustée ; un point à fort effet de levier (prédicteur inhabituel) peut la faire pivoter sensiblement.
La non-linéarité. Se détecte avec un graphique des résidus en fonction des valeurs ajustées : une forme en U trahit une relation que le modèle linéaire ne capture pas — un terme quadratique la fait souvent disparaître.
La corrélation des erreurs et la variance non constante. Fréquentes sur des séries temporelles ou des mesures répétées, elles rendent les intervalles de confiance et p-valeurs artificiellement optimistes ; une transformation comme le logarithme de la réponse corrige souvent l’hétéroscédasticité.
Aller plus loin
- Les K plus proches voisins : quand la vraie relation est loin d’être linéaire, cette méthode non paramétrique peut reprendre l’avantage — au prix d’une interprétabilité bien moindre et d’un besoin en données plus important.
- Ridge et lasso : quand tu as beaucoup de prédicteurs corrélés, ces méthodes de rétrécissement stabilisent les coefficients là où les moindres carrés ordinaires deviennent instables.
- Les splines et modèles additifs (GAM) : pour assouplir l’hypothèse de linéarité prédicteur par prédicteur, sans perdre toute interprétabilité.
À retenir
- La bonne question n’est pas « dans quel domaine ? » mais « ma variable à prédire est-elle continue, et sa relation aux prédicteurs est-elle à peu près linéaire ? ».
- Un seul prédicteur donne une droite ; plusieurs donnent un plan, avec les mêmes moindres carrés en coulisses.
- Le R² dit combien le modèle explique ; les termes d’interaction peuvent transformer un ajustement correct en un ajustement excellent.
- Réponse binaire ou catégorielle → régression logistique ; réponse de comptage → régression de Poisson : même famille, fonction de lien différente.
- Colinéarité, points influents et non-linéarité se diagnostiquent avec des outils simples (VIF, graphique des résidus) — ne les saute jamais.
Questions fréquentes
Puis-je utiliser la régression linéaire si ma relation n’est pas parfaitement linéaire ? Souvent oui, en la transformant : la régression polynomiale reste linéaire en les coefficients même si la courbe résultante ne l’est plus, ce qui permet de continuer à l’ajuster par moindres carrés.