Parmi les clients d’une banque, environ 3 % seulement feront un jour défaut sur leur carte de crédit. Un « modèle » qui répondrait toujours « pas de défaut » ne se tromperait donc que 3,33 % du temps, et ne servirait strictement à rien. Pour faire mieux, il faut un outil qui rende non pas un verdict, mais une probabilité que l’on transforme ensuite en décision. À la fin de cet article, tu sauras ce que calcule une régression logistique, d’où vient son drôle de nom et comment on passe de sa sortie à une réponse oui/non.
Sommaire
- L’essentiel en 30 secondes
- Un modèle qui classe en deux temps
- Probabilité, cote, log-cote : le trajet qui rend la droite possible
- Ce que dit (et ne dit pas) un coefficient
- Comment le modèle trouve ses coefficients
- Une probabilité devient une réponse : la frontière et le seuil
- Pourquoi un taux d’erreur de 3 % peut tromper
- Lire un coefficient sans se faire piéger : l’affaire de l’étudiant
- La régression logistique face à ses voisines
L’essentiel en 30 secondes
- La régression logistique est, malgré son nom, une méthode de classification : elle prédit une catégorie, comme « défaut » ou « pas de défaut ».
- Elle ne tranche pas d’emblée : elle estime d’abord la probabilité d’appartenir à une classe, puis une règle en déduit la catégorie.
- Son principe tient en une phrase : le logarithme de la cote est linéaire en les prédicteurs.
- Ses coefficients s’obtiennent par maximum de vraisemblance, avec une descente de gradient faute de formule directe.
- Le passage au oui/non repose sur un seuil qu’il faut choisir selon le coût des erreurs, pas par défaut à 50 %.
Un modèle qui classe en deux temps
Quand la cible à prédire est une catégorie (un client fait défaut ou non, un patient survit ou non, une transaction est frauduleuse ou non), on parle de classification. Quand c’est un nombre, on parle de régression. Le nom « régression logistique » mélange donc les genres, et c’est la première idée reçue à lever : l’algorithme sert bien à classer.
D’où vient alors le mot « régression » ? La plupart des méthodes de classification procèdent en deux temps : elles estiment d’abord la probabilité que l’observation appartienne à chaque catégorie, puis en déduisent une classe. La régression logistique incarne ce schéma à l’état pur. Son premier temps produit un nombre continu entre 0 et 1, ce qui ressemble beaucoup à une régression ; son second temps applique une règle de décision.
Pour la suite, garde en tête un cas fil rouge : prédire si un client fera défaut sur sa carte à partir de son revenu annuel et du solde mensuel de sa carte (le balance). Les clients qui font défaut ont en général des soldes nettement plus élevés que les autres, et c’est exactement ce signal que le modèle va exploiter.
Probabilité, cote, log-cote : le trajet qui rend la droite possible
Le modèle part de la probabilité  qu’un client fasse défaut sachant son solde. Il l’écrit avec la fonction logistique :
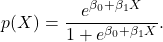
Dans cette expression,  et
 sont deux coefficients à estimer et
 est le solde. Tout nombre réel mis à la place de
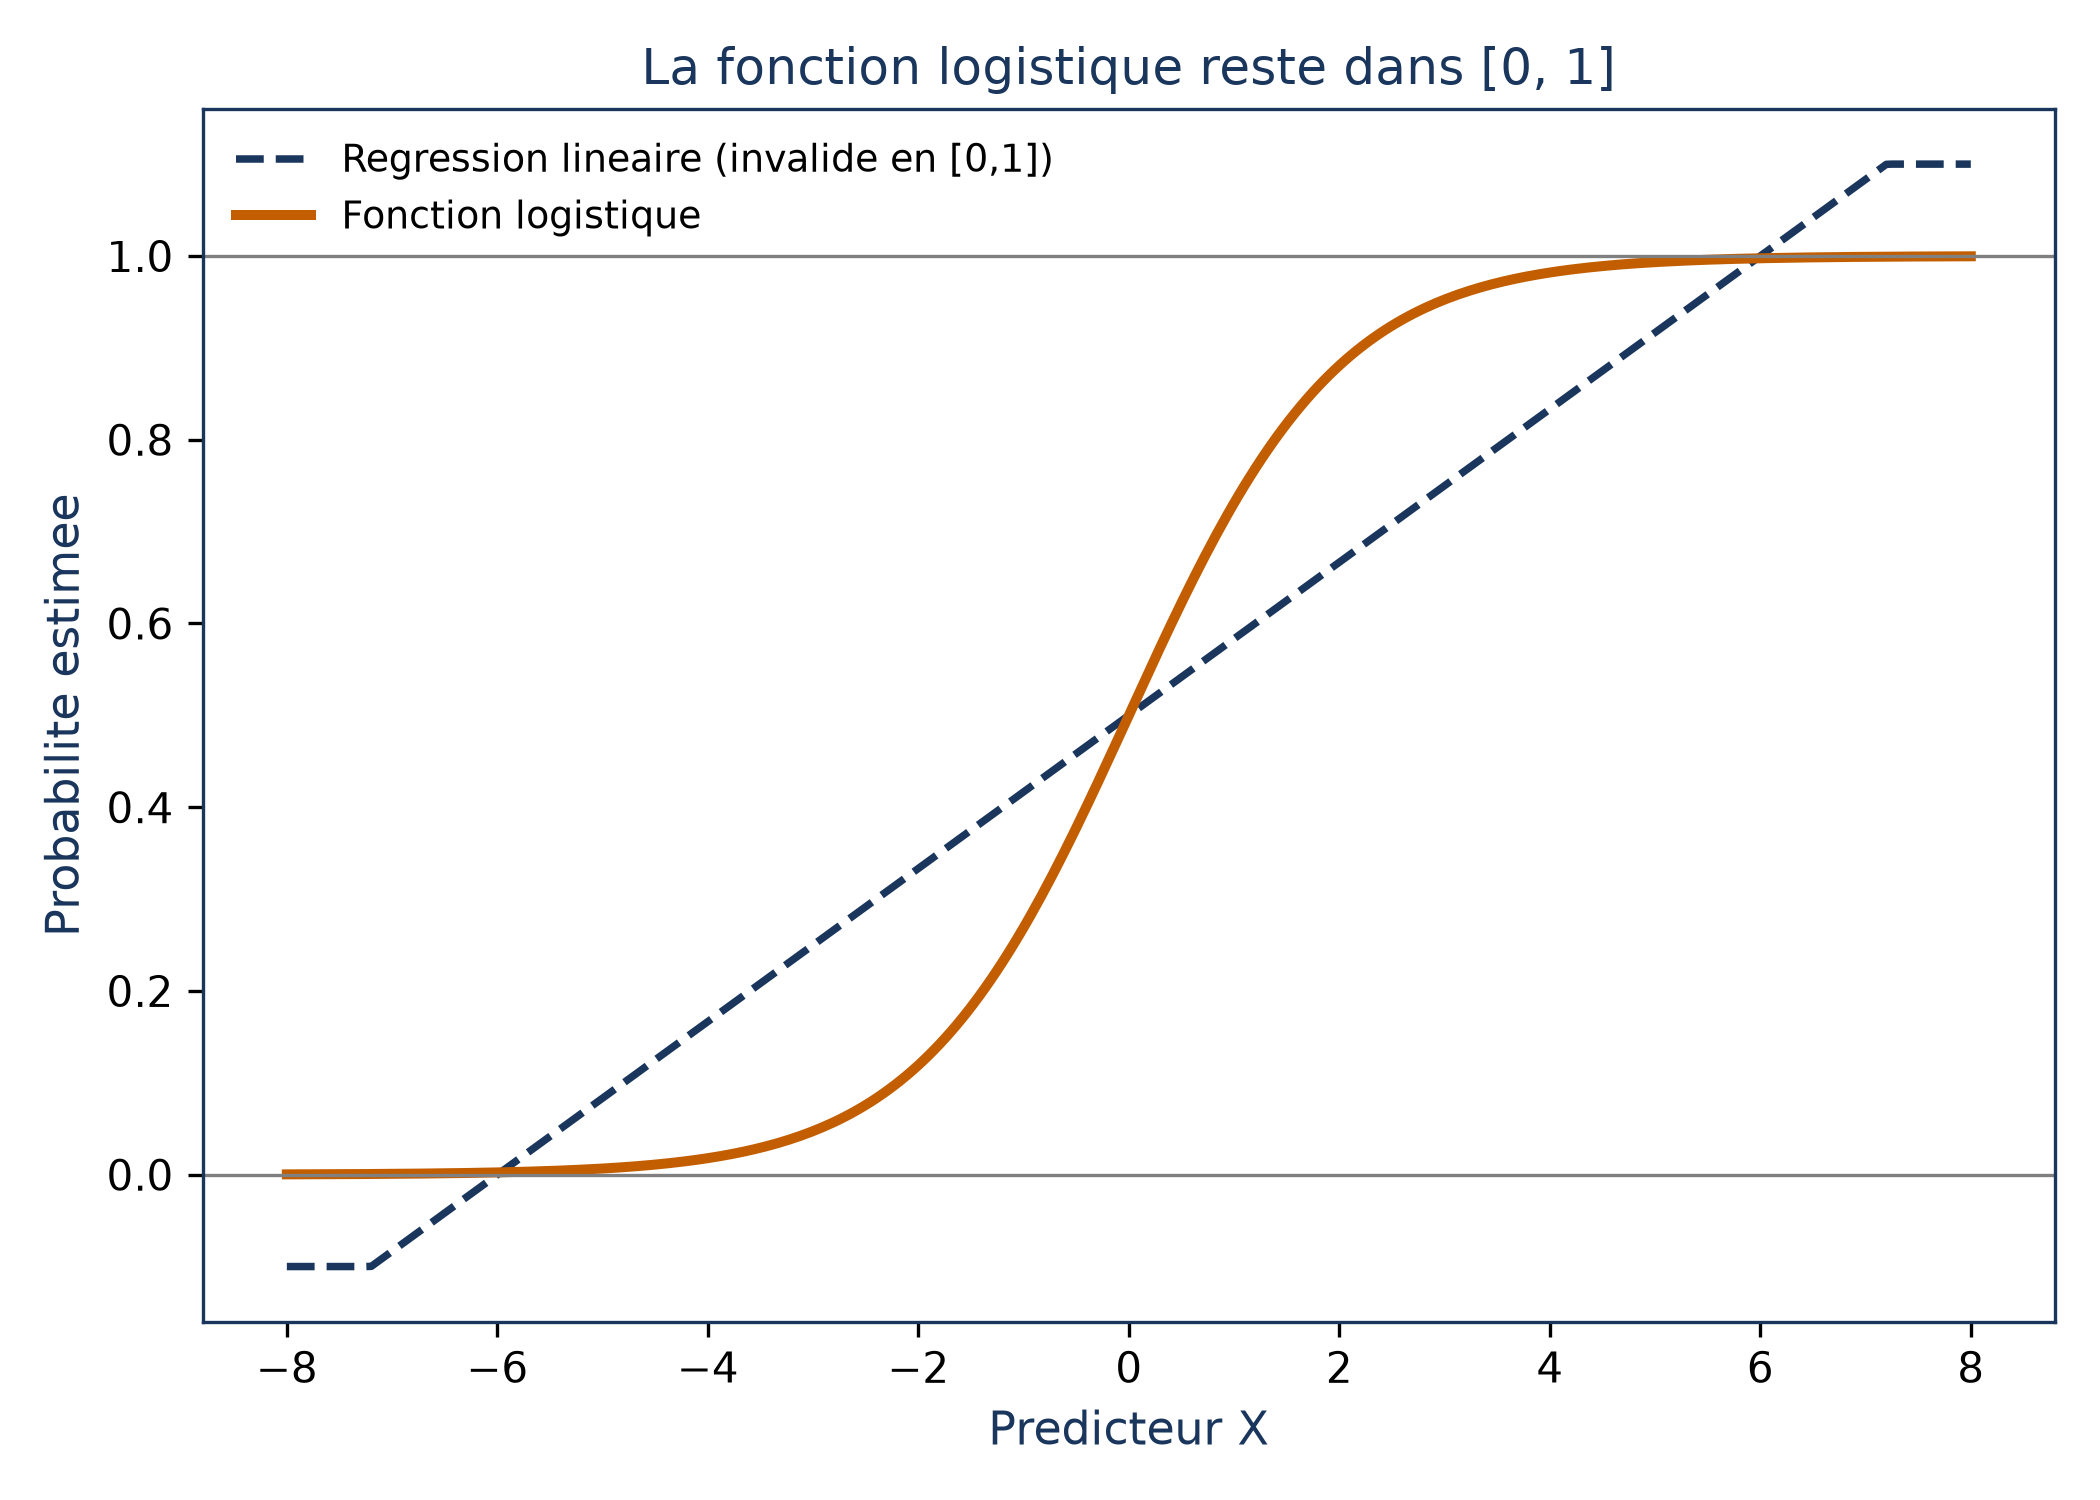
 ressort comme une probabilité valide entre 0 et 1 : proche de 0 pour les faibles valeurs, proche de 1 pour les fortes, jamais en dehors.
Un peu d’algèbre fait apparaître ce qui donne son nom au modèle. On définit la cote (odds en anglais) comme le rapport 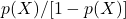 : elle vaut 1 quand la probabilité est de 50 %, et grandit sans limite quand la probabilité approche de 1. En passant au logarithme, on obtient le logit, ou log-cote :
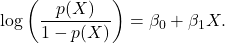
Le membre de droite est une simple droite. Voilà le tour de passe-passe : la régression logistique est une régression linéaire déguisée, mais appliquée au log-cote plutôt qu’à la probabilité elle-même.
💡 Intuition On ne peut pas poser une droite sur une probabilité sans qu’elle déborde de
. Alors on pose la droite sur une grandeur qui n’a pas de bornes, le log-cote, puis on la ramène dans
Ce que dit (et ne dit pas) un coefficient
Dans ce cadre, augmenter d’une unité change le log-cote de , ou, de façon équivalente, multiplie la cote par  . Un coefficient positif signifie donc que la probabilité croît avec la variable.
Mais attention : comme la relation entre et n’est pas une droite, n’est pas la variation de probabilité pour une unité de plus. Ce changement dépend de la valeur de départ de , et seul le signe de est lisible sur la probabilité.
⚠️ Piège Dire « un point de solde en plus ajoute
Comment le modèle trouve ses coefficients
Pour une droite ordinaire, on minimise une somme de carrés. Ici, on change de principe : le maximum de vraisemblance choisit les valeurs des paramètres qui rendent les données observées les plus probables.
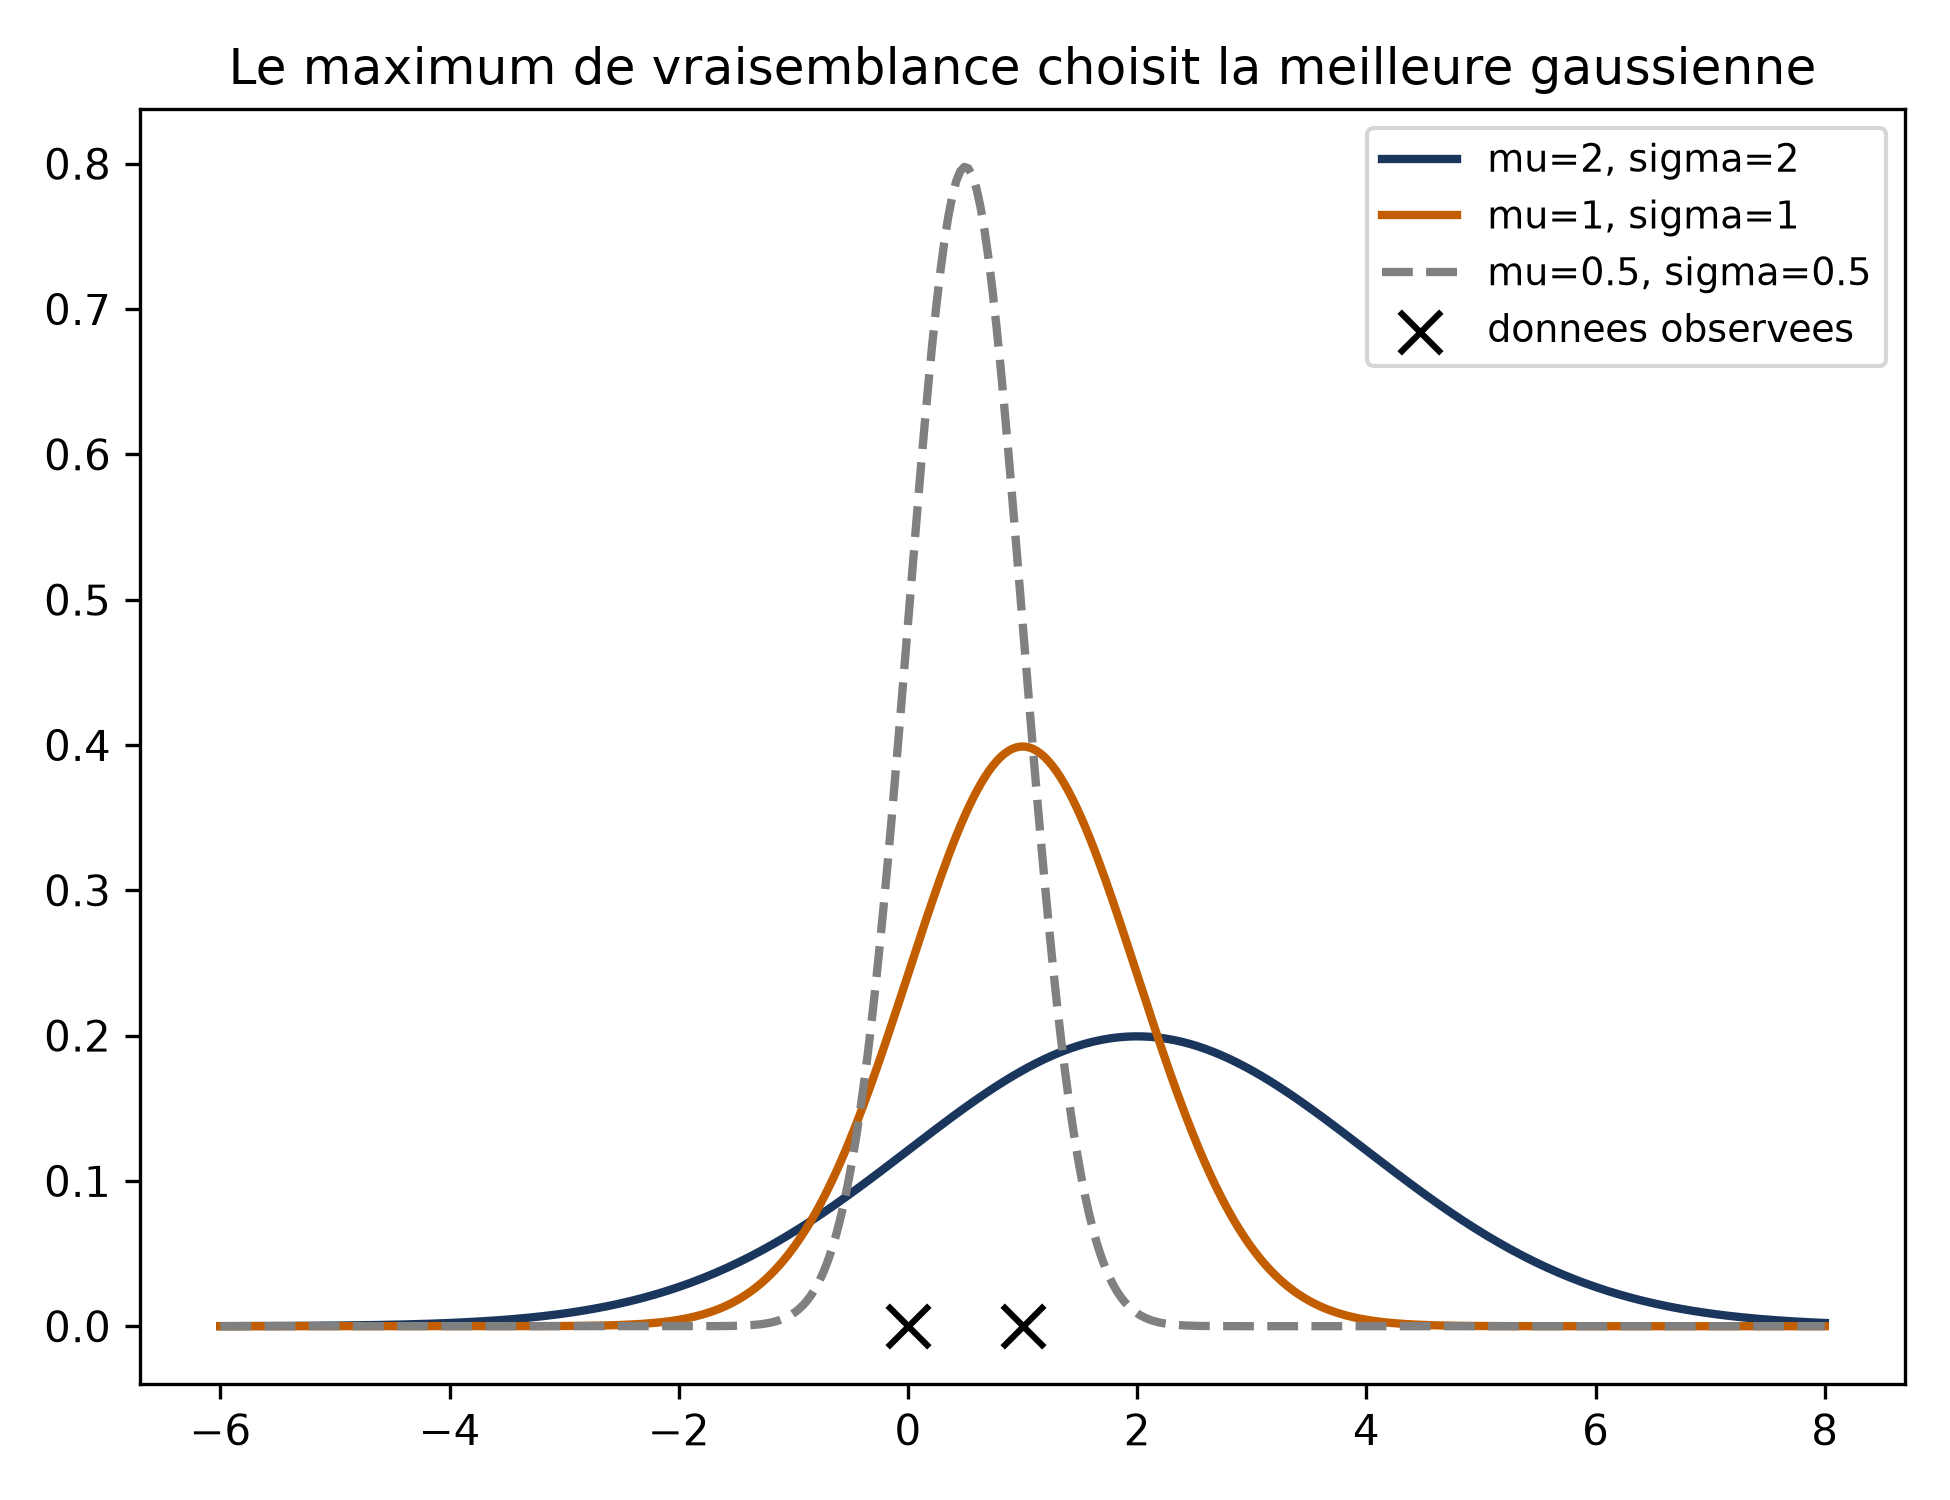
Un exemple minuscule pour sentir l’idée. Deux observations,  et
 , ont été tirées d’une loi normale dont on ignore les paramètres. Entre une loi
 et une loi
 , la seconde attribue aux deux points une densité combinée nettement plus élevée : elle les « explique » mieux. En comparant ainsi toutes les lois candidates, on retient celle qui colle le mieux, ici une moyenne de 0,5 et un écart-type de 0,5.
Pour la régression logistique, on écrit la probabilité de chaque observation avec la sigmoïde  appliquée à
 , c’est-à-dire
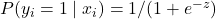 (on trouve aussi les coefficients notés
 au lieu de
 ). La vraisemblance multiplie alors, sur toutes les observations :
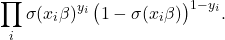
Cette écriture compacte vaut  quand
 et
 quand
 : chaque client contribue par la probabilité que le modèle lui attribuait dans la case où il est réellement tombé.
Contrairement à la régression linéaire, il n’existe aucune formule fermée pour les coefficients qui maximisent le logarithme de cette vraisemblance. On recourt donc à la descente de gradient, dont la mise à jour prend une forme étonnamment simple, grâce à la propriété 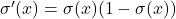 :
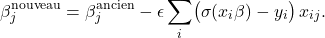
Lis le terme entre parenthèses : c’est l’écart entre la probabilité prédite et la vraie réponse (0 ou 1). Chaque client mal classé tire donc les coefficients dans la direction qui corrige son erreur, et en quelques itérations la frontière se déplace vers sa position optimale.
Pour la petite histoire, cette approche généralise ce qu’on connaît : avec un bruit gaussien, le maximum de vraisemblance redonne exactement l’équation normale des moindres carrés.
Une probabilité devient une réponse : la frontière et le seuil
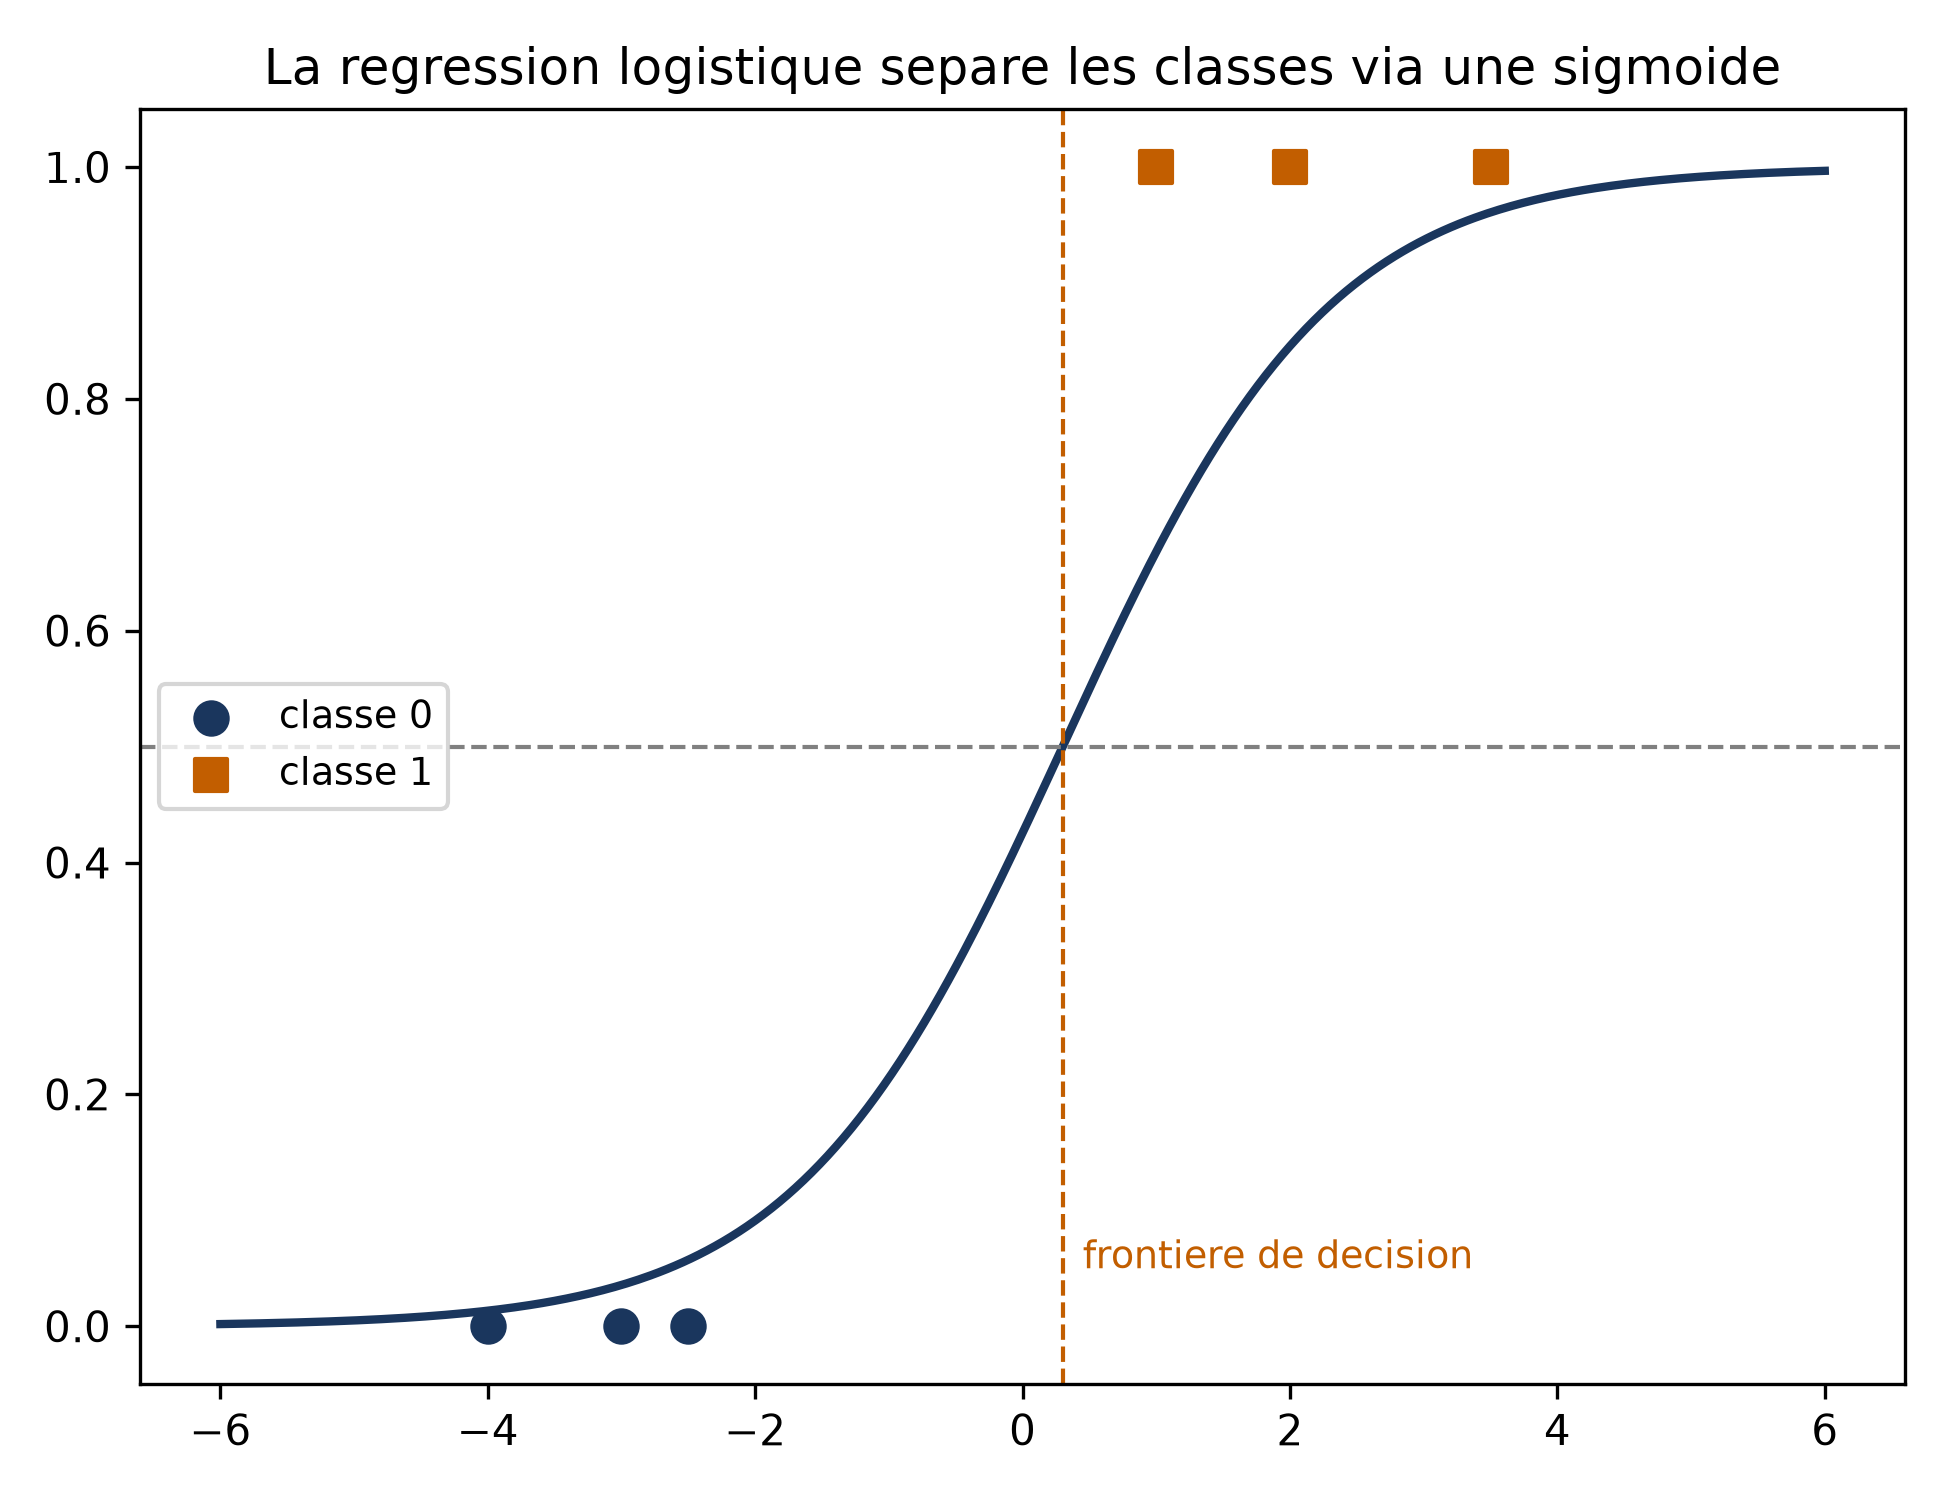
Une fois les coefficients connus, la règle de décision la plus simple consiste à répondre « oui » dès que la probabilité dépasse 0,5. Le paramètre contrôle la pente de la transition (plus  est grand, plus la bascule est nette), et en fixe la position. La frontière de décision, là où la probabilité vaut exactement 0,5, se situe en :

Voyons ça sur nos clients. La question est : à partir de quel solde le défaut devient-il plus probable que le contraire ? Les extraits qui suivent reprennent une session interactive : In [n]: marque la n-ième commande saisie, Out[n]: ce que Python affiche en retour. Le module sm.GLM, combiné à family=sm.families.Binomial(), ajuste une régression logistique de default sur balance.
In [12]: X = MS(['balance']).fit_transform(Default)
         y = Default.default == 'Yes'
         glm = sm.GLM(y, X, family=sm.families.Binomial())
         results = glm.fit()
         summarize(results)
Out[12]:
              coef  std err  z  P>|z|
intercept -10.6513  0.361 -29.491  0.0
balance  0.0055  0.000  24.952  0.0
Default est le tableau des clients ; X contient la colonne du solde (avec l’ordonnée à l’origine) et y vaut vrai pour chaque défaillant. Le tableau final donne l’estimation de (intercept, −10,65) et de (balance, 0,0055), avec leurs erreurs standards et leurs statistiques  : à solde nul, le log-cote de défaut part très bas, et il monte avec le solde.
Reste à obtenir des réponses oui/non. On demande au modèle la probabilité de chaque client, on applique le seuil de 50 %, puis on compare aux statuts réels :
In [15]: probs = results.predict()
         labels = np.array(['No']*10000)
         labels[probs>0.5] = "Yes"
         confusion_table(labels, Default.default)
Ici results.predict() renvoie la probabilité estimée de défaut de chaque client ; on étiquette « Yes » ceux qui dépassent 0,5. La fonction confusion_table() croise ensuite les prédictions et la réalité : c’est la matrice de confusion, dont on se sert dans la section suivante.
Pourquoi un taux d’erreur de 3 % peut tromper
Reviens à l’accroche : 3 % de défauts, donc un classifieur qui prédirait toujours « pas de défaut » obtiendrait un taux d’erreur de 3,33 %. Un modèle qui affiche moins n’est pas forcément bon.
Le cas d’école est celui d’une analyse discriminante linéaire (une autre méthode de classification à base de probabilités) appliquée aux mêmes clients : son taux d’erreur d’entraînement n’est que de 2,75 %. Pourtant, sur 333 clients qui ont réellement fait défaut, elle en manque 252, soit 75,7 %.
On mesure cela avec deux notions. La sensibilité est la proportion de vrais défaillants correctement repérés (ici seulement 24,3 %) ; la spécificité est la proportion de non-défaillants correctement identifiés (99,8 %).
La raison est simple. Un classifieur qui cherche à minimiser le nombre total d’erreurs ne distingue pas leur nature. Or une banque tolérerait sans doute davantage de fausses alertes (un bon payeur classé à risque) pour manquer moins de vrais défauts.
Heureusement, ce compromis se règle, et c’est précisément l’intérêt d’avoir des probabilités en main : il suffit de faire varier le seuil appliqué à probs. Sur le classifieur précédent, abaisser le seuil de 50 % à 20 % fait monter le taux d’erreur global (à 3,73 %) mais améliore nettement la sensibilité, parce qu’on accepte de classer davantage de non-défaillants comme à risque.
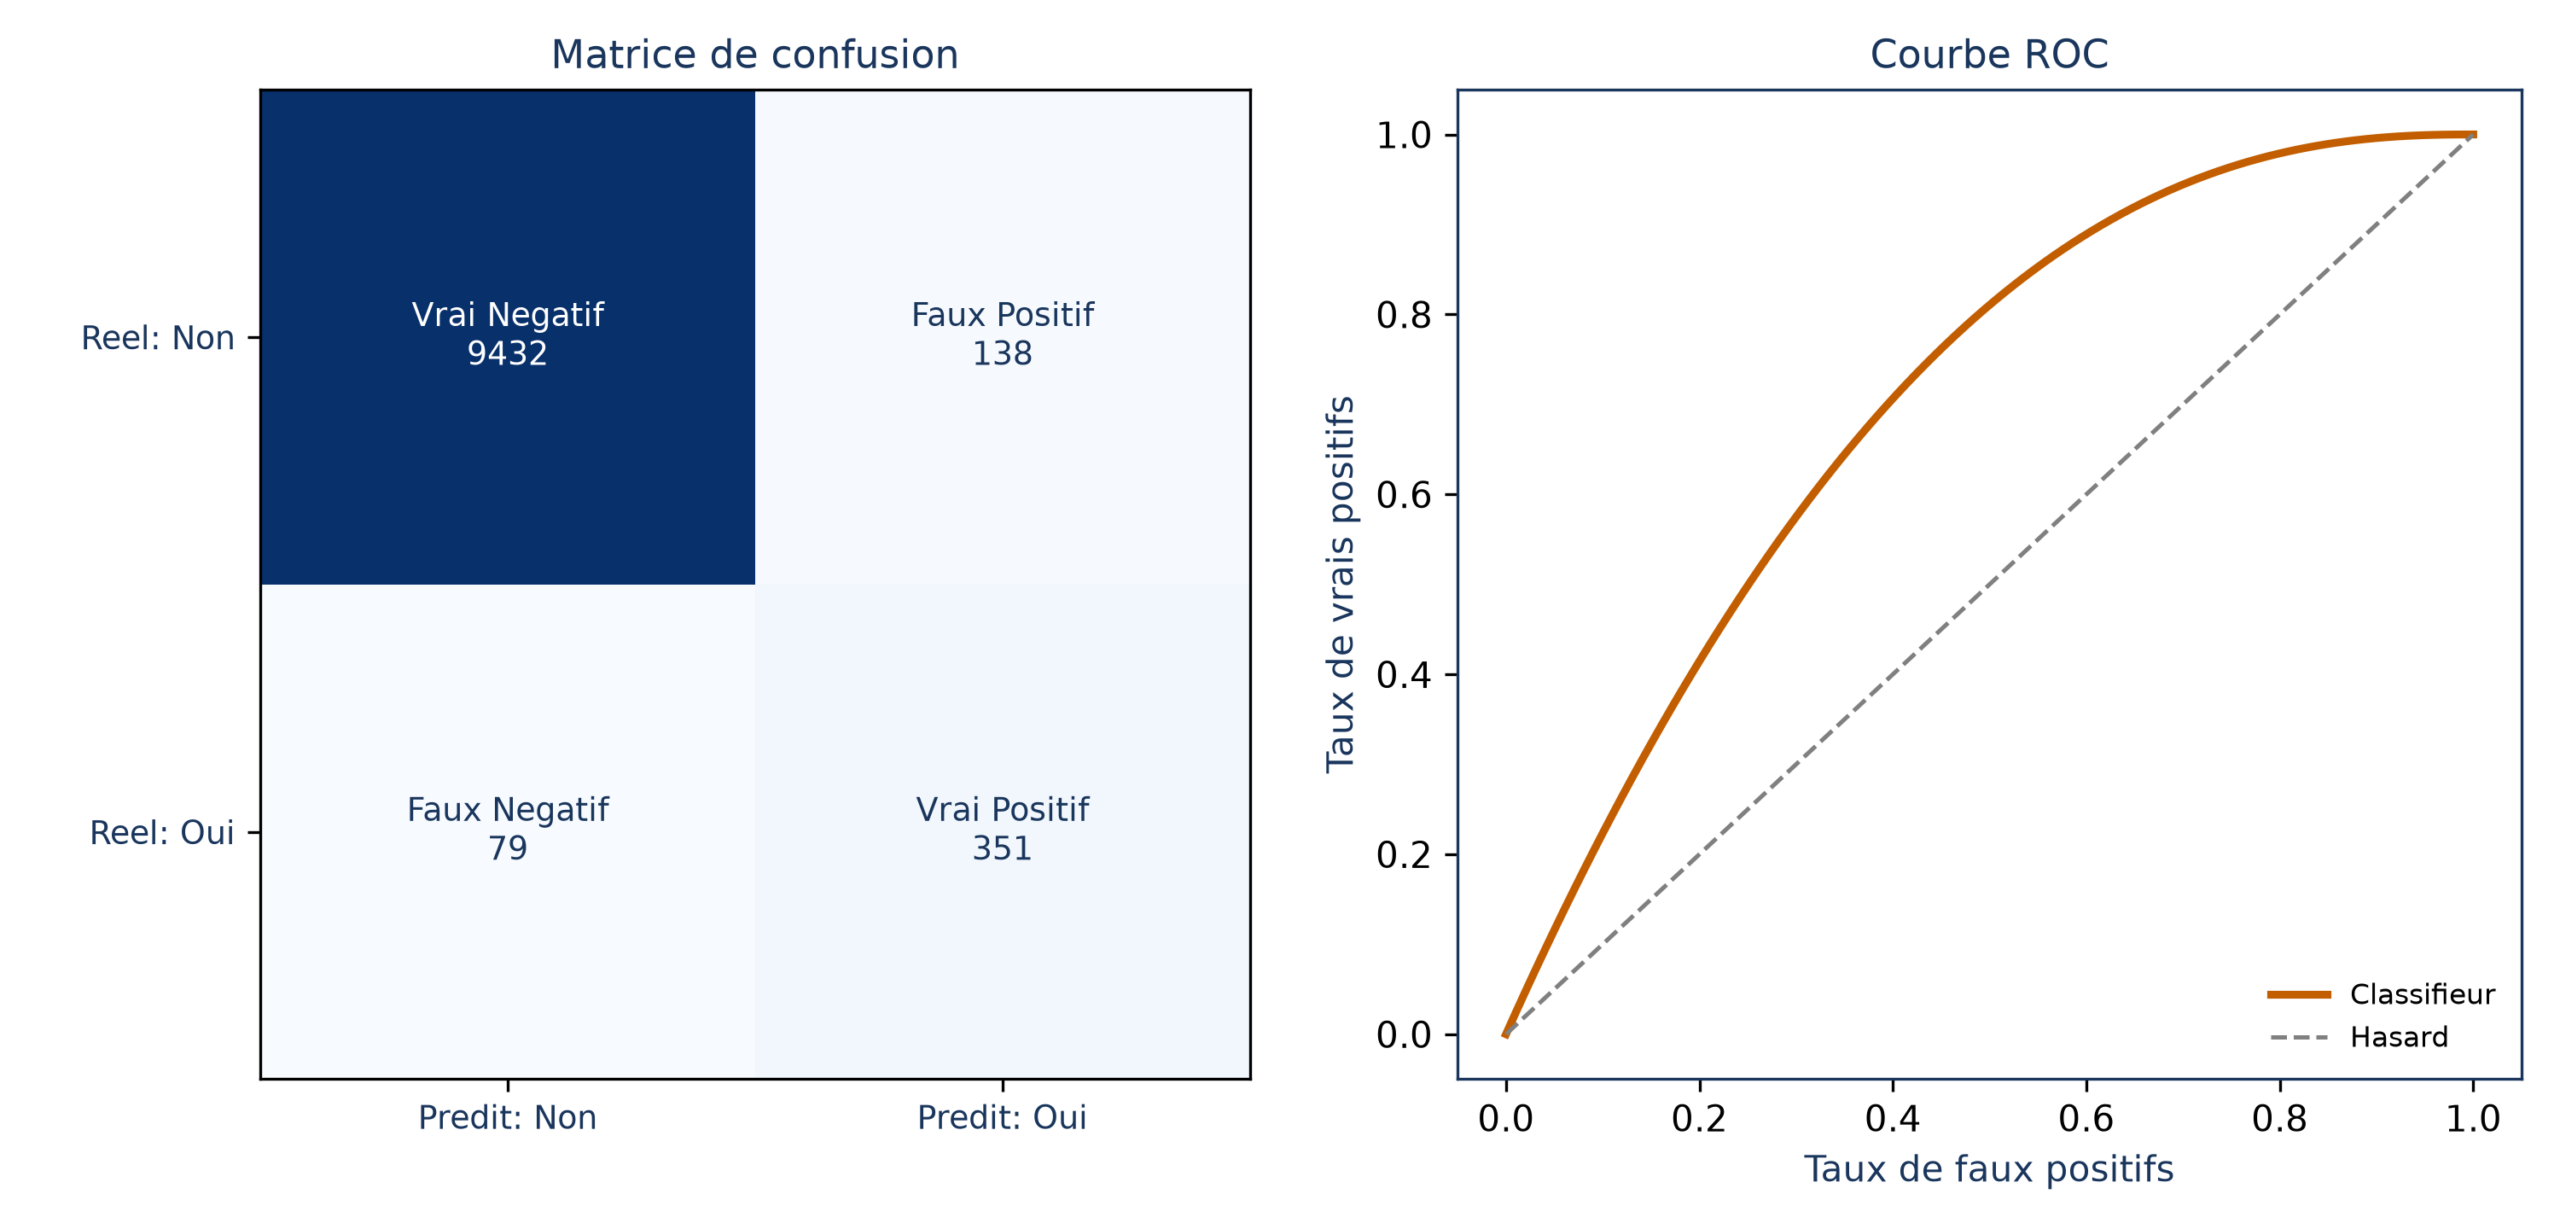
Plus cette courbe s’approche du coin supérieur gauche, meilleur est le classifieur ; l’aire sous la courbe (AUC) le résume en un seul nombre, indépendamment du seuil choisi.
Quand les classes sont déséquilibrées, d’autres mesures complètent le tableau : le rappel (part des vrais positifs retrouvés), la précision (part des prédictions positives qui sont justes) et le F-score qui les combine.
⚠️ Piège Un modèle entraîné sur des classes très déséquilibrées finit souvent par prédire toujours la classe majoritaire. Compare toujours ton taux d’erreur à celui de ce classifieur paresseux avant de te réjouir.
Lire un coefficient sans se faire piéger : l’affaire de l’étudiant
Les prédicteurs qualitatifs s’ajoutent à une régression logistique comme à une régression linéaire, via des variables indicatrices. Une version simple de nos données le montre : si tu régresses le défaut sur le seul statut étudiant, le coefficient est positif et significatif. Les étudiants semblent plus risqués, avec 4,31 % de défaut contre 2,92 % pour les non-étudiants.
Ajoute maintenant le solde et le revenu à la régression : le coefficient de l’étudiant devient négatif. À solde et revenu égaux, un étudiant est en réalité moins risqué qu’un non-étudiant.
Le paradoxe n’en est pas un. Les étudiants portent en moyenne des soldes plus élevés, et un solde élevé est associé à un risque plus fort : dans la régression simple, le statut étudiant « hérite » d’un effet qui vient en réalité du solde. C’est ce qu’on appelle un phénomène de confusion.
Une banque qui ne connaîtrait que le statut verrait bien un risque moyen plus élevé ; mais à solde identique, être étudiant devient un facteur protecteur. Interpréter l’effet d’un prédicteur en ignorant les autres mène donc à des conclusions inversées.
La régression logistique face à ses voisines
La régression logistique modélise directement 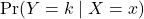 : c’est une approche discriminante. Les méthodes dites génératives font l’inverse : elles modélisent d’abord la distribution des prédicteurs dans chaque classe, puis retrouvent la probabilité de classe avec le théorème de Bayes.
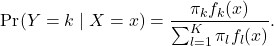
Ici  est la probabilité a priori de la classe
 et
 la densité des prédicteurs dans cette classe. Cette famille garde un avantage précis : elle reste stable quand les classes sont bien séparées, un cas où la régression logistique devient étonnamment instable, et elle se généralise naturellement à plus de deux classes.
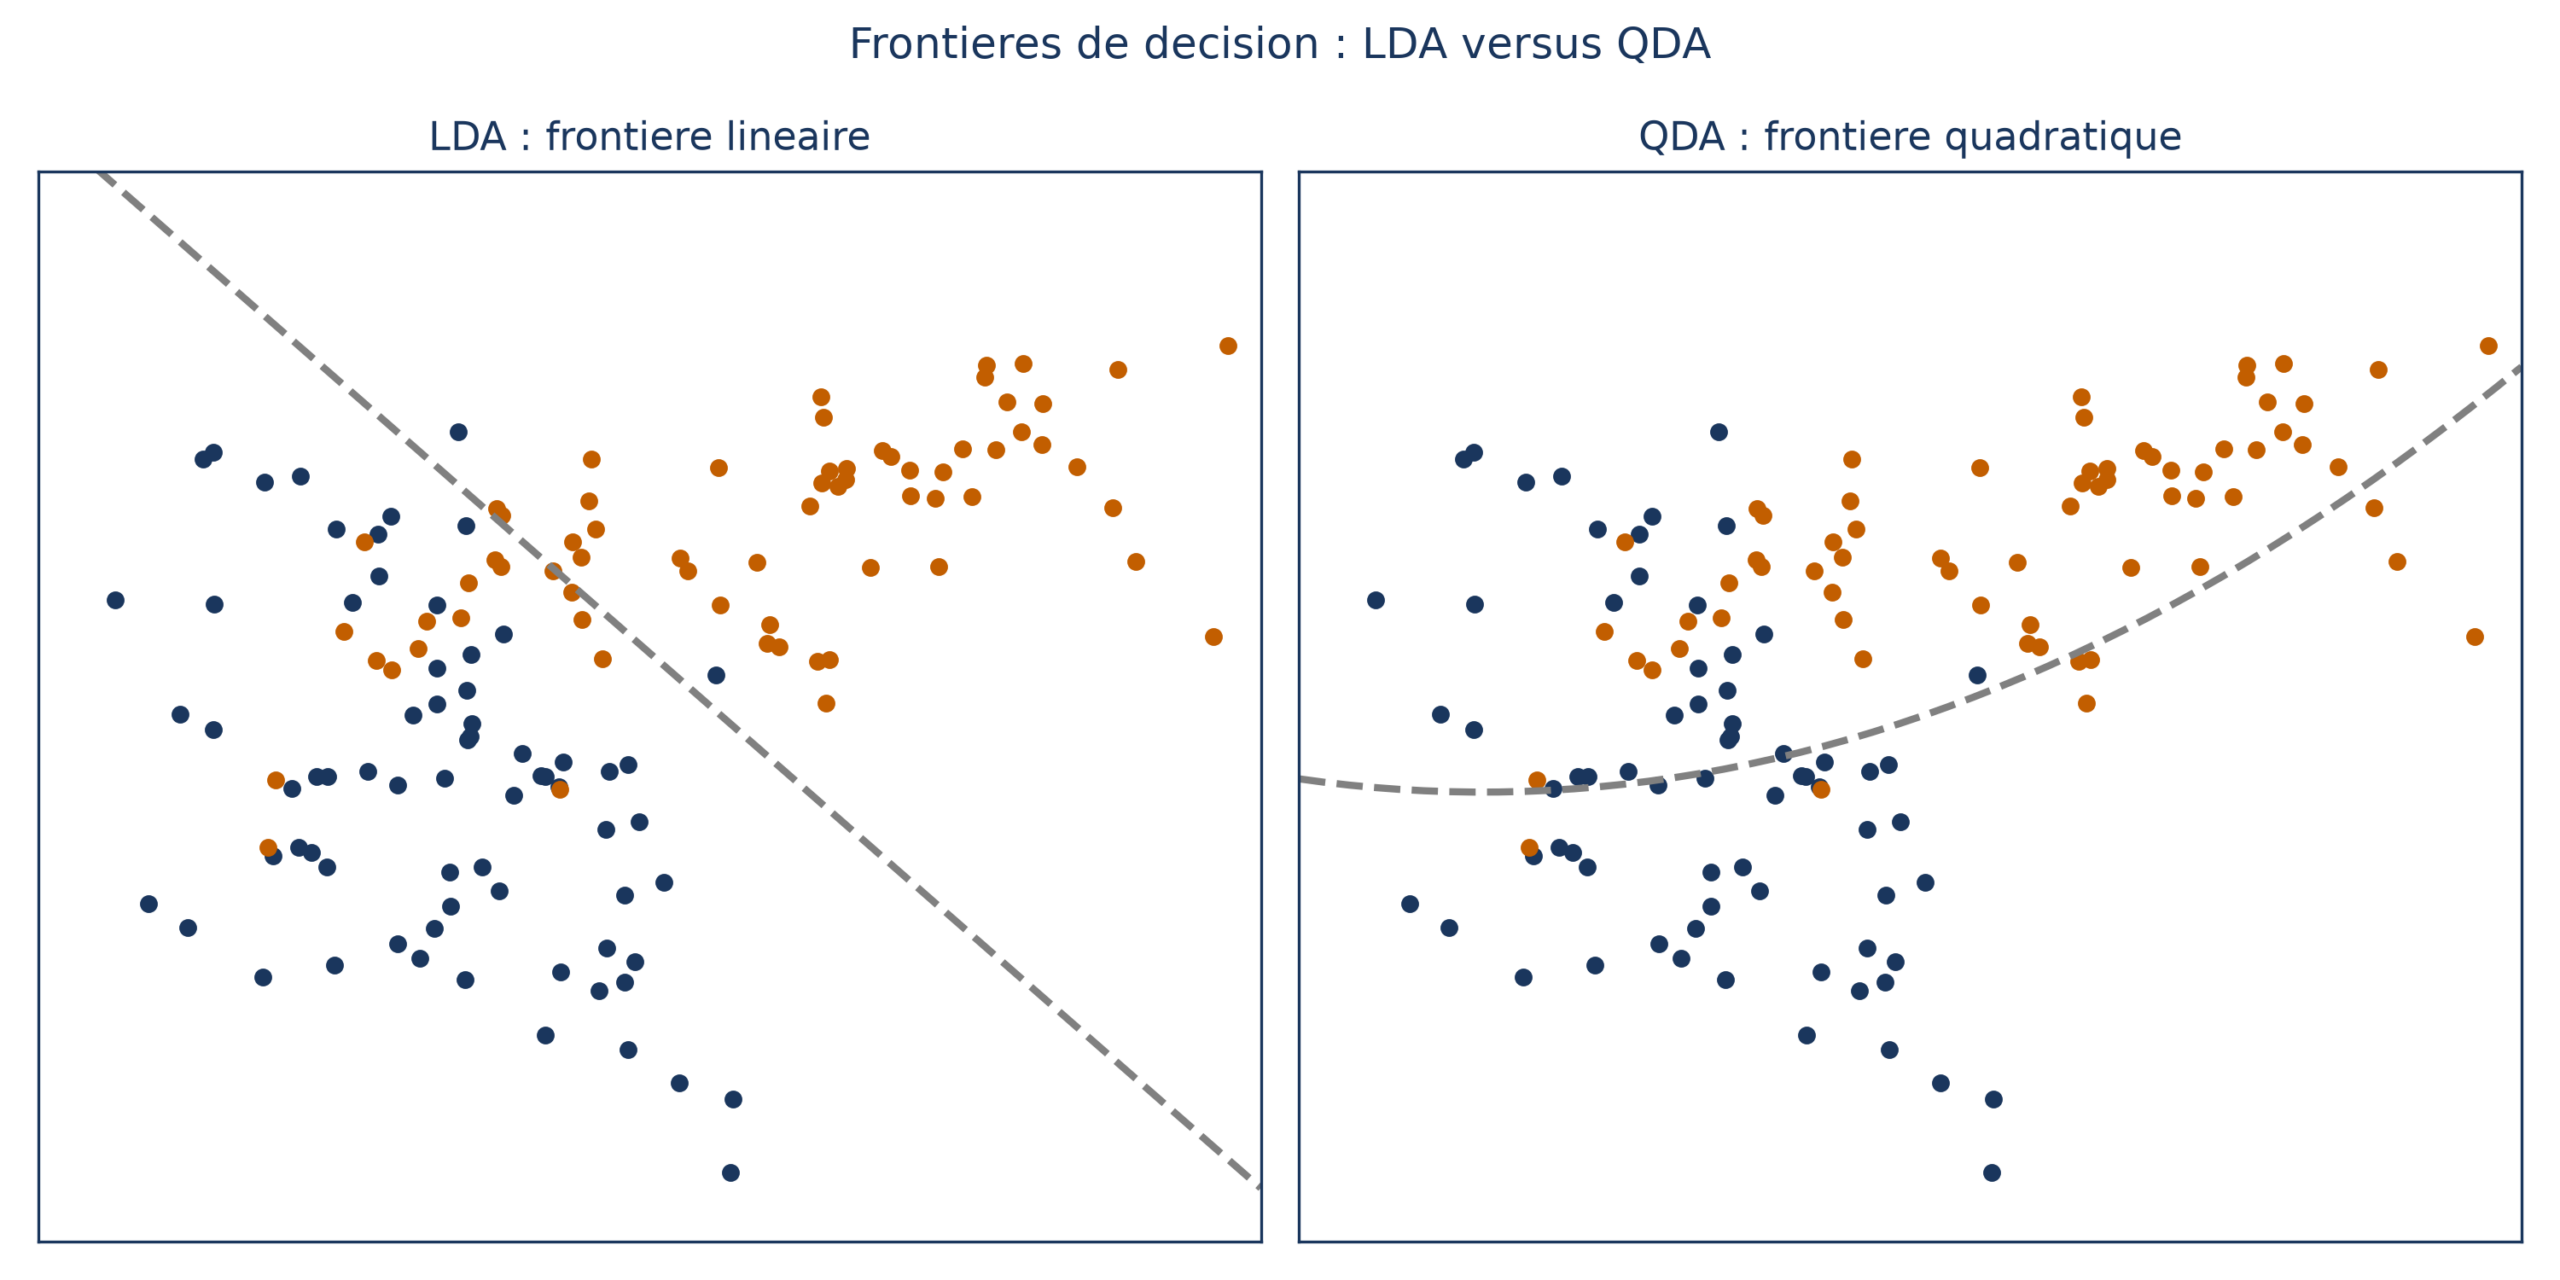
Pour choisir, voici les repères à retenir :
| Situation | Méthode à préférer | Pourquoi |
|---|---|---|
| Classes bien séparées, ou prédicteurs normaux dans chaque classe | Analyse discriminante (LDA) | Léger avantage de cette méthode |
| Normalité clairement violée | Régression logistique | Plus robuste à cette violation |
| Frontière fortement non linéaire | K plus proches voisins | Épouse la frontière, au prix d’une interprétabilité nulle et de plus de données |
| Classes presque séparables, probabilités inutiles | Machines à vecteurs de support | Tendent à mieux se comporter quand les classes sont bien séparées |
| Besoin de probabilités de classe interprétables | Régression logistique | Elle les fournit directement |
Aucune méthode ne domine uniformément les autres : le bon choix dépend de la forme de la vraie frontière, de la taille de l’échantillon et du poids que tu accordes à l’interprétabilité.
📌 À retenir Une régression logistique, c’est trois gestes : une droite posée sur le log-cote, une probabilité qui en sort, et un seuil que tu règles selon ce que coûte chaque type d’erreur.