Ouvre un cours de statistique : la LDA, qui sert à ranger des clients dans deux catégories, y est présentée comme une méthode « générative ». Ouvre l’actualité : les modèles « génératifs » écrivent des textes et fabriquent des vidéos. Même adjectif, deux univers qui n’ont, à première vue, rien à se dire. Cet article te donne une définition qui tient pour les deux, les trois mécanismes à savoir reconnaître, et trois idées reçues à ranger.
Sommaire
- L’essentiel en 30 secondes
- Un seul mot, deux métiers
- Chez les statisticiens : décrire chaque groupe, puis inverser
- Chez les ingénieurs, premier moteur : écrire la suite, un jeton après l’autre
- Chez les ingénieurs, second moteur : partir du bruit
- Un moteur par format
- Trois idées reçues sur « génératif »
L’essentiel en 30 secondes
- Une méthode générative repose sur une loi de probabilité qu’elle apprend, puis exploite pour classer ou pour produire.
- En classification, elle décrit d’abord chaque classe, puis applique le théorème de Bayes pour retrouver la probabilité d’appartenir à chacune.
- Pour produire du contenu, il n’existe que deux grands archétypes : prédire le jeton suivant, ou raffiner un bruit aléatoire.
- Le premier couvre le texte, la parole et les embeddings ; le second, les images et les vidéos.
- Un texte fluide ne prouve rien : la fluidité n’est pas du raisonnement, et quelques mots changés suffisent à le montrer.
Un seul mot, deux métiers
Chez les statisticiens, une méthode est générative quand elle commence par se demander : « à quoi ressemblent les valeurs des prédicteurs, classe par classe ? ». Elle en tire ensuite la probabilité d’appartenir à chaque classe. La LDA, la QDA et le naïf Bayes appartiennent à cette famille.
Chez les ingénieurs en IA, le mot désigne tout un éventail de modèles : les LLM, qui prennent du texte et en produisent, mais aussi les modèles vision-langage, la transcription de la voix, la synthèse vocale, la génération musicale, d’images, de vidéos ou de modèles 3D. Quand l’un d’eux répond, il échantillonne une distribution et choisit parmi ce qu’il a appris.
💡 Intuition Les deux mondes posent une question de probabilité. Le premier : « avec quelle probabilité cette valeur apparaît-elle dans cette classe ? ». Le second : « quel est le prochain élément le plus probable ? ». Savoir reconnaître la distribution que manipule un modèle, voilà le fil qui relie le tout.
Chez les statisticiens : décrire chaque groupe, puis inverser
L’idée tient en une formule. Pour chaque classe  , on estime d’abord une loi des prédicteurs, notée
 , valable au sein de cette seule classe. Le théorème de Bayes en tire ensuite la probabilité de la classe :
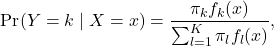
Au numérateur, la classe pèse  , où
 est sa probabilité a priori. Au dénominateur, on additionne ce poids sur les
 classes, ce qui ramène le tout à une probabilité.
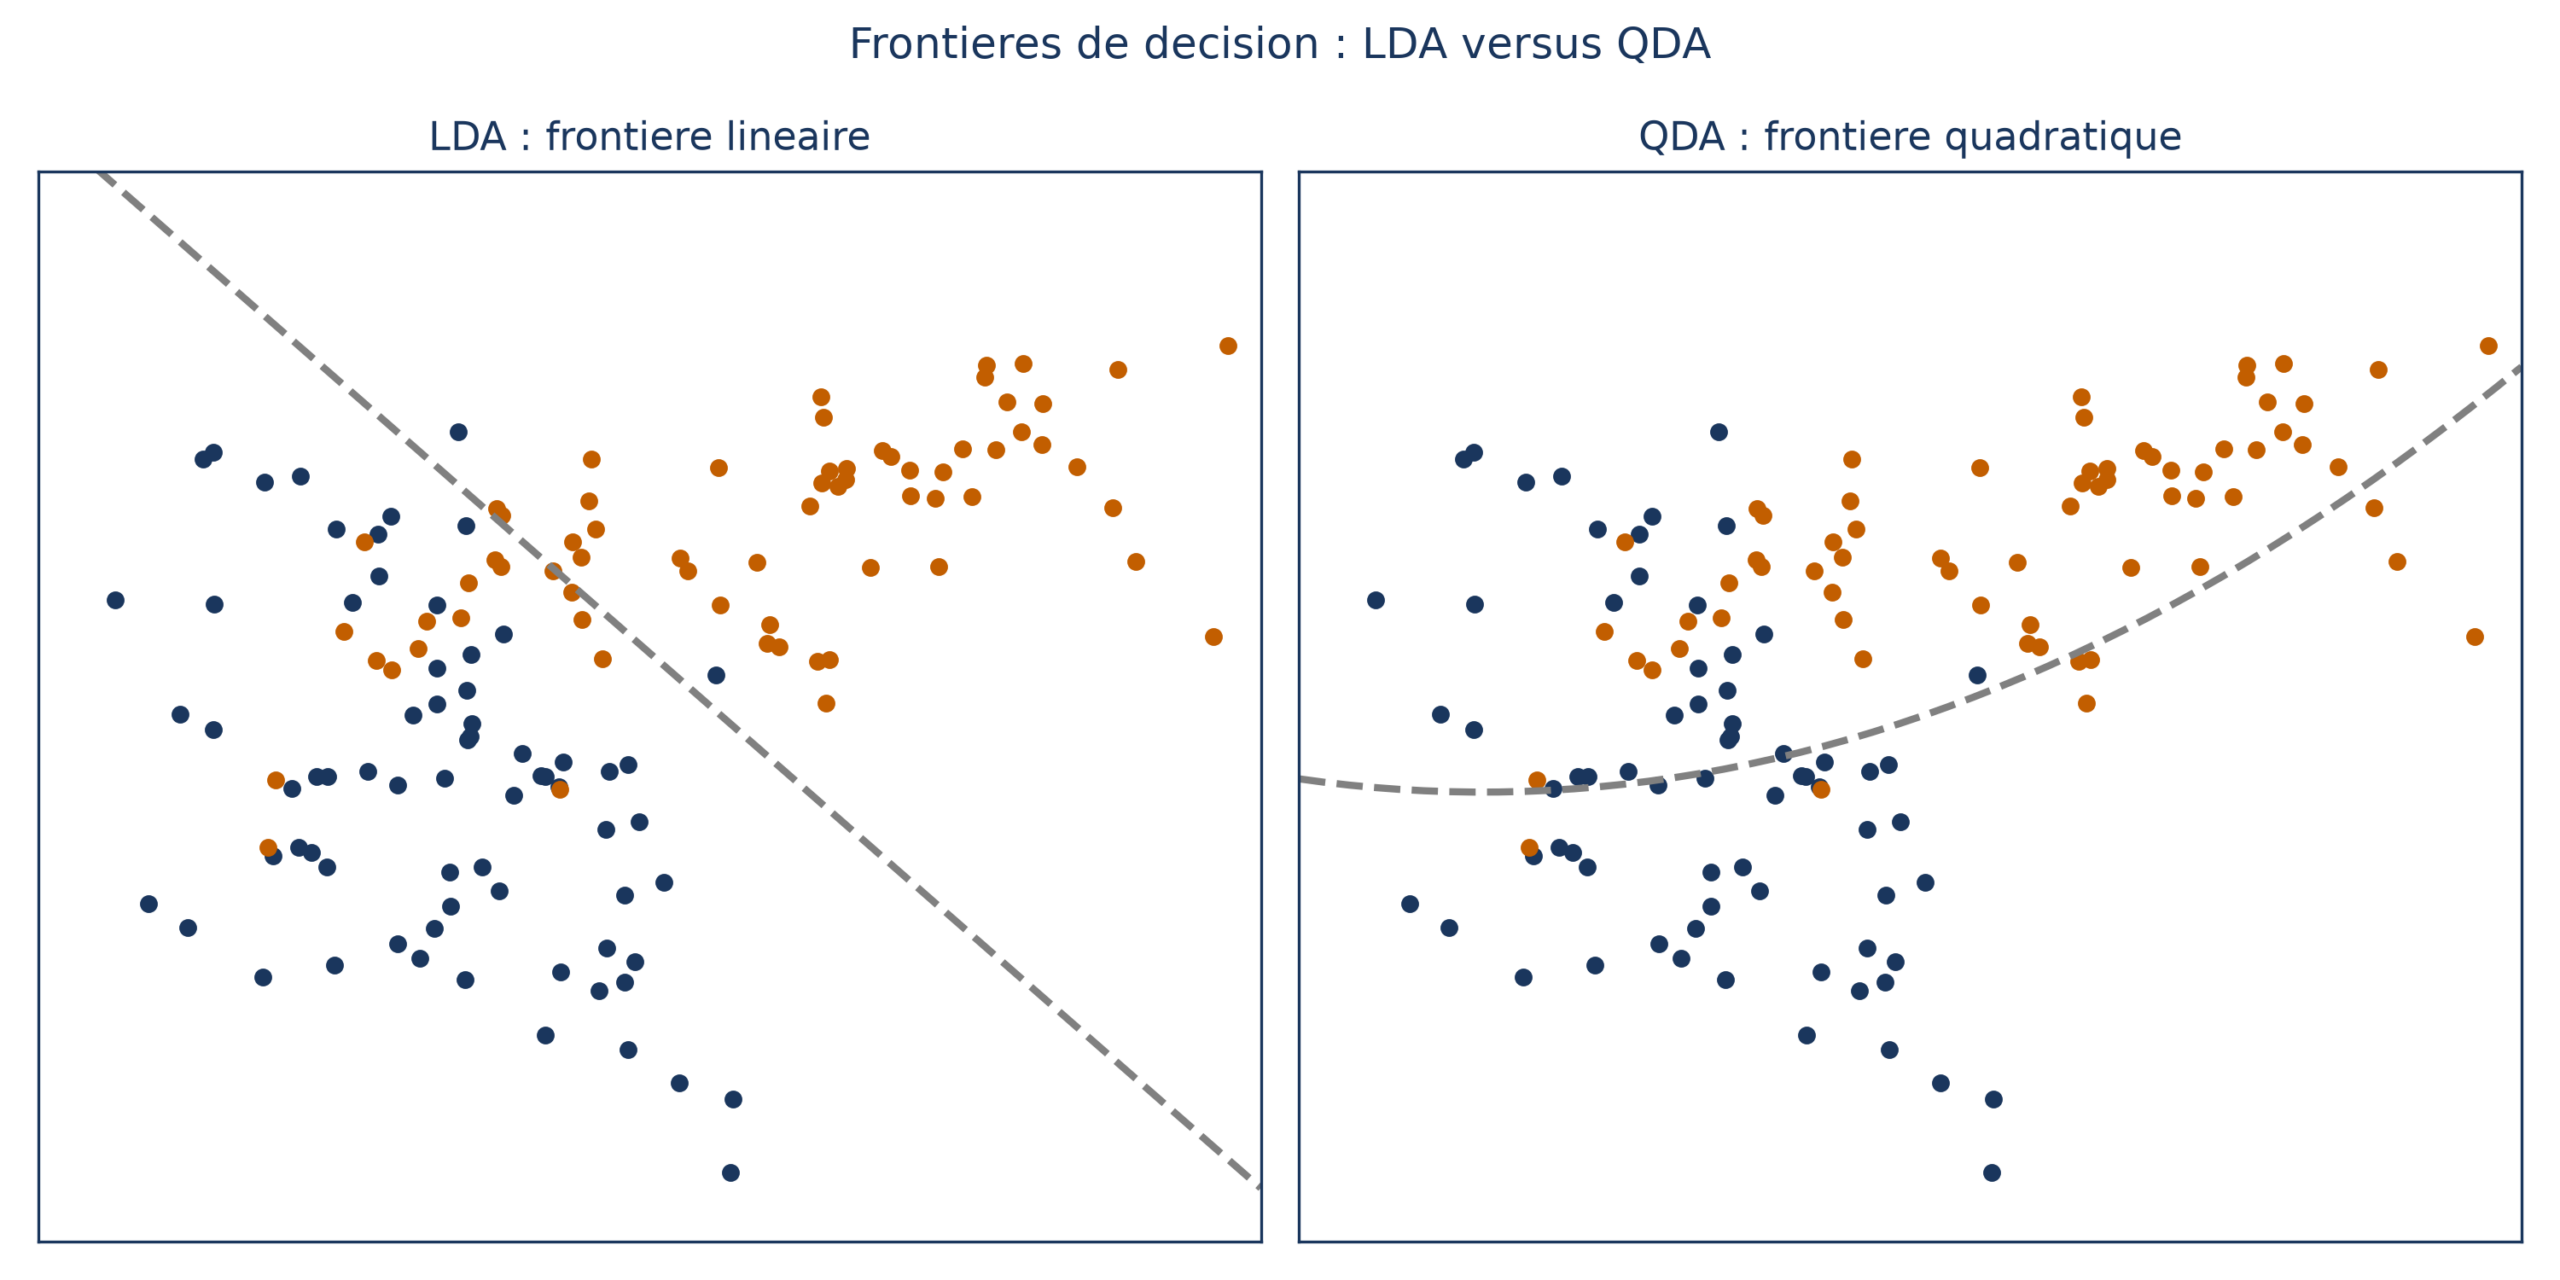
Cette lignée est ancienne : l’analyse discriminante linéaire date de 1936, la régression logistique des années 1940. Au sein de la famille, ce qui change d’une méthode à l’autre, c’est l’hypothèse faite sur  : une loi normale à covariance commune pour la LDA, une covariance propre à chaque classe pour la QDA, des prédicteurs indépendants pour le naïf Bayes.
Ce dernier mérite qu’on s’y arrête, car son nom prête à sourire. Il ne suppose aucune forme paramétrique pour : il affirme seulement que, dans chaque classe, les prédicteurs sont indépendants les uns des autres. L’hypothèse est presque toujours fausse en toute rigueur, d’où le qualificatif « naïf », mais elle évite de modéliser les corrélations entre prédicteurs et simplifie radicalement l’estimation.
Chez les ingénieurs, premier moteur : écrire la suite, un jeton après l’autre
Prends la séquence « to be or not to ». Un modèle de langage estime la probabilité que le mot suivant soit « be », et il le fait pour chaque mot du vocabulaire à la fois. La probabilité d’une phrase entière se décompose alors en un produit :
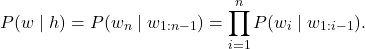
Lis-la de gauche à droite :  est le
 -ième mot,
 tous ceux qui le précèdent, et le produit multiplie, mot après mot, la probabilité de chaque mot sachant ce qui a déjà été écrit. On parle de génération autorégressive, ou de modélisation causale du langage, puisque les mots déjà choisis comptent dans le calcul de la suite.
Reste à choisir un mot dans cette liste de probabilités. Prendre systématiquement le plus probable (le décodage glouton) ne s’utilise plus guère : le résultat est trop prévisible, générique et répétitif. Tirer au hasard produit l’excès inverse, des phrases étranges, car le modèle peut choisir des mots rares. L’échantillonnage top-k tient le milieu : à chaque pas, il ne garde que les mots les plus probables. Le réglage consiste à équilibrer qualité et diversité.
La même mécanique accepte un contexte en plus. Dans un système qui va chercher des documents avant de répondre, chaque probabilité du produit dépend aussi de la consigne donnée, des documents retrouvés et de la question, tous concaténés.
Chez les ingénieurs, second moteur : partir du bruit
Une image ne s’écrit pas mot à mot. Le second archétype part d’un bruit aléatoire et le raffine, étape après étape, vers la sortie la plus probable : c’est le débruitage itératif. Les modèles d’images et de vidéos fonctionnent ainsi.
La partie la plus longue d’une génération d’image, ce sont les 30 à 50 étapes de débruitage. Le temps de génération est linéaire en nombre d’étapes, et chaque passage s’exécute avec un lot de deux : une passe guidée par le prompt, une sans. Le paramètre de guidage règle le poids de l’image guidée dans la combinaison des deux.
Pourquoi ne pas simplement faire moins d’étapes ? Des modèles y sont entraînés : huit étapes ou moins, 80 à 90 % plus rapides que les modèles traditionnels. On les obtient par cohérence latente (le modèle prédit directement le vecteur latent cible et répète la prédiction deux à quatre fois) ou par distillation (un petit modèle apprend à imiter un grand en moins d’étapes).
⚠️ Piège Cette vitesse a un prix écrit noir sur blanc : une qualité nettement moindre. Ces modèles conviennent aux usages sensibles à la latence où la qualité compte moins, comme des filtres génératifs en temps réel, pas à tout.
La vidéo pousse la même logique à l’extrême. L’approche naïve, image après image, accumule les erreurs : de petits défauts initiaux s’aggravent et la vidéo part à la dérive. Les modèles modernes gardent donc toute la vidéo dans l’espace latent et la modifient à chaque étape : chaque image porte son attention sur toutes les autres, et l’espace latent ajoute une troisième dimension, le temps, aux deux dimensions de l’image.
L’addition est salée : plusieurs secondes d’inférence par seconde de vidéo, un nœud de huit GPU mobilisé pour une seule requête, et des séquences qui ne dépassent pas quelques secondes. Ironie du sort, une piste de recherche revient à l’idée autorégressive : combiner une vue globale de la qualité et une génération itérative, ce qui traite en partie le goulot de l’attention.
Un moteur par format
Deux archétypes suffisent à ranger presque toutes les modalités. Voici la carte :
| Archétype | Comment la sortie se construit | Modèles concernés |
|---|---|---|
| Génération autorégressive | à partir d’une séquence de jetons, on prédit le plus probable à chaque pas | LLM, modèles vision-langage, embeddings de texte et de multimédia, reconnaissance vocale, synthèse vocale |
| Débruitage itératif | on part d’un bruit et on le raffine vers la sortie probable | images, vidéos |
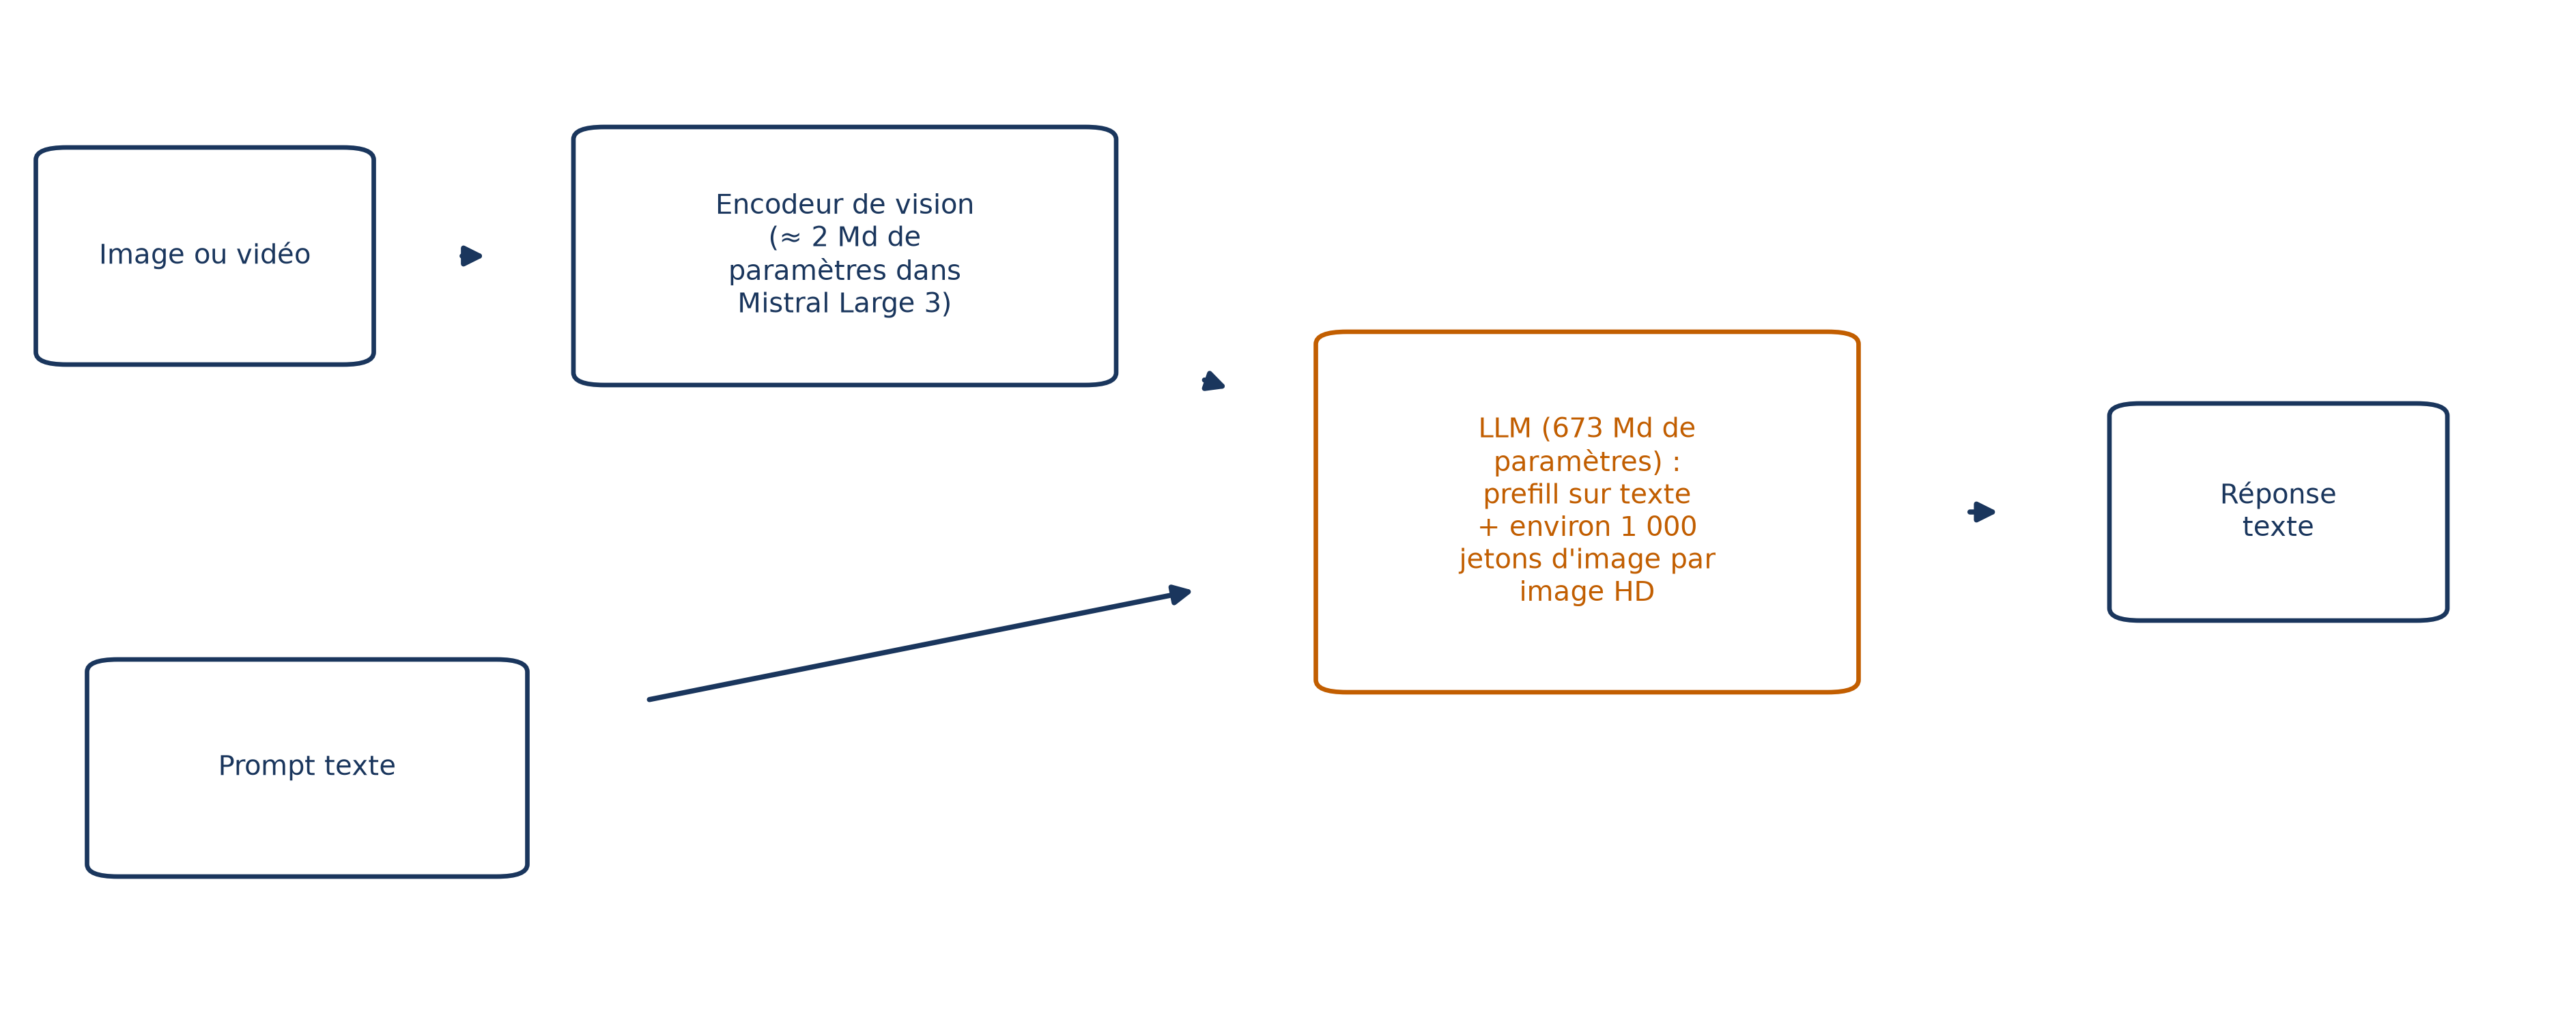
Comment une image entre-t-elle dans le premier moteur ? Un petit encodeur de vision la convertit en jetons d’image, qui rejoignent le texte à l’entrée du LLM. Au niveau le plus général, ces jetons ressemblent aux jetons ordinaires, mais ils s’additionnent vite : une image haute résolution ajoute environ mille jetons à la séquence.
La parole raconte la même parenté. Aujourd’hui, la plupart des systèmes vocaux enchaînent un modèle de reconnaissance de la voix, un LLM et un modèle de synthèse vocale. Les modèles parole à parole unifient ce pipeline en un seul modèle, ce que rend possible la ressemblance d’architecture entre ces trois briques, surtout côté décodeur. À la publication, les options fermées de ce type sont nettement moins capables et plus chères que le montage en cascade. Autre conséquence d’un format nouveau : on change de métrique. Un seul jeton audio n’est pas très utile, donc on mesure le temps jusqu’au premier mot ou à la première phrase.
Reste un point de méthode. Un modèle génératif est une composition de grands et complexes réseaux de neurones, et le servir en production est autrement plus complexe que pour un modèle classique : aux débuts de Baseten, des modèles XGBoost tournaient sur de modestes processeurs avec une pile logicielle élémentaire.
Trois idées reçues sur « génératif »
« Génératif veut dire qui crée »
Pas nécessairement. La LDA, la QDA et le naïf Bayes sont génératifs au sens statistique, et pourtant ils ne fabriquent rien : ils servent à classer. Le qualificatif décrit la manière de modéliser les données, pas ce que tu fais de la sortie.
« Un modèle naïf est un mauvais modèle »
Le naïf Bayes répond à lui seul. Son hypothèse d’indépendance est presque toujours fausse, et il se révèle pourtant souvent étonnamment efficace, en particulier quand les observations sont peu nombreuses ou les prédicteurs relativement nombreux : un domaine où estimer une matrice de covariance complète deviendrait périlleux.
« Un texte fluide est un texte raisonné »
Un modèle de langage résout le classique problème des 25 chevaux. Remplace « cheval » par « lapin » : il échoue, alors que la logique du problème n’a pas bougé. GPT-4 comme Claude chutent nettement quand on perturbe les noms d’animaux et les nombres. Sur un jeu d’arithmétique dont on a modifié les valeurs numériques, la performance chute quand on change les chiffres et se dégrade avec la complexité, et le modèle se laisse tromper par des phrases ajoutées sans pertinence, qu’il tente de transformer en opérations.
Le débat n’est pas clos. Pour certains, ces modèles savent raisonner et il faut seulement le débloquer, par exemple en demandant des étapes intermédiaires. Mais même ce gain est contesté : jusqu’à 95 % du gain de cette technique sur un référentiel très utilisé (MMLU) est attribué aux questions contenant le signe « = ». Retiens la leçon pour toute la famille : un modèle qui produit des suites probables est excellent pour trouver des motifs, et fragile quand le motif change.
📌 À retenir Devant un modèle « génératif », demande-lui quelle loi de probabilité il apprend : celle des données de chaque classe (puis Bayes pour décider), celle du jeton suivant (jeton après jeton), ou celle d’une image à partir du bruit (étape après étape). Le reste est une affaire de format et de coût.