Un enquêteur relève une empreinte, une trace de boue et un témoignage. Aucun de ces trois indices ne désigne un coupable à lui seul, mais pour chaque suspect il sait à peu près à quel point chacun lui ressemble. Le classificateur Naive Bayes procède comme lui : il pèse les indices un par un, puis les combine en un verdict. À la fin, tu sauras ce qu’il calcule, pourquoi on le dit « naïf » et ce que cette naïveté te coûte ou te rapporte.
Sommaire
- L’essentiel en 30 secondes
- Ce que calcule un classificateur génératif
- « Naïf » : une hypothèse qui transforme tout en produit
- Un calcul à la main : deux indices, deux classes
- Pourquoi une hypothèse fausse peut bien classer
L’essentiel en 30 secondes
- Le Naive Bayes est un classificateur génératif : il décrit d’abord la répartition des prédicteurs dans chaque classe, puis applique le théorème de Bayes.
- Sa seule hypothèse, les prédicteurs sont indépendants au sein de chaque classe, lui vaut le qualificatif « naïf ».
- Cette hypothèse est presque toujours fausse en toute rigueur, mais elle épargne l’estimation des corrélations entre prédicteurs.
- Il se révèle souvent très efficace quand les exemples d’entraînement manquent ou que les variables abondent.
- Sa frontière de décision est plus flexible que celle de la LDA, sans covariance croisée à estimer.
Ce que calcule un classificateur génératif
Classer une observation, c’est lui attribuer une catégorie. La plupart des méthodes y parviennent en deux temps : elles estiment d’abord la probabilité d’appartenir à chaque catégorie, puis en déduisent une classe. Le meilleur choix possible est connu : retenir la classe dont la probabilité 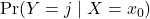 est la plus grande. Le seul obstacle est que cette probabilité reste inconnue en pratique, ce qui fait de ce choix idéal un étalon inatteignable.
Le Naive Bayes la reconstruit par le chemin inverse. Au lieu de modéliser directement cette probabilité, il décrit d’abord, classe par classe, la façon dont les prédicteurs  se répartissent :
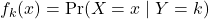 . Le théorème de Bayes ramène ensuite de cette description à la probabilité cherchée :
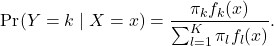
Dans cette formule,  porte le nom de a priori : la fréquence attendue de la classe
 avant d’avoir regardé
 . Le terme
 est la vraisemblance : il dit à quel point les valeurs observées sont typiques de la classe .
Rapporte le produit  à son total sur les
 classes : tu obtiens la probabilité a posteriori, celle qui intègre les données une fois vues. Le Naive Bayes suit ce schéma à la lettre, en ajoutant une seule hypothèse sur la façon de construire
 .
💡 Intuition Reprends l’enquêteur. L’a priori, c’est sa première impression avant d’examiner quoi que ce soit. La vraisemblance, c’est ce que chaque suspect aurait pu laisser comme indices. L’a posteriori, c’est son opinion après avoir tout confronté.
« Naïf » : une hypothèse qui transforme tout en produit
Reste à fabriquer . Le piège est que regroupe plusieurs prédicteurs à la fois : décrire leur répartition d’ensemble oblige à modéliser leurs corrélations. Le Naive Bayes coupe court avec une seule hypothèse : classe par classe, les prédicteurs sont indépendants entre eux.
Quand deux événements sont indépendants, savoir que l’un s’est produit n’apprend rien sur l’autre, et la règle de multiplication se simplifie en 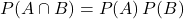 . Appliquée aux
 prédicteurs d’une même classe, elle fait éclater la loi d’ensemble en un produit de lois à une seule variable :
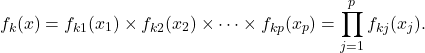
Le facteur  décrit le seul prédicteur
 dans la classe . Il suffit de glisser ce produit à la place de dans la formule de Bayes : chaque indice se décrit à part, classe par classe, comme chez ton enquêteur.
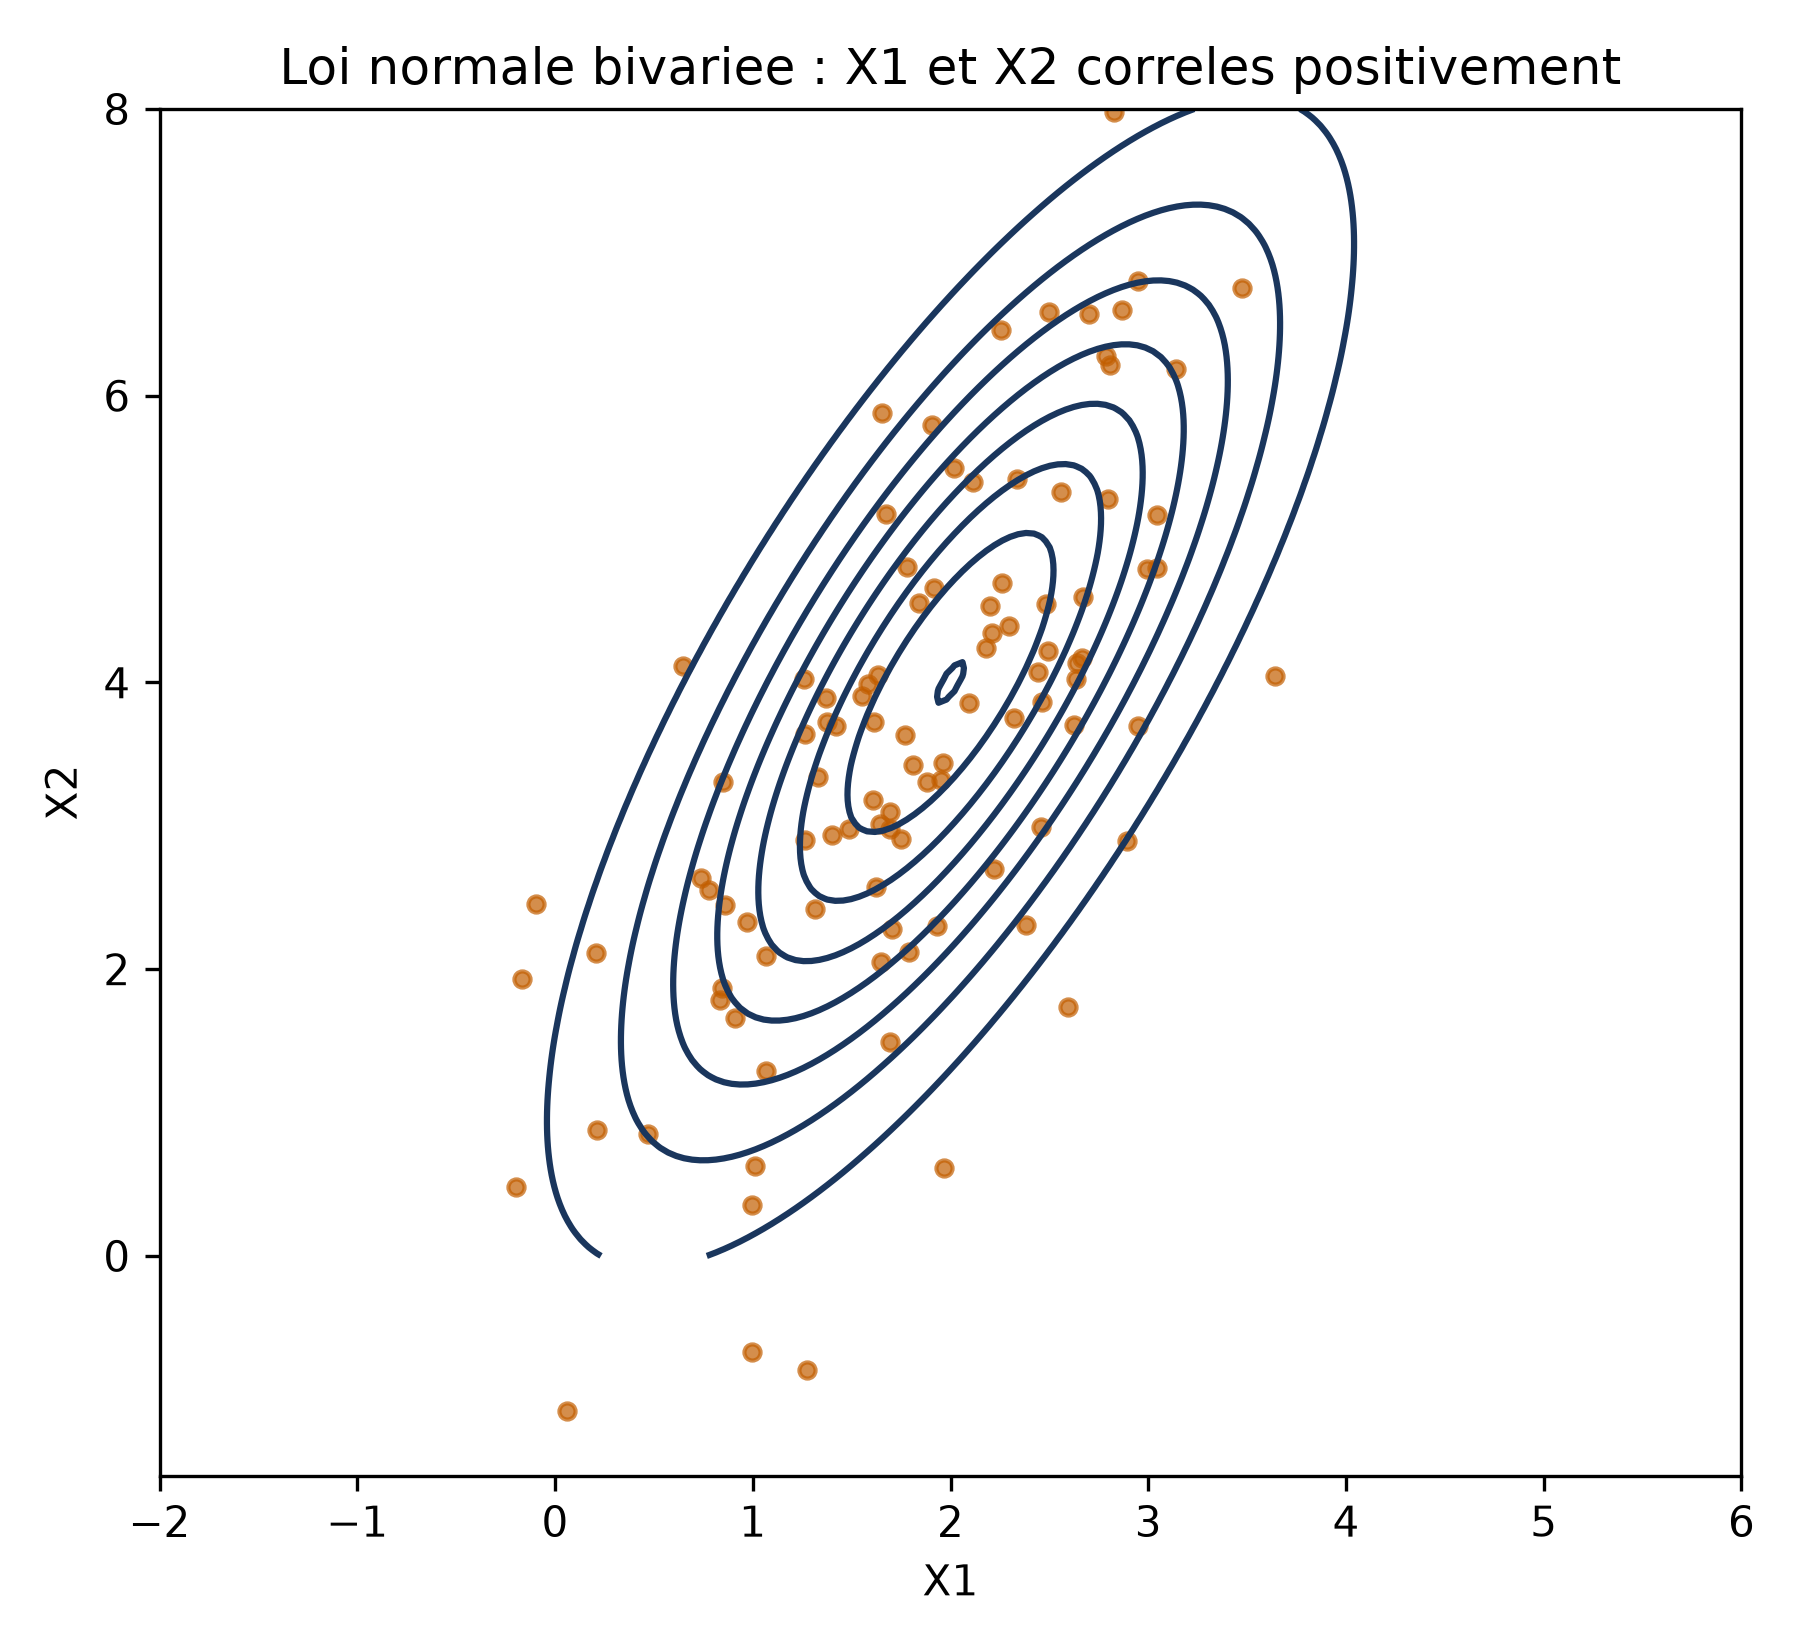
⚠️ Piège Indépendant ne se réduit pas à « covariance nulle » : la covariance ne mesure que la dépendance linéaire, et une covariance nulle n’implique pas l’indépendance. Retiens aussi que l’hypothèse vaut classe par classe : c’est une indépendance conditionnellement à la classe.
Un calcul à la main : deux indices, deux classes
Passons aux chiffres. Les nombres ci-dessous sont inventés pour suivre le calcul, ce ne sont pas des mesures. Deux classes, A et B, et deux indices observés sur une même observation :
| Classe A | Classe B | |
|---|---|---|
| a priori |
0,3 | 0,7 |
| vraisemblance de l’indice 1 | 0,8 | 0,2 |
| vraisemblance de l’indice 2 | 0,5 | 0,4 |
Pour chaque classe, multiplie l’a priori par les deux vraisemblances, comme le prescrit le produit ci-dessus :

Le dénominateur de la formule de Bayes est la somme de ces deux résultats, soit  . Les probabilités a posteriori valent donc
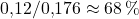 pour A et
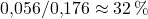 pour B. L’observation est rangée dans la classe la plus probable, ici A.
Observe le renversement : B était la classe la plus fréquente, avec 70 % d’a priori, et pourtant les deux indices font basculer le verdict vers A. Un seul indice isolé aurait pu ne pas suffire ; leur produit, si.
Pourquoi une hypothèse fausse peut bien classer
Une hypothèse presque toujours fausse en toute rigueur, et pourtant un modèle étonnamment efficace : l’apparente contradiction se résout en regardant ce qu’il faut estimer. La matrice de covariance range d’un côté la dispersion de chaque variable, de l’autre les liens qui les unissent deux à deux. L’estimer pour de bon devient périlleux quand les lignes sont rares ou les colonnes nombreuses, alors que le Naive Bayes ne l’estime jamais.
Cette économie le distingue de ses cousines génératives. La LDA suppose une loi normale et une covariance commune à toutes les classes, la QDA une covariance propre à chaque classe. Le Naive Bayes n’impose aucune forme précise aux : il ne retient que l’indépendance. Il obtient une frontière plus flexible que la LDA, sans covariances croisées à estimer.
Face à la régression logistique, la différence est de nature : elle modélise directement 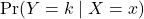 , alors que le Naive Bayes passe par la description des classes. Comme les autres méthodes génératives, il s’étend naturellement à plus de deux classes.
Rien de tout cela ne fait de lui le gagnant universel : aucune méthode ne l’emporte partout. Ton choix dépendra de la vraie forme de la frontière, du nombre d’exemples dont tu disposes et du poids que tu donnes à l’interprétabilité.
📌 À retenir Naive Bayes, c’est le théorème de Bayes plus une seule hypothèse : des prédicteurs indépendants dans chaque classe. Cette hypothèse fait du calcul un simple produit d’indices, au prix d’une promesse que les données tiennent rarement.