Tu dois répartir une somme fixe entre deux placements, X et Y, en limitant le risque total. Pour trouver la bonne répartition, il te faut seulement trois nombres : la variabilité de X, celle de Y, et la façon dont les deux bougent ensemble. Rangés dans un petit tableau carré, ces trois nombres forment une matrice de covariance. À la fin, tu sauras la construire, lire chacune de ses cases et deviner où elle travaille en coulisses.
Sommaire
- L’essentiel en 30 secondes
- Trois nombres pour deux placements
- Lire la matrice case par case
- La même matrice en quelques lignes de Python
- Ce que la matrice calcule : la variance d’un mélange
- La forme du nuage de points
- Une matrice par classe, ou une seule pour toutes
- Ce que les bibliothèques font de la matrice
- Trois façons de mal la lire
L’essentiel en 30 secondes
- Une matrice de covariance est un tableau carré de covariances : une ligne et une colonne par variable.
- Sa diagonale contient les variances ; chaque autre case compare deux variables différentes.
- Elle est toujours symétrique : la case (h, k) et la case (k, h) sont identiques.
- Elle donne la variance de tout mélange pondéré des variables.
- Dans une loi normale, elle fixe la forme du nuage de points, et c’est elle qui distingue LDA de QDA.
- Elle se déforme facilement : dupliquer une ligne de données la modifie.
Trois nombres pour deux placements
Reprenons nos deux placements, de rendements X et Y. Tu en mets une fraction α dans X et le reste dans Y, et tu cherches la fraction qui rend le risque 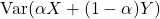 le plus petit possible. La réponse s’écrit :
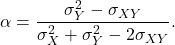
Trois quantités seulement y figurent :  et
 sont les variances de X et de Y, et
 leur covariance. Prends des valeurs :
 ,
 et
 . Le calcul donne
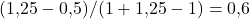 : 60 % dans X, 40 % dans Y.
Une covariance entre deux variables  et
 , mesurées sur
 observations, est la moyenne (corrigée par
 ) des produits de leurs écarts à la moyenne :
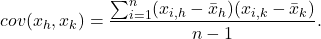
Son signe indique si les deux variables évoluent de concert ou à contresens. Il reste à ranger nos trois nombres. On les dispose dans un tableau carré, ligne et colonne étiquetées X puis Y :
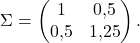
C’est la matrice de covariance de nos deux placements : on y rassemble toutes les covariances, y compris celle de chaque variable avec elle-même.
Lire la matrice case par case
Chaque case répond à une question précise. Garde notre  sous les yeux.
- Case (X, X) = 1 : la covariance de X avec lui-même, qui n’est autre que sa variance.
- Case (Y, Y) = 1,25 : la variance de Y, donc la dispersion de ses valeurs autour de sa moyenne.
- Cases (X, Y) et (Y, X) = 0,5 : la covariance des deux placements. Positive, elle indique des rendements qui montent et descendent plutôt ensemble.
Les deux cases hors diagonale sont égales. Ce n’est pas un hasard : une matrice égale à sa propre transposée est dite symétrique, et toute matrice de covariance l’est. Avec  variables, le tableau compte lignes et colonnes.
Une covariance de 0,5 est-elle forte ou faible ? Le nombre seul ne le dit pas. Pour le savoir, on divise par les écarts-types, ce qui donne le coefficient de corrélation de Pearson, coincé entre −1 et 1 quelles que soient les variables.
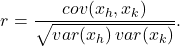
Ici,  : un lien positif et modéré.
💡 Intuition Lis la diagonale comme « chacun pour soi » et le reste comme « chacun avec chacun ». Une matrice ne contient donc rien d’autre que les variances et les covariances de toutes les paires, rangées une fois pour toutes.
La même matrice en quelques lignes de Python
Imagine que tu disposes d’un tableau Portfolio de 100 paires de rendements, colonnes X et Y, et que tu veux en tirer la fraction α sans recopier de formule à la main. Le bloc suivant est une session interactive : chaque ligne In [n]: est une commande saisie, le nombre n compte les saisies de la session.
In [15]: Portfolio = load_data('Portfolio')

In [16]: def alpha_func(D, idx):
             cov_ = np.cov(D[['X','Y']].loc[idx], rowvar=False)
             return ((cov_[1,1] - cov_[0,1]) /
                      (cov_[0,0]+cov_[1,1]-2*cov_[0,1]))
np.cov reçoit les deux colonnes X et Y et renvoie la matrice, que le code lit par positions. cov_[0,0] et cov_[1,1] sont les cases de la diagonale, donc les variances de X et de Y ; cov_[0,1] est la covariance. Remplace-les dans la formule de α de la section précédente : c’est exactement le même calcul. L’argument idx désigne les lignes à garder : on peut ainsi recalculer α sur un sous-ensemble tiré au hasard.
Sur 100 paires, la matrice estimée n’est pas exacte. Avec des paramètres connus (, , ), 1 000 échantillons simulés donnent un α moyen de 0,5996 et un écart-type d’environ 0,083 : d’un échantillon à l’autre, la fraction trouvée bouge de quelques centièmes.
Ce que la matrice calcule : la variance d’un mélange
Voici son vrai talent. Soit  un tableau de données à lignes et colonnes, et
 une liste de poids. Le mélange pondéré des colonnes, noté
 , a pour variance :
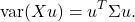
Applique-le à nos placements, avec 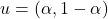 . Pour
 , on trouve
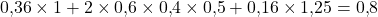 . Une répartition moitié-moitié donne 0,8125, tout dans X donne 1, tout dans Y donne 1,25. 0,6 reste la fraction optimale, et la matrice a suffi pour le vérifier.
Cette même quantité sert aussi en ACP : on cherche la direction de norme 1 qui la rend maximale. Cette direction est un vecteur propre de , et la variance obtenue vaut la valeur propre correspondante.
La forme du nuage de points
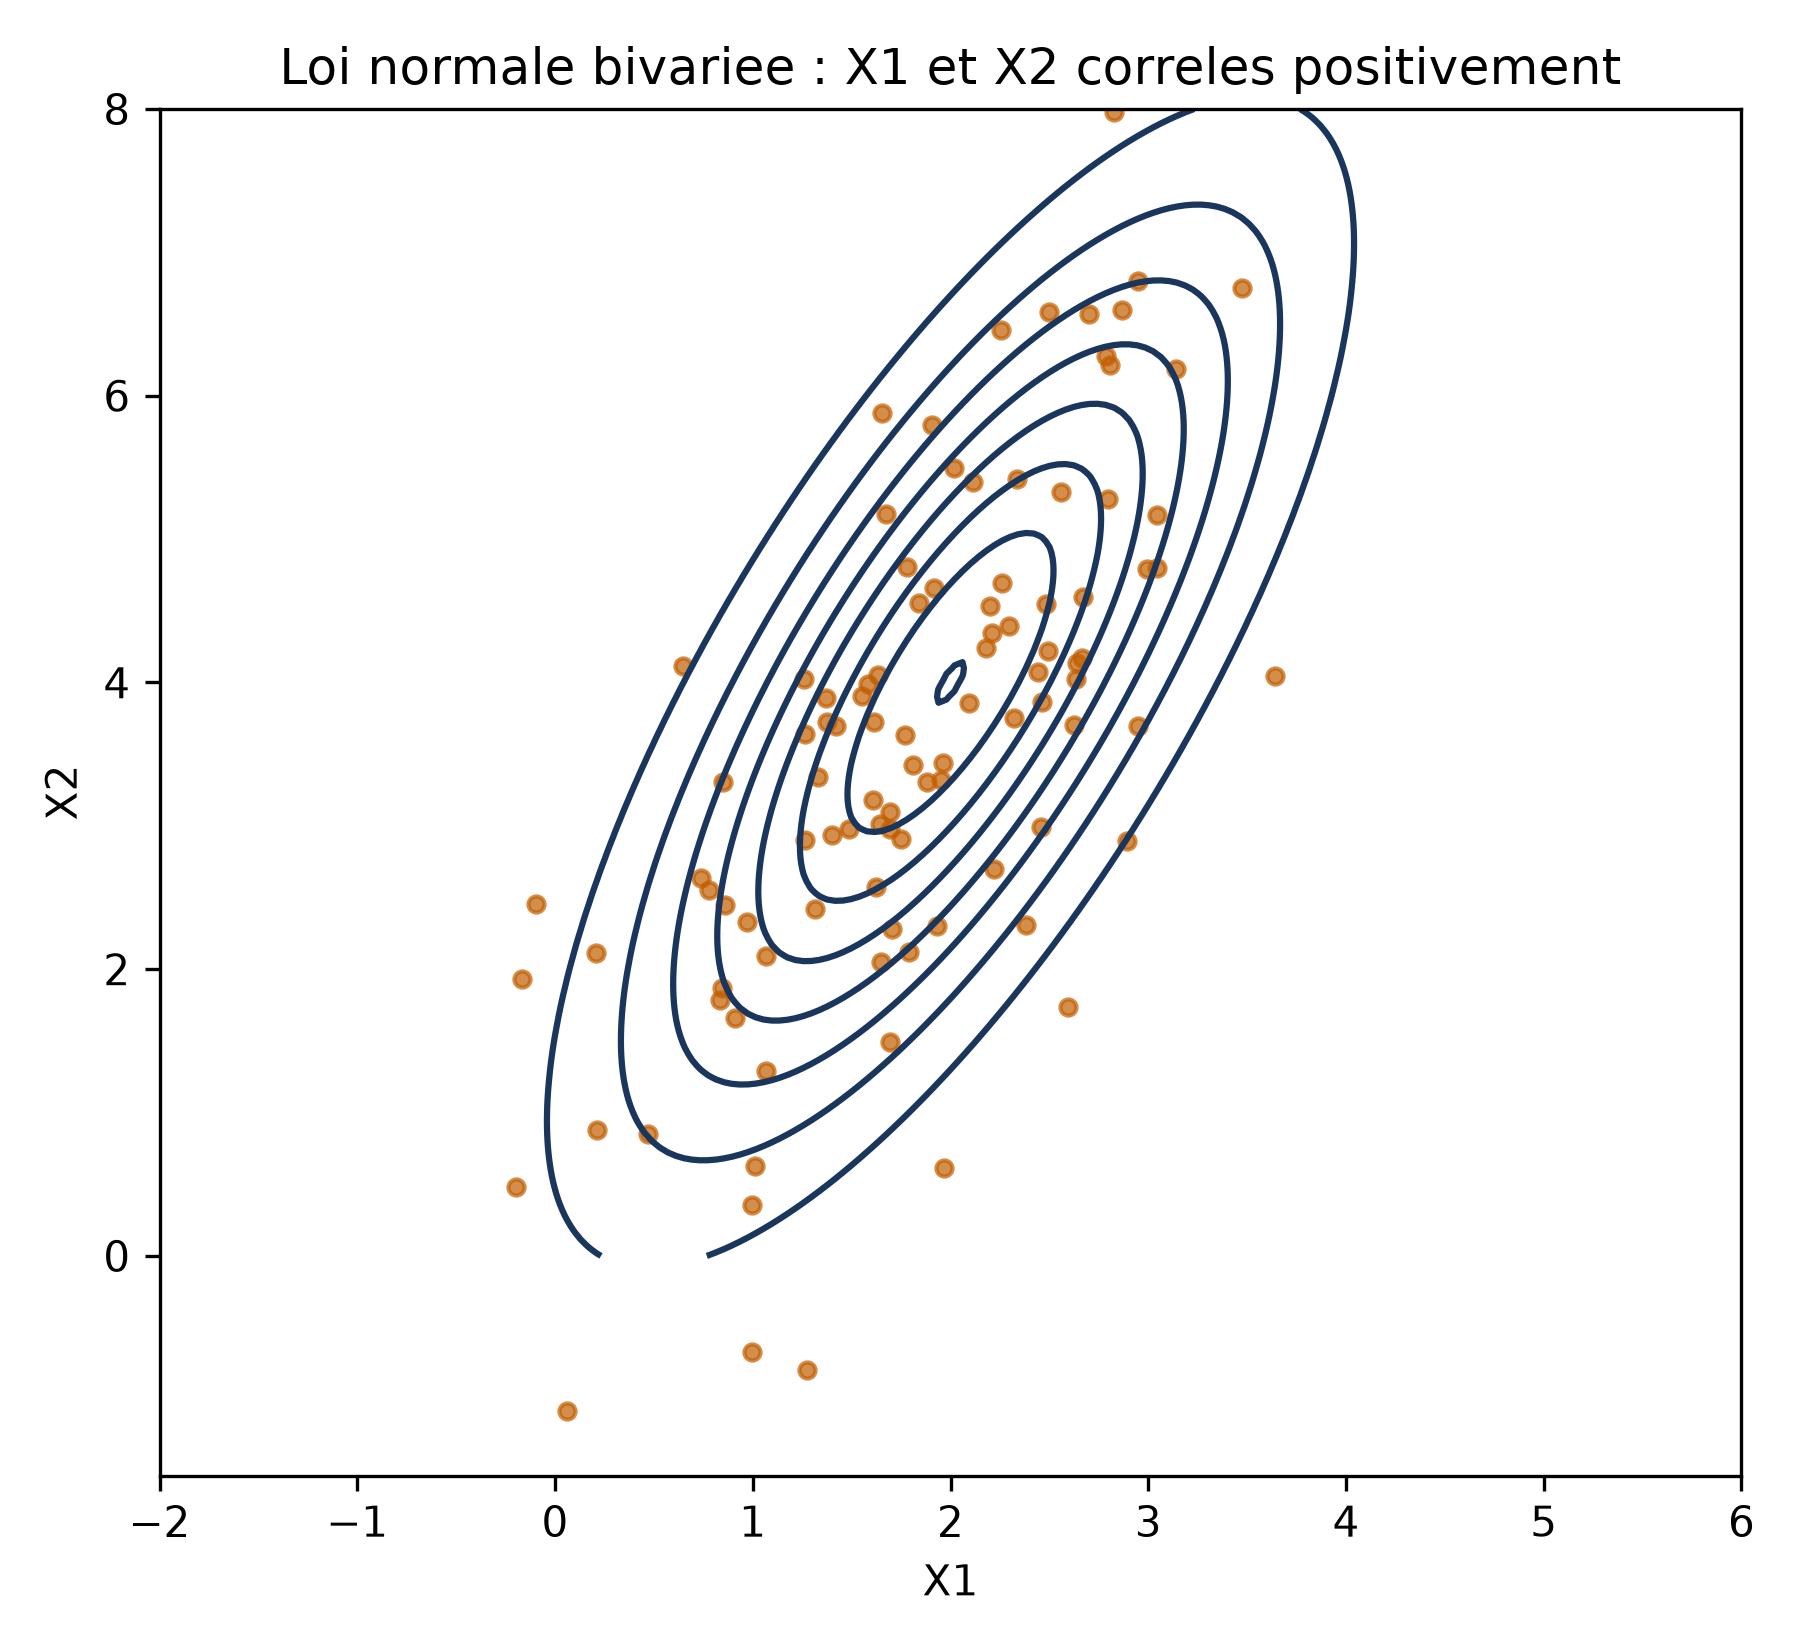
Une loi normale à une variable se décrit par une moyenne et une variance. Avec plusieurs variables, la variance devient une matrice de covariance complète, qui capture la dispersion de chaque variable et leurs corrélations mutuelles. Une propriété rend ce cadre précieux : toute combinaison linéaire de ses variables suit encore une loi normale.
Une matrice par classe, ou une seule pour toutes
La matrice de covariance joue aussi un rôle de juge en classification. L’analyse discriminante linéaire (LDA) modélise chaque classe par une loi normale à moyenne propre, mais impose une matrice de covariance commune à toutes les classes. L’analyse discriminante quadratique (QDA) assouplit cette règle : chaque classe a sa propre matrice.
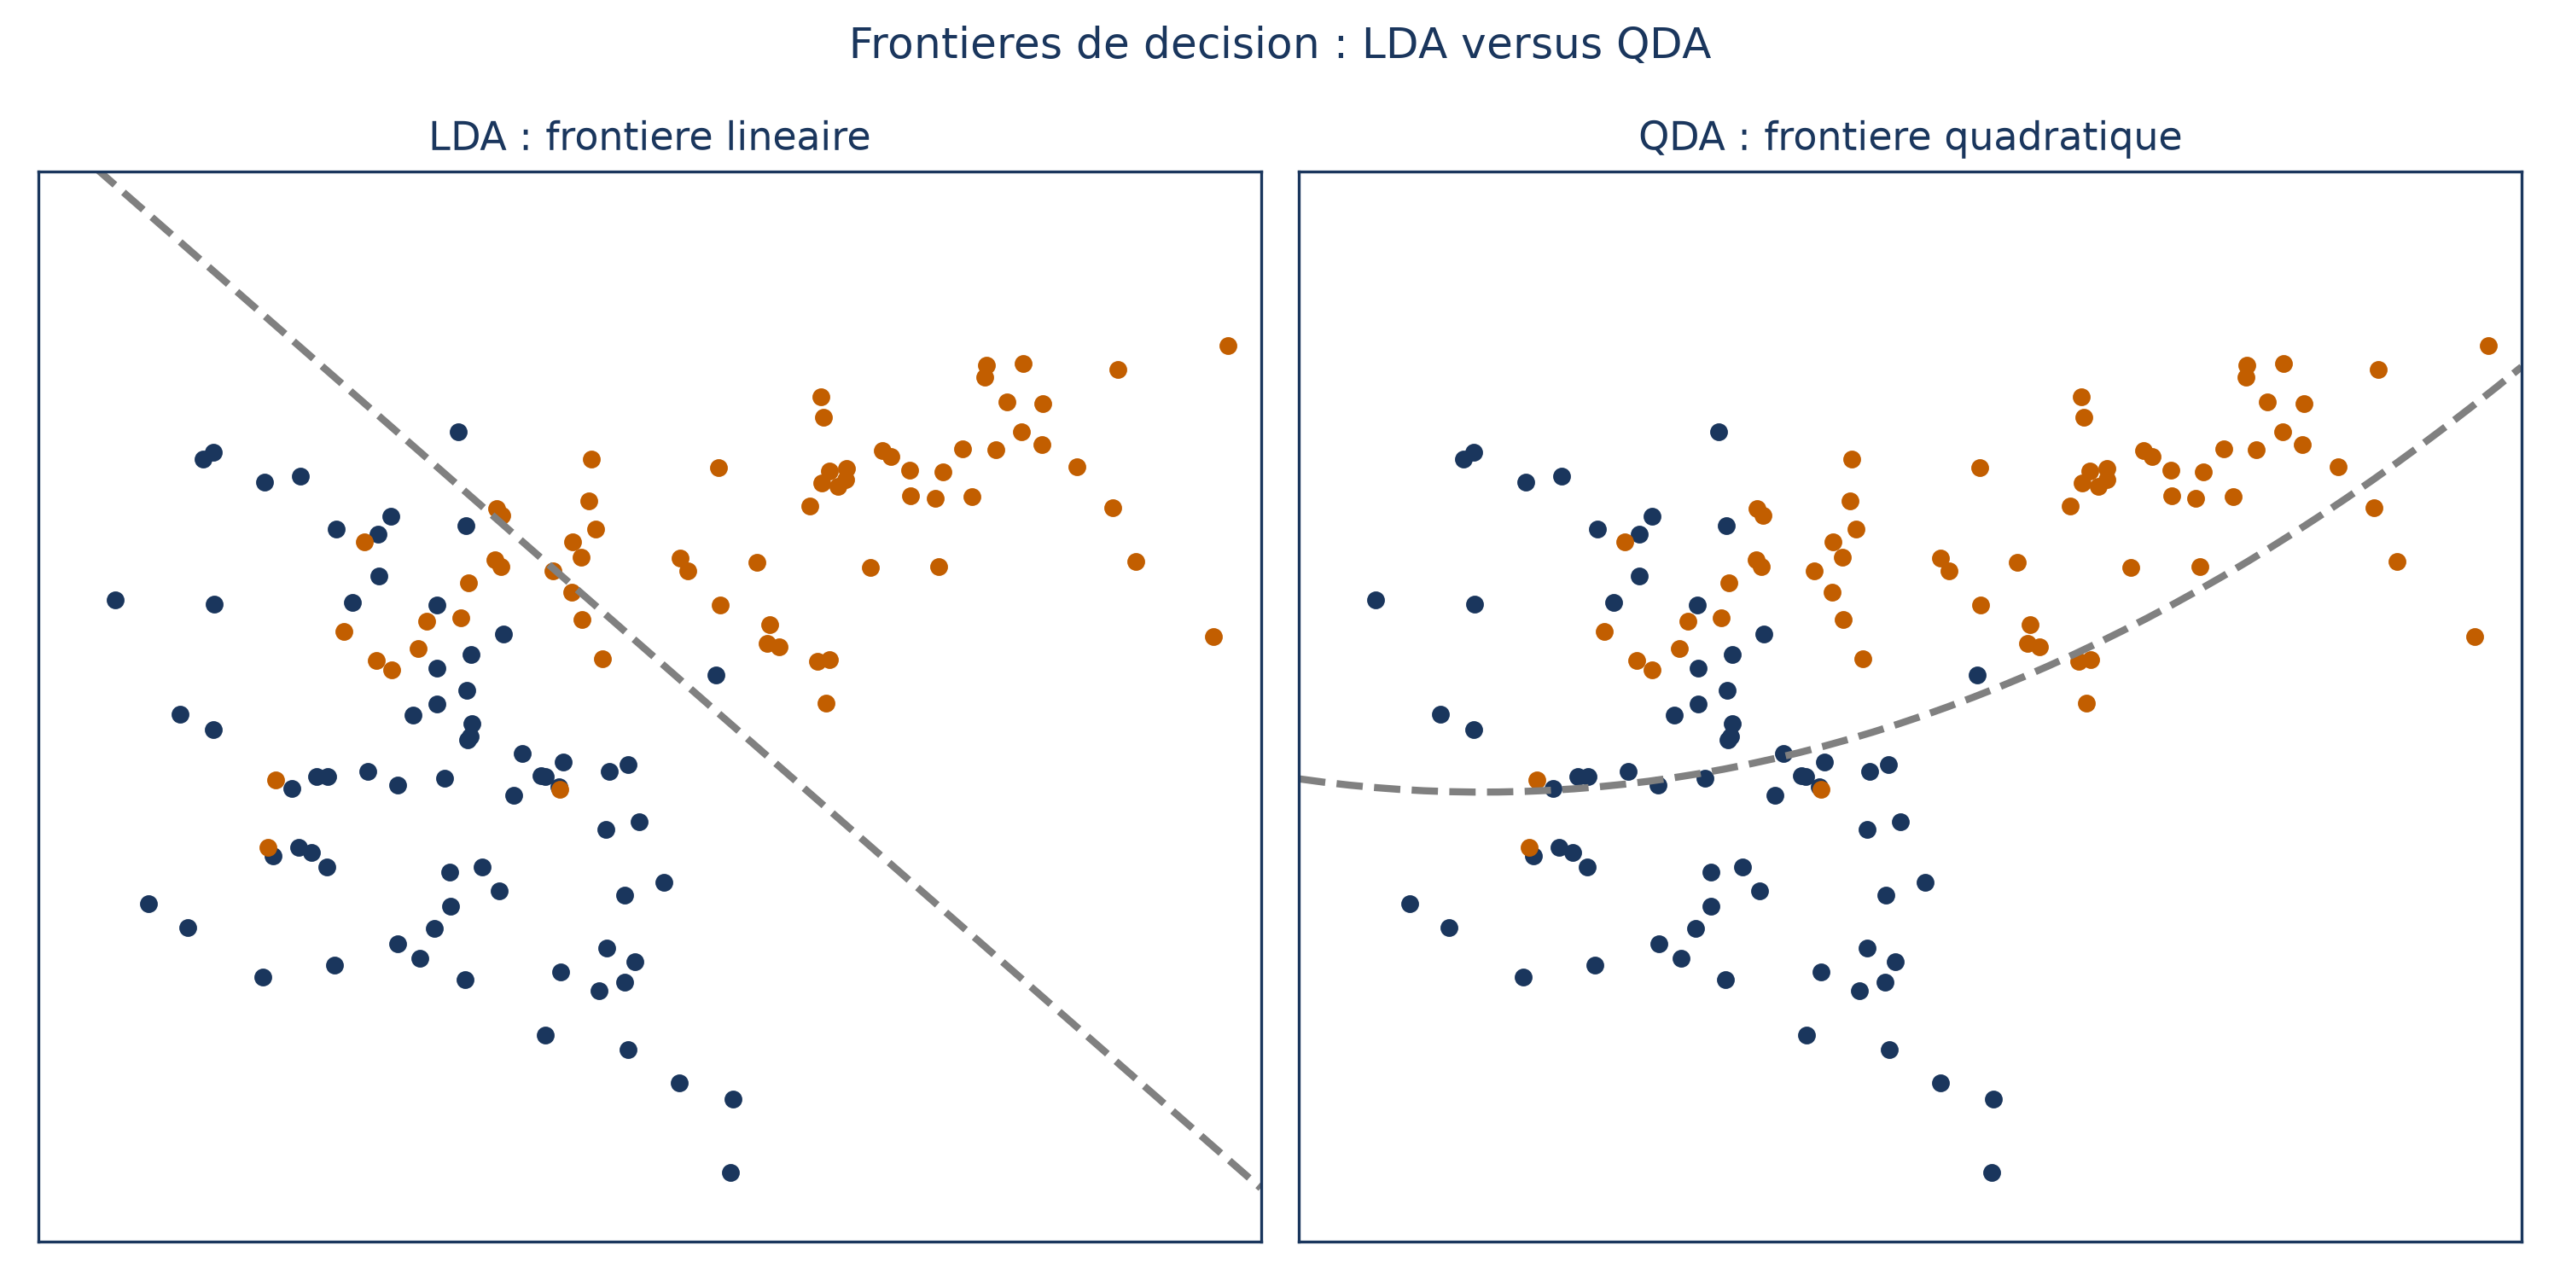
Le choix se joue sur un compromis. QDA est plus flexible mais doit estimer davantage de paramètres : elle se justifie si les classes n’ont vraisemblablement pas la même covariance, ou si l’échantillon est assez grand pour estimer ces paramètres en plus. Avec peu de données, LDA reste préférable.
Ce que les bibliothèques font de la matrice
Dans la pratique, on forme rarement la matrice pour la décomposer ensuite. Les composantes d’une ACP sont ses vecteurs propres, mais les bibliothèques préfèrent souvent passer par la décomposition en valeurs singulières des données centrées, pour des raisons de stabilité numérique.
Les deux chemins mènent au même résultat, car les valeurs singulières  se relient directement aux valeurs propres de la matrice :

où est le nombre d’observations. La symétrie de la matrice garantit en outre que ses vecteurs propres sont orthogonaux entre eux.
Trois façons de mal la lire
Une ligne dupliquée la change. Répéter artificiellement un même point dans les données modifie la matrice de covariance. Une comparaison entre un jeu et sa version où un point est dupliqué trois fois le montre : les valeurs et vecteurs propres restent proches, mais ne coïncident plus exactement.
Elle ne voit que le linéaire. La covariance mesure la dépendance linéaire entre deux variables. Une covariance nulle n’implique donc pas l’indépendance.
Les unités pèsent. Une variable exprimée dans une unité qui donne de grands nombres domine le calcul des variances. Pour l’éviter, on normalise chaque variable à variance 1, quitte à obtenir des directions principales sensiblement différentes.
📌 À retenir Devant une matrice
pour le mélange qui t’intéresse (sa variance).