Imagine un trieur de courrier qui n’a jamais appris de règle de séparation. Il a simplement passé des années à regarder deux piles, jusqu’à connaître par cœur à quoi ressemble une lettre de chaque pile. Face à une enveloppe nouvelle, il se demande laquelle des deux piles aurait le plus de raisons de la produire. C’est, en gros, la démarche de l’analyse discriminante linéaire : au lieu de chercher une frontière, elle apprend un portrait de chaque classe, puis laisse ces portraits voter.
Sommaire
- L’essentiel en 30 secondes
- Décrire d’abord, décider ensuite
- Le portrait d’une classe : une cloche, une moyenne, une dispersion partagée
- Le score δ : trois ingrédients, une droite
- Plusieurs variables : de la cloche aux ellipses
- Où la LDA est à l’aise, où elle trébuche
- Trois cousines et un idéal
L’essentiel en 30 secondes
- La LDA est une méthode de classification dite générative : elle décrit d’abord comment les variables se répartissent dans chaque classe.
- Elle suppose que, dans chaque classe, les variables suivent une loi normale de moyenne propre à la classe mais de dispersion partagée par toutes.
- Pour chaque classe, elle calcule un score linéaire qui combine moyenne, variance commune et fréquence de la classe, puis retient le score le plus haut.
- Elle est stable quand les classes sont bien séparées et s’étend naturellement à plus de deux classes.
- Son talon d’Achille est la normalité : quand elle est clairement violée, la régression logistique se montre plus robuste.
Décrire d’abord, décider ensuite
Beaucoup de méthodes de classification posent la question de front : étant donné ces valeurs, quelle est la probabilité de chaque classe ? La régression logistique est de celles-là. La LDA prend le chemin inverse. Elle modélise d’abord, séparément pour chaque classe  , la façon dont les valeurs
 se distribuent, c’est-à-dire la densité
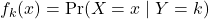 .
Ces portraits ne suffisent pas : il faut encore retourner la question. C’est le travail du théorème de Bayes, qui permet d’inverser une probabilité conditionnelle :
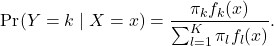
Lis-la comme un jury.  est la probabilité a priori d’appartenir à la classe , avant même d’avoir regardé .
 dit à quel point est typique de cette classe. Leur produit, comparé à la somme du même produit sur les
 classes, donne la probabilité a posteriori : celle qu’on obtient après avoir vu .
Le poids de l’a priori n’a rien d’un détail, et un arbre de dénombrement le montre mieux qu’un long discours. Dans une population de 1 120 personnes, 140 sont malades et 980 sont saines. Parmi les malades, 120 testent positif ; parmi les sains, 735 testent aussi positif (le test n’est pas parfait). Un test positif ne dit donc pas « malade » : la probabilité d’être malade vaut 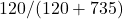 , soit environ 14 %.
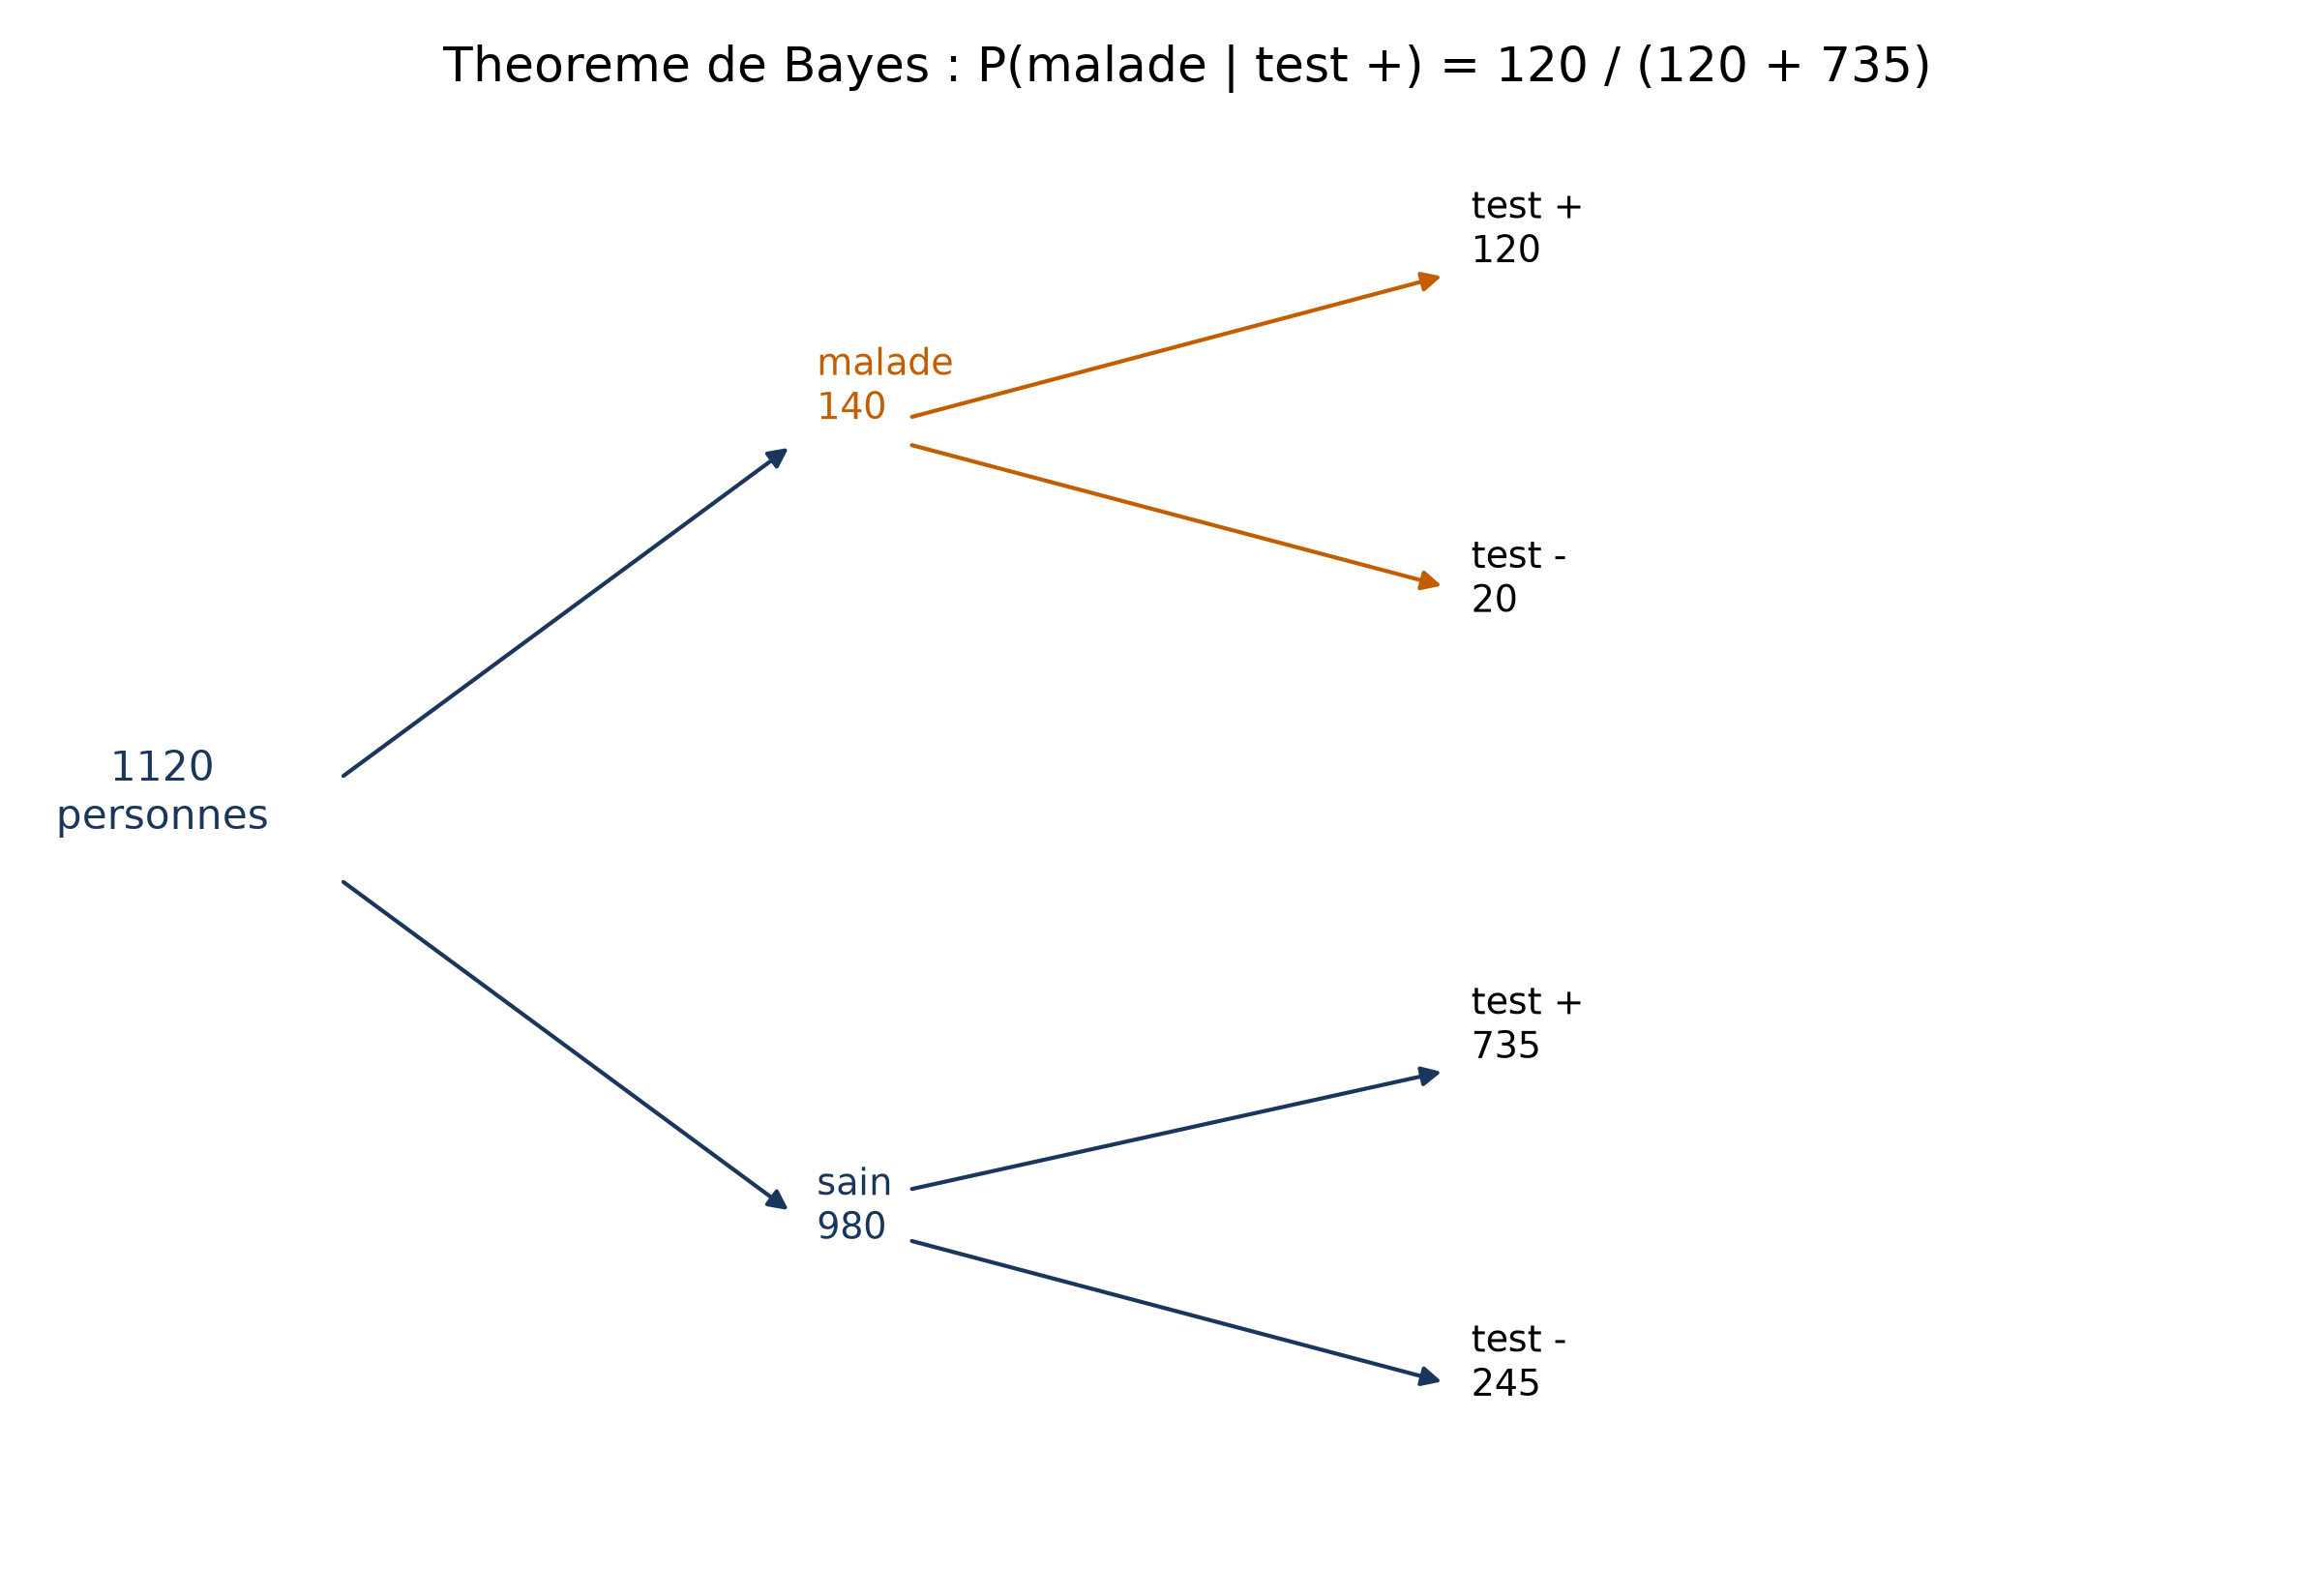
💡 Intuition Une classe qui domine l’effectif prend de l’avance avant même que tu regardes les données. La LDA garde ce réflexe de Bayes : elle ne juge pas un point seulement sur sa ressemblance, mais aussi sur la fréquence de chaque classe.
Le portrait d’une classe : une cloche, une moyenne, une dispersion partagée
Reste à fabriquer chaque . La LDA fait un choix tranché : dans chaque classe, les variables suivent une loi normale, avec une moyenne propre à la classe mais une variance commune à toutes les classes. La densité de cette loi, de moyenne  et de variance
 , s’écrit :
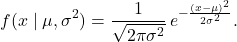
est le centre de la cloche,  son étalement. Environ 68 % des valeurs tombent à moins d’un écart-type de la moyenne, environ 95 % à moins de 1,96 écart-type.
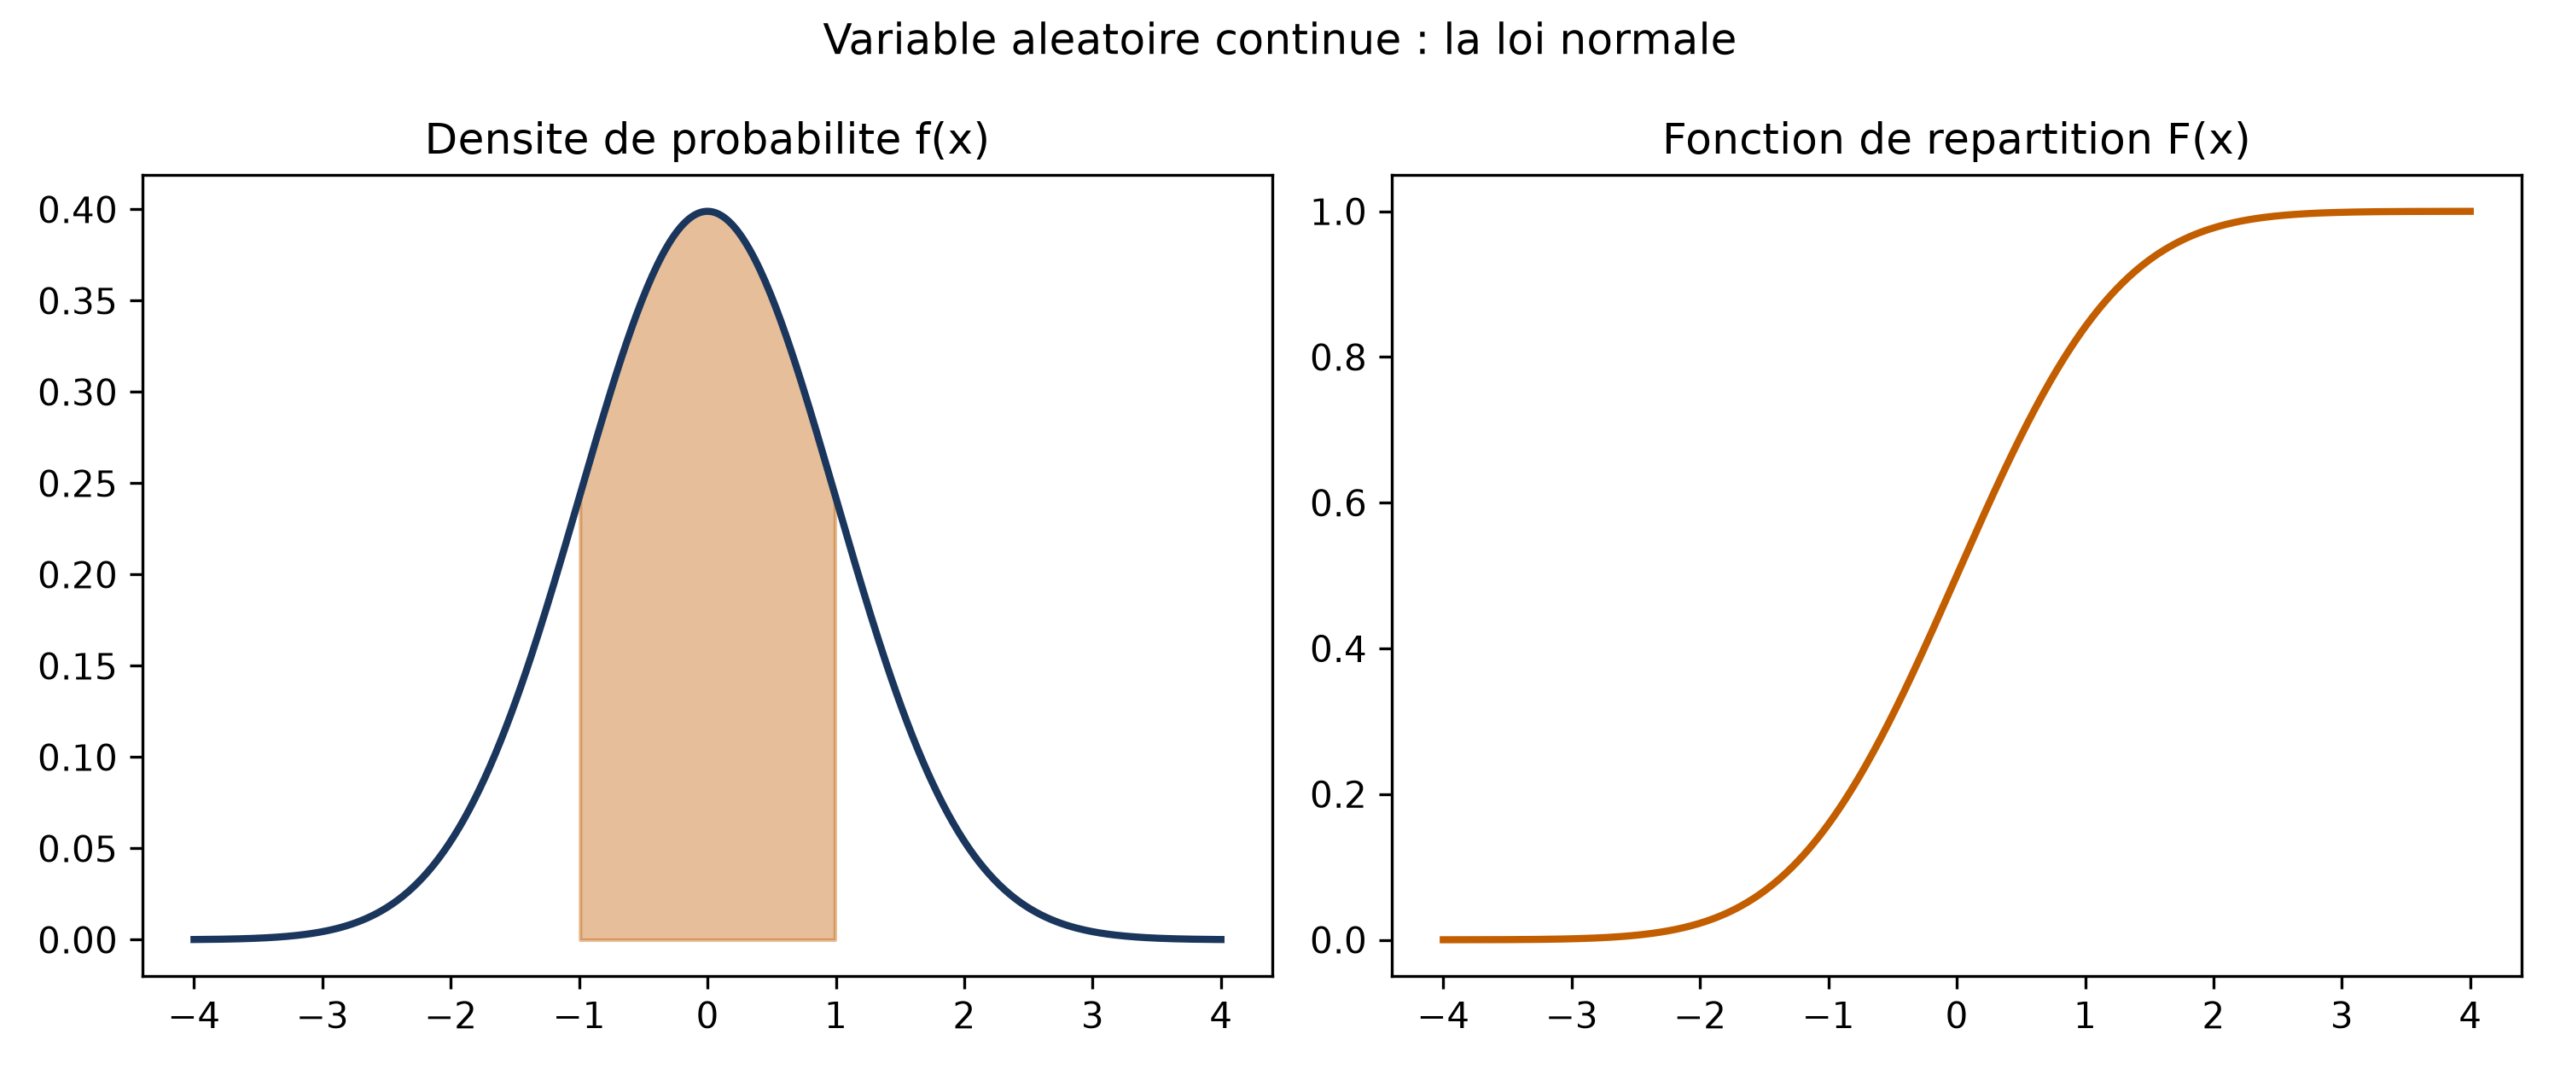
Cette largeur partagée est l’hypothèse qui donne toute sa simplicité à la méthode. Deux classes qui diffèrent par leur centre mais pas par leur étalement : voilà le portrait-robot de ce que la LDA sait traiter.
Le score δ : trois ingrédients, une droite
Une fois les cloches posées, comment la LDA tranche-t-elle ? Avec un seul prédicteur, on montre que la classe attribuée à est celle qui maximise :
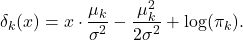
Chaque symbole a un rôle clair.  est la moyenne de la classe , la variance commune, la proportion de la classe.
 est un score : plus il est grand, plus la classe est plausible pour la valeur . Les deux premiers termes font intervenir la moyenne de la classe et la dispersion commune ; le dernier,
 , reporte la fréquence de la classe dans le verdict.
Le score est une fonction linéaire de , d’où le nom de la méthode : dans l’expression, n’apparaît qu’à la puissance un. Calculer un tel score pour chaque classe, puis garder le plus élevé, revient à découper l’espace des valeurs en zones séparées par des frontières droites.
Aucune des trois grandeurs n’est inconnue très longtemps : on les estime directement sur les données d’entraînement. devient la moyenne observée dans la classe, la variance groupée de toutes les classes, la proportion de chaque classe dans l’échantillon. On classe alors chaque observation selon la classe qui maximise  , où le chapeau signale une estimation.
📌 À retenir Pas d’optimisation itérative ici : tu calcules des moyennes, une variance groupée et des proportions, puis tu les glisses dans
Plusieurs variables : de la cloche aux ellipses
Avec un seul prédicteur, la cloche est une courbe. Avec plusieurs, elle devient une loi normale multivariée, de moyenne propre à chaque classe et de matrice de covariance commune.
La matrice de covariance  remplace la variance scalaire : elle capture la dispersion de chaque variable, mais aussi leurs corrélations. Pour deux variables corrélées positivement, les lignes de niveau de la densité deviennent des ellipses qui s’inclinent le long de la direction de corrélation. Toutes les classes partagent donc la même forme d’ellipse ; seules leurs positions changent.
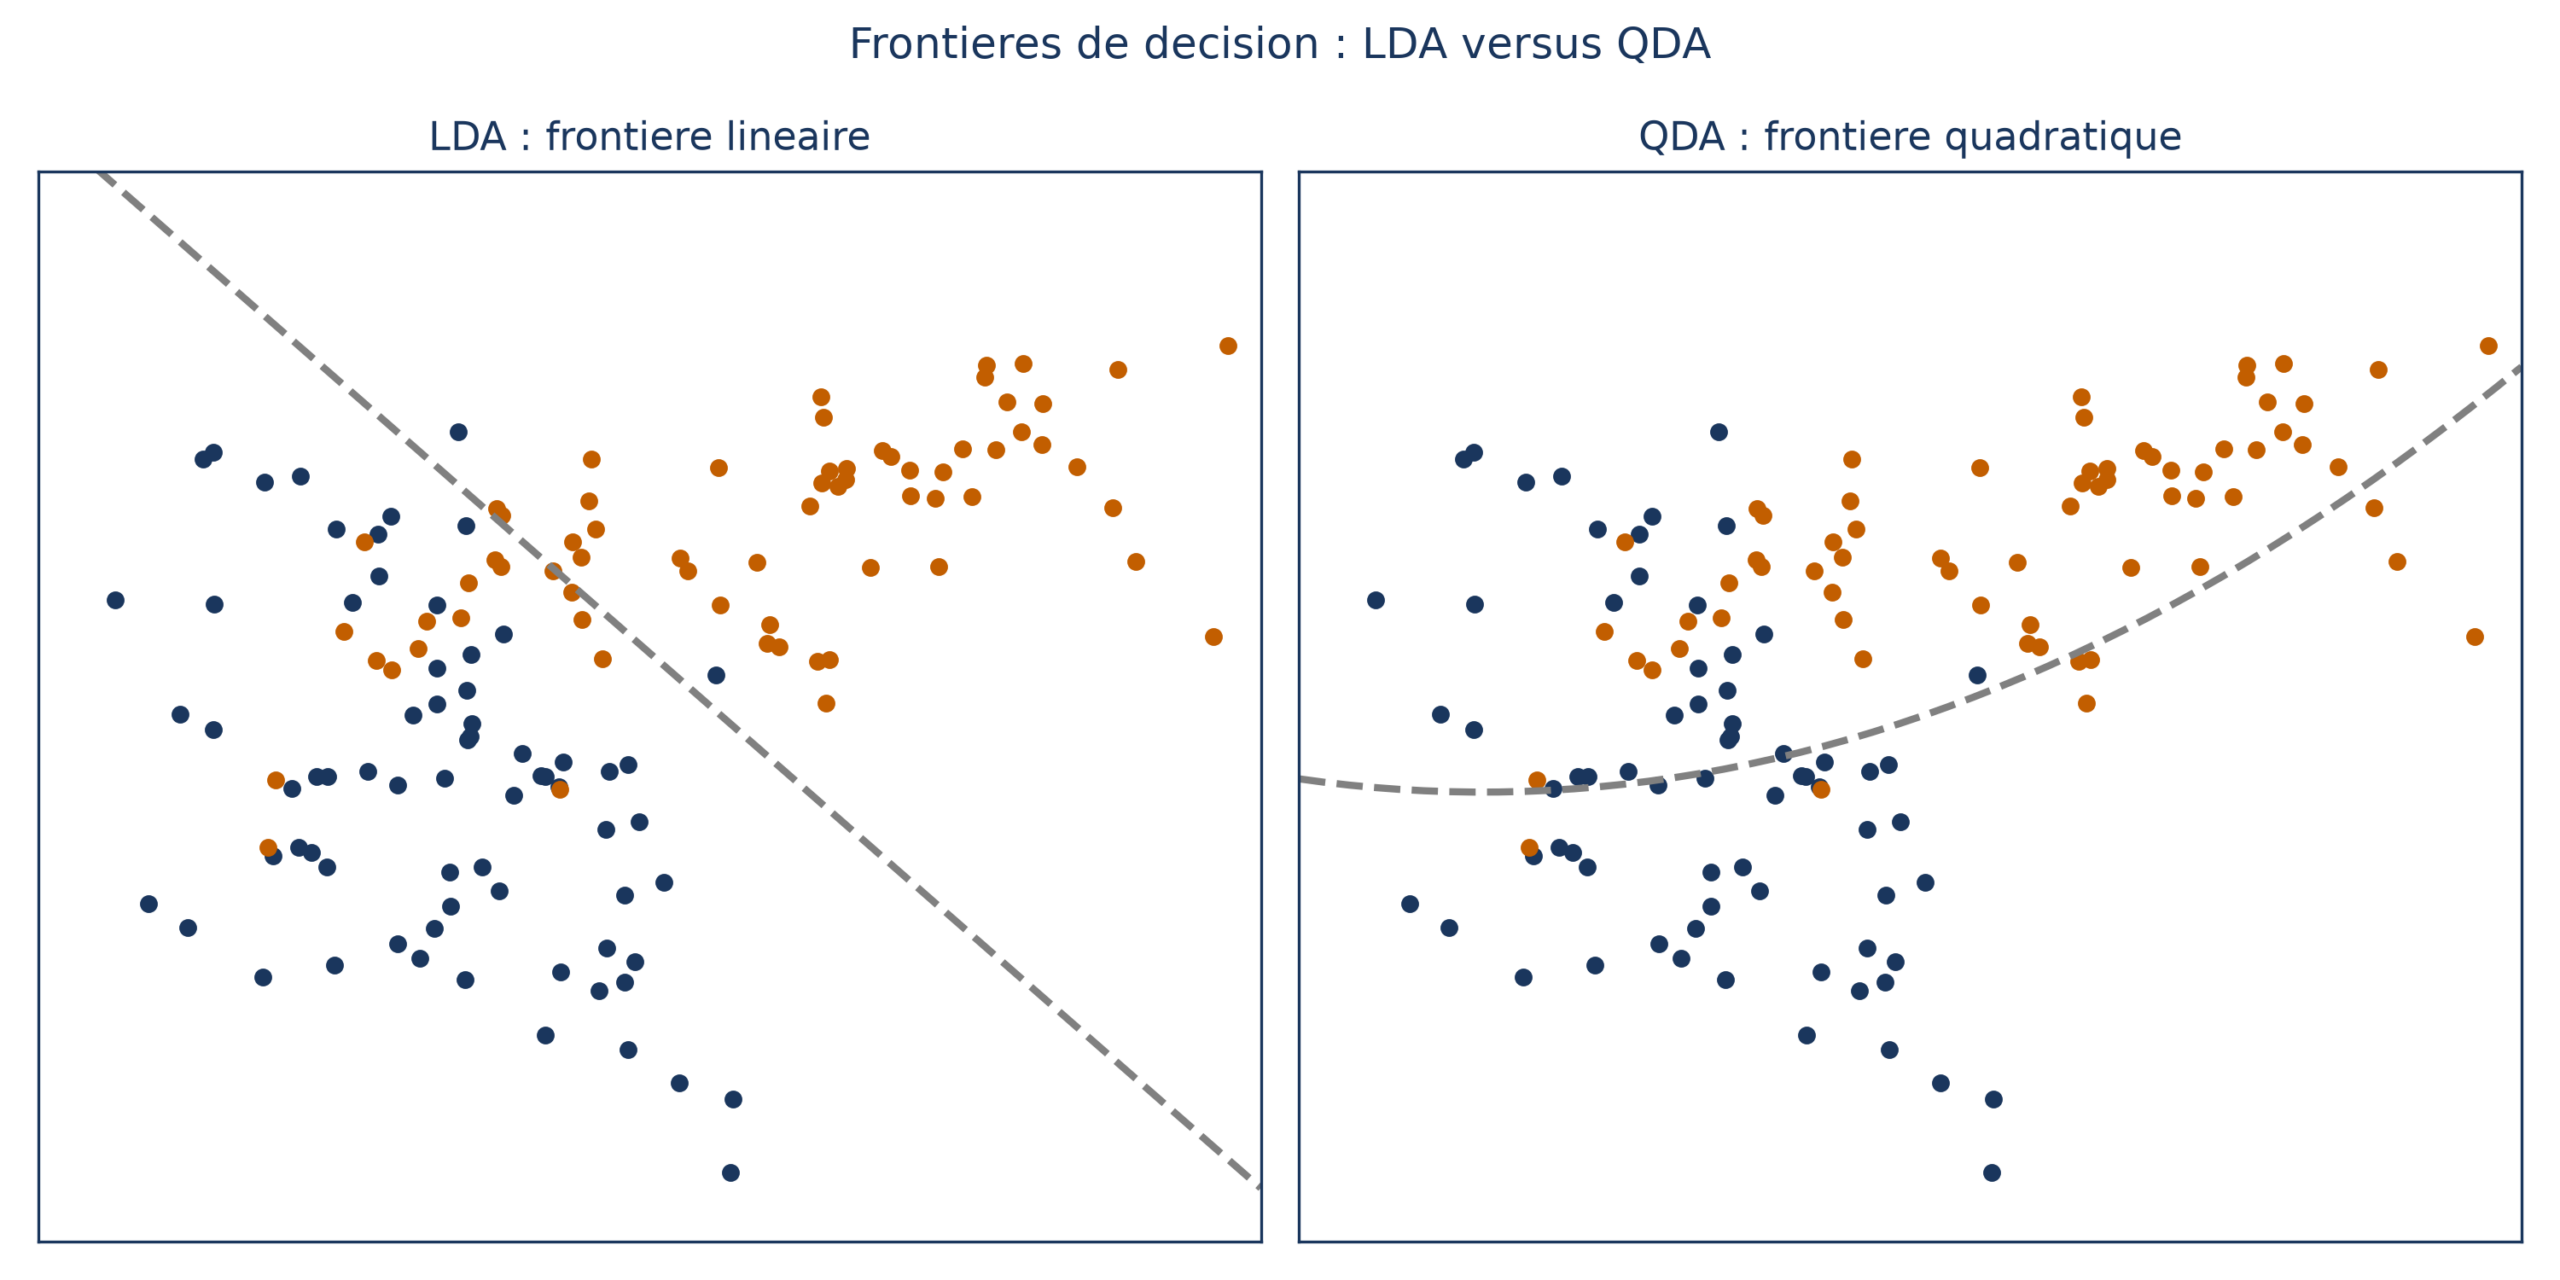
C’est cette hypothèse de forme commune qui garde la frontière droite. La LDA produit une frontière de décision linéaire, alors que la QDA, qui autorise une matrice de covariance propre à chaque classe, obtient une frontière quadratique.
Où la LDA est à l’aise, où elle trébuche
Son premier atout touche un cas gênant pour sa concurrente directe : quand les classes sont bien séparées, la régression logistique devient étonnamment instable, alors que la LDA reste stable.
Deuxième atout : avec peu d’observations, elle se comporte mieux, à condition que les prédicteurs suivent effectivement une loi normale dans chaque classe. Troisième atout : elle se généralise naturellement à plus de deux classes sans bricolage.
Le revers se lit dans la même phrase. Tout repose sur la normalité : dès qu’elle est clairement violée, la régression logistique est plus robuste. En pratique, les deux produisent des frontières linéaires et des résultats très proches ; la LDA garde un léger avantage quand les classes sont bien séparées ou que la normalité tient.
⚠️ Piège Le mot « linéaire » ne protège de rien. Une frontière droite est une conséquence de la covariance commune, pas une garantie que ta vraie frontière est droite. Si elle est fortement non linéaire, c’est une méthode comme les K plus proches voisins qui l’emporte, au prix d’une interprétabilité nulle et d’un besoin de données plus important.
Trois cousines et un idéal
La LDA appartient à une petite famille de méthodes génératives, qui toutes appliquent Bayes après avoir modélisé chaque classe. Ce qui les distingue, c’est l’hypothèse qu’elles relâchent.
- LDA : normale, covariance commune, frontière linéaire.
- QDA : une covariance propre à chaque classe, frontière quadratique. Elle est plus flexible, au prix de plus de paramètres à estimer.
- Naïve Bayes : indépendance des prédicteurs à l’intérieur de chaque classe. Elle donne une frontière plus flexible que la LDA, sans avoir à estimer de covariances croisées.
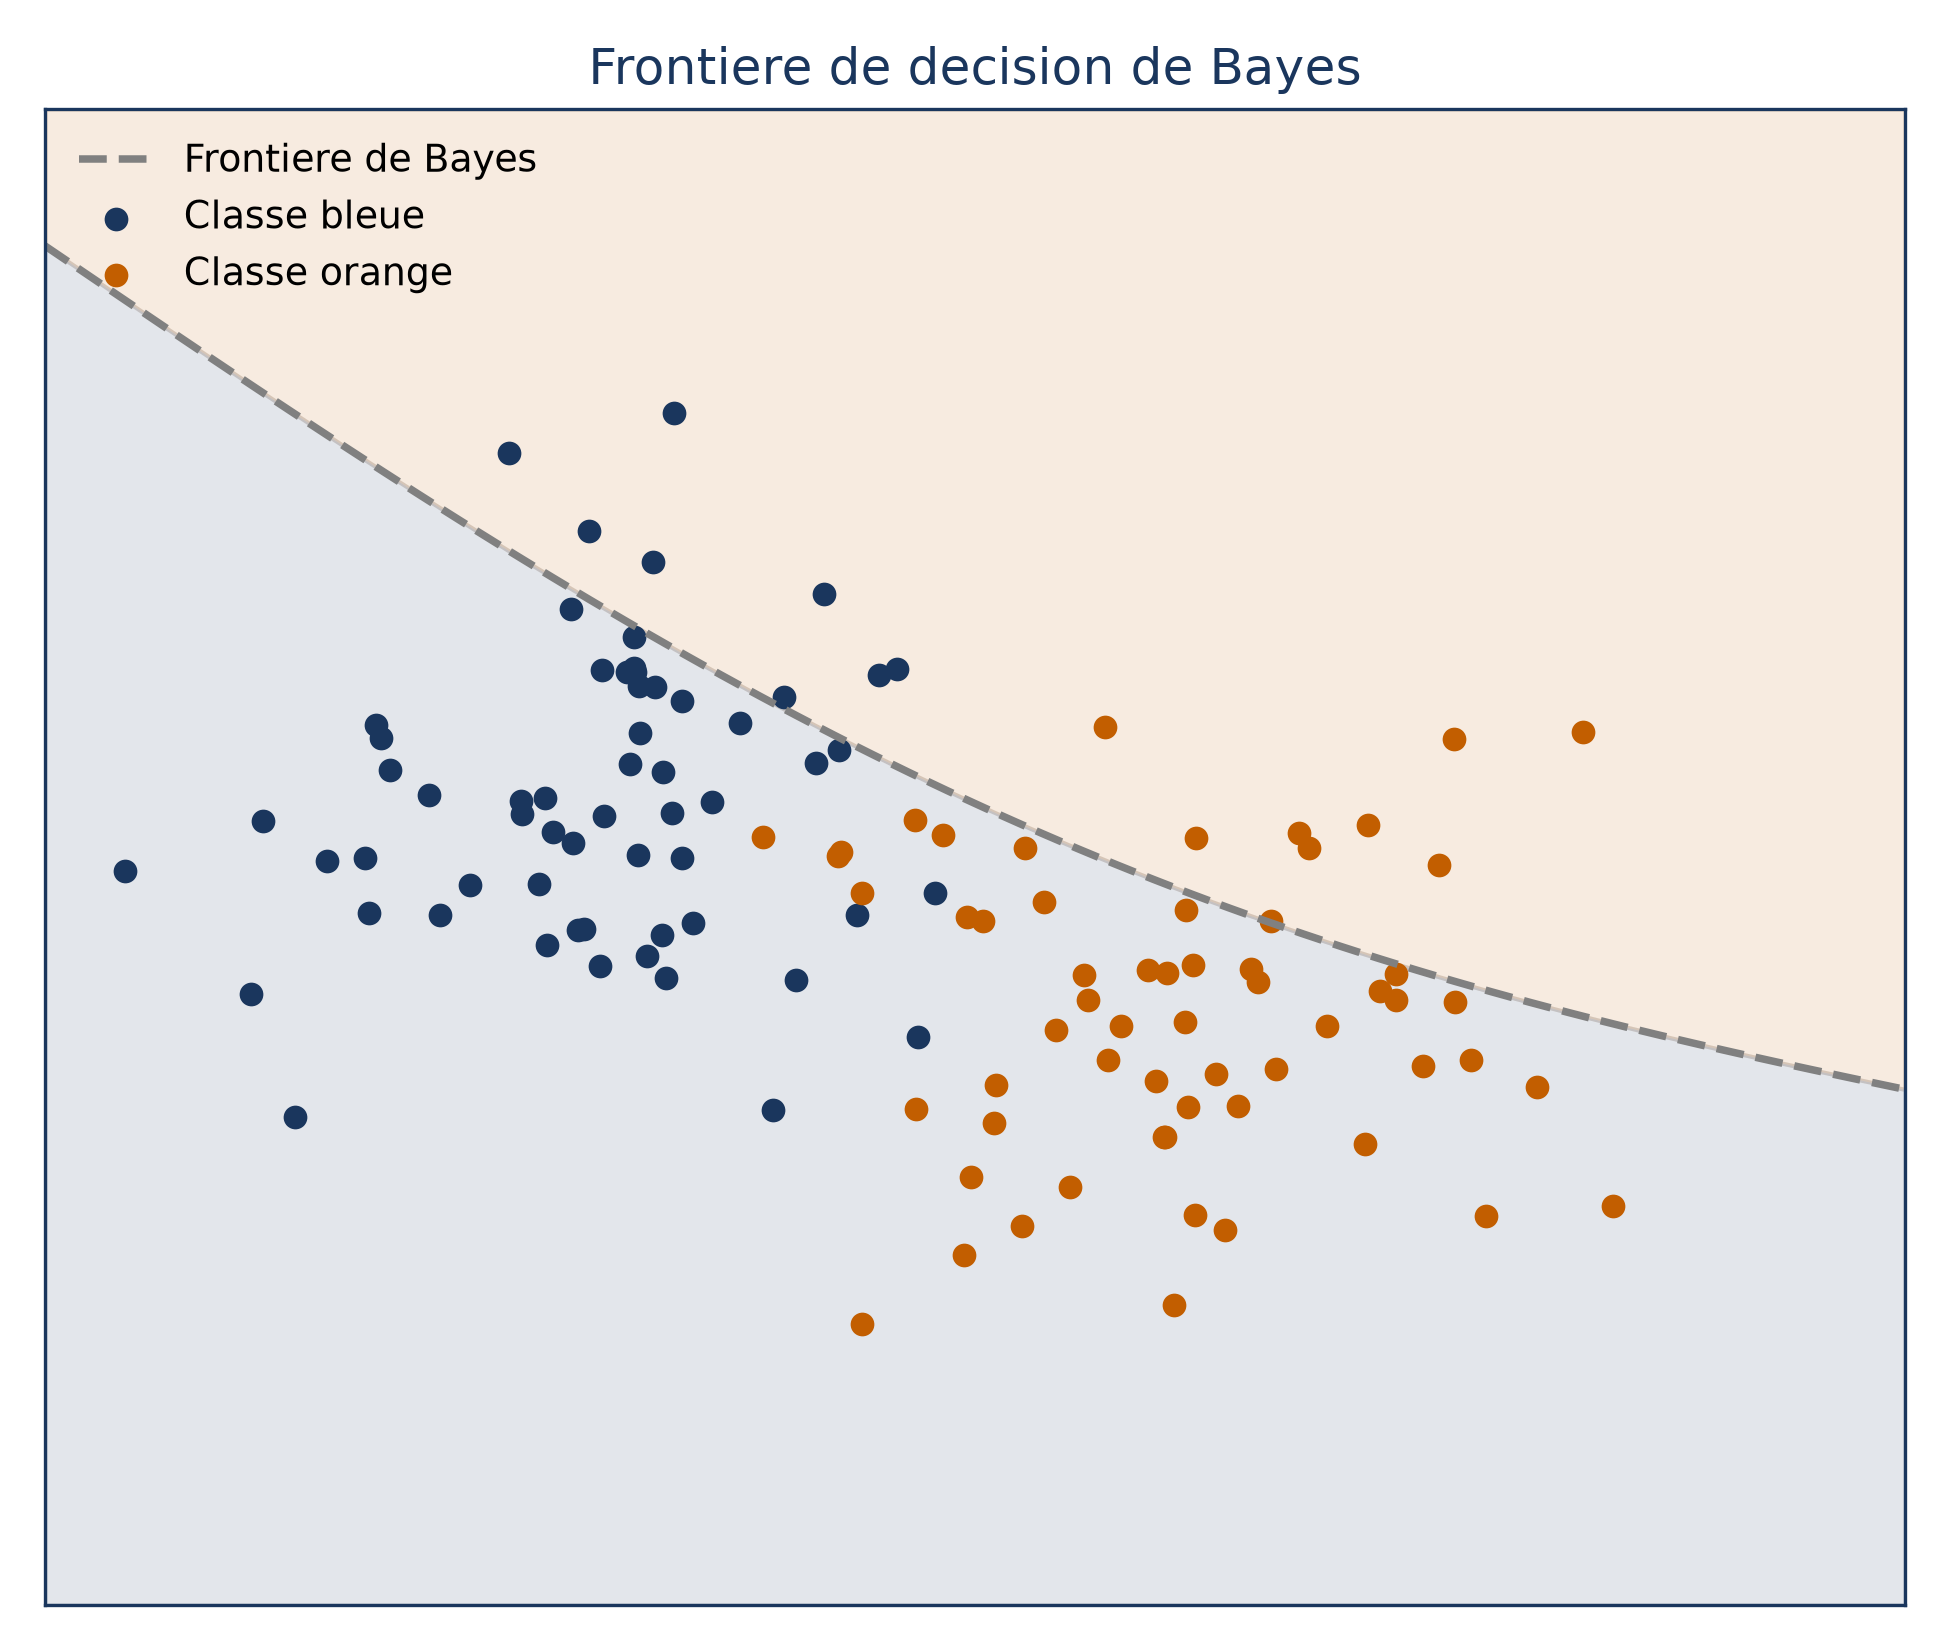
Au-dessus de toutes ces méthodes plane un modèle de référence : le classifieur de Bayes, qui affecte chaque observation à la classe la plus probable compte tenu de ses valeurs. Il atteint le taux d’erreur de test le plus bas possible, appelé erreur de Bayes. Mais il suppose connue la vraie distribution de la réponse sachant les variables, ce qui n’arrive jamais : c’est un étalon, pas un outil.
📌 À retenir Décrire chaque classe par une cloche, inverser avec Bayes, comparer les scores : voilà toute la LDA. Sa force est sa simplicité et sa stabilité ; sa fragilité, l’hypothèse de normalité à variance commune.