Imagine deux villages posés sur une carte, et une route à construire entre eux. Il existe une infinité de tracés possibles, mais un seul ne frôle aucune maison. Cette route la plus dégagée possible, c’est exactement ce que cherche une machine à vecteurs de support. À la fin de cet article, tu sauras ce qu’est sa marge, pourquoi seuls quelques points décident de tout, et comment un simple noyau lui permet de courber sa frontière.
Sommaire
- L’essentiel en 30 secondes
- Une frontière entre deux camps : laquelle choisir ?
- Les seuls points qui comptent : les vecteurs de support
- Quand les camps se chevauchent : la marge souple
- Courber la frontière sans changer de méthode : le noyau
- Un SVM en quelques lignes de Python
- Un cousin de la régression logistique, pas un étranger
L’essentiel en 30 secondes
- Un SVM est une méthode de classification qui sépare deux classes par un hyperplan.
- Parmi tous les séparateurs possibles, il retient celui qui maximise la marge, la distance minimale aux points les plus proches.
- Seuls les vecteurs de support (les points sur le bord de la marge) fixent la position de la frontière.
- Une marge souple réglée par C tolère quelques erreurs, et un noyau donne des frontières non linéaires.
- C et γ se choisissent par validation croisée, en une ligne de scikit-learn.
Une frontière entre deux camps : laquelle choisir ?
Les machines à vecteurs de support (SVM) forment une famille de méthodes de classification, longtemps comptée parmi les meilleurs classifieurs « prêts à l’emploi ». Elles se construisent par couches successives, en partant d’une idée purement géométrique.
Commençons par le mot hyperplan. En dimension 2, c’est une droite ; en dimension 3, un plan ordinaire ; avec  variables, un sous-espace de dimension
 . Son équation est :

Les  sont les coefficients qui orientent et placent l’hyperplan, et les
 les variables. Le signe de cette expression te dit de quel côté de l’hyperplan se trouve un point : c’est ce qui sert à ranger une observation dans la classe
 ou
 .
Si les deux classes se séparent parfaitement, une infinité d’hyperplans conviennent : tu peux toujours en décaler un peu un sans qu’il se trompe. Le SVM départage en choisissant l’hyperplan dont la distance minimale aux observations d’entraînement est la plus grande. Cette distance s’appelle la marge.
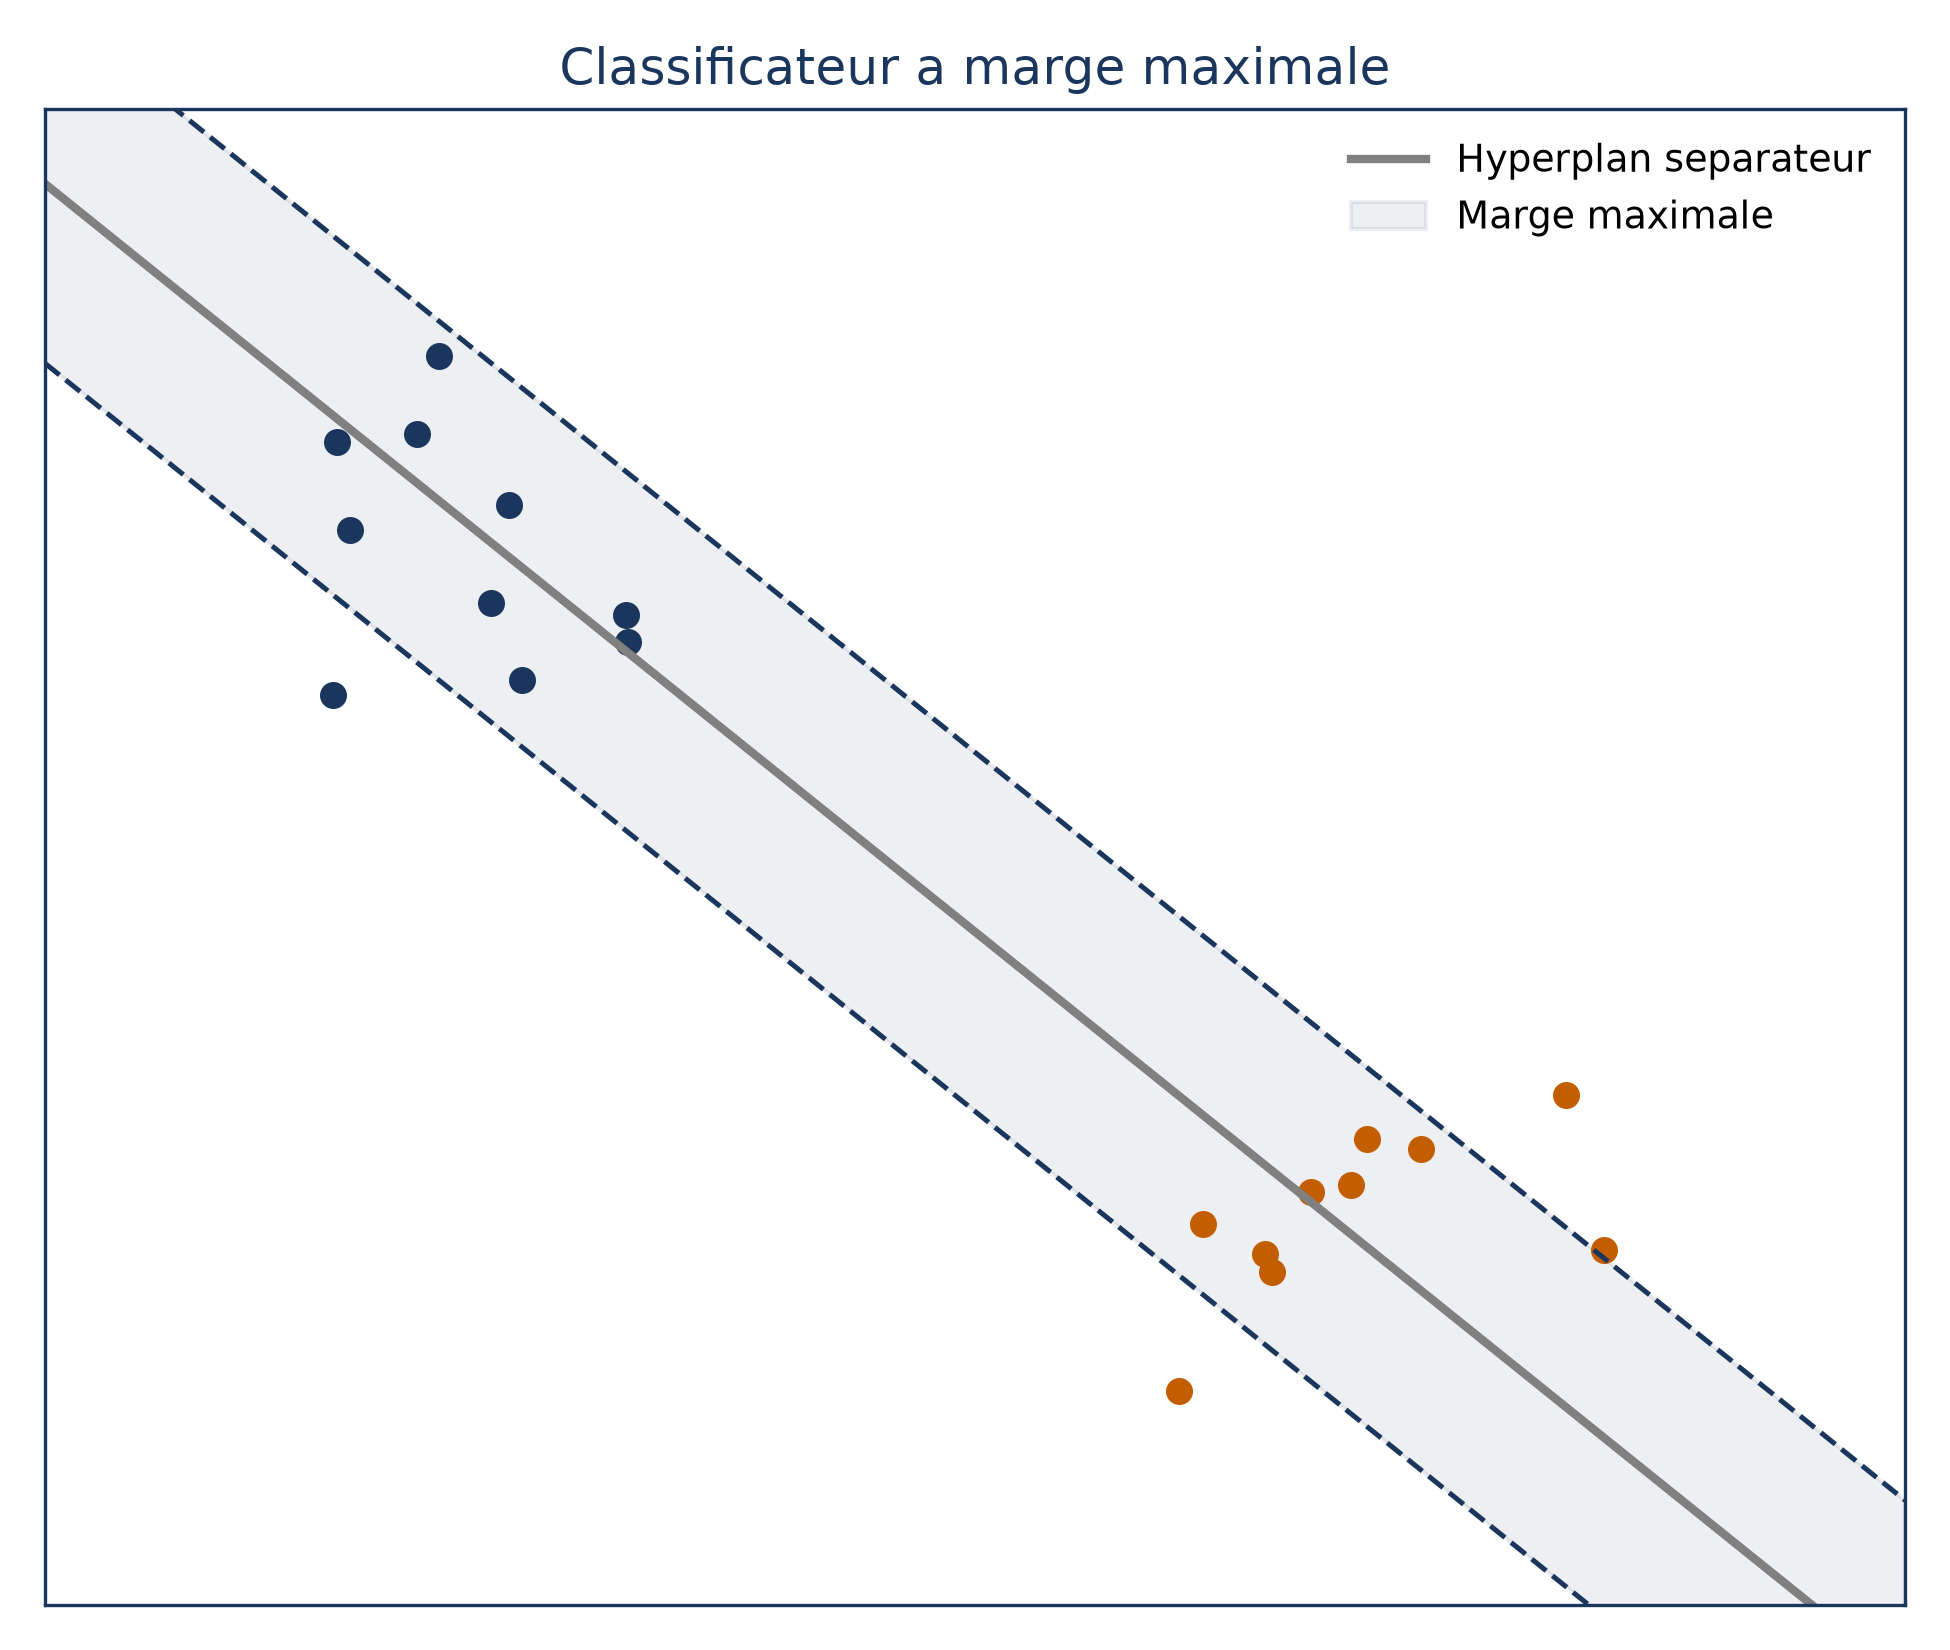
💡 Intuition Ta route entre les deux villages passe par la ligne médiane de la plus large bande qu’on puisse tracer sans toucher une seule maison.
Les seuls points qui comptent : les vecteurs de support
Voici le fait le plus étonnant de la méthode. La position de l’hyperplan ne dépend que d’un tout petit nombre d’observations, celles posées exactement sur le bord de la marge. On les appelle les vecteurs de support.
Déplace n’importe quel autre point, à condition qu’il reste en dehors de la marge : rien ne bouge. L’hyperplan est « soutenu » par ces quelques points seulement, d’où le nom de la méthode.
C’est aussi une bonne nouvelle pour la lecture du modèle : au lieu de retenir des milliers de lignes, il suffit de savoir quels points tiennent la bande.
Quand les camps se chevauchent : la marge souple
Reste un problème de taille. Cette construction exige que les classes soient parfaitement séparables par un hyperplan, une condition rarement remplie en pratique.
Et même quand elle l’est, le séparateur parfait est fragile : ajouter un seul point peut déplacer radicalement la marge et l’hyperplan. C’est un symptôme classique de surajustement.
La parade s’appelle le classifieur à vecteurs de support : il accepte une marge souple. On tolère qu’un certain nombre de points passent du mauvais côté de la marge, voire du mauvais côté de l’hyperplan. Cette tolérance se règle avec un paramètre de budget, noté  .
Le réglage est un curseur biais-variance. Une marge étroite, calée sur peu de vecteurs de support, donne un modèle à faible biais mais forte variance, très sensible aux points isolés. Une marge large, appuyée sur de nombreux vecteurs de support, rend le modèle plus rigide : variance plus faible, biais potentiellement plus élevé. Comme toujours, se choisit par validation croisée.
⚠️ Piège Le sens de
donne une marge plus large que
. Ne te fie pas au nombre : regarde la largeur de la marge obtenue.
Courber la frontière sans changer de méthode : le noyau
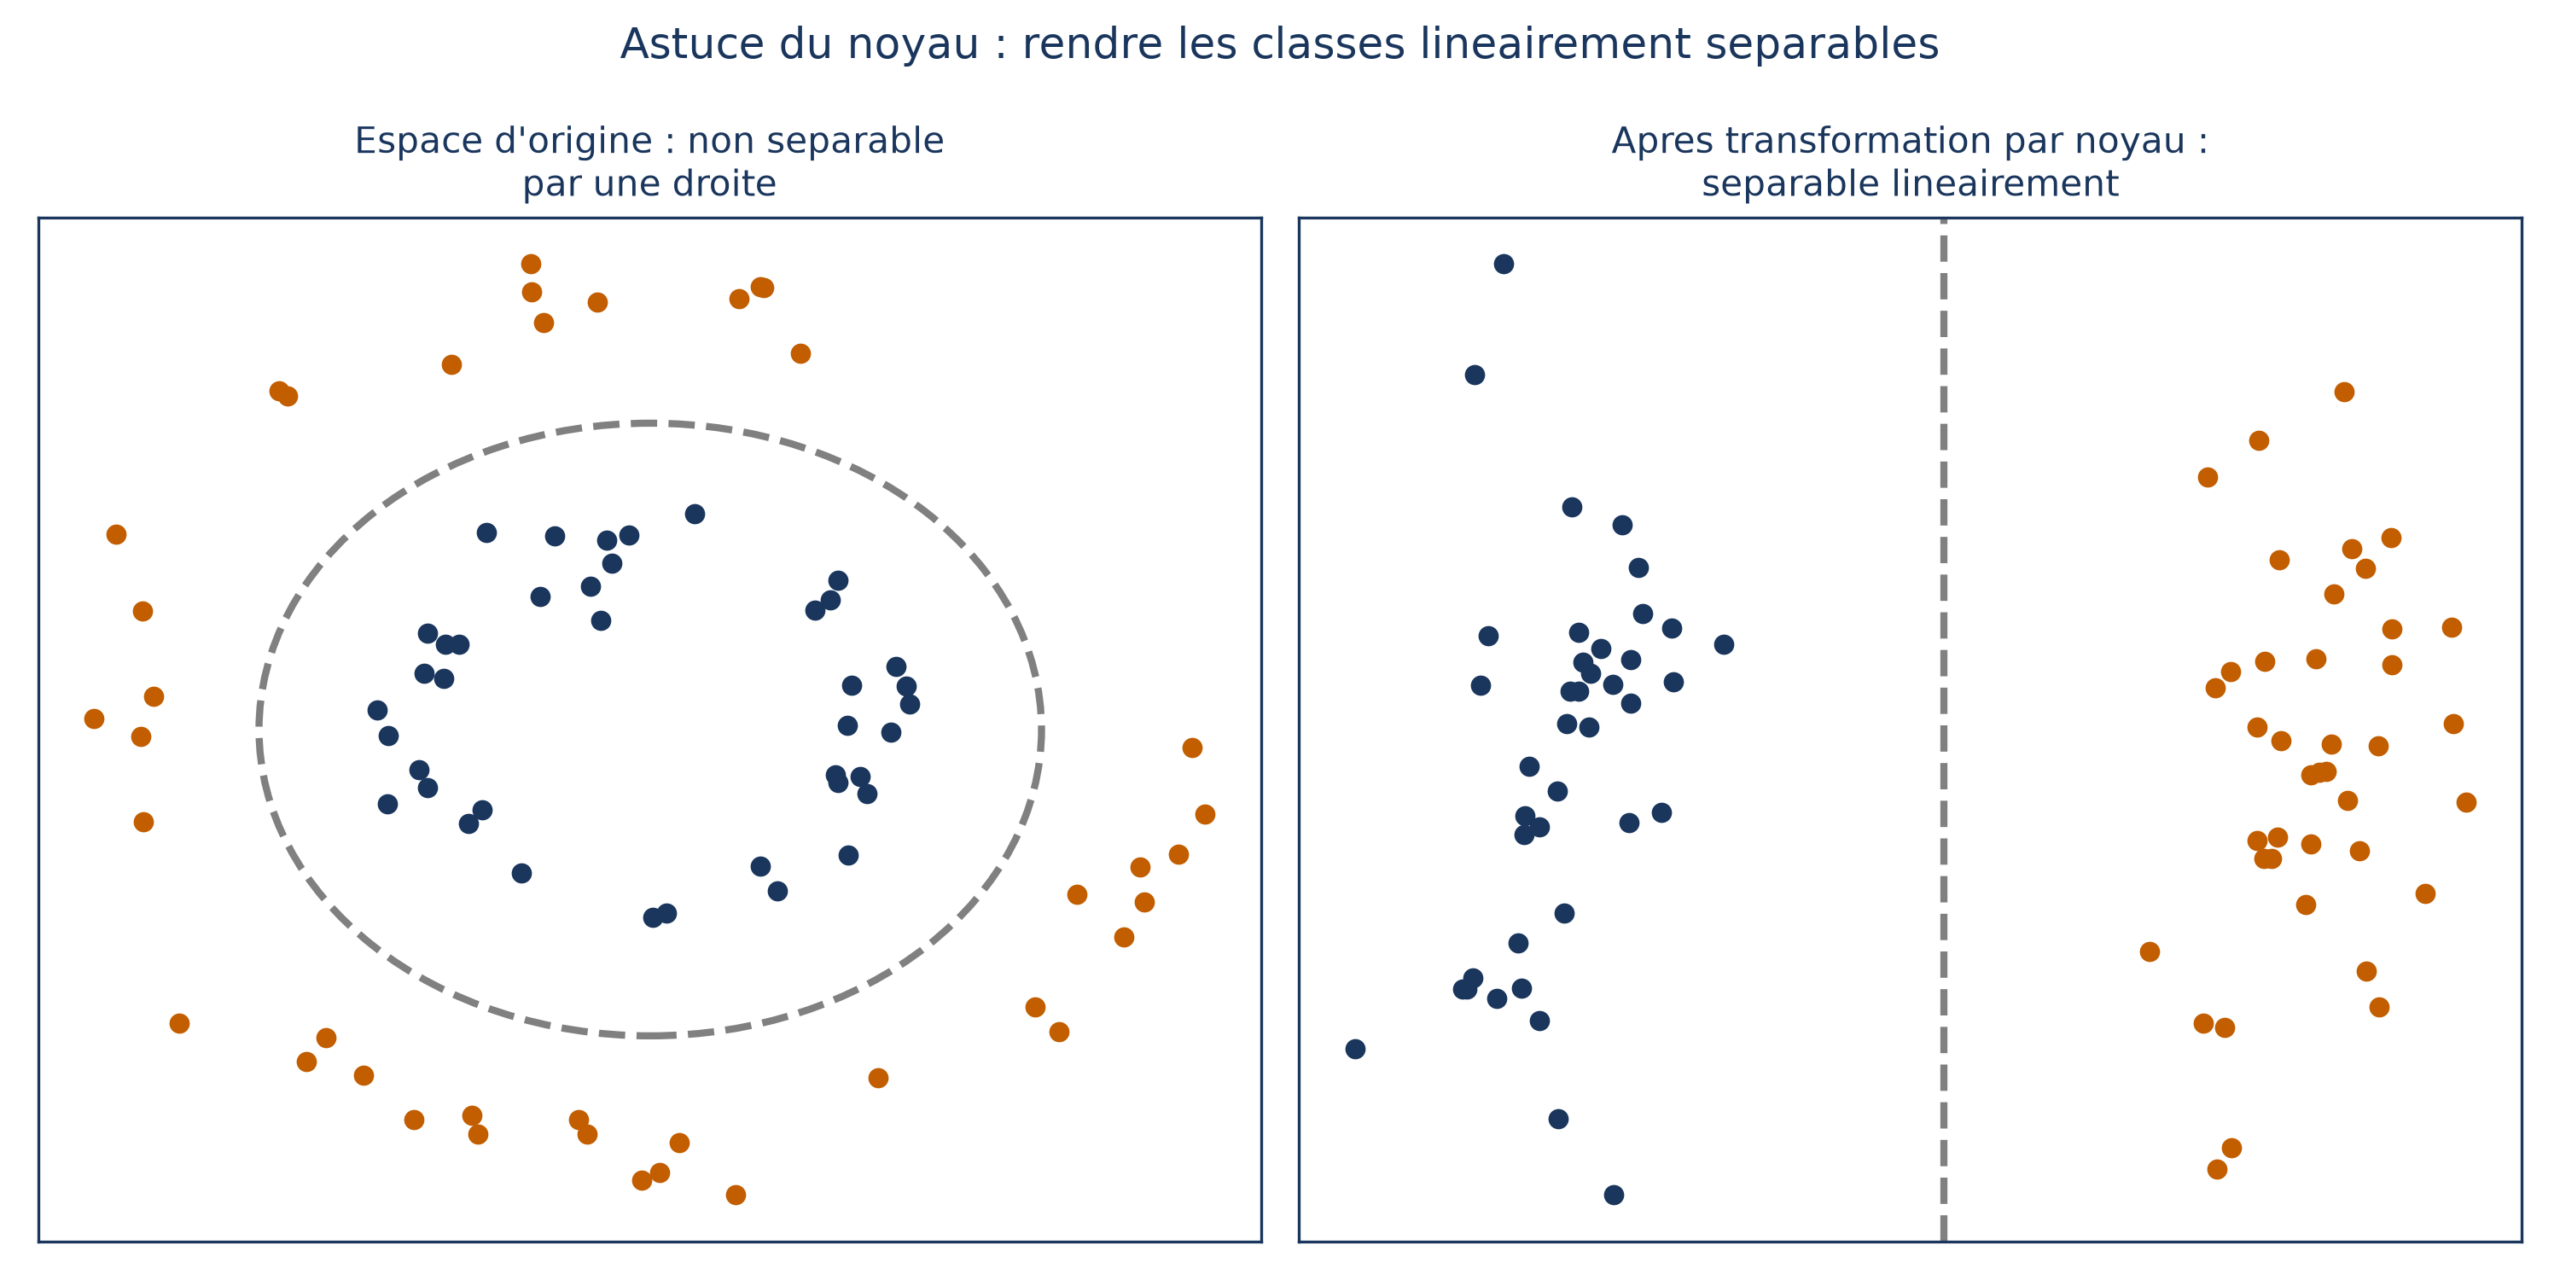
Le classifieur à vecteurs de support reste, par construction, linéaire : sa frontière est toujours un hyperplan. Or beaucoup de problèmes ont une frontière manifestement courbe, que même une marge souple généreuse ne rattrape pas.
L’astuce consiste à travailler comme si l’on avait enrichi les variables de carrés et de produits croisés, puis à tracer la droite dans cet espace enrichi. Revenue dans l’espace d’origine, elle devient une courbe. Le tour de force est de ne jamais calculer ces nouvelles coordonnées, qui peuvent être en nombre immense, voire infini.
Comment ? La solution du problème d’optimisation ne dépend des observations que par leurs produits scalaires deux à deux. On remplace donc chaque produit scalaire par une fonction  qui mesure la similarité entre deux points : c’est l’astuce du noyau (kernel trick).
Deux noyaux courants. Le noyau polynomial de degré  donne une frontière polynomiale :
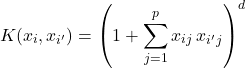
Le noyau radial, lui, produit une frontière plus flexible et fortement locale :
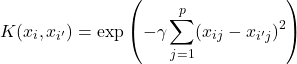
Ici  est la valeur de la variable
 pour l’observation
 , et la somme sous l’exponentielle est le carré de la distance entre deux points. Un point de test éloigné d’un point d’entraînement n’en reçoit presque aucune influence : seul le voisinage immédiat compte, un peu comme pour les K plus proches voisins.
Le paramètre  joue le rôle de curseur de flexibilité, comme : un grand donne une frontière très irrégulière qui épouse chaque groupe local, un petit une frontière plus lisse.
📌 À retenir Le noyau radial correspond implicitement à un espace de dimension infinie. Calculer dedans serait impossible, alors que le noyau n’a besoin que de produits scalaires entre paires de points.
Un SVM en quelques lignes de Python
Passons à la pratique. Tu as des variables dans X, des classes dans y, et tu veux voir l’effet de la souplesse sur la marge. La classe SVC de scikit-learn ajuste aussi bien un classifieur linéaire qu’un SVM à noyau, selon l’argument kernel.
Une précision de lecture : les marqueurs In [n]: désignent les cellules qu’on a saisies dans un notebook, et leur numéro n’a pas de signification particulière.
In [5]: svm_linear = SVC(C=10, kernel='linear')
        svm_linear.fit(X, y)

In [7]: svm_linear_small = SVC(C=0.1, kernel='linear')
        svm_linear_small.fit(X, y)
Avec la plus petite valeur de C, on observe une marge plus large et donc davantage de vecteurs de support. C’est bien le compromis décrit plus haut.
Passer à une frontière courbe ne demande de changer qu’un argument :
In [22]: svm_rbf = SVC(kernel="rbf", gamma=1, C=1)
         svm_rbf.fit(X_train, y_train)
gamma est le du noyau radial. Reste à trouver le bon couple  . On le cherche par validation croisée à 5 blocs, avec une grille qui croise chaque valeur de
C avec chaque valeur de gamma :
In [24]: kfold = skm.KFold(5,
                             random_state=1,
                             shuffle=True)
         grid = skm.GridSearchCV(svm_rbf,
                                   {'C':[0.1,1,10,100,1000],
                                    'gamma':[0.5,1,2,3,4]},
                                   refit=True,
                                   cv=kfold,
                                   scoring='accuracy')
         grid.fit(X_train, y_train)
         grid.best_params_
Chaque combinaison est évaluée, et best_params_ renvoie celle qui maximise l’exactitude (accuracy).
Un cousin de la régression logistique, pas un étranger
On présente parfois le SVM comme une boîte à part. C’est une fausse piste : le problème d’optimisation du classifieur à vecteurs de support se réécrit comme la minimisation d’une fonction de perte particulière, la hinge loss, assortie d’une pénalité de type ridge sur les coefficients. La structure rappelle directement la régression logistique pénalisée.
Les deux méthodes donnent des résultats très proches quand les classes sont proches d’être séparables. La différence tient surtout à la fonction de perte et au comportement quand les classes sont bien séparées.
Deux nuances pratiques. La régression logistique fournit directement des probabilités de classe interprétables, tandis que les SVM s’en sortent plutôt mieux lorsque les deux camps sont nettement distincts.
Autre idée reçue à lâcher : l’astuce du noyau n’est pas propre aux SVM. Elle peut s’appliquer, avec des précautions de calcul, à la régression logistique ou à d’autres méthodes ; c’est surtout pour des raisons historiques qu’on l’associe aux seules machines à vecteurs de support.
Au-delà de deux classes, on combine plusieurs SVM binaires, par des stratégies un contre un ou un contre tous.