Tu as une colonne à prédire, un tableau de variables, et l’envie de lancer le premier modèle venu. Mauvaise idée : une régression logistique est redoutable dans certaines situations et simplement hors sujet dans d’autres, et rien dans le tableau ne te le dit tout seul. À la fin de cet article, tu sauras la confronter à ton problème en quelques questions, et tu sauras vers quoi te tourner quand la réponse est non.
Sommaire
- L’essentiel en 30 secondes
- Première question : prédis-tu une catégorie à deux issues ?
- Deuxième question : ta frontière ressemble-t-elle à une droite ?
- Troisième question : as-tu assez de données pour une méthode souple ?
- Quatrième question : combien de classes veux-tu départager ?
- Comment départager deux candidates sans te fier à ton impression
- Ce que ça te coûte de rester linéaire, et ce que ça te rapporte
L’essentiel en 30 secondes
- Elle sert quand tu prédis une catégorie à deux issues, comme une hausse ou une baisse.
- Elle trace une frontière en ligne droite : si la vraie frontière est très courbe, d’autres méthodes reprennent l’avantage.
- Avec peu de données, reste prudent : une méthode plus souple n’est pas toujours la meilleure, même pour prédire.
- Au-delà de deux classes, il faut changer de stratégie (un contre un, un contre tous, ou une méthode générative).
- Pour trancher entre deux candidates, utilise la validation croisée à 5 ou 10 blocs.
Première question : prédis-tu une catégorie à deux issues ?
Prends un problème qui paraît désespéré : deviner si le S&P 500 montera ou descendra demain, à partir des variations des cinq derniers jours. À l’œil, les rendements passés se ressemblent que le marché monte ou baisse le lendemain. Et pourtant, avec les bons outils statistiques, on retrouve la bonne direction environ 60 % du temps sur cinq ans de données : un résultat modeste, mais loin d’être négligeable en finance.
Ce profil, deux issues possibles et des variables numériques en entrée, est celui où la régression logistique est à sa place : malgré son nom, c’est une méthode de classification, utilisée pour une réponse binaire. Si ta cible a plus de deux issues, ou si tu hésites encore sur son type, les sections suivantes te disent quoi faire.
Deuxième question : ta frontière ressemble-t-elle à une droite ?
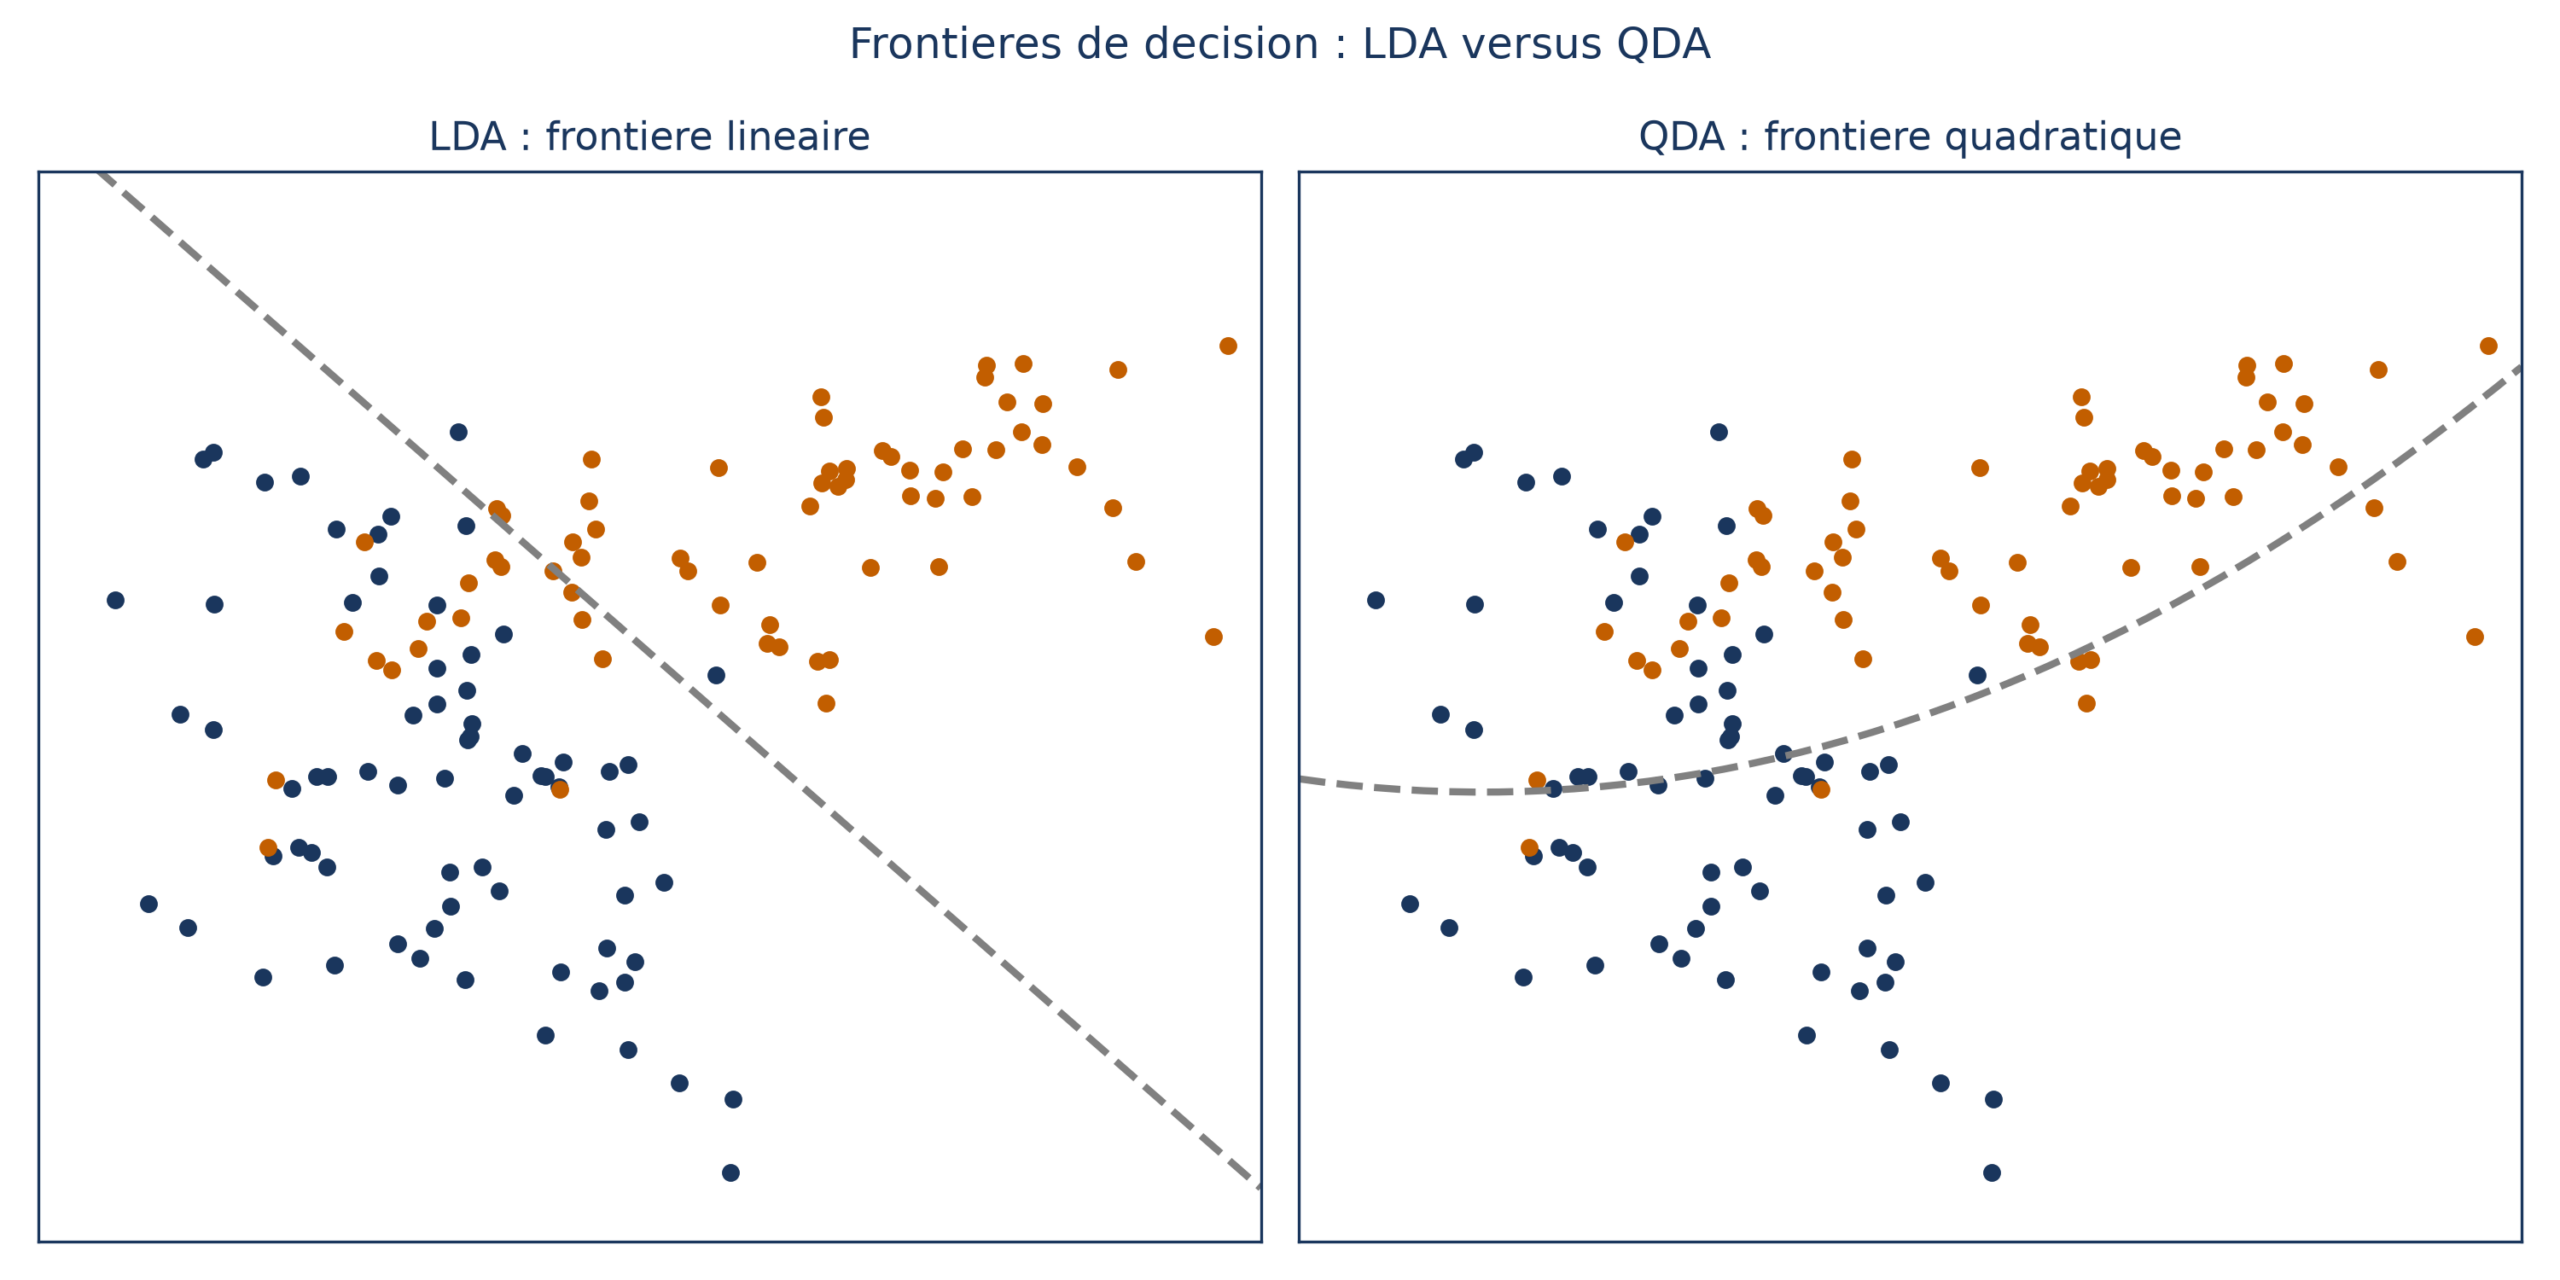
La régression logistique sépare les classes par une frontière linéaire, comme l’analyse discriminante linéaire (LDA). Toutes les méthodes de classification ne dessinent pas des frontières aussi sages : on peut les ranger selon la souplesse de la frontière qu’elles savent produire.
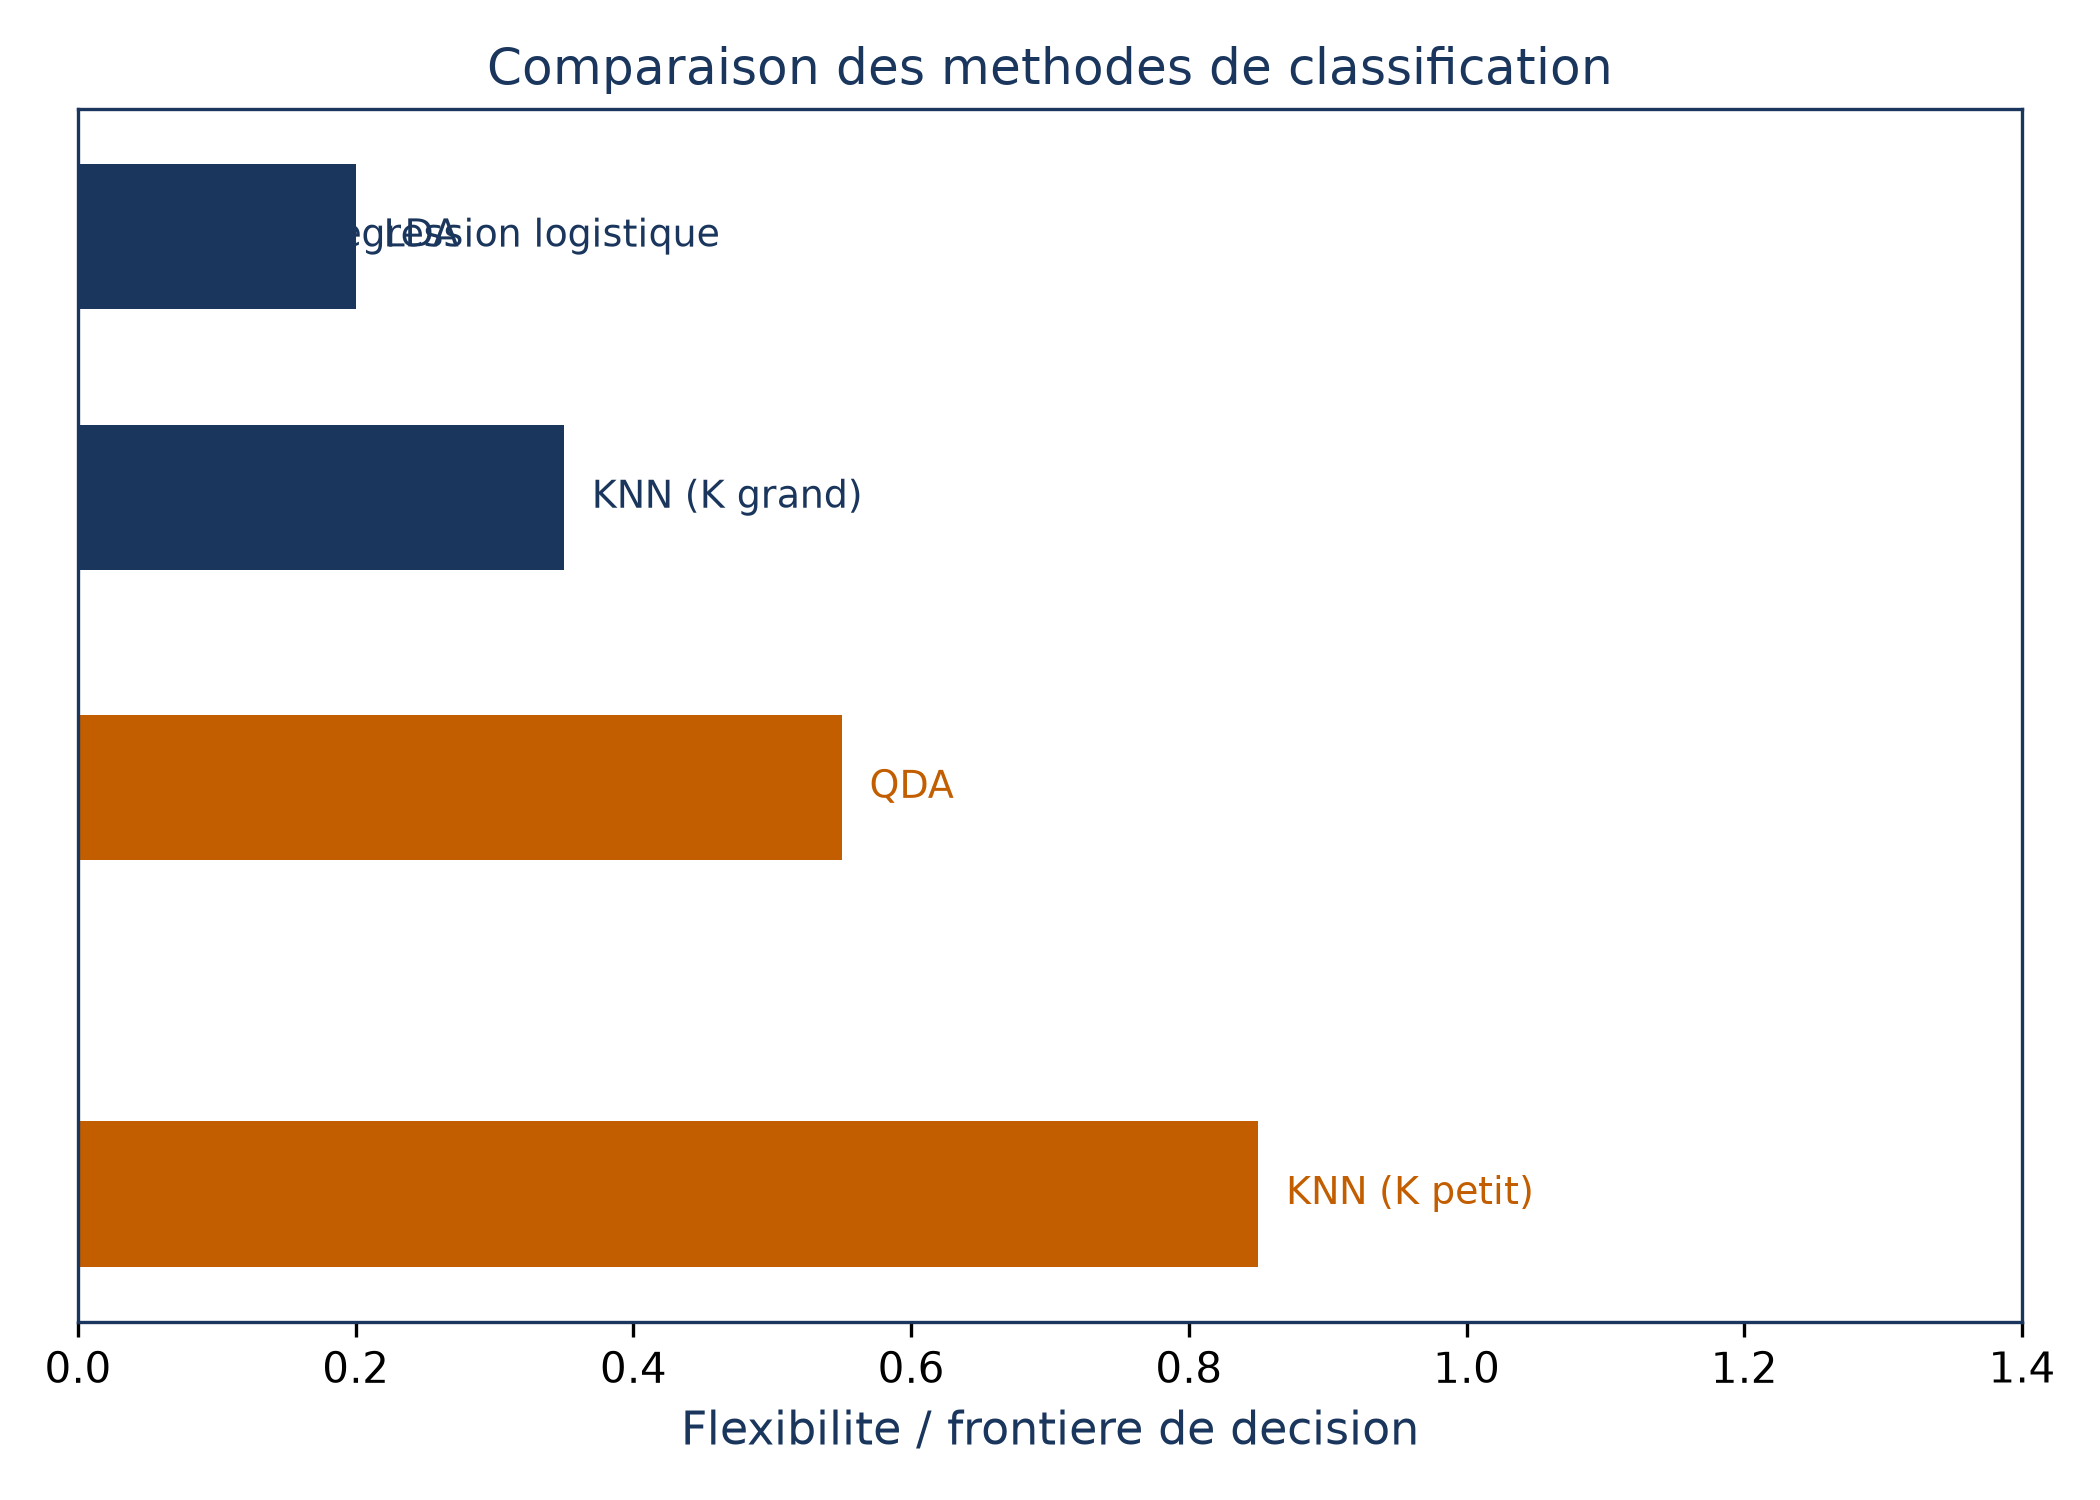
Pour monter d’un cran, il y a d’abord l’analyse discriminante quadratique (QDA). Elle laisse chaque classe avoir sa propre matrice de covariance, d’où une frontière en courbe quadratique au lieu d’une droite, au prix de davantage de paramètres à estimer.
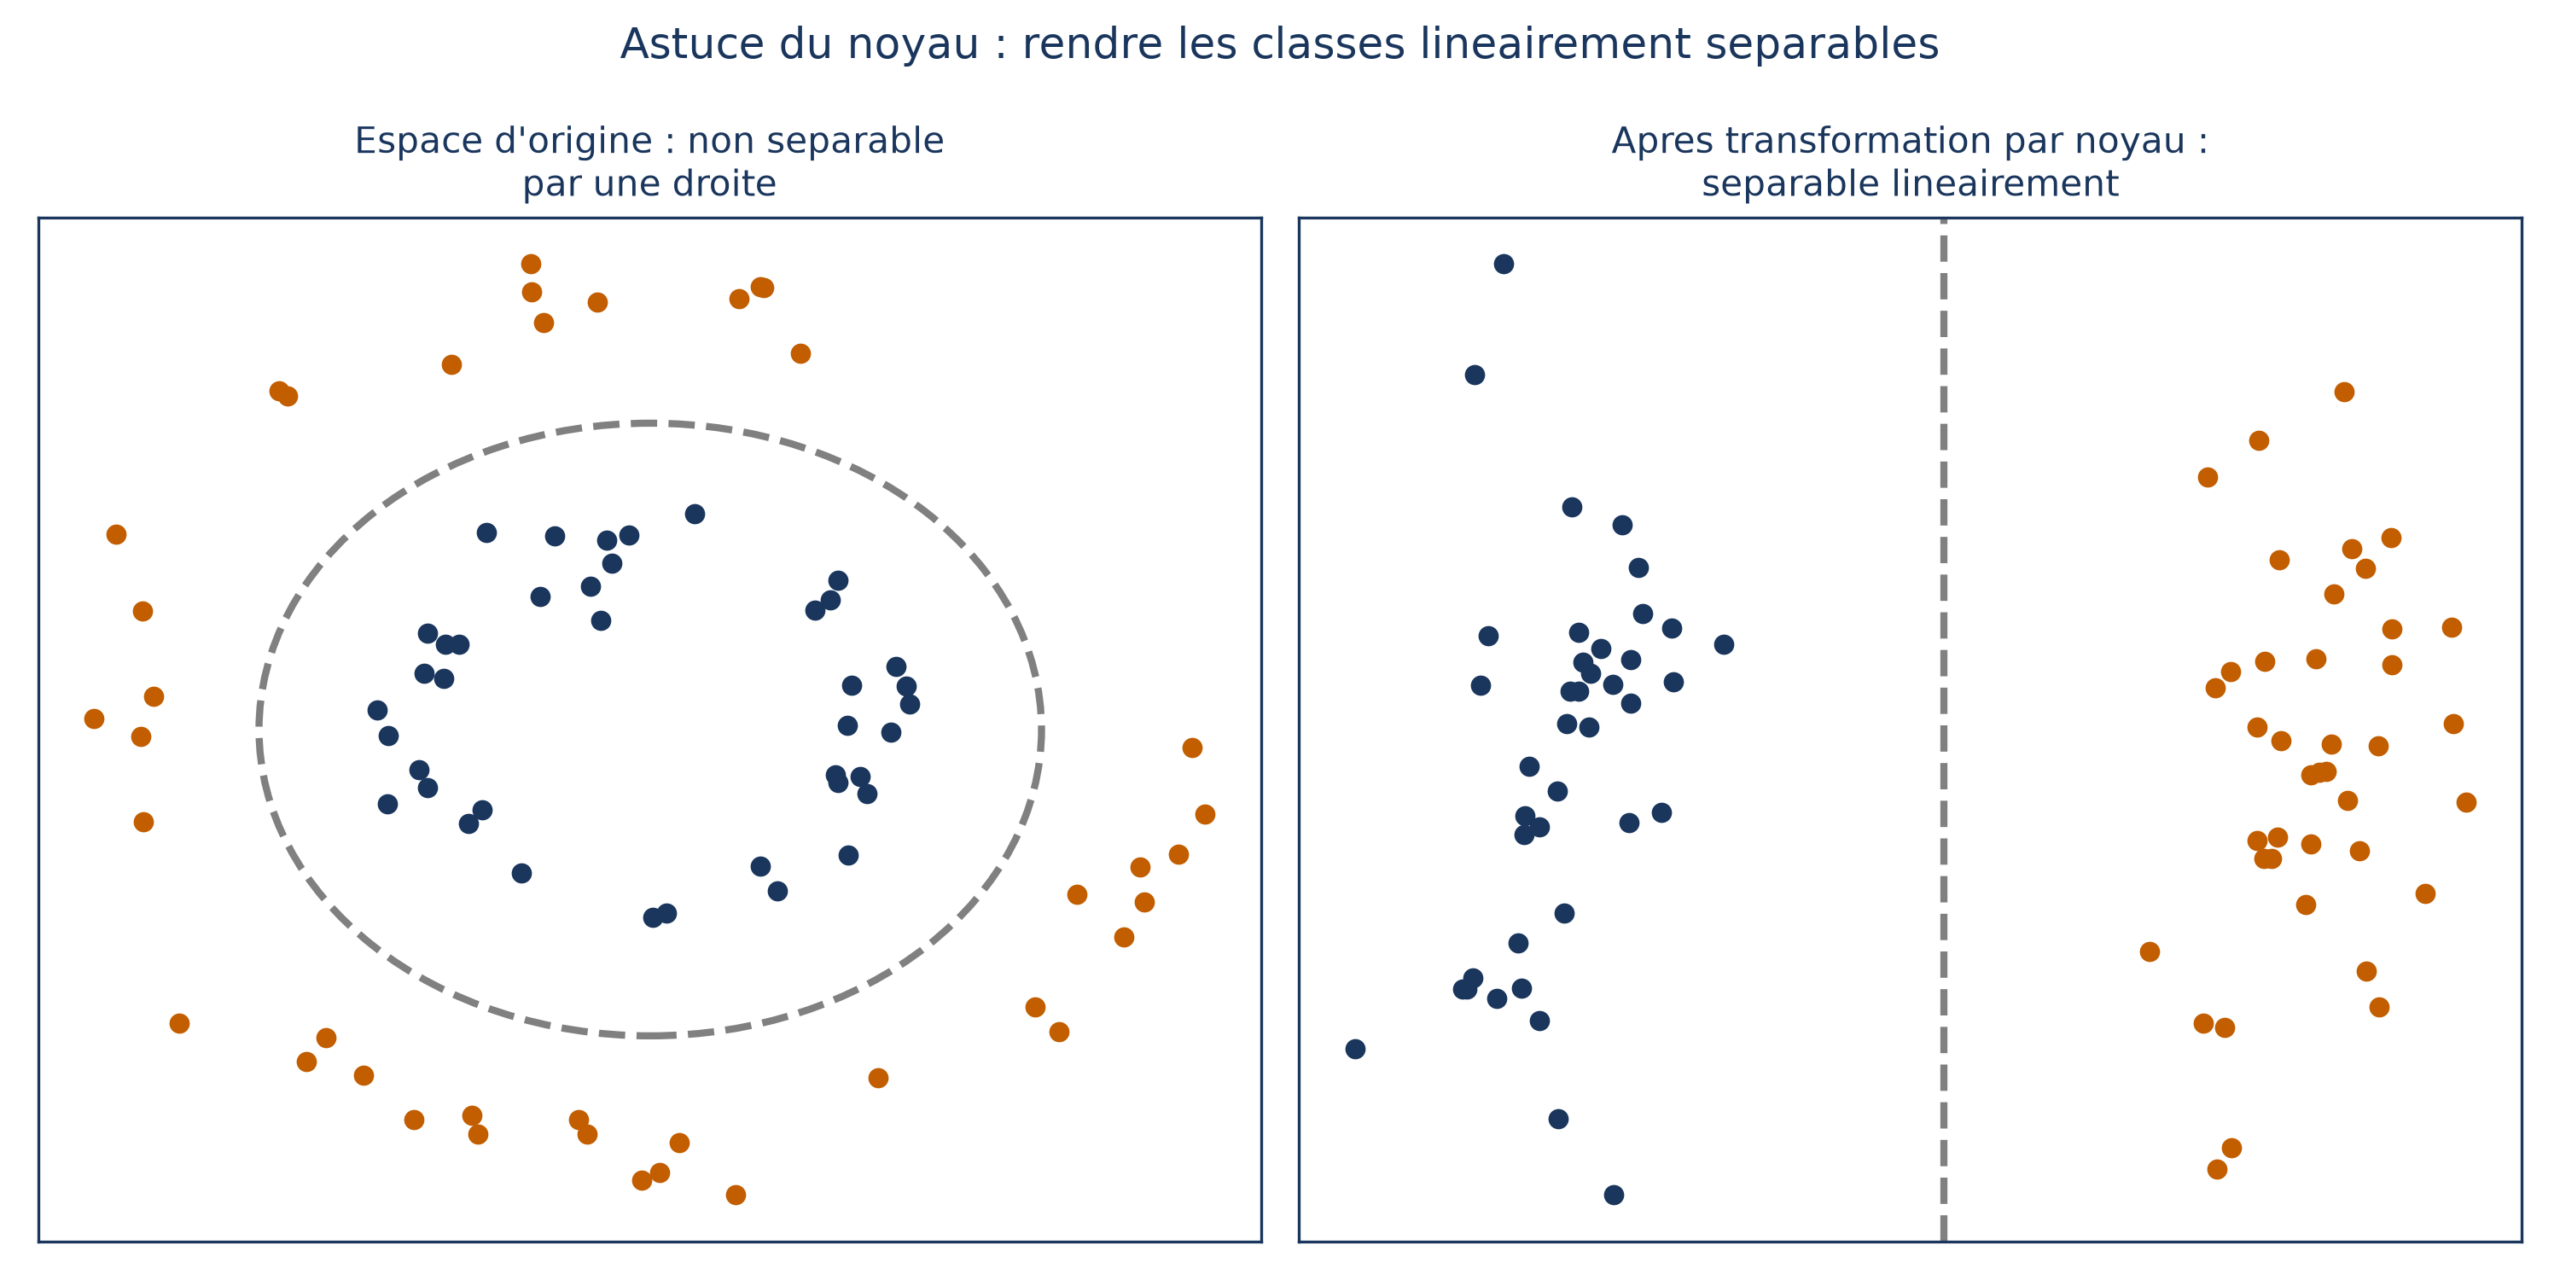
Pour aller bien plus loin, le classifieur à vecteurs de support reste linéaire par construction, mais les machines à vecteurs de support (SVM) agrandissent implicitement l’espace des prédicteurs avec des transformations non linéaires, puis y cherchent un hyperplan séparateur. Revenu dans l’espace d’origine, il devient une frontière non linéaire.
Troisième question : as-tu assez de données pour une méthode souple ?
Une frontière plus souple n’est pas un cadeau : elle se paie en données. QDA convient quand les classes ont probablement des covariances différentes ou que l’échantillon est assez grand pour estimer les paramètres supplémentaires sans trop de variance ; la LDA reste préférable avec peu de données, ou quand une frontière linéaire est une approximation raisonnable.
Les K plus proches voisins (KNN) illustrent le même arbitrage avec un seul bouton. Pour classer un point, on regarde les K observations d’entraînement les plus proches et on prend la classe majoritaire.
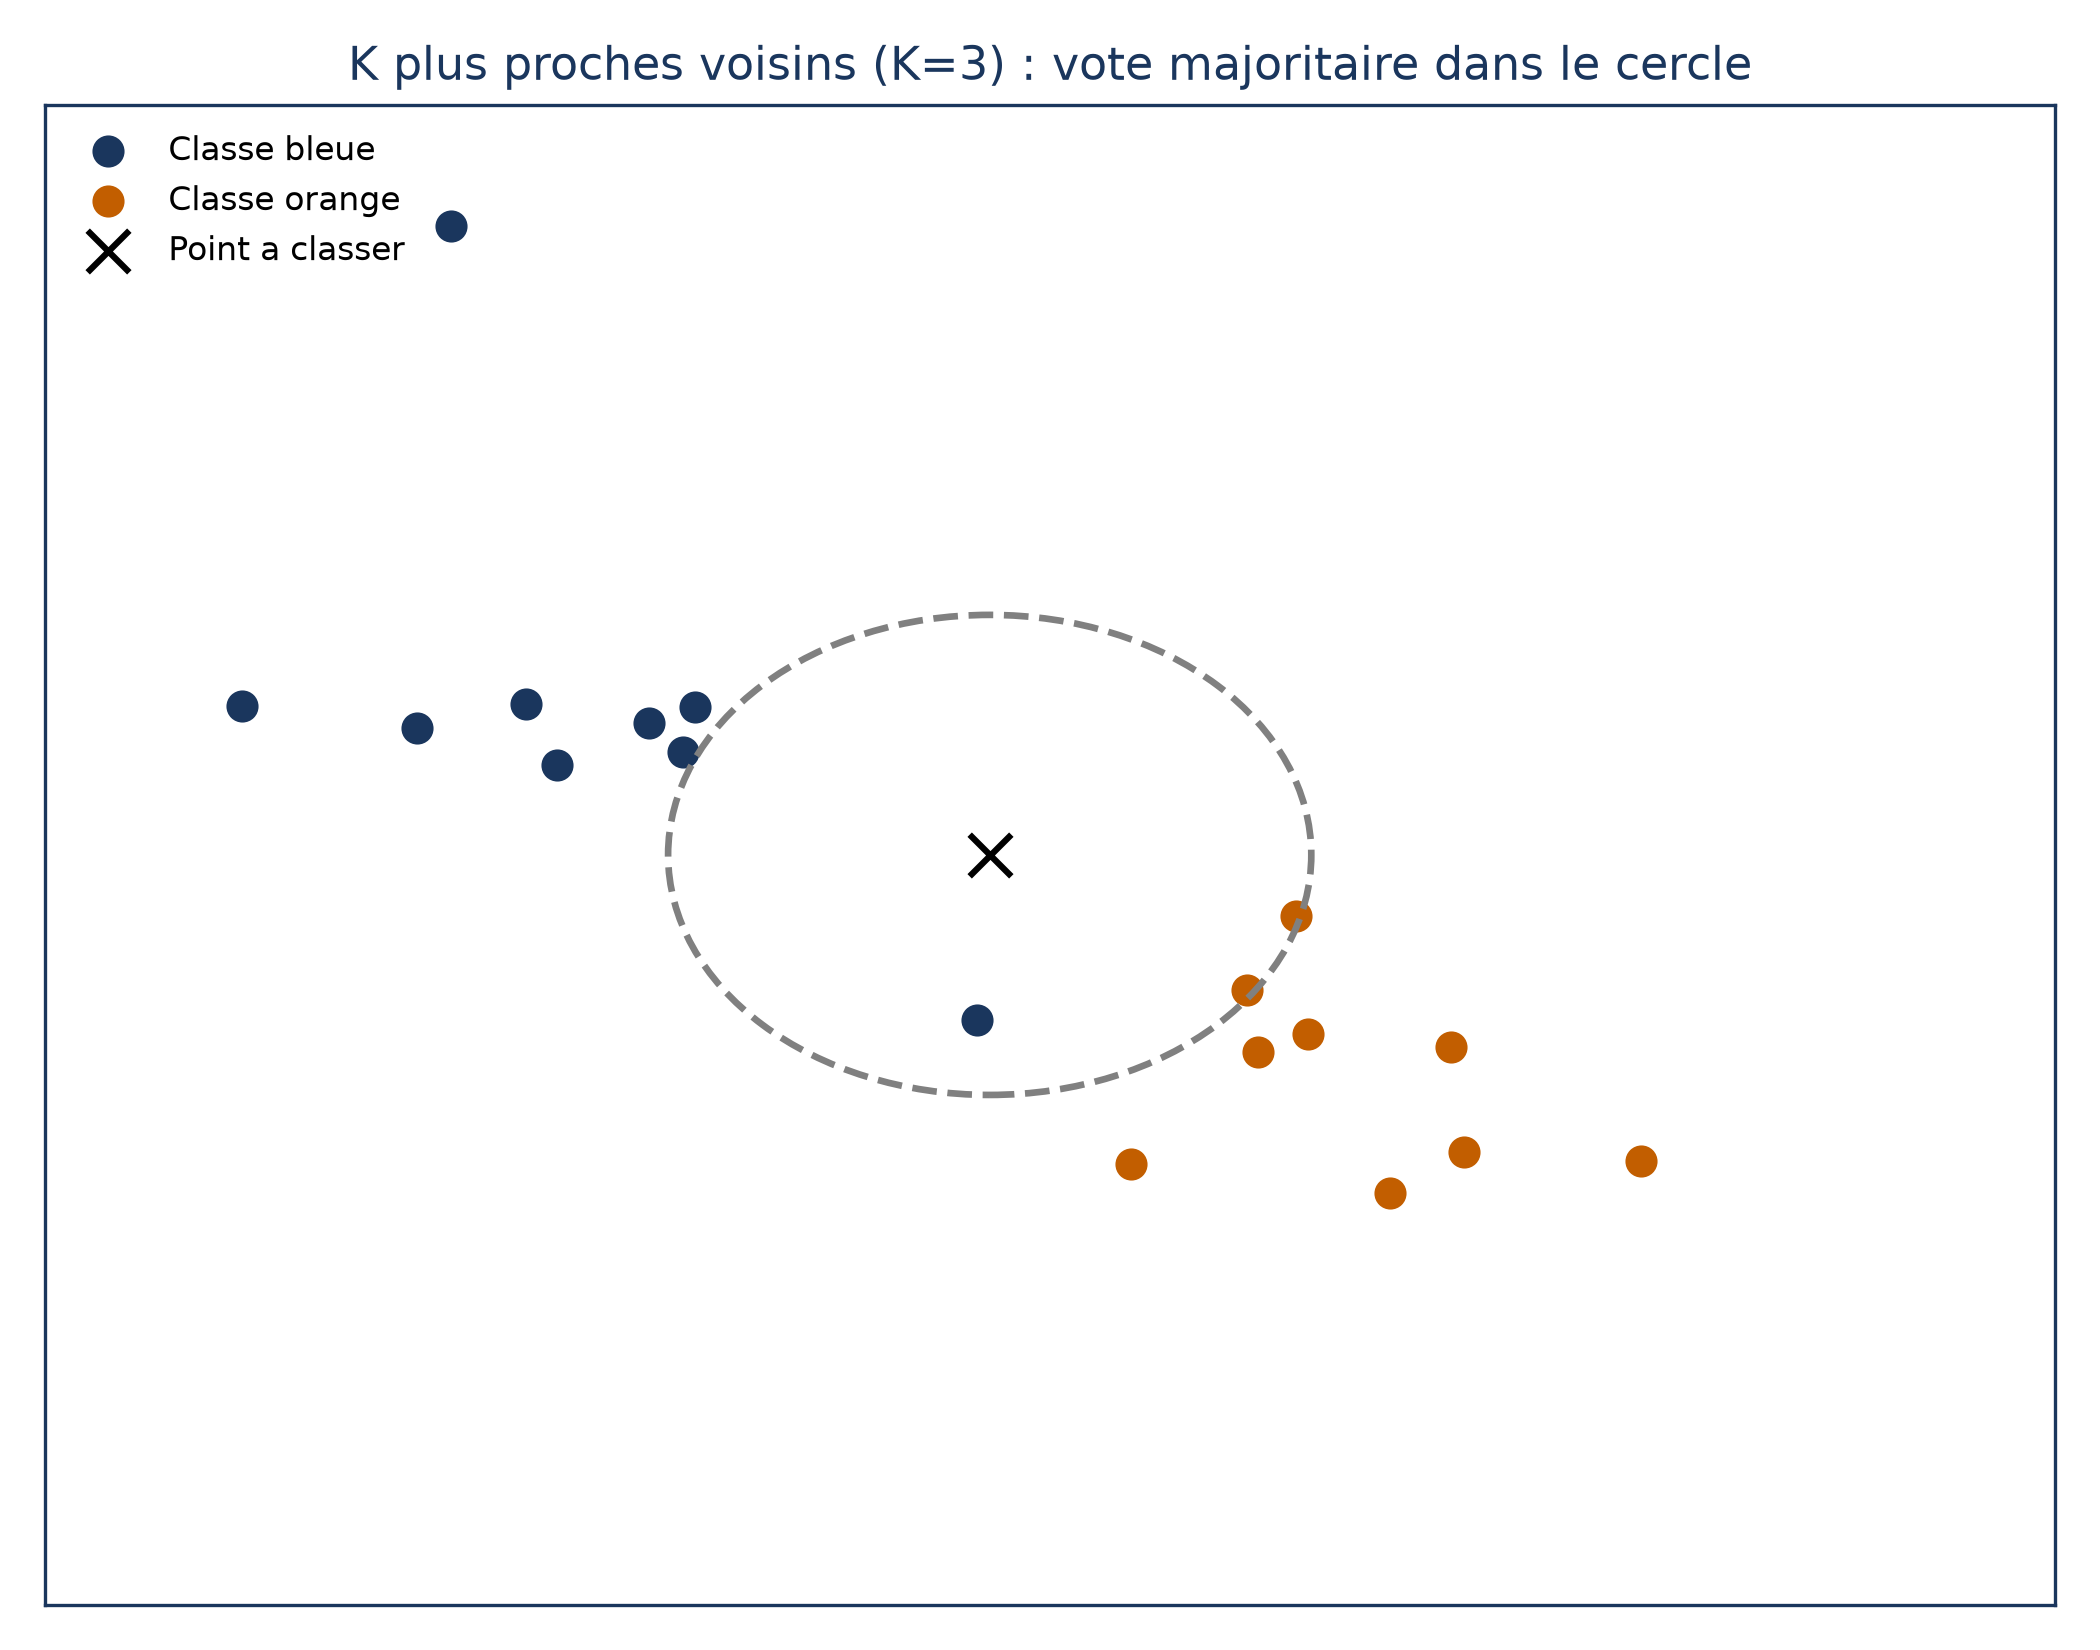
Avec K = 1, la frontière devient extrêmement irrégulière, épousant chaque particularité des données : faible biais mais très forte variance. À l’inverse, un grand K rigidifie la méthode, jusqu’à une frontière presque linéaire, avec une faible variance et un fort biais. Le taux d’erreur de test dessine alors une courbe en U : ni l’extrême souple ni l’extrême rigide ne sont satisfaisants.
💡 Intuition Viser la méthode la plus souple « pour être sûr » est un réflexe trompeur : à cause du surajustement, une méthode très flexible fait parfois de moins bonnes prédictions sur des données nouvelles qu’une méthode plus simple.
Quatrième question : combien de classes veux-tu départager ?
Imagine un service d’urgences où le diagnostic est à choisir parmi plusieurs pathologies : plus aucune frontière unique ne suffit. Deux familles de réponses s’offrent à toi.
La première, ce sont les méthodes génératives (LDA, QDA, naïve Bayes), dont un avantage cité est de se généraliser naturellement à plus de deux classes. La seconde consiste à ramener le problème à une série de choix binaires avec des SVM. Pour  classes, il existe deux stratégies : la classification un contre un, qui ajuste un SVM par paire de classes, soit
 classifieurs, puis vote à la majorité ; et la classification un contre tous, qui ajuste
 SVM opposant chacun une classe à toutes les autres réunies, et retient la classe dont le classifieur est le plus confiant.
Comment départager deux candidates sans te fier à ton impression
Reste un piège : choisir la méthode qui a le plus petit taux d’erreur… sur les données qui ont servi à l’entraîner. Minimiser l’erreur d’entraînement ne garantit jamais de minimiser l’erreur de test ; c’est cette dernière, estimée sur des données non vues, qui doit guider ton choix.
Pour l’estimer sans mettre de côté une grosse part de tes données, la validation croisée à k blocs (k = 5 ou 10 en pratique) offre le meilleur compromis entre biais et variance, avec un coût de calcul maîtrisé. Elle s’applique de la même façon en classification, avec le taux d’erreur comme mesure. La variante leave-one-out réduit le biais au minimum, mais coûte cher en calcul et affiche une variance plus forte.
Ce que ça te coûte de rester linéaire, et ce que ça te rapporte
Rester sur une frontière droite n’est pas une paresse. Quand ton but est de comprendre comment la réponse dépend des variables, les modèles restrictifs sont nettement plus interprétables : il est bien plus facile d’expliquer une droite qu’un réseau de neurones profond.
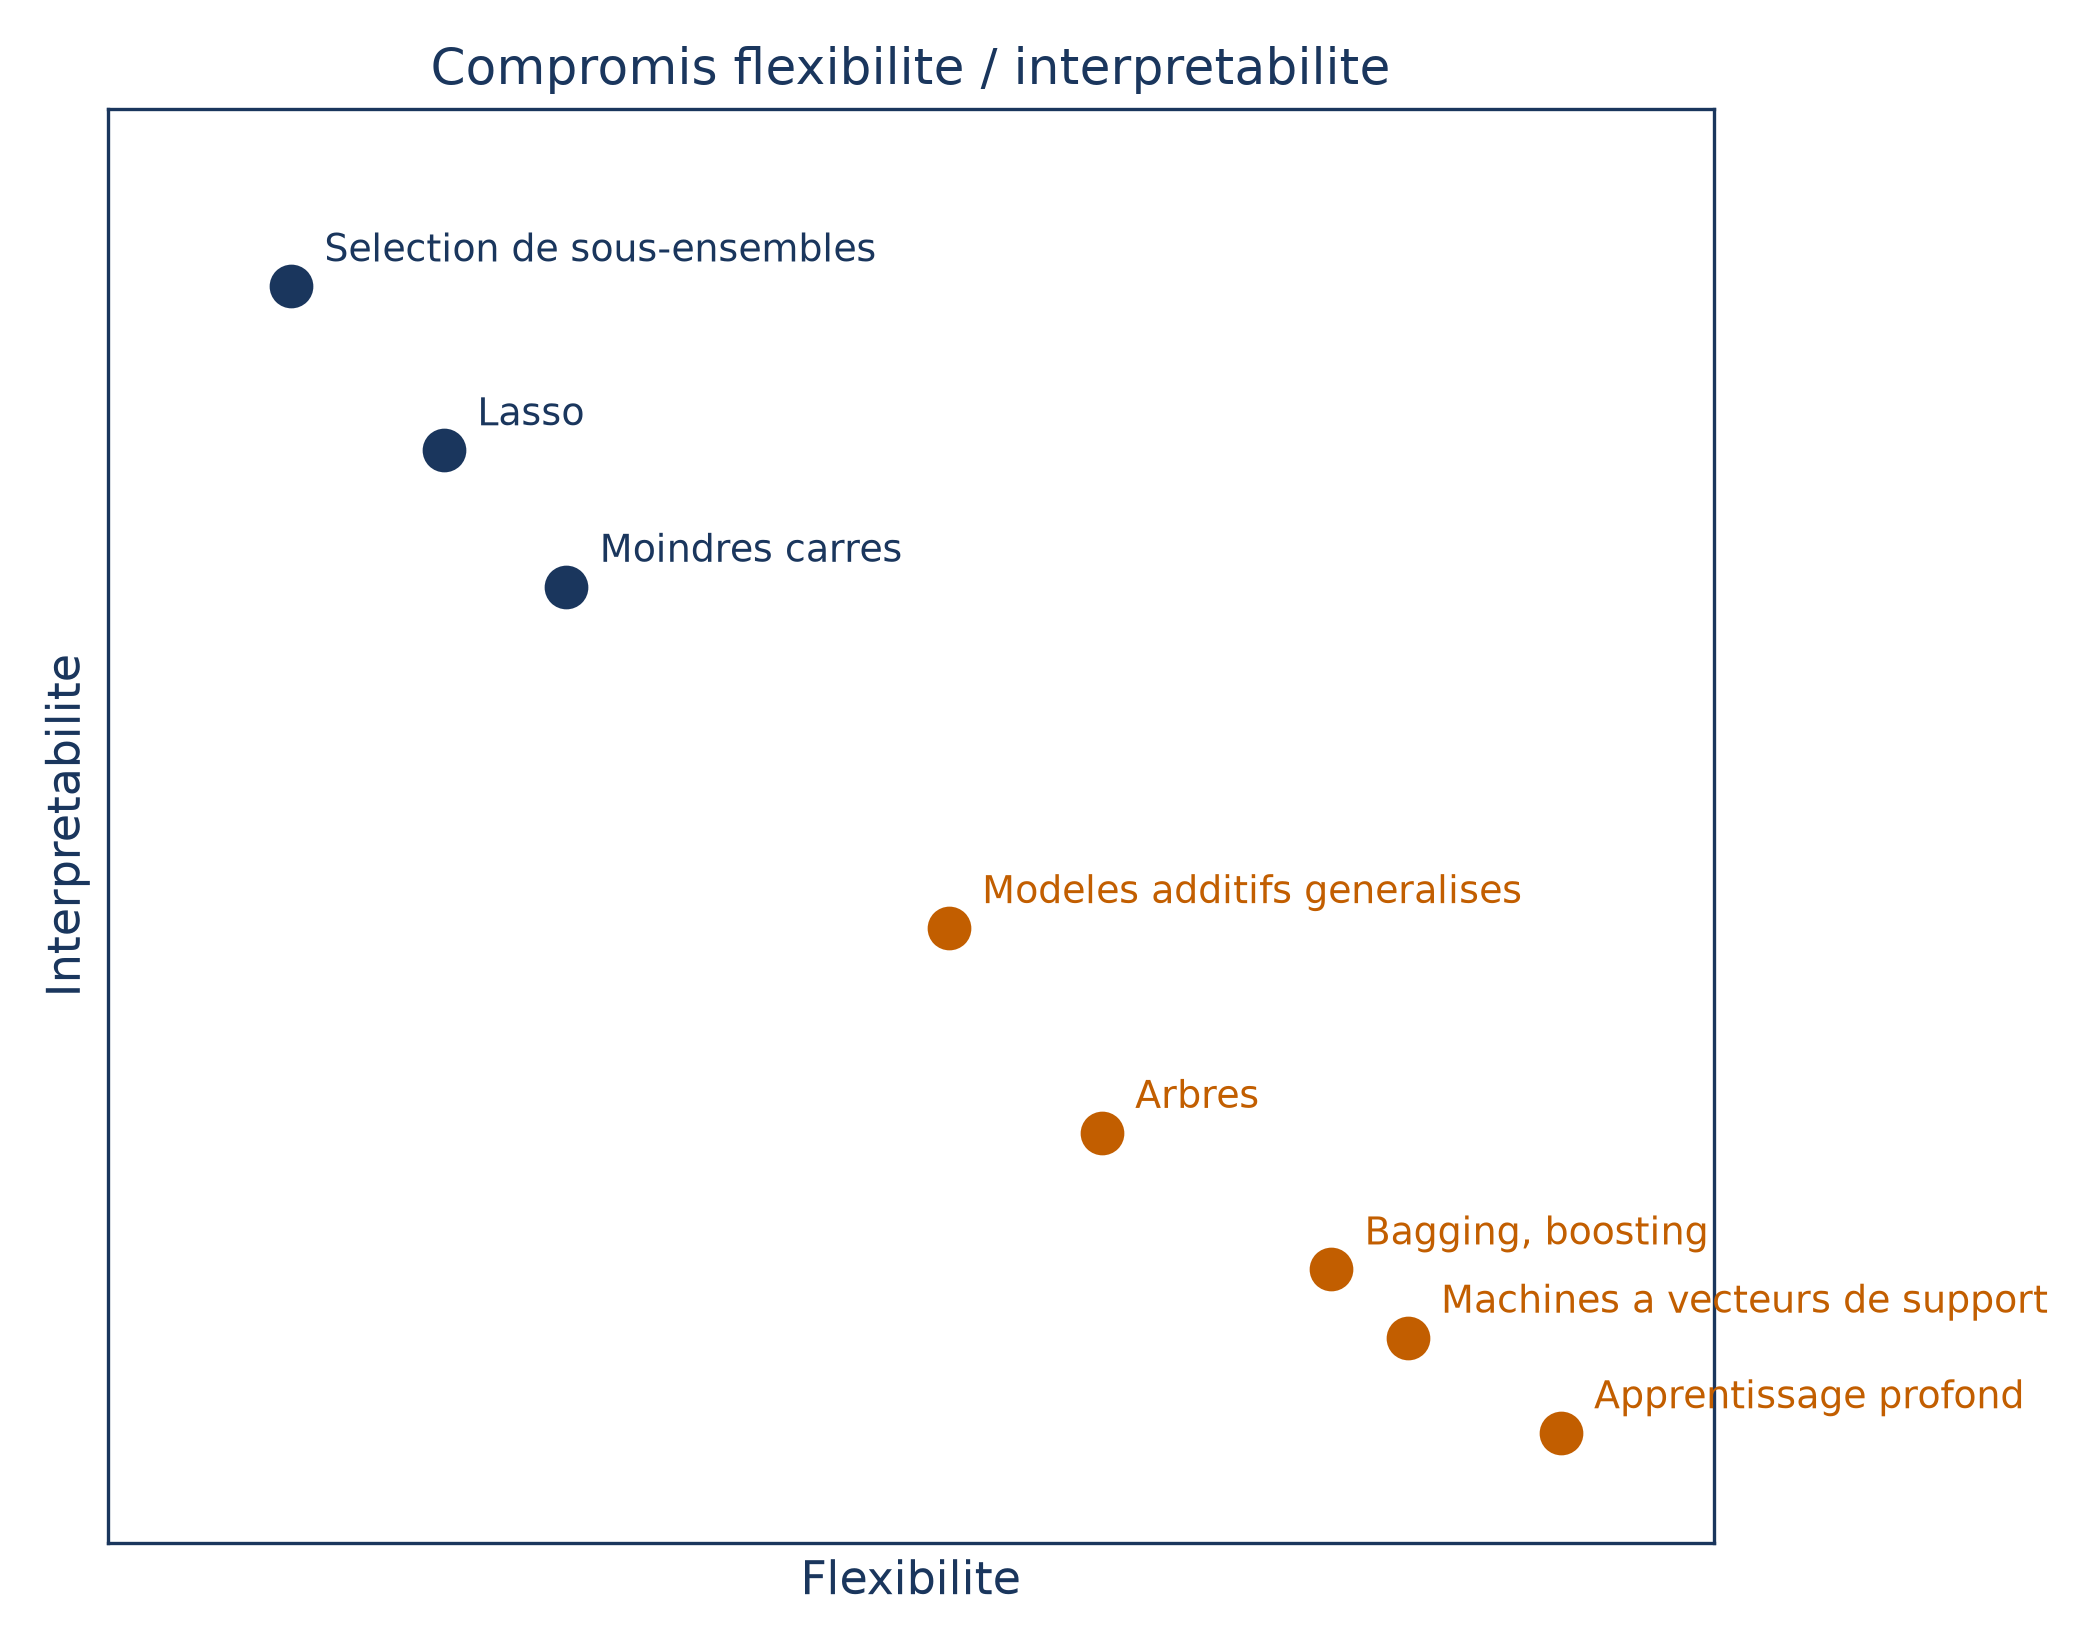
Il y a aussi un héritage : la régression logistique date des années 1940, et jusqu’à la fin des années 1970 les méthodes restaient presque exclusivement linéaires, la modélisation non linéaire étant trop coûteuse en calcul. Les arbres et les modèles additifs n’ont pu se développer qu’avec les progrès des ordinateurs dans les années 1980, les SVM dans les années 1990.
📌 À retenir Une catégorie à deux issues, une frontière qui ressemble à une droite, un volume de données modeste, un besoin de comprendre : voilà les conditions où la régression logistique est un bon premier choix. Dès qu’un de ces points vacille, la validation croisée te dit si une méthode plus souple vaut son prix.