Demande à un LLM qui a gagné la Coupe du monde de cricket 2023. Il peut avouer qu’il l’ignore, ou pire, répondre avec assurance que c’est l’Inde. C’est faux : c’est l’Australie.
On branche alors le modèle sur une source fiable, et on respire. Sauf que le problème ne disparaît pas : il change de forme. Le modèle a désormais le bon document sous les yeux, et il peut encore le lire de travers. À la fin de cet article, tu sauras où se cachent ces erreurs de lecture et quel verrou poser à chaque endroit.
L’essentiel en 30 secondes
- Un système RAG hallucine pour trois raisons : la récupération rate le bon contexte ou ramène du hors-sujet, le modèle ne tient pas compte du contexte fourni, ou il se fie à des éléments non pertinents de ce contexte.
- Il faut donc trois verrous, un par étage : bien chercher avant la lecture, contraindre la lecture dans le prompt, relire la réponse avant de la livrer.
- Le prompt qui interdit de sortir du contexte et autorise « Je ne sais pas » réduit le risque quand la recherche ne trouve rien de pertinent.
- Aucun verrou n’est gratuit : chacun ajoute du calcul, de la latence ou du stockage.
- Pour savoir si ça tient, on mesure la fidélité, c’est-à-dire la part de la réponse qui s’appuie réellement sur les documents. Mais une fidélité élevée ne suffit pas à garantir une réponse juste.
L’intuition : un modèle qui prédit ne consulte rien
Il est tentant d’imaginer qu’un LLM range des faits quelque part et va les chercher. Ce n’est pas le cas : le modèle ne mémorise ni faits ni événements précis, il génère sa réponse à partir de poids appris, exactement comme il prédirait le mot suivant d’une phrase ordinaire.
Autrement dit, produire une réponse fausse mais plausible est son comportement de base, pas une panne rare. Et il le fait souvent avec la même assurance qu’une réponse exacte.
Le RAG change l’entrée du modèle, pas sa nature. Le système va chercher de l’information dans une source externe, la combine à la question, puis laisse le LLM produire la réponse : c’est le schéma « récupérer puis lire ». Chaque étape a sa faiblesse propre.
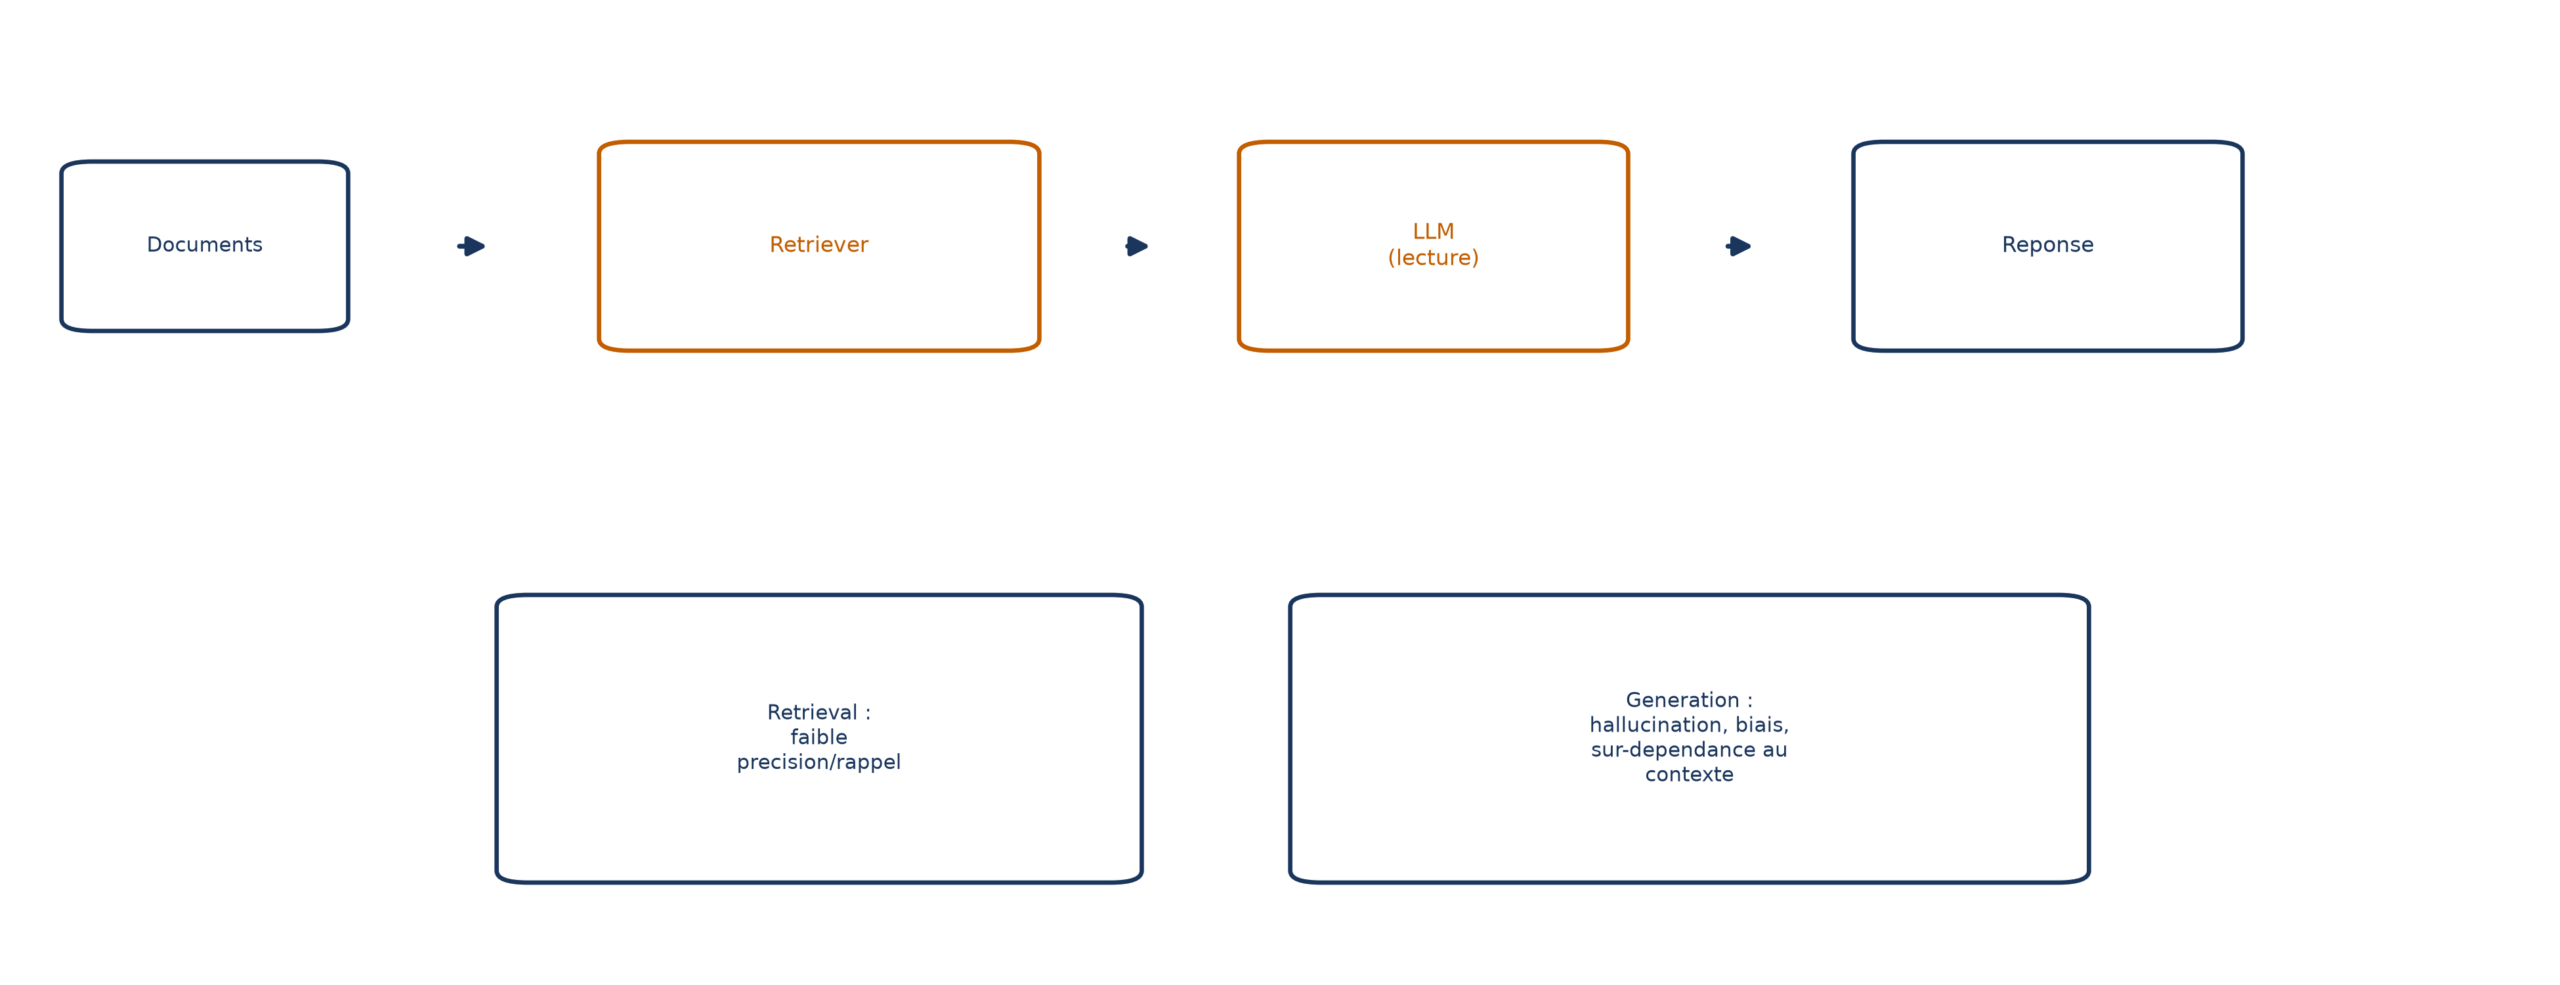
💡 Intuition Quand la réponse déraille, ne demande pas seulement « le modèle est-il mauvais ? ». Demande d’abord : a-t-il reçu le bon texte, l’a-t-il lu correctement, et quelqu’un a-t-il relu sa copie ?
Premier verrou : lui donner le bon texte
Beaucoup de « mauvaises interprétations » sont en réalité de mauvaises lectures de mauvais documents. Un contexte non pertinent ou mal structuré distrait le modèle, ou dépasse le budget de jetons sans rien apporter. Première règle : ne remonter que les informations les plus utiles, plutôt que de gros blocs de texte ajoutés sans discernement.
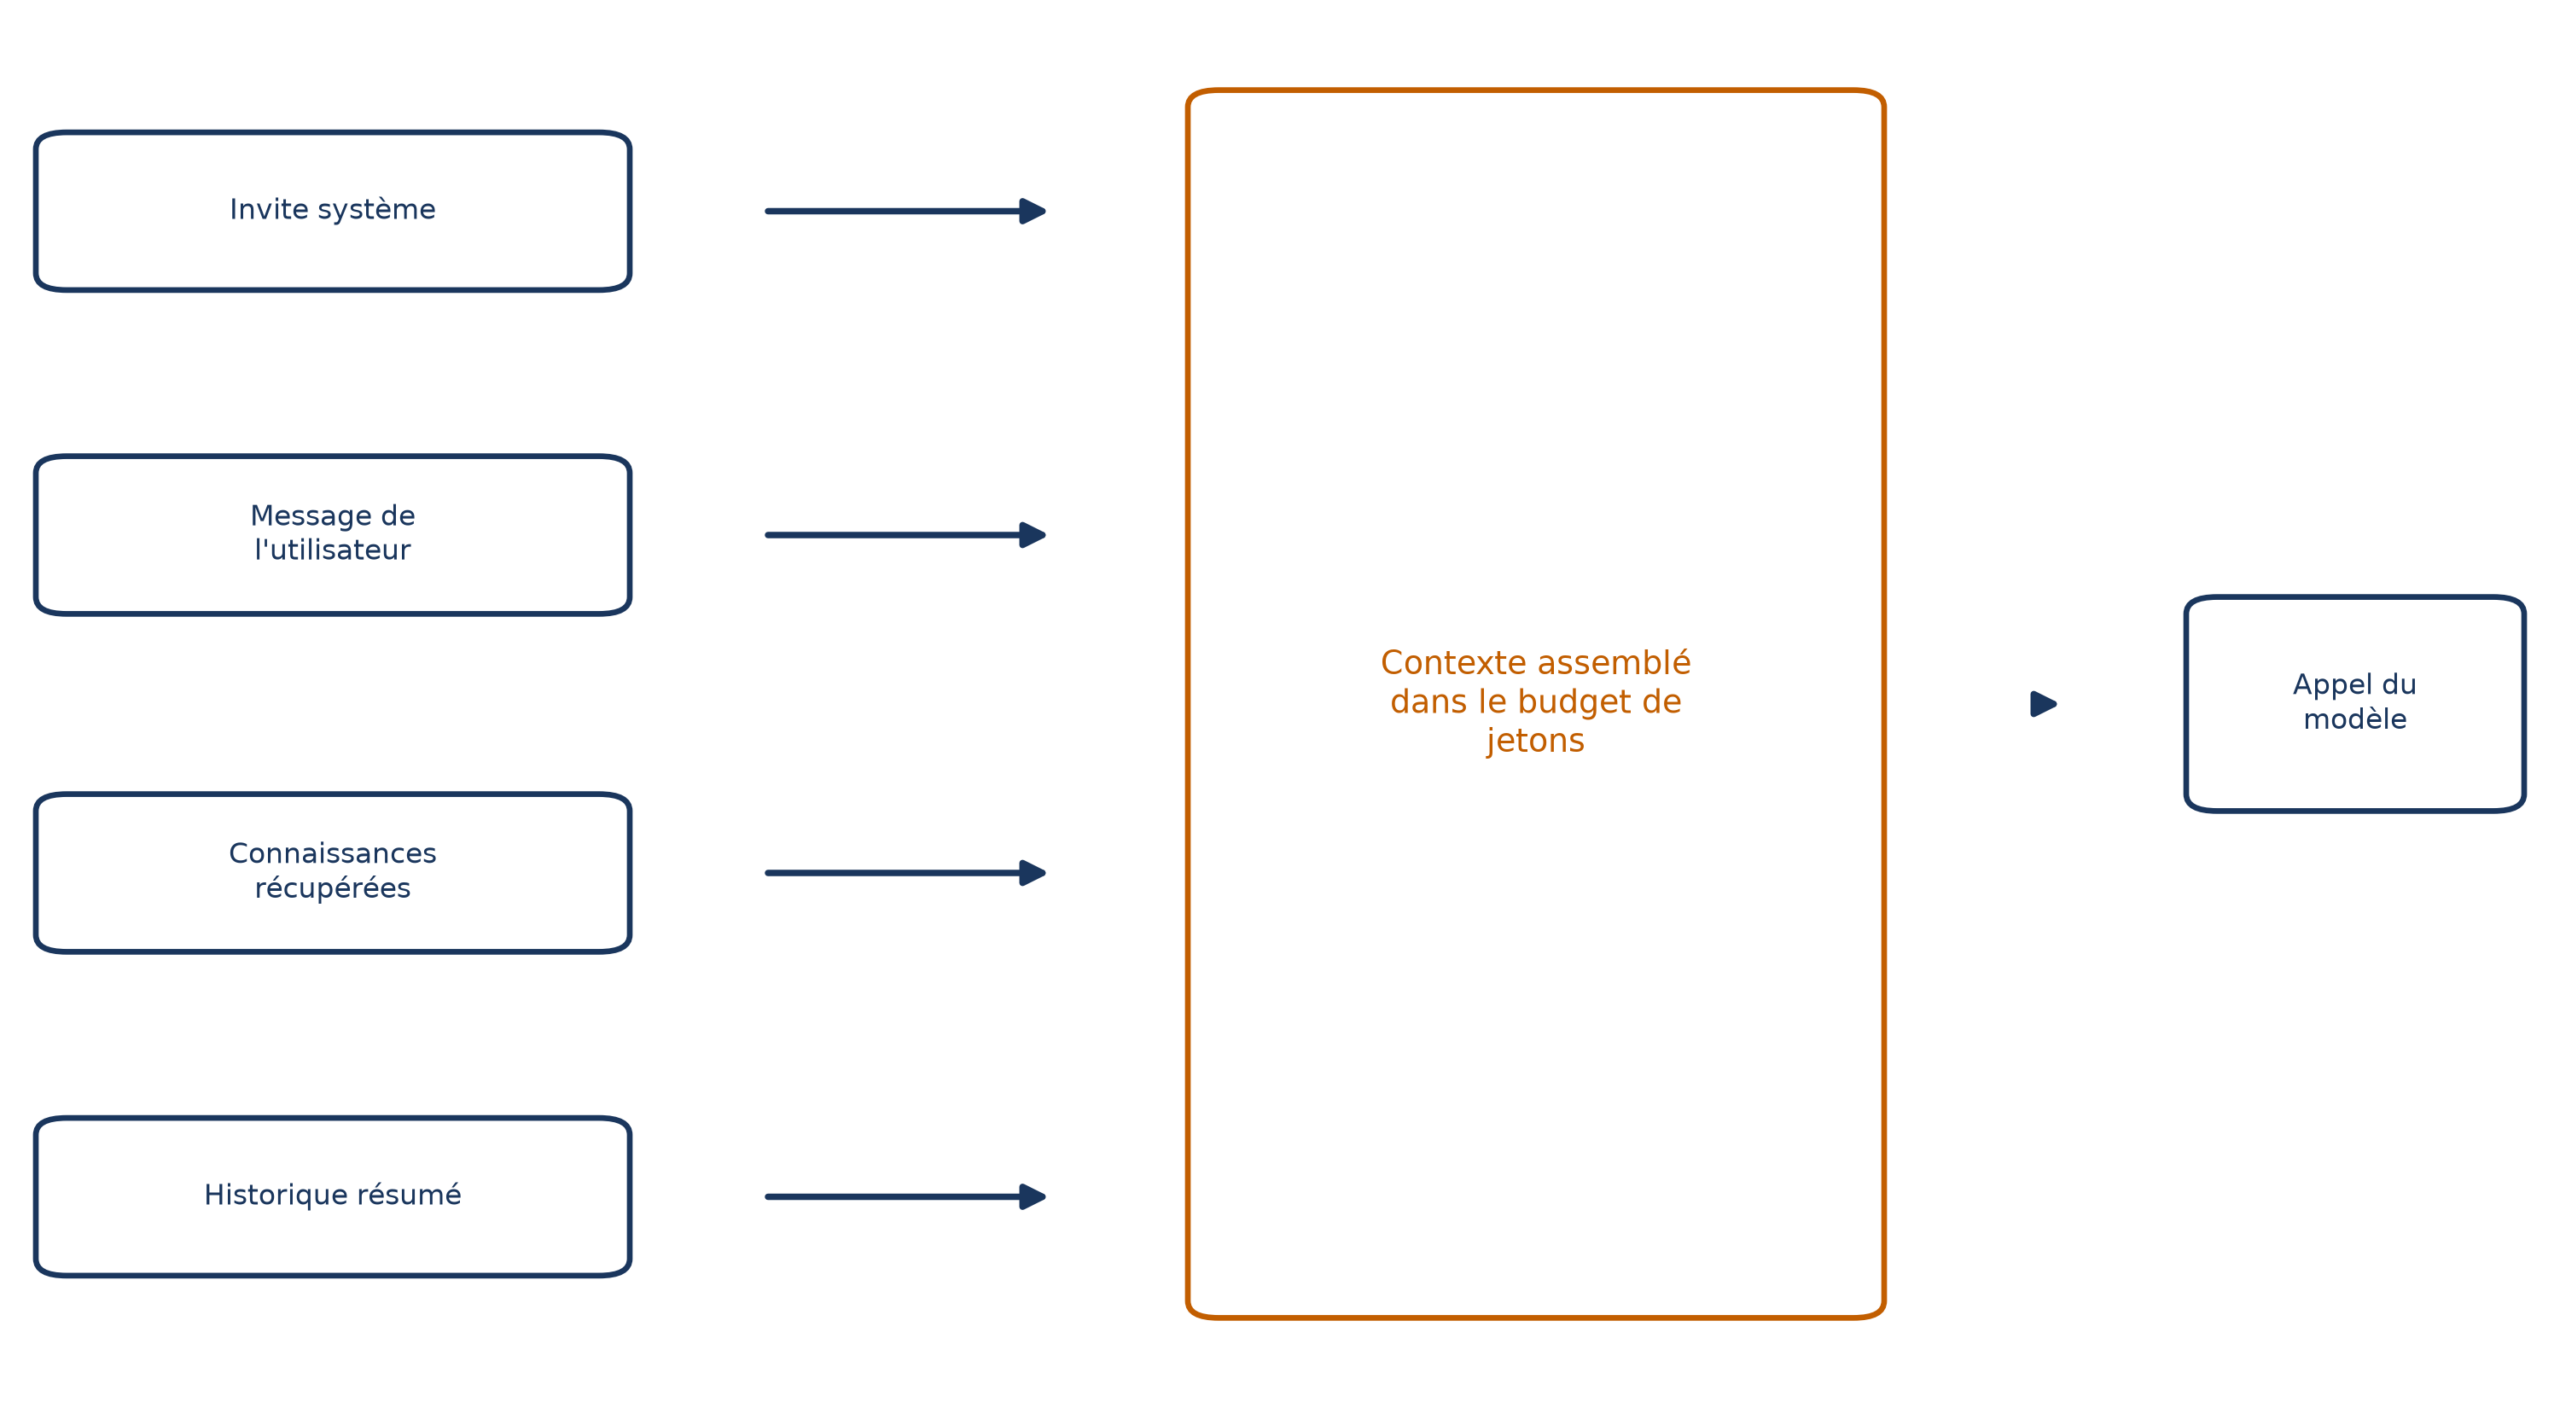
Plusieurs leviers existent, chacun visant un défaut précis :
- La taille des fragments. De grands fragments apportent du contexte mais aussi du bruit ; de petits fragments sont précis mais peuvent perdre le contexte.
Un document juridique de 10 000 mots découpé en segments de 1 000 mots mélangera plusieurs clauses. Des segments de 200 mots isoleront chaque clause, au risque de perdre le contexte des clauses voisines. - Le filtrage par métadonnées. Restreindre la recherche par date, auteur ou catégorie réduit le bruit ; filtrer par date évite par exemple de remonter des informations obsolètes.
- La reformulation de la question. L’embedding d’une question ne colle pas toujours à celui du document qui contient la réponse, à cause de différences de terminologie. Le step-back prompting transforme une question précise en question plus générale : « Which team did Thierry Audel play for from 2007 to 2008 ? » devient « What is the career history of Thierry Audel ? ».
- Le re-classement et la compression. Le re-classement réordonne les documents récupérés pour prioriser les plus pertinents ; la compression supprime les tokens peu importants d’un contexte trop long, au prix d’une possible perte d’information.
Un autre écueil est propre aux longs prompts. Même les LLM à grande fenêtre de contexte perdent en précision quand l’information pertinente se trouve au milieu ; ne transmettre que l’information pertinente limite ce risque, et placer le contexte le plus pertinent près de la fin de l’invite augmente les chances qu’il soit utilisé.
Sur la question de la Coupe du monde, c’est ce verrou qui décide si le paragraphe utile arrive ou non devant le modèle : sans lui, le reste du dispositif travaille dans le vide.
Deuxième verrou : contraindre la lecture
Supposons que le bon passage soit arrivé. Reste à empêcher le modèle de broder autour, ou de retomber sur sa mémoire interne. Cela relève de l’étape d’augmentation, c’est-à-dire de l’ingénierie de prompt : la façon dont le prompt est construit influence considérablement la qualité de la réponse.
Deux consignes font l’essentiel du travail. Le prompting contextuel ajoute l’instruction de répondre uniquement à partir du contexte fourni, pour contraindre le LLM à s’appuyer sur l’information donnée plutôt que sur sa mémoire paramétrique. Le prompting à génération contrôlée va plus loin : il demande de répondre « Je ne sais pas » si le contexte ne permet pas de répondre, ce qui réduit le risque d’hallucination quand le retriever n’a rien trouvé de pertinent.
Ce second point compte plus qu’il n’y paraît. L’une des aptitudes qu’un système doit posséder est le rejet négatif : ne pas répondre quand aucune information pertinente n’existe dans la base, car un LLM, par nature, tend toujours à générer du texte.
Voici les deux consignes réunies dans une fonction complète. Ce que tu vas observer : le contexte récupéré est collé dans le prompt, les deux règles sont posées en toutes lettres, et le modèle est appelé avec temperature=0. La fonction renvoie à la fois le contexte utilisé et la réponse, ce qui servira plus loin pour la mesure.
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings, ChatOpenAI

def rag_function(query, db_path, index_name):
    embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
    db = FAISS.load_local(
        folder_path=db_path,
        index_name=index_name,
        embeddings=embeddings,
        allow_dangerous_deserialization=True
    )
    retrieved_docs = db.similarity_search(query, k=2)
    retrieved_context = [retrieved_docs[0].page_content
                          + retrieved_docs[1].page_content]
    augmented_prompt = f"""
Given the context below, answer the question.
Question: {query}
Context : {retrieved_context}
Remember to answer only based on the context
provided and not from any other source.
If the question cannot be answered based
on the provided context, say I don't know.
"""
    llm = ChatOpenAI(
        model="gpt-4o-mini",
        temperature=0,
        max_tokens=None,
        timeout=None,
        max_retries=2
    )
    response = llm.invoke([("human", augmented_prompt)])
    answer = response.content
    return retrieved_context, answer
Trois choses à retenir de ce code. La recherche par similarité garde les deux documents les plus proches (k=2). Le prompt contient à la fois la consigne « uniquement à partir du contexte » et la sortie de secours « I don’t know ». Et la température est fixée à zéro : c’est l’un des réglages qui, avec l’ancrage dans un contexte explicite et le raisonnement étape par étape, atténuent le risque d’hallucination en rendant les réponses plus déterministes.
⚠️ Piège Ce prompt ne fait pas de miracle. Il demande au modèle d’être fidèle, il ne le vérifie pas. Un LLM peut ignorer le contexte malgré tout : c’est justement l’une des trois causes d’hallucination.
Le prompt peut aussi guider la forme de la réponse. Le few-shot prompting fournit des exemples de questions-réponses dans le prompt, et le chain-of-thought introduit des étapes de raisonnement intermédiaires, utiles sur les tâches complexes.
Troisième verrou : relire avant de répondre
Les deux premiers verrous agissent en amont. Le troisième ajoute un contrôle en aval, et c’est là que l’agent prend son sens. Les LLM étant non déterministes, ils peuvent se tromper à n’importe quelle étape : reformulation, mise à jour, routage. D’où l’utilité d’un garde-fou final, la critique de réponse.
Le principe : un second appel au modèle reçoit la question d’origine et les réponses obtenues, puis vérifie qu’elles répondent bien à la question. S’il manque quelque chose, il propose de nouvelles questions à poser ; sinon, il renvoie une liste vide. Regarde surtout la consigne du prompt : les nouvelles questions doivent être « complètes, atomiques et spécifiques ».
Ici, chat est la fonction d’appel au modèle GPT-4o utilisée dans cet exemple, et answers est la liste des réponses déjà obtenues, transmise en messages.
answer_critique_prompt = """
    You are an expert at identifying if questions have been fully answered or
if there is an opportunity to enrich the answer.
    The user will provide a question, and you will scan through the provided
information to see if the question is answered.
    If anything is missing from the answer, you will provide a set of new
questions that can be asked to gather the missing information.
    All new questions must be complete, atomic, and specific.
    However, if the provided information is enough to answer the original
question, you will respond with an empty list.
    JSON template to use for finding missing information:
    {
        "questions": ["question1", "question2"]
    }
"""

def critique_answers(question: str, answers: list[dict[str, str]]) -> list[str]:
    messages = [
        {
            "role": "system",
            "content": answer_critique_prompt,
        },
        *answers,
        {
            "role": "user",
            "content": f"The original user question to answer: {question}",
        },
    ]
    config = {"response_format": {"type": "json_object"}}
    output = chat(messages, model="gpt-4o", config=config)
    try:
        return json.loads(output)["questions"]
    except json.JSONDecodeError:
        print("Error decoding JSON")
    return []
Ce qu’il faut en retenir : la sortie est forcée au format JSON, ce qui rend la critique exploitable par du code, et une liste vide signifie « rien à ajouter ». Si la critique renvoie de nouvelles questions, on repasse par le routeur de retrievers pour récupérer les informations manquantes, toujours avec un critère de sortie de boucle pour ne pas rester bloqué indéfiniment.
Cette idée de boucle acteur-critique est particulièrement utile quand évaluer est plus facile que générer : si l’on sait dire de façon fiable « ceci est une bonne sortie » sans savoir la produire du premier coup, une boucle simple est un outil puissant, sans apprentissage requis.
D’autres approches poussent l’idée plus loin, en contrôlant les documents eux-mêmes :
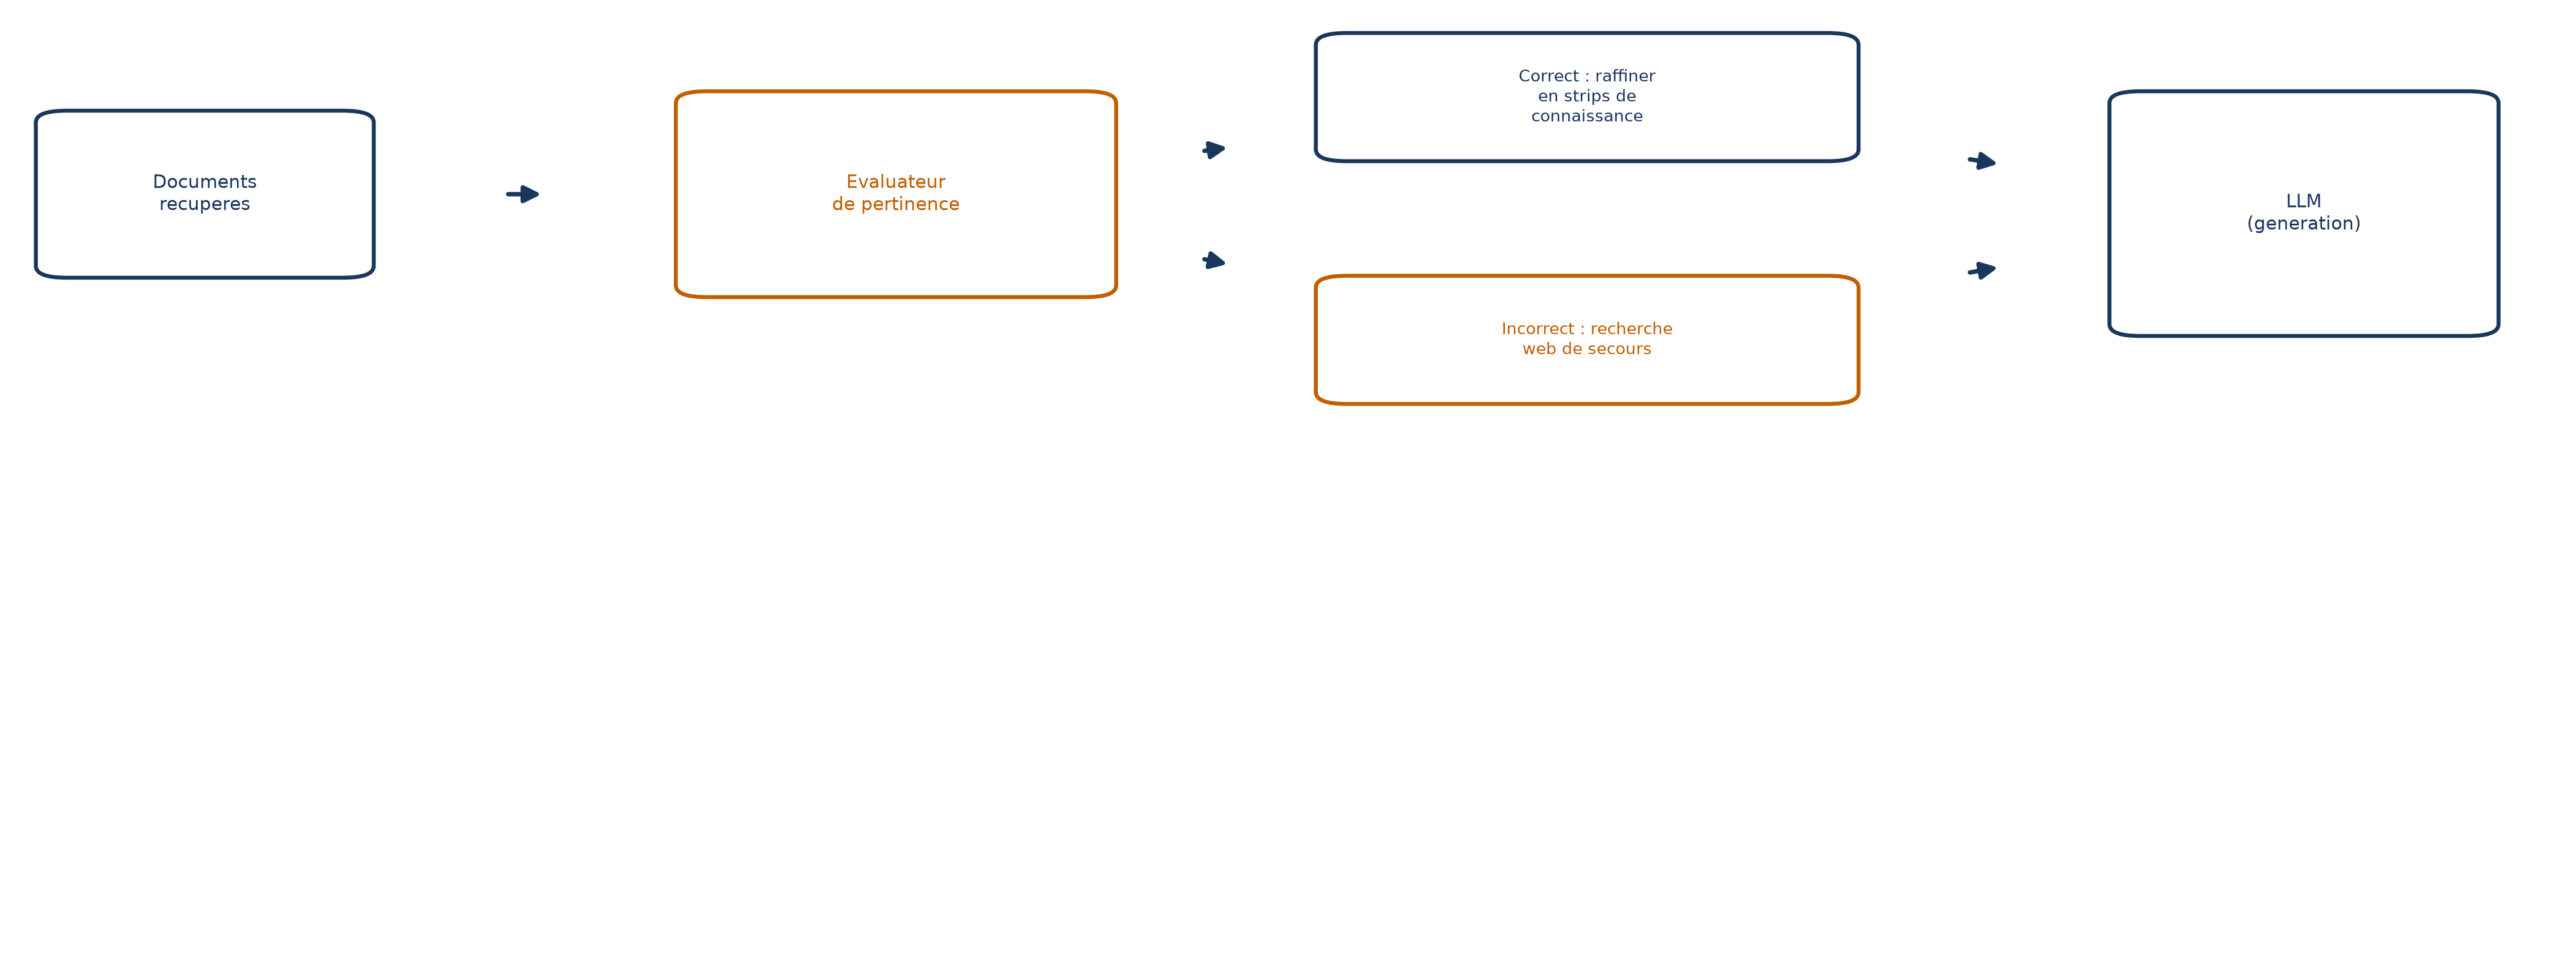
- CRAG (RAG correctif). Un évaluateur léger classe chaque document récupéré comme correct, incorrect ou ambigu. Si un document est jugé incorrect, une recherche web vient compléter la base ; les documents corrects sont décomposés en « bandes de connaissance » réévaluées individuellement avant la génération.
- Self-RAG. Le LLM est entraîné à produire des « jetons de réflexion » : un jeton de récupération indique si une recherche est nécessaire, un jeton de pertinence évalue un passage, un jeton de support vérifie que la réponse s’appuie bien sur le contenu récupéré, un jeton d’utilité note la réponse.
Enfin, quand la relecture échoue, il vaut mieux dire les choses. Un agent bien conçu échoue avec élégance : reconnaître le problème, l’expliquer, proposer une suite. Face à une information introuvable, mieux vaut un message du genre « Je n’ai pas trouvé l’information recherchée ; souhaites-tu que je transmette ta demande à un conseiller ? » qu’une réponse incorrecte ou absurde.
Mesurer : la fidélité, et ce qu’elle ne dit pas
Poser des verrous ne prouve pas qu’ils tiennent. Pour le vérifier, on regarde trois relations : la question face au contexte récupéré (pertinence du contexte), le contexte face à la réponse (fidélité, ou groundedness), et la réponse face à la question (pertinence de la réponse).
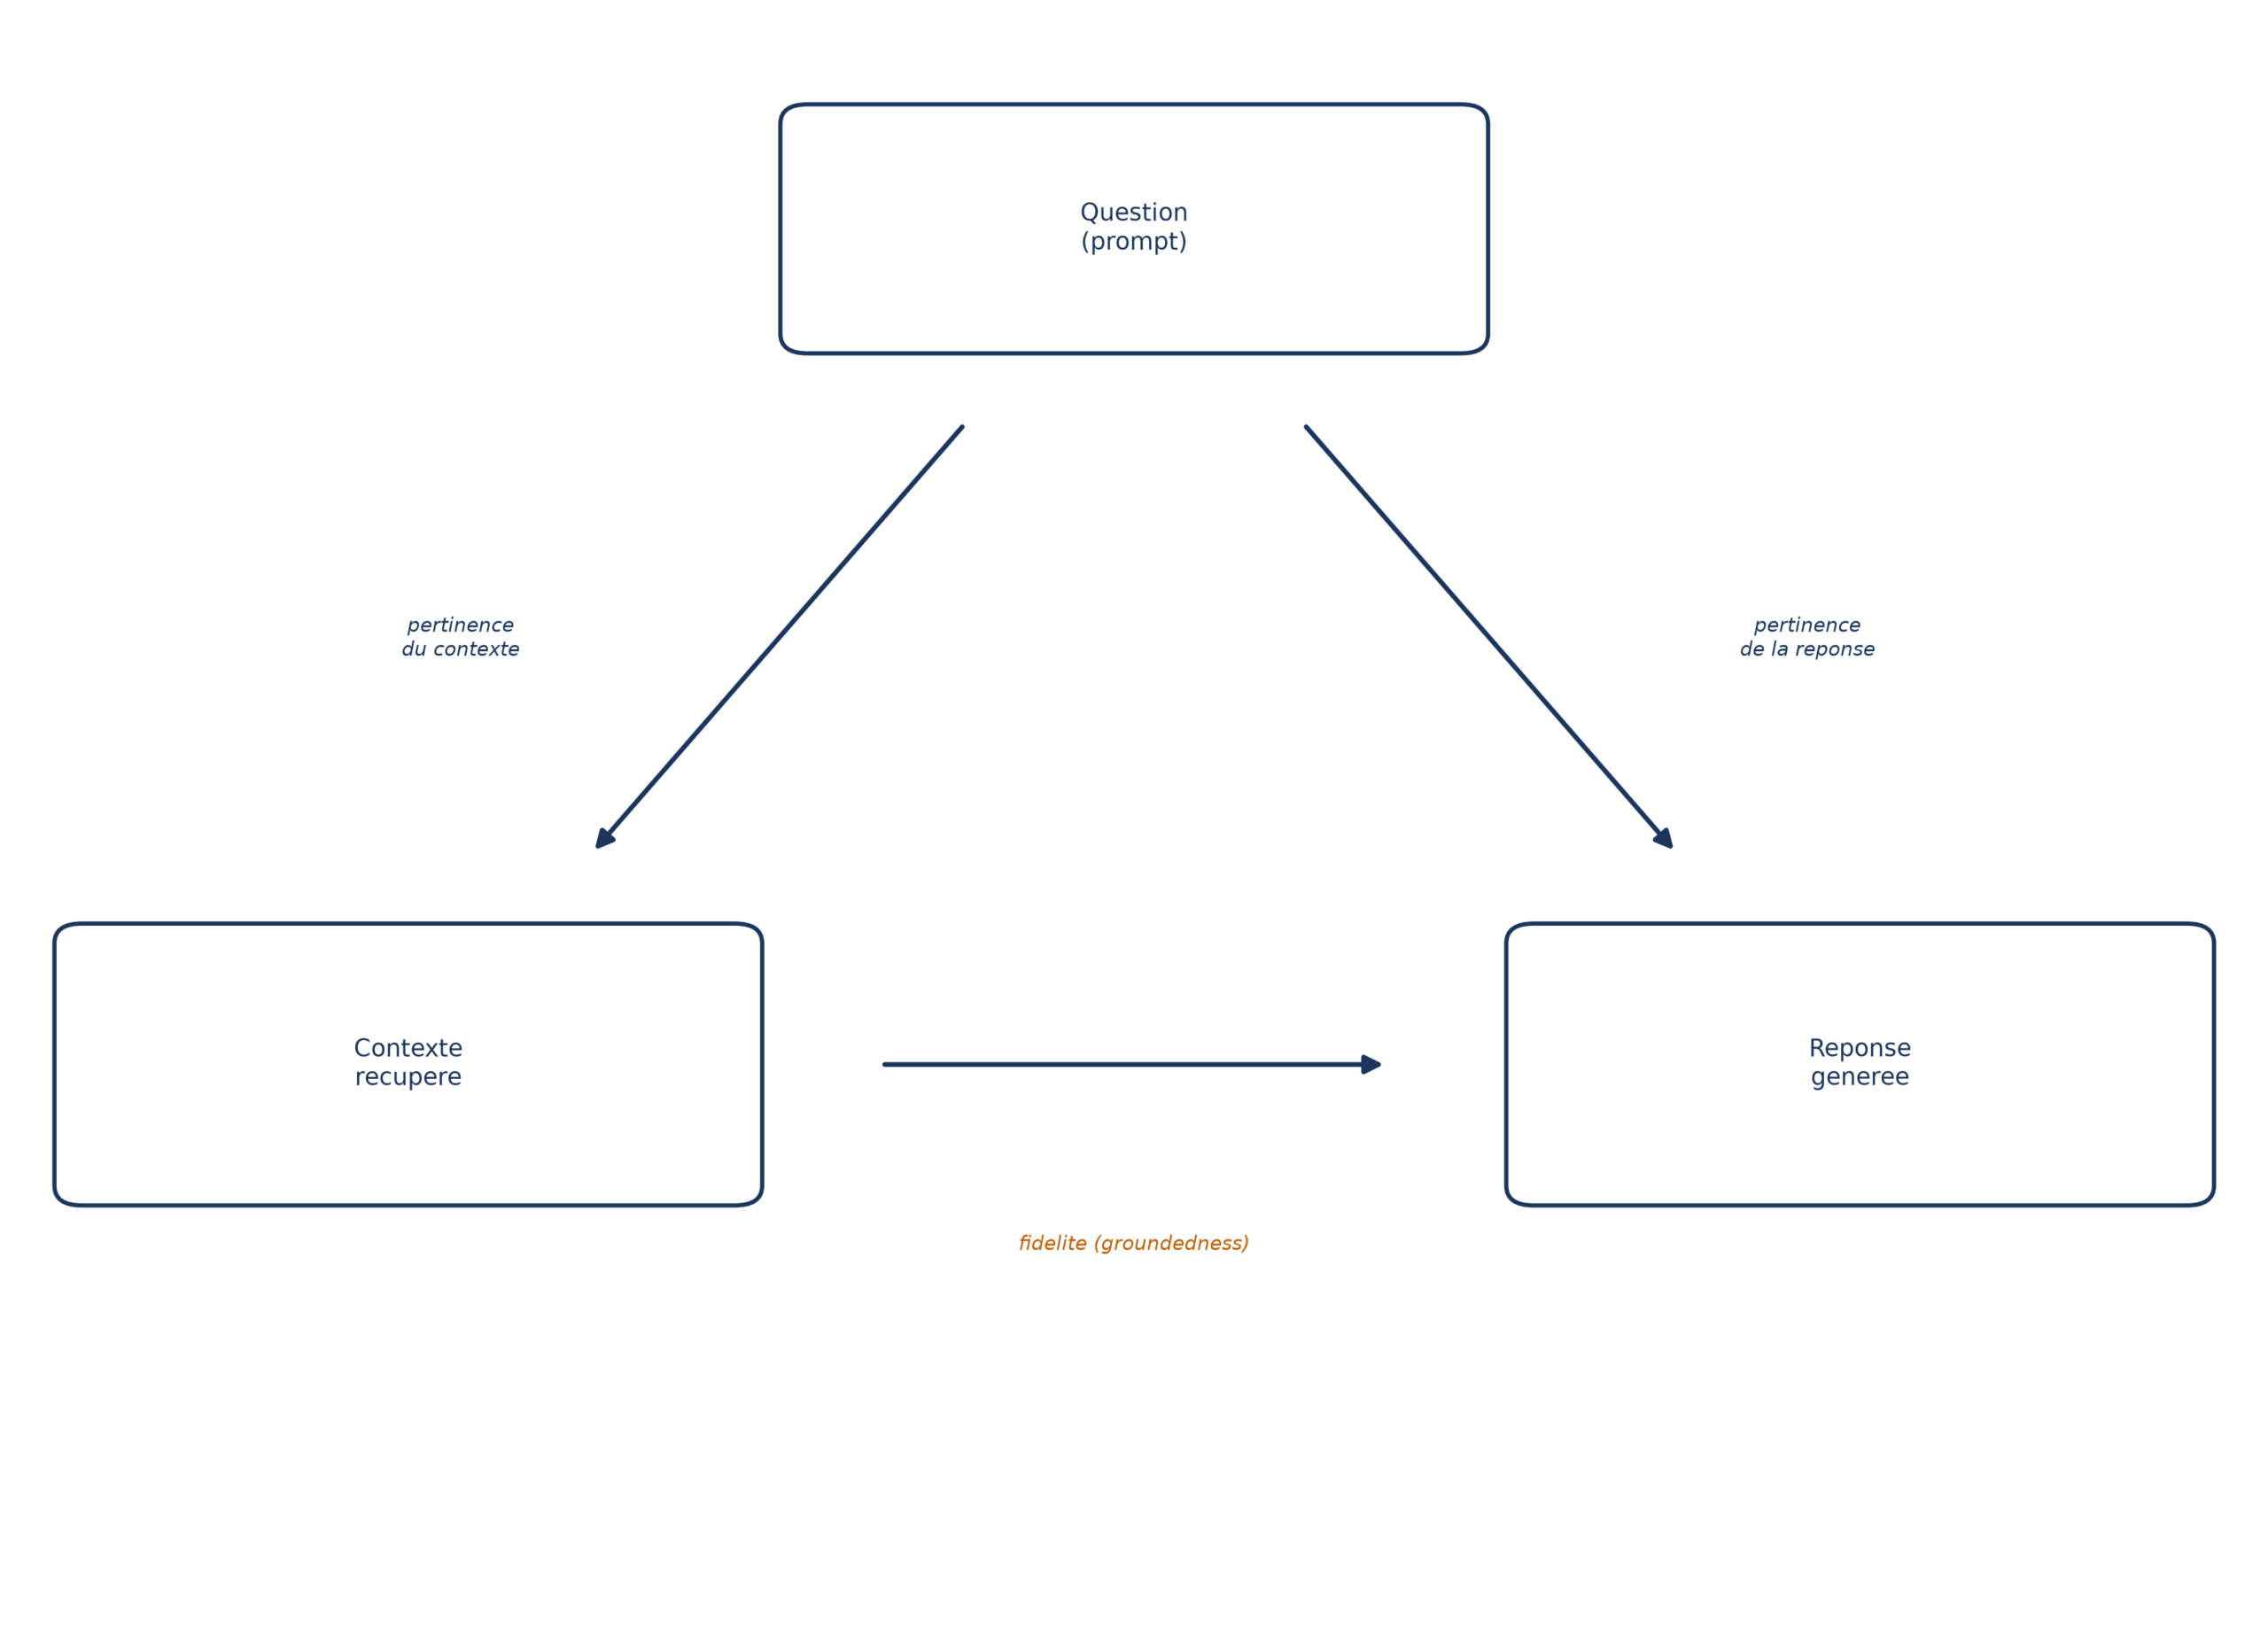
Le framework RAGAs calcule la fidélité en décomposant la réponse en affirmations élémentaires, puis en mesurant la proportion de ces affirmations que l’on retrouve dans le contexte récupéré. L’inverse de la fidélité est le taux d’hallucination. En pratique, pour chaque affirmation, on demande au LLM si elle peut être déduite du contexte.
dataset_to_eval, la liste des questions, réponses générées, contextes récupérés et réponses de référence obtenue en faisant tourner le pipeline sur chaque question de test) et applique plusieurs métriques dont Faithfulness.from ragas import EvaluationDataset, evaluate
from ragas.metrics import (
LLMContextRecall,
Faithfulness,
FactualCorrectness,
AnswerCorrectness,
ResponseRelevancy)
evaluation_dataset = EvaluationDataset.from_list(dataset_to_eval)
evaluator_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o-mini"))
result = evaluate(
dataset=evaluation_dataset,
metrics=[LLMContextRecall(), Faithfulness(), AnswerCorrectness(),
ResponseRelevancy(), FactualCorrectness()],
llm=evaluator_llm)
Le juge est ici un LLM, evaluator_llm, enveloppé par LangChain. Retiens que c’est un second modèle qui note le premier.
Que donne ce type de mesure en pratique ? Sur un benchmark d’agent interrogeant un graphe de connaissances, le résumé donne une exactitude de réponse de 0,7774, un rappel de contexte de 0,7941 et une fidélité de 0,9657.
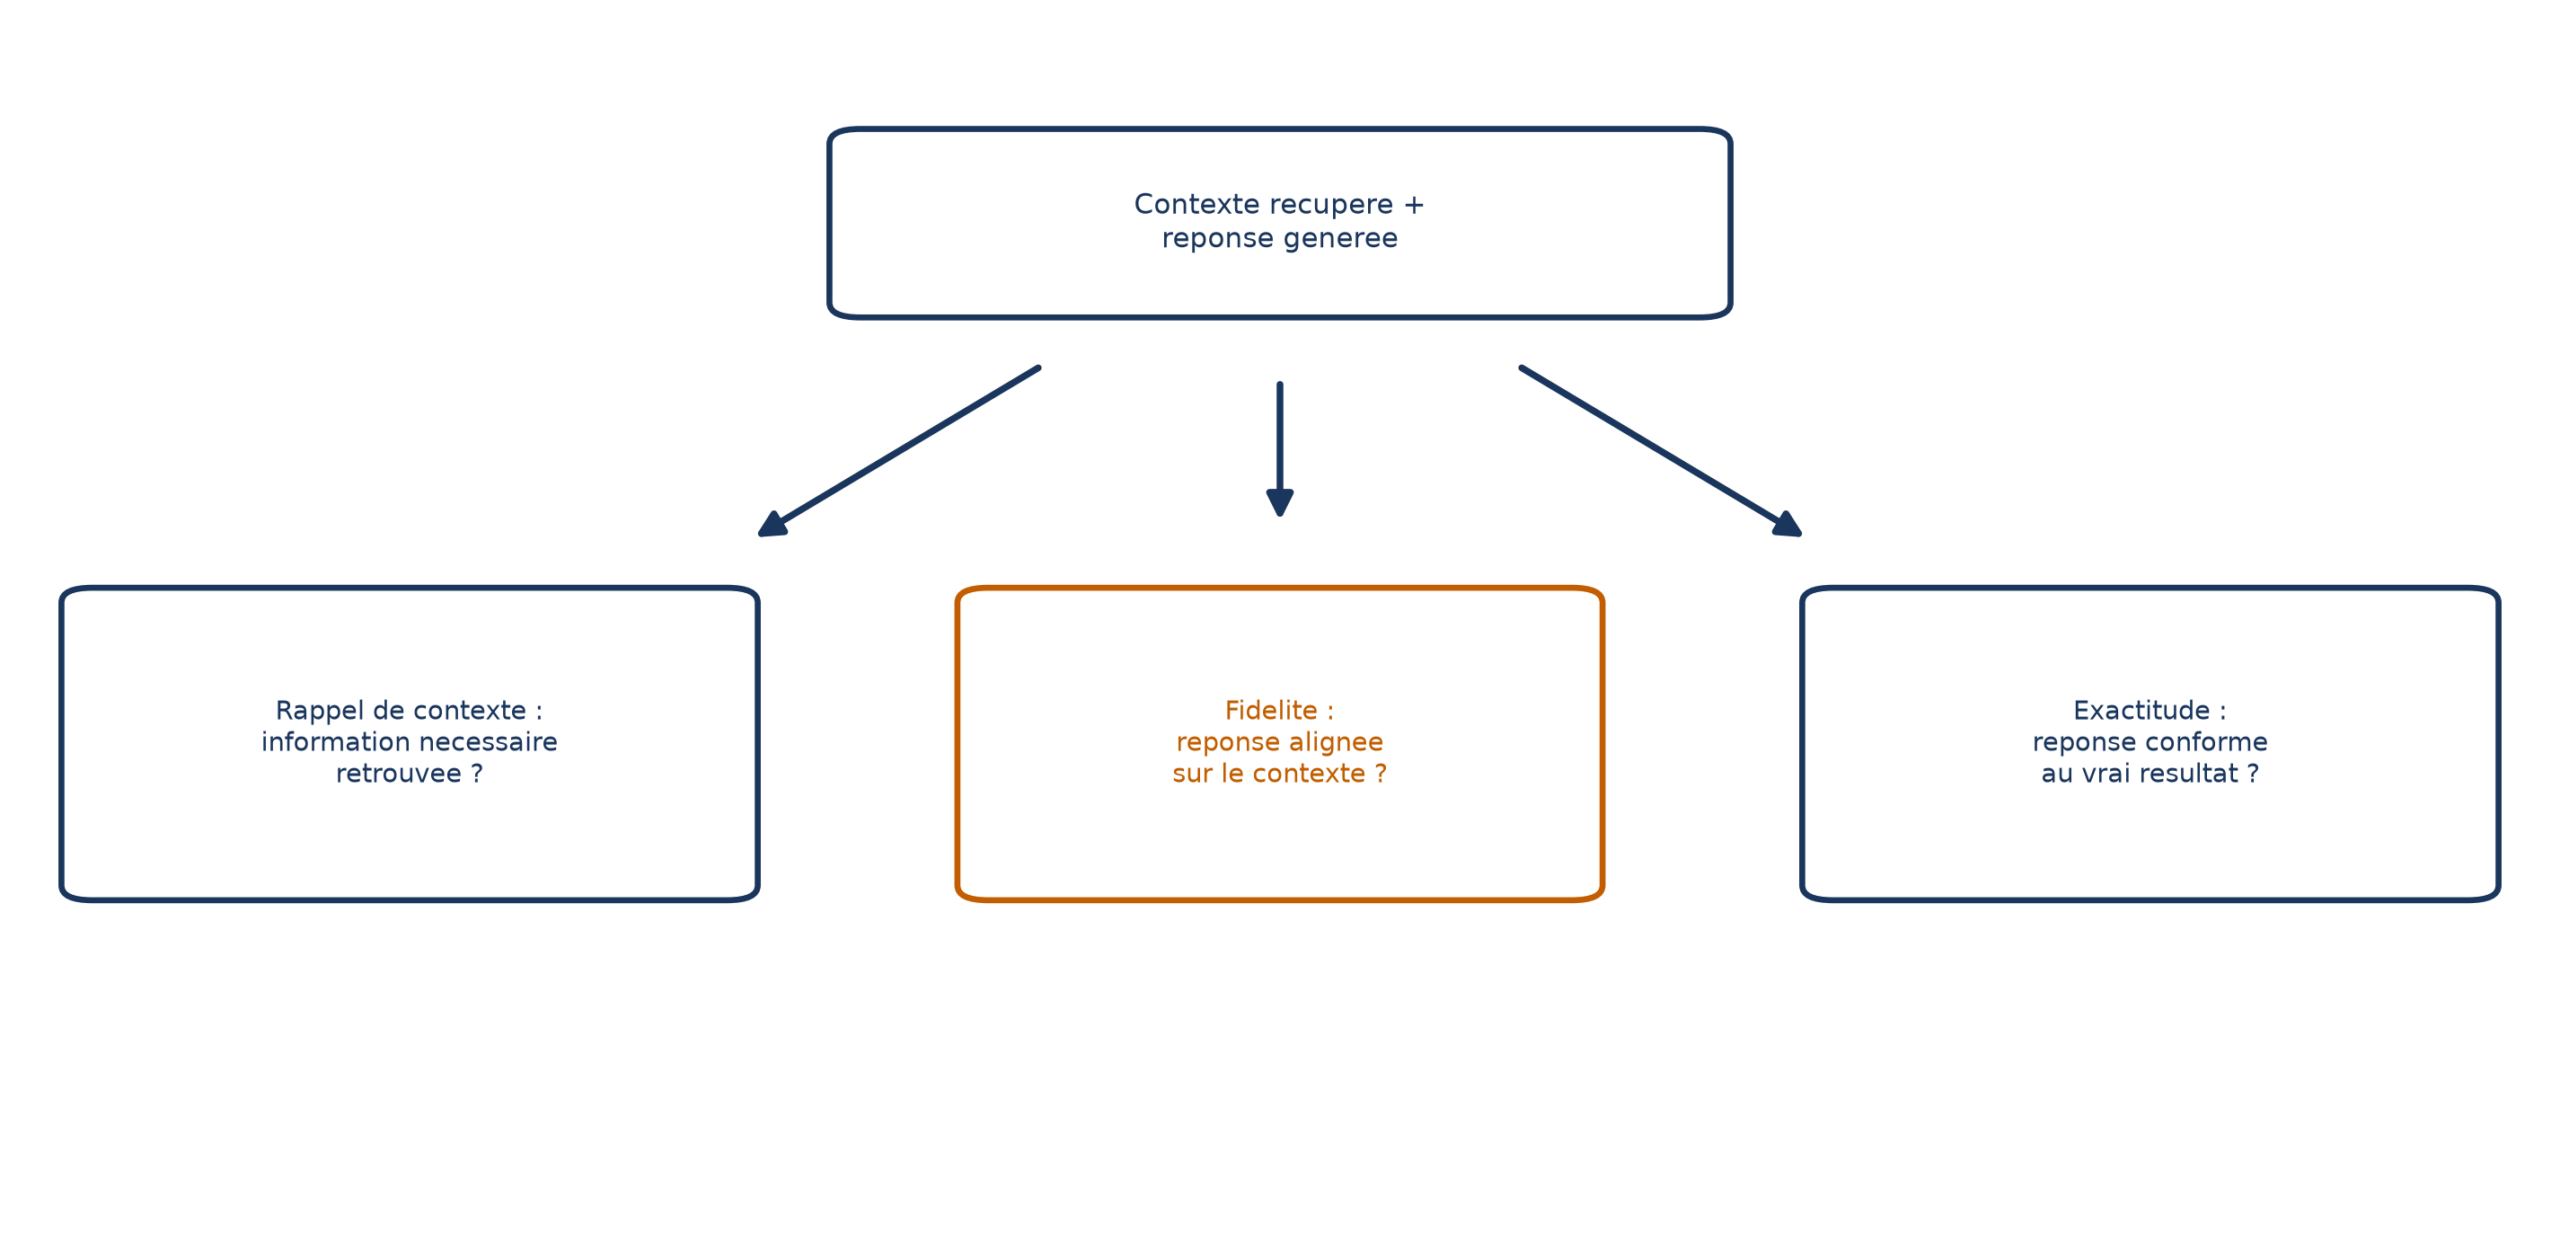
Lis ces trois chiffres ensemble. La fidélité est excellente : le modèle invente rarement et reste fidèle au contexte. Mais l’exactitude tourne autour de 0,78, donc le modèle se trompe encore dans près d’un quart des cas, et le rappel de contexte de 0,79 indique que la récupération ne capture pas toujours toute l’information nécessaire.
💡 Intuition Un modèle peut être irréprochable dans sa lecture et pourtant se tromper, tout simplement parce qu’on ne lui a pas donné tout ce qu’il fallait. Ce diagnostic revient au premier verrou : améliorer la récupération.
C’est une bonne nouvelle pour le diagnostic. Évaluer si le LLM produit la bonne réponse quand on lui donne le bon contexte permet de mesurer séparément ses capacités de raisonnement et de synthèse de celles de la récupération.
Pièges et limites
Le premier piège est de confondre fidélité et justesse. Une forte pertinence du contexte améliore généralement la fidélité, mais une forte fidélité ne garantit pas une forte pertinence de la réponse : un système peut reproduire fidèlement le contexte récupéré sans répondre directement à la question posée.
Deuxième piège : le juge lui-même. Sa fiabilité dépend de la qualité du LLM utilisé comme juge, et il est recommandé d’utiliser un juge différent du LLM de génération, pour éviter un biais d’auto-référence. Sur le benchmark cité plus haut, le juge étant un LLM, certains scores peuvent même paraître incohérents, par exemple sur la simple entrée « Hello ».
Troisième piège : le coût. Chaque technique avancée introduit un surcoût de calcul, de latence ou de stockage qu’il faut mettre en balance avec le gain attendu. CRAG ajoute de la latence ; Self-RAG demande davantage de calcul et un réglage fin des seuils.
Quatrième piège : croire qu’un agent élimine le problème. Aucun agent n’est fiable à 100 % ; les systèmes multi-agents cumulent les taux d’erreur, et une autonomie de décision accrue peut produire des actions non désirées si des garde-fous explicites manquent.
Enfin, les métriques ne remplacent pas le jugement humain. Il est conseillé d’échantillonner régulièrement les jugements du LLM évaluateur, de compléter les métriques génériques par des critères métier, et de préférer un benchmark adapté à son domaine plutôt qu’une confiance aveugle dans un score générique.
Aller plus loin
- Fidélité et pertinence du contexte : les deux mesures qui disent si l’erreur vient de la lecture ou de la recherche.
- Re-classement : réordonner les passages récupérés pour que les plus utiles passent en premier, y compris avec des services spécialisés comme Cohere Rerank.
- RAG agentique : confier à des agents le choix de la source à interroger et la décision de relancer une récupération quand l’information ne suffit pas.
- Fenêtre de contexte : le budget de jetons dans lequel tout doit tenir, et qui impose de choisir ce que l’on transmet au modèle.
- RAGAs : le framework qui automatise le calcul des métriques et peut générer un jeu de test synthétique à partir de la base de connaissances.
Questions fréquentes
Faut-il simplement écrire « ne réponds que d’après le contexte » dans le prompt ?
C’est nécessaire, pas suffisant. Cette consigne, associée au « Je ne sais pas » de secours, réduit le risque quand la recherche ne trouve rien de pertinent, mais le modèle peut toujours ignorer le contexte malgré tout.
Un contexte plus long limite-t-il les hallucinations ?
Pas forcément. Un contexte non pertinent ou mal structuré distrait le modèle, et l’information placée au milieu d’un long prompt est moins bien exploitée.
Comment savoir si l’erreur vient de la recherche ou de la lecture ?
Compare le rappel de contexte, qui mesure si l’information nécessaire a été retrouvée, et la fidélité, qui mesure si la réponse est alignée sur le contexte. Un rappel plus faible qu’une fidélité élevée pointe vers la récupération.
À retenir
- L’erreur de lecture d’un agent a trois origines distinctes : mauvais passages, contexte ignoré, contexte mal exploité. Traite-les séparément.
- Sers-lui d’abord le bon texte : fragments bien calibrés, filtres, question reformulée, re-classement.
- Ensuite, enferme sa réponse dans le contexte fourni, et donne-lui une sortie honnête quand ce contexte ne suffit pas.
- Fais relire la réponse avant de la livrer : une critique finale, ou un évaluateur de documents comme dans CRAG.
- Mesure la fidélité, mais lis-la à côté du rappel de contexte et de l’exactitude : une réponse fidèle peut rester fausse.