« Quand Einstein a-t-il obtenu le brevet de son modèle de blouse ? » Pose cette question telle quelle à un moteur de recherche qui compare des textes, et tu lui demandes de repérer un passage qui ressemble à une phrase très pointue. Il existe une astuce plus maline : avant de chercher, on fait reformuler la question en plus large, et c’est cette version-là qui part à la recherche. À la fin de cette lecture, tu sauras ce que fait le step-back prompting, comment on le fabrique en quelques lignes et ce qu’il ne fait pas.
Sommaire
- L’essentiel en 30 secondes
- Reculer d’un pas : le principe en une image
- Dans le moteur : un prompt, deux exemples, un appel
- Du début à la fin avec la blouse d’Einstein
- Chercher avec la question large, avec les deux, ou autrement
- À côté des autres façons de retoucher une question
- Trois idées reçues sur le step-back
L’essentiel en 30 secondes
- Le step-back prompting demande à un LLM de remplacer la question par une plus large avant la recherche, pour ne pas se laisser piéger par les détails.
- Le recul se fabrique avec un prompt et deux exemples, en un seul appel au modèle.
- La question large sert à chercher, pas à répondre : la réponse finale porte toujours sur la question d’origine.
- Sur l’exemple d’Einstein, ce détour a permis de retrouver le bon document parent, d’où la date du 27 octobre 1936.
- C’est une retouche de question parmi d’autres (décomposition, réécriture, HyDE) : il élargit là où les autres découpent.
Reculer d’un pas : le principe en une image
Le step-back prompting (littéralement « prompt qui fait un pas en arrière ») s’appuie sur un LLM pour générer, à partir de ta question, une requête de portée plus large, qui correspond à un contexte de haut niveau. L’idée imite un réflexe humain : devant une tâche difficile, on prend du recul et on abstrait pour retrouver les principes généraux.
Pourquoi ça aide une recherche ? Une question qui cite une date, un nom précis, un détail minuscule se rapproche mal des documents qui parlent du sujet en général. Une requête plus large couvre un éventail d’informations plus complet, et la recherche vectorielle (celle qui compare des textes par leur sens) a moins de peine à identifier les faits pertinents.
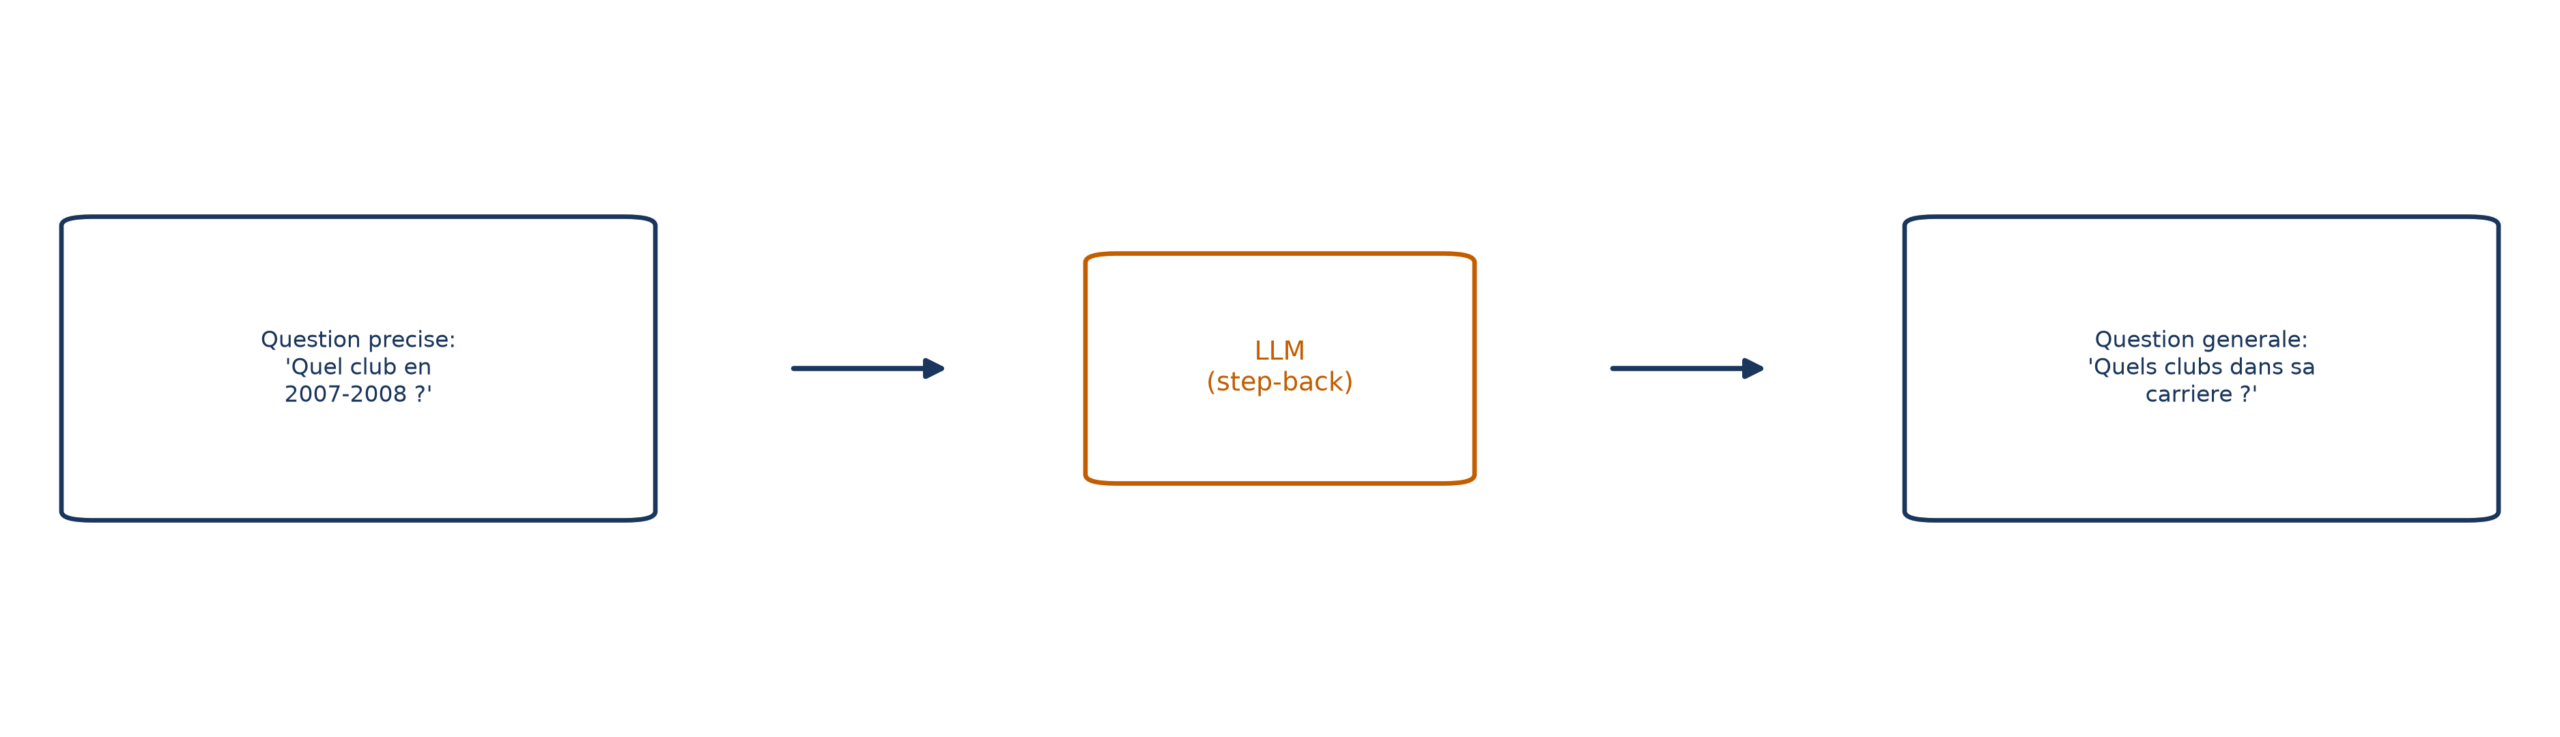
💡 Intuition Pense à une encyclopédie : plutôt que de fouiller l’index à la recherche d’une phrase exacte, tu cherches d’abord la fiche de la personne, puis tu lis jusqu’au détail qui t’intéresse. Le step-back prompting fait cette première démarche à ta place.
Dans le moteur : un prompt, deux exemples, un appel
Qui écrit la question large ? Un LLM, guidé par un prompt système. Ce prompt commence par une instruction simple (« reformule cette question en une version plus générique et plus facile à répondre »), puis il l’enrichit de quelques exemples. Fournir des exemples dans le prompt s’appelle le few-shot prompting ; sans exemple, on parle de zero-shot.
Voici le message système de la technique. Ce que tu vas observer : une consigne en une phrase, puis deux paires entrée-sortie, qui montrent au modèle le genre de recul attendu.
stepback_system_message = f"""
You are an expert at world knowledge. Your task is to step back
and paraphrase a question to a more generic step-back question, which
is easier to answer. Here are a few examples

"input": "Could the members of The Police perform lawful arrests?"
"output": "what can the members of The Police do?"
"input": "Jan Sindel's was born in what country?"
"output": "what is Jan Sindel's personal history?"
"""
Regarde la forme des deux exemples. Dans les deux cas, une question étroite (le droit d’arrêter quelqu’un, le pays de naissance) devient une question sur l’ensemble du sujet : ce que peuvent faire les membres de The Police, l’histoire personnelle de Jan Sindel. C’est ce déplacement que le modèle apprend à reproduire sur ta question.
L’appel lui-même tient en quelques lignes. chat est la fonction qui interroge un modèle de conversation, question est celle de l’utilisateur, et le résultat est la question reformulée.
def generate_stepback(question: str):
    user_message = f"""{question}"""
    step_back_question = chat(
        messages=[
            {"role": "system", "content": stepback_system_message},
            {"role": "user", "content": user_message},
        ]
    )
    return step_back_question
La fonction envoie deux messages : le message système défini plus haut, puis ta question dans le rôle de l’utilisateur. Rien d’autre : pas d’entraînement, pas de nouveau modèle.
Du début à la fin avec la blouse d’Einstein
Reprenons la question de départ sur le modèle de blouse. La base de connaissances contient un long texte consacré à Einstein, découpé en gros blocs eux-mêmes découpés en petits fragments : la recherche compare la question aux petits fragments, mais renvoie le bloc entier dont ils sont issus. Les deux fonctions ci-dessous mettent bout à bout recul, recherche et réponse.
def generate_answer(question: str, documents: List[str]) -> str:
    user_message = f"""
    Use the following documents to answer the question that will follow:
    {documents}
    ---
    The question to answer using information only from the above
documents: {question}
    """
    result = chat(
        messages=[
            {"role": "system", "content": system_message},
            {"role": "user", "content": user_message},
        ]
    )
    print("Response:", result)

def rag_pipeline(question: str) -> str:
    stepback_prompt = generate_stepback(question)
    print(f"Stepback prompt: {stepback_prompt}")
    documents = parent_retrieval(stepback_prompt)
    answer = generate_answer(question, documents)
    return answer
Dans generate_answer, documents est la liste des textes retrouvés et system_message la consigne système du modèle qui rédige la réponse, posée avant l’appel. La partie qui compte est rag_pipeline, en quatre lignes : on fabrique la question large, on la donne à parent_retrieval (la fonction qui calcule l’embedding de la question, sa représentation sous forme de nombres, et renvoie les textes les plus proches), puis on répond. Remarque quelle question est transmise à chaque étape.
La recherche reçoit stepback_prompt, la question large. Mais generate_answer reçoit question, la question d’origine, intacte. Le pipeline cherche large et répond précis, et c’est tout l’intérêt du dispositif.
Sur « When was Einstein granted the patent for his blouse design ? », la reformulation produit « What are some notable achievements in Einstein’s life ? ». Le pipeline répond alors correctement : « Einstein was granted the patent for his blouse design on October 27, 1936. » La question plus générale a retrouvé le bon document parent, qui contenait tout le contexte nécessaire pour répondre à la question initiale, bien plus spécifique : le 27 octobre 1936 n’a pas eu besoin d’être mentionné dans la recherche pour être trouvé.
Chercher avec la question large, avec les deux, ou autrement
Le pipeline précédent cherche avec la seule question large. Ce n’est pas la seule façon de s’en servir. Dans une autre version, on calcule l’embedding de la requête de haut niveau et celui de la requête de l’utilisateur, on lance les deux recherches, et les deux contextes trouvés sont donnés au LLM pour la génération.
Imagine deux filets. Le premier, large, ramène les passages qui parlent du sujet ; le second, étroit, ramène ceux qui ressemblent à la question mot pour mot. Le modèle de réponse reçoit alors les deux prises. Ce qui change d’une version à l’autre, c’est ce qui atterrit sous les yeux du modèle, pas le principe du recul.
Dans les deux cas, la phase de recul vient avant tout le reste. Dans une chaîne avancée de recherche, elle occupe la première étape, celle qui précède la récupération.
À côté des autres façons de retoucher une question
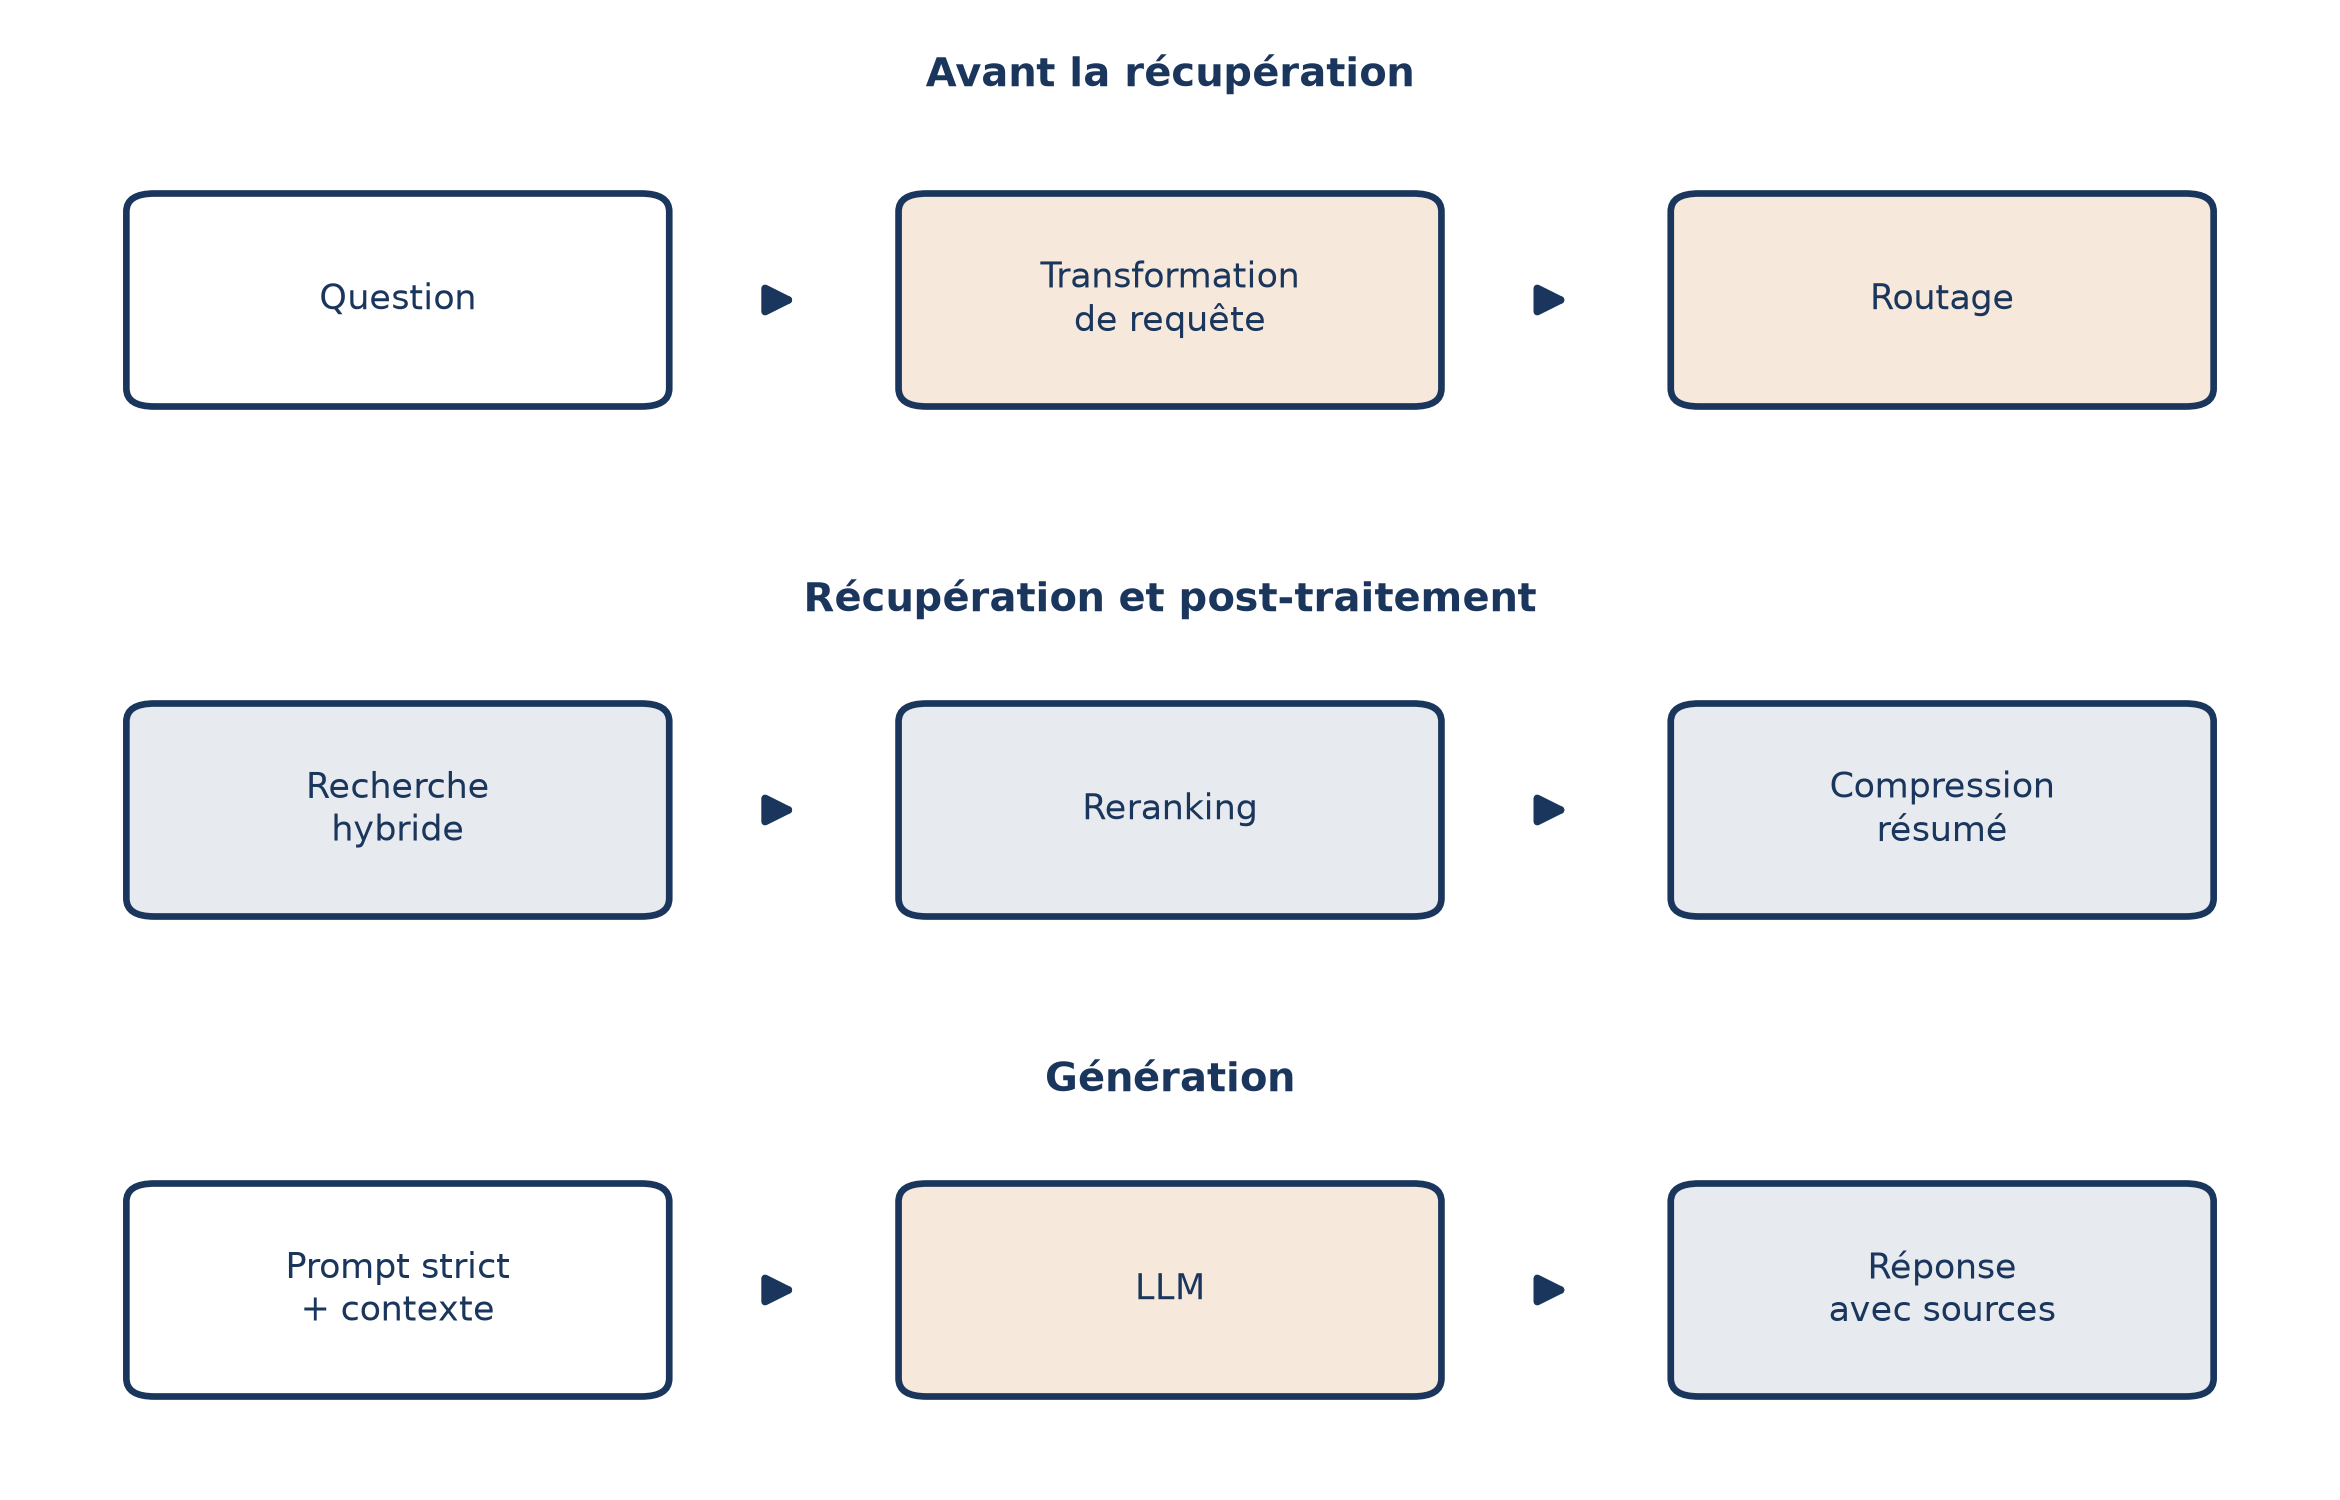
Le step-back n’est pas la seule retouche possible : toutes s’appuient sur un LLM pour améliorer la récupération, mais chacune fait autre chose de la question.
| Retouche | Ce qu’on fait de la question | Exemple donné |
|---|---|---|
| Step-back | La remplacer par une version plus générale, conceptuelle | « achievements in Einstein’s life » à la place du brevet de la blouse |
| Décomposition | La couper en plusieurs requêtes indépendantes | « qui a inventé le télégraphe et le téléphone ? » devient deux requêtes |
| Réécriture | Transformer un énoncé quelconque en requête de recherche | Une plainte sur l’envoi de courriels depuis un téléphone devient une recherche d’étapes de dépannage |
| HyDE | Faire générer une réponse hypothétique, sans consulter la base, et chercher avec elle | La réponse inventée sert d’appât, même si le modèle ne connaît pas la vraie |
| Expansion multi-requêtes | Faire générer plusieurs variantes de la question | Cinq reformulations lancées chacune dans la base |
La différence la plus utile à retenir se joue avec l’expansion : elle accroît le rappel, c’est-à-dire la part des documents pertinents effectivement retrouvés, mais en multipliant les formulations, elle risque de s’éloigner de ce que tu voulais demander, et la précision en pâtit. Le step-back, lui, ne multiplie pas les variantes : il en choisit une seule, plus haute.
Trois idées reçues sur le step-back
« C’est du chain-of-thought »
Non. Le chain-of-thought fournit dans le prompt un triplet entrée, chaîne de pensée, sortie : les étapes intermédiaires servent à découper la tâche de raisonnement en étapes plus gérables. Dans le pipeline vu plus haut, la sortie du recul est une seule question, et elle travaille en amont de la recherche. Les deux techniques peuvent coexister, mais elles n’agissent pas au même endroit.
« La question large remplace la vraie question »
Pas dans le pipeline vu plus haut : la réponse est rédigée à partir de la question d’origine, et la question large n’est qu’un outil de recherche. Dans la variante à deux recherches, les deux requêtes restent même présentes jusqu’à la génération. Le recul prépare le terrain, il ne réécrit pas ce qu’on demande au modèle de répondre.
« Plus c’est large, mieux c’est »
⚠️ Piège La question large t’amène au bon endroit, elle ne fournit pas le détail. Dans l’exemple d’Einstein, le détail est arrivé parce que le bloc renvoyé contenait tout le contexte nécessaire pour répondre à la question précise.
Un recul trop ample pourrait donc ramener le bon sujet mais pas la bonne ligne : la précision vient de ce que tu rends au modèle de réponse, pas seulement de la façon de chercher. C’est pour cela que l’exemple associe le recul à une récupération qui renvoie un bloc assez grand.
📌 À retenir Le step-back prompting ne rend pas le modèle plus malin : il rend la recherche plus tolérante. Une question pointue décide de la réponse, une question large décide de l’endroit où on va la chercher.