Ton assistant répond correctement à « Qui a gagné la Coupe du monde de cricket 2023 ? » en s’appuyant sur une page Wikipédia. Bravo. Mais sur la millième question, sans personne pour relire, comment sais-tu qu’il ne ment pas ? Un système RAG se juge sur des chiffres, pas sur une impression de démonstration. RAGAS est la boîte à outils qui te les donne, et à la fin de cet article tu sauras générer un jeu de test, lancer l’évaluation et lire les scores sans te tromper.
L’essentiel en 30 secondes
- RAGAS est un cadre d’évaluation conçu pour les systèmes RAG : il calcule des métriques de qualité à partir de la question, du contexte récupéré, de la réponse générée et d’une réponse de référence.
- Il peut fabriquer lui-même un jeu de test à partir de tes documents, sans annotation humaine massive.
- Chaque métrique repose sur un LLM qui joue le juge : décomposer la réponse en affirmations, vérifier chacune, compter la proportion de bonnes.
- Trois scores se lisent ensemble : le contexte récupéré est-il utile, la réponse est-elle fidèle à ce contexte, répond-elle à la question ?
- Le juge n’est pas infaillible : choisis-le différent du modèle qui génère et complète les chiffres par un regard humain.
L’intuition : trois relations à surveiller
Quand un RAG se trompe, le coupable n’est pas toujours le même. Soit la récupération a raté l’information utile ou ramené du hors-sujet ; soit le LLM a ignoré le contexte qu’on lui donnait ; soit il s’est laissé distraire par un passage sans rapport avec la question.
Ces trois pannes correspondent à trois relations dans le système. Entre la question et le contexte récupéré, on regarde la pertinence du contexte : l’information ramenée est-elle bien celle qu’il fallait ? Entre le contexte et la réponse, on regarde la fidélité (faithfulness, aussi appelée groundedness) : la réponse s’appuie-t-elle vraiment sur ce qui a été récupéré ? Entre la réponse et la question, on regarde la pertinence de la réponse : répond-elle à ce qui était demandé ?
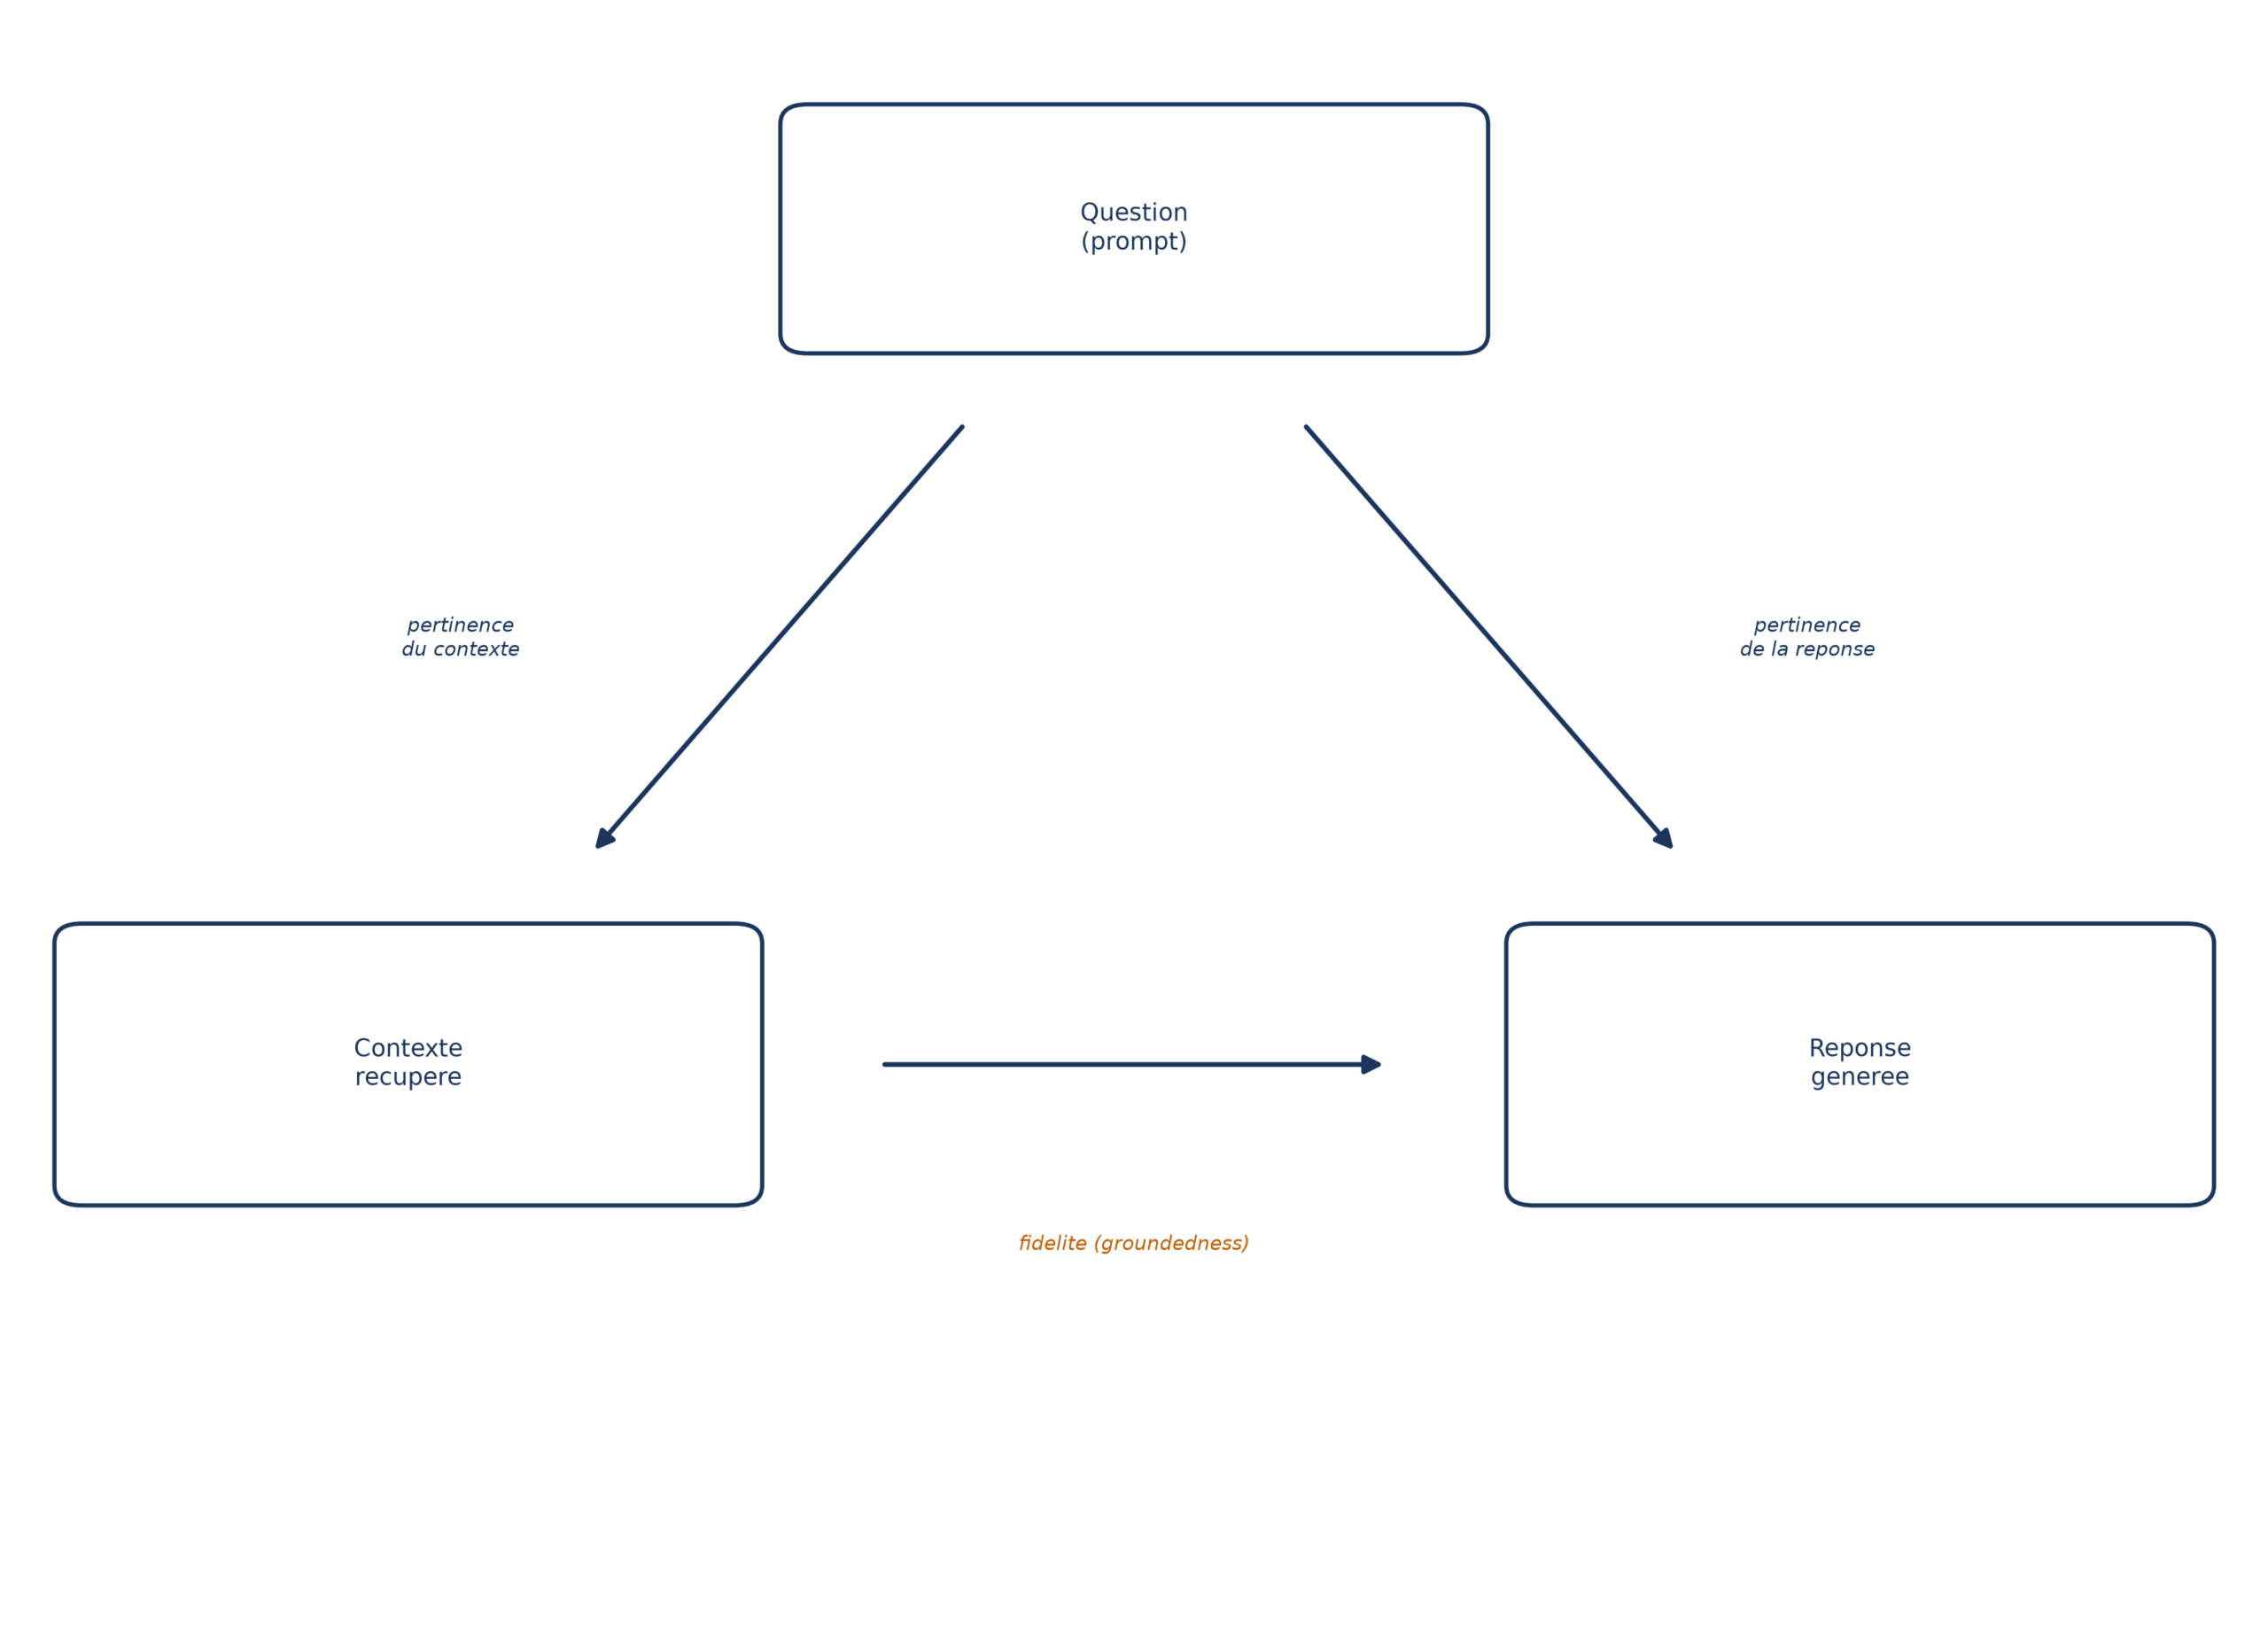
💡 Intuition Ces scores ne se remplacent pas. Une forte pertinence du contexte améliore en général la fidélité, mais une forte fidélité ne garantit pas que la réponse traite la question : un système peut recopier fidèlement son contexte sans jamais répondre directement.
Sous le capot : comment RAGAS calcule ses scores
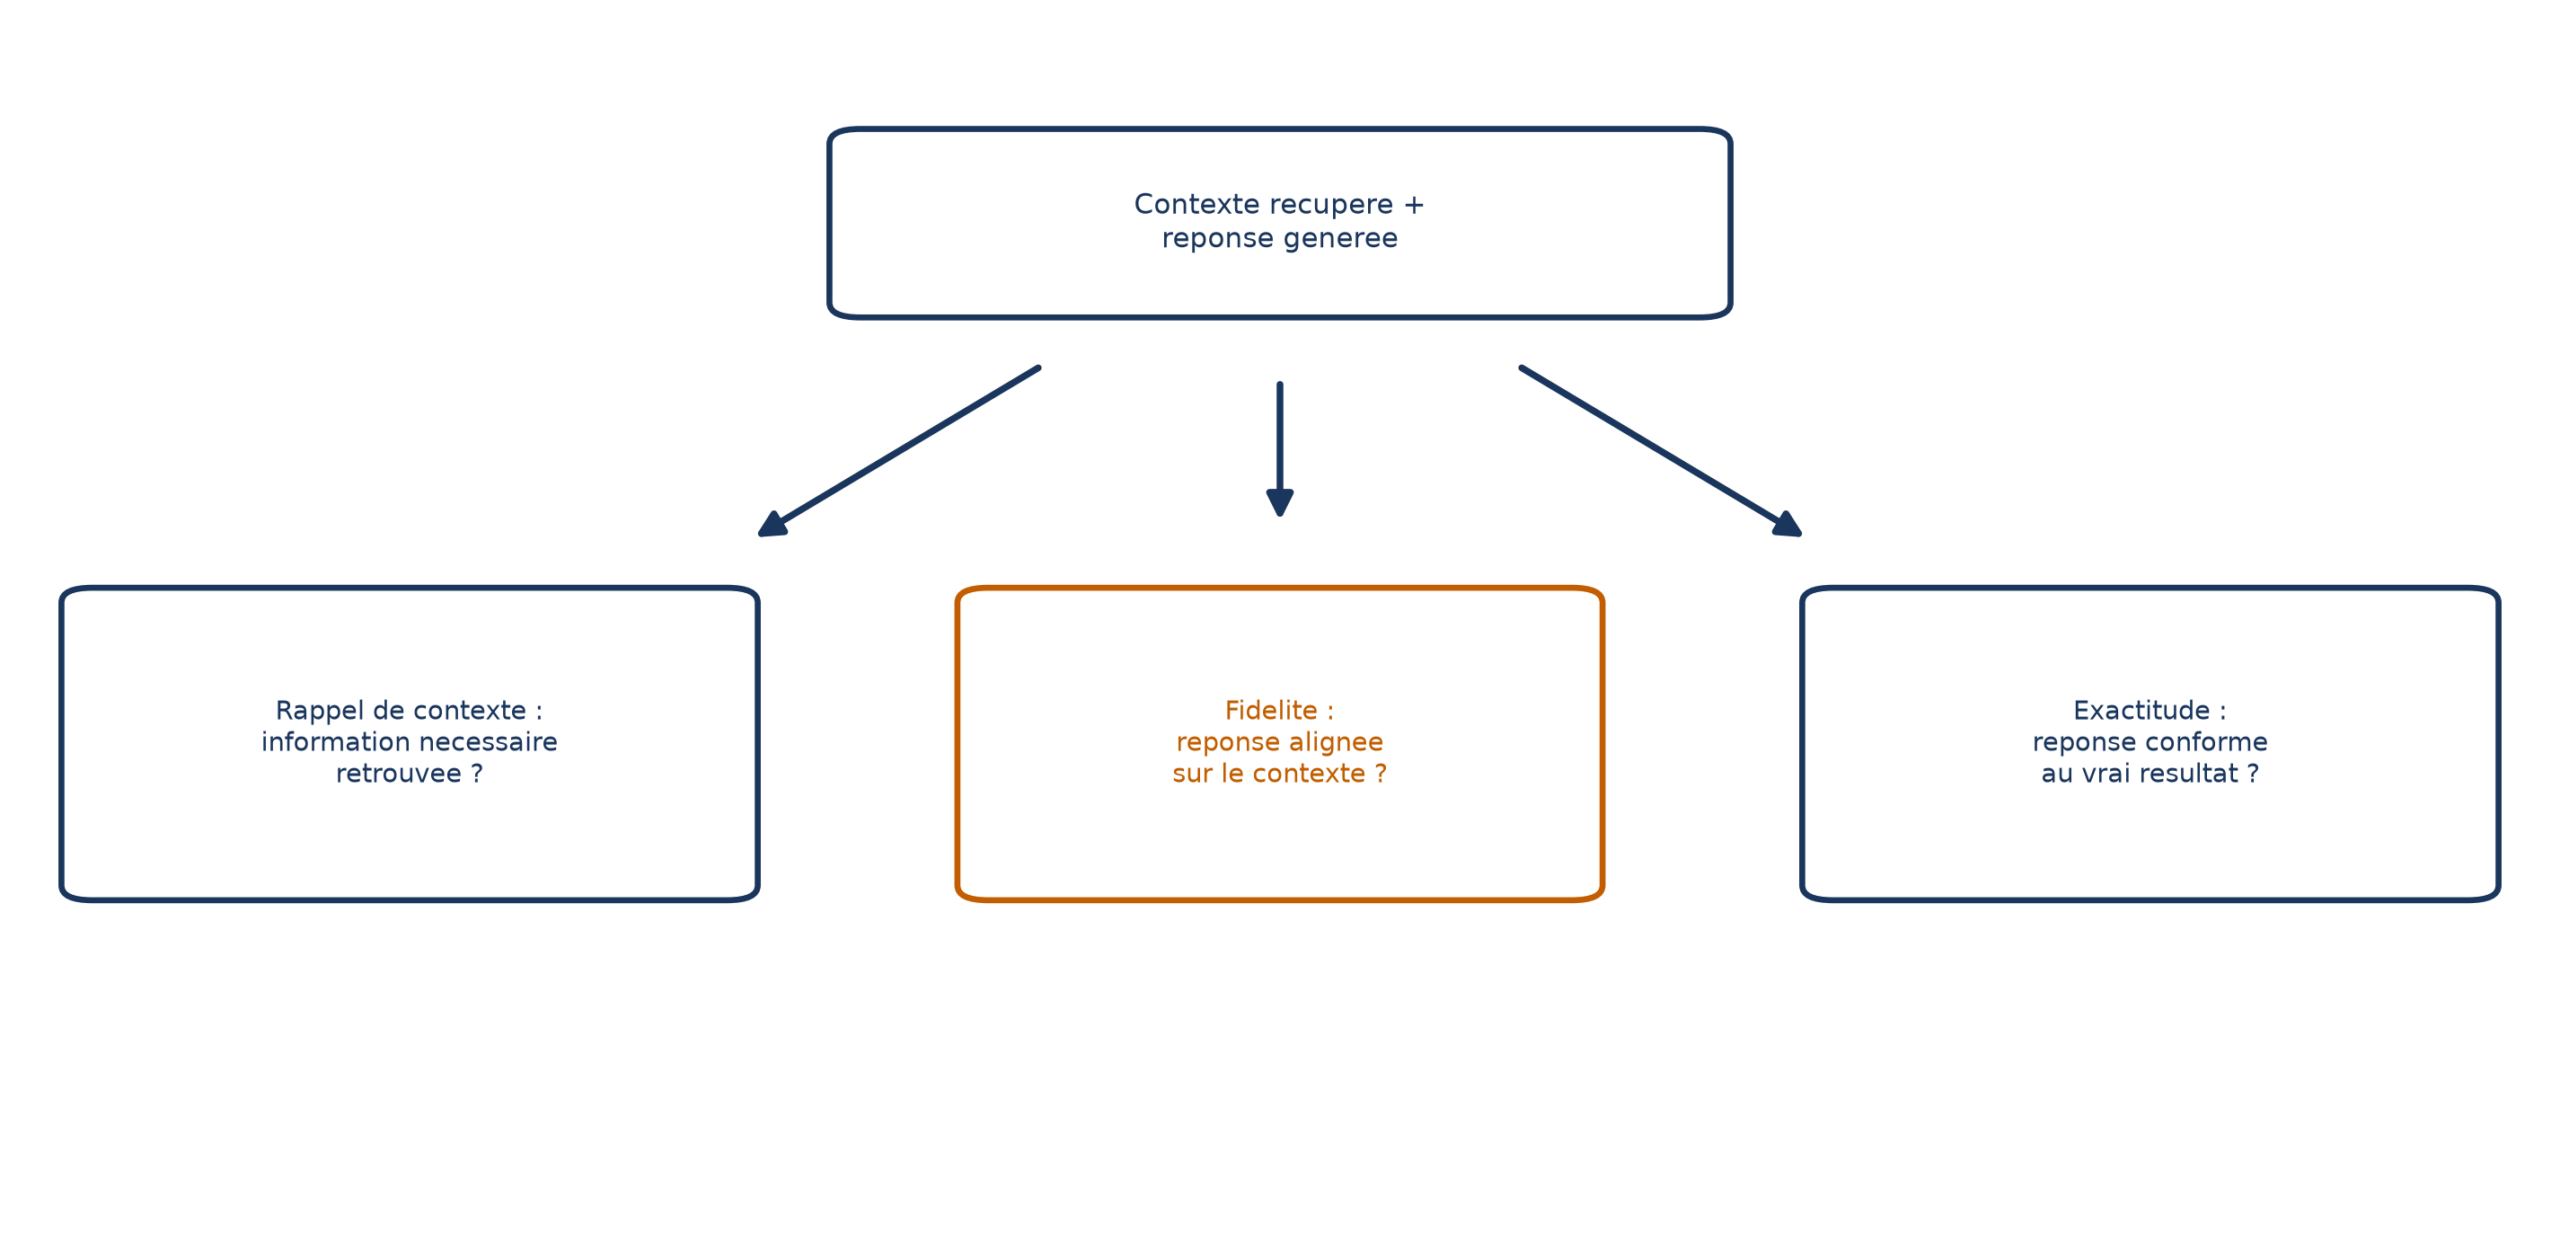
RAGAS ne compare jamais deux textes avec une règle mécanique. Il confie le jugement à un LLM, guidé par des consignes précises. Le principe est toujours le même : découper, vérifier, compter. Voici les métriques que tu croiseras.
Fidélité : la réponse invente-t-elle quelque chose ?
RAGAS commence par décomposer la réponse en affirmations atomiques, sans pronoms, pour qu’on puisse les vérifier une à une. Le LLM juge ensuite, pour chacune, si elle peut être directement déduite du contexte, avec un verdict binaire. La fidélité est la proportion d’affirmations jugées fidèles, et son inverse est le taux d’hallucination.
Rappel de contexte : a-t-on tout retrouvé ?
Cette métrique mesure combien d’informations pertinentes ont réellement été récupérées. Un score élevé indique que la récupération capte bien tout le contexte nécessaire pour répondre. Le prompt d’évaluation examine chaque phrase et la classe 0 ou 1 selon qu’elle peut être rattachée au contexte fourni.
Exactitude de la réponse : est-elle juste et complète ?
Elle évalue à quel point la réponse traite précisément et complètement la question, en combinant exactitude factuelle et pertinence. Elle reprend la décomposition en affirmations, puis range chacune dans l’une de trois cases : vrai positif (présente dans la réponse et soutenue par la référence), faux positif (présente mais non soutenue), faux négatif (présente dans la référence mais absente de la réponse), avec une justification à chaque fois.
Pertinence de la réponse et pertinence du contexte
Pour la pertinence de la réponse, RAGAS demande au LLM d’inventer plusieurs questions à partir de la réponse produite, puis mesure la similarité cosinus moyenne entre ces questions et la question d’origine. L’idée : si la réponse traite bien le sujet, les questions qu’on en reconstruit doivent lui ressembler. La pertinence du contexte, elle, est la proportion de phrases du contexte récupéré réellement utiles pour répondre.
📌 Bon à savoir Une métrique voisine, la couverture, mesure la proportion des affirmations pertinentes du contexte effectivement reprises dans la réponse.
Le voir tourner : évaluer un pipeline de bout en bout
Reste à brancher tout cela sur un vrai pipeline. Notre fil conducteur reste la Coupe du monde de cricket : un pipeline RAG construit sur une page Wikipédia, que l’on évalue en trois temps. D’abord on fabrique les questions de test, ensuite on fait répondre le pipeline, enfin on note les réponses.
Étape 1 : générer le jeu de test
Écrire à la main des centaines de couples question-réponse est fastidieux. RAGAS propose donc un générateur : un premier module crée des questions « germes » à partir de tes documents, puis un module d’évolution les complexifie en versions multi-contextes, conditionnelles ou de raisonnement, avant que les réponses ne soient générées.
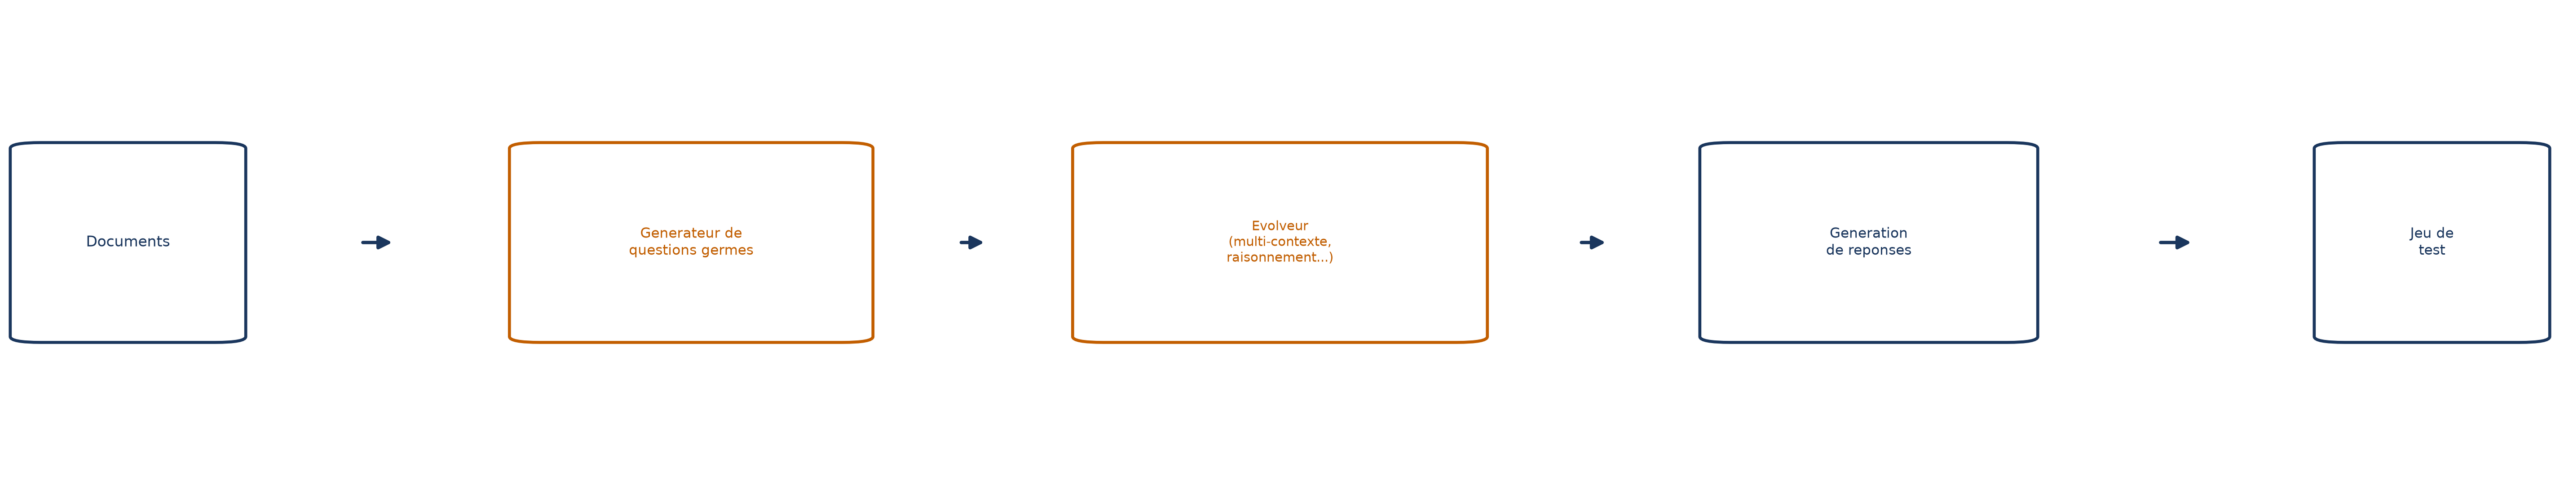
Dans le code ci-dessous, la première ligne installe la bibliothèque depuis le notebook ; html_data_transformed désigne les documents LangChain tirés de la page Wikipédia, préparés dans les étapes précédentes du pipeline. Le LLM qui écrit les questions est gpt-4o-mini, accompagné d’un modèle d’embeddings d’OpenAI.
%pip install ragas==0.2.13

from ragas.llms import LangchainLLMWrapper
from ragas.embeddings import LangchainEmbeddingsWrapper
from ragas.testset import TestsetGenerator
from langchain_openai import ChatOpenAI, OpenAIEmbeddings

generator_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o-mini"))
generator_embeddings = LangchainEmbeddingsWrapper(
    OpenAIEmbeddings(model="text-embedding-3-small")
)
generator = TestsetGenerator(
    llm=generator_llm,
    embedding_model=generator_embeddings
)
testset = generator.generate_with_langchain_docs(
    html_data_transformed,
    test_size=20,
)
Résultat : 20 questions, chacune liée au fragment de document dont elle vient et à une réponse de référence, la ground truth. Retiens les enveloppes LangchainLLMWrapper et LangchainEmbeddingsWrapper : elles adaptent des modèles LangChain pour que RAGAS puisse les appeler.
Étape 2 : faire répondre ton pipeline
Il faut maintenant exécuter ton RAG sur chaque question. Le plus simple est de l’encapsuler dans une fonction réutilisable qui renvoie à la fois le contexte récupéré et la réponse, car RAGAS a besoin des deux. Ici, elle charge un index FAISS, récupère les deux passages les plus proches, construit un prompt qui impose de répondre seulement d’après le contexte (ou de dire « I don’t know ») puis interroge le LLM.
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings, ChatOpenAI

def rag_function(query, db_path, index_name):
    embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
    db = FAISS.load_local(
        folder_path=db_path,
        index_name=index_name,
        embeddings=embeddings,
        allow_dangerous_deserialization=True
    )
    retrieved_docs = db.similarity_search(query, k=2)
    retrieved_context = [retrieved_docs[0].page_content
                          + retrieved_docs[1].page_content]
    augmented_prompt = f"""
Given the context below, answer the question.
Question: {query}
Context : {retrieved_context}
Remember to answer only based on the context
provided and not from any other source.
If the question cannot be answered based
on the provided context, say I don't know.
"""
    llm = ChatOpenAI(
        model="gpt-4o-mini",
        temperature=0,
        max_tokens=None,
        timeout=None,
        max_retries=2
    )
    response = llm.invoke([("human", augmented_prompt)])
    answer = response.content
    return retrieved_context, answer
Note le k=2 : seuls les deux passages les plus proches alimentent le prompt, ce qui a un effet direct sur le rappel de contexte que tu mesureras plus tard.
Étape 3 : assembler et noter
Tu regroupes, pour chaque question, la réponse générée, le contexte récupéré et la réponse de référence dans un EvaluationDataset. Dans le code, cette collection s’appelle dataset_to_eval, une liste construite à partir des résultats de l’étape précédente. Un second LLM, l’évaluateur, note ensuite chaque exemple sur les cinq métriques choisies.
from ragas import EvaluationDataset, evaluate
from ragas.metrics import (
    LLMContextRecall,
    Faithfulness,
    FactualCorrectness,
    AnswerCorrectness,
    ResponseRelevancy)

evaluation_dataset = EvaluationDataset.from_list(dataset_to_eval)
evaluator_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o-mini"))

result = evaluate(
    dataset=evaluation_dataset,
    metrics=[LLMContextRecall(), Faithfulness(), AnswerCorrectness(),
             ResponseRelevancy(), FactualCorrectness()],
    llm=evaluator_llm)
Tu reconnais les noms : LLMContextRecall pour le rappel de contexte, Faithfulness pour la fidélité, AnswerCorrectness et FactualCorrectness pour l’exactitude, ResponseRelevancy pour la pertinence de la réponse. Le résultat donne un score par métrique et par exemple.
Une variante sur un graphe de connaissances
Le même principe fonctionne sur un agent qui interroge une base de graphe. Là, la vérité terrain n’est pas une phrase figée : c’est une requête Cypher de référence, exécutée au moment du test, ce qui garde le benchmark valable même quand les données évoluent. Le jeu de test est lu depuis un CSV.
test_data = pd.read_csv("../data/benchmark_data.csv", delimiter=";")
Ici, test_data est ce tableau pandas ; une boucle parcourt ensuite chaque ligne : elle exécute la requête de référence, génère la réponse de l’agent, mesure la latence et enregistre le contexte récupéré. Dans ce cadre, les réponses manquantes sont remplacées par « I don’t know », car RAGAS exige des valeurs non nulles, avant de lancer l’évaluation sur trois métriques. Cette fois, elles se passent directement sous forme de fonctions (answer_correctness, context_recall, faithfulness) et le tableau est converti en Dataset, le format Hugging Face.
dataset = Dataset.from_pandas(test_data.fillna("I don't know"))

result = evaluate(
    dataset,
    metrics=[
        answer_correctness,
        context_recall,
        faithfulness,
    ],
)
Lire les résultats
Sur ce benchmark de 17 exemples, le résumé donne une exactitude de réponse de 0,7774, un rappel de contexte de 0,7941 et une fidélité de 0,9657.
Que dire de ces trois chiffres ? Avec une exactitude proche de 0,78, le modèle répond juste la plupart du temps mais se trompe encore dans près d’un quart des cas. Le rappel de 0,79 montre que la récupération fonctionne plutôt bien sans toujours ramener toute l’information utile. La fidélité, elle, est excellente : le modèle invente rarement et reste collé à son contexte.
Le diagnostic est donc clair : le générateur est sage, c’est la récupération qu’il faut améliorer. Pistes citées : enrichir la couverture de récupération, affiner la reformulation des requêtes, mieux faire correspondre les entités pour les questions ambiguës.
💡 Intuition Quand la fidélité est haute et que l’exactitude est plus basse, le LLM fait correctement son travail avec ce qu’on lui donne. Le problème se situe en amont, dans ce qu’on lui donne.
Descendre au niveau des exemples est tout aussi instructif. La latence est nettement plus basse quand la question évite text2cypher, puisqu’on économise un appel LLM. Et sur la question « Who has the longest name among all actors ? », le système échoue faute de générer la bonne requête Cypher : on pourrait y remédier avec un exemple few-shot ou un outil dédié.
Pièges et limites
⚠️ Piège Le juge est un LLM, donc sa fiabilité dépend de sa qualité. Dans l’exemple plus haut, l’évaluateur est le même modèle que celui qui génère les réponses : c’est précisément le cas d’auto-référence qu’on cherche à éviter.
Plusieurs limites méritent d’être gardées en tête :
- Un LLM juge peut se tromper. Sur l’exemple « Hello », certains scores ont paru incohérents. Il est conseillé d’échantillonner régulièrement les jugements et d’employer plusieurs LLM juges, différents du LLM de génération.
- Pas de standard. Chaque framework calcule les métriques à sa façon ; comparer plusieurs frameworks aide à relativiser un score.
- Le générique ne suffit pas. Complète par des critères propres à ton métier et par un retour humain : avis d’utilisateurs, évaluation d’experts.
- Un benchmark vieillit. Préfère un jeu adapté à ton domaine, qui continue à s’enrichir, plutôt qu’une confiance aveugle dans un score générique.
- Mesure aussi le reste. Latence, coût, biais et toxicité des réponses ne sont pas capturés par ces scores.
Aller plus loin
- ARES entraîne un classifieur au lieu d’utiliser des prompts heuristiques, et fournit des intervalles de confiance. Il exige un jeu de validation d’environ 150 annotations humaines et au moins cinq exemples few-shot : plus robuste, plus lourd. RAGAS privilégie la rapidité, ARES la robustesse statistique.
- TruLens, DeepEval, RAGChecker sont d’autres frameworks utilisés par la communauté ; le cadre de la triade, lui, a été proposé par TruEra.
- Les métriques de récupération classiques (précision, rappel, F1, MRR, MAP, nDCG) jugent le classement du retriever seul ; un MRR ou un nDCG faible signale souvent un problème d’algorithme de classement.
- Les benchmarks publics (RGB, Multi-hop RAG, CRAG) permettent de comparer des systèmes sur des tâches standardisées.
À retenir
- Évaluer un RAG, c’est surveiller trois relations : question-contexte, contexte-réponse, réponse-question.
- Le cycle tient en trois gestes : générer ou construire des questions avec réponse de référence, faire tourner ton pipeline, faire noter le résultat.
- Lis les scores ensemble : une fidélité haute avec un rappel moyen pointe la récupération, pas le générateur.
- Un juge LLM est un instrument, pas un oracle : change de modèle, échantillonne ses verdicts, ajoute l’avis humain.
Questions fréquentes
RAGAS peut-il créer mes questions de test ? Oui : il génère un jeu de test synthétique à partir de ta base de connaissances, via un générateur de questions puis un module d’évolution qui les complexifie.
Faut-il une réponse de référence ? Pour l’exactitude de la réponse, oui : elle se mesure par rapport à la référence. La fidélité, elle, n’en a pas besoin : elle compare la réponse au contexte récupéré.
Quel LLM choisir comme juge ? Un modèle différent de celui qui génère tes réponses, pour éviter un biais d’auto-référence.