Sur 200 marchés, les ventes semblent grimper avec la presse écrite. Puis tu ajoutes la radio au modèle, et l’effet de la presse s’évapore : presse et radio évoluent ensemble, et la presse seule « captait » en réalité une partie de l’effet de la radio. Plutôt que d’arbitrer entre deux colonnes qui se recoupent, la régression sur composantes principales (PCR) en fabrique de nouvelles qui ne se recoupent plus. À la fin, tu sauras ce qu’elle construit, ce qu’elle règle et comment l’écrire en Python.
Sommaire
- L’essentiel en 30 secondes
- Deux situations où les moindres carrés se perdent
- Le principe : changer les colonnes, garder le modèle
- Fabriquer les composantes
- Choisir M et l’écrire en Python
L’essentiel en 30 secondes
- La PCR est une régression en deux temps : on remplace les
 prédicteurs par
 combinaisons linéaires, puis on les confie à une régression ordinaire.
- Ces combinaisons sont les composantes principales, calculées sans jamais consulter la réponse.
- Deux composantes successives sont non corrélées : la régression finale n’a plus de colonnes qui se recoupent.
- La PCR reste utilisable quand il y a plus de colonnes que de lignes, cas où les moindres carrés ordinaires échouent.
- Le nombre
 est un réglage, fixé par validation croisée.
Deux situations où les moindres carrés se perdent
La régression ordinaire se comporte bien quand les colonnes apportent des informations distinctes et que les lignes sont nombreuses. Deux cas la prennent en défaut, et la PCR vise les deux.
Des colonnes qui disent presque la même chose
Reprends nos 200 marchés. Une régression des ventes sur la presse écrite seule montrait un effet net ; avec la télévision et la radio dans le modèle, il devient quasiment nul et non significatif. Rien de contradictoire : là où l’on dépense plus en radio, on dépense aussi plus en presse. Ce phénomène s’appelle la colinéarité : plusieurs prédicteurs sont fortement corrélés, et leurs effets deviennent difficiles à séparer.
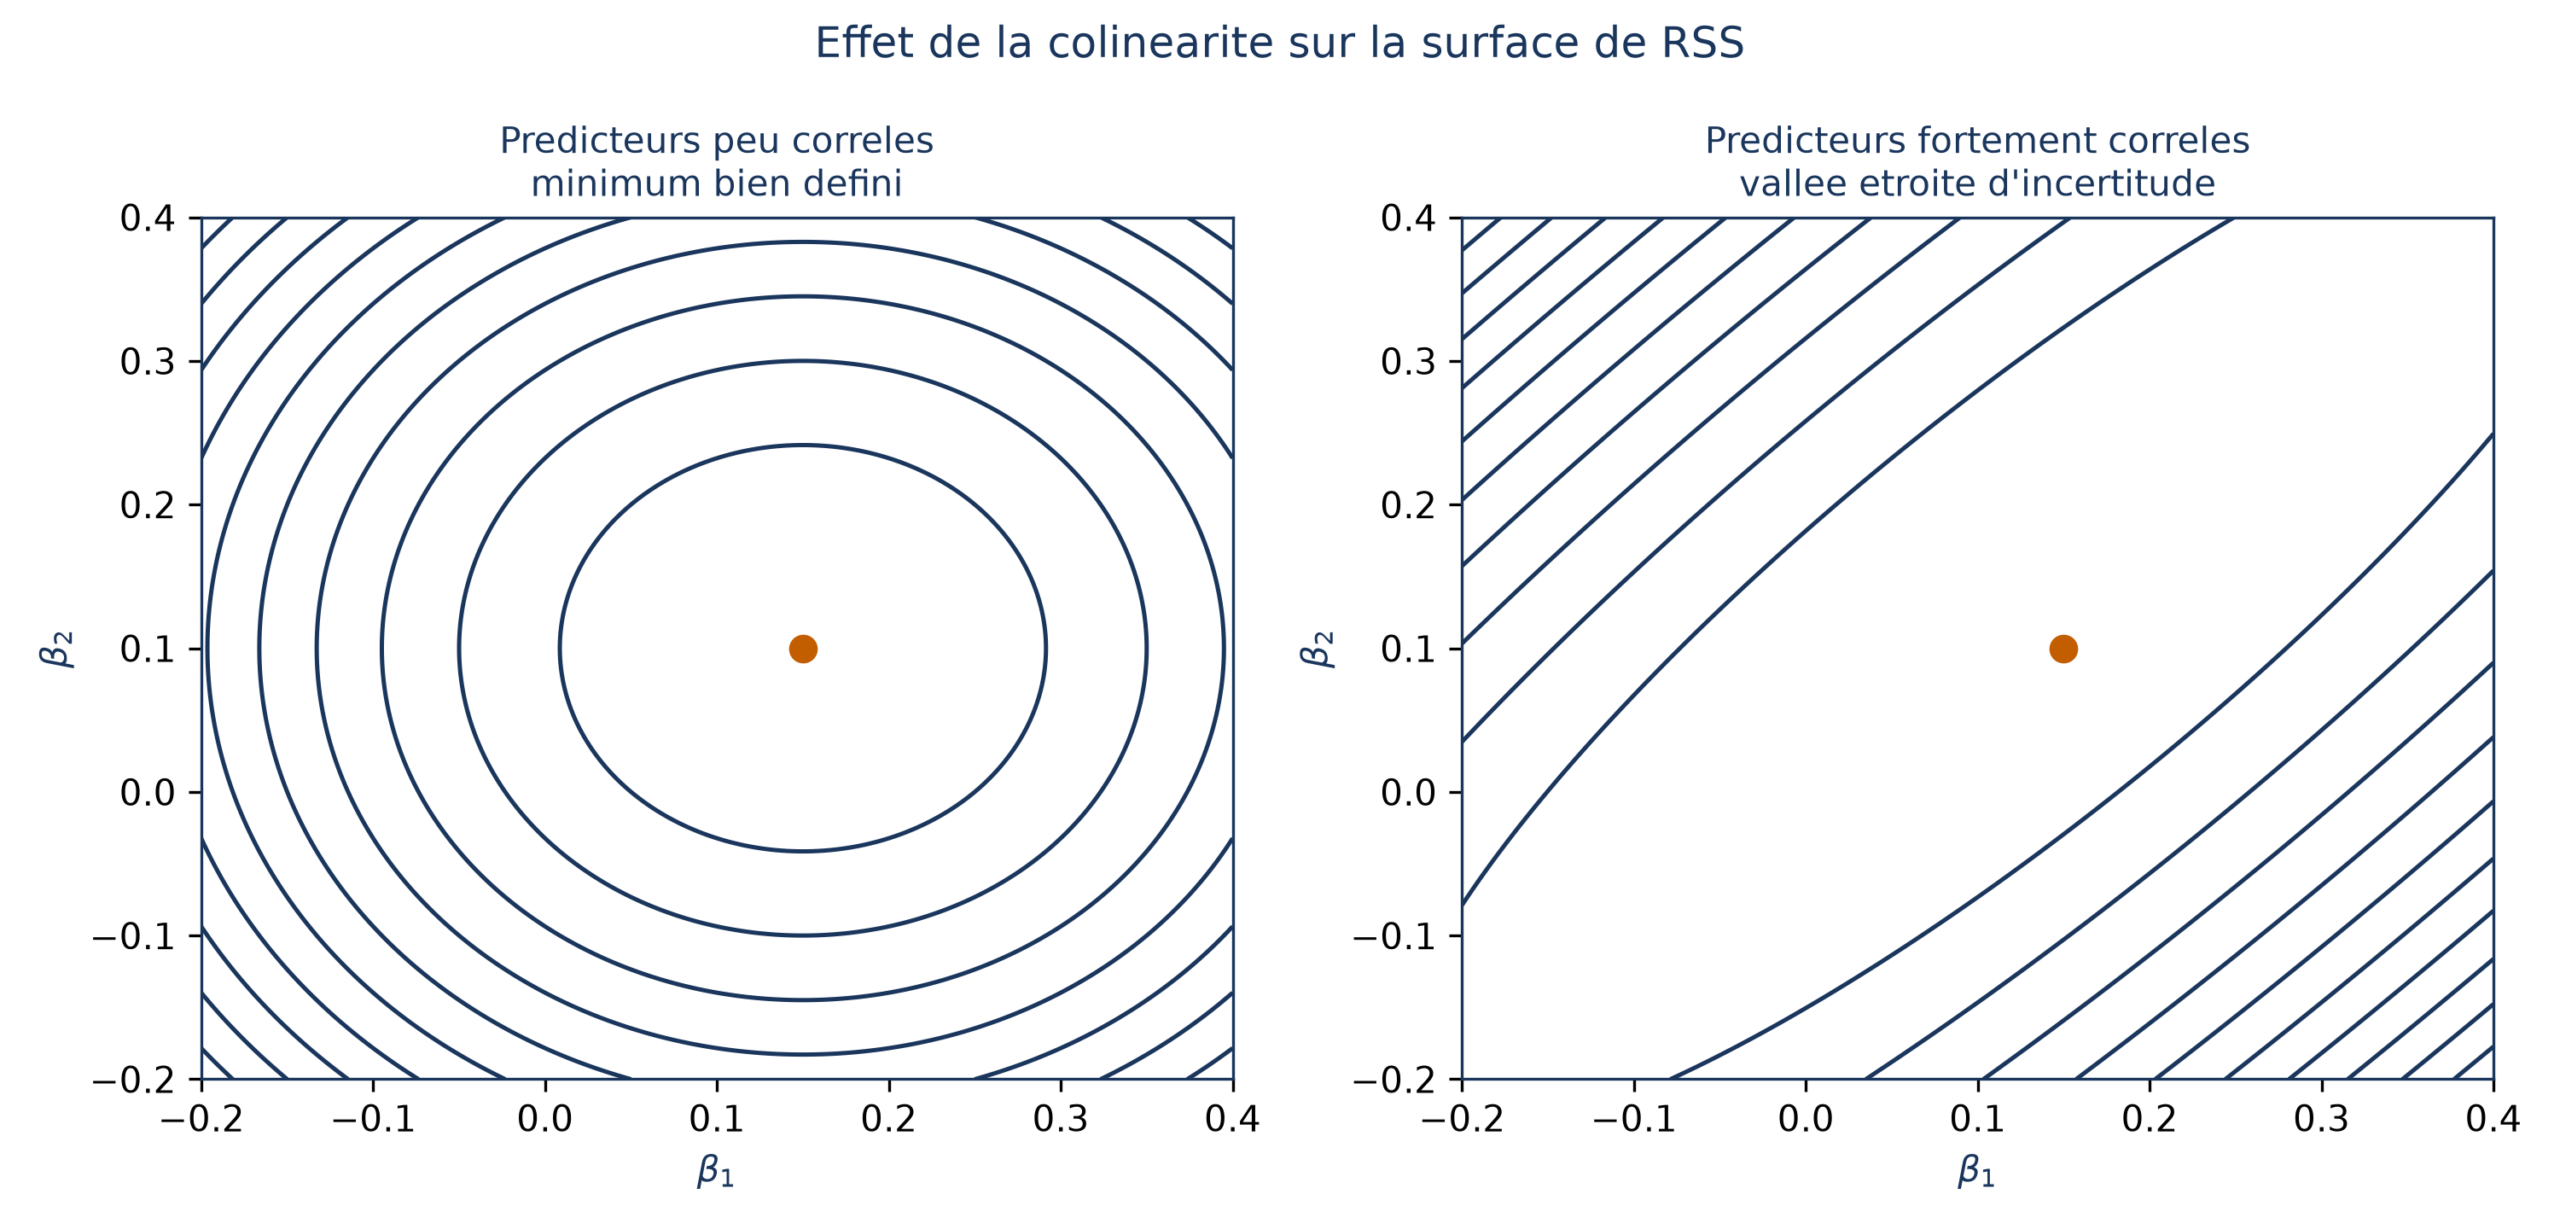
Un indicateur chiffre ce flou, le facteur d’inflation de la variance (VIF) : au-delà de 5 ou 10, la colinéarité devient préoccupante. Deux remèdes classiques existent : retirer l’une des variables redondantes, ou combiner les variables colinéaires en un seul indicateur synthétique. Garde cette seconde idée en tête : la PCR travaille exactement dans cet esprit.
Plus de colonnes que de lignes
Imagine des centaines de milliers de mutations génétiques mesurées sur quelques centaines de patients, ou des dizaines de milliers de termes pour quelques milliers de documents. Quand le nombre de variables dépasse celui des observations  , on parle de haute dimension.
Dans ce régime, les moindres carrés ordinaires deviennent inutilisables : une infinité de solutions reproduisent l’entraînement sans la moindre erreur (RSS nul), et prédisent pourtant très mal des données nouvelles. La réduction de dimension, elle, reste applicable, parce qu’elle impose au modèle final une forme de simplicité.
Le principe : changer les colonnes, garder le modèle
La PCR ne touche pas à la régression elle-même : elle change ce qu’on lui donne à manger. On construit combinaisons linéaires des prédicteurs d’origine, notées  , puis on les utilise comme prédicteurs d’un modèle de régression ordinaire.
Le modèle final s’écrit donc :
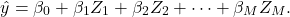
Les coefficients  portent sur les composantes
 , pas sur les variables de départ. Ces composantes sont fabriquées en observant uniquement les prédicteurs : la réponse
 n’est jamais consultée à cette étape.
Ce procédé repose sur une hypothèse de travail. Si les directions où les prédicteurs varient le plus sont aussi les plus liées à la réponse, quelques composantes suffisent à porter l’essentiel du signal utile, hypothèse raisonnable en pratique mais jamais garantie. Le gain : beaucoup moins de paramètres à estimer, donc moins de risque de surajustement.
Fabriquer les composantes
Pour voir d’où sortent les , pars de deux prédicteurs seulement.
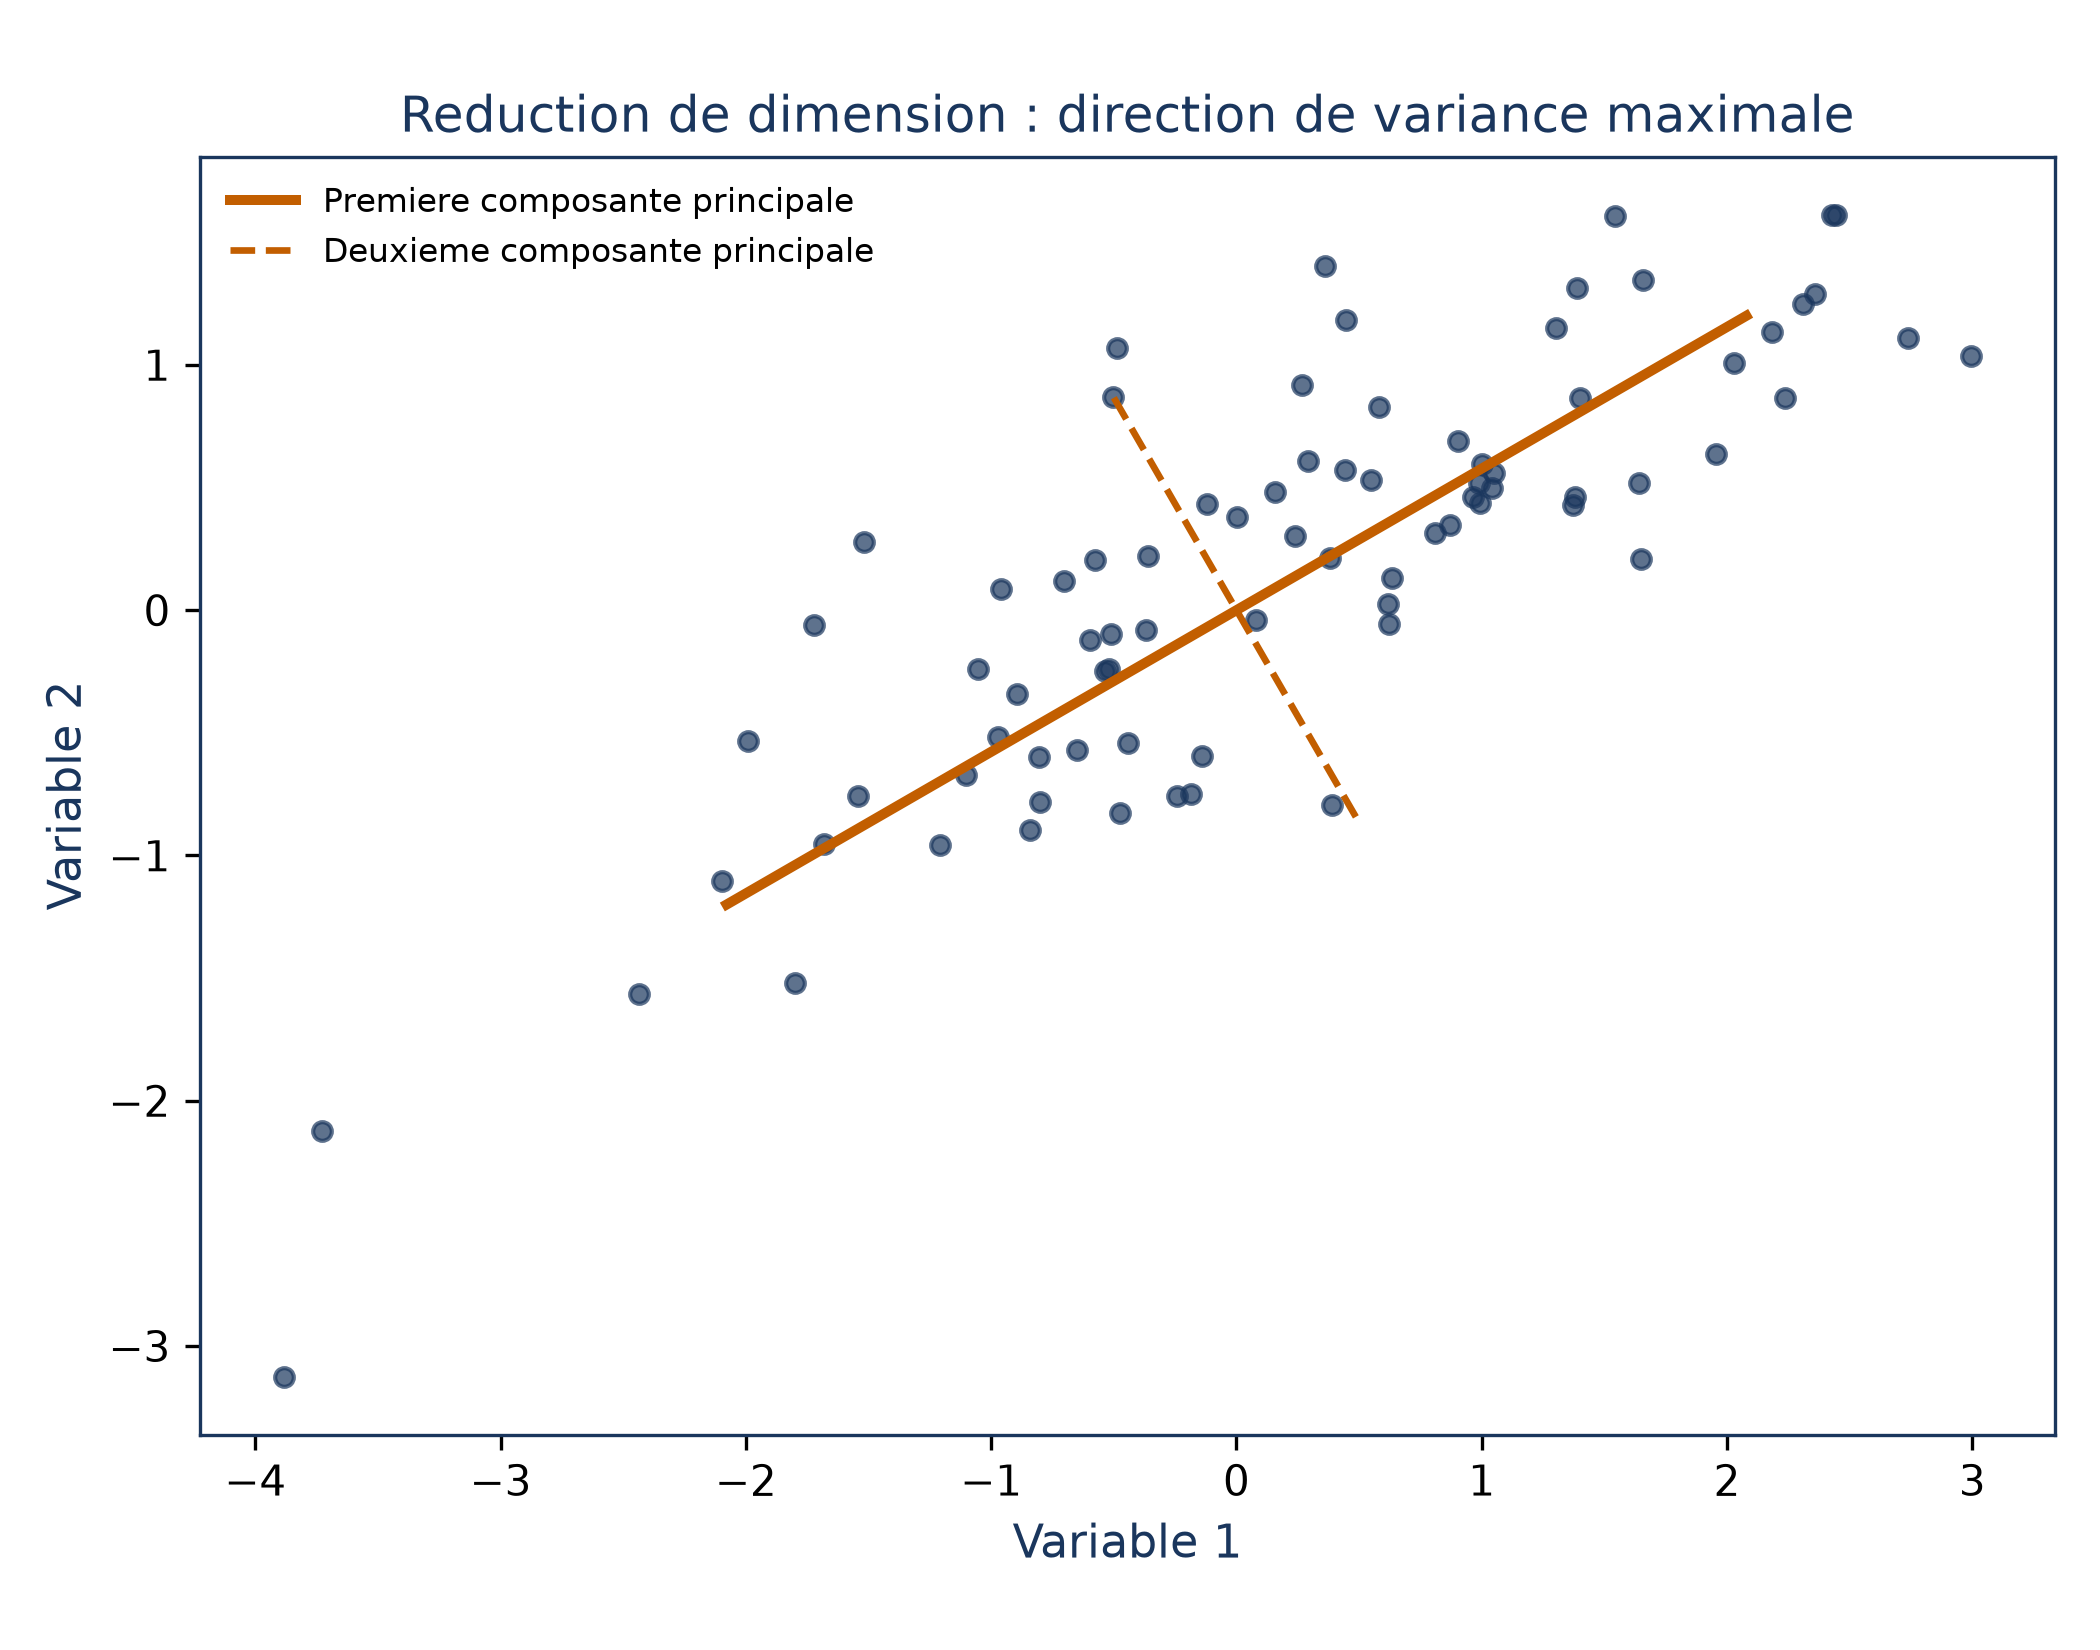
La première composante est la combinaison linéaire des prédicteurs dont la variance est la plus grande :
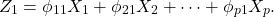
Chaque  est le poids du prédicteur
 . Les poids sont liés par
 ; sans ce garde-fou, il suffirait de multiplier tous les poids pour faire exploser la variance.
Pour la deuxième, même recette sous une condition supplémentaire : aucune corrélation avec la première, ce qui revient à lui être perpendiculaire. La suite s’enchaîne jusqu’à composantes, de moins en moins riches en variance ; la PCR s’arrête aux premières.
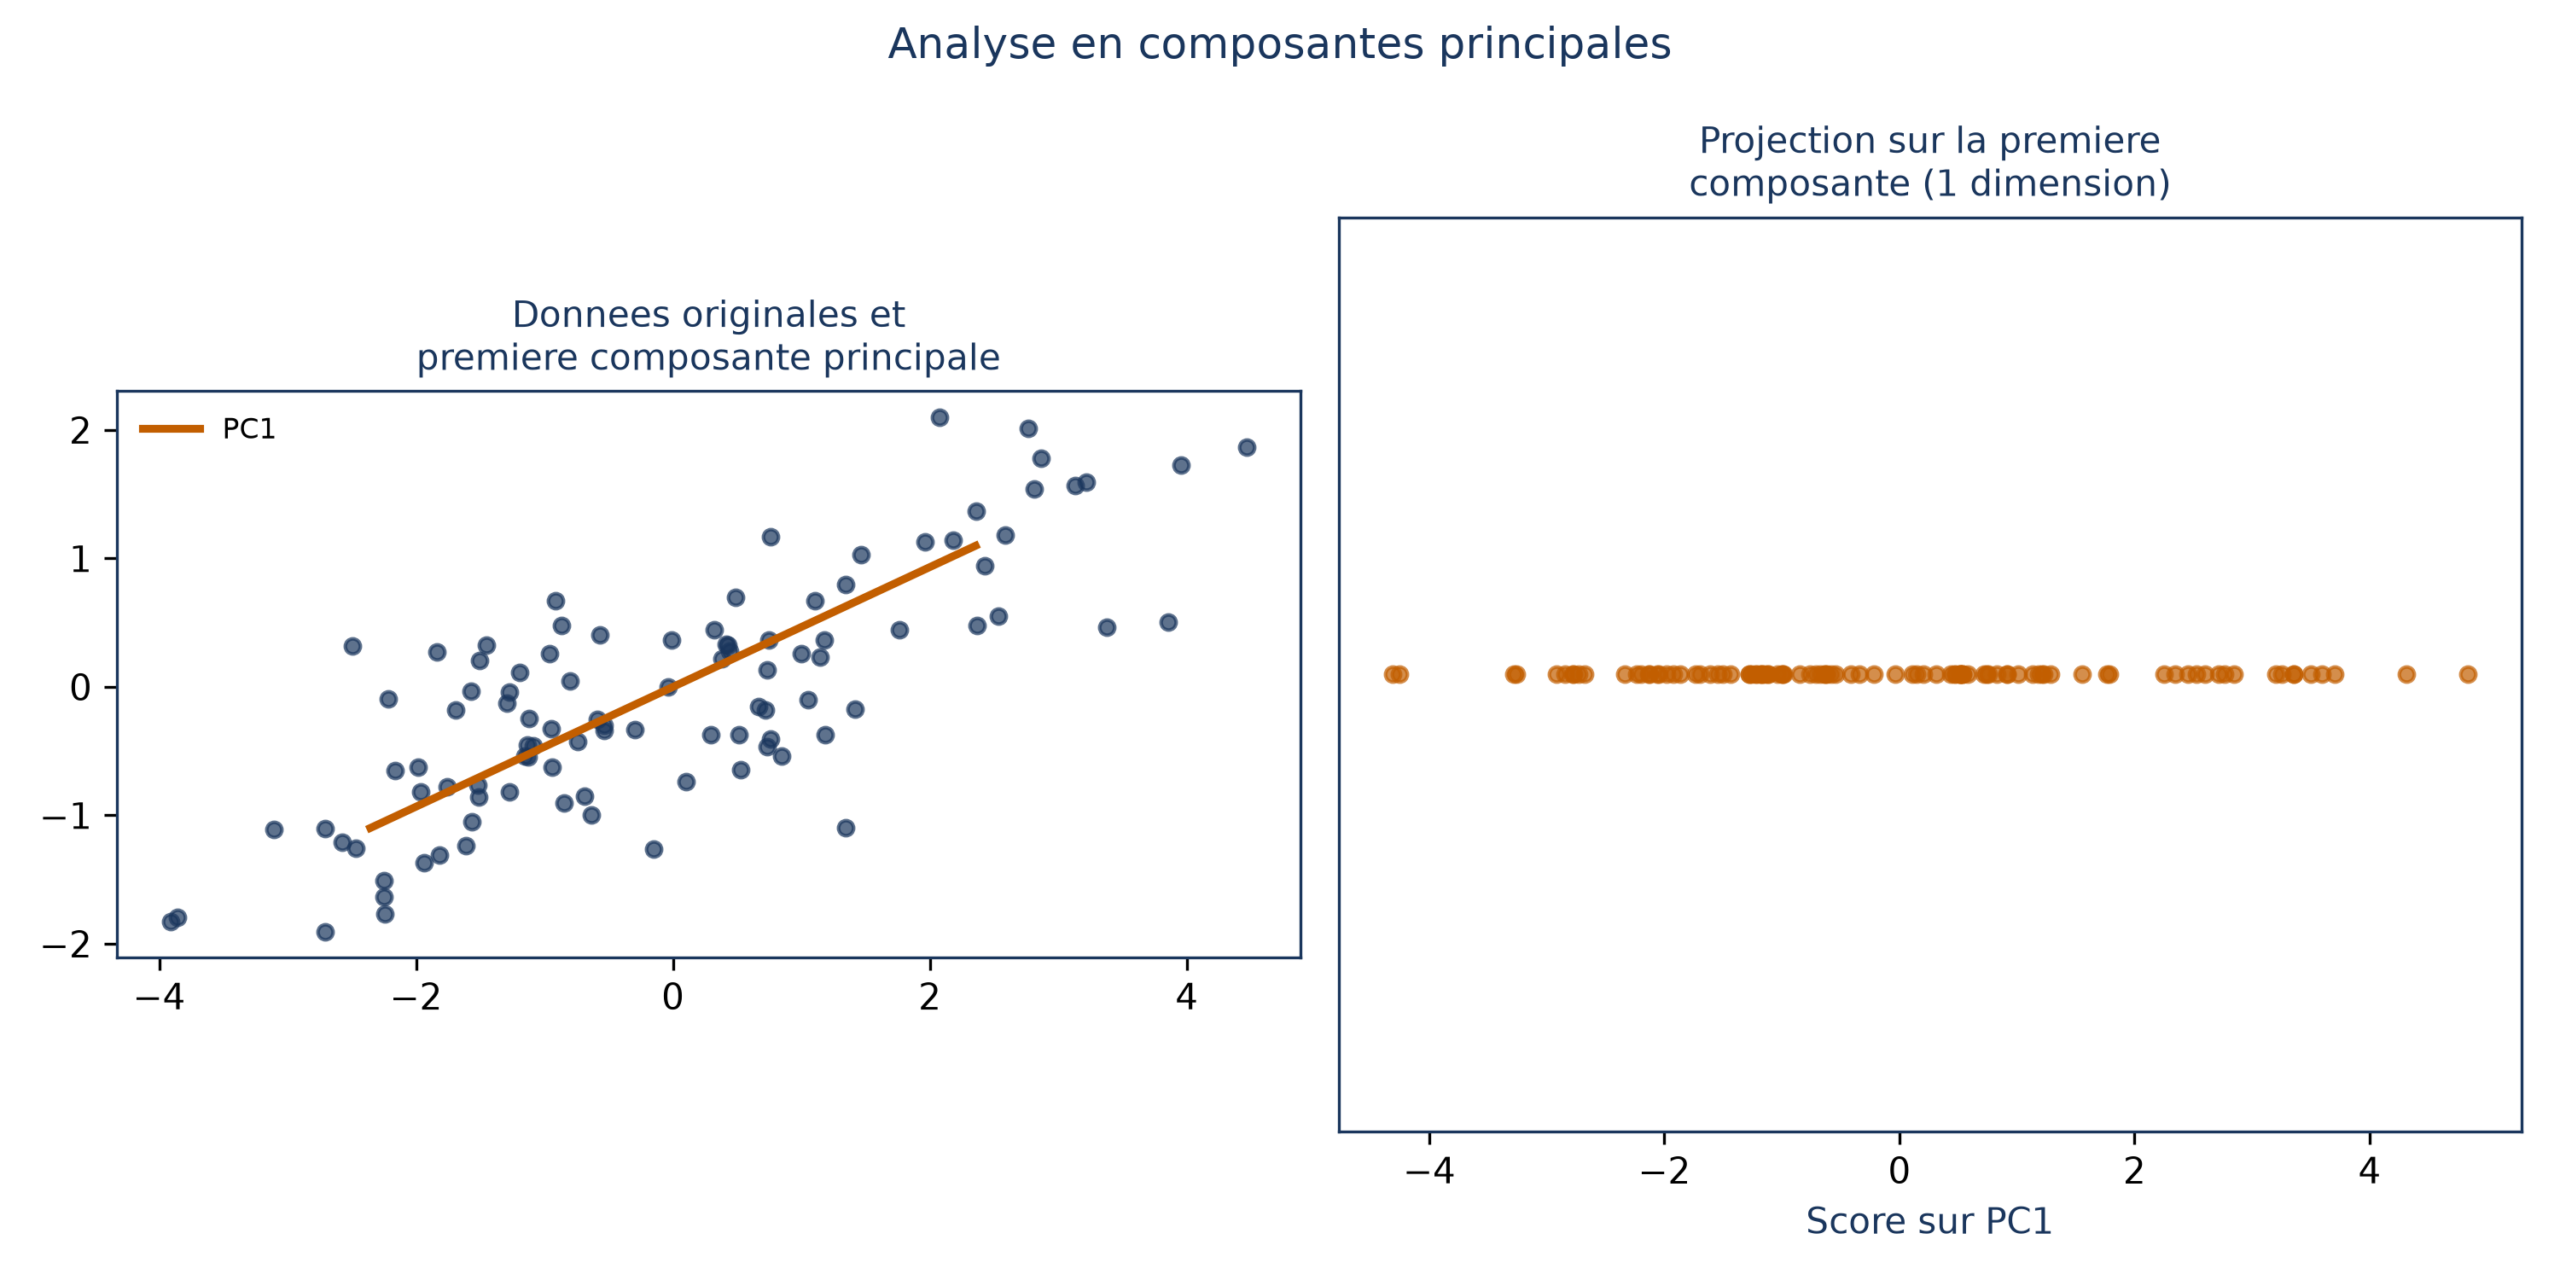
Regarde le panneau de droite : chaque observation est réduite à un seul nombre, sa position le long de PC1. Ce nombre est la valeur de  pour cette observation, et c’est lui qui devient une colonne de la régression.
Reviens maintenant au problème du début. Comme deux composantes successives sont non corrélées, les colonnes qui entrent dans la régression ne se recoupent plus : là où presse et radio se disputaient un même effet, la régression travaille sur des axes indépendants.
Choisir M et l’écrire en Python
Le nombre de composantes n’est pas calculé : c’est un réglage que tu fixes. On fait varier , on évalue chaque modèle par validation croisée et l’on retient la valeur qui donne la meilleure erreur de test estimée, avec en pratique 5 ou 10 blocs.
Imagine un tableau X de prédicteurs et une réponse Y, déjà chargés, avec un entier M à tester. Le bloc ci-dessous est une session interactive : In [24]: désigne la commande numéro 24 de la session.
In [24]: pca = PCA(n_components=M)
         linreg = skl.LinearRegression()
         pipe = Pipeline([('pca', pca),
                            ('linreg', linreg)])
         pipe.fit(X, Y)
Chaque ligne a son rôle : PCA(n_components=M) fabrique les premières composantes, skl.LinearRegression() est la régression ordinaire, et le Pipeline les enchaîne, si bien qu’un seul pipe.fit(X, Y) exécute les deux temps de la méthode. Il reste à relancer ce bloc pour chaque valeur de M et à comparer les erreurs de validation croisée.
📌 À retenir La PCR vaut le détour quand tes prédicteurs se recoupent (un VIF au-delà de 5 ou 10) ou quand ils dépassent tes observations en nombre. Elle consiste en deux gestes : fabriquer