Demande à un assistant documentaire : « Qui a vécu le plus longtemps, X ou Y ? » Une seule phrase, mais deux recherches cachées (la durée de vie de X, puis celle de Y) et une comparaison que personne n’a rédigée d’avance. Un système qui ne récupère qu’une fois avant de répondre n’a pas prévu ce détour ; un système agentique, si. À la fin, tu sauras définir un RAG agentique, repérer où l’agent intervient et suivre sa logique sur un cas concret.
Sommaire
- L’essentiel en 30 secondes
- Les questions qu’une seule passe laisse échapper
- Définition : le système décide au lieu de suivre un rail
- Les décisions confiées à l’agent, de l’indexation à la réponse
- Pas à pas : une question coupée en deux
- Quand l’enquête s’allonge : la recherche approfondie
- Le RAG, mémoire de l’agent
- Trois idées reçues
L’essentiel en 30 secondes
- Un RAG agentique est un RAG où des décisions autonomes remplacent le trajet fixe « chercher puis répondre ».
- L’agent décide où chercher, avec quoi et quand relancer, à chaque étape des deux pipelines, pas seulement au moment de la recherche.
- Il sert surtout aux questions à plusieurs étapes, vagues, longues ou implicites, qu’une passe unique traite mal.
- Sa boucle type : planifier, chercher, observer, ajuster, c’est-à-dire pensée, action, observation.
- Il ne suppose pas une base vectorielle : la source peut être une API, et un humain garde souvent la main sur le cadrage.
Les questions qu’une seule passe laisse échapper
La pratique standard consiste à récupérer une fois, puis générer. Pour une question simple, cela suffit. Cette approche devient insuffisante dès que le problème exige un raisonnement en plusieurs étapes.
Quatre familles de requêtes restent des points de faiblesse récurrents quand le trajet est figé :
- les requêtes à raisonnement multi-étapes, qui demandent une récupération à sauts multiples : la réponse se construit en enchaînant plusieurs recherches ;
- les requêtes générales ou vagues, difficiles à rapprocher de fragments de texte précis ;
- les requêtes longues ou complexes, qui mettent à l’épreuve la compréhension du retriever (le composant chargé d’aller chercher les passages) ; une demande du type « résume les points A, B et C » gagne parfois à être retouchée avant la recherche ;
- les requêtes implicites, qui supposent une compréhension du contexte que le RAG seul ne fournit pas.
Même quand la recherche aboutit, la réponse peut rester incomplète sans être fausse : soit l’information nécessaire n’a pas été entièrement retrouvée, soit le modèle l’a mal exploitée.
Reviens à la question de départ. La réponse tient en une phrase, « X a vécu 85 ans, Y 90 ans, donc Y a vécu plus longtemps », mais elle n’existe qu’une fois les deux durées de vie obtenues, l’une après l’autre.
💡 Intuition Une passe unique répond à « quel passage ressemble à ma question ? ». Une question à étapes pose autre chose : « quelle suite de recherches mène à la réponse ? ». Cette seconde question, le RAG agentique la confie au système lui-même.
Définition : le système décide au lieu de suivre un rail
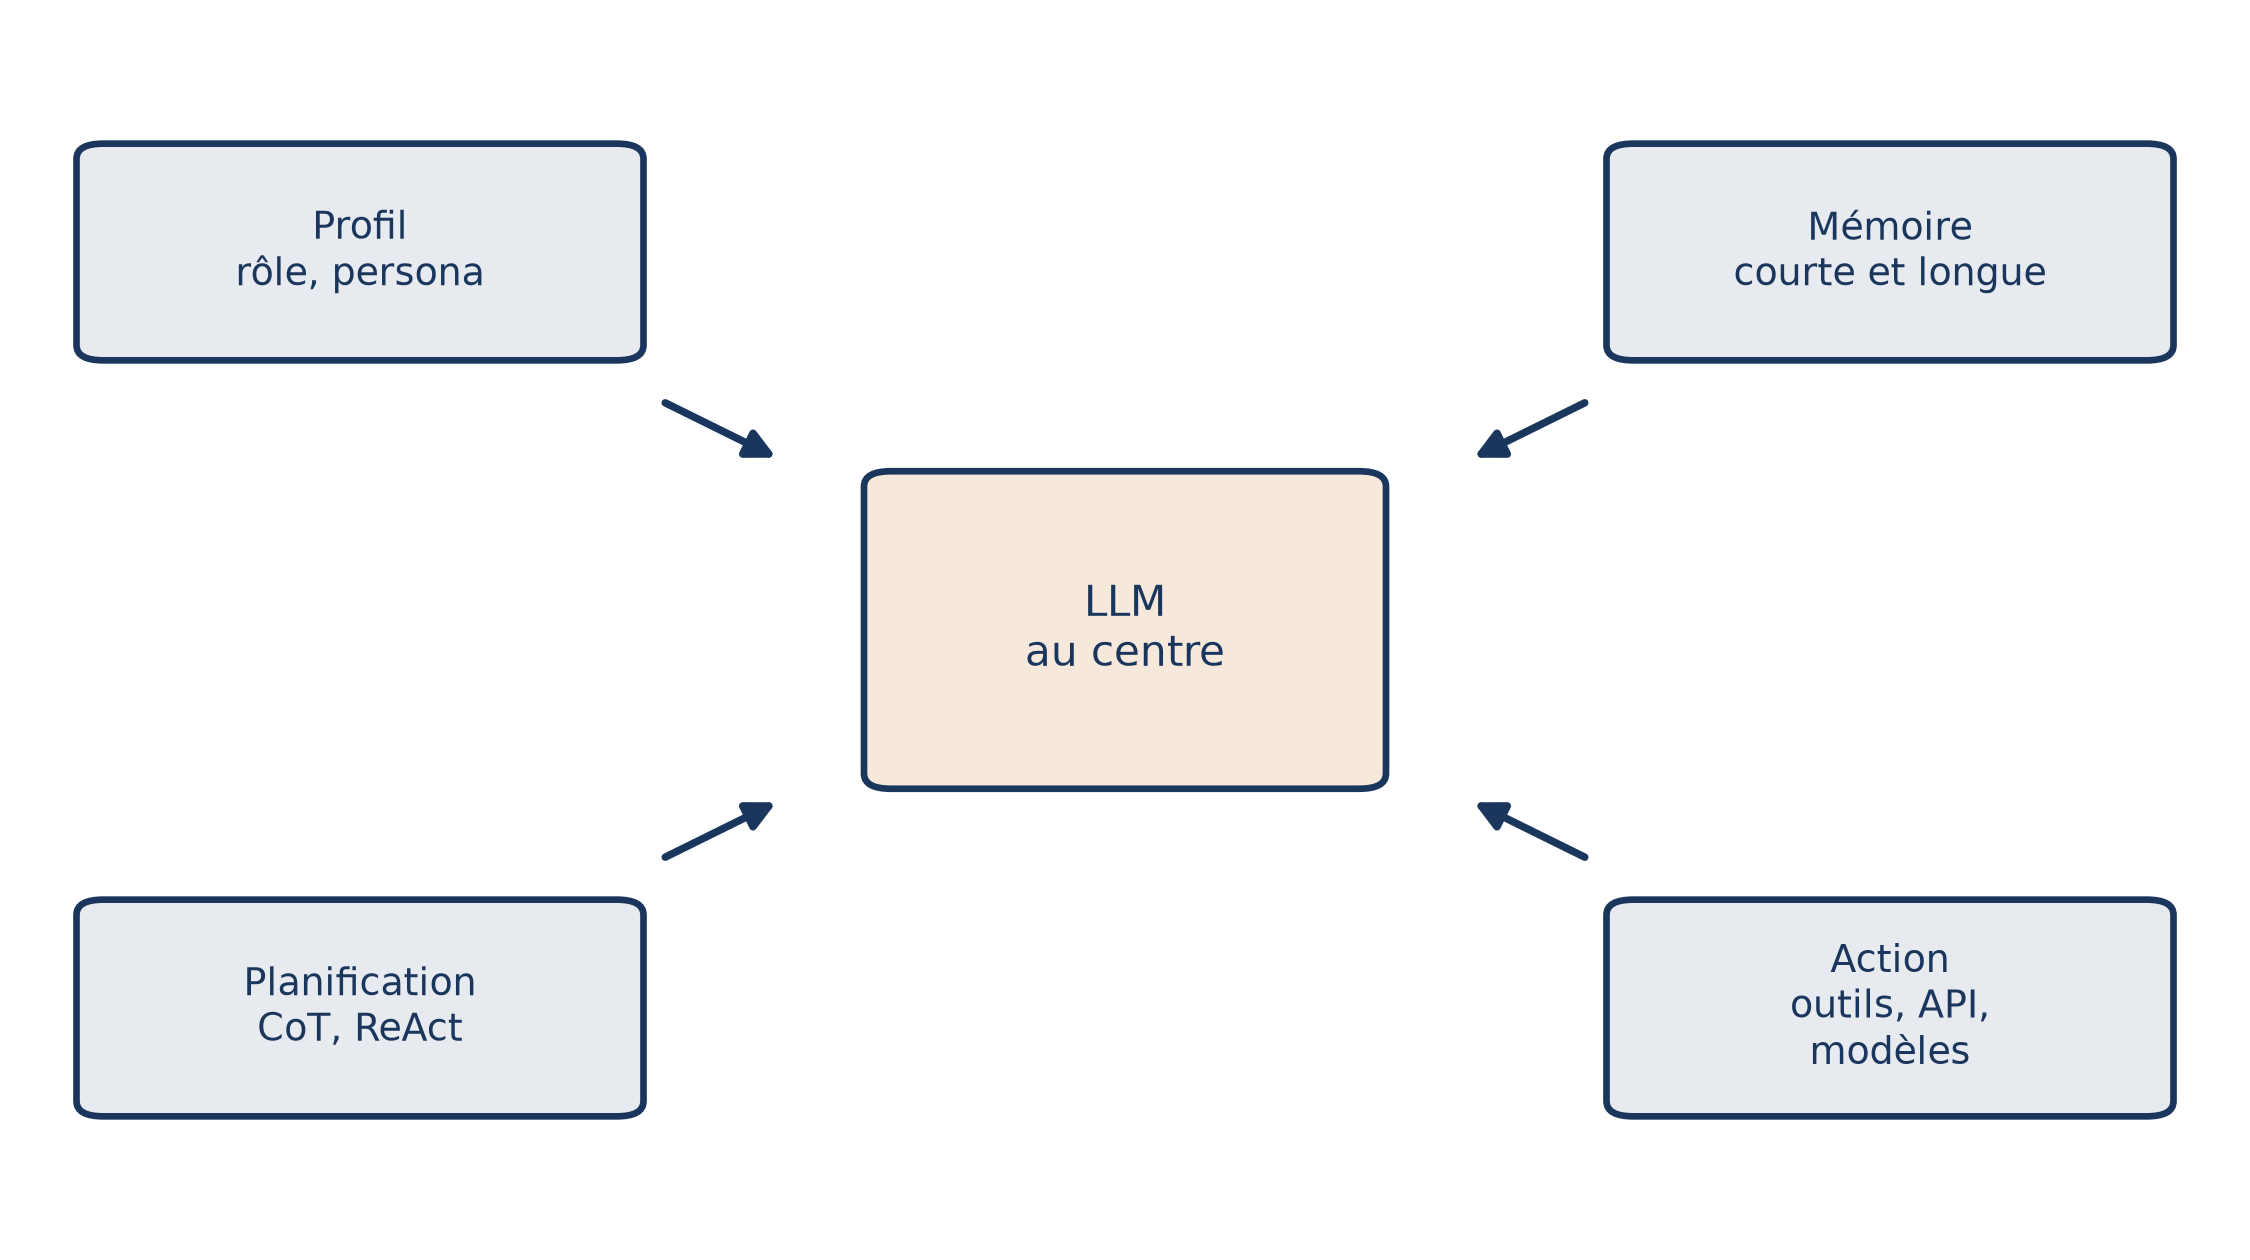
Un agent est un système capable d’accomplir des tâches ou de prendre des décisions seul : il perçoit son environnement, raisonne, choisit en fonction de ses buts et agit. Un RAG agentique met ce pouvoir de décision au service de la recherche : des agents LLM prennent en charge le routage des requêtes, l’usage d’outils externes et la récupération adaptative, à chaque étape des deux pipelines.
Pourquoi un modèle de langage plutôt que des règles écrites d’avance ? Parce qu’un pipeline complexe empile des composants qui ne conviennent pas à toutes les situations, et qu’un LLM peut décider lesquels employer pour chaque cas.
Sa forme la plus aboutie est la récupération adaptative. Le modèle détermine lui-même quand chercher et si ce qu’il a trouvé suffit ; il juge l’étape de recherche, mais aussi son propre fonctionnement, et peut choisir de répondre, de chercher encore ou de solliciter un outil de plus. FLARE en donne une illustration : il surveille la confiance du modèle au fil de la génération et anticipe ce dont la suite aura besoin.
Le point de vocabulaire compte : la récupération adaptative relève de l’IA agentique, où le système prend des décisions autonomes pendant la tâche.
Où il se place parmi les RAG
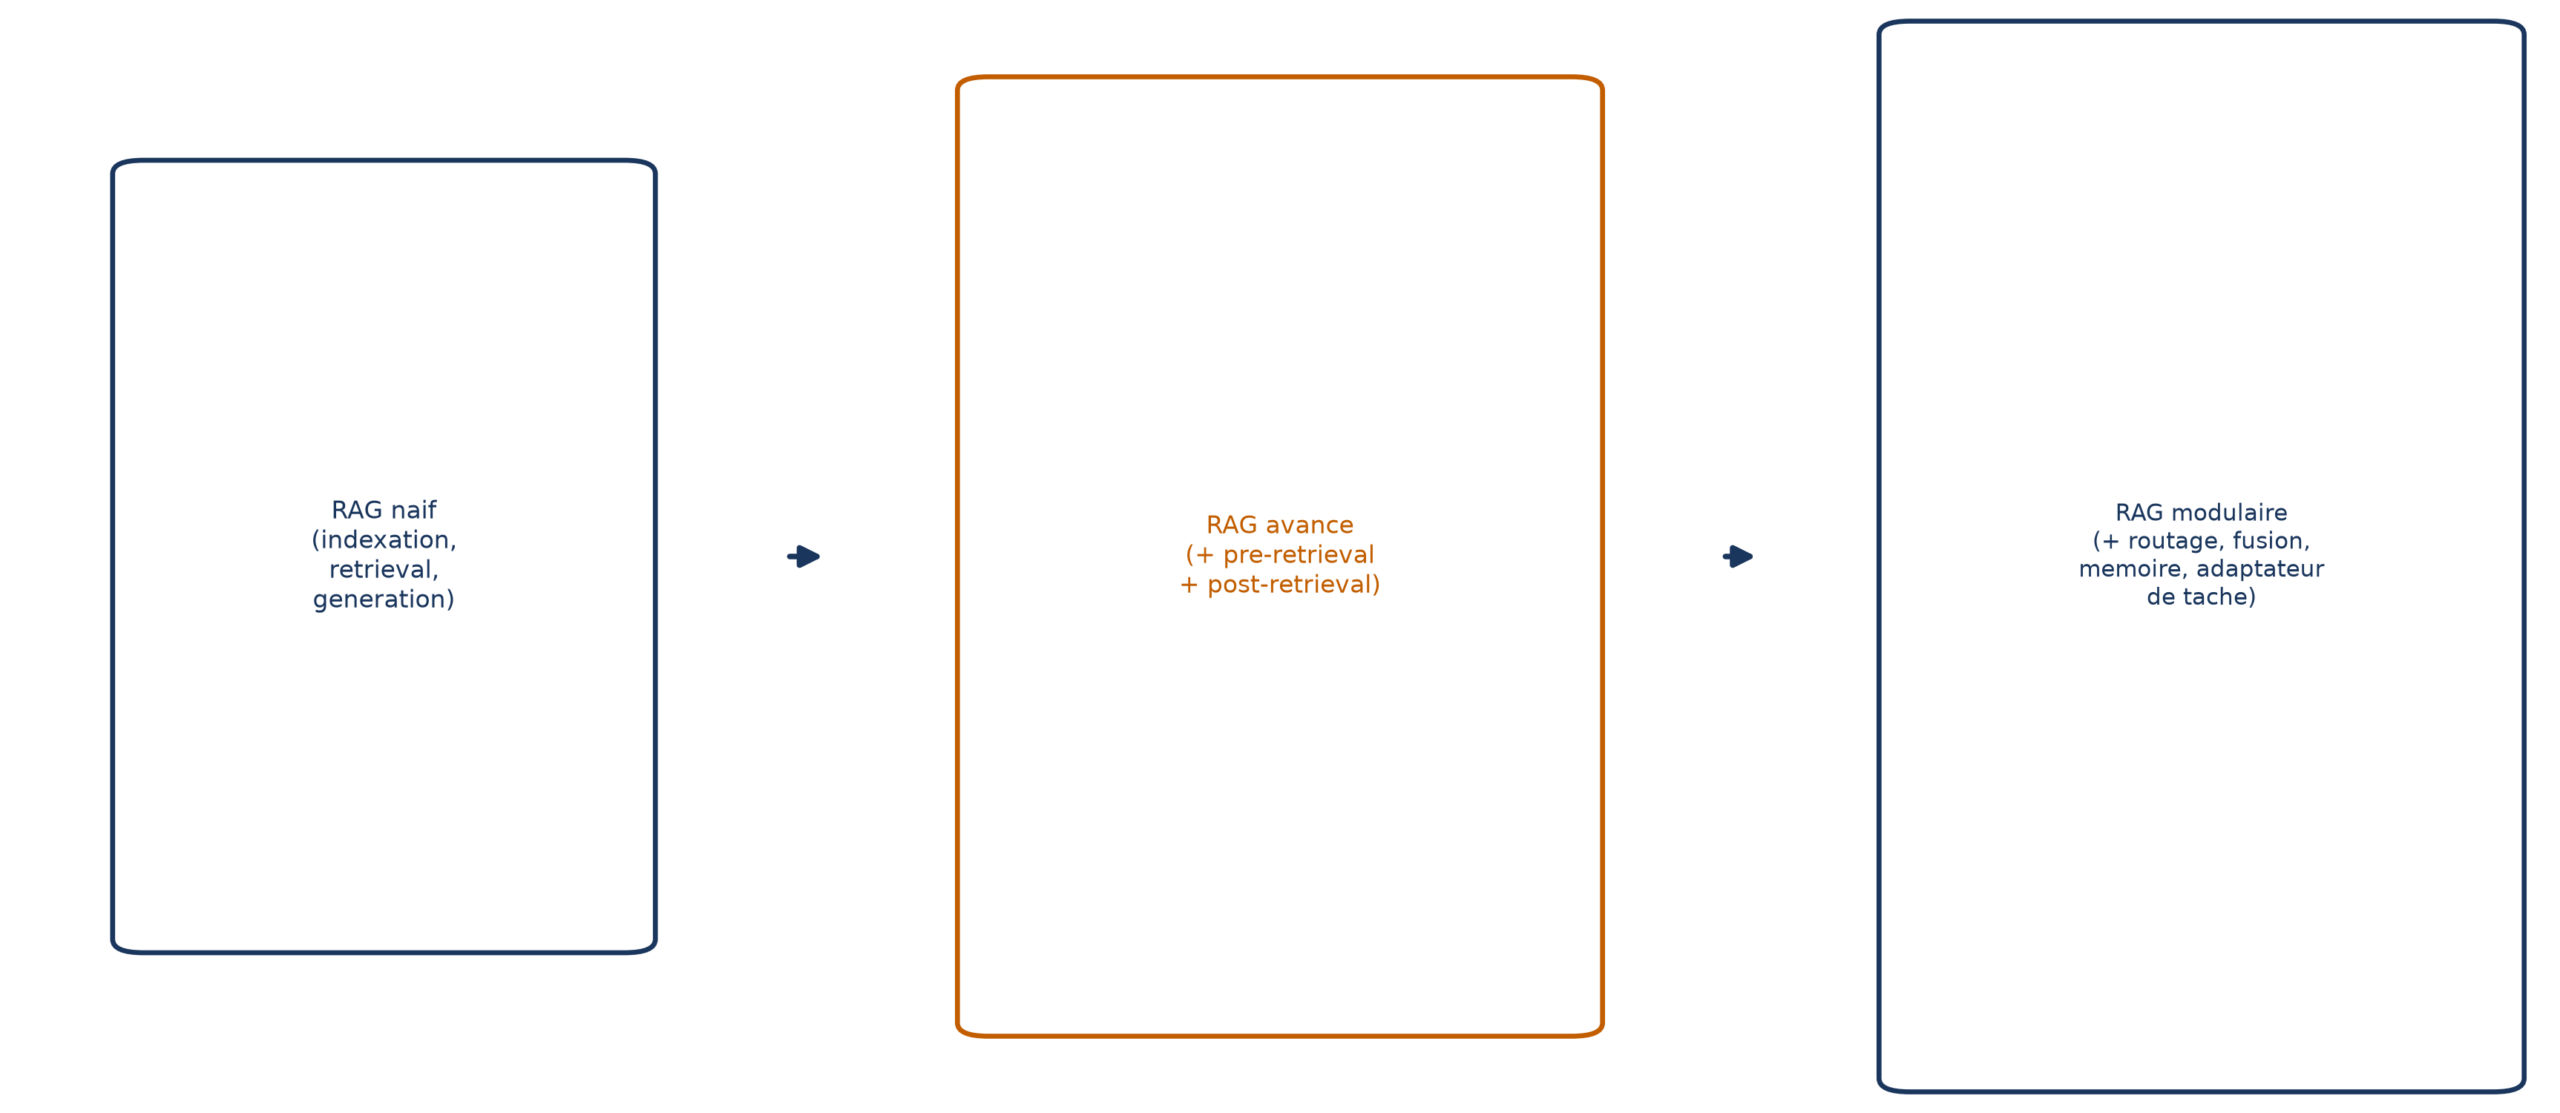
Trois étapes d’architecture se sont succédé. Le RAG naïf enchaîne indexation, récupération et génération. Le RAG avancé ajoute des traitements avant et après la récupération, ce qui donne la séquence « réécrire, récupérer, re-classer, lire ». Le RAG modulaire ajoute en plus le routage, la fusion, la mémoire et l’adaptateur de tâche ; grâce à l’évaluation et au retour, le système raffine sa réponse : à la lecture s’ajoute la réécriture.
À côté de cette progression existent des variantes, chacune répondant à un aspect précis des limites du RAG standard. Celle qui t’intéresse ici apporte une réponse particulière : la prise de décision autonome.
| Variante | Limite du RAG standard qu’elle vise |
|---|---|
| RAG multimodal | données non textuelles |
| RAG par graphe | compréhension des relations |
| RAG agentique | prise de décision autonome |
| CRAG | fiabilité factuelle |
| RAG spéculatif | efficacité |
| Self-RAG | adaptabilité |
| RAPTOR | raisonnement hiérarchique |
Les décisions confiées à l’agent, de l’indexation à la réponse
On associe l’agent à la seule étape de recherche. En réalité, il peut intervenir dans les deux pipelines : celui qui prépare la base en amont, et celui qui répond à chaque question.
| Étape | Décision que l’agent peut prendre |
|---|---|
| Chargement | analyser finement des documents complexes, extraire des métadonnées riches |
| Découpage | regrouper les phrases selon un objectif, par exemple séparer les avis clients positifs et négatifs sur un même sujet |
| Embeddings | choisir le modèle adapté au domaine de chaque fragment |
| Stockage | répartir l’information entre plusieurs collections selon sa nature |
| Récupération | router vers la bonne source, intégrer des outils, relancer au besoin |
| Augmentation | choisir dynamiquement la technique de prompting |
| Génération | produire en plusieurs étapes : un agent évalue la réponse d’un premier passage et décide d’un nouveau tour |
La récupération reste le terrain principal des agents. Mais regarde la dernière ligne : même la rédaction de la réponse peut déclencher une nouvelle recherche, quand un agent juge le premier jet insuffisant. Cette variante s’appelle IterRetGen.
💡 Intuition Lis la colonne de droite comme une liste de questions que le système se pose lui-même : quelle source ? quel modèle ? quel découpage ? faut-il chercher encore ? Le mot « agentique » désigne l’endroit où ces questions reçoivent une réponse : dans le système, pas dans un schéma figé.
Pas à pas : une question coupée en deux
Reprenons « Qui a vécu le plus longtemps, X ou Y ? ». Un agent de décomposition de requête scinde la question en sous-questions, invoque la recherche (ou d’autres outils) pour chacune, puis synthétise la réponse finale. Ce motif porte un nom, « self-ask with search » : le modèle se demande « quelle question de suivi dois-je poser ? », appelle la recherche, passe à la suivante, jusqu’à la réponse.
Concrètement, le déroulé tient en trois temps :
- première sous-question : quelle est la durée de vie de X ? La recherche rapporte 85 ans ;
- deuxième sous-question : quelle est celle de Y ? Elle rapporte 90 ans ;
- synthèse : Y a vécu plus longtemps.
Chaque fait est ancré dans la sortie d’un outil avant que la réponse ne soit composée. C’est ce qui donne à l’approche sa force dès qu’il faut aller chercher de la connaissance externe.
Planifier avec ou sans retour
Ce va-et-vient entre question et observation porte un nom : la planification avec retour. Le module de planification décompose une tâche complexe en tâches plus gérables, et il peut en recevoir ou non un retour.
| Planification | Principe | Exemples cités |
|---|---|---|
| Sans retour, chemin unique | étapes intermédiaires enchaînées en cascade | chaîne de pensée |
| Sans retour, multi-chemins | structure en arbre, chaque étape pouvant se ramifier | CoT-SC, Tree of Thoughts |
| Avec retour | le retour de l’environnement et les observations sont réincorporés | ReAct : triplets pensée, action, observation |
La version avec retour sert surtout aux tâches de long terme, quand il est difficile de bâtir d’emblée un plan efficace ou que la situation peut changer en route. Le retour peut aussi venir d’un humain ou d’un autre modèle.
Quand l’enquête s’allonge : la recherche approfondie
Mets l’exemple à l’échelle : une revue de littérature, une découverte scientifique, une analyse stratégique de marché. Les agents de recherche approfondie (deep research) s’attaquent à ces investigations ouvertes en combinant plusieurs motifs : un planificateur-exécuteur pour tracer les flux de recherche, la décomposition de requête pour découper les grandes questions, et des boucles ReAct pour affiner les hypothèses à la lumière des nouveaux éléments.
Un cycle typique se déroule ainsi :
- l’agent planifie l’agenda global, avec les sous-thèmes et les sources clés ;
- il décompose chaque sous-thème en requêtes concrètes ;
- il invoque des outils (API de recherche académique, bases spécialisées) en jugeant la pertinence et la fiabilité de chaque résultat ;
- il synthétise le tout dans un rapport qui évolue, résumé et critiqué par le LLM à chaque étape.
Deux qualités en découlent : la direction de recherche s’ajuste quand de nouvelles preuves apparaissent, et les plans comme les décompositions sont explicites, ce qui permet d’auditer la méthode.
Le RAG, mémoire de l’agent
Jusqu’ici, le RAG apporte du savoir à l’agent. Il peut aussi lui servir de souvenir. Les mémoires les plus courantes sont insérées dans le prompt système et sont donc plafonnées par la longueur de contexte du modèle, comme l’historique d’une conversation.
La mémoire hybride dépasse cette limite en combinant un court terme, dans le contexte, et un long terme, externe. Pensées, conversations et autres informations peuvent être sauvegardées par un RAG, une base de données ou un graphe de connaissances ; au besoin, on retrouve l’information utile et on l’injecte dans le prompt. L’agent agit alors selon ses connaissances antérieures sans dépasser les limites de contexte.
Cette mémoire doit couvrir trois opérations : la lecture (extraire ce qui sert l’action en cours), l’écriture (stocker ce qui servira plus tard, en évitant doublons et débordement) et la réflexion (inférer une information plus abstraite à partir de ce qui est stocké, pour ajuster le comportement vers les objectifs).
Trois idées reçues
« Il faut forcément une base vectorielle »
Non. Un pipeline d’indexation hors ligne n’est pas toujours nécessaire. Imagine un assistant de voyage dont la seule source est une API météo tierce, appelée selon la position de l’utilisateur : toute la recherche est déléguée à ce service, et aucune base de connaissances propre n’a besoin d’exister. À l’autre extrémité, un système qui se contente de glisser dans le prompt un résumé fourni par l’utilisateur n’est, pour certains, pas un RAG au sens strict.
Les agents d’un même système peuvent d’ailleurs s’appuyer sur des sources de natures très différentes. Dans un système de voyage à plusieurs agents, l’un prédit le meilleur mois pour visiter un lieu avec un modèle entraîné sur la météo passée, un autre retrouve des hôtels en comparant des embeddings à tes préférences.
« Plus l’agent boucle, plus la réponse est précise »
Pas automatiquement. Dans la récupération itérative, on récupère, on génère, puis un LLM juge le résultat, et l’on répète jusqu’à n fois : la robustesse augmente à chaque tour, mais l’information non pertinente peut s’accumuler. La version récursive affine la requête d’après les résultats précédents ; la version adaptative laisse le modèle décider quand chercher et si ce qu’il a trouvé suffit.
« L’agent travaille tout seul »
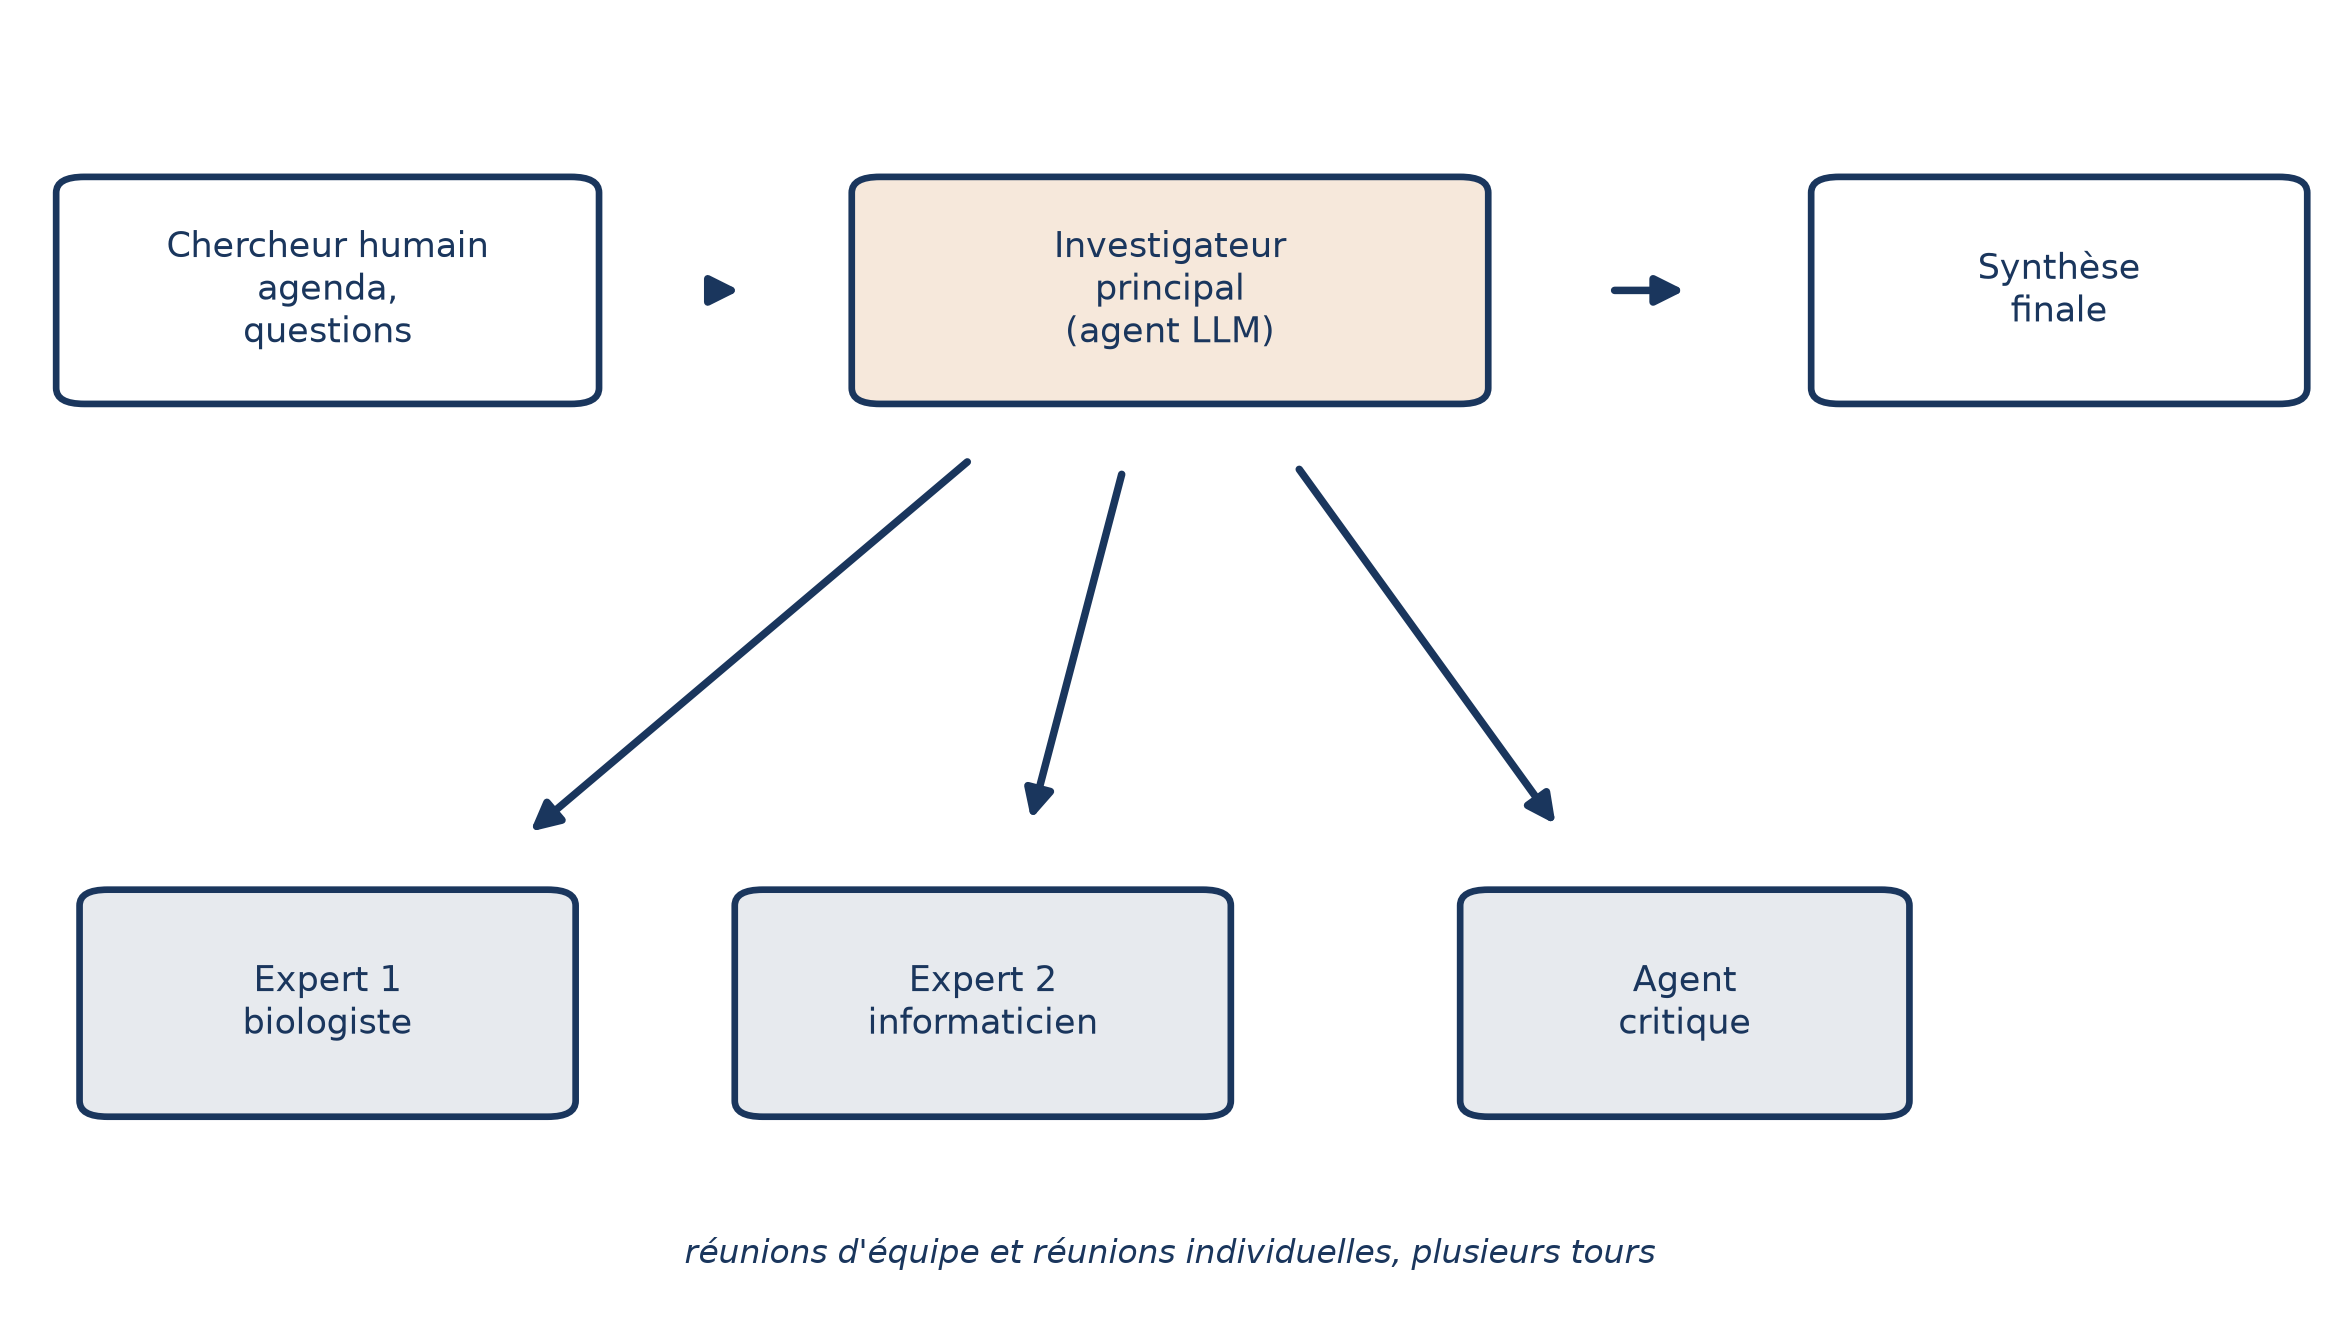
Même les systèmes les plus ambitieux gardent un humain dans la boucle. Dans un « laboratoire virtuel » conçu pour de la recherche interdisciplinaire, un chercheur humain fixe l’agenda ; un investigateur principal, lui-même agent LLM, dirige des agents experts et un agent critique à travers des réunions d’équipe et individuelles, puis rédige une synthèse finale.
Sans orientation, les modèles peuvent donner des réponses vagues, ne pas trancher si on ne le leur demande pas, ou s’écarter de la tâche. Et leurs connaissances s’arrêtent à une certaine date : ils peuvent ignorer les derniers outils publiés. La piste suggérée pour combler ce retard est justement le RAG, ou une recherche sur internet.