Après une tempête, on a mesuré cinq dimensions du corps de moineaux femelles pour tester la théorie de la sélection naturelle de Darwin. Le tableau est là, mais personne n’a écrit la question : aucune valeur à prédire, aucune réponse à viser. Pourtant, deux axes construits à partir de ces mesures rassemblent près de 83 % de la variance totale, et un simple graphique y fait ressortir les oiseaux atypiques. Voilà un apprentissage non supervisé : tu vas voir ce qu’il cherche, comment deux de ses outils s’y prennent, et quelles idées fausses les accompagnent.
Sommaire
- L’essentiel en 30 secondes
- Aucune réponse à prédire : ce qu’on cherche alors
- À quoi sert une structure découverte : voir, résumer, compléter, regrouper
- L’ACP : pivoter les axes vers là où ça varie
- Faire des paquets : k-moyennes puis dendrogramme
- Où le non supervisé se glisse dans un projet de prédiction
- Quatre idées reçues sur ce que ces méthodes trouvent
L’essentiel en 30 secondes
- Un apprentissage non supervisé travaille sur des mesures sans réponse associée : rien à prédire, une structure à faire apparaître.
- Cette structure prend deux formes : des groupes naturels d’observations, ou une représentation plus compacte de variables corrélées.
- L’ACP résume beaucoup de variables en quelques axes, et la variance expliquée dit si le résumé reste fidèle : près de 83 % pour deux axes sur cinq mesures de moineaux.
- Les k-moyennes fixent le nombre de groupes d’avance ; le clustering hiérarchique dessine un arbre où le dendrogramme se coupe à la hauteur voulue.
- Aucun résultat n’est une vérité unique : optimum local, linkage, normalisation changent ce que l’algorithme trouve.
Aucune réponse à prédire : ce qu’on cherche alors
Dans un apprentissage non supervisé, tu disposes seulement d’un ensemble de mesures  : pour chaque individu, une série de valeurs, et rien d’autre. Pour chaque moineau, ce sont ses cinq mesures corporelles ; aucune réponse
 n’y est rattachée. Le but devient de faire apparaître une structure à l’intérieur des données.
Cette structure prend deux formes : des groupes naturels d’observations, ou une représentation plus compacte de variables fortement corrélées entre elles. À chacune son outil. Le clustering, ou classification non supervisée, répartit les observations en groupes tels que celles d’un même groupe se ressemblent davantage entre elles qu’avec celles des autres.
L’analyse en composantes principales (ACP) cherche, elle, un petit nombre de dimensions synthétiques qui capturent l’essentiel de la variabilité présente dans les données d’origine. Ces deux outils structurent la suite.
💡 Intuition Tu ne cherches pas à deviner une valeur, tu demandes aux données ce qu’elles montrent d’elles-mêmes. Un groupe dit « ces individus se ressemblent » ; un axe dit « ces variables racontent presque la même chose ».
À quoi sert une structure découverte : voir, résumer, compléter, regrouper
Une structure découverte rend des services très différents, et pas seulement en statistique classique. Le tableau les range par besoin.
| Besoin | Outil | Ce que ça donne |
|---|---|---|
| Voir des données à nombreuses variables | ACP | une projection sur deux ou trois composantes |
| Résumer et repérer l’atypique | ACP | deux axes pour cinq mesures de moineaux |
| Boucher des valeurs manquantes | ACP itérative | des évaluations d’utilisateurs complétées |
| Regrouper des phrases | k-moyennes | un découpage de texte par proximité de sens |
| Fusionner des variantes d’une même entité | clustering | un seul nœud cohérent dans un graphe |
Pour voir, le problème est simple : dès que le nombre de variables  dépasse deux ou trois, un nuage de points ordinaire devient impossible. L’ACP y répond en projetant les observations sur les deux ou trois premières composantes.
Pour boucher les trous, prends un système de recommandation : la matrice des évaluations des utilisateurs pour différents produits est presque toujours très incomplète. La complétion de matrice par ACP reconstruit alors les composantes et les valeurs manquantes ensemble, en alternant entre les deux jusqu’à convergence, avec un résultat nettement plus robuste que la moyenne.
Hors des tableaux de mesures, les mêmes idées servent aussi sur du texte. Pour découper un document, on plonge ses phrases dans un espace numérique puis on regroupe les phrases semblables par k-moyennes : il faut régler le nombre de groupes, et l’ordre des phrases risque de se perdre.
Dans un graphe de connaissances, la résolution d’entités fusionne les variantes de nommage d’une même entité réelle en un seul nœud, notamment grâce à des algorithmes de clustering. Les seuils qui conviennent à des organisations financières donneraient des résultats médiocres sur des entités biologiques. Quant aux neurones d’un Transformer, on réduit d’abord leur dimension pour visualiser leurs activations, avec une factorisation de matrices non négatives plutôt que l’ACP, afin d’éviter les activations négatives.
L’ACP : pivoter les axes vers là où ça varie
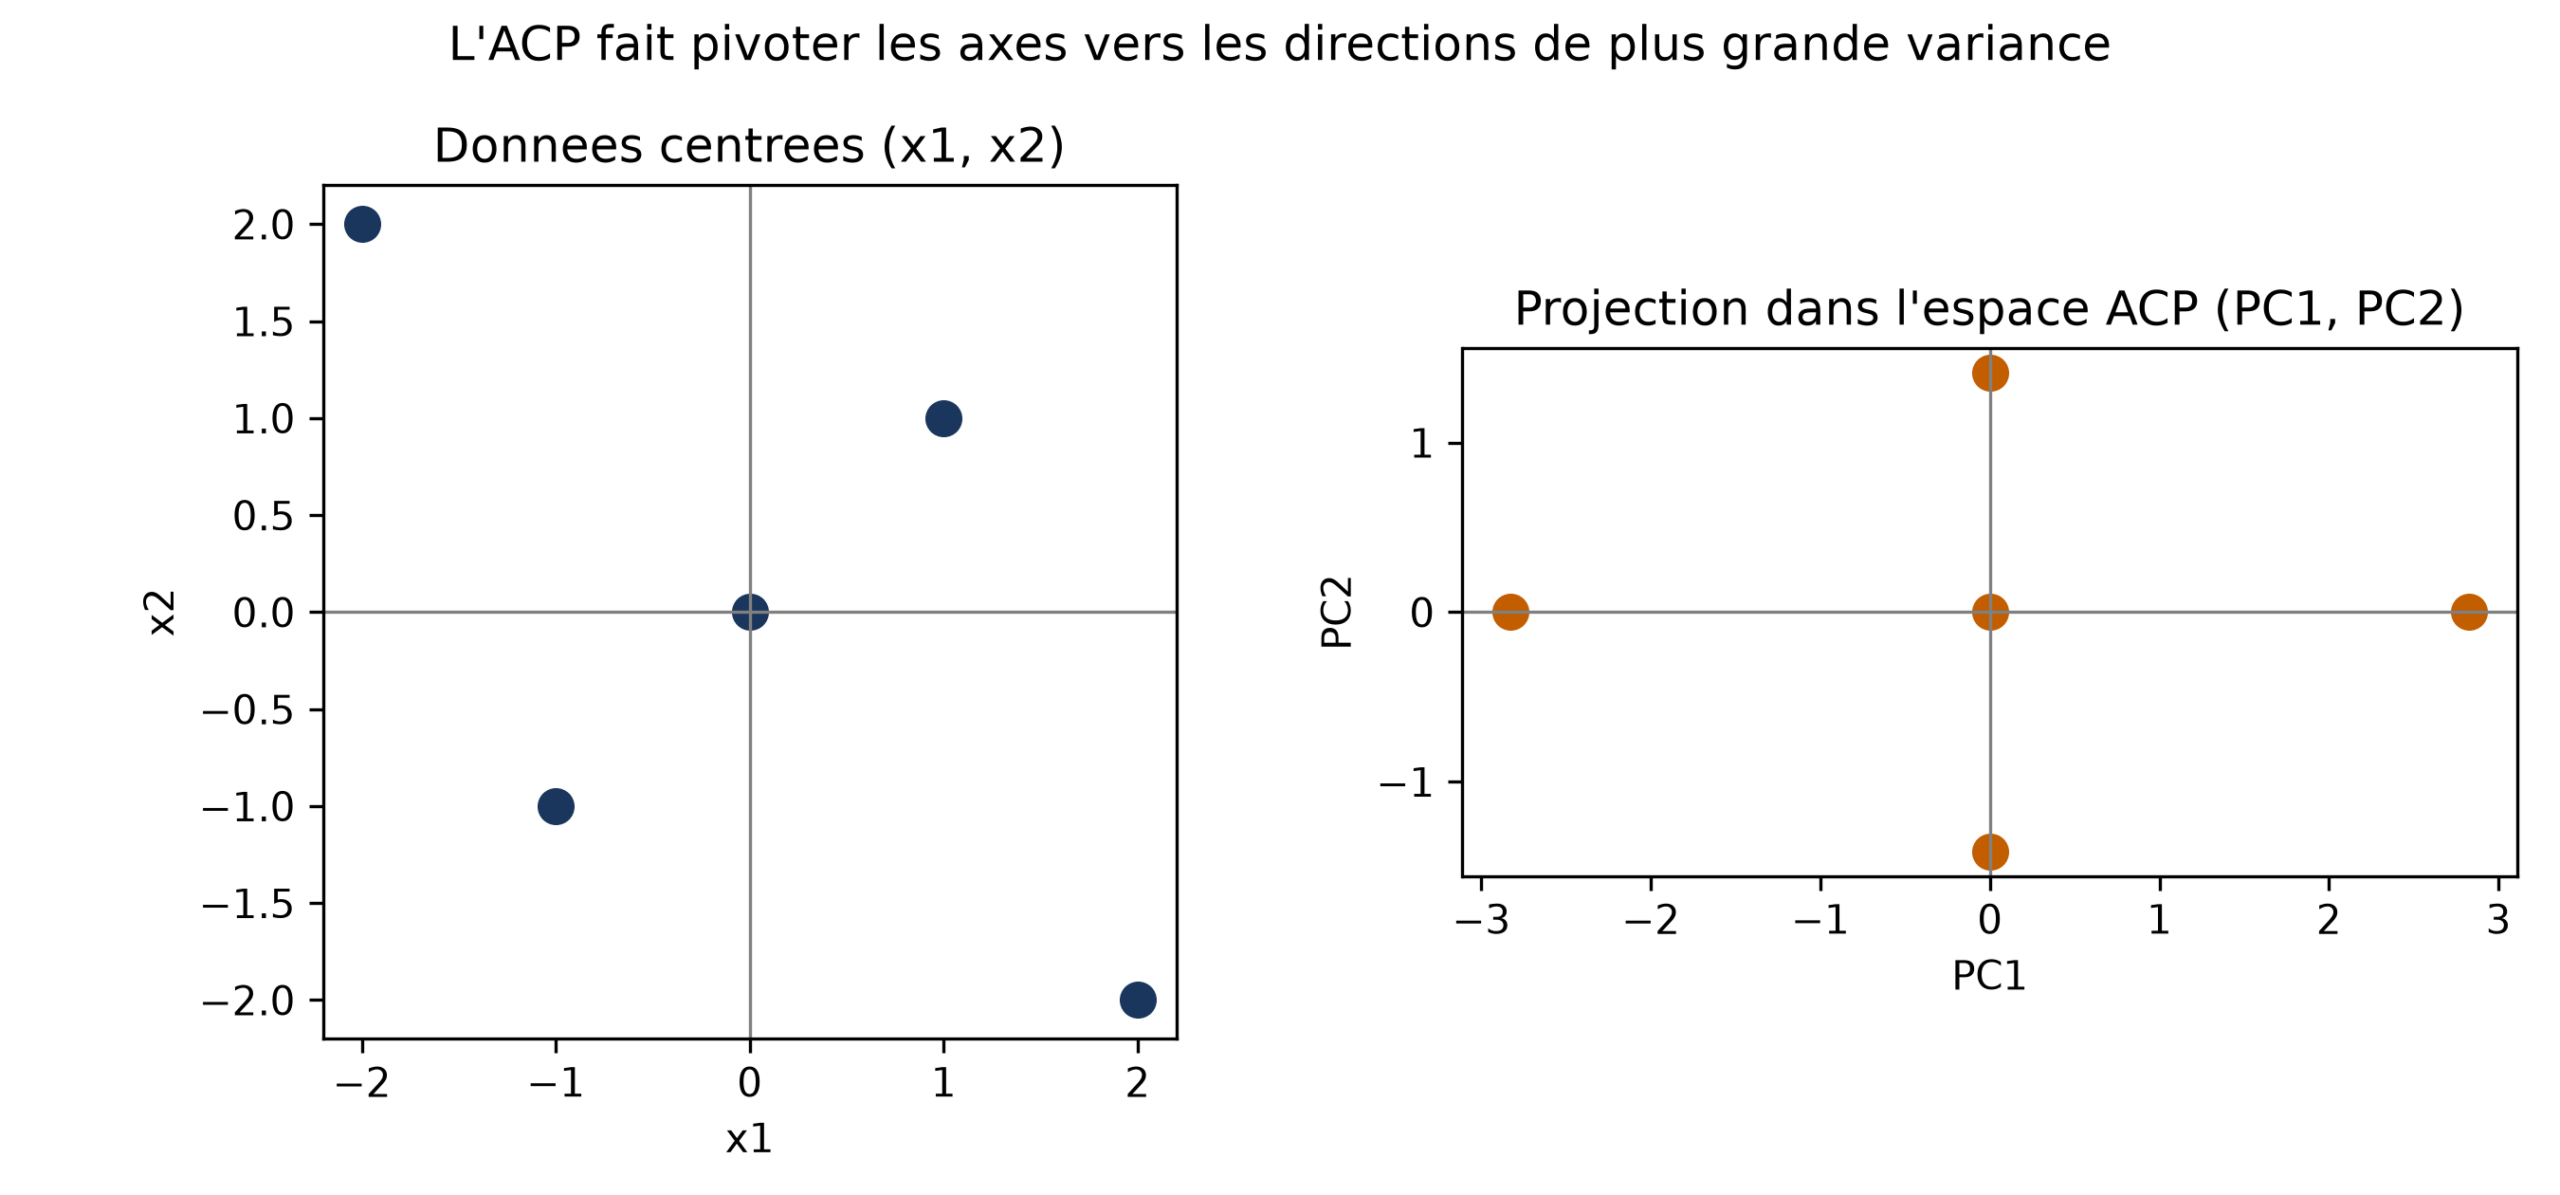
Prends cinq points décrits par deux attributs, centrés autour de zéro. L’ACP ressemble à une simple rotation des axes : on fait pivoter le repère pour que la plus grande dispersion des données s’aligne sur l’axe horizontal.
La première composante : la direction qui étale le plus
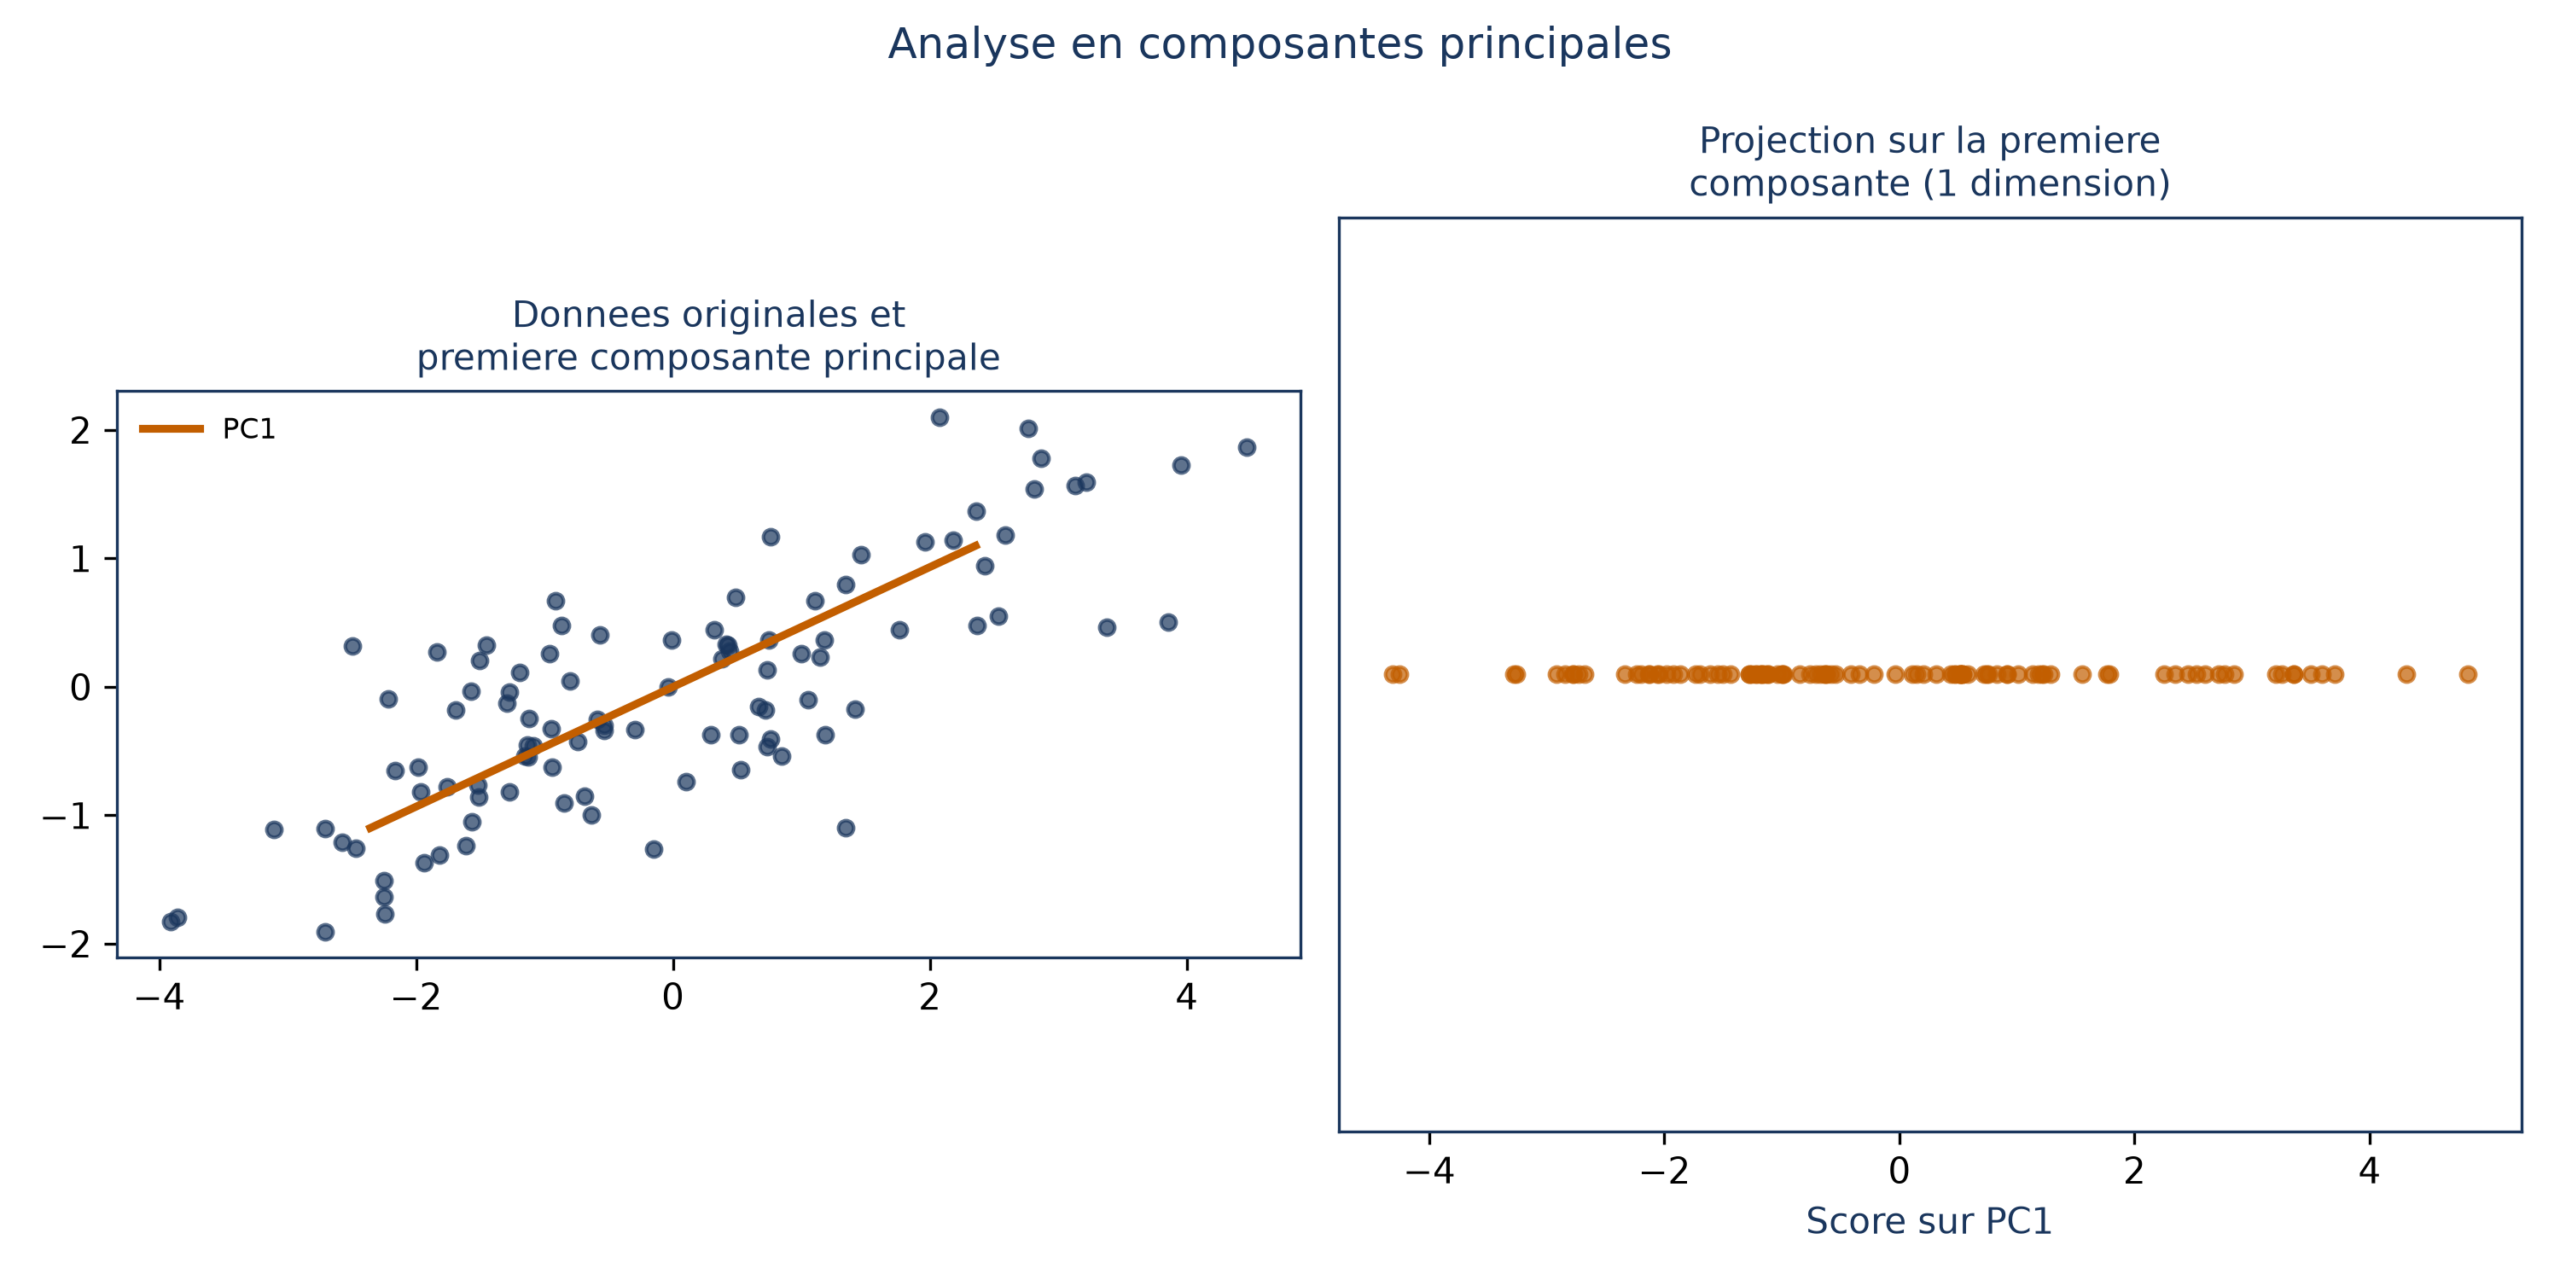
La première composante principale est la direction de l’espace des variables le long de laquelle les observations varient le plus. C’est la combinaison linéaire
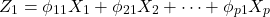
dont la variance est maximale parmi toutes les combinaisons possibles. Les  sont les poids des variables, contraints par
 : sans cette contrainte, la variance pourrait croître indéfiniment.
La deuxième composante se construit de la même façon, avec une exigence en plus : être non corrélée à la première, donc orthogonale à elle. On poursuit jusqu’à composantes, chacune orthogonale aux précédentes et capturant une part de variance de plus en plus faible.
La recette en cinq temps
Concrètement, une ACP suit cinq étapes :
- prétraiter les données, c’est-à-dire les centrer, et généralement les normaliser pour leur donner une variance unitaire ;
- calculer leur matrice de covariance ;
- en extraire les vecteurs propres et les valeurs propres ;
- sélectionner les
 premières composantes, souvent
 pour une visualisation ;
- projeter les données normalisées sur ces composantes par une simple multiplication matricielle.
La covariance mesure la variation linéaire conjointe de deux variables  et
 sur
 observations :
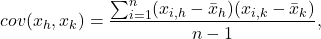
où  est la moyenne de la variable
 . Un signe positif ou négatif indique si elles évoluent ensemble ou à contresens. Rassemblées dans un tableau
 , ces covariances forment la matrice de covariance
 , toujours symétrique (la covariance d’une variable avec elle-même est sa variance).
Le résultat clé est que les composantes principales sont les vecteurs propres de , ordonnés par valeurs propres décroissantes 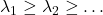 . En maximisant la variance de la projection sous la contrainte d’un axe de norme 1, on aboutit à

c’est-à-dire que  est un vecteur propre de . Et la variance capturée égale la valeur propre : la première composante porte exactement
 .
Combien d’axes garder ?
Chaque composante porte une part de la variance totale. Le rapport

donne le pourcentage de variation capturé par la  -ième composante, et la somme de ces rapports sur les deux premières dit si une projection en deux dimensions reste fidèle aux données d’origine.
On lit cette proportion de variance expliquée sur un scree plot, ou graphique d’éboulis : il la trace pour chaque composante, par ordre décroissant. On y cherche un coude, au-delà duquel les composantes supplémentaires ne rajoutent plus qu’une contribution marginale.
📌 À retenir Pour les moineaux, les deux premières composantes portent près de 83 % de la variance totale : c’est ce chiffre qui autorise à dessiner la carte en deux dimensions et à y chercher les individus atypiques.
Le même calcul en Python
Imagine maintenant que tu tiens un tableau de mesures, ici USArrests, déjà chargé, et que tu veux savoir combien d’axes en résument l’essentiel. Les blocs ci-dessous sont des sessions Python interactives : In [n]: marque une commande que tu tapes, numérotée dans l’ordre de la session.
In [8]: scaler = StandardScaler(with_std=True,
                                   with_mean=True)
        USArrests_scaled = scaler.fit_transform(USArrests)
        pcaUS = PCA()
        pcaUS.fit(USArrests_scaled)

In [12]: pcaUS.explained_variance_ratio_
StandardScaler centre et réduit les variables, ce qui correspond à la première étape de la recette ; PCA() calcule les composantes. L’attribut explained_variance_ratio_ donne la proportion de variance expliquée par chaque composante, dans l’ordre décroissant : ce sont exactement les valeurs du scree plot. Les coordonnées des observations projetées s’obtiennent avec .transform().
Faire des paquets : k-moyennes puis dendrogramme
Le clustering a deux grandes approches : le partitionnement en k-moyennes (K-means) et le clustering hiérarchique. Elles ne demandent pas le même effort au départ.
K-moyennes : fixer K, puis alterner deux gestes
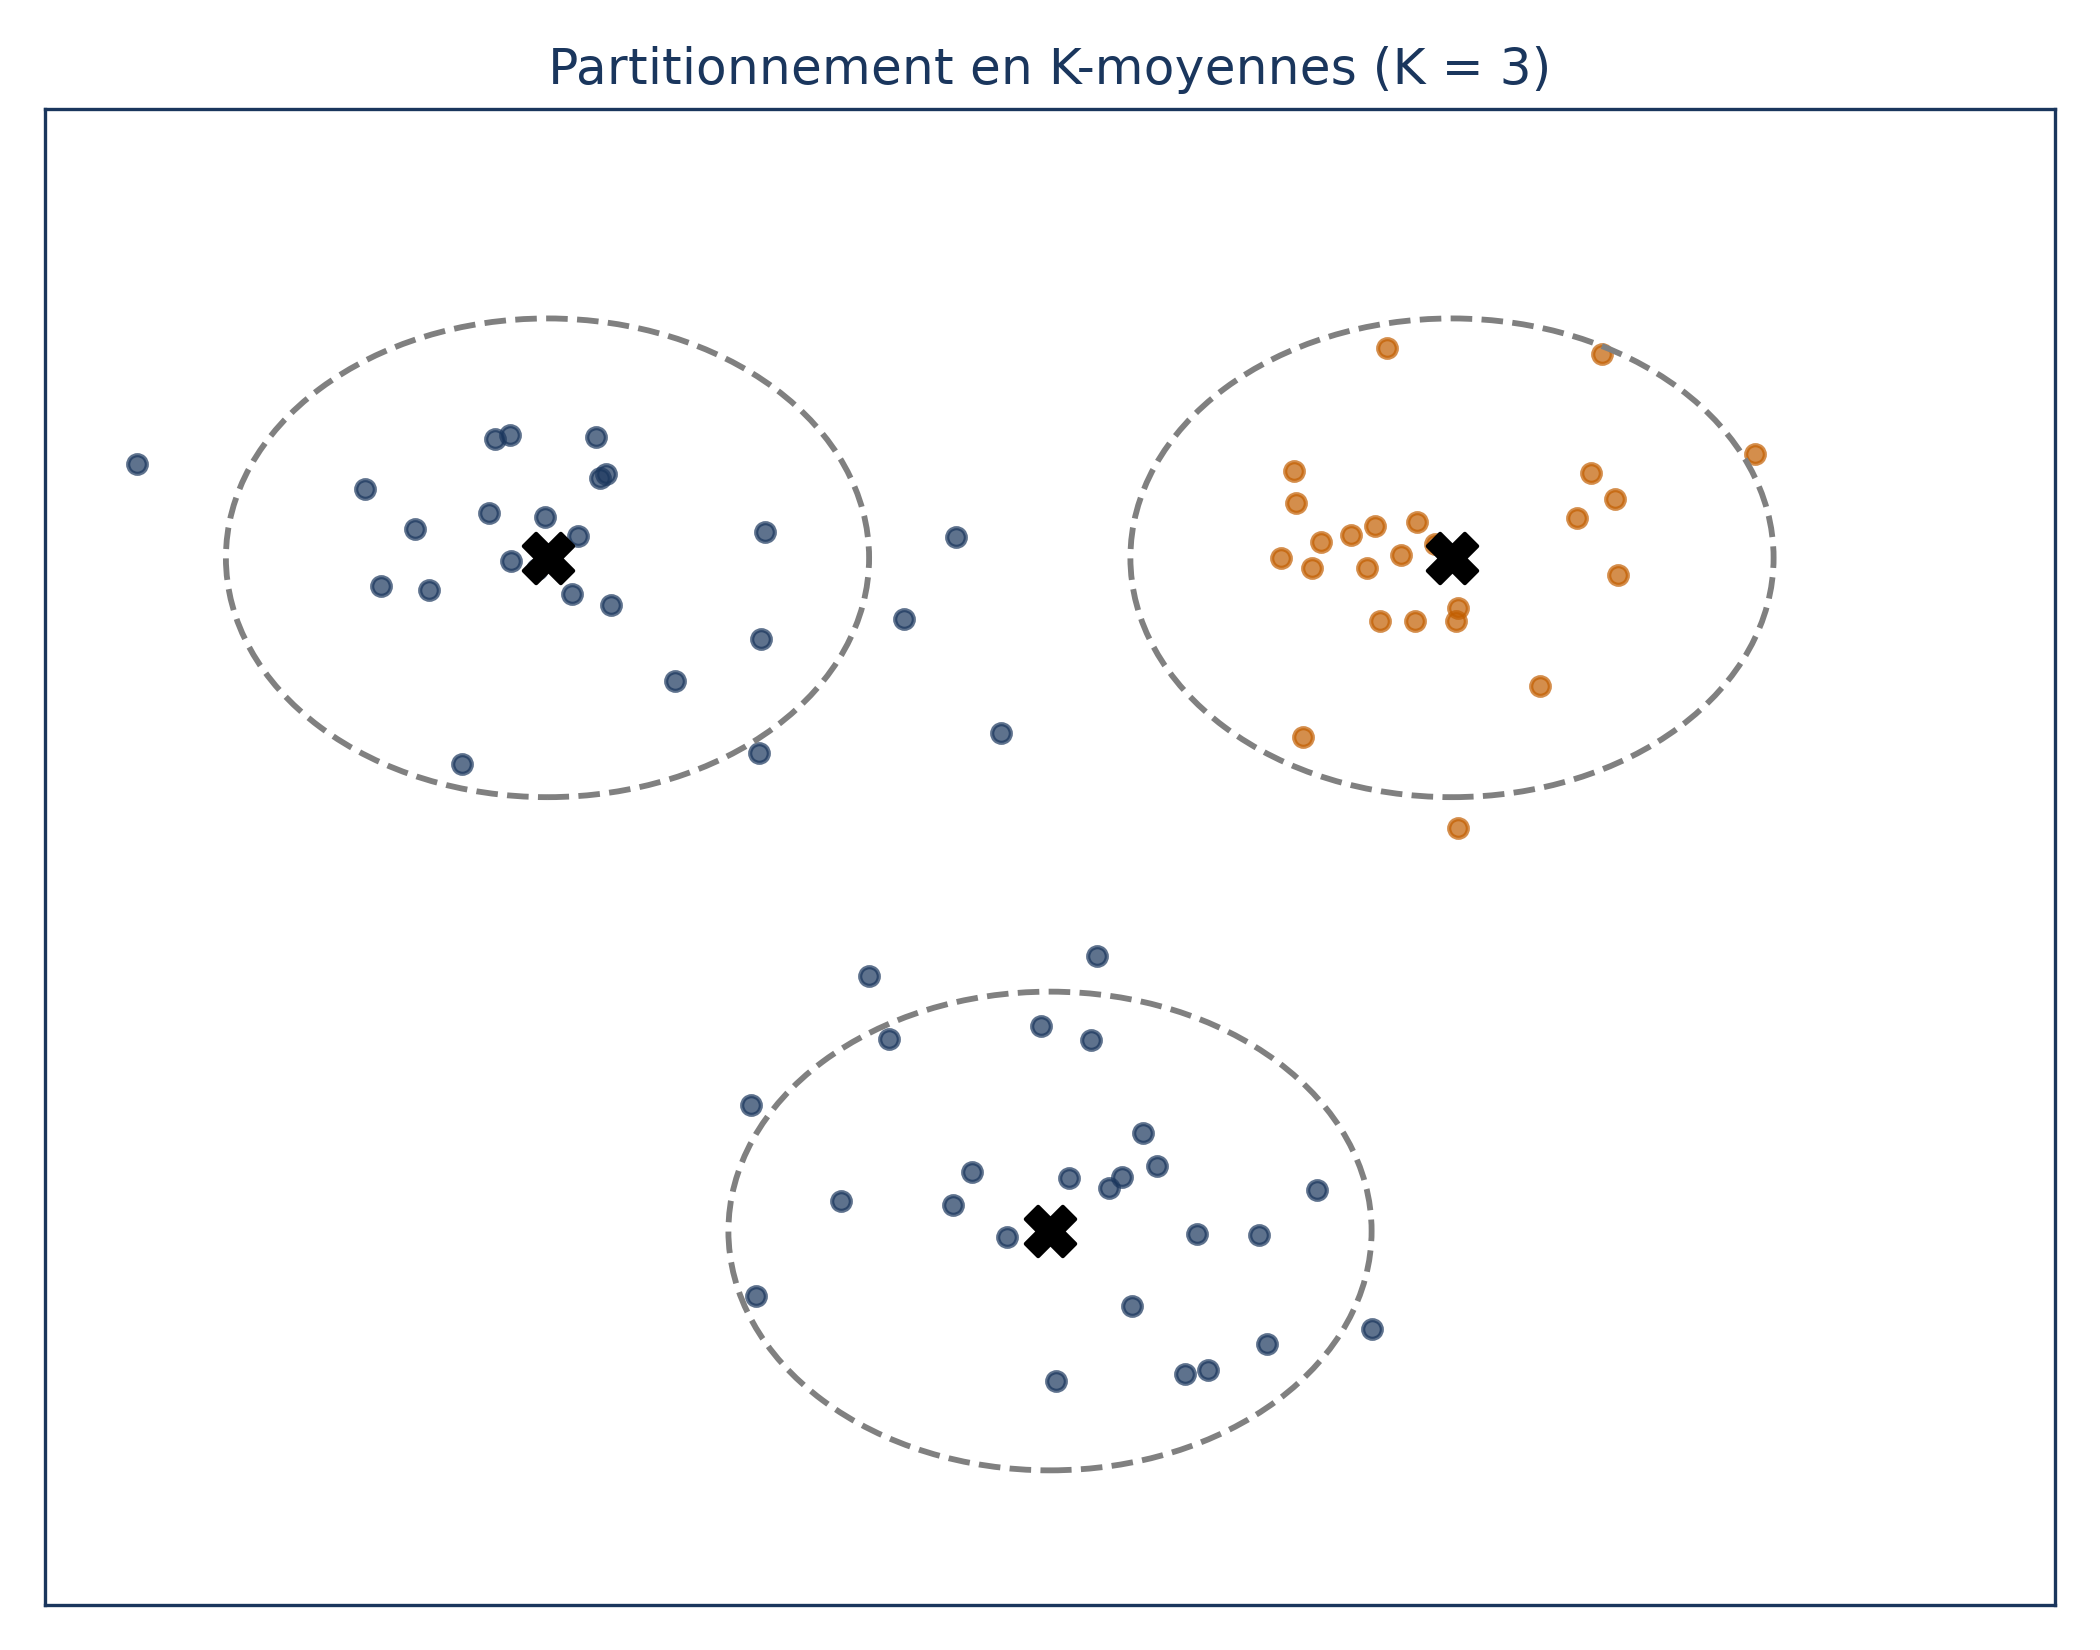
Les k-moyennes exigent de fixer d’emblée le nombre K de groupes. L’algorithme cherche alors la partition en K groupes qui minimise la variation intra-groupe totale : la somme, pour chaque groupe, des distances au carré entre chaque observation et le centre de son groupe, appelé centroïde.
Tester toutes les partitions est hors de portée : il existe  façons de répartir observations en
 groupes. On procède donc par un algorithme itératif qui alterne deux étapes, à partir d’une affectation initiale aléatoire, jusqu’à ce qu’aucune réaffectation ne change plus la partition :
- recalculer le centroïde de chaque groupe, c’est-à-dire la moyenne des observations qui lui sont affectées ;
- réaffecter chaque observation au groupe dont le centroïde est le plus proche.
Le dendrogramme : ne pas fixer K
Le clustering hiérarchique évite de fixer K à l’avance. Son principe, dit agglomératif : on part de groupes réduits chacun à une observation, et à chaque étape on fusionne les deux groupes les plus proches, jusqu’à n’en garder qu’un seul. La suite des fusions se dessine en dendrogramme, un arbre inversé dont chaque jonction se place à une hauteur proportionnelle à la dissimilarité entre les deux groupes fusionnés.
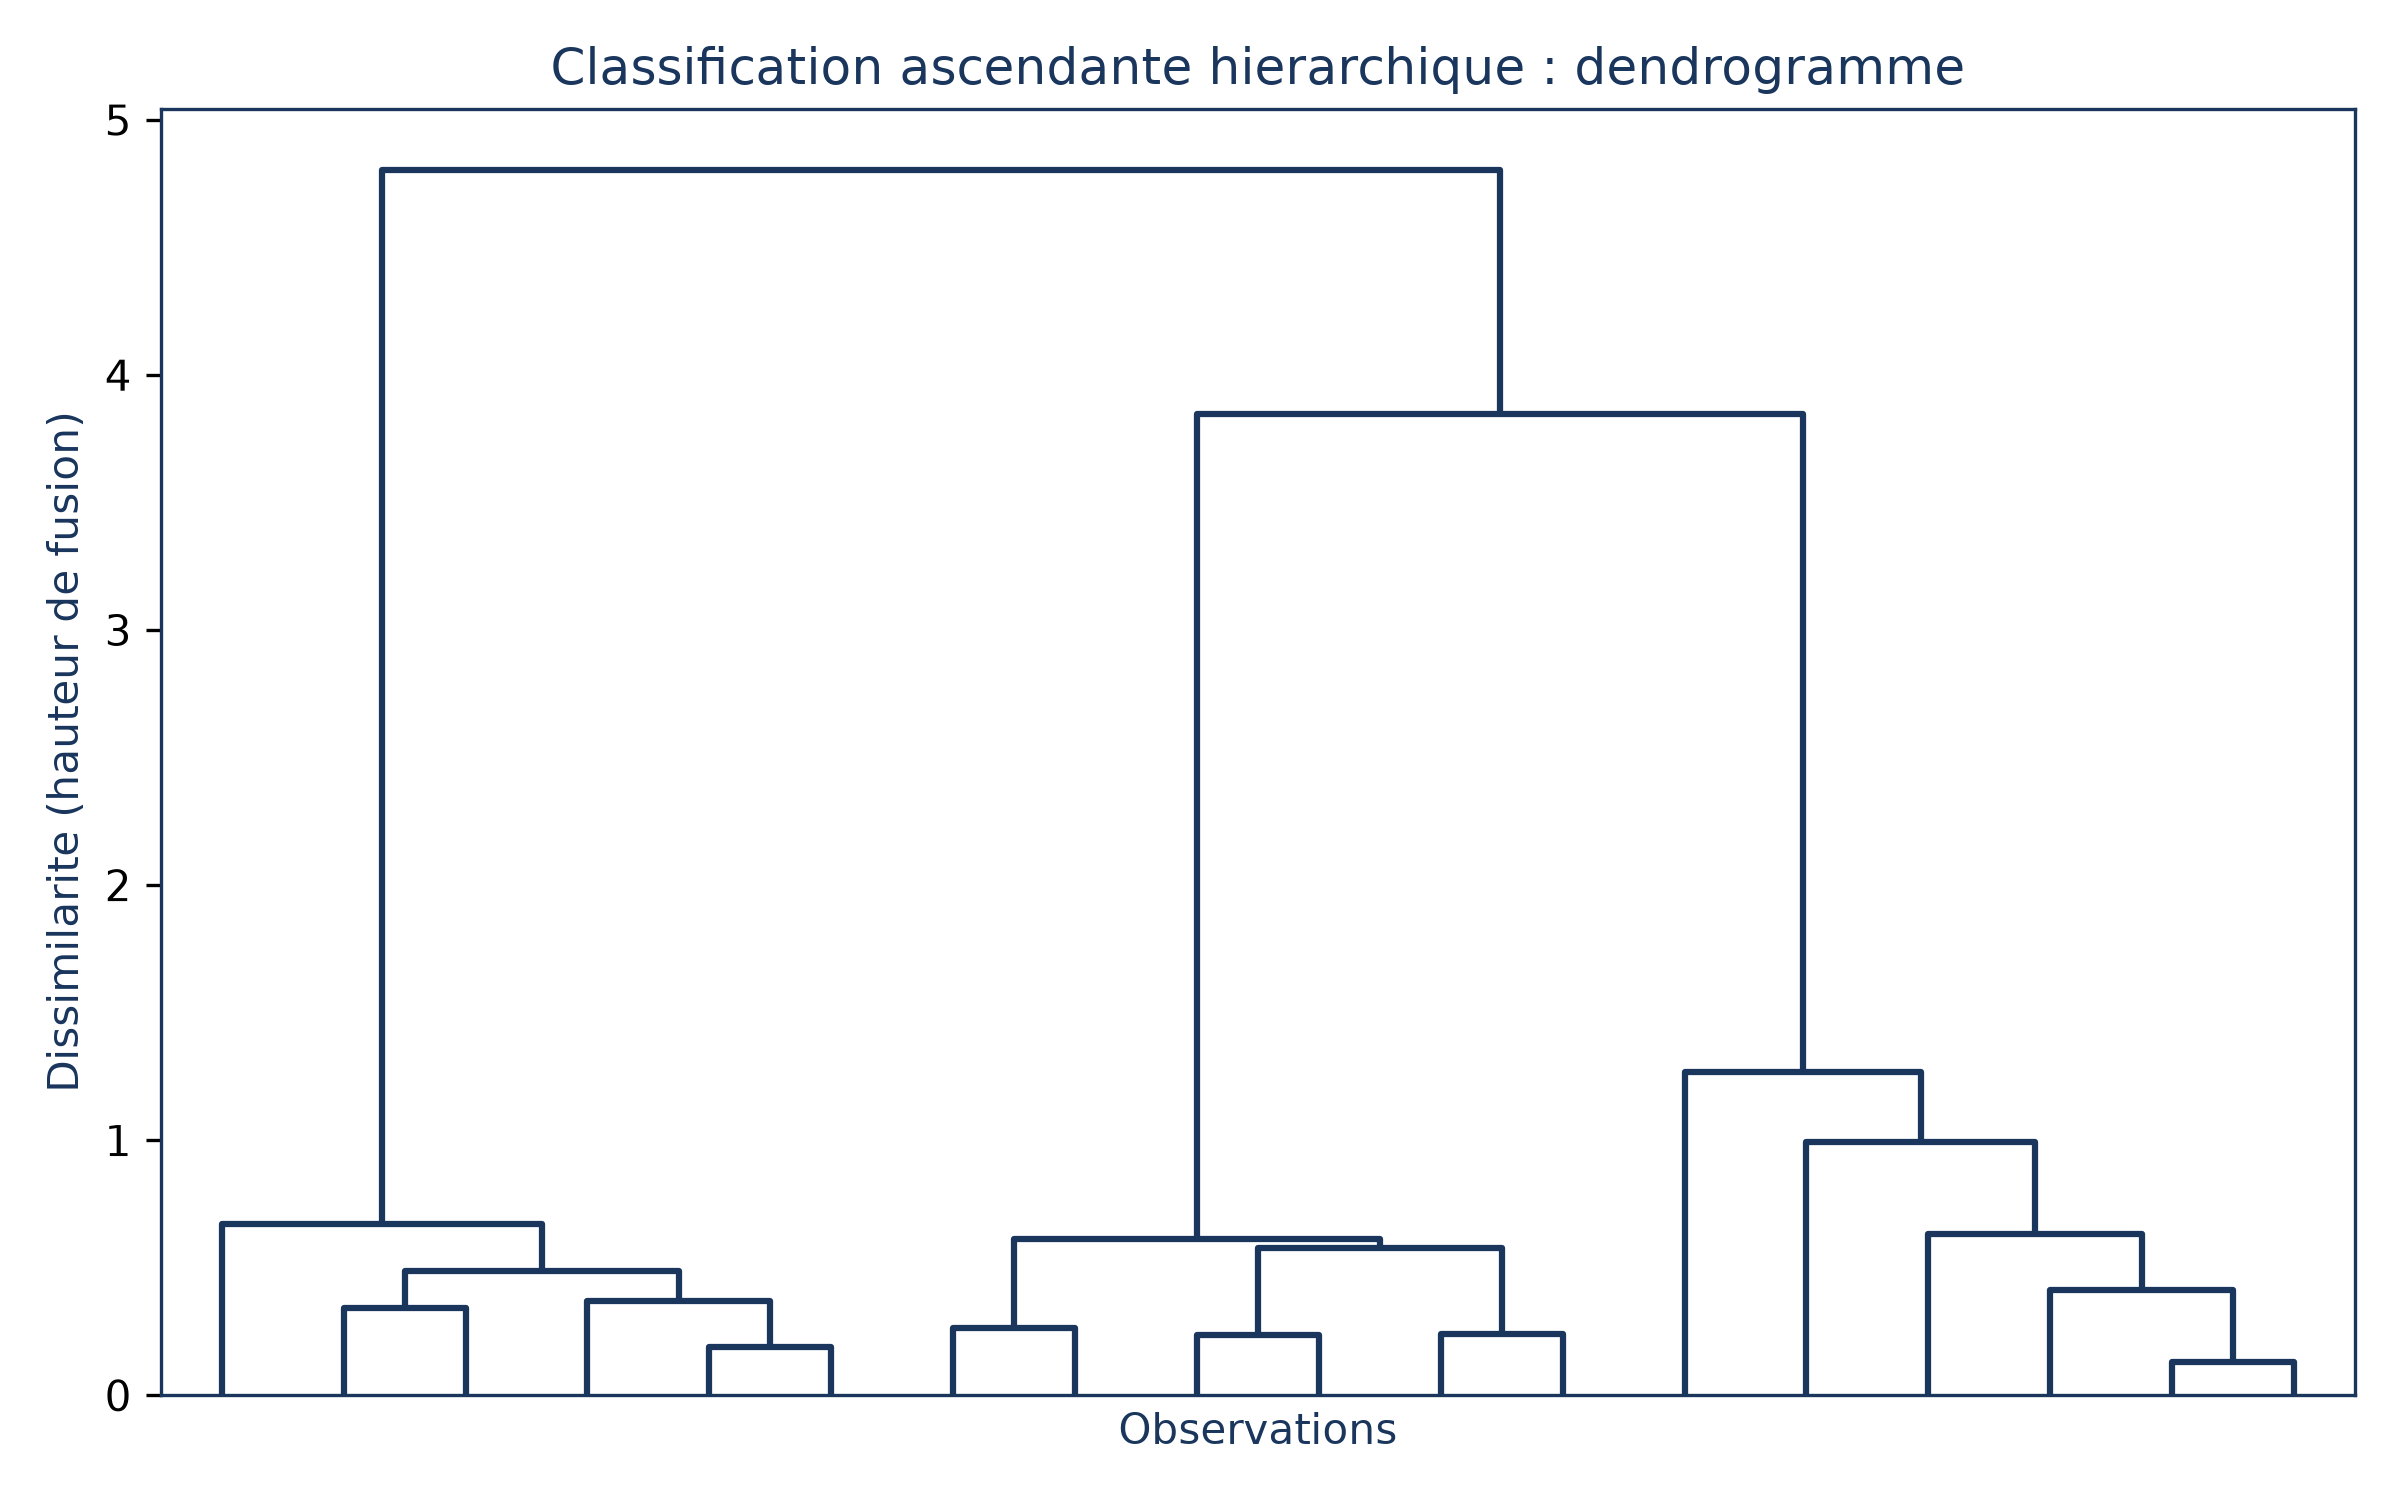
Pour obtenir un nombre précis de groupes, coupe l’arbre horizontalement : plus la coupe est basse, plus tu obtiens de groupes. Un seul arbre donne tous les découpages, sans jamais relancer l’algorithme.
Reste une question : que veut dire « les deux groupes les plus proches » ? Il faut une dissimilarité non seulement entre observations (le plus souvent la distance euclidienne), mais aussi entre groupes : c’est le rôle du linkage. Trois choix reviennent :
- le linkage complet retient la plus grande distance entre deux observations, une de chaque groupe ;
- le linkage moyen retient la distance moyenne entre toutes les paires ;
- le linkage simple retient la plus petite distance, et tend à produire des chaînes étirées et déséquilibrées.
Les deux premiers sont les plus utilisés, car ils produisent des dendrogrammes équilibrés.
Passons à la pratique, avec un tableau de mesures X déjà chargé : deux groupes par k-moyennes, puis un arbre hiérarchique complet.
In [24]: kmeans = KMeans(n_clusters=2,
                            random_state=2,
                            n_init=20).fit(X)
         kmeans.labels_

In [31]: hc_comp = HClust(distance_threshold=0,
                             n_clusters=None,
                             linkage='complete')
         hc_comp.fit(X)
n_clusters=2 demande deux groupes, et n_init=20 multiplie les départs : on verra plus bas pourquoi c’est une précaution. Côté hiérarchique, linkage='complete' choisit le linkage complet, et n_clusters=None avec distance_threshold=0 laisse l’arbre se construire jusqu’au bout, sans nombre de groupes fixé.
Où le non supervisé se glisse dans un projet de prédiction
Un projet de données n’est pas une ligne droite : on collecte, on explore, on modélise, on présente, et chaque étape peut renvoyer à la précédente, comme une roue qui tourne. Si la modélisation révèle qu’il manque une caractéristique importante, on retourne collecter des données. C’est à l’étape d’exploration que l’ACP entre en scène, pour visualiser des données à plusieurs dimensions, aux côtés d’outils élémentaires comme les boîtes à moustaches qui repèrent la dispersion des valeurs.
L’ACP peut aussi se placer en amont d’une prédiction. La régression sur composantes principales (PCR) construit  combinaisons linéaires des prédicteurs,
 , qu’elle confie ensuite à une régression ordinaire. Ces combinaisons se fabriquent sans jamais regarder la réponse : on parie que les directions de plus forte variance sont aussi les plus associées à la réponse, pari raisonnable en pratique mais jamais garanti.
Les moindres carrés partiels (PLS) corrigent ce défaut en construisant les combinaisons de façon supervisée : la première direction donne le plus grand poids aux prédicteurs les plus fortement corrélés à la réponse. Mais PLS ne fait pas forcément mieux. Le gain en biais (l’erreur d’un modèle trop simple) se paie souvent d’une variance accrue (l’estimation change davantage d’un échantillon à l’autre), et le bénéfice net reste le plus souvent à peu près nul.
Dans le code, la PCR s’écrit en chaînant la réduction de dimension et la régression linéaire dans un même Pipeline. X contient les prédicteurs, Y la réponse, et M le nombre de composantes à garder.
In [24]: pca = PCA(n_components=M)
         linreg = skl.LinearRegression()
         pipe = Pipeline([('pca', pca),
                            ('linreg', linreg)])
         pipe.fit(X, Y)
Faire varier n_components et évaluer chaque pipeline par validation croisée permet de retrouver le nombre optimal de composantes pour les données considérées.
Quatre idées reçues sur ce que ces méthodes trouvent
« L’algorithme trouve le meilleur découpage »
Les k-moyennes convergent toujours, mais vers un optimum local, jamais nécessairement global : le résultat dépend de l’affectation initiale tirée au hasard. D’où la précaution n_init=20 du code plus haut. On relance l’algorithme depuis des départs différents et on garde la solution qui minimise le plus la variation intra-groupe totale.
« Deux feuilles voisines se ressemblent »
Sur un dendrogramme, l’ordre gauche-droite des feuilles n’a aucune signification : chaque fusion peut pivoter librement sans changer la structure de l’arbre. Deux observations côte à côte ne sont donc pas forcément proches. Seule compte la hauteur à laquelle elles fusionnent.
« L’ACP choisit les bonnes variables »
La PCR n’est pas une méthode de sélection de variables : chaque composante retenue reste une combinaison de tous les prédicteurs d’origine. L’ACP extrait de nouvelles caractéristiques, alors que la sélection se contente de retenir un sous-ensemble des attributs d’origine, sans les combiner.
Un exemple de sélection : on calcule la corrélation entre toutes les paires de caractéristiques, on repère la paire la plus corrélée, on retire celle des deux dont la corrélation moyenne avec les autres est la plus élevée, puis on recommence jusqu’à ce qu’aucune corrélation ne dépasse le seuil fixé.
« Normaliser, c’est de la cosmétique »
Centrer les données place l’origine au centre du nuage et facilite l’interprétation. Normaliser, c’est donner à chaque variable une variance unitaire : cela évite qu’une caractéristique domine le calcul parce que son unité produit de grandes valeurs. Or répéter l’ACP avant puis après normalisation peut conduire à des directions principales sensiblement différentes, car la normalisation change la contribution de chaque dimension à la variance totale.
📌 À retenir Un apprentissage non supervisé ne rend pas de verdict : il propose des axes et des groupes dont la forme dépend de réglages que tu fixes, du point de départ des k-moyennes au linkage, en passant par la normalisation.