Un client te confie les ventes de son produit dans 200 marchés, avec, pour chacun, ses budgets de publicité à la télévision, à la radio et dans la presse. Il ne peut pas toucher aux ventes, mais il règle ses budgets : à toi de lui dire où placer son argent. Pour répondre, tu vas chercher dans ces cas déjà observés une règle qui relie les budgets aux ventes, puis la tester sur des marchés que tu n’as jamais vus. Voilà l’apprentissage supervisé, et cette page t’en donne les pièces, la mécanique et le principal piège.
Sommaire
- L’essentiel en 30 secondes
- Un client, 200 marchés et une fonction que personne ne connaît
- À quoi sert d’estimer cette fonction : prédire ou comprendre
- Un nombre ou une catégorie : régression ou classification
- Un cas concret en code : qui va faire défaut sur sa carte ?
- Comment la machine apprend : trois jeux de données et une erreur à réduire
- Le piège de l’apprentissage par cœur
- Ce qui change quand il n’y a plus de réponse à comparer
L’essentiel en 30 secondes
- Un apprentissage supervisé cherche une règle entrées vers sortie à partir de cas dont la réponse est connue, puis l’applique à de nouveaux cas.
- La nature de la sortie décide du problème : un nombre donne une régression, une catégorie donne une classification.
- Le modèle s’ajuste sur des exemples, se règle sur un second jeu et se juge sur des données jamais vues.
- Le piège central est le surajustement : un modèle trop souple épouse le bruit des exemples et prédit mal ailleurs.
- Sans réponse à comparer, il n’y a plus d’erreur de test : c’est le terrain de l’apprentissage non supervisé.
Un client, 200 marchés et une fonction que personne ne connaît
Reprends ta mission. Les budgets de publicité sont des variables d’entrée, notées  avec un indice pour les distinguer :
 pour la télévision,
 pour la radio,
 pour la presse. Les ventes forment la variable de sortie, notée
 . On parle aussi de prédicteurs ou de features pour les entrées, et de réponse pour la sortie.
Pour chacun des 200 marchés, tu connais les entrées et la sortie observée ensemble. Dans un apprentissage supervisé, chaque observation des prédicteurs  est ainsi accompagnée d’une mesure de réponse
 : cette réponse « supervise » l’analyse, au sens où elle sert de repère.
Ce que tu cherches, c’est la relation entre les deux. Le modèle de départ s’écrit :
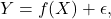
Les entrées sont regroupées dans 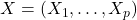 . La lettre
 désigne une règle fixe, que personne ne connaît, qui fait passer des entrées à la sortie ;
 est un aléa de moyenne nulle, sans lien avec . Ce que les budgets apportent vraiment sur les ventes, c’est l’information systématique portée par ; ramasse le reste. Apprendre, c’est estimer à partir des données.
💡 Intuition Vois
À quoi sert d’estimer cette fonction : prédire ou comprendre
Le client n’agit pas directement sur les ventes, mais s’il existe une association entre publicité et ventes, tu peux l’aider à les augmenter indirectement en orientant ses dépenses. Tes questions de consultant sont alors naturelles :
- existe-t-il seulement une relation entre budget et ventes, et est-elle forte ?
- quels médias y contribuent, et dans quelle mesure ?
- peut-on prédire les ventes futures avec une précision raisonnable ?
- la relation est-elle une droite, et deux budgets combinés produisent-ils plus que la somme de leurs effets ?
Elles se rangent en deux raisons d’estimer : la prédiction et l’inférence.
Pour la prédiction, tu disposes d’entrées faciles à mesurer alors que la sortie ne l’est pas, et tu prédis par  , où
 est ton estimation de . La forme exacte de importe peu : tu la traites en boîte noire tant qu’elle prédit juste. Un cas médical : des prises de sang simples permettent d’estimer qu’un patient risque une réaction grave à un traitement ; on évite alors de le lui prescrire, sans avoir à comprendre la biologie en jeu.
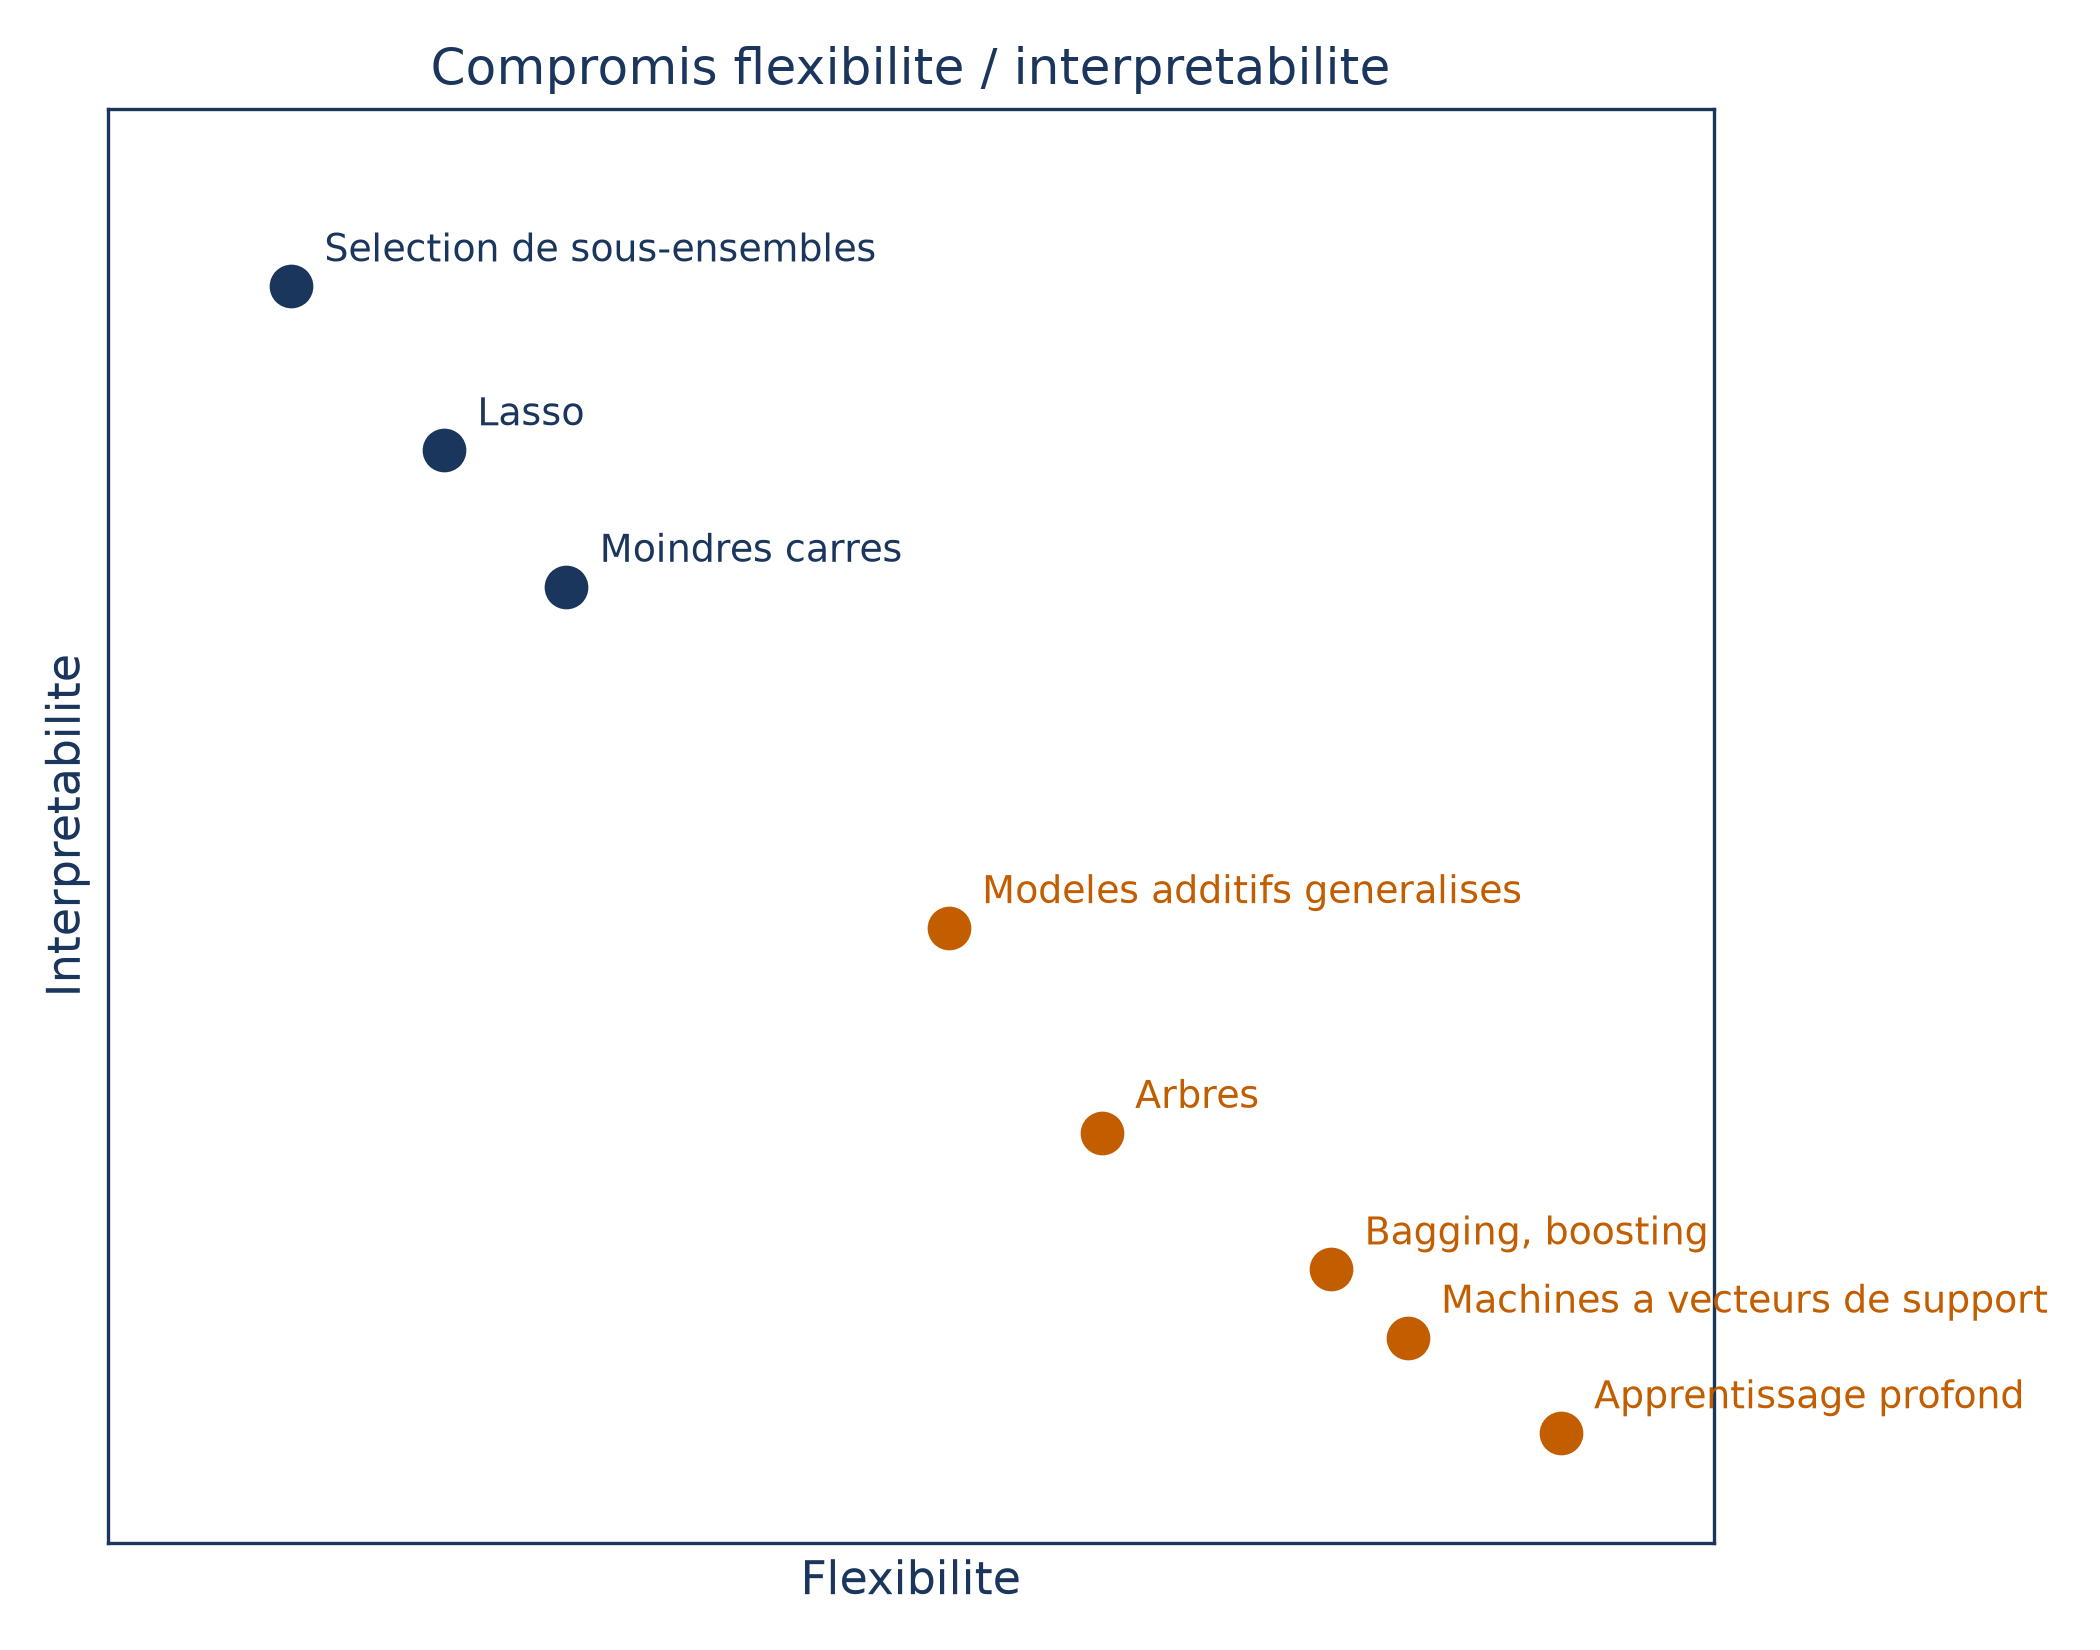
Pour l’inférence, ton but est de comprendre comment dépend des entrées. Là, la lisibilité compte : il est bien plus facile de lire cette dépendance dans une régression linéaire que dans un réseau de neurones profond. Les deux objectifs n’orientent donc pas forcément vers les mêmes méthodes.
Un nombre ou une catégorie : régression ou classification
Une fois la question posée, la nature de la sortie fixe le type de problème. Quand elle est quantitative (un âge, un revenu, un prix), on parle de régression. Quand elle est qualitative, c’est-à-dire l’une de  catégories possibles (un statut marital, une marque, un diagnostic), on parle de classification.
| Ce que tu prédis | Type de problème | Exemple tiré du terrain |
|---|---|---|
| Une valeur numérique | Régression | le prix d’une maison d’après son nombre de chambres et sa localisation |
| Une catégorie | Classification | l’indice boursier montera-t-il (Up) ou descendra-t-il (Down) demain ? |
Côté régression, prends un jeu de salaires d’hommes de la région atlantique des États-Unis. Le salaire augmente avec l’âge jusque vers 60 ans environ, puis diminue ; il croît aussi, plus modestement, entre 2003 et 2009 et avec le niveau d’éducation. Aucune variable seule ne suffit pour prédire un salaire : il faut combiner l’âge, l’éducation et l’année, en admettant que la relation avec l’âge n’est pas une droite.
Côté classification, l’idée est de tracer des frontières de décision qui séparent les classes présentes dans les données.
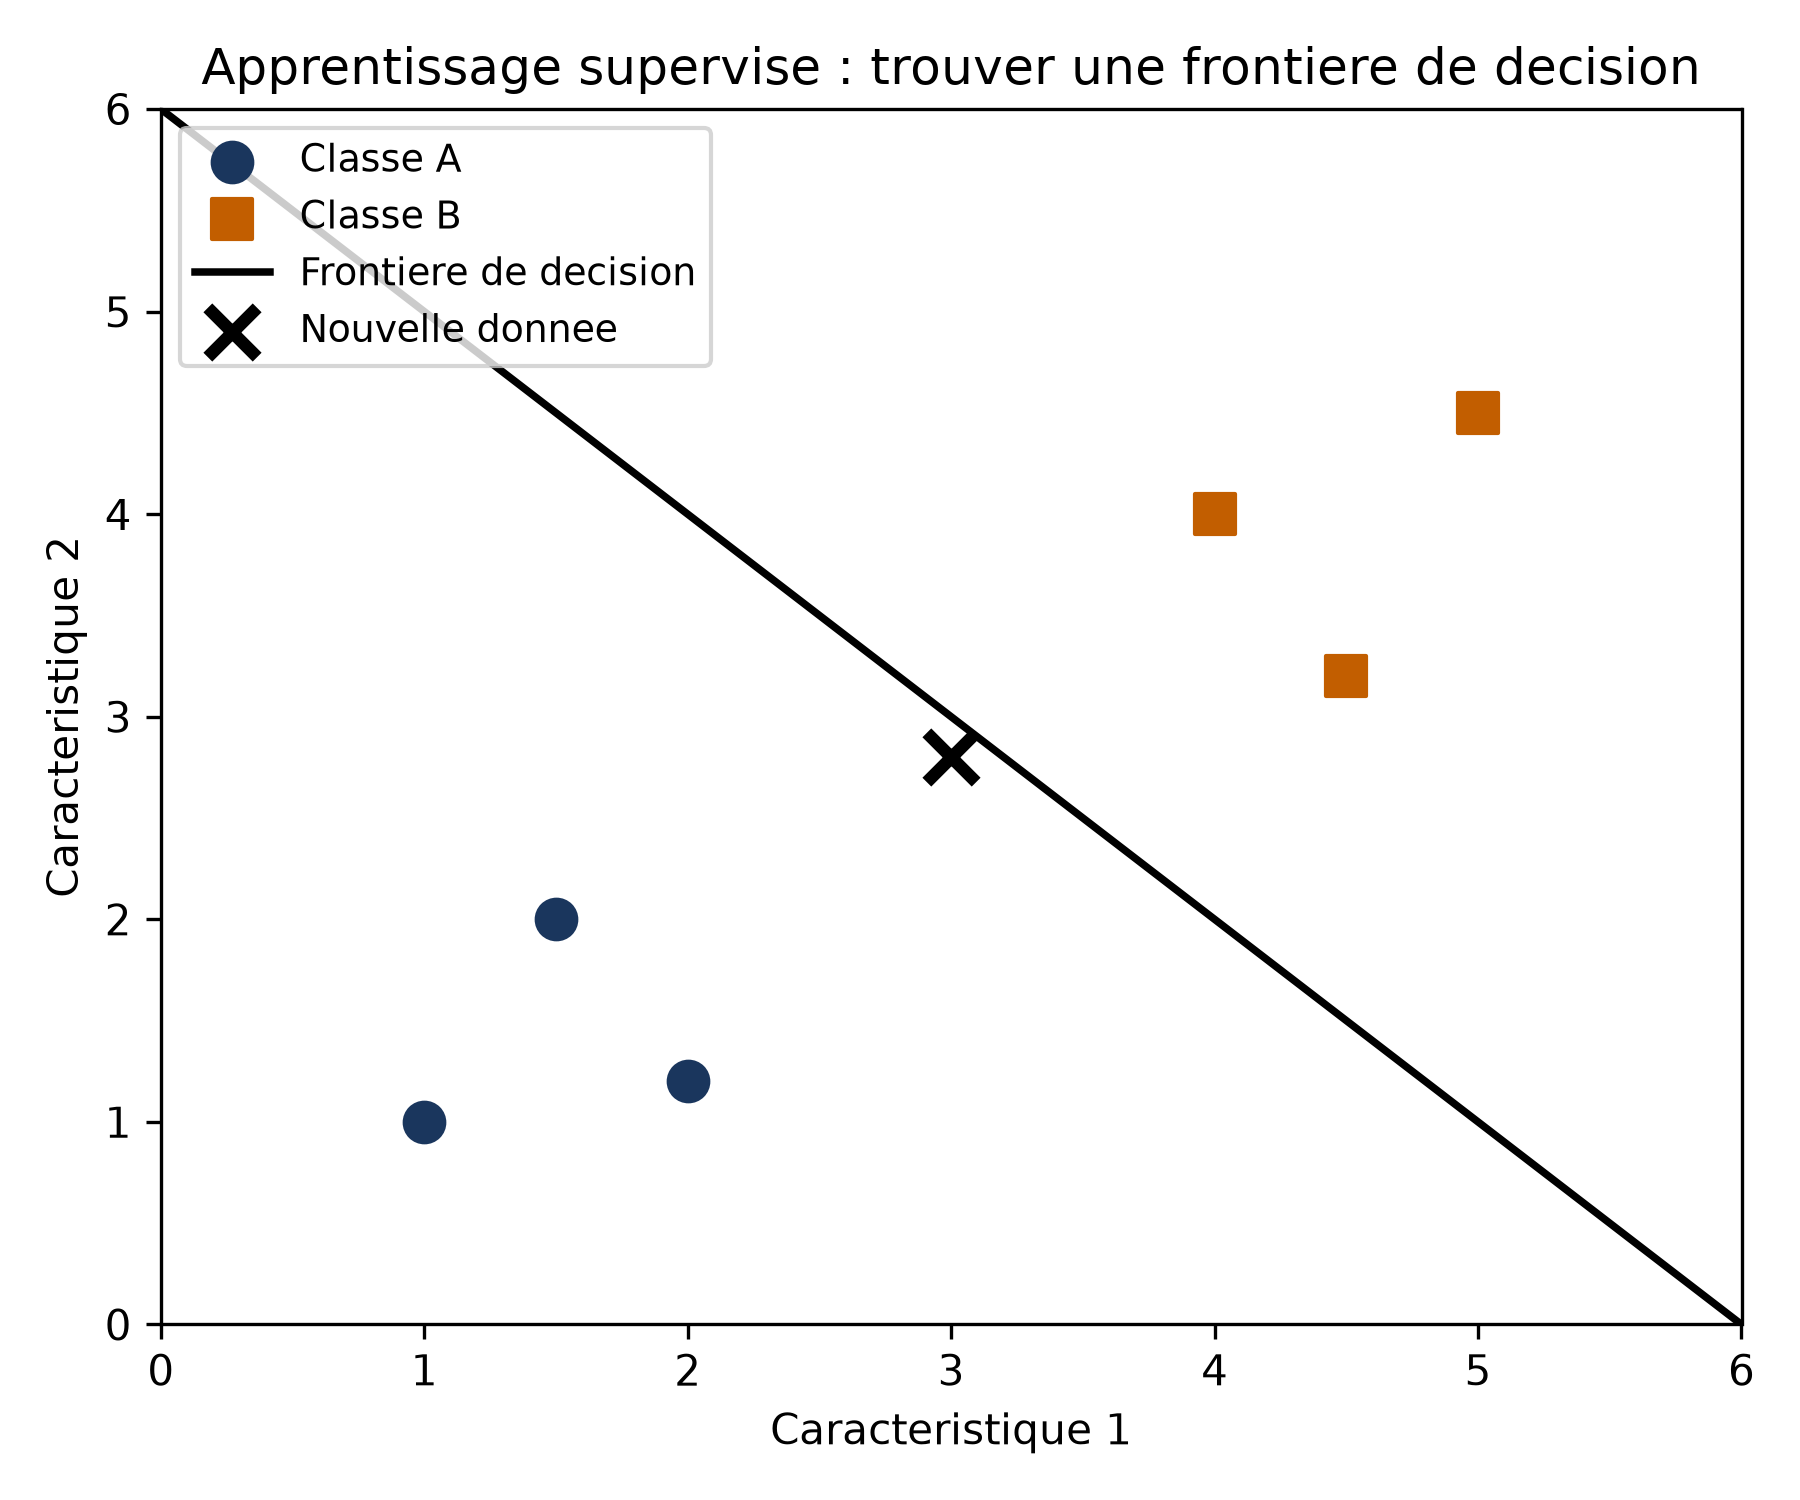
Le jeu boursier montre que le résultat n’a pas à être spectaculaire. À première vue, les variations des cinq derniers jours ne semblent guère informatives sur le lendemain. Pourtant, avec les bons outils statistiques, on parvient à prédire la direction du marché environ 60 % du temps sur la période étudiée : un score modeste, qui compte pourtant dans ce domaine.
⚠️ Piège Il est tentant de coder des catégories par des entiers (1 pour un AVC, 2 pour une overdose, 3 pour une crise d’épilepsie) et d’appliquer une régression linéaire. Ce codage impose un ordre et des écarts égaux qui n’ont aucun sens : recoder les mêmes diagnostics dans un autre ordre donnerait un modèle entièrement différent.
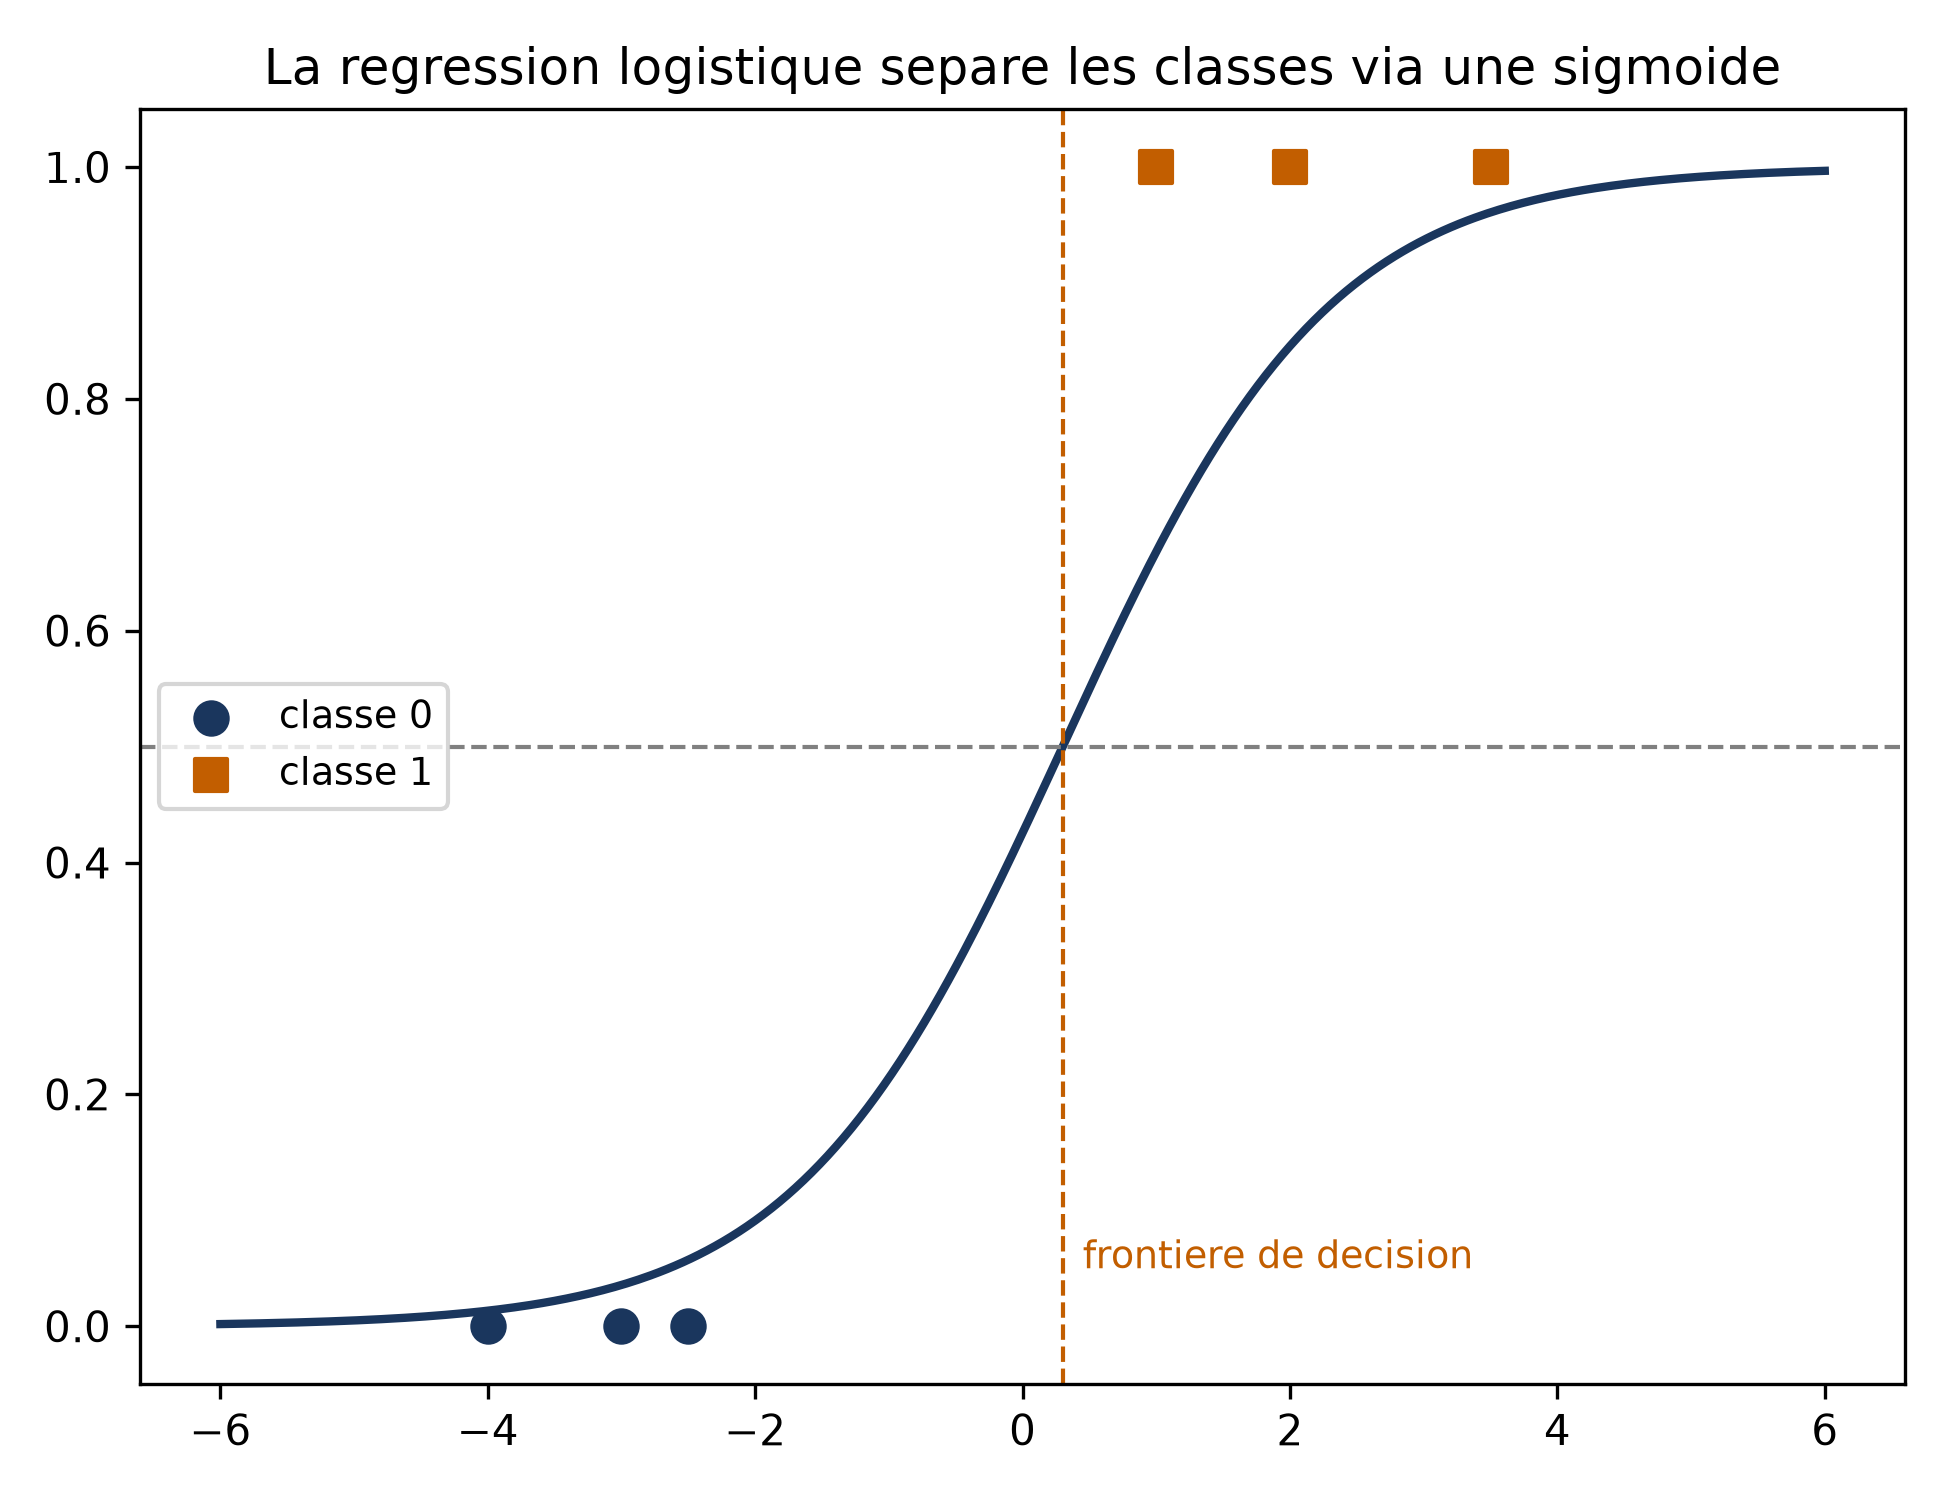
La plupart des méthodes de classification passent d’abord par des probabilités : pour chaque catégorie possible, elles chiffrent la chance que le cas lui appartienne, et c’est seulement ensuite qu’elles désignent une classe.
La frontière entre les deux familles est d’ailleurs poreuse : la régression logistique, malgré son nom, est une méthode de classification, et certaines méthodes comme les K plus proches voisins ou le boosting s’appliquent aux deux types de réponse. En pratique, c’est la nature de la réponse, bien plus que celle des prédicteurs, qui guide le choix de la méthode.
Un cas concret en code : qui va faire défaut sur sa carte ?
Passons à des données chiffrées. Question posée aux données : une personne va-t-elle manquer le remboursement de sa carte de crédit (Oui ou Non), quand on ne connaît que le solde mensuel de sa carte et son revenu sur l’année ? Le taux de défaut global n’est que d’environ 3 %, mais les individus en défaut présentent des soldes nettement plus élevés que les autres.
Les lignes In [n]: et Out[n]: ci-dessous sont les entrées et les sorties numérotées d’une session Python interactive. Default désigne le tableau des clients ; MS et sm sont des outils déjà importés.
In [12]: X = MS(['balance']).fit_transform(Default)
         y = Default.default == 'Yes'
         glm = sm.GLM(y, X, family=sm.families.Binomial())
         results = glm.fit()
         summarize(results)
Out[12]:
              coef  std err  z  P>|z|
intercept -10.6513  0.361 -29.491  0.0
balance  0.0055  0.000  24.952  0.0
X ne garde que le solde (balance) comme prédicteur, y vaut vrai quand le client est en défaut, et sm.GLM avec la famille Binomial() ajuste une régression logistique. Le modèle apprend deux nombres : une ordonnée à l’origine de  et un coefficient de
 pour le solde.
Reste à transformer les probabilités en décisions. Le code suivant utilise results, le modèle ajusté ci-dessus, fixe un seuil à 50 % et croise les prédictions avec la réalité :
In [15]: probs = results.predict()
         labels = np.array(['No']*10000)
         labels[probs>0.5] = "Yes"
         confusion_table(labels, Default.default)
On part de 10 000 étiquettes « No », on bascule en « Yes » tous les clients dont la probabilité dépasse 0,5, puis confusion_table fabrique le tableau qui croise prédictions et statut réel. En faisant varier le seuil, tu explores le compromis entre les deux types d’erreur.
Comment la machine apprend : trois jeux de données et une erreur à réduire
Un modèle supervisé se construit à partir de trois ensembles de données aux rôles distincts. L’ensemble d’entraînement sert à apprendre la relation entre entrées et cibles. L’ensemble de validation guide le choix des hyperparamètres, des réglages fixés à l’avance par toi plutôt qu’appris par le modèle. L’ensemble de test, enfin, est réservé à l’évaluation finale : le modèle ne doit jamais l’avoir vu.
L’objectif n’est jamais de mémoriser parfaitement les exemples, mais de bien généraliser à de nouvelles données. Tout ce qui suit sert cette idée.
Fixer une forme, puis ajuster ses coefficients
Le plus simple pour réduire le problème est de supposer une forme pour , par exemple une combinaison linéaire des entrées :
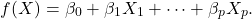
 est l’ordonnée à l’origine (l’intercept) et chaque
 pondère l’entrée
 . Estimer une fonction arbitraire en
 dimensions devient alors estimer
 coefficients. On ajuste le modèle sur les données d’entraînement en cherchant les valeurs de coefficients telles que
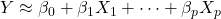 ; la méthode des moindres carrés ordinaires est l’approche la plus courante.
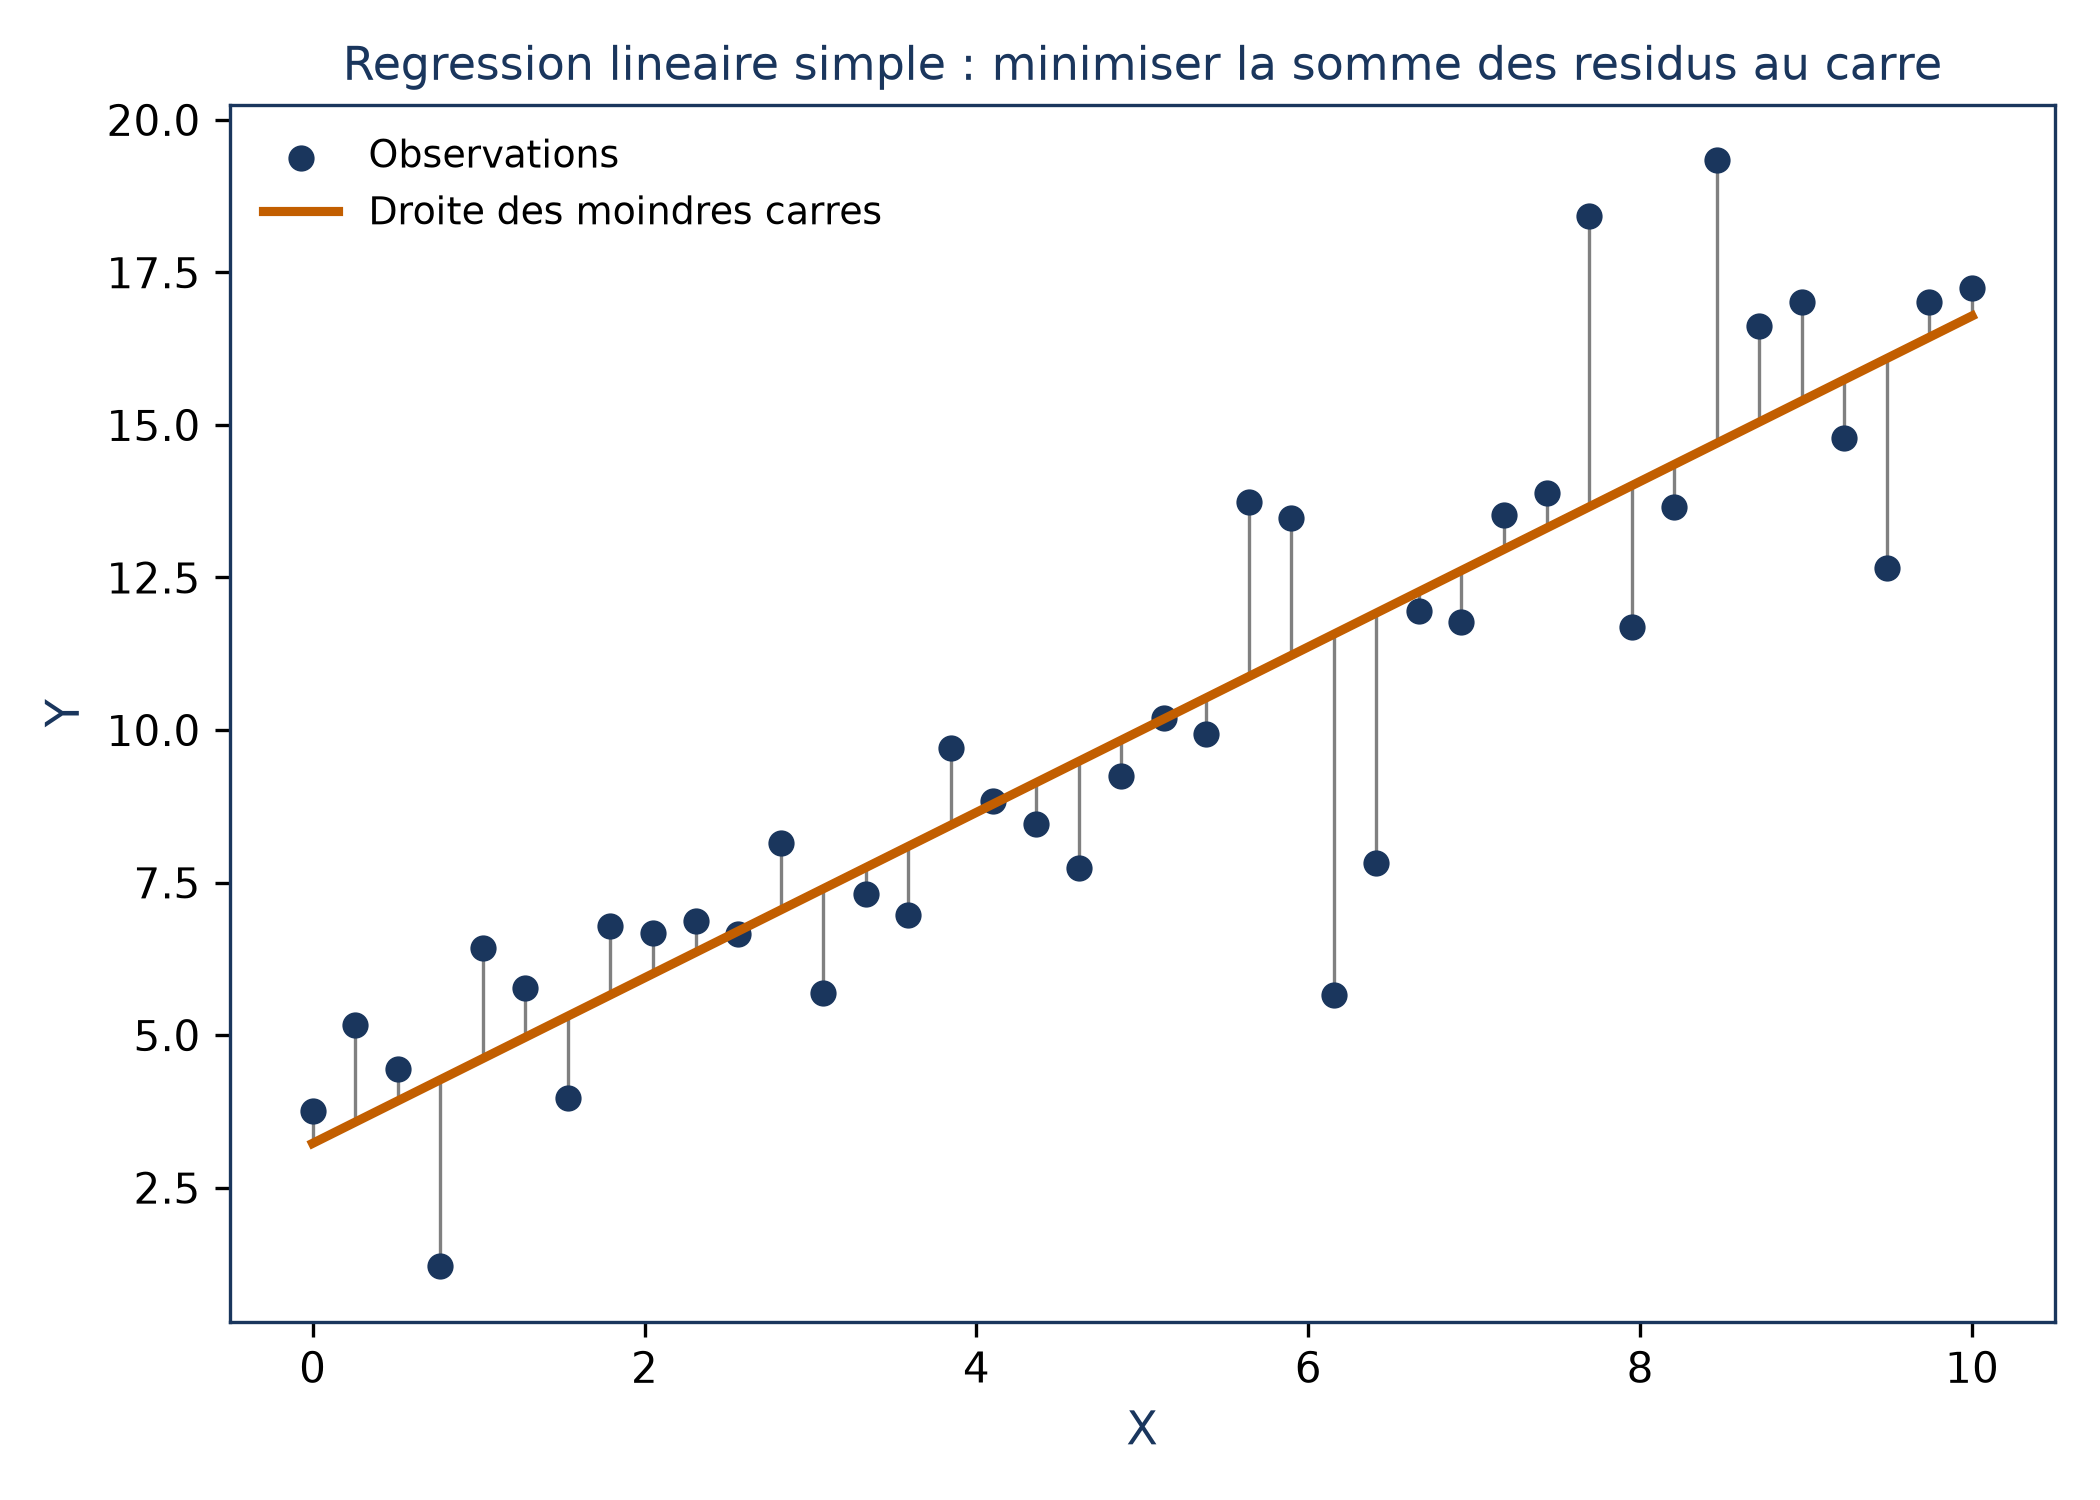
Cette hypothèse a un prix : le modèle choisi ne correspond en général pas exactement à la vraie forme de , et si l’hypothèse est trop éloignée de la réalité, l’estimation sera mauvaise. Les méthodes non paramétriques, elles, ne posent aucune hypothèse sur la forme de : elles cherchent une estimation proche des points sans être trop irrégulière, mais il leur faut bien plus de données.
Mesurer l’erreur
En régression, l’erreur quadratique moyenne et sa racine mesurent l’écart moyen entre valeurs prédites et observées ; la racine, exprimée dans la même unité que la cible, est souvent préférée. Sur les ventes de ton client, même avec les coefficients exacts, tes prévisions de ventes se tromperaient encore en moyenne d’environ 3 260 unités, soit près d’un quart des ventes moyennes. Cette lecture dépend du contexte : un modèle de physique attendrait une erreur quasi nulle, alors qu’en sciences sociales une erreur bien plus élevée peut rester honorable.
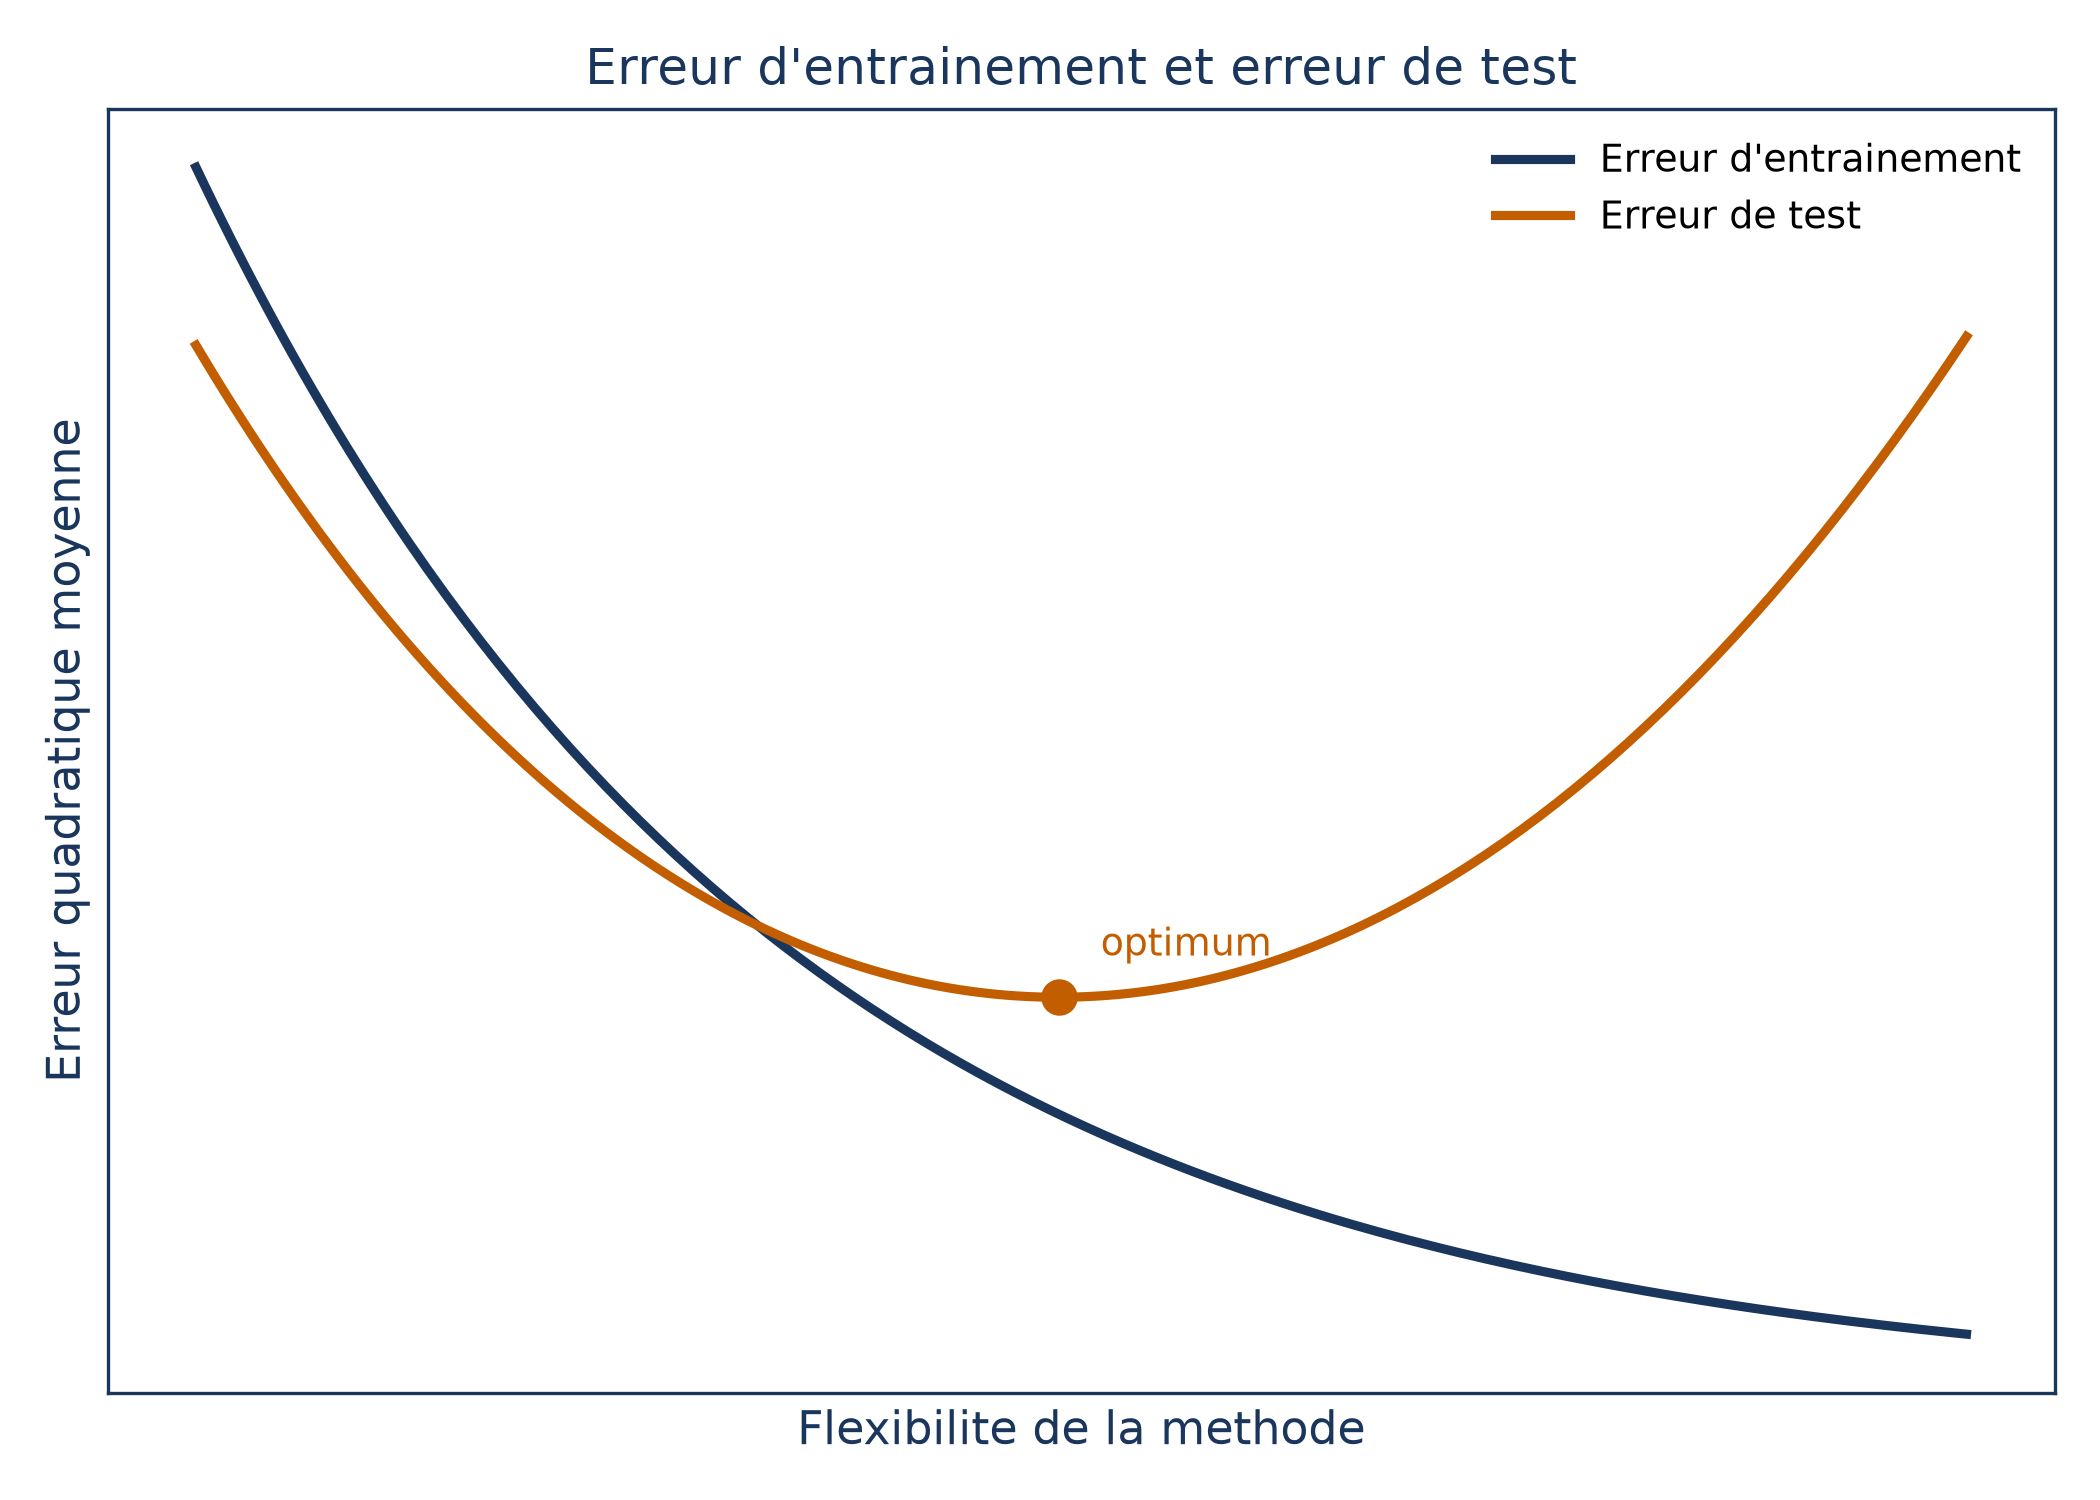
En classification, on compte les observations mal classées. Dans les deux cas, on distingue l’erreur d’entraînement de l’erreur de test, et c’est la seconde qui nous intéresse en priorité.
Des exemples propres avant tout
Avant de modéliser, quelques vérifications évitent des modèles trompeurs :
- Classes déséquilibrées : si une classe domine, un modèle entraîné sans précaution prédit toujours cette classe ; avec seulement 3 % de défauts, un modèle paresseux qui répondrait toujours « non » aurait presque toujours raison. On rééquilibre en sous-échantillonnant la classe majoritaire ou en sur-échantillonnant la minoritaire.
- Incohérences : des données identiques en apparence mais associées à des cibles différentes signalent souvent qu’il manque une caractéristique explicative, comme l’âge d’un client dans une prédiction d’achat.
- Valeurs manquantes : si les données restantes suffisent, mieux vaut retirer les observations concernées que les remplacer par la moyenne, qui risque d’introduire un biais.
Le piège de l’apprentissage par cœur
« Le meilleur modèle est celui qui colle le mieux aux exemples »
Sans données de test sous la main, on pourrait choisir la méthode qui minimise l’erreur d’entraînement. C’est une tentation dangereuse : rien ne garantit qu’elle minimise aussi l’erreur de test. À mesure que la flexibilité d’une méthode augmente, l’erreur d’entraînement baisse sans cesse, alors que l’erreur de test dessine typiquement une courbe en U.
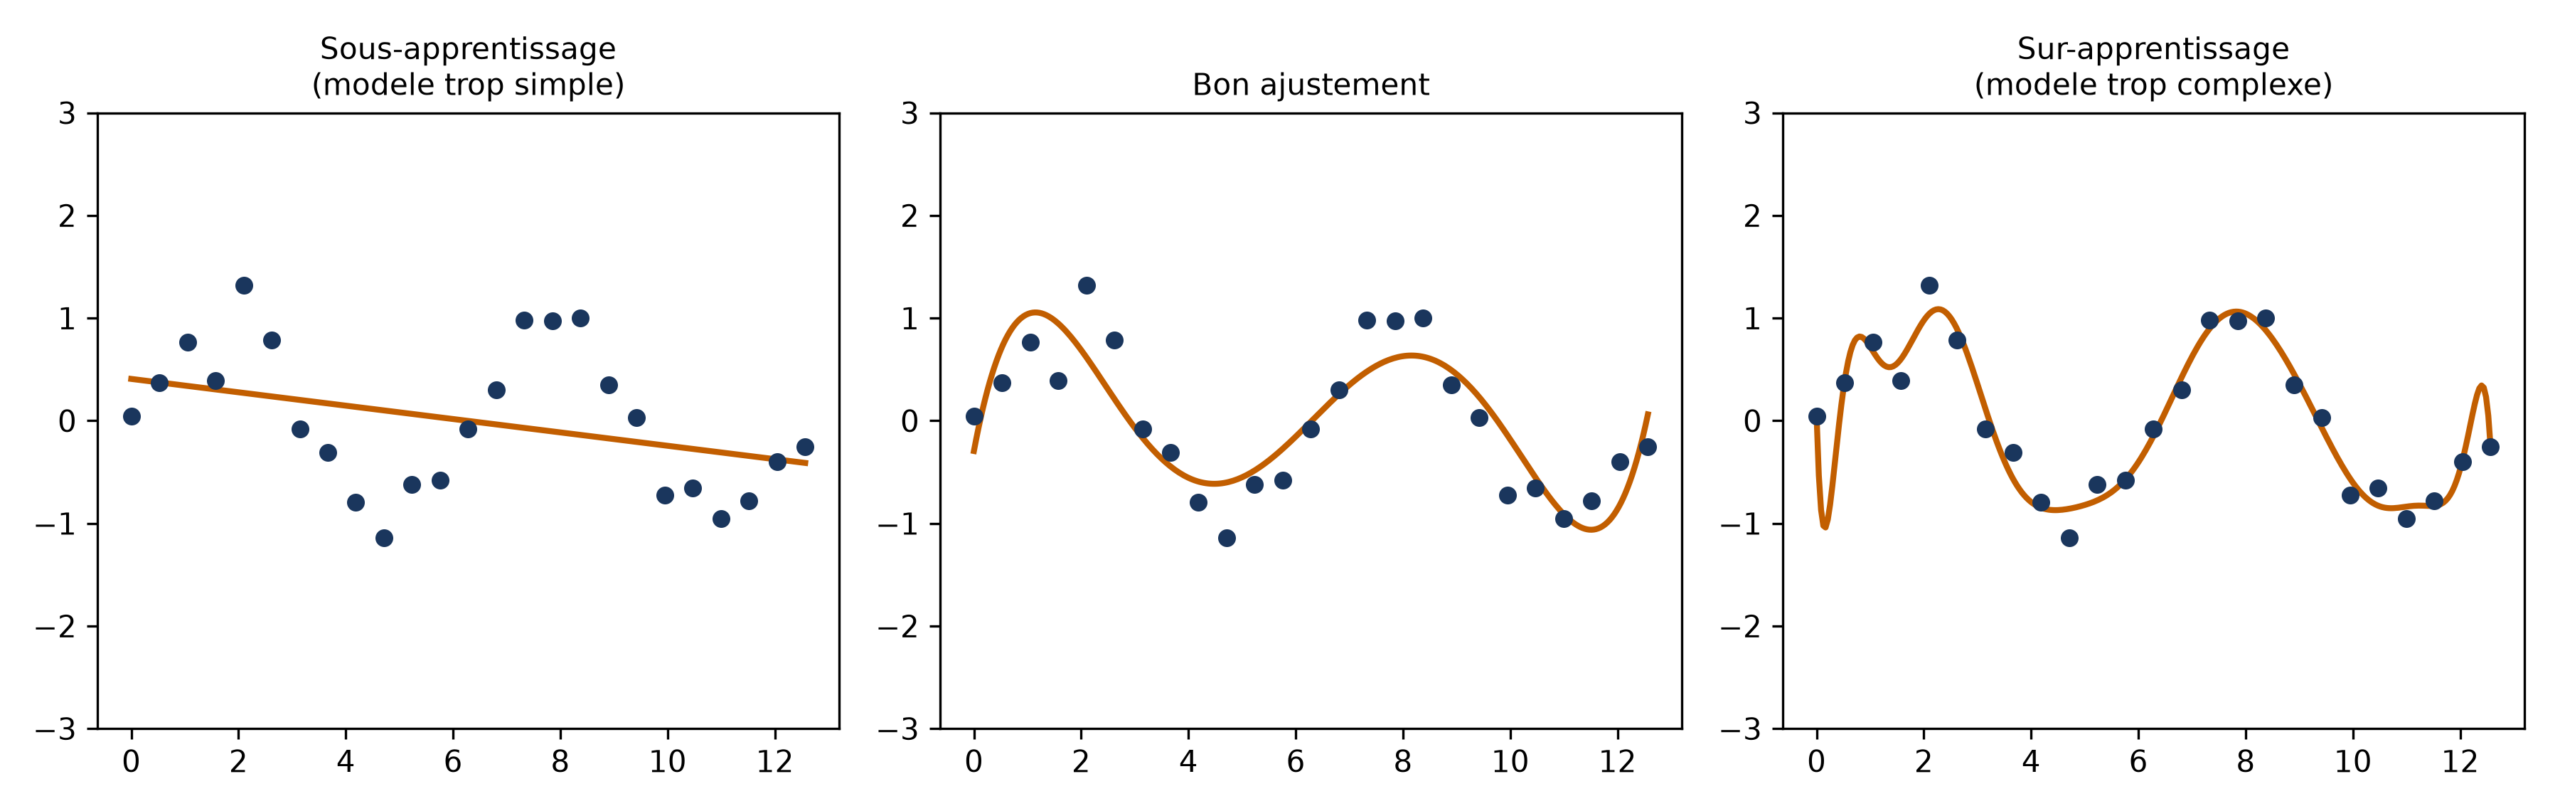
Un même jeu de données bruitées illustre les trois régimes. Un modèle linéaire trop simple ignore la structure sinusoïdale sous-jacente : c’est le sous-apprentissage. Un polynôme de degré modéré la capte fidèlement. Un polynôme de degré très élevé épouse jusqu’au moindre bruit, au détriment de toute généralisation.
« Plus un modèle est souple, mieux il prédit »
Si ton but est purement prédictif, ne faut-il pas toujours choisir la méthode la plus flexible ? La réponse est non, et c’est l’un des constats les plus contre-intuitifs du domaine. Une méthode très souple se montre parfois moins précise sur des cas nouveaux qu’une méthode plus simple, justement parce qu’elle s’ajuste trop.
« Une méthode finit toujours par l’emporter »
Il n’existe pas de méthode universellement meilleure que les autres : sur un jeu de données donné, l’une fonctionne le mieux, mais une autre l’emportera sur un jeu voisin mais différent. Choisir est donc une étape essentielle et souvent délicate.
📌 À retenir Un bon modèle supervisé se juge sur ce qu’il fait des cas qu’il n’a pas vus, jamais sur sa fidélité aux exemples d’entraînement.
Ce qui change quand il n’y a plus de réponse à comparer
L’apprentissage non supervisé observe un vecteur de mesures pour chaque individu, sans réponse associée : on ne peut ajuster aucun modèle de régression, faute de variable à prédire. On avance un peu à l’aveugle, d’où le nom. Un exemple : 6 830 mesures d’expression génique pour 64 lignées de cellules cancéreuses, que l’on cherche à regrouper en familles sur leur seul profil génétique.
Cela change surtout la façon de juger le résultat. Sans « bonne réponse » à comparer, il n’existe aucune façon directe de calculer une erreur de test ou d’appliquer la validation croisée. Le résultat reste, par nature, plus exploratoire.
Le regroupement exige donc du jugement : faut-il standardiser les variables ? Quelle mesure de dissimilarité choisir ? Combien de groupes retenir ? Ces choix peuvent modifier substantiellement les groupes obtenus, alors qu’en supervisé l’erreur de test offre un critère relativement objectif entre modèles concurrents. Pour les lignées cancéreuses, les groupes se sont pourtant révélés cohérents avec les 14 types de cancer réellement présents, alors que cette information n’avait pas servi à les former.
Entre les deux, il arrive qu’on dispose des réponses pour une partie seulement des observations : on parle d’apprentissage semi-supervisé, ce qui rappelle que ces catégories ne sont pas cloisonnées.
Enfin, l’approche déborde largement la statistique classique : l’ajustement par instructions d’un modèle de langage, qui le rend plus apte à suivre des consignes, est une sous-catégorie de l’apprentissage supervisé.