Quelqu’un lance en réunion : « Et si on réglait ça avec du renforcement ? » La phrase sonne bien. Elle ouvre aussi un chantier : concevoir une récompense, payer du calcul, accepter des réglages délicats. Cette page te donne les questions à poser avant de répondre oui, dans l’ordre où elles écartent le plus vite les faux départs.
Sommaire
- L’essentiel en 30 secondes
- Ce que tu as sous la main décide de la voie
- Le critère qui tranche : tes choix s’enchaînent-ils ?
- Comparer des variantes : un bandit avant le renforcement complet
- Le test de la récompense : sais-tu écrire le score ?
- Ce que ça coûte : calcul, essais, réglages
- Quand lever le pied
- Ta grille de décision
L’essentiel en 30 secondes
- Si tu possèdes déjà des exemples corrects, l’affinage supervisé est la voie de base : le renforcement se réserve à l’optimisation d’un signal mesurable.
- Le renforcement paie quand tes décisions s’enchaînent et que le verdict n’arrive qu’après coup.
- Pour choisir entre quelques variantes, un bandit suffit : il déplace le trafic vers la meilleure option en cours d’expérience.
- Sans un score fiable et mesurable, il n’y a rien à optimiser : la récompense est le point dur.
- Compte le coût global, pas seulement le calcul : si une règle simple fait aussi bien, elle l’emporte.
Ce que tu as sous la main décide de la voie
Avant de parler de renforcement, regarde ce que tu possèdes déjà. Trois situations, trois voies bien distinctes.
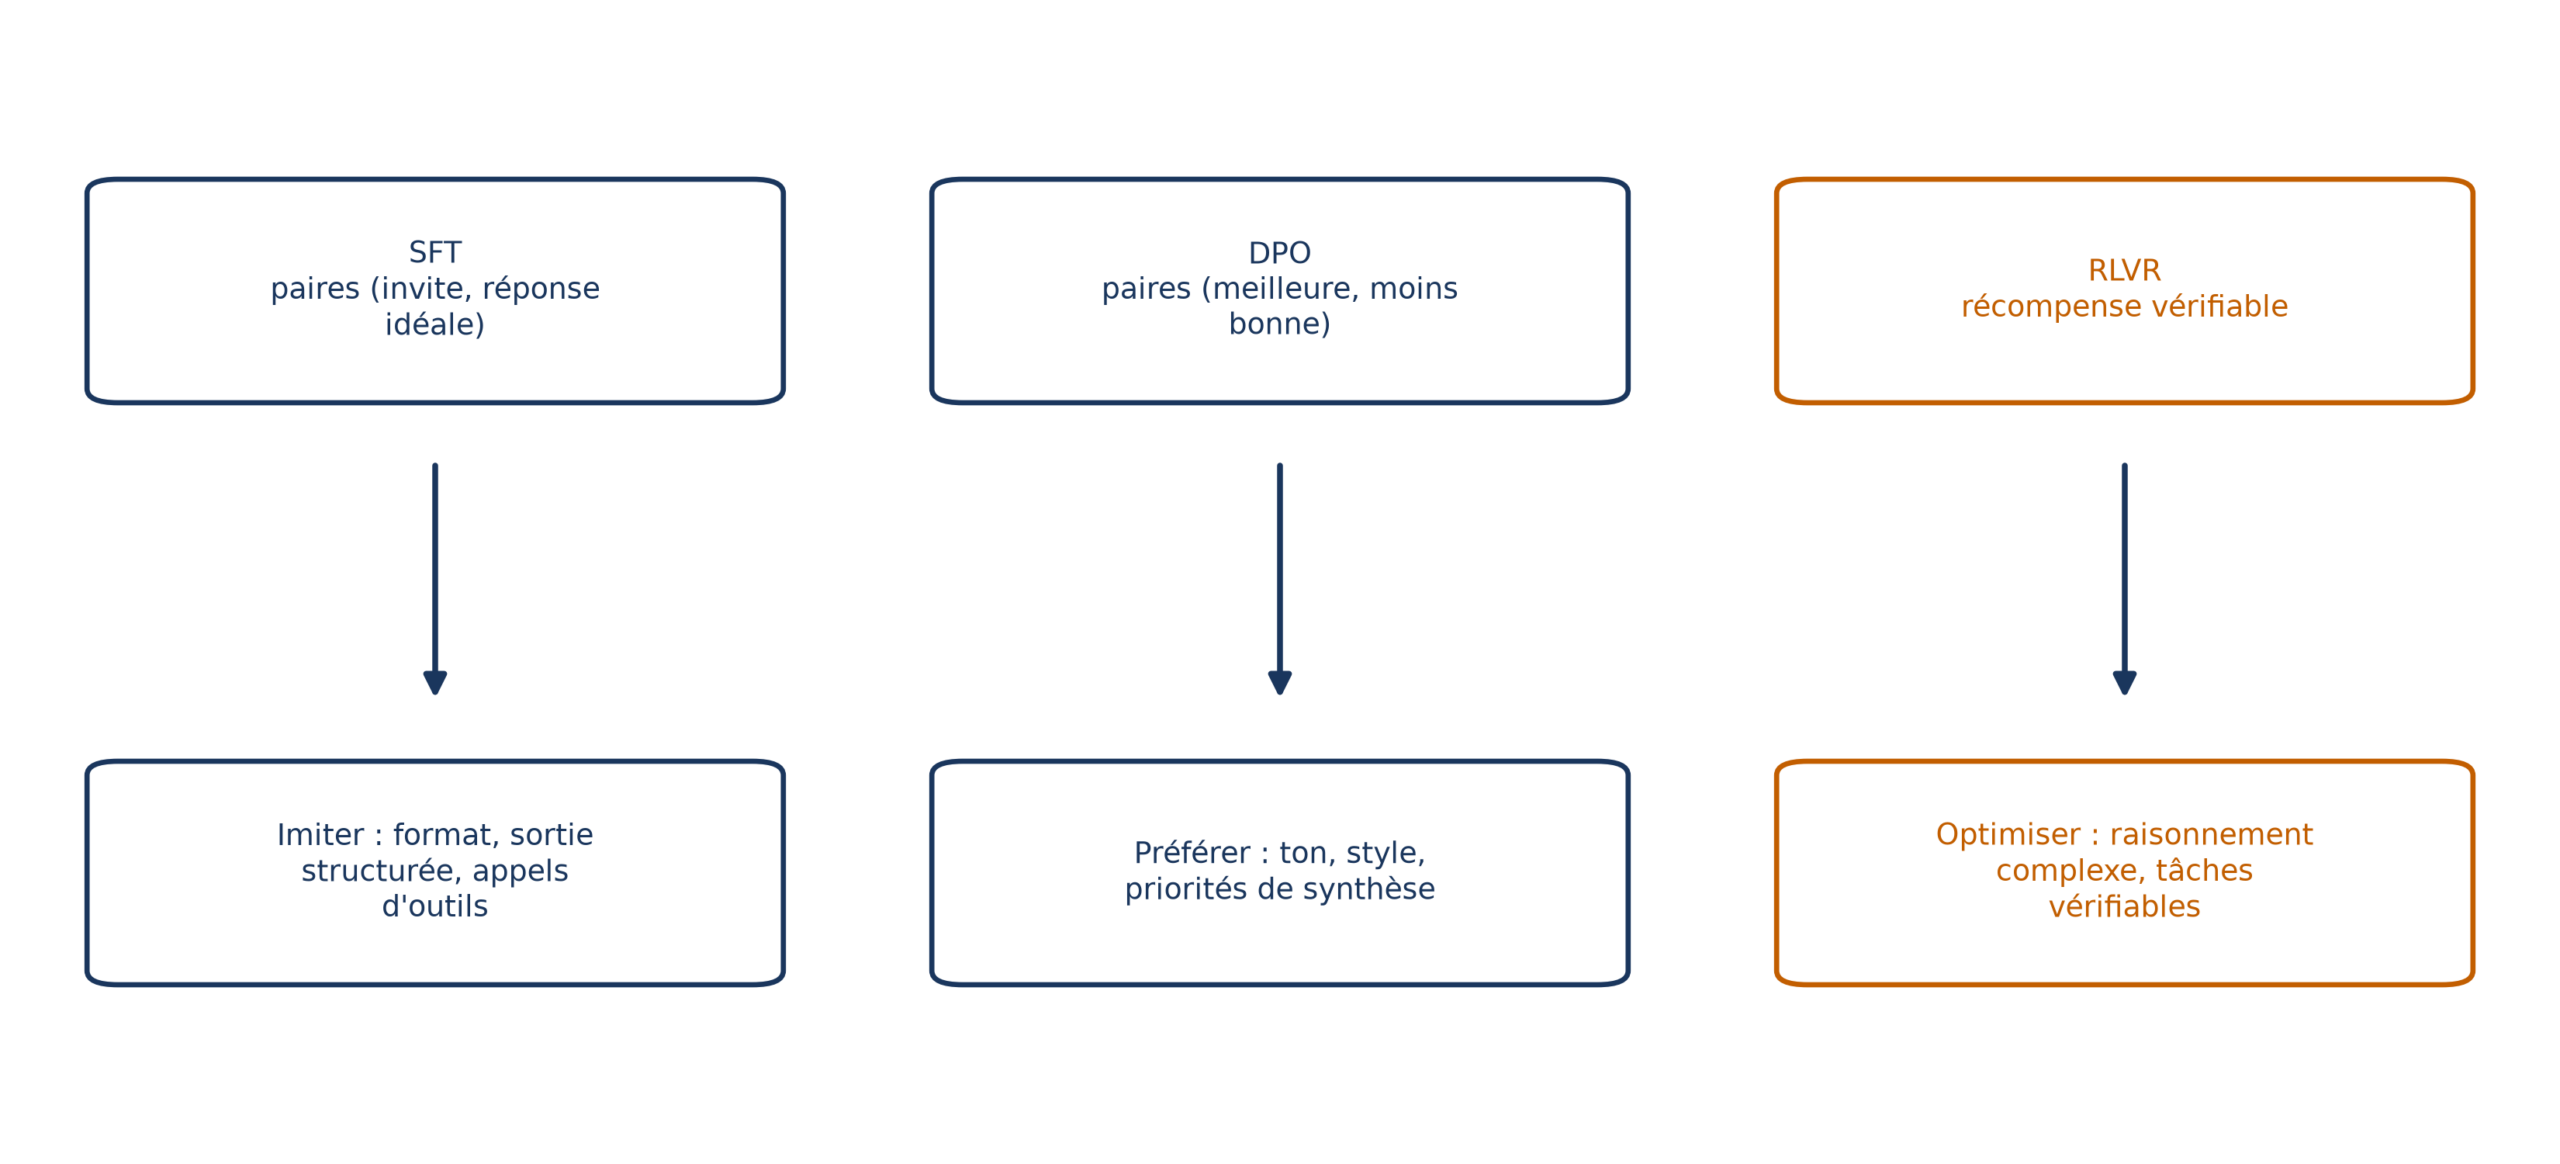
Tu disposes de paires (entrée, bonne réponse) ? Alors l’affinage supervisé est la technique de base : il façonne le comportement à partir d’exemples choisis avec soin, pour de la classification, des sorties structurées ou la correction d’erreurs de suivi d’instructions.
Reste une question de volume. Un modèle de 70 milliards de paramètres peut se contenter d’environ 1 000 exemples de qualité, alors qu’un petit modèle de 7 milliards en réclame jusqu’à un million. Construire des milliers d’exemples coûte cher : en général, seule une petite part est rédigée par des humains, le reste étant généré par un modèle ou emprunté à des jeux existants. Confronte ce chiffre à ta situation avant d’aller plus loin.
Tu disposes plutôt de paires « meilleure réponse / moins bonne réponse » ? L’optimisation directe des préférences (DPO) entraîne le modèle à favoriser les sorties de meilleure qualité, utile pour le ton, le style ou les priorités de synthèse.
Tu disposes enfin d’un évaluateur capable de noter une sortie ? Tu entres alors dans le territoire du renforcement : l’apprentissage par renforcement à récompenses vérifiables (RLVR) branche n’importe quel évaluateur que tu sais construire (métrique automatique, validateur à règles, modèle de notation, évaluateur humain) et optimise directement le modèle vers ce score.
Dernier réflexe avant d’entraîner quoi que ce soit : l’apprentissage non paramétrique améliore l’agent sans toucher à ses poids, par exemple en récupérant des exemples ou en enregistrant puis réinjectant des réflexions sur ses échecs. Il est simple, rapide et peu coûteux, donc à essayer en premier. L’affinage paramétrique ne se justifie que si le domaine, le format ou la précision d’outil l’exigent et que données, budget et maintenance suivent.
Le critère qui tranche : tes choix s’enchaînent-ils ?
Admettons que tu aies un score à optimiser. Reste à savoir si la mécanique du renforcement convient, et un critère domine : la décision d’aujourd’hui change-t-elle ce que tu rencontreras demain ? Le renforcement apprend de récompenses plutôt que d’étiquettes, ce qui convient aux tâches à retour différé et décisions séquentielles.
Trois signaux plaident pour lui :
- tes actions déplacent la situation : chaque geste de l’agent te place devant un contexte différent de celui d’avant ;
- le verdict arrive tard, par exemple quand la récompense n’est donnée qu’à la fin d’une partie ;
- personne ne sait à l’avance quelle action mener : le système doit explorer pour découvrir celles qui rapportent.
💡 Intuition Si tu peux corriger chaque réponse isolément, tu es en terrain supervisé. Si tu ne sais juger qu’une suite de décisions une fois jouée, tu es en terrain de renforcement.
Certains savoir-faire relèvent d’ailleurs de l’interaction pure. Les modèles de langage n’ont qu’une compréhension limitée du monde réel, tant pour le raisonnement de sens commun que pour les relations spatiales : pour progresser, il faut un système qui laisse l’IA interagir avec un environnement et en apprendre par l’exploration.
À l’inverse, si chaque choix est indépendant du suivant, inutile de suivre un état. Le problème se réduit à comparer des options, et c’est le terrain des bandits.
Comparer des variantes : un bandit avant le renforcement complet
Imagine que tu hésites entre trois versions d’une consigne donnée à un assistant. Un test A/B répartit le trafic de façon rigide. Un bandit bayésien, lui, apprend en chemin : chaque bras représente une variante (invites alternatives, stratégies d’orchestration), l’algorithme observe des récompenses (tâches résolues, latence moindre, meilleures notes) et affine ses croyances par des mises à jour bayésiennes.
Un cas chiffré : un système teste trois chaînes de raisonnement pour classer des menaces ambiguës. Il démarre à parts égales ; quand l’une améliore l’exactitude de 15 %, il lui réaffecte 70 % des requêtes tout en sondant les autres, pour détecter les évolutions du comportement des utilisateurs.
Le bénéfice est direct : la majorité des utilisateurs profite de la meilleure configuration dès qu’elle est identifiée, au lieu de voir un trafic égal gaspillé sur des variantes sous-optimales.
Cette règle choisit à chaque pas l’action qui maximise :
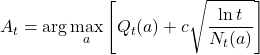
 est la valeur estimée de l’action
 ,
 le nombre de fois où tu l’as testée,
 le nombre total d’essais et
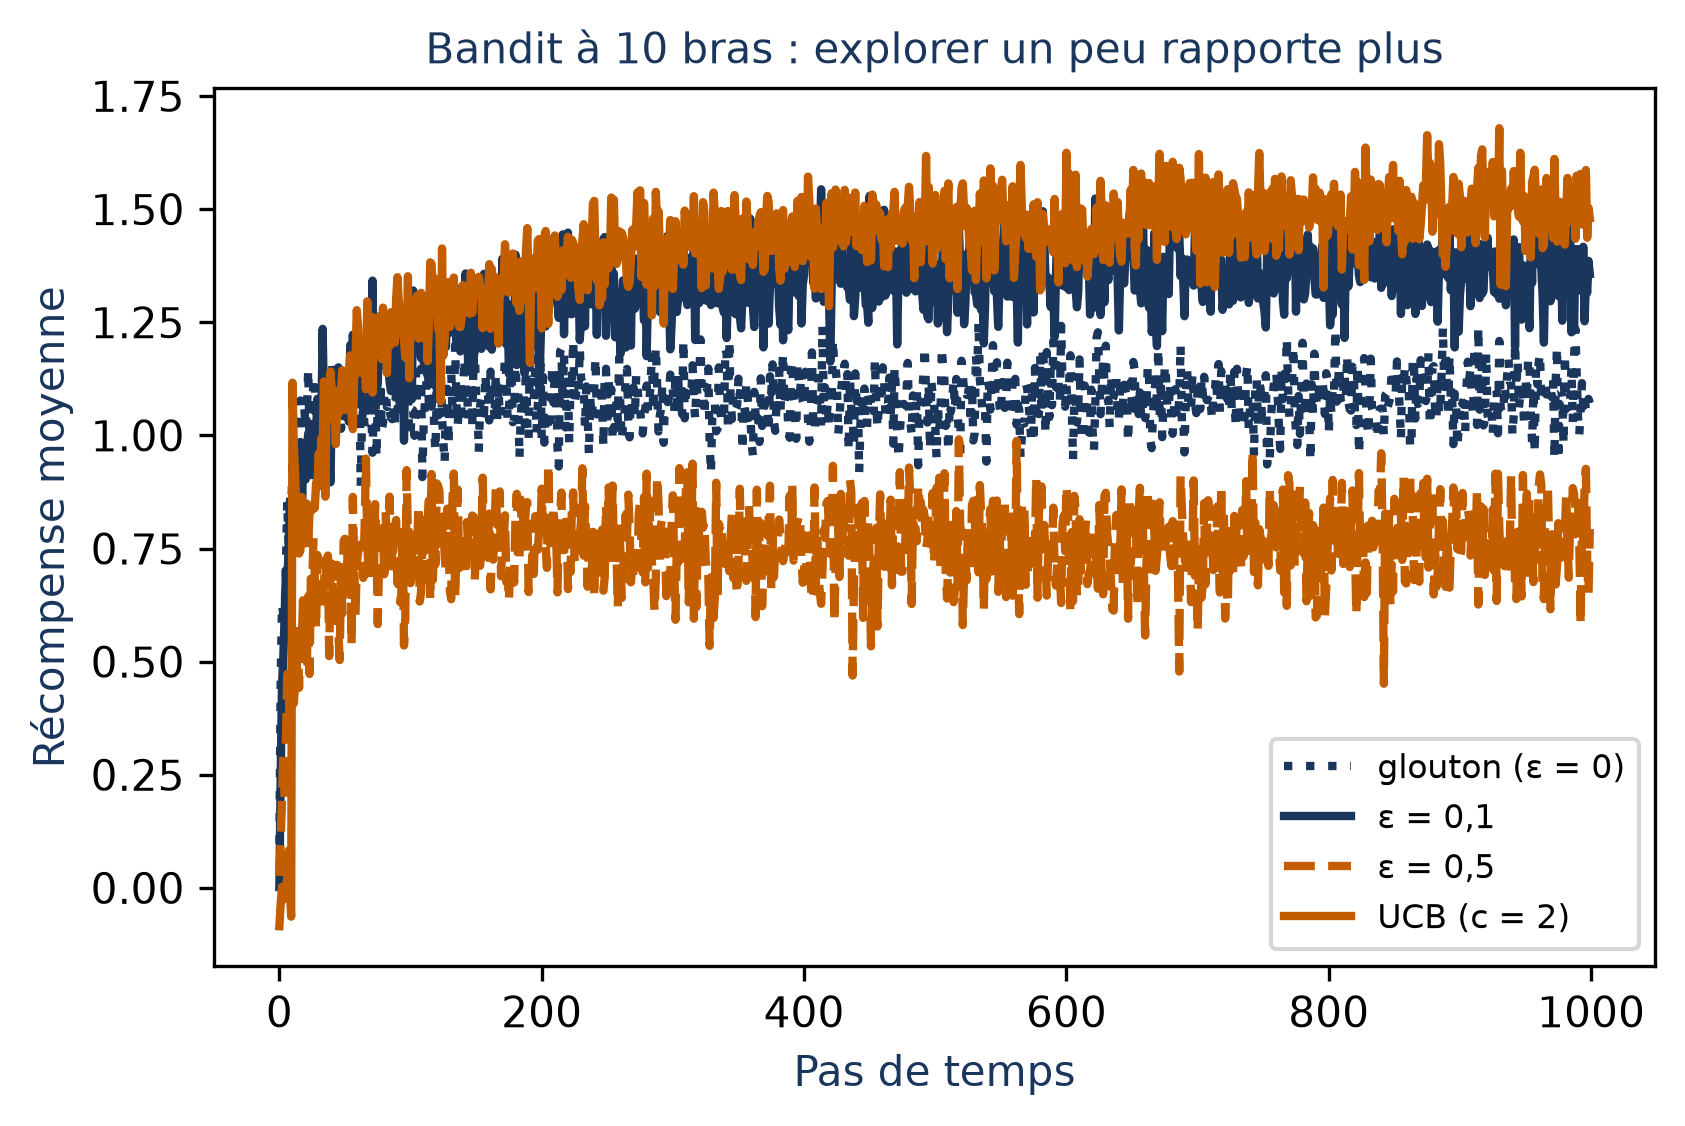
 le réglage de l’exploration. Une option peu testée voit son second terme grandir et finit par être retentée ; celles dont l’estimation est faible et qui ont été souvent testées sont rechoisies de moins en moins.
Le bandit s’arrête pourtant là où commence la séquence : c’est un système simpliste qui ne s’applique pas à de nombreuses situations réelles, celles où le but est plus lointain que le gain immédiat. Et la règle UCB, si elle marche très bien, est difficile à appliquer hors des bandits.
Deux garde-fous si tu t’en sers. Les récompenses doivent refléter les vrais objectifs, sans proxys trompeurs. Et il faut surveiller les boucles de rétroaction pathologiques, ainsi que l’exploitation de tendances à court terme au détriment d’objectifs à long terme ; des a priori neutres et une régularisation évitent de biaiser trop tôt vers une variante.
Le test de la récompense : sais-tu écrire le score ?
Quand le problème est connu, ou que la récompense se définit par une fonction claire et déterministe (le score d’un jeu, une condition de victoire ou de défaite), sa conception est simple. Dans bien d’autres applications, ce n’est pas possible : les tâches sont longues et complexes, les récompenses éparses.
C’est le point où beaucoup de projets achoppent, parce que la fonction de récompense contrôle le comportement, l’apprentissage et la performance de l’agent. La concevoir est difficile en récompenses éparses, avec un risque de biais qui conduit à des comportements inattendus ou à une politique sous-optimale.
| Ton signal | Verdict |
|---|---|
| Score de jeu, victoire ou défaite | Récompense simple à écrire |
| Métrique automatique, validateur à règles, modèle de notation, évaluateur humain | Utilisable en RLVR |
| Tâche longue et complexe, retour rare | Récompense difficile ; un LLM peut aider, avec des réserves |
Le RLVR vise les tâches où l’on sait définir un signal d’évaluation vérifiable : qualité de synthèse, exactitude des appels d’outils, factualité de la recherche de connaissances, respect de contraintes de sécurité. Il est efficace quand on dispose de données de préférence classées ou d’une fonction de score fiable, et idéal quand l’évaluation est trop coûteuse à obtenir à grande échelle par annotation directe.
Quand tu ne sais pas écrire la récompense toi-même, un LLM peut la fournir : soit par un retour direct, soit en générant le code d’une fonction de récompense que tu peux modifier pendant l’entraînement, par exemple quand l’agent a acquis des compétences et que gagner devient plus difficile. Le procédé n’est pas facile pour autant : des ambiguïtés surgissent, et le système ne marche pas toujours avec des instructions de mauvaise qualité.
Ce que ça coûte : calcul, essais, réglages
Une fois le renforcement jugé pertinent, le coût se pilote par le choix de la famille d’algorithmes. Le tableau croise ta contrainte avec le levier et son prix.
| Ta contrainte | Le levier | Ce qu’il te coûte |
|---|---|---|
| Chaque essai coûte cher | Méthodes hors politique : elles réutilisent les données passées, explorent mieux et convergent plus vite | Moins de stabilité, plus de variance, plus de complexité |
| Tu veux de la stabilité | Méthodes sur la politique : plus stables, moins de variance | Elles jettent les données des politiques précédentes et conviennent surtout aux environnements stables |
| Tu veux un point de départ simple | PPO : stable, peu d’hyperparamètres ; A2C : plus facile à déboguer | A2C est en général plus lente |
Les deux familles se reconnaissent à un exemple. Un assistant conversationnel qui améliore sa politique d’après le retour des utilisateurs relève du « sur la politique ». Un système de recommandation musicale qui propose du neuf pour explorer genres et nouveautés sépare au contraire la politique qui collecte les données de celle qu’il cherche à optimiser.
Pour un premier essai, la PPO exploite plusieurs époques de mises à jour par mini-lots, marche bien dans de nombreux cas, et ses valeurs par défaut conviennent en général. Elle tire aussi bon parti des GPU.
Au-delà de l’algorithme, fais le calcul complet : développement, déploiement et maintenance face au bénéfice attendu. Les modèles sophistiqués réclament de grands jeux de données, une expertise pointue, beaucoup de calcul, des cycles itératifs de test et une infrastructure d’essai (environnements de simulation compris). Le coût doit être justifié par la valeur apportée : si un système à règles fait aussi bien qu’un réseau profond, il est plus rentable.
Le réflexe de la simplicité vaut aussi en statistique : plus de souplesse n’améliore pas toujours les prédictions, car le surajustement guette.
Quand lever le pied
Plusieurs tâches à la fois
Un agent multitâche montre souvent des performances très inférieures à celles d’un agent optimisé pour une seule tâche, avec le risque qu’il n’apprenne que les plus faciles et ignore les plus complexes. Si ton besoin est plusieurs compétences à la fois, prévois de le traiter comme un sujet de recherche, pas comme une recette.
Un environnement qui bouge
Les méthodes sur la politique sont peu exploratoires et conviennent aux environnements stables. Les méthodes hors politique, avec leur exploration poussée, sont plus utiles dans des environnements complexes et dynamiques, au prix de plus de complexité.
Un LLM dans la boucle
Confier un rôle à un LLM (décideur, concepteur de récompense) allège parfois l’exploration, mais l’agent hérite de ses biais et de ses hallucinations, peut mal interpréter une tâche complexe ou bruitée, et reste démuni face à un environnement que son pré-entraînement n’a jamais montré. Compte aussi un coût de calcul plus élevé, une latence accrue et des questions de confidentialité dans les domaines sensibles comme la santé ou la finance.
Ta grille de décision
| Ta situation | La voie à privilégier |
|---|---|
| Tu as des paires entrée / bonne réponse | Affinage supervisé : imiter |
| Tu as des réponses classées de la meilleure à la moins bonne | DPO : préférer |
| Tu disposes d’un évaluateur fiable pour un modèle de langage | RLVR : optimiser le score |
| Tu compares quelques variantes sur du trafic réel | Bandit |
| Tes décisions s’enchaînent, le retour est tardif, tu peux t’offrir les essais | Renforcement complet, avec la PPO comme point de départ |
| Une règle ou une amélioration sans réentraînement fait aussi bien | Aucun renforcement |