Imagine que tu caches une recette dans un tableur : « multiplie  par 5, ajoute 3,8 », puis tu saupoudres un peu de hasard sur chaque résultat. Tu donnes ensuite les points obtenus à une méthode qui ignore tout de la recette. Elle te rend une pente d’environ 4,88 et une ordonnée d’environ 4,02 : presque les bons nombres. Cette devinette tient en cinq idées de mathématiques, toutes d’un niveau de lycée, et tu vas pouvoir les raconter une par une à la fin.
Sommaire
- L’essentiel en 30 secondes
- Une droite, c’est une recette à deux boutons
- Aucune droite ne touche tout : mesurer ses écarts
- Chercher le fond du bol avec une pente
- La formule de la pente : deux nuages qui bougent ensemble
- Quand les boutons se multiplient : le tableau et le produit ligne-colonne
- Descendre dans le brouillard quand la formule est trop lourde
- La recette retrouvée, et ce que la droite ne voit pas
L’essentiel en 30 secondes
- Une droite se règle avec deux boutons : la pente et l’ordonnée.
- La meilleure droite est celle qui minimise la somme des carrés des écarts.
- Pour la trouver, on cherche le fond d’un bol : l’endroit où la pente de l’erreur s’annule.
- La pente se calcule en divisant une covariance par une variance, et l’ordonnée se déduit des moyennes.
- Avec plusieurs variables, un tableau de nombres remplace la droite ; si la formule devient trop lourde, on avance pas à pas.
Une droite, c’est une recette à deux boutons
Une droite s’écrit 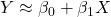 . Le nombre
 est l’ordonnée à l’origine, la hauteur de départ ;
 est la pente, ce que
 gagne quand augmente d’une unité. Ces deux nombres s’appellent les coefficients, ou paramètres, du modèle.
Dans notre devinette, la recette cachée a pour pente 5 et pour ordonnée 3,8. Voici comment les données sont fabriquées : on tire des valeurs de au hasard, on applique la recette, puis on ajoute un bruit aléatoire. La question du jeu est alors : sachant seulement les points, peut-on retrouver les deux boutons ?
import numpy as np
np.random.seed(42)
X = 3 * np.random.rand(100, 1) + 1 # Feature values
...
y_linear = 5 * X.flatten() + 3.8 + np.random.normal(0, 1, 100) # True
                                                                # relationship with noise
Le tirage de X donne cent valeurs, et la ligne y_linear applique la recette (5 fois X, plus 3,8) avant d’y ajouter le bruit np.random.normal. Une fois la méthode lancée, elle ne propose pas la vraie droite mais une estimation, que l’on note avec un chapeau : 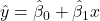 . Le chapeau rappelle que ces nombres sortent des données et ne sont pas les vrais.
Un problème surgit tout de suite. Rien n’empêche de tracer de nombreuses droites à travers le même nuage de points ; il faut donc un critère précis pour désigner la meilleure.
Aucune droite ne touche tout : mesurer ses écarts
Avec des données réelles, il est en général impossible qu’une droite passe exactement par tous les points. Le mieux qu’on puisse faire est de la tracer au plus près. Pour dire « au plus près », on mesure, point par point, la distance verticale entre ce qu’on a observé et ce que la droite prédit.
Cet écart se calcule par une simple soustraction :  . On l’appelle le résidu du point
 . Sur le schéma ci-dessous, les points sont presque alignés, et chaque petit trait pointillé gris qui relie un point à la droite est un résidu.
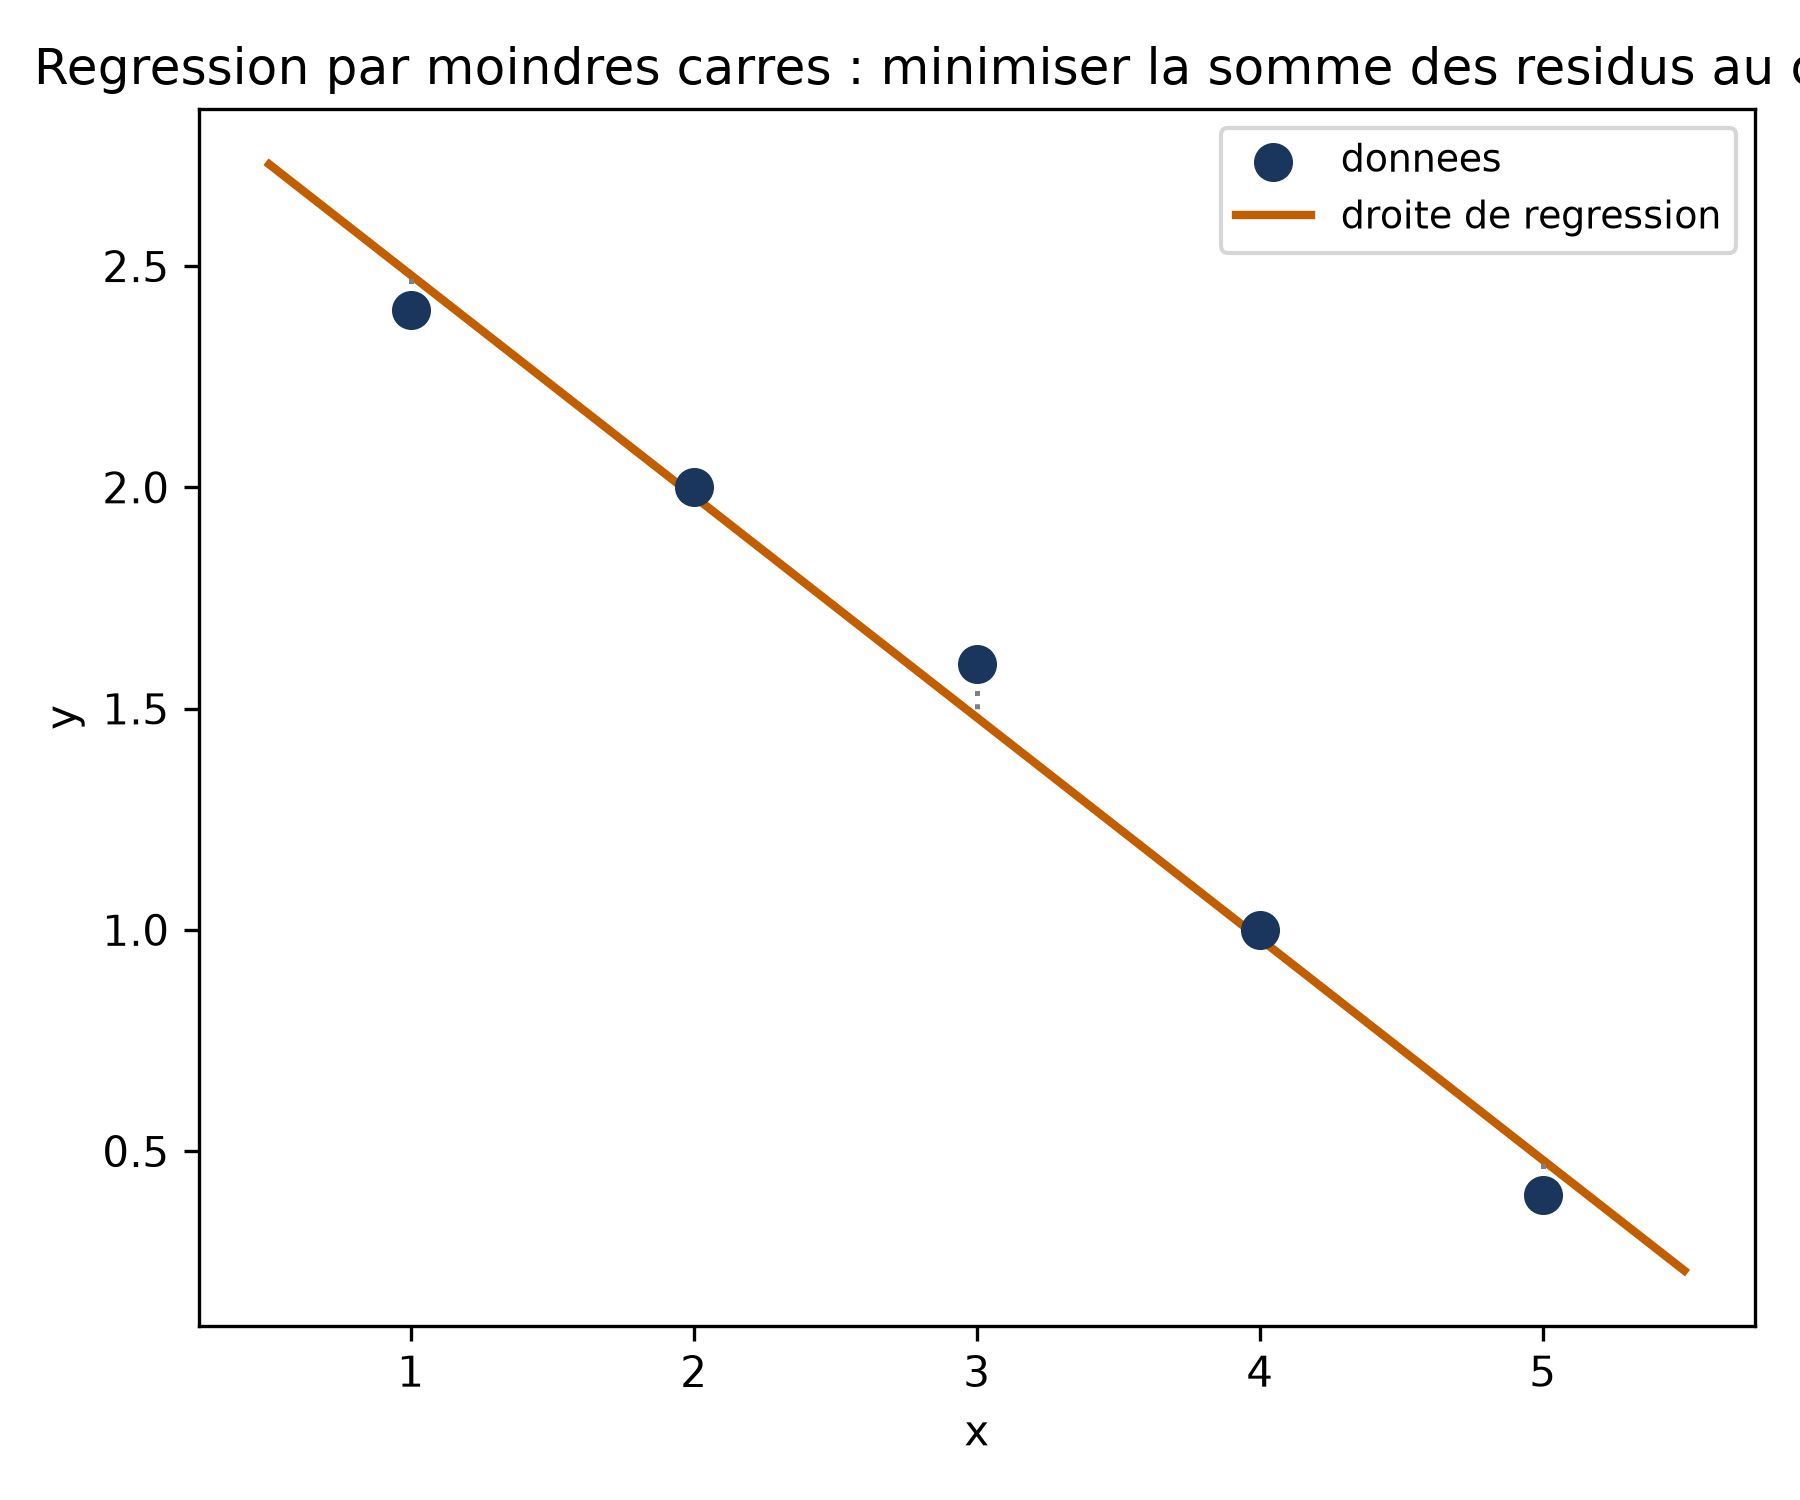
Il reste à résumer tous ces écarts en un seul score. On élève chaque résidu au carré, puis on additionne :
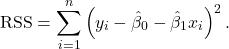
Les lettres RSS désignent la somme des carrés des résidus. Le carré a un effet que tu peux vérifier à la main : un écart de 2 compte pour 4, mais un écart de 10 compte pour 100. Les gros écarts pèsent donc bien plus lourd que les petits dans le score.
Cette règle de choix s’appelle la méthode des moindres carrés : on garde les deux boutons qui rendent le RSS le plus petit possible.
💡 Intuition Pour la meilleure droite, les écarts positifs et négatifs se compensent exactement : la somme des résidus est toujours nulle. C’est un contrôle pratique, car si ta somme n’est pas nulle, le calcul ne s’est pas terminé correctement.
Chercher le fond du bol avec une pente
Le RSS dépend des deux boutons, et . Imagine qu’on les fasse varier : le score monte et descend comme le relief d’un bol. Chercher les meilleurs réglages, c’est chercher le point le plus bas du bol. Les mathématiques ont un outil pour cela : la dérivée.
Pense à une voiture. Sa vitesse moyenne s’obtient en divisant la distance par le temps écoulé ; sa vitesse à un instant précis s’obtient en rétrécissant l’intervalle de temps jusqu’à presque zéro. Cette vitesse instantanée, c’est la dérivée, le taux de variation à cet instant. Sur une courbe, elle correspond à la pente de la tangente, la droite qui effleure la courbe en un point.
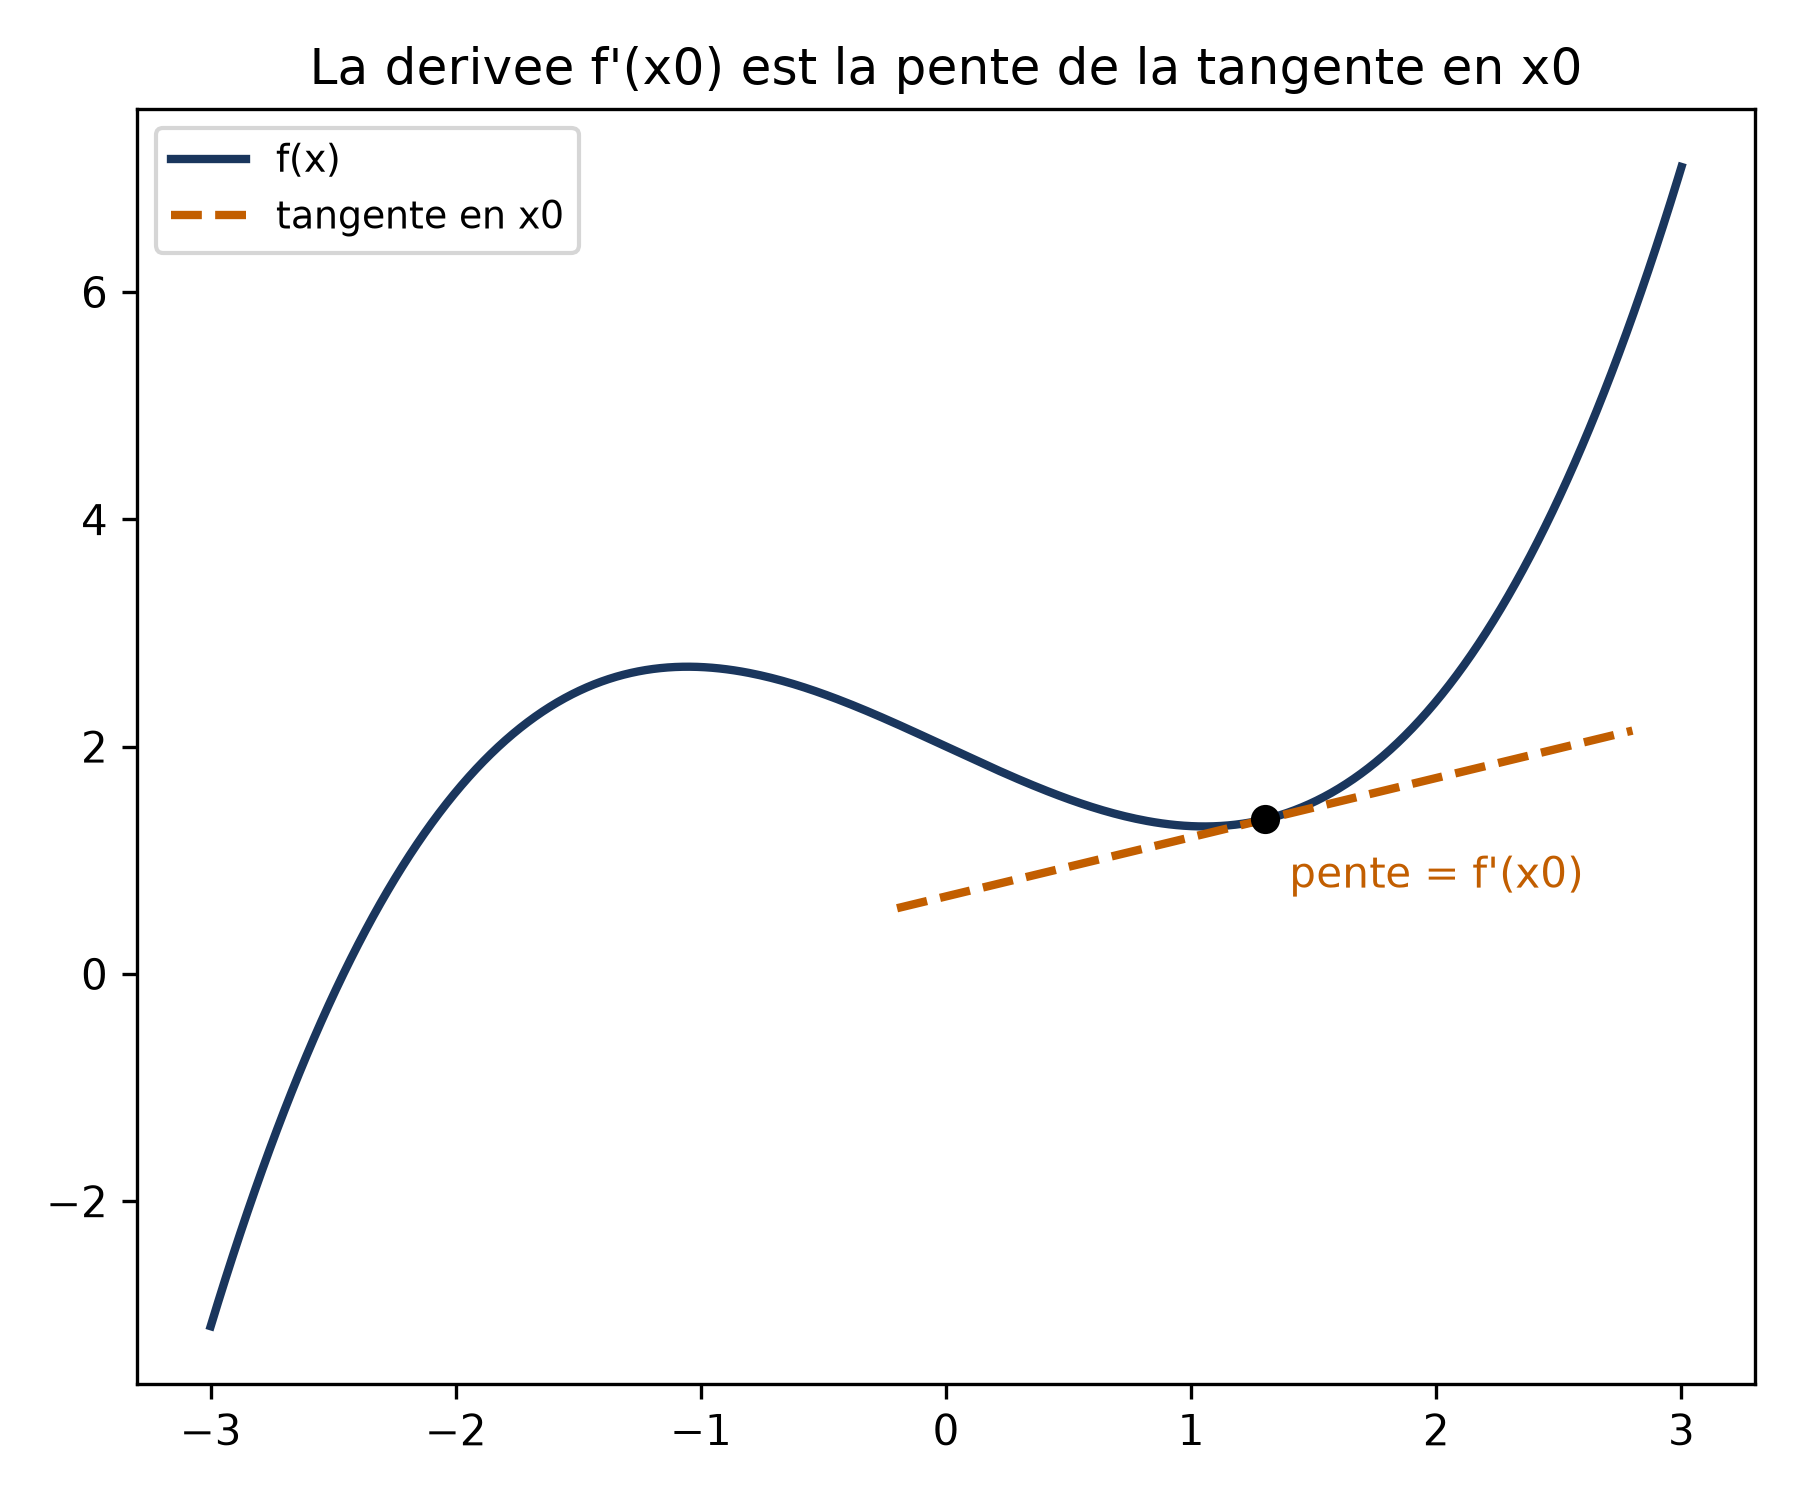
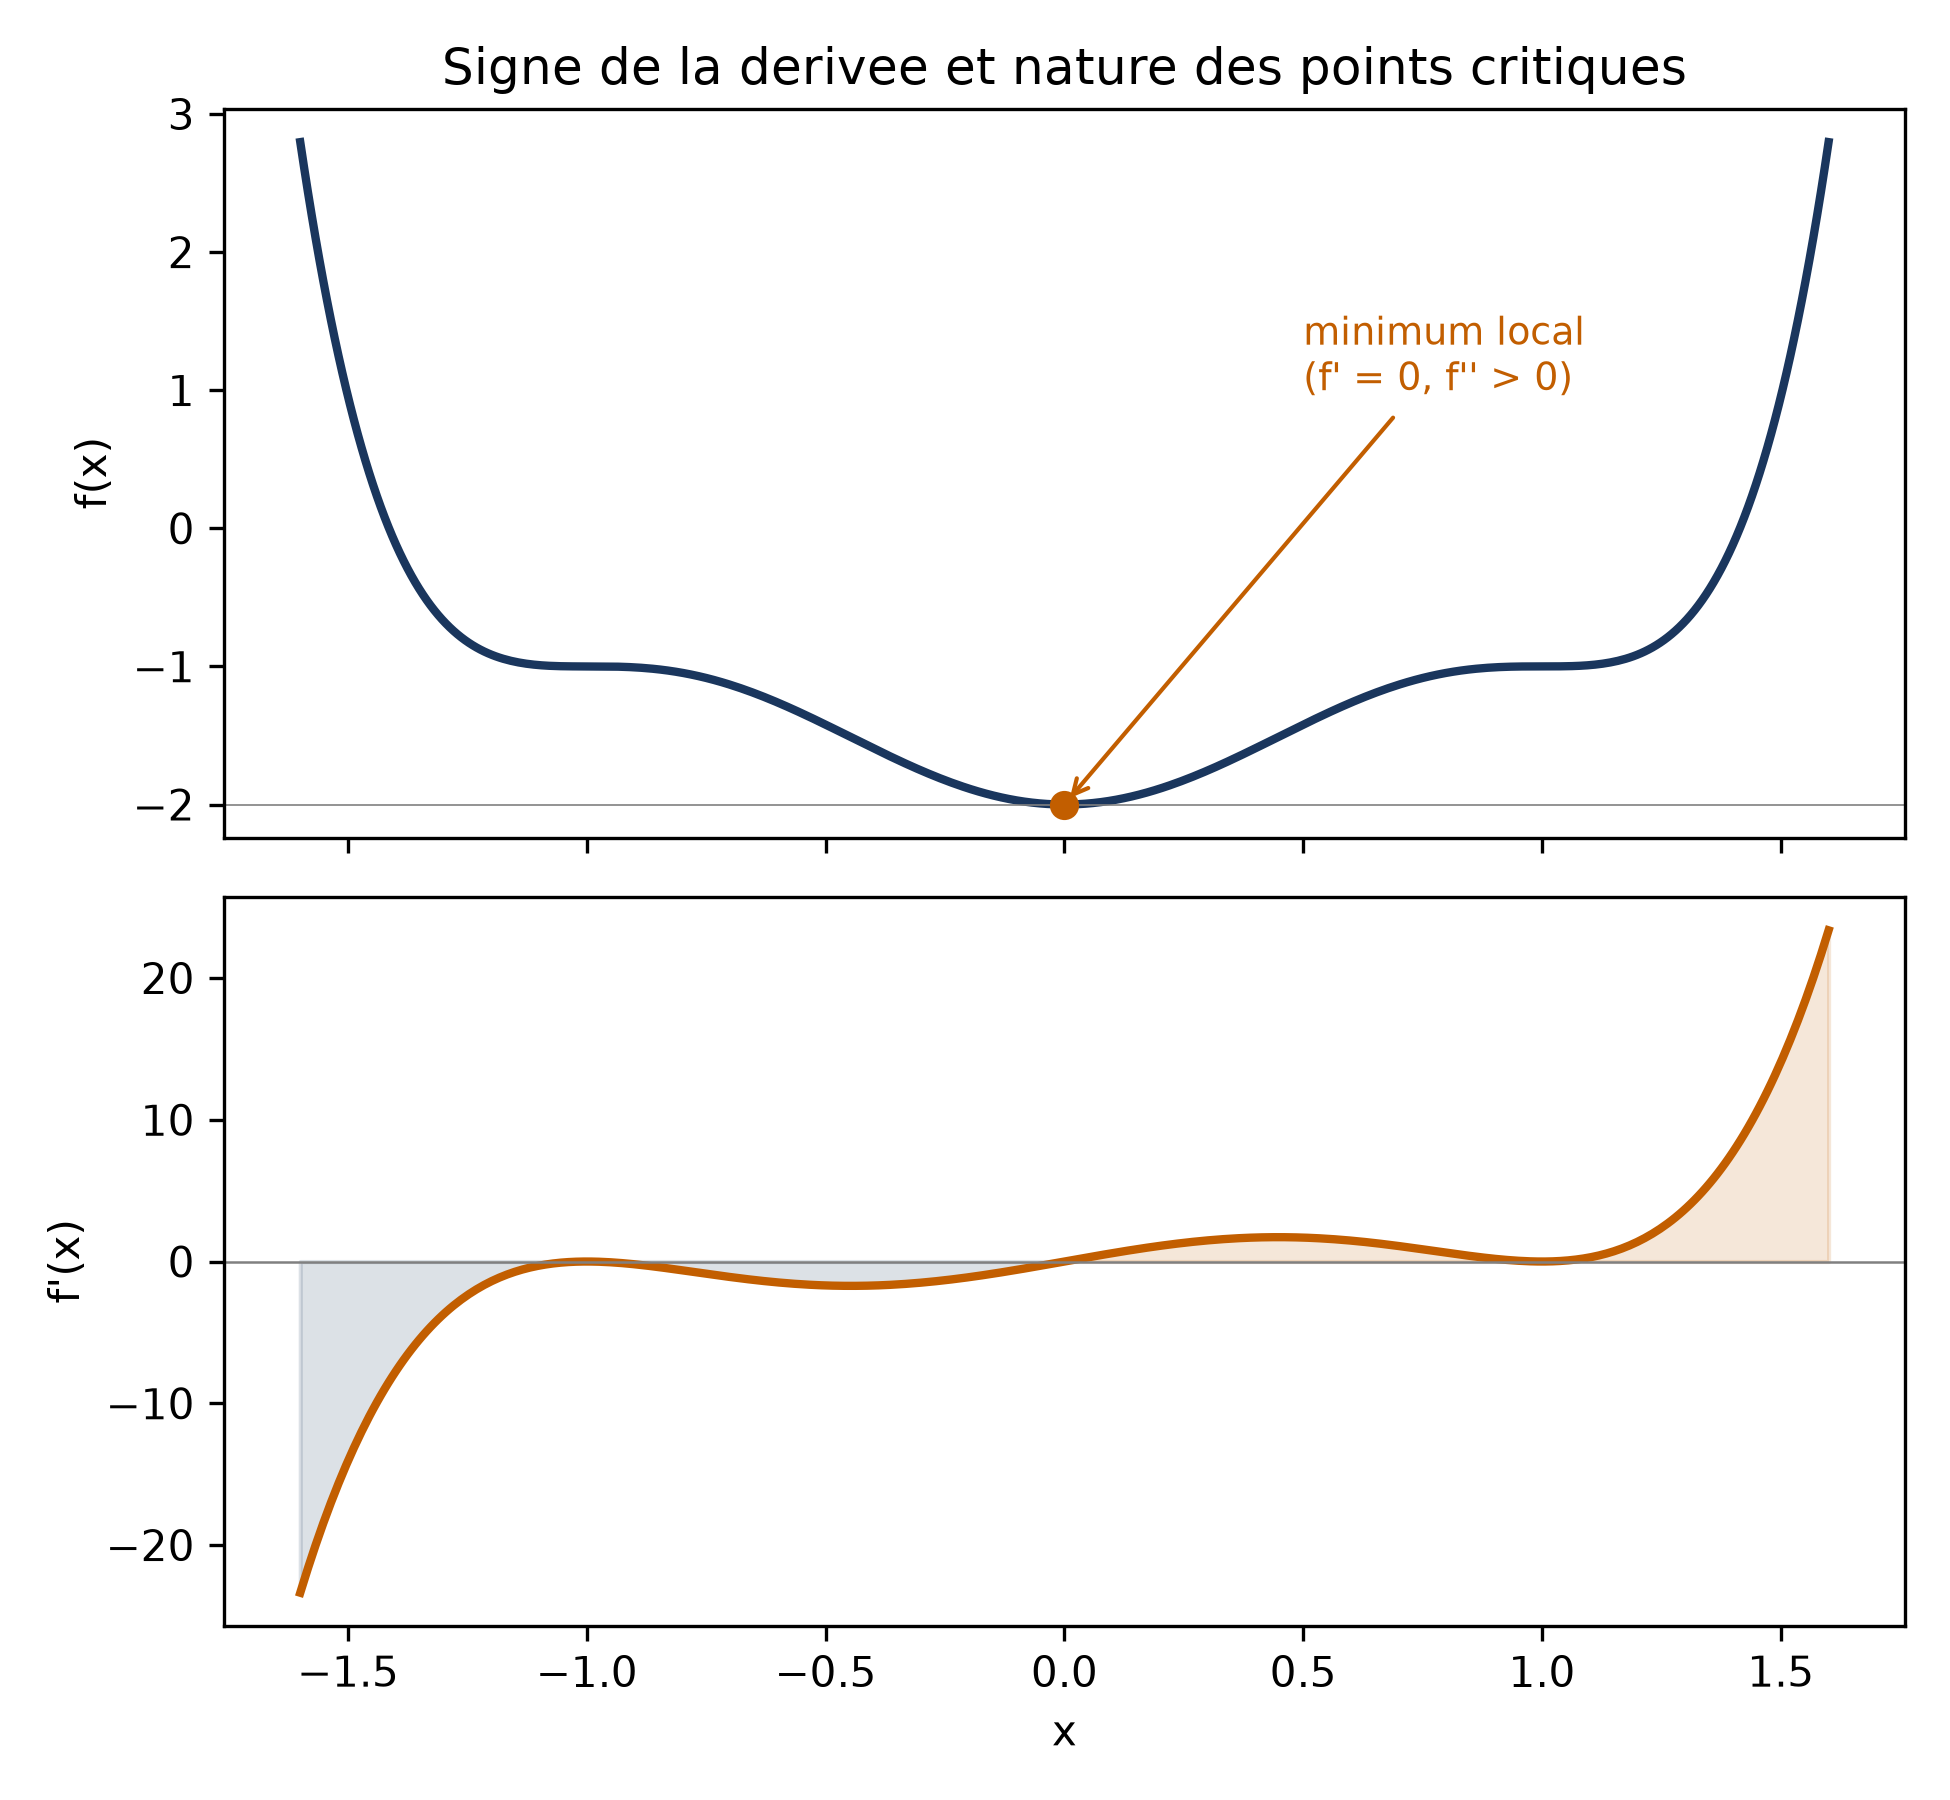
Le signe de la dérivée raconte le reste. Quand elle est positive, la courbe monte ; quand elle est négative, elle descend. Au fond du bol, la tangente est horizontale, donc la dérivée vaut zéro, et elle change de signe : négative avant, positive après. La dérivée seconde confirme que c’est un bol et pas un sommet : positive, la courbe se redresse comme un bol.
Ici, il y a deux boutons et non un seul. On utilise alors une dérivée partielle : on traite toutes les variables sauf une comme des constantes, et on ne regarde la pente que dans cette direction.Minimiser le RSS revient à annuler ces pentes pour chaque bouton. On obtient deux équations de degré un, qu’on sait résoudre exactement.
📌 À retenir Trouver la meilleure droite n’a rien de mystérieux : on cherche l’endroit où l’erreur cesse de descendre, c’est-à-dire où ses deux pentes valent zéro.
La formule de la pente : deux nuages qui bougent ensemble
La résolution de ces deux équations donne des formules toutes faites :
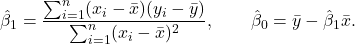
Les barres désignent des moyennes :  est la moyenne des
 ,
 celle des
 . Pour lire la formule sans effort, prends le haut et le bas séparément.
Le haut additionne, pour chaque point, le produit de deux écarts à la moyenne : celui de  et celui de
 . Cette somme est, à un facteur près, une covariance, qui indique si deux variables varient dans le même sens ou en sens opposé. Si dépasse sa moyenne quand dépasse la sienne, les produits sont positifs ; si l’un monte quand l’autre descend, ils sont négatifs.
Le bas additionne les carrés des écarts de seul : c’est la variance de , la dispersion de ses valeurs autour de leur moyenne.La pente est donc le rapport de la covariance entre et sur la variance de .
Autrement dit, la pente mesure combien les deux nuages bougent ensemble, rapporté à la façon dont bouge tout seul. Plus s’agite seul et moins le suit, plus la pente est faible.
L’ordonnée, elle, se déduit des moyennes : moins la pente fois . Relis-la : pour la valeur moyenne de , cette droite prédit exactement la valeur moyenne de .
Il existe une version de la covariance ramenée à une échelle fixe, le coefficient de corrélation de Pearson, qui reste toujours entre −1 et 1.
⚠️ Piège Une covariance nulle ne prouve pas l’absence de lien. Prends
et
:
Quand les boutons se multiplient : le tableau et le produit ligne-colonne
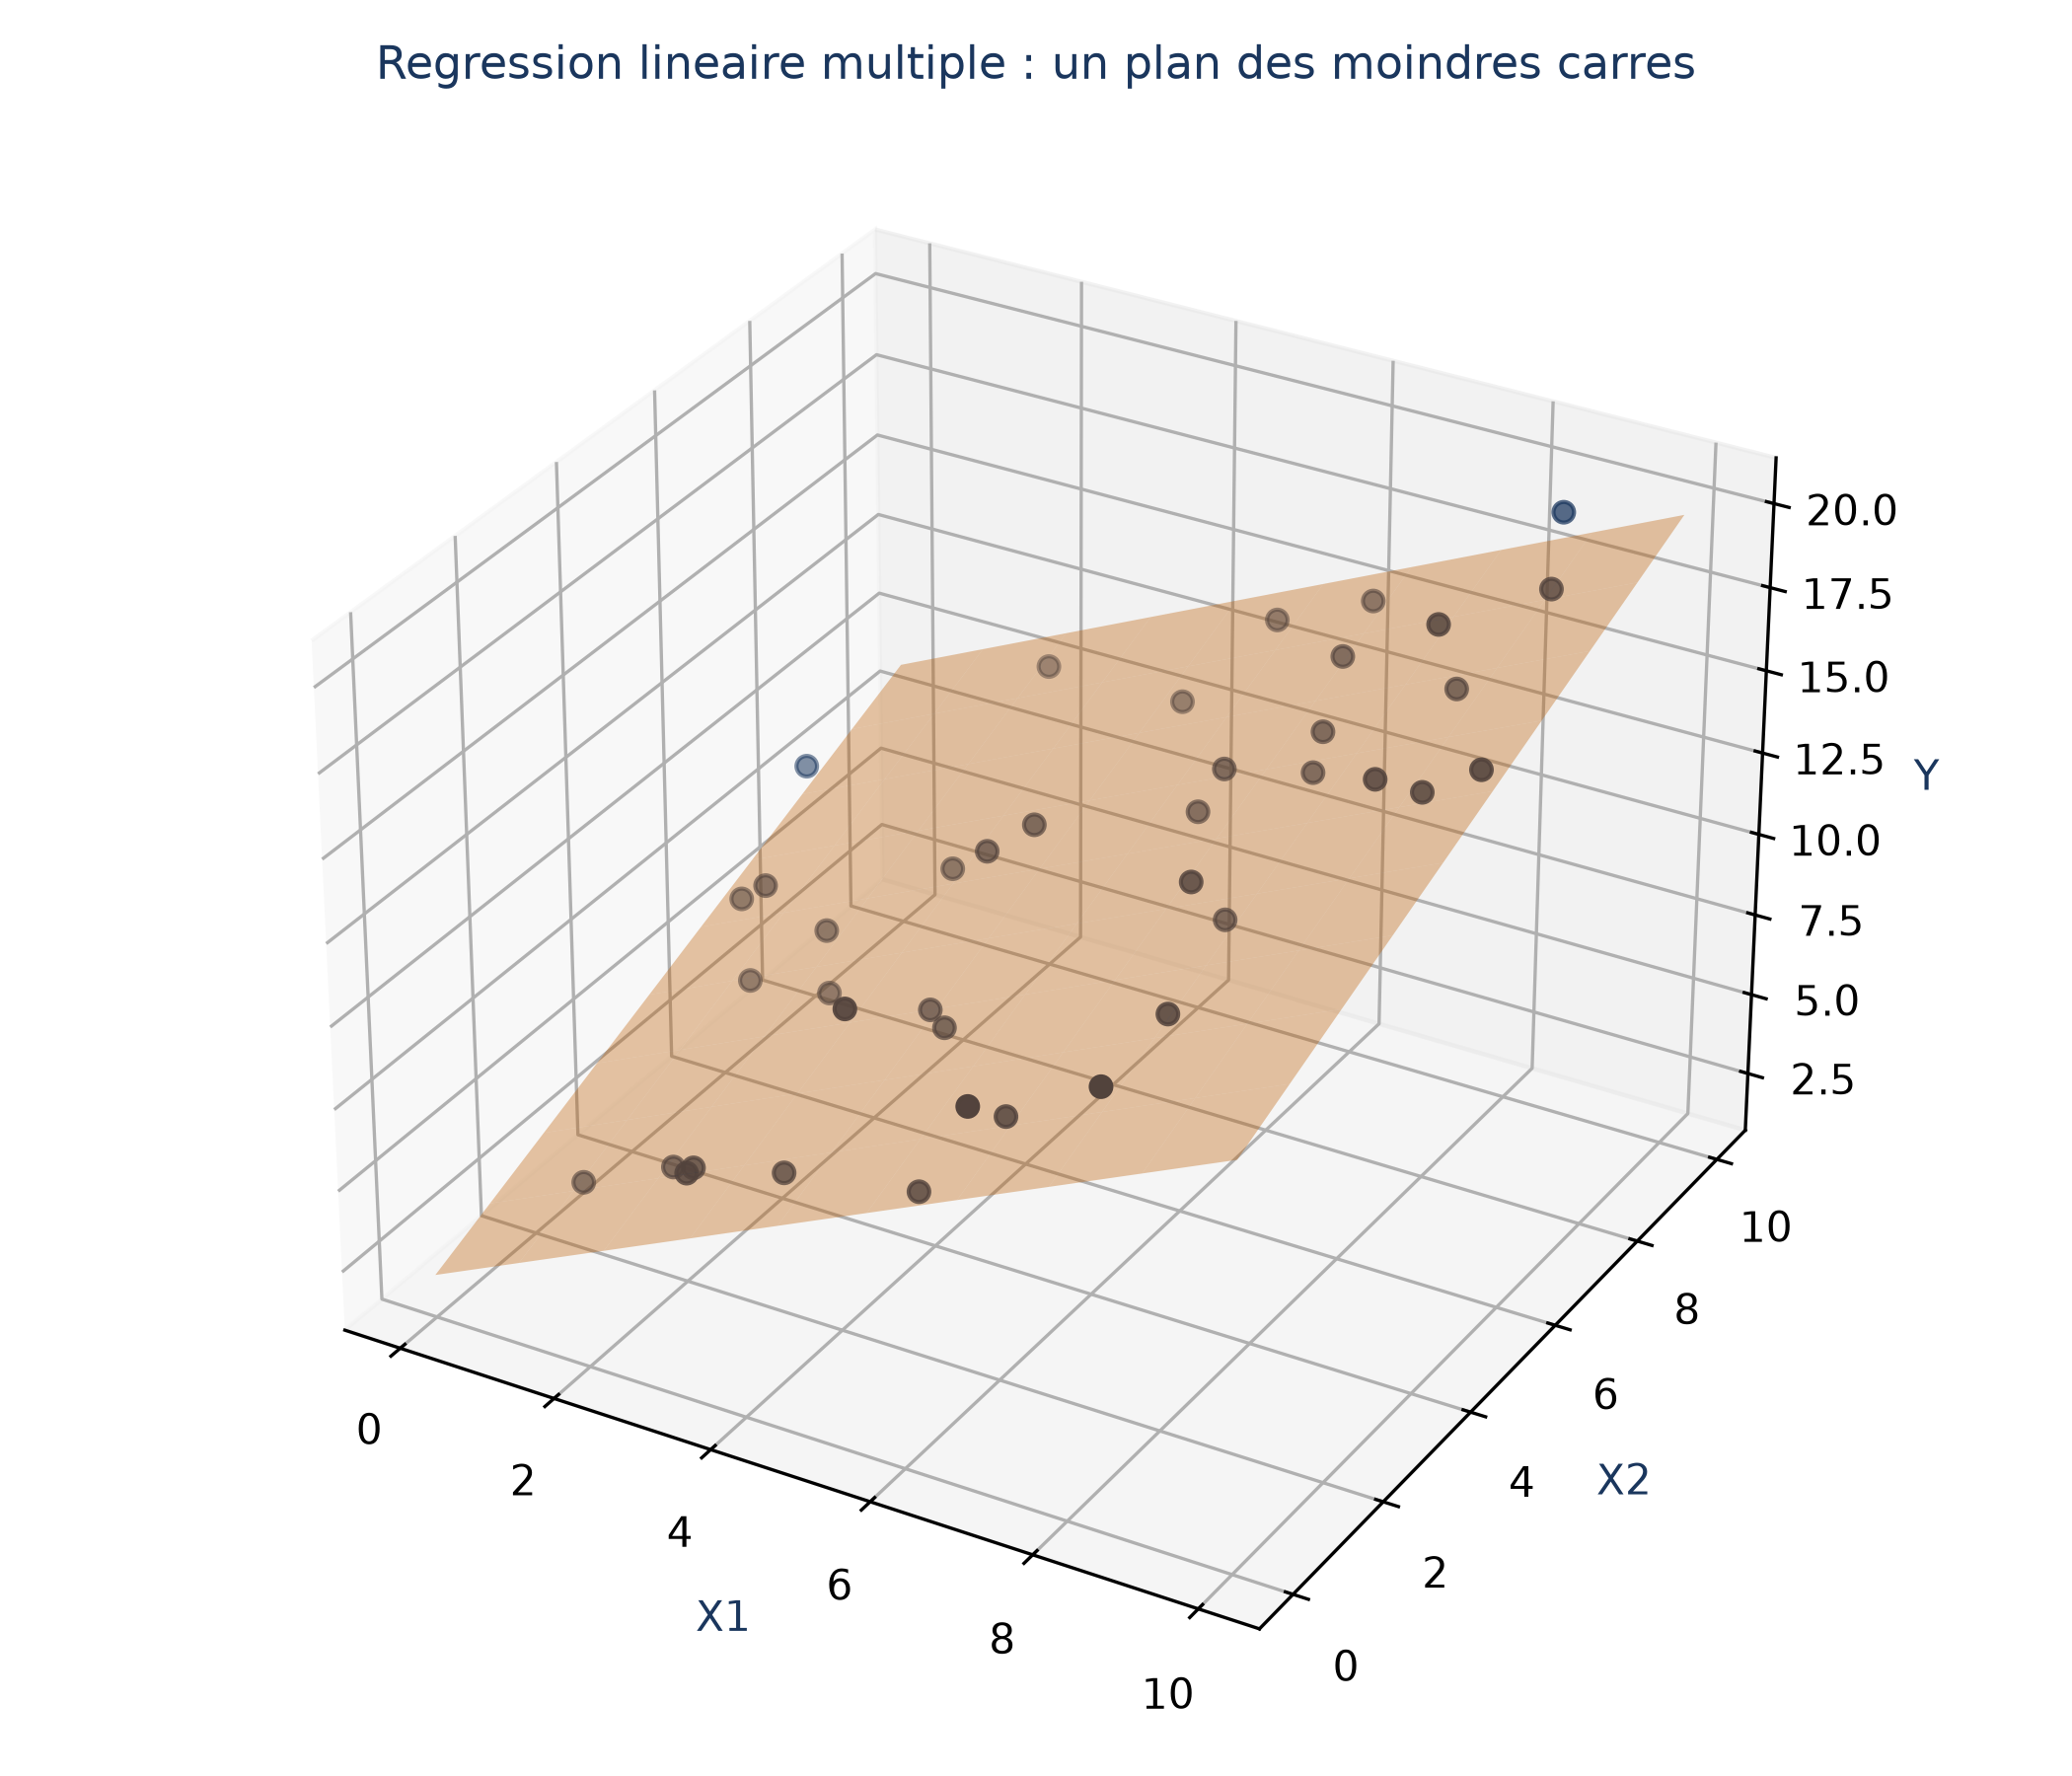
Avec plusieurs variables, la droite devient une formule à plusieurs pentes : 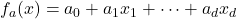 , où l’on convient que
 pour que l’ordonnée entre dans la même écriture que les pentes. On y trouve les mêmes coefficients, notés ici
 plutôt que
 .
Pour ranger tout cela, les mathématiciens utilisent un tableau de nombres, une matrice. Les notes de cinq étudiants dans deux matières en font une : chaque ligne est un étudiant, chaque colonne une matière. De la même façon, on range les  observations dans un tableau à lignes et
 colonnes, dont la première colonne ne contient que des 1.
Le calcul clé est le produit de deux listes de nombres : on multiplie les éléments deux à deux et on additionne. C’est ce qu’on appelle un produit scalaire, et c’est exactement ce que fait un neurone artificiel quand il pondère ses entrées. Pour une matrice, chaque case du résultat est le produit scalaire d’une ligne de la première matrice et d’une colonne de la seconde.
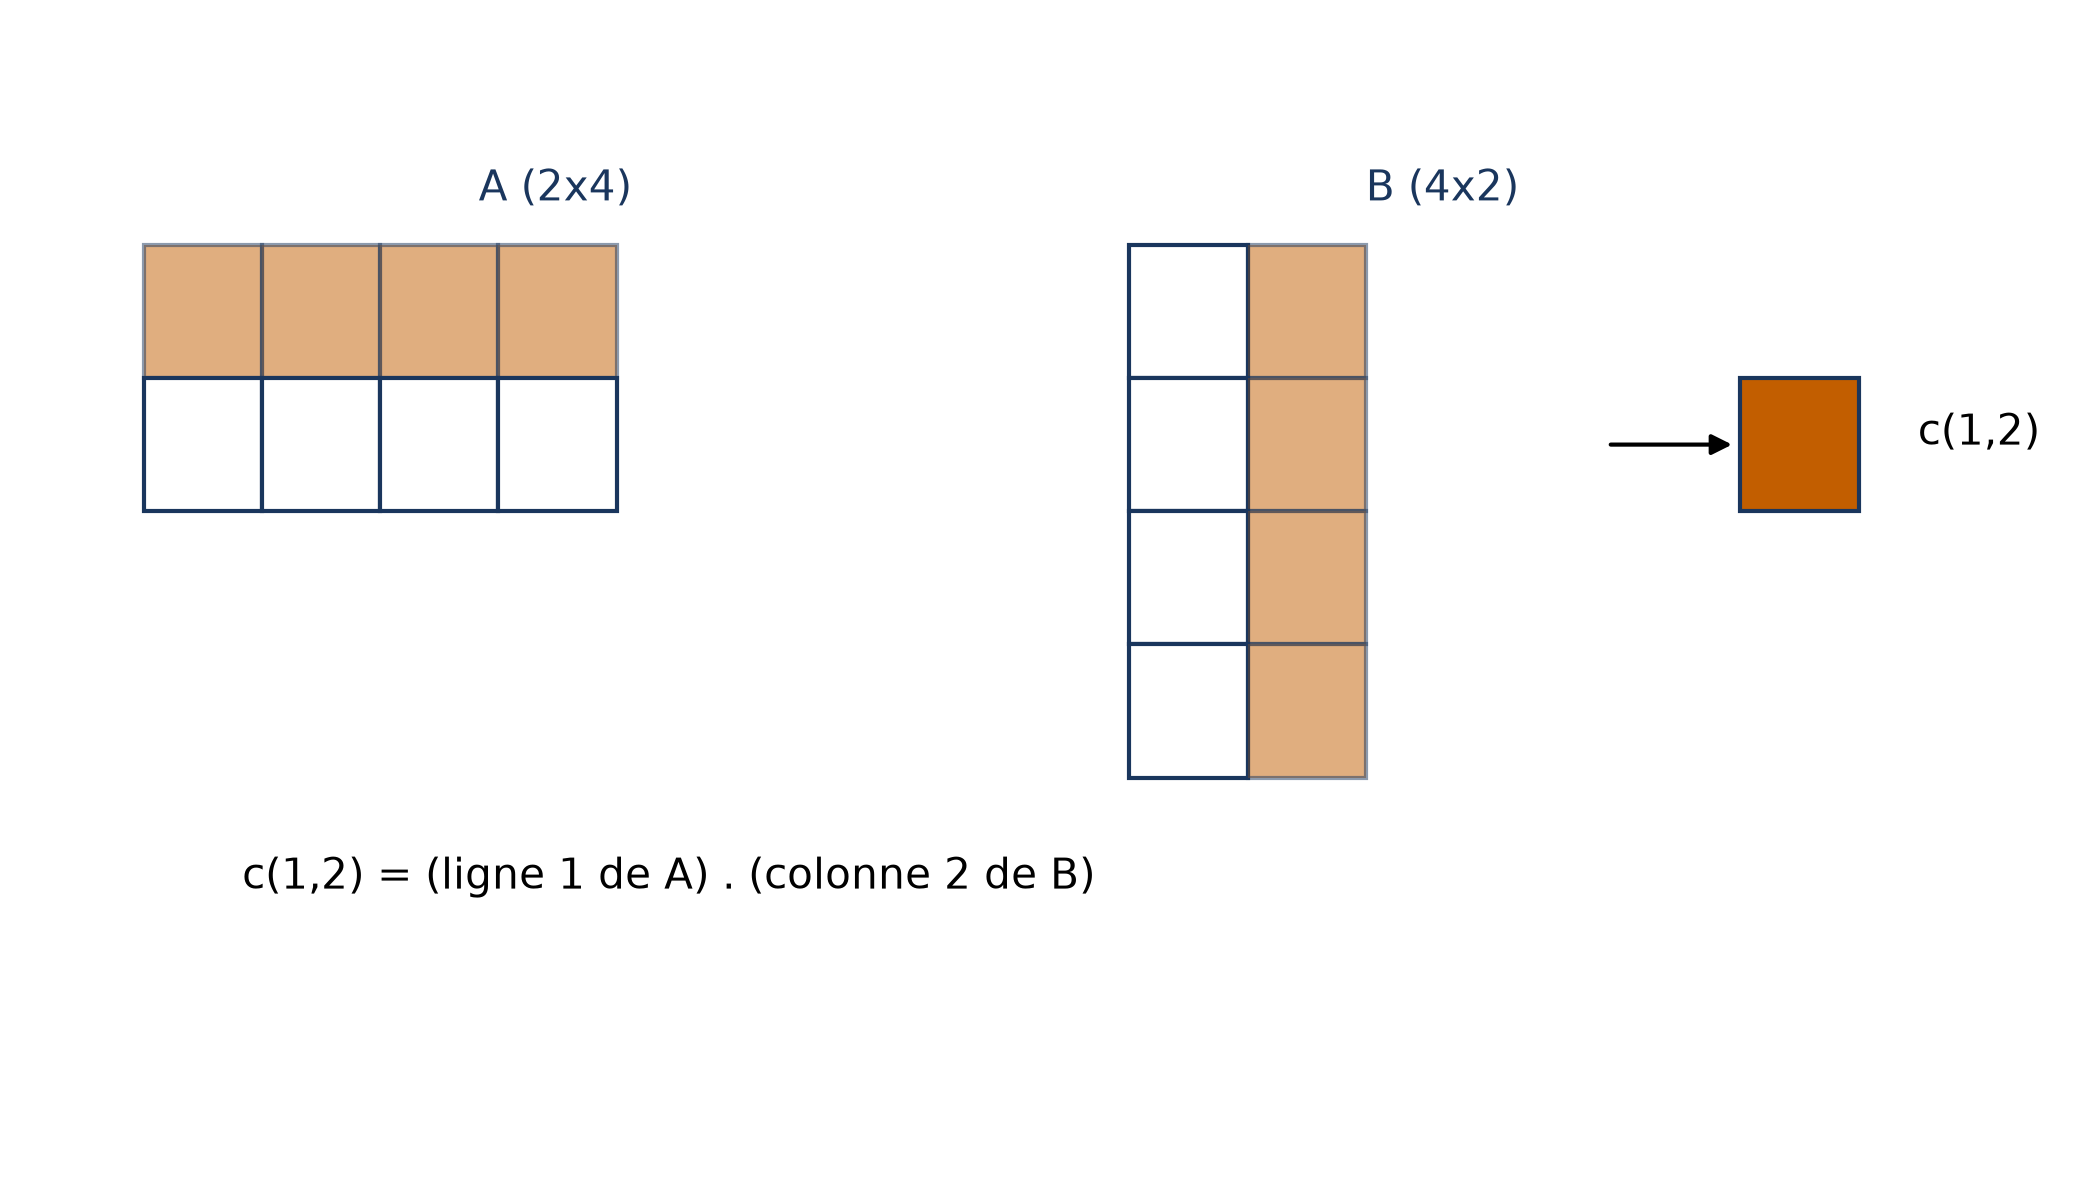
L’erreur à minimiser se réécrit alors de façon compacte, 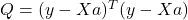 . En l’annulant, la pente tout entière donne l’équation normale :
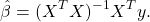
Cette formule généralise à  dimensions celles qu’on a vues pour une seule variable. Elle réclame d’inverser la matrice
 , ce qui est impossible quand la matrice est singulière, c’est-à-dire quand certaines colonnes de sont linéairement dépendantes : l’une se déduit des autres. Dans ce cas, deux colonnes apportent la même information, et aucune formule ne peut répartir leur effet.
Descendre dans le brouillard quand la formule est trop lourde
Inverser devient coûteux quand les variables sont très nombreuses. On change alors de méthode : au lieu de calculer d’un coup, on avance par petits pas, comme un randonneur dans le brouillard qui ne voit que la pente sous ses pieds.
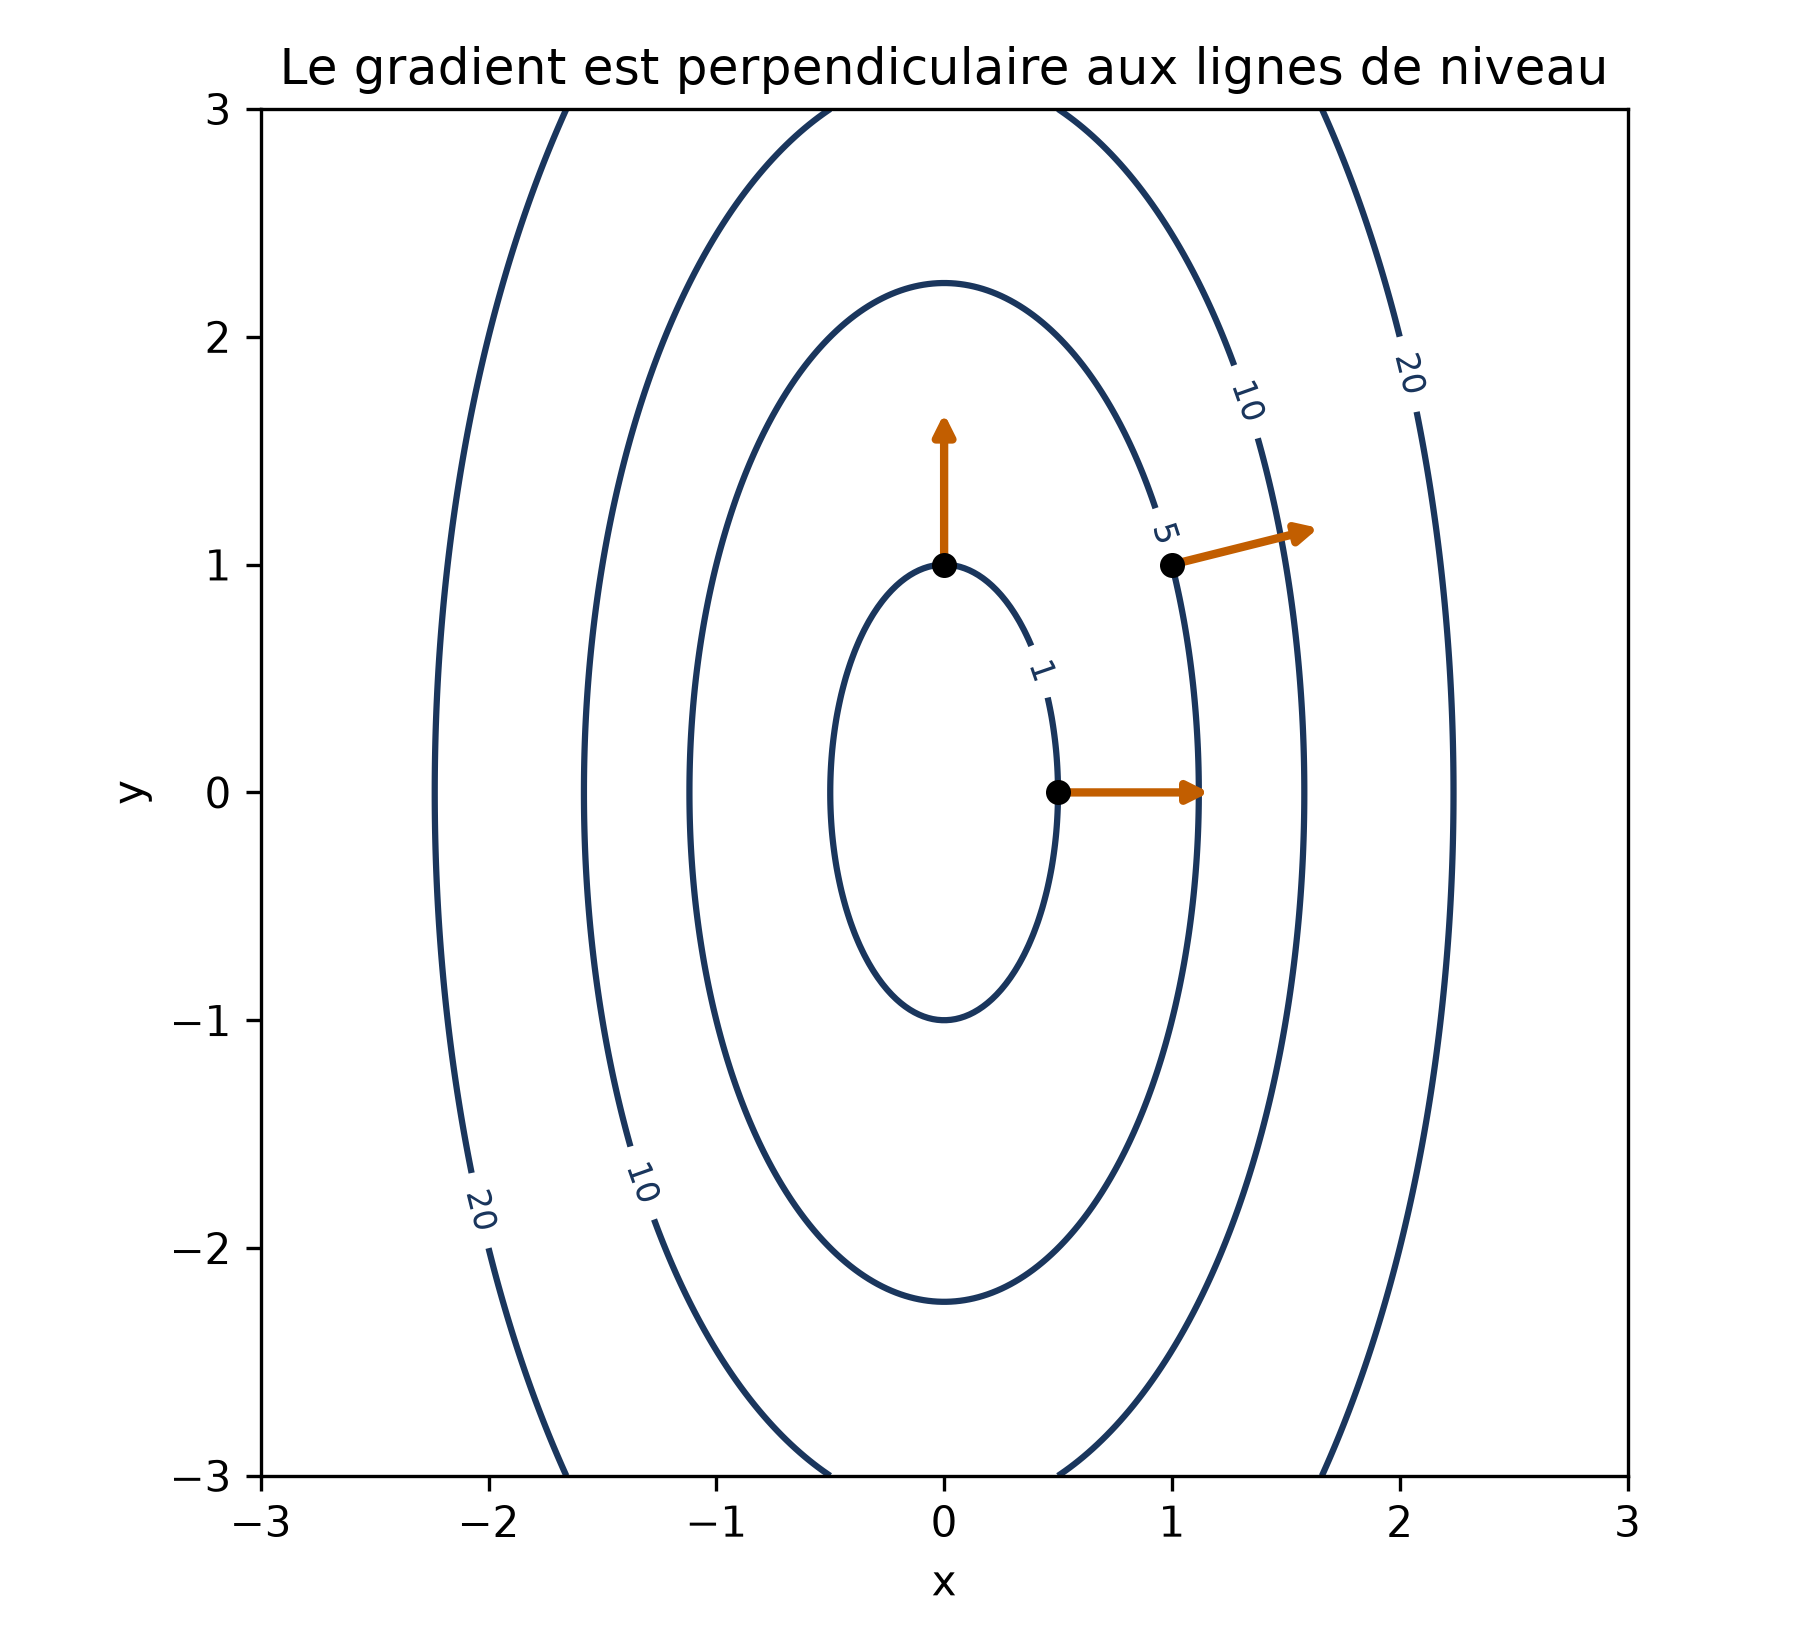
Pour savoir où aller, il utilise le gradient : un vecteur qui rassemble toutes les dérivées partielles et pointe vers la direction où la fonction croît le plus vite. Il est toujours perpendiculaire aux lignes de niveau, ces courbes le long desquelles la fonction garde la même valeur.
La règle de mise à jour tient en une ligne :
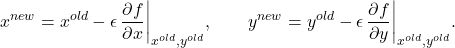
Elle se lit ainsi : la nouvelle valeur est l’ancienne, moins un petit coup donné dans le sens de la pente. Le nombre  règle la longueur de chaque pas. On part de valeurs quelconques et on répète, jusqu’à ce que l’erreur soit assez petite : on rejoint alors la même solution que la formule exacte.
La recette retrouvée, et ce que la droite ne voit pas
Revenons à notre devinette. Après avoir écarté un point aberrant introduit volontairement, la méthode est lancée sur les points restants. Voici les lignes qui l’exécutent :
# Load cleaned dataset
cleaned_data = pd.read_csv('cleaned_data.csv')

X_clean = cleaned_data[['X']].values
y_clean = cleaned_data['Y'].values

# Split data (70% train, 30% test)
X_train, X_test, y_train, y_test = train_test_split(
X_clean, y_clean, test_size=0.3, random_state=42)

# Train model
model = LinearRegression()
model.fit(X_train, y_train)
...
print("\nModel Report:")
print(f"Coefficient (slope): {model.coef_[0]:.4f}")
print(f"Intercept: {model.intercept_:.4f}")
On lit directement les deux boutons : coef_ est la pente, intercept_ l’ordonnée. Le résultat est une pente proche de 4,88 et une ordonnée proche de 4,02, cohérentes avec la recette 5X + 3,8 aux fluctuations du bruit près.
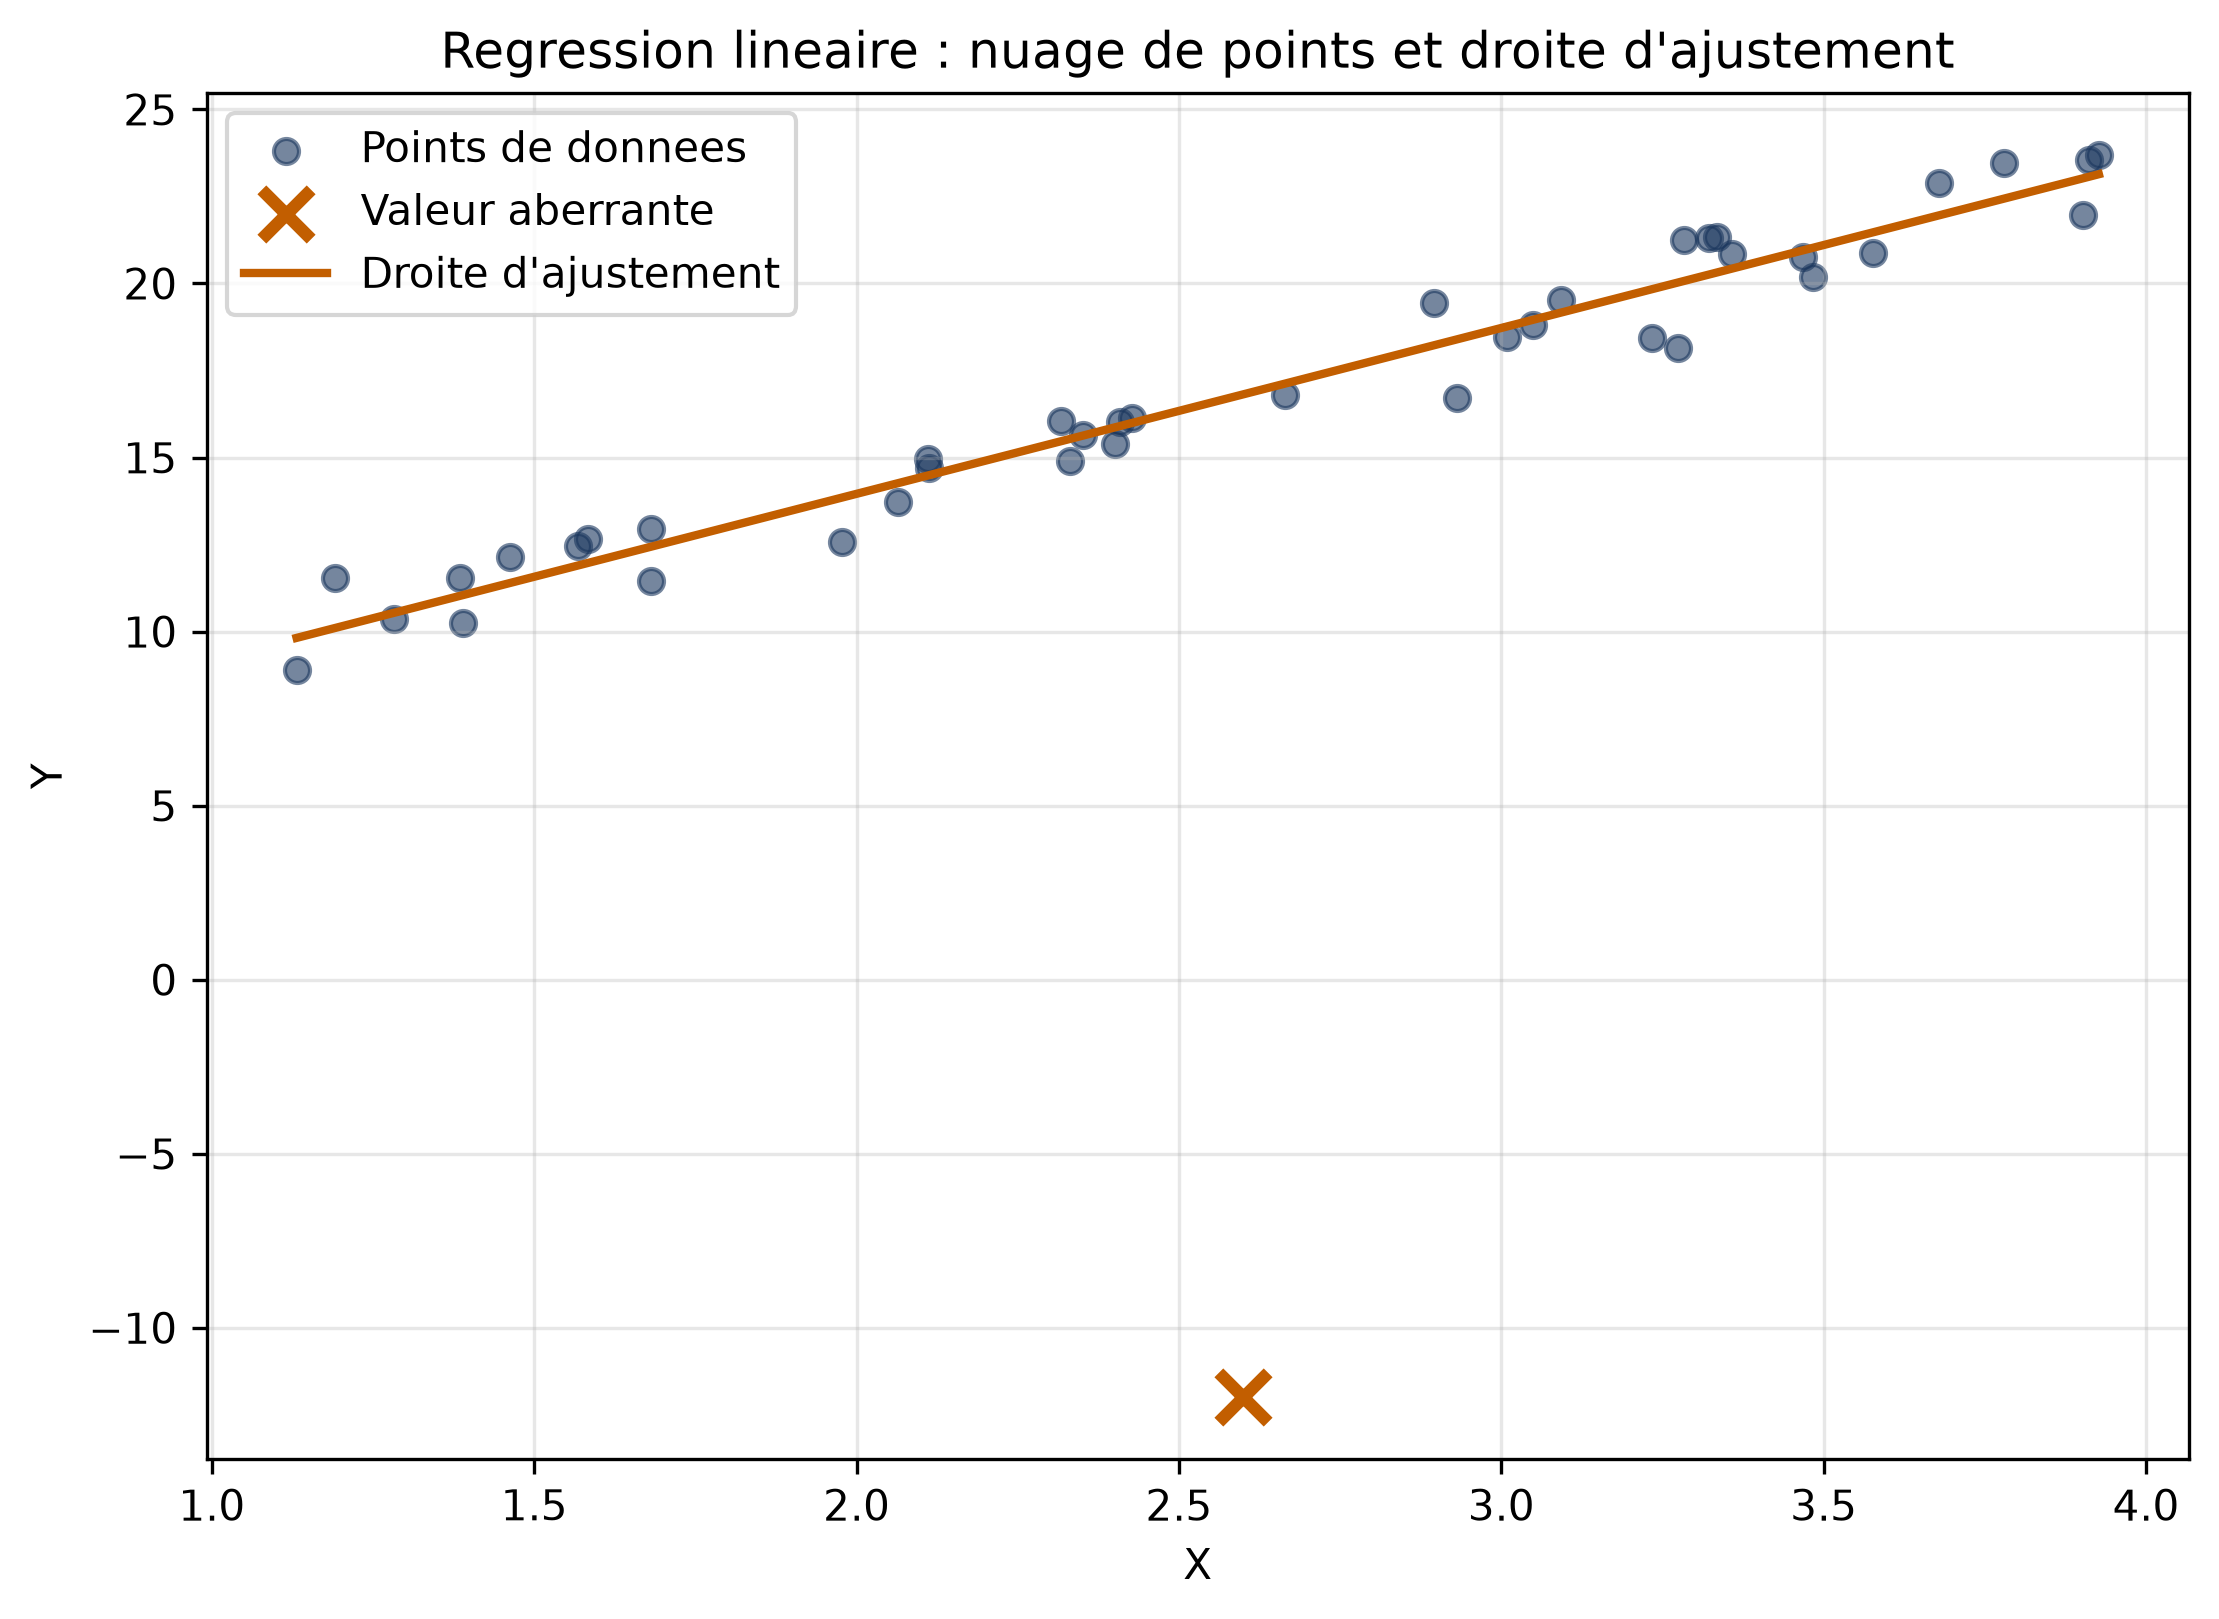
Retiens deux conséquences pratiques de tout ce qui précède. Une droite ne prédit que ce qui est linéaire : le lien courbe d’un instant plus tôt lui échappe. Enfin, un jeu très petit, de deux ou trois points, laisse des intervalles de confiance très larges, ce qui n’a rien d’anormal : il y a simplement peu de données pour estimer.
📌 À retenir Une régression linéaire, c’est : deux boutons (pente, ordonnée), un score (la somme des carrés des écarts), un fond de bol (dérivées nulles), et un raccourci par pas si le calcul direct coûte trop.