Tu as branché ton assistant sur tes documents. Il répond vite, avec aplomb, et sur les trois questions que tu as essayées, il a même eu raison. Pas de quoi dormir tranquille : un RAG peut se tromper de deux façons très différentes, et rien ne te dit laquelle tant que tu ne mesures pas.
À la fin de cet article, tu sauras poser le bon diagnostic : ton système ne trouve pas la bonne information, ou bien il la trouve et la lit de travers. Et tu sauras avec quelles mesures, sur quel jeu de test, et avec quelles précautions le vérifier.
L’essentiel en 30 secondes
- Un RAG se joue à deux étages mesurables : la récupération (trouver les bons passages) et la génération (rédiger la réponse à partir d’eux). L’indexation et l’augmentation ne se mesurent qu’indirectement.
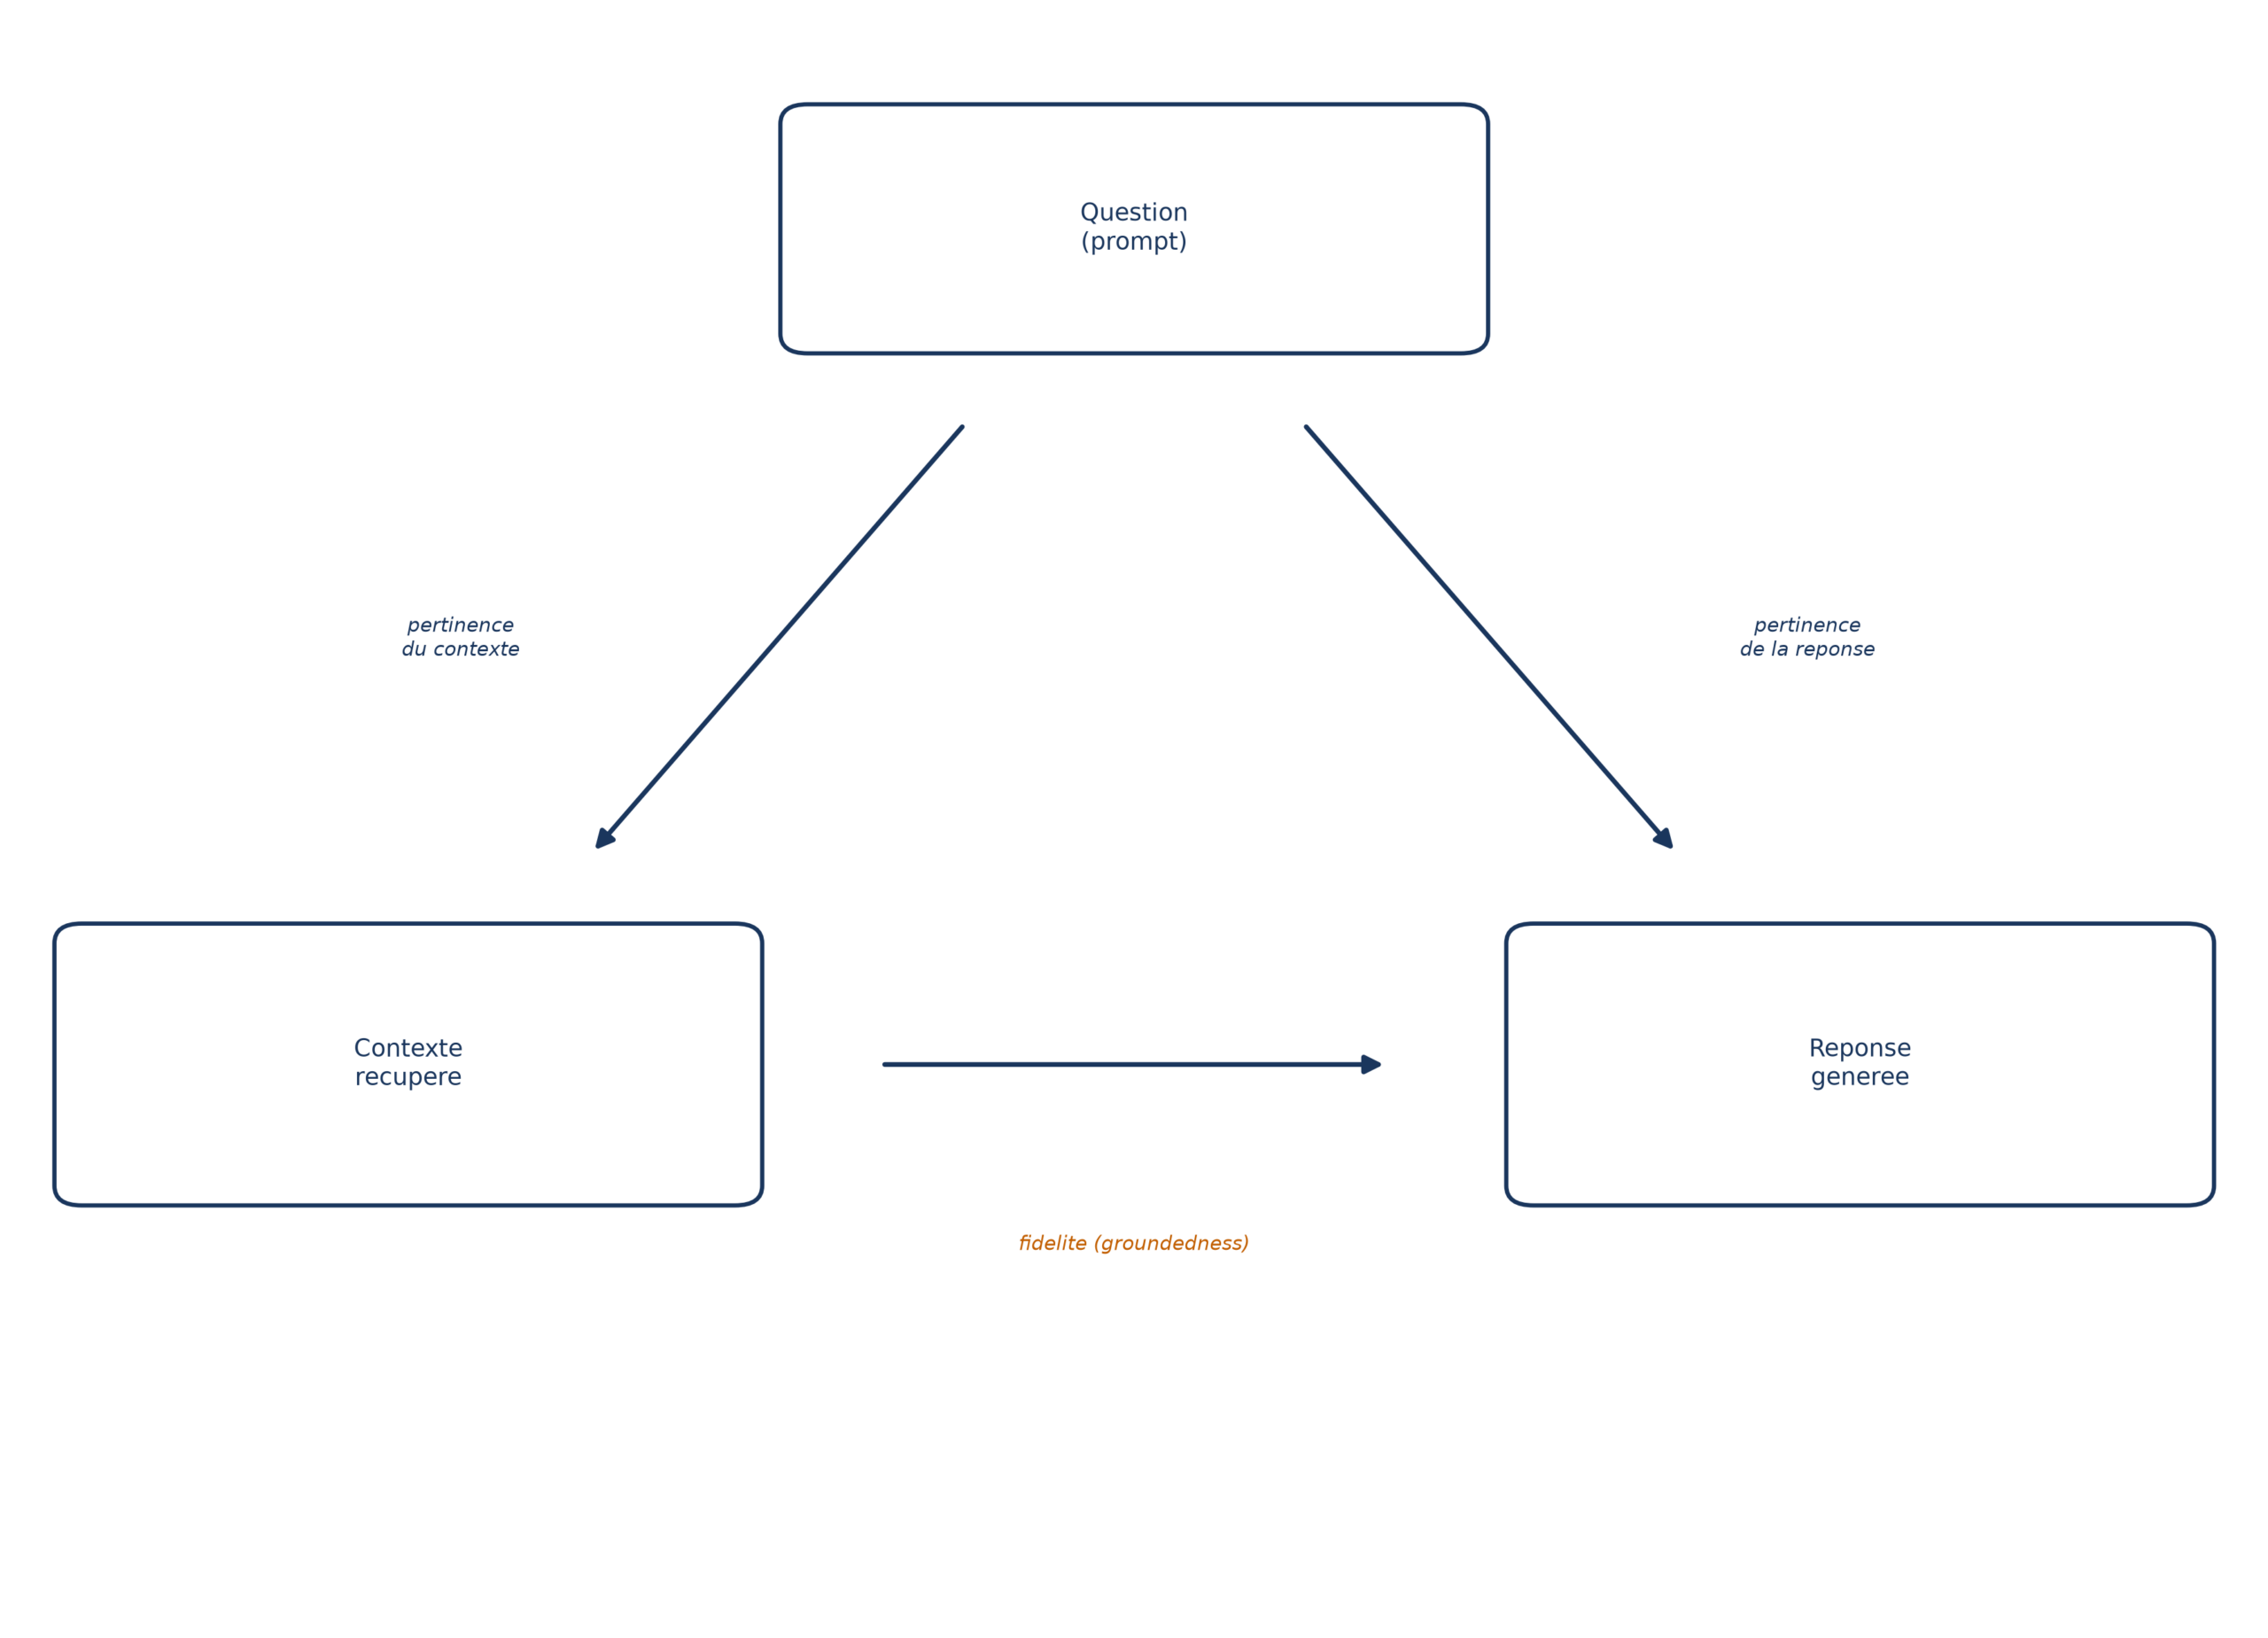
- Trois relations à surveiller : la question face au contexte récupéré (pertinence du contexte), le contexte face à la réponse (fidélité), la réponse face à la question (pertinence de la réponse).
- Côté récupération, on emprunte les métriques de la recherche d’information : précision, précision@k, rappel, F1, MRR, MAP, nDCG. Côté réponse, des frameworks comme RAGAS demandent à un LLM de jouer le juge.
- Tout cela exige un jeu de test : des questions associées à une réponse de référence (la ground truth), écrites à la main ou générées.
- Aucun score n’est parfait : le juge peut être biaisé, les benchmarks vieillissent, et la latence comme le coût comptent autant que l’exactitude.
L’intuition : deux endroits où ça peut casser
Le RAG le plus simple suit un chemin linéaire, « récupérer puis lire » : un retriever va chercher l’information, un LLM la lit pour écrire la réponse. Chaque étape a ses faiblesses. À la récupération, on peut ramener des passages hors sujet ou en manquer d’utiles. À la génération, ces défauts se paient en hallucinations.
Une hallucination peut ainsi naître de trois causes : le retriever n’a pas récupéré tout le contexte pertinent (ou en a récupéré un qui ne l’est pas), le LLM ignore le contexte fourni, ou il puise dans des éléments non pertinents du contexte au lieu de répondre à la question.
💡 Intuition Face à une mauvaise réponse, la bonne question n’est pas « est-elle fausse ? » mais « à quel étage a-t-elle déraillé ? ». Vérifier si le LLM répond bien quand on lui donne le bon contexte permet de séparer ses capacités de raisonnement et de synthèse de celles de la récupération.
Une figure résume ce qu’il faut regarder : un triangle formé par la question, le contexte récupéré et la réponse générée. Chaque côté est une métrique.
Où placer les mesures dans un vrai pipeline
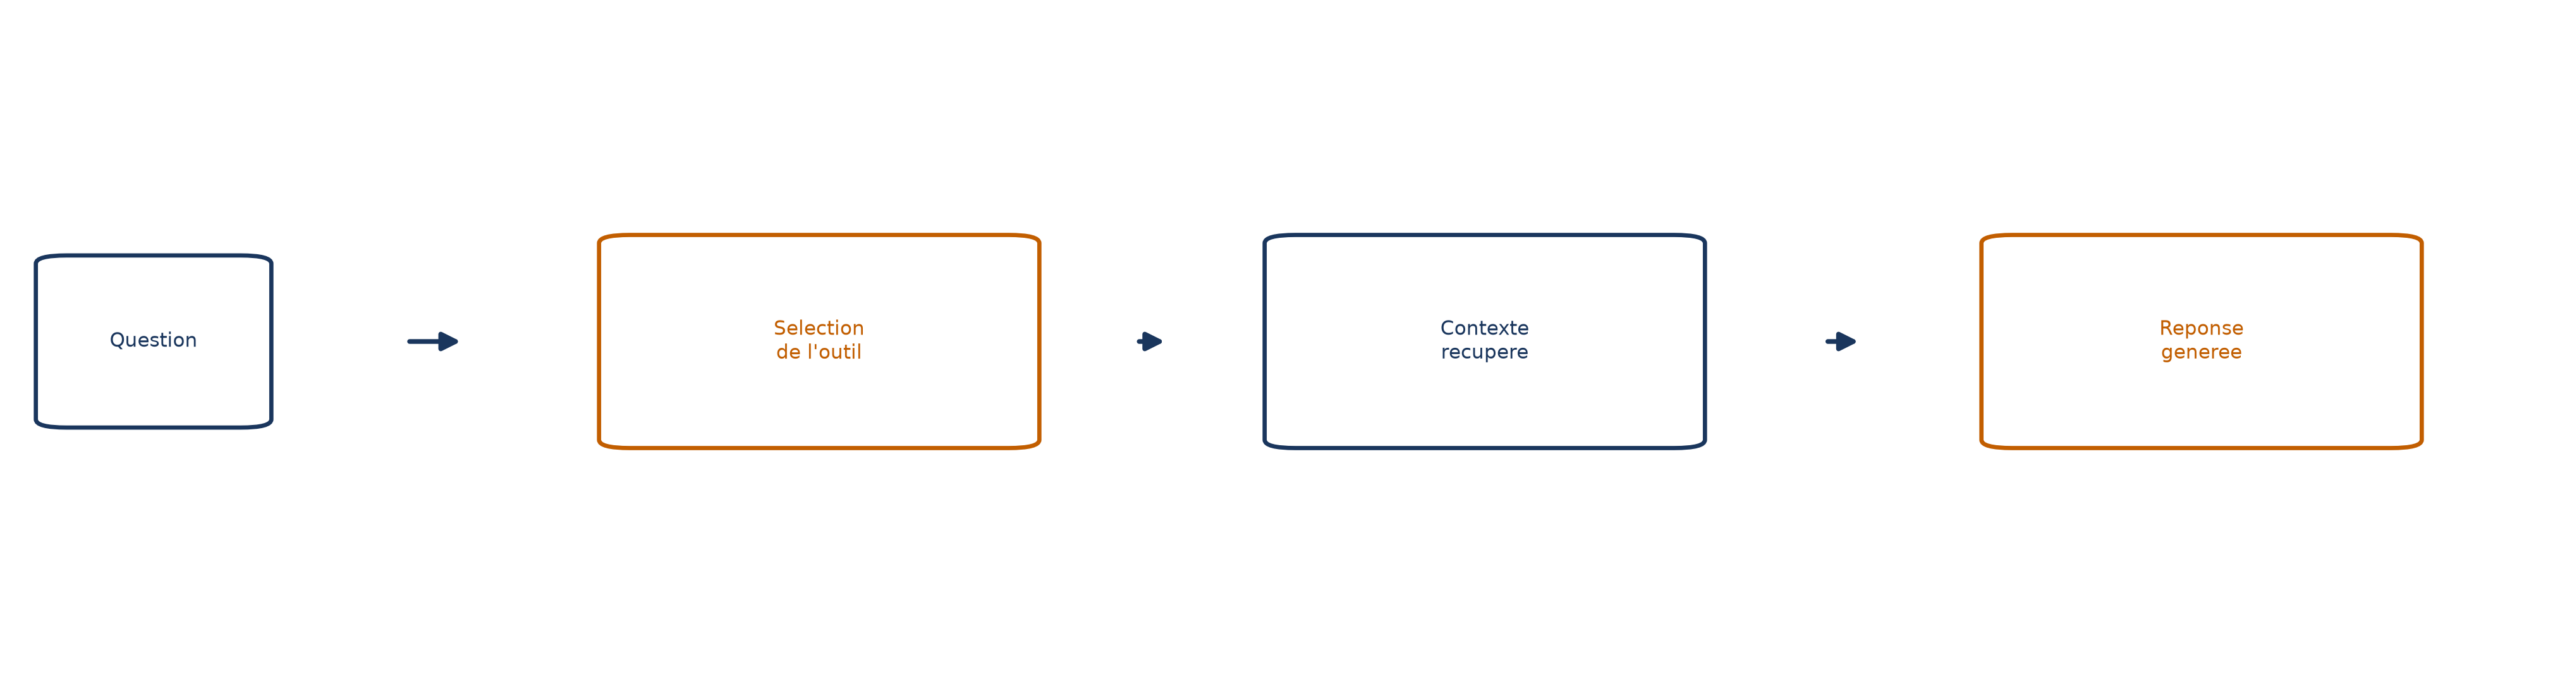
Prenons un agent qui répond à des questions sur une base de films, le fil rouge de cet article. Le pipeline commence par la question. Un LLM choisit l’outil de récupération le plus adapté (recherche vectorielle, gabarit de requête, génération de requête à la volée) : le choix lui-même peut être évalué. L’outil ramène un contexte, dont la pertinence est un autre point de mesure. Le LLM rédige enfin la réponse, et le pipeline entier peut être jugé d’un bloc.
Décider de ce que « réussir » veut dire
Avant de mesurer quoi que ce soit, il faut fixer des objectifs chiffrés. Un « réponse rapide » vague devient « 90 % des requêtes traitées en moins de 2 secondes », accompagné de métriques de succès choisies dès le départ, comme le taux de requêtes résolues, la latence ou la précision@5.
Sous le capot : les métriques
Côté récupération : a-t-il trouvé les bons passages ?
La précision répond à « parmi les documents récupérés, combien étaient pertinents ? ». Le rappel répond à l’inverse : « parmi tous les documents pertinents, combien ont été récupérés ? ». La précision@k limite le calcul aux k premiers résultats, ce qui colle bien au RAG puisque seuls les tout premiers servent à nourrir la réponse.
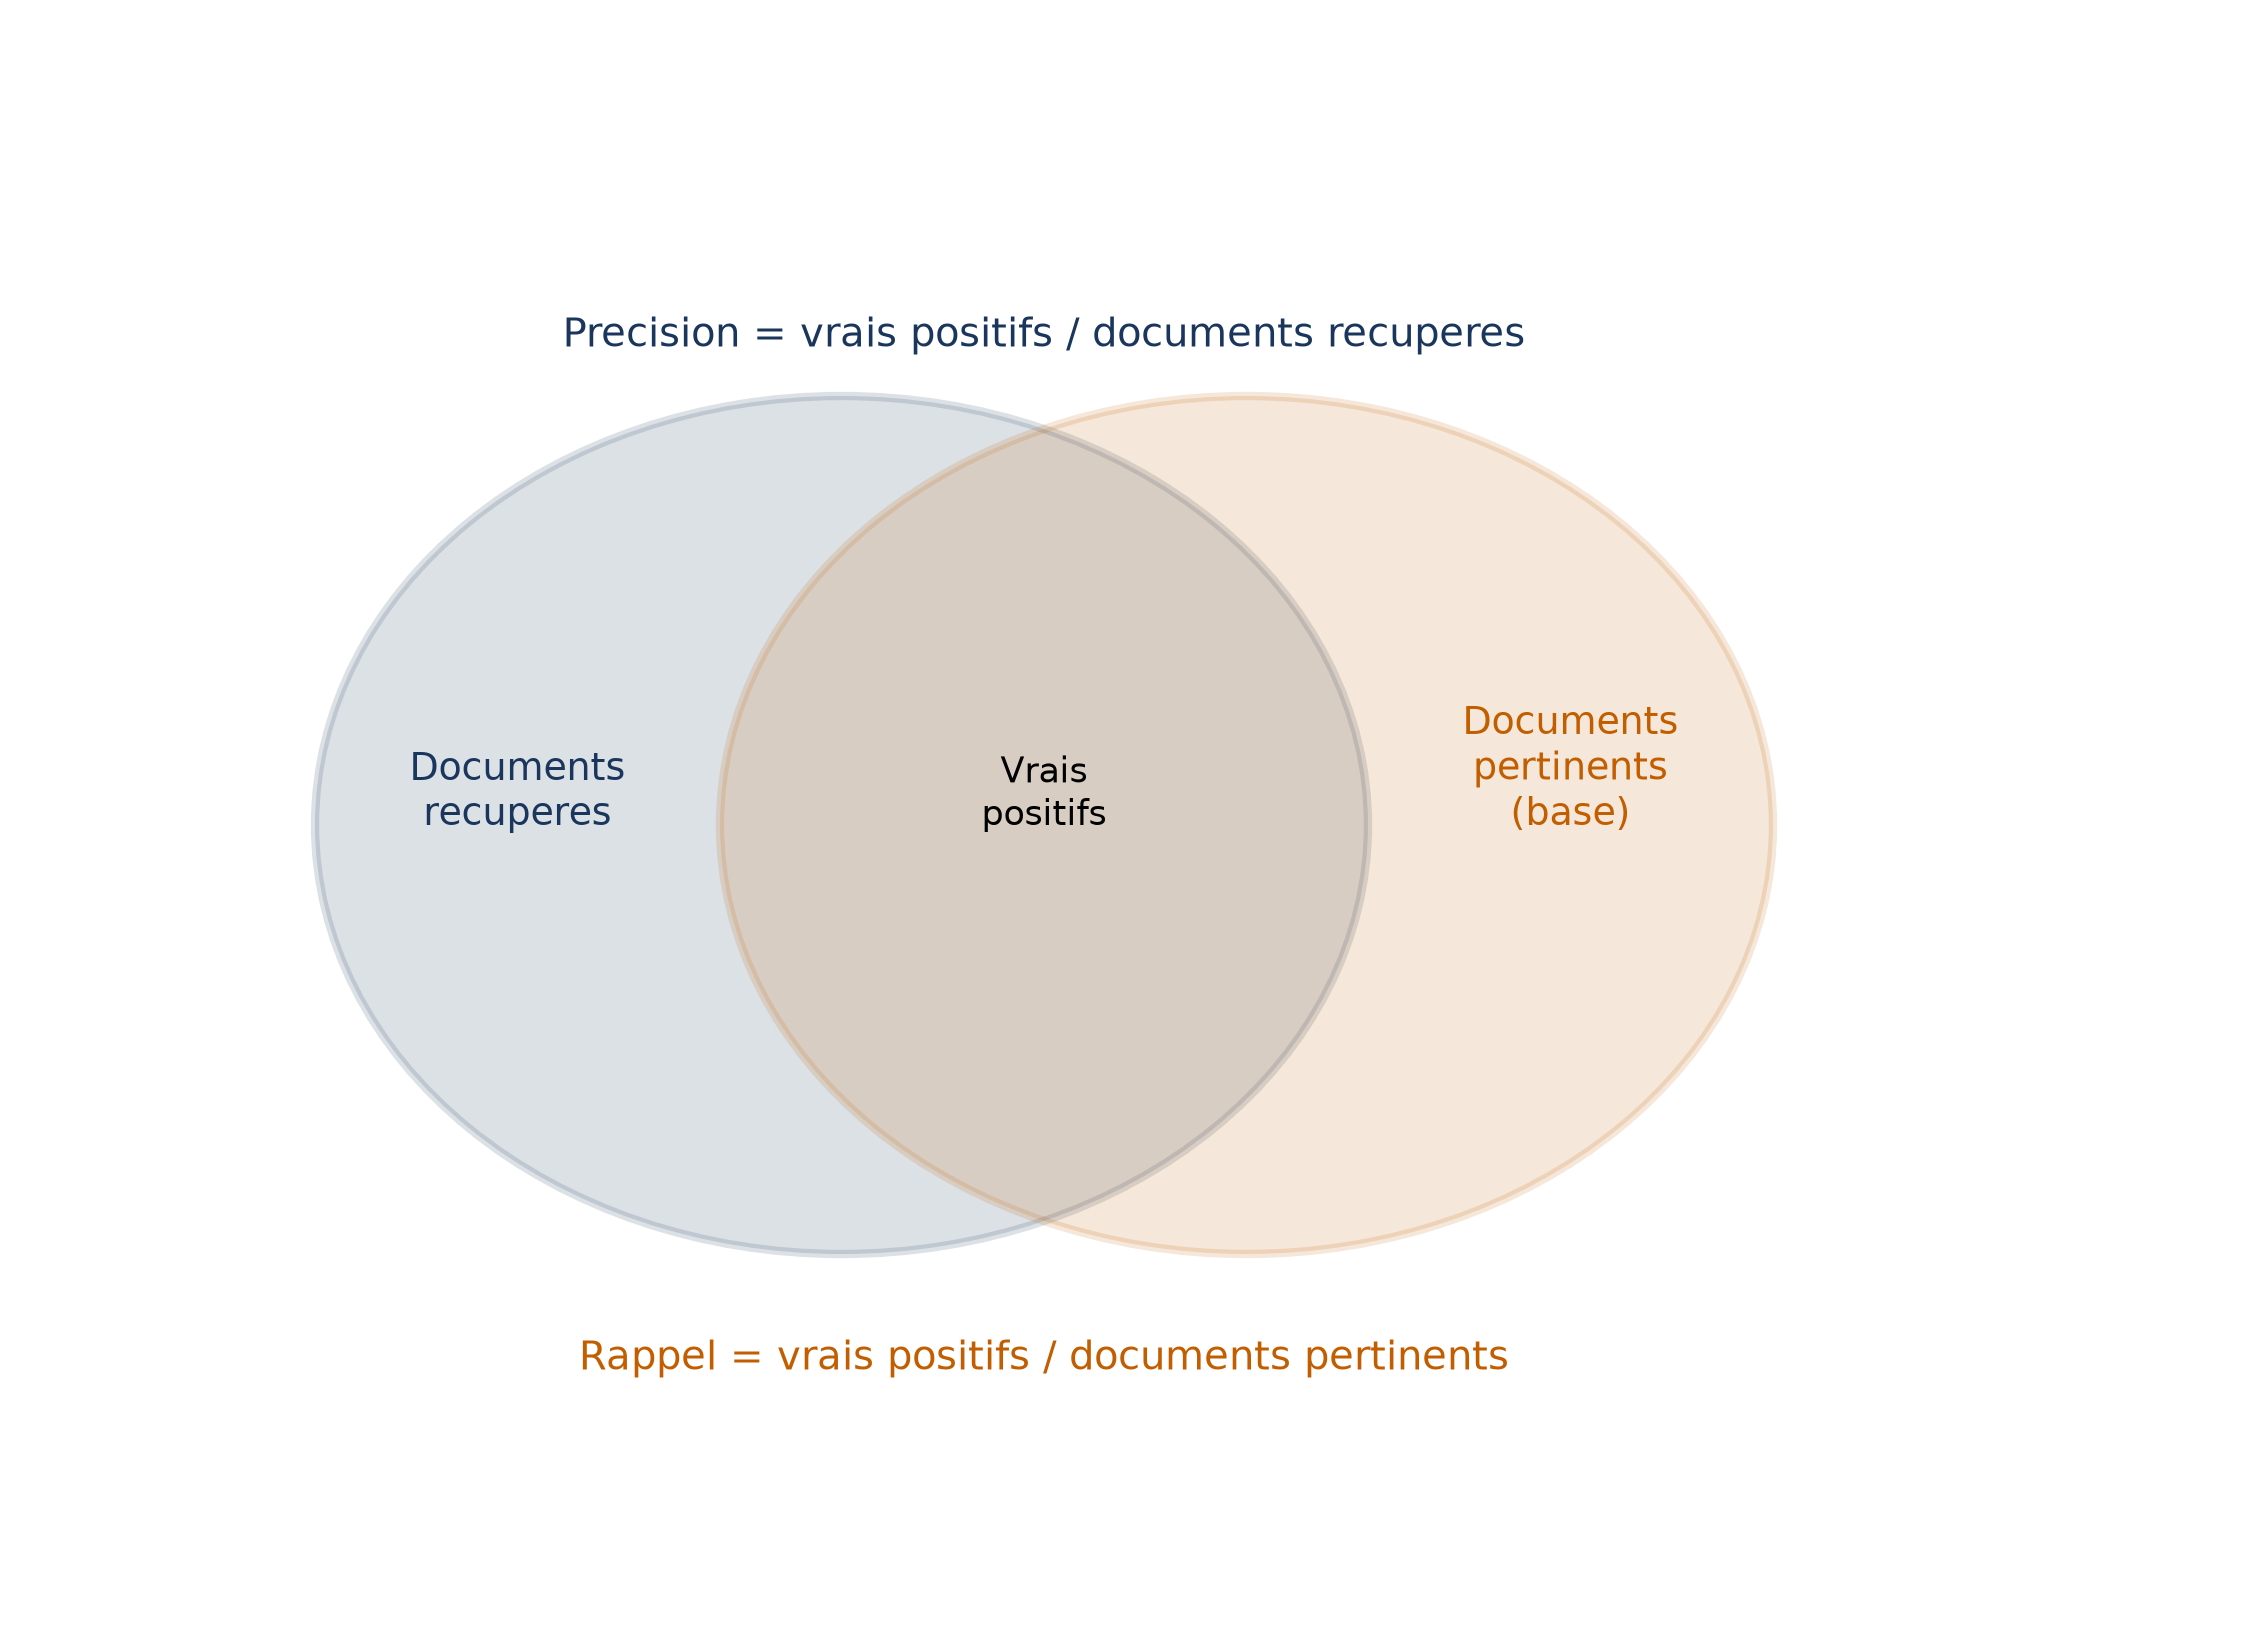
Le score F1 réconcilie les deux. C’est leur moyenne harmonique : il pénalise fortement la valeur faible, donc un F1 élevé exige précision et rappel élevés ensemble.
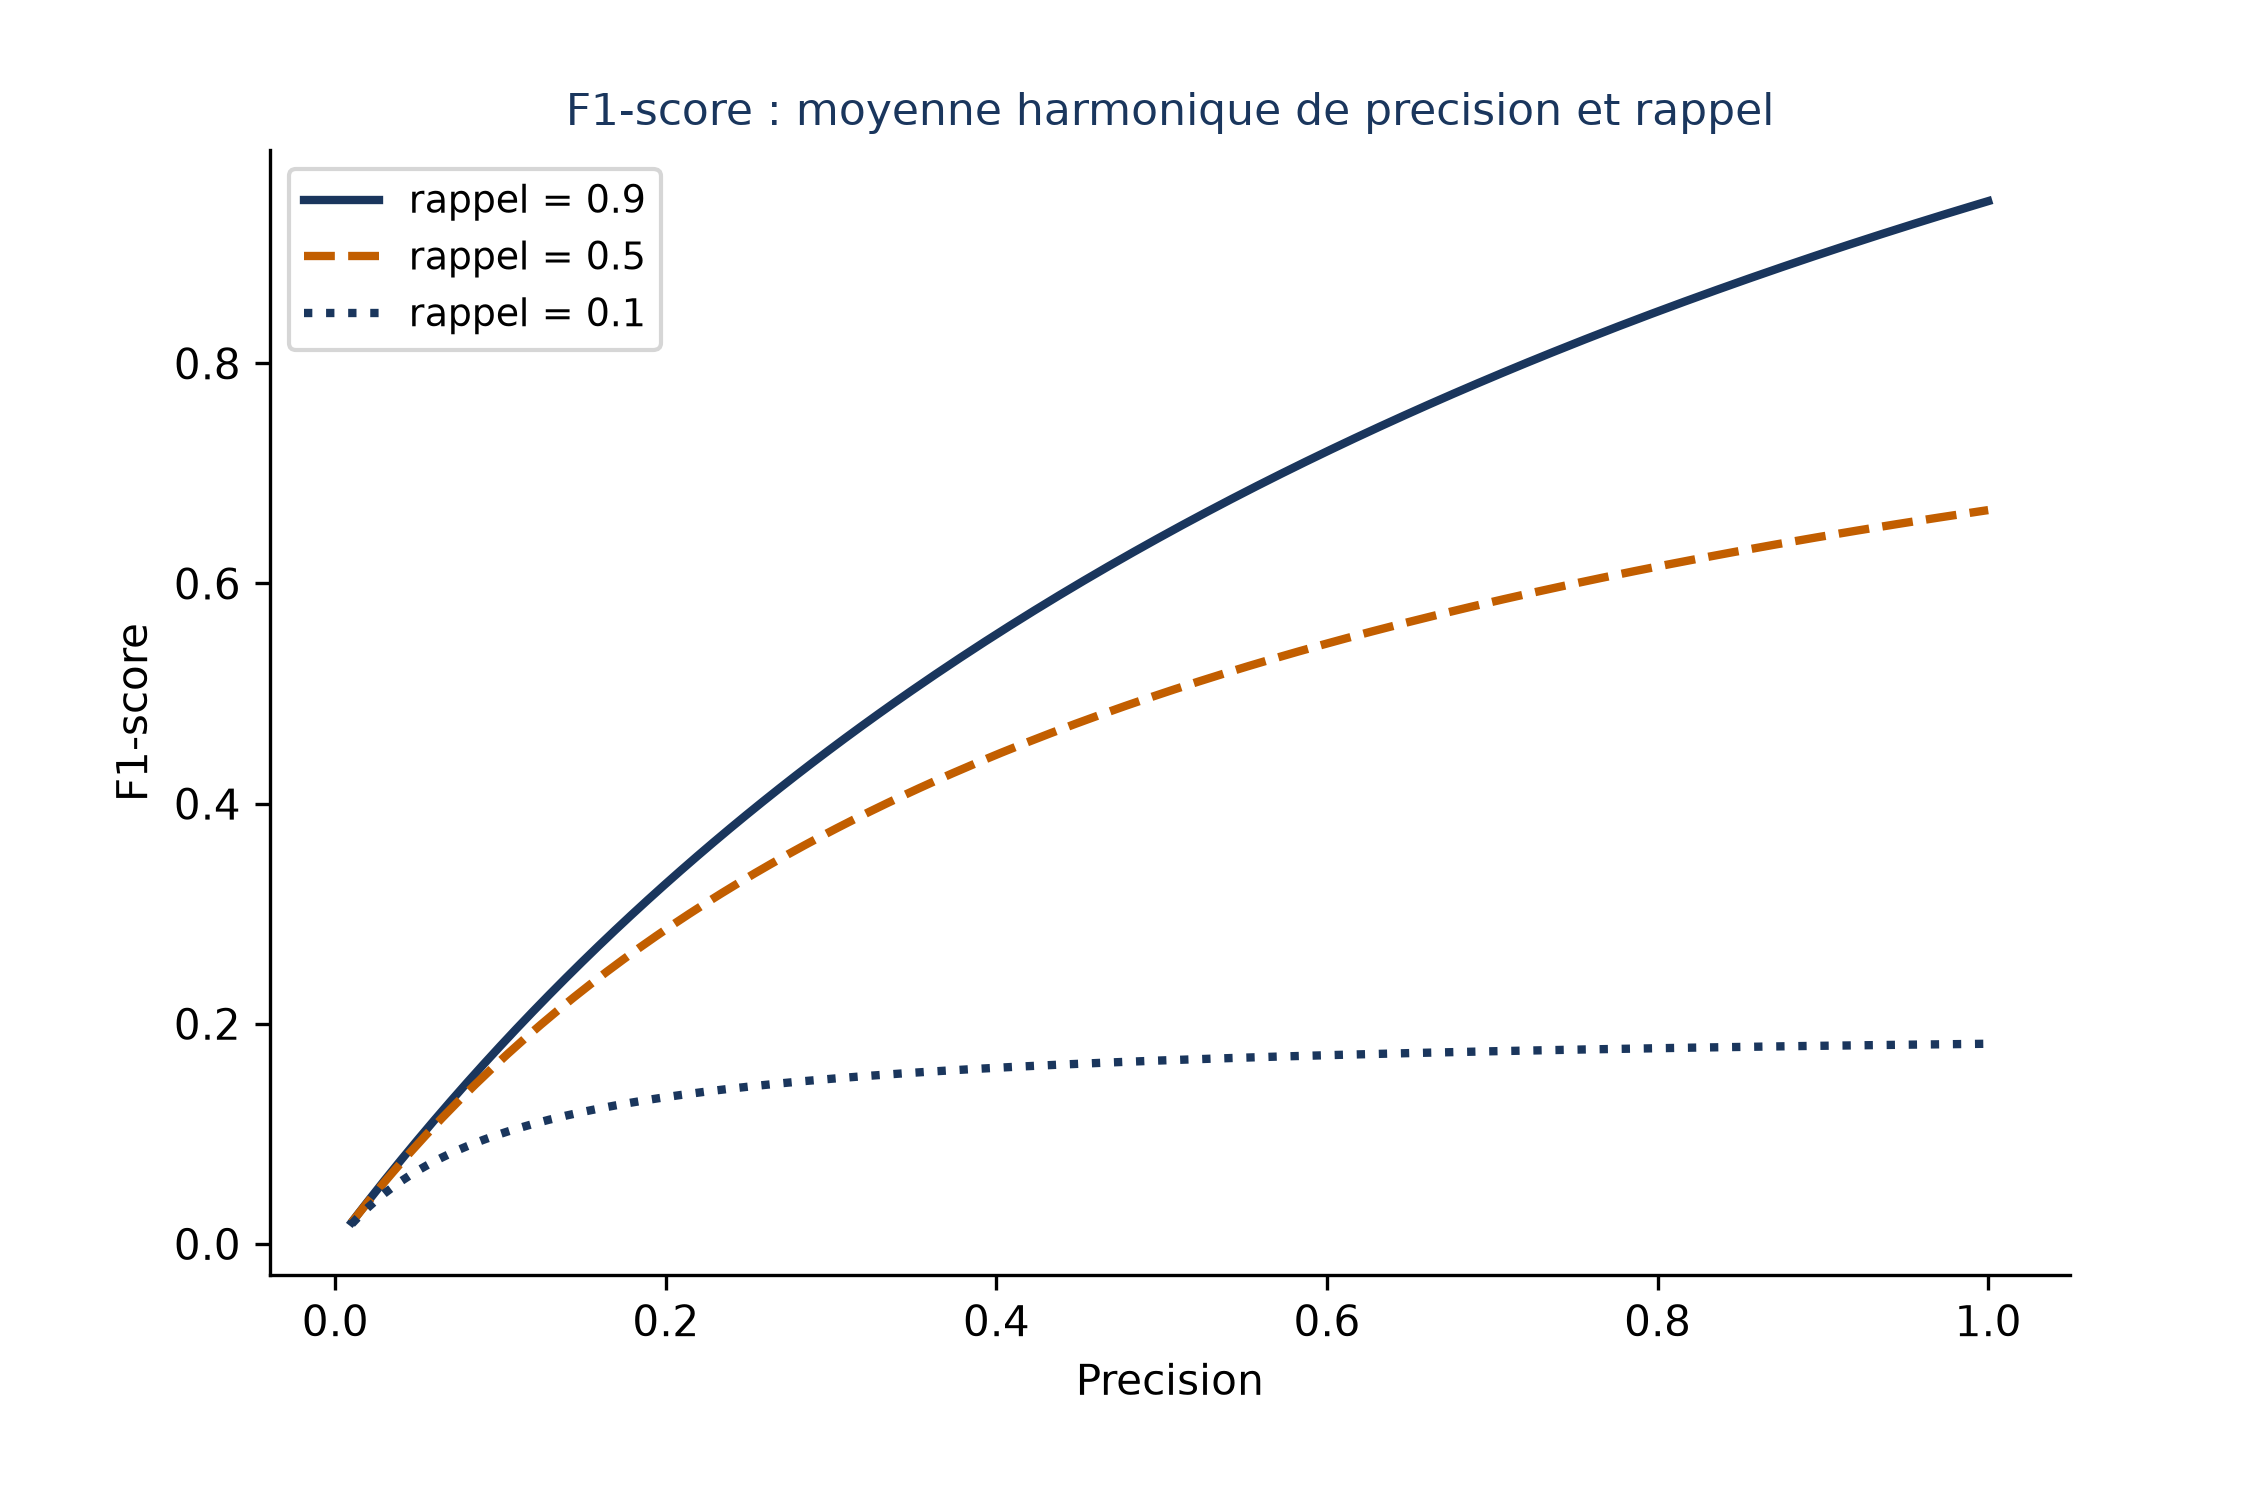
Ces métriques ignorent l’ordre des résultats. Trois autres en tiennent compte :
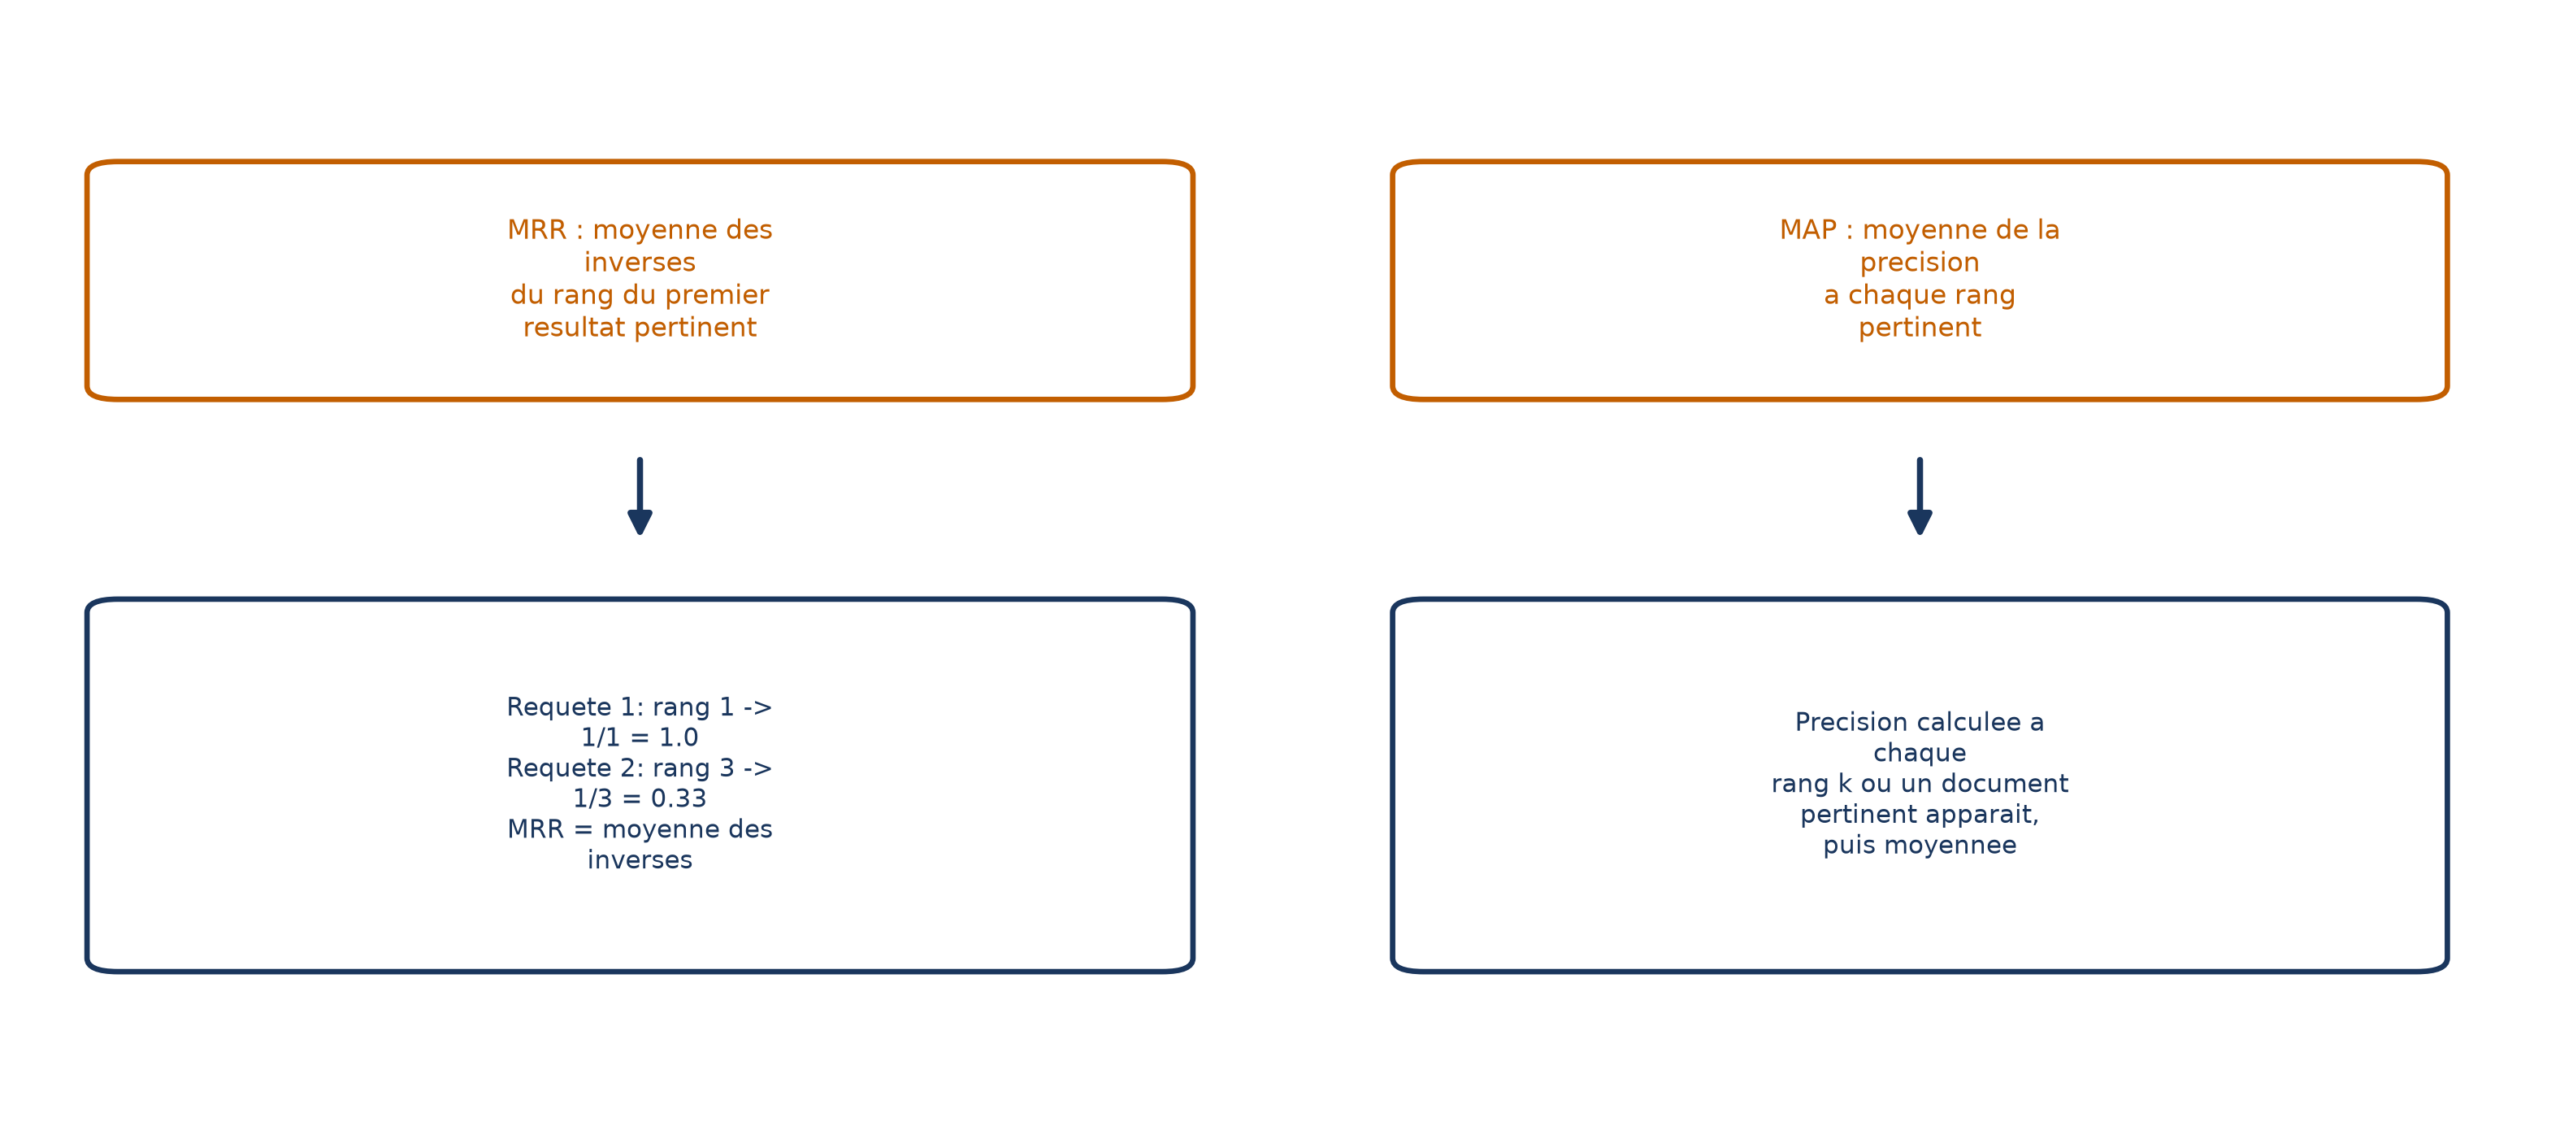
- le MRR (rang de réciprocité moyen) prend l’inverse du rang du premier document pertinent, puis moyenne sur les requêtes. Il dit à quelle vitesse on trouve un bon résultat, mais ignore tout ce qui suit ;
- le MAP (précision moyenne) moyenne la précision calculée à chaque rang où apparaît un document pertinent. Il donne une mesure unique sensible au classement, au prix d’un calcul plus lourd ;
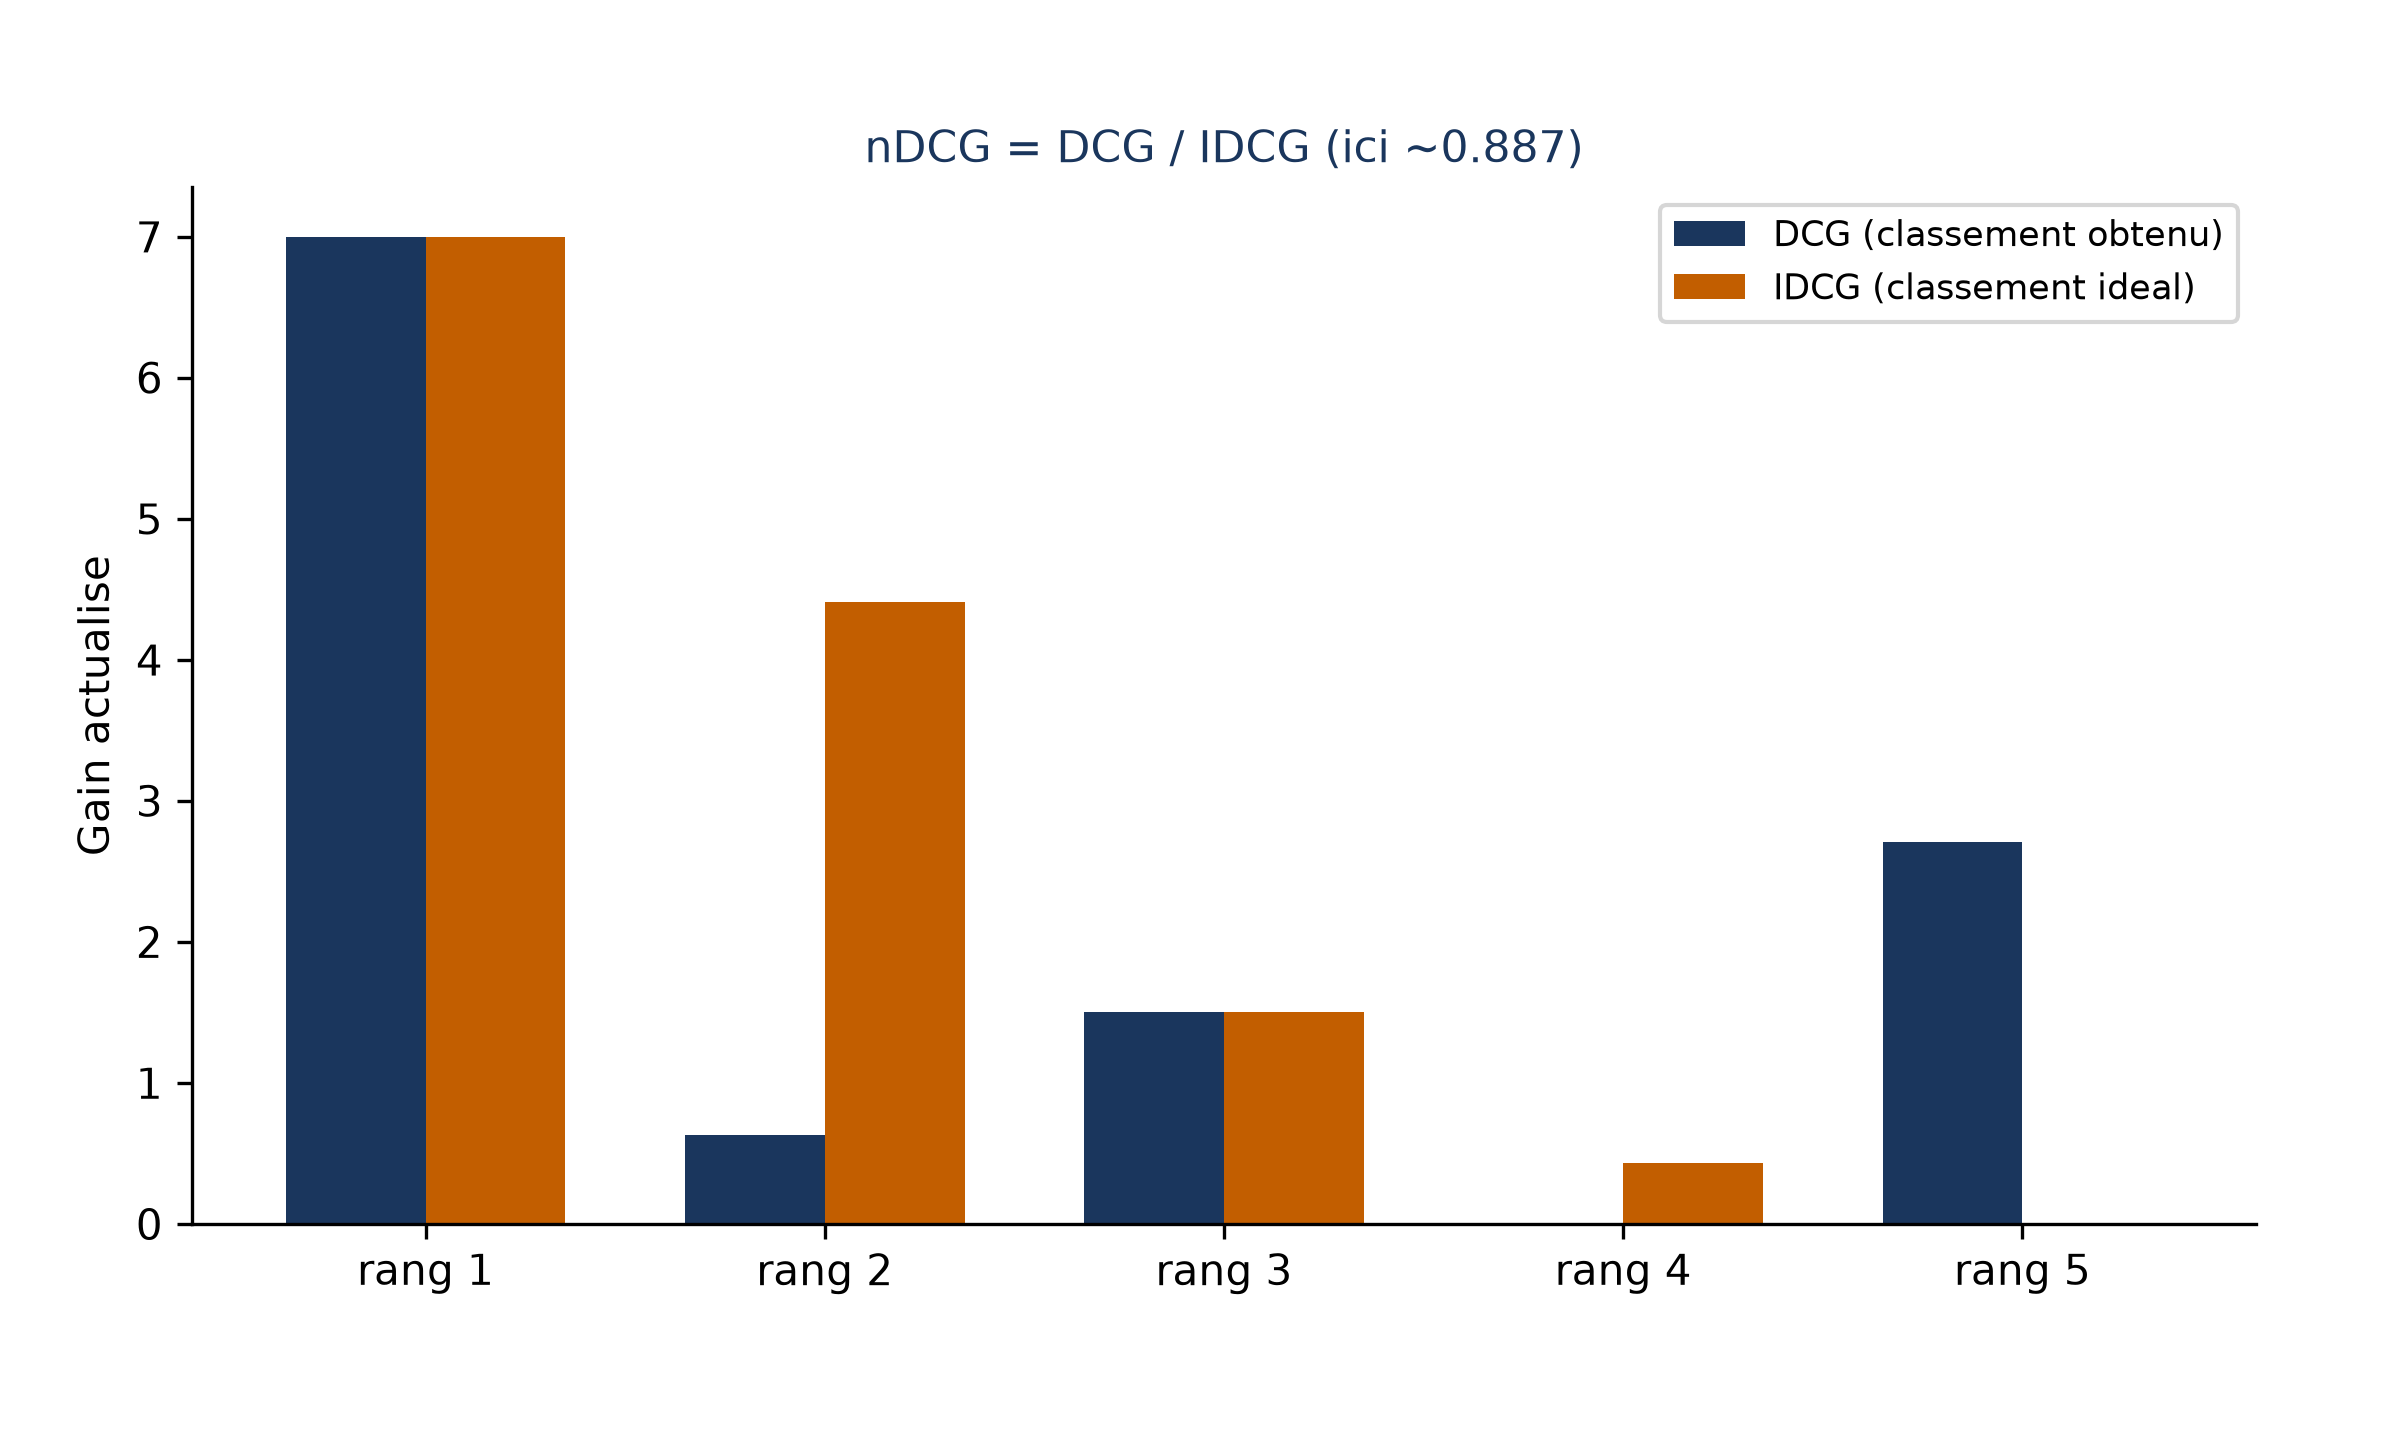
- le nDCG donne un score plus élevé aux documents pertinents placés en tête, et accepte des degrés de pertinence gradués. Il exige en contrepartie un score de pertinence pour chaque document, ce qui ajoute de la subjectivité.
📌 À retenir Ces chiffres se lisent en combinaison. Précision faible avec fort rappel : tu récupères trop de documents, sois plus sélectif. Précision faible et rappel faible : le problème est plus profond, du côté de l’indexation. MRR ou nDCG faible : suspecte l’algorithme de classement du retriever.
Côté réponse : trois scores et un juge
Passons à l’étage du dessus. Les trois relations de la triade deviennent trois scores, que le framework RAGAs calcule à l’aide d’un LLM :
- la pertinence du contexte : la proportion de phrases du contexte récupéré réellement utiles pour répondre à la question ;
- la fidélité : on décompose la réponse en affirmations élémentaires, puis on mesure la proportion de celles qu’on retrouve dans le contexte. L’inverse de la fidélité est le taux d’hallucination ;
- la pertinence de la réponse : on demande au LLM de fabriquer plusieurs questions à partir de la réponse, puis on calcule la similarité cosinus moyenne avec la question d’origine. Si la réponse traite bien la question, les questions reconstruites lui ressemblent.
Une variante voisine mesure la couverture : la part des affirmations pertinentes du contexte effectivement reprises dans la réponse.
Une autre présentation de la même démarche découpe l’évaluation avec des noms un peu différents : rappel de contexte (l’information nécessaire a-t-elle été retrouvée ?), fidélité et exactitude de la réponse (est-elle conforme à la vérité de référence ?). C’est la formulation qu’on retrouve dans le code plus bas.
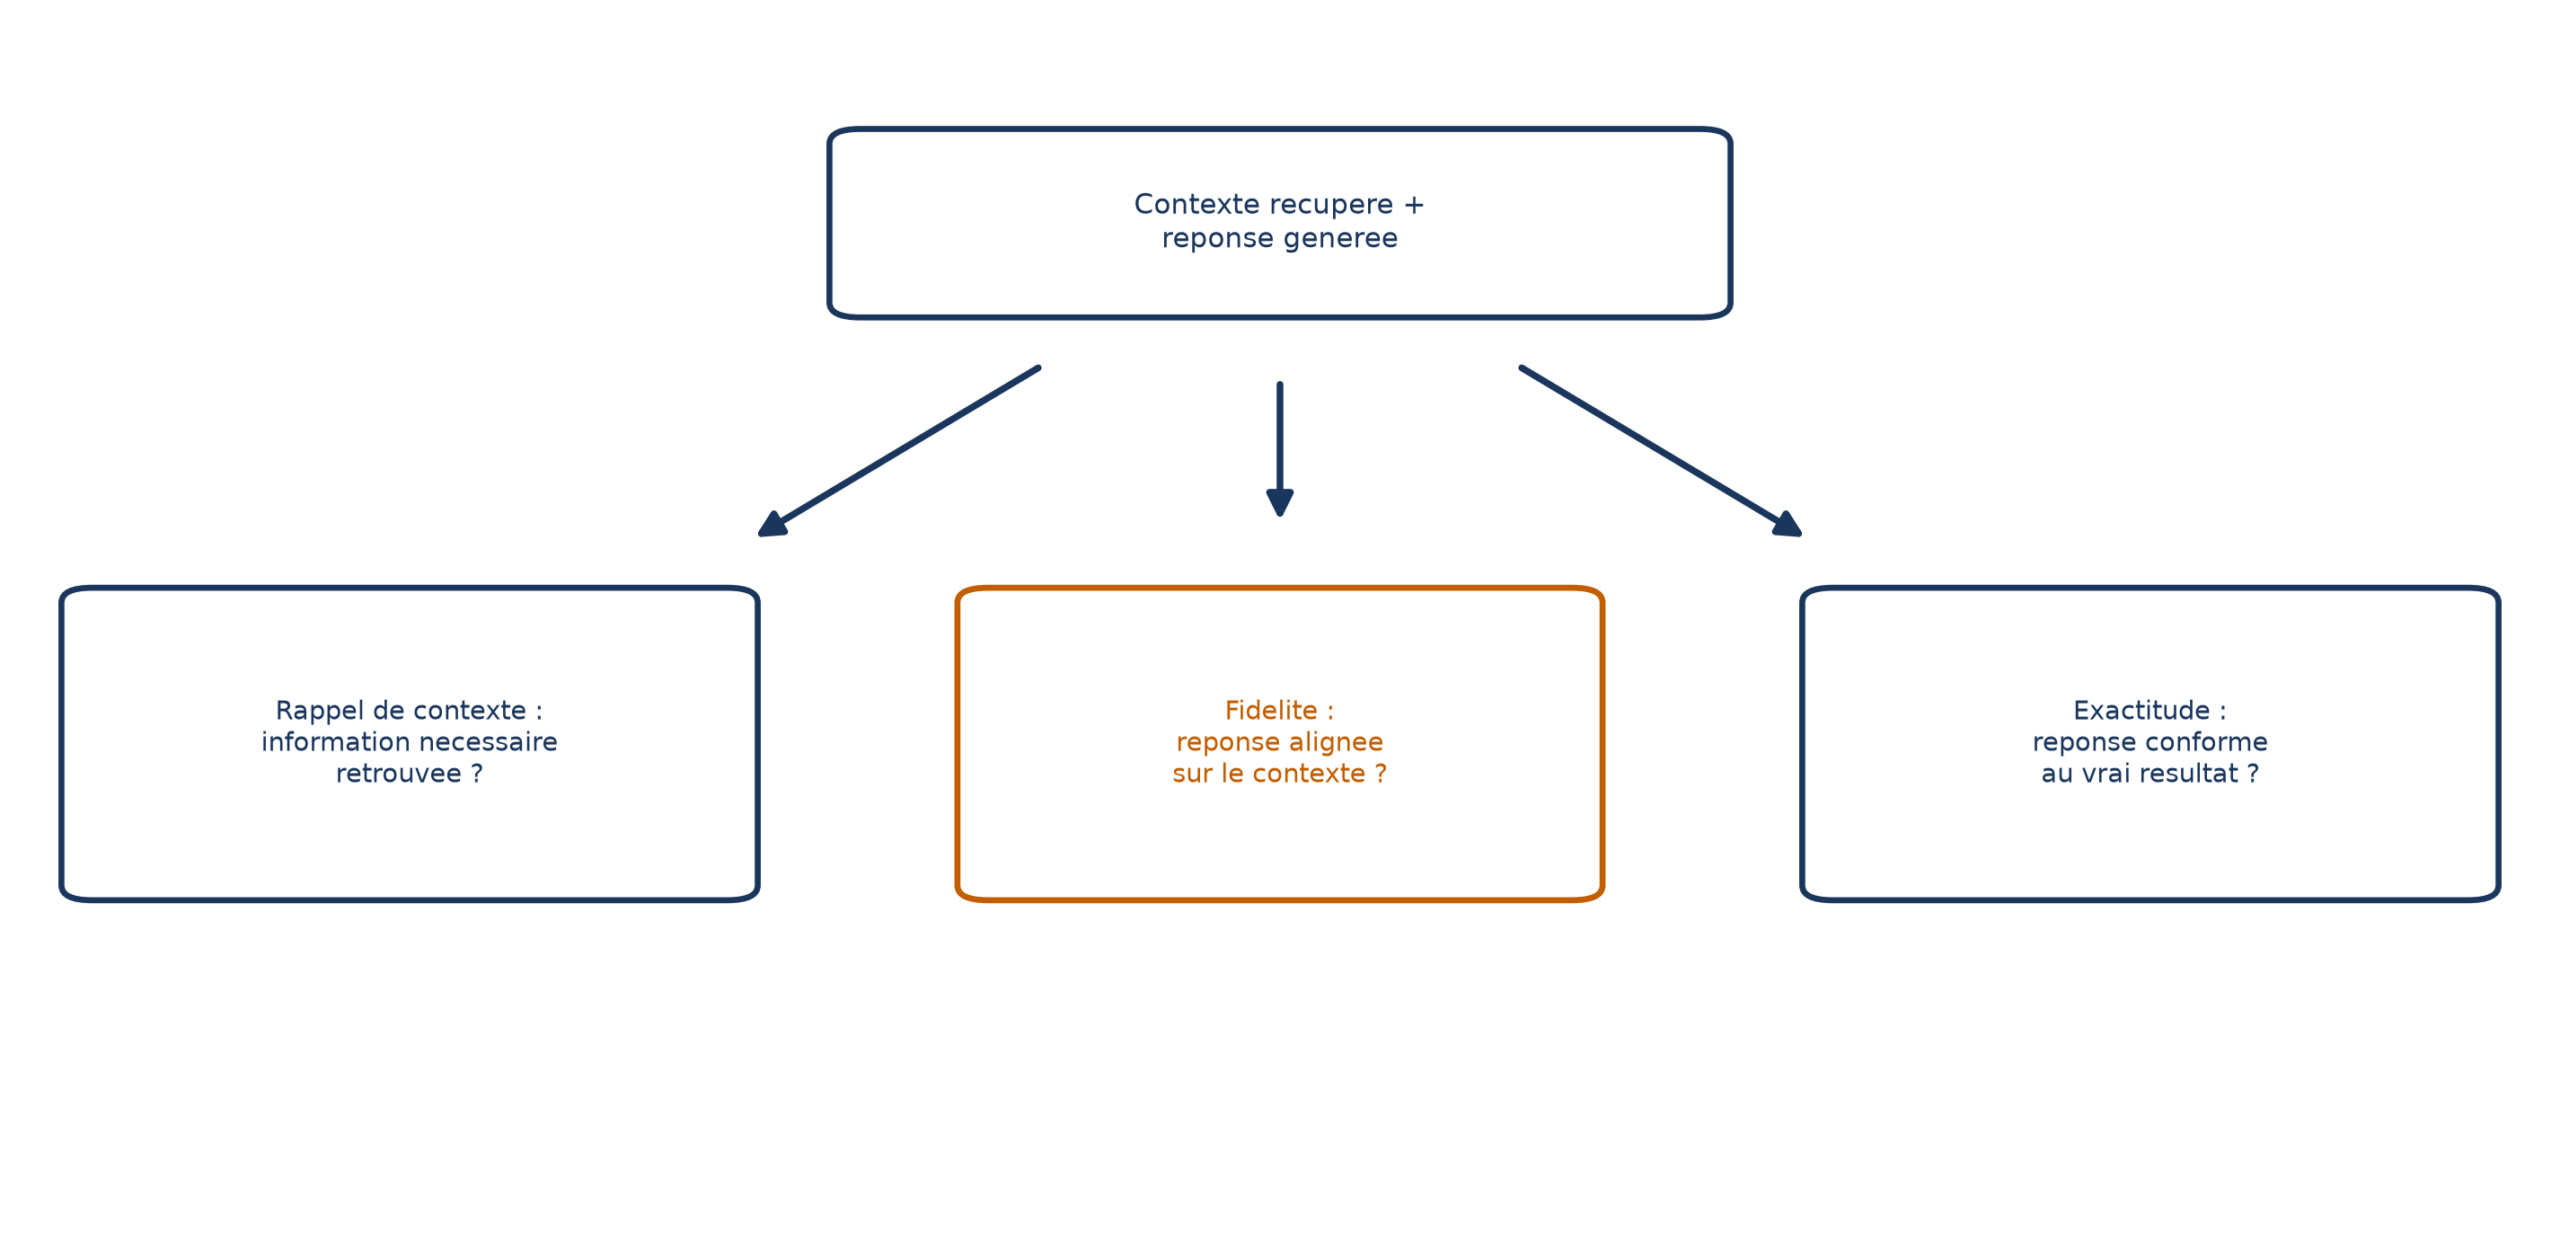
Comment un LLM juge-t-il la fidélité ? En deux temps : il décompose d’abord la réponse en affirmations atomiques, sans pronoms pour faciliter la vérification. Il juge ensuite, pour chacune, si elle peut être directement inférée du contexte, avec un verdict binaire.
L’exactitude, elle, reprend cette décomposition puis classe chaque affirmation : vrai positif (dans la réponse et soutenue par la référence), faux positif (dans la réponse mais absente de la référence) ou faux négatif (dans la référence mais absente de la réponse), avec une justification à chaque fois.
Ces trois scores ne se valent pas et ne montent pas ensemble. Une forte pertinence du contexte améliore généralement la fidélité, mais une forte fidélité ne garantit pas une bonne pertinence de la réponse : un système peut recopier fidèlement le contexte sans répondre directement à la question.
Les aptitudes qu’un score ne voit pas
Au-delà de ces scores, un RAG doit posséder quatre aptitudes :
- la robustesse au bruit : distinguer les documents qui parlent du sujet sans rien apporter des documents réellement utiles ;
- le rejet négatif : ne pas répondre quand la base ne contient rien de pertinent, car un LLM tend par nature à toujours générer du texte ;
- l’intégration d’information : composer une réponse complète à partir de plusieurs documents ;
- la robustesse contrefactuelle : rejeter des inexactitudes connues présentes dans la base elle-même.
La première relève surtout de la récupération, les trois autres de la génération.
Le jeu de test : la moitié du travail
Aucune de ces métriques ne dit quoi que ce soit sans des exemples. Les données de vérité terrain (des exemples question, contexte, réponse préparés à l’avance) jouent ici le rôle du jeu étiqueté d’un apprentissage supervisé. Les fabriquer à la main est fastidieux, et un LLM peut aider : à partir des documents de la base, il produit des questions variées (simples, multi-contextes, conditionnelles, de raisonnement).
C’est exactement ce que fait RAGAs : un générateur de questions initiales, puis un module d’évolution qui les complexifie, puis la génération des réponses.
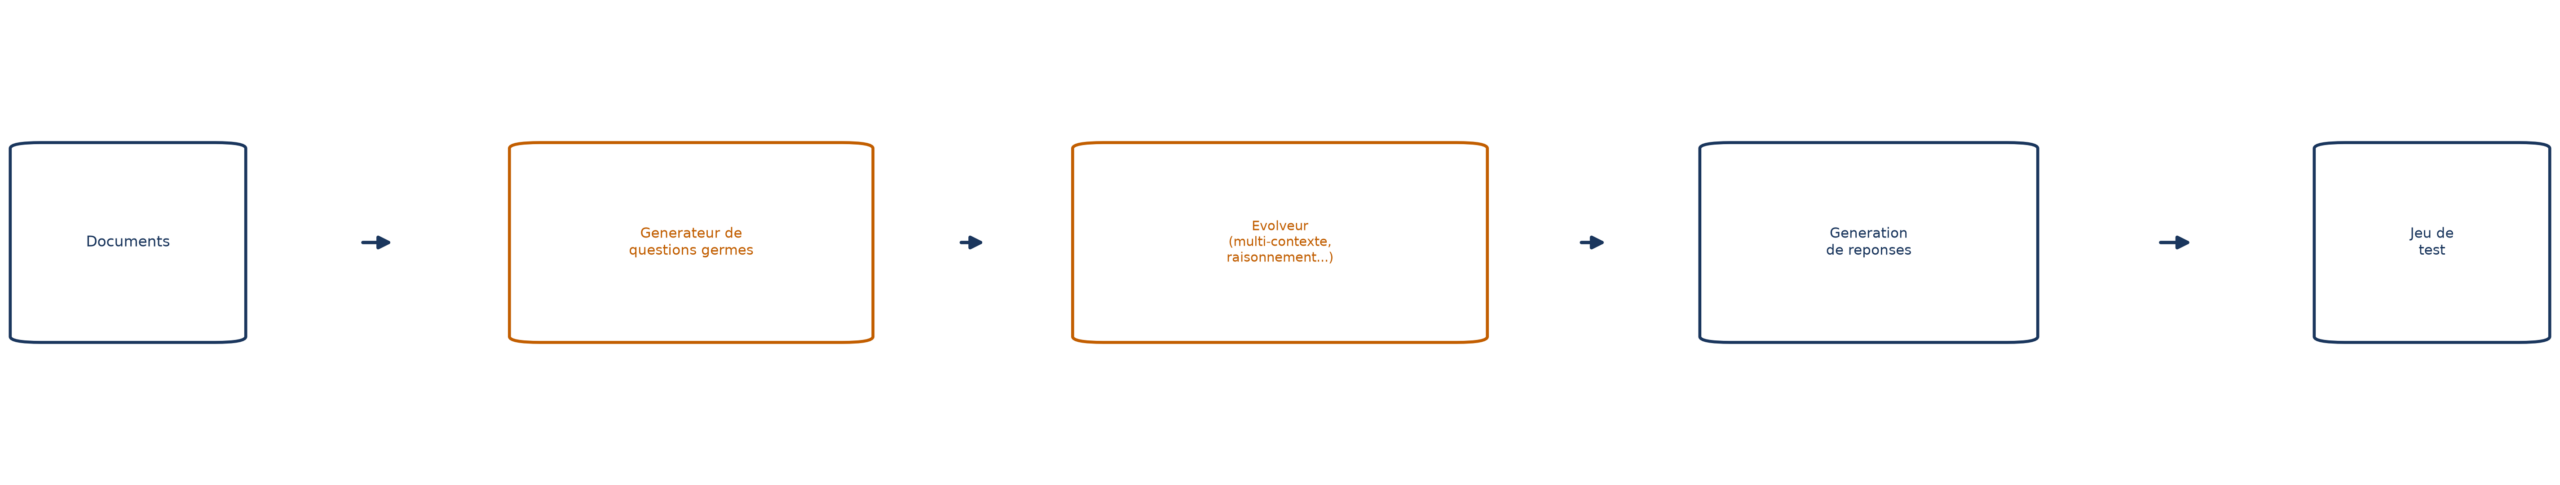
Dans notre fil rouge, le jeu de test est construit à la main et il est varié à dessein. Chaque exemple associe une question à une réponse de référence. Il doit mettre à l’épreuve chaque maillon : le choix du bon outil, le mappage des entités de la question vers la base, les scénarios en plusieurs étapes, les cas limites, et même la conversation (une salutation, une question hors sujet).
Une astuce élégante : plutôt qu’une chaîne figée comme réponse attendue, la référence est une requête Cypher exécutée sur la base de données. Comme la vérité est recalculée à chaque test, le benchmark reste valide même quand les données évoluent, sans mise à jour constante. Pour une salutation ou une question météo hors sujet, une simple instruction RETURN suffit à définir une réponse statique.
Tu y glisses aussi des cas limites : des questions dans le domaine dont la réponse manque pourtant dans les données (par exemple le film qui a remporté le plus d’Oscars, absent du jeu de données de films). Le benchmark construit ici compte 17 exemples et sa composition dépend entièrement des fonctionnalités de l’agent testé.
Le voir tourner
Deux façons de faire tourner l’évaluation. La première génère le jeu de test avec RAGAs. Elle installe la bibliothèque, configure un LLM et un modèle d’embeddings, puis demande 20 questions à partir des documents.
%pip install ragas==0.2.13

from ragas.llms import LangchainLLMWrapper
from ragas.embeddings import LangchainEmbeddingsWrapper
from ragas.testset import TestsetGenerator
from langchain_openai import ChatOpenAI, OpenAIEmbeddings

generator_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o-mini"))
generator_embeddings = LangchainEmbeddingsWrapper(
    OpenAIEmbeddings(model="text-embedding-3-small")
)
generator = TestsetGenerator(
    llm=generator_llm,
    embedding_model=generator_embeddings
)
testset = generator.generate_with_langchain_docs(
    html_data_transformed,
    test_size=20,
)
Ici html_data_transformed est la liste de documents déjà chargés et nettoyés par l’étape d’indexation. Le résultat : 20 questions, chacune liée au fragment dont elle est issue et à sa réponse de référence. Il reste à passer le pipeline sur chaque question, en gardant le contexte récupéré et la réponse générée.
La seconde façon part du jeu de test construit à la main. Pour chaque ligne, on exécute la requête Cypher de référence pour obtenir la vérité terrain, on demande sa réponse à l’agent, et on note au passage la latence et le contexte récupéré. La fonction get_answer est celle de l’agent, neo4j_driver le connecteur vers la base, test_data le tableau des questions :
answers = []
ground_truths = []
latencies = []
contexts = []
for i, row in tqdm(test_data.iterrows(), total=len(test_data),
desc="Processing rows"):
    ground_truth, _, _ = neo4j_driver.execute_query(row["cypher"])
    ground_truths.append([str(el.data()) for el in ground_truth])
    start = datetime.now()
    try:
        answer, context = get_answer(row["question"])
        context = [el['content'] for el in context]
    except Exception:
        answer, context = None, []
    latencies.append((datetime.now() - start).total_seconds())
    answers.append(answer)
    contexts.append(context)

test_data['ground_truth'] = [str(el) for el in ground_truths]
test_data['answer'] = answers
test_data['latency'] = latencies
test_data['retrieved_contexts'] = contexts
Retiens deux détails : une exception ne plante pas le test, elle est enregistrée comme une absence de réponse, et la latence est mesurée pour chaque question, ce qui donnera un second axe d’analyse.
Reste à lancer l’évaluation proprement dite. Le cadre exige des valeurs non nulles : les réponses manquantes sont donc remplacées par « I don’t know ». Trois métriques sont calculées : l’exactitude de la réponse, le rappel de contexte et la fidélité.
dataset = Dataset.from_pandas(test_data.fillna("I don't know"))

result = evaluate(
    dataset,
    metrics=[
        answer_correctness,
        context_recall,
        faithfulness,
    ],
)
Avec un jeu de test généré comme dans le premier extrait, on assemble d’abord les résultats (question, réponse générée, contexte récupéré, réponse de référence) dans une liste dataset_to_eval. Puis on invoque cinq métriques, avec un LLM évaluateur exposé par LangChain. Tu remarques que cet extrait utilise des classes (Faithfulness()) là où le précédent importe des fonctions (faithfulness) : c’est la même idée, écrite différemment.
from ragas import EvaluationDataset, evaluate
from ragas.metrics import (
    LLMContextRecall,
    Faithfulness,
    FactualCorrectness,
    AnswerCorrectness,
    ResponseRelevancy)

evaluation_dataset = EvaluationDataset.from_list(dataset_to_eval)
evaluator_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o-mini"))

result = evaluate(
    dataset=evaluation_dataset,
    metrics=[LLMContextRecall(), Faithfulness(), AnswerCorrectness(),
             ResponseRelevancy(), FactualCorrectness()],
    llm=evaluator_llm)
Pas besoin d’un framework pour mesurer la récupération seule. Voici une fonction d’évaluation écrite pour tester la mémoire d’un agent, mais qui s’applique telle quelle à n’importe quel retriever : pour chaque requête, y a-t-il au moins un élément attendu parmi les k premiers résultats ?
def evaluate_memory_retrieval(
    retrieve_fn: Any,
    queries: List[str],
    expected_results: List[List[Any]],
    top_k: int = 1) -> Dict[str, float]:
    """
    Given a retrieval function `retrieve_fn(query, k)` that returns a list of
    k memory items, evaluate over multiple queries.
    Returns:
      - `retrieval_accuracy@k`: fraction of queries for which at least one
        expected item appears in the top-k.
    """
    hits = 0
    for query, expect in zip(queries, expected_results):
        results = retrieve_fn(query, top_k)
        # did we retrieve any expected item?
        if set(results) & set(expect):
            hits += 1
    accuracy = hits / len(queries) if queries else 1.0
    return {f"retrieval_accuracy@{top_k}": accuracy}
Le résultat est une fraction : sur combien de requêtes la bonne information est-elle remontée dans les k premiers ? C’est une mesure de récupération pure, sans LLM juge.
Lire les résultats
Sur le jeu de 17 questions, le résumé global affiche une exactitude de réponse de 0,7774, un rappel de contexte de 0,7941 et une fidélité de 0,9657.
Comment lire ces trois chiffres ensemble ? Avec une exactitude proche de 0,78, l’agent répond correctement la plupart du temps mais se trompe encore dans près d’un quart des cas. Le rappel de 0,79 montre que la récupération fonctionne plutôt bien sans toujours ramener toute l’information nécessaire, ce qui pèse sur l’exactitude. La fidélité, elle, est excellente : le modèle invente rarement et reste fidèle au contexte.
📌 À retenir Une fidélité haute avec une exactitude et un rappel plus bas dit où investir : pas dans la rédaction, mais dans la récupération. Enrichir la couverture de récupération, affiner la reformulation des requêtes, améliorer le mappage d’entités pour les questions ambiguës.
Les réponses individuelles apprennent autant que la moyenne. La latence est nettement plus faible pour les questions qui n’ont pas besoin de la génération de requête Cypher, puisqu’on évite un appel LLM supplémentaire. Certains scores paraissent incohérents (sur la simple salutation « Hello »), le juge étant lui-même un LLM. Enfin, une question ne trouve aucune réponse : « Who has the longest name among all actors ? », faute d’avoir généré la bonne requête. Le remède proposé : ajouter un exemple few-shot pour guider cette génération ou créer un outil dédié.
Pièges et limites
Le juge n’est pas neutre. L’approche « LLM as a judge » dépend directement de la qualité du LLM utilisé. En cas d’auto-référence, quand le LLM juge et le LLM générateur sont les mêmes, l’évaluation peut être biaisée. Les remèdes : échantillonner régulièrement les jugements et recourir à plusieurs juges différents du générateur.
Pas de standard, pas de score universel. Chaque framework calcule ses métriques selon sa méthodologie propre : il est recommandé de comparer les résultats de plusieurs frameworks.
Le choix de l’outil d’évaluation est un arbitrage. ARES, développé par des chercheurs de Stanford et Databricks, entraîne un classifieur au lieu d’utiliser des prompts heuristiques et fournit des intervalles de confiance. Il exige davantage de données : des passages du domaine, un ensemble de validation d’environ 150 annotations humaines et au moins cinq exemples few-shot. Il est plus robuste mais plus complexe à mettre en œuvre que RAGAs, qui privilégie la rapidité. TruLens, DeepEval ou RAGChecker existent aussi.
Un benchmark public ne remplace pas le tien. Les benchmarks sont statiques et ignorent l’évolution des connaissances. Pour se comparer à d’autres systèmes, on trouve BEIR (9 tâches de recherche d’information, 19 jeux de questions-réponses), RGB (les quatre aptitudes vues plus haut), Multi-hop RAG (2556 requêtes dont les preuves sont réparties sur deux à quatre documents) ou CRAG (4409 paires question-réponse, huit types de questions, cinq domaines). Mieux vaut pourtant un benchmark adapté à ton domaine qu’une confiance aveugle dans un score générique.
Attention au surajustement de métriques. Régler un système pour exceller sur une référence se fait parfois au détriment de son utilité réelle : optimiser un score unique peut favoriser des sorties formulaïques qui manquent l’intention. Si les cas de test sont trop étroits, le système semble bon hors ligne et échoue en production.
Le jeu de test doit vivre. À chaque outil ou flux ajouté, on ajoute les cas de test correspondants. Le jeu devient une spécification vivante qui permet de détecter les régressions et de repérer les progrès apparents payés par de nouvelles erreurs ailleurs. On l’alimente en extrayant des exemples des journaux de production, en faisant générer des variantes par un LLM (relues par des humains) ou avec des techniques ciblées comme le prompt adverse ou l’édition contrefactuelle.
L’exactitude n’est pas tout. La latence (le délai entre la requête et la réponse), le débit, l’utilisation des ressources et le coût par requête font partie de l’évaluation. Latence et coût méritent une attention particulière en RAG, qui ajoute la récupération au coût déjà inhérent au LLM. Il faut aussi regarder le biais et la toxicité des réponses.
Et l’humain ? Les métriques génériques doivent être complétées par des critères propres à ton cas d’usage et par un retour humain (avis des utilisateurs, évaluation d’experts).
En production, l’évaluation continue permet d’identifier les types de requêtes que le système traite mal, et le retour qualitatif des utilisateurs la complète. On suit par exemple le taux de reformulation (les utilisateurs sont-ils compris du premier coup ?), le taux d’abandon de tâche et les notes explicites de type pouce en haut ou en bas.
Aller plus loin
- Hallucination : une hallucination est une information incorrecte, absurde ou fabriquée. On la limite en ancrant les sorties dans des données vérifiables, mais la qualité des sources reste déterminante, car des données périmées ou mal vérifiées la favorisent.
- RAG naïf et RAG avancé : les faiblesses repérées à l’évaluation (faible précision et rappel à la récupération, contexte décousu, hallucinations) sont exactement ce que corrigent les techniques avancées comme le re-classement ou la récupération hybride. On mesure d’abord, on améliore ensuite.
- Latence : chaque étape ajoutée au pipeline augmente le délai de réponse, et un système modulaire supplémentaire peut alourdir la latence et le coût d’inférence. L’évaluation doit donc peser gain de qualité et surcoût.
À retenir
- Évaluer un RAG, c’est d’abord localiser l’erreur : le retriever n’a pas trouvé, ou le LLM a mal lu.
- Pour la recherche, regarde précision@k et rappel, puis les métriques sensibles à l’ordre (MRR, MAP, nDCG) ; pour la réponse, pertinence du contexte, fidélité et pertinence de la réponse.
- Sans jeu de test de qualité, aucune métrique ne vaut rien : construis-le avec des cas variés, des cas limites, et fais-le grandir.
- Un score de fidélité élevé rassure sur l’invention, mais ne dit rien de la complétude de la récupération : croise toujours plusieurs scores.
- Méfie-toi du juge (un LLM), des benchmarks figés et des scores uniques ; ajoute humain, latence et coût.
Questions fréquentes
Peut-on évaluer un RAG sans annoter soi-même des centaines de questions ?
On peut générer un jeu de test synthétique à partir de la base de connaissances (questions simples, multi-contextes, conditionnelles, de raisonnement). Les échantillons générés sont ensuite relus et raffinés par des humains avant d’entrer dans le jeu de test.
Quel LLM utiliser comme juge ?
Il est recommandé d’utiliser un LLM juge différent du LLM de génération, pour éviter le biais d’auto-référence, et d’échantillonner régulièrement ses jugements.
Une bonne fidélité veut-elle dire que mon RAG est bon ?
Non : la fidélité mesure que la réponse colle au contexte, pas que le contexte soit le bon ni que la réponse traite la question. Dans notre exemple, une fidélité de 0,97 cohabite avec un rappel de contexte de 0,79.