Un test de dépistage revient positif. Sur 1 120 personnes testées, 855 sont positives, mais seules 120 sont réellement malades : la chance d’être malade, quand on est positif, n’est que d’environ 14 %. Ce genre de raisonnement, compter dans le bon sous-groupe, est la première brique de la régression logistique. À la fin de cette page, tu sauras raconter avec des mots simples les cinq idées de mathématiques qui la composent, sans formule intimidante.
Sommaire
- L’essentiel en 30 secondes
- Une probabilité, c’est un décompte
- Un score se fabrique en additionnant des poids
- L’exponentielle rend positif, la fraction ramène entre 0 et 1
- Le logarithme : un pont entre multiplications et additions
- Pourquoi on additionne des logarithmes au lieu de multiplier des probabilités
- Corriger les coefficients : la pente dit dans quel sens tourner
- La même brique dans un neurone et dans un classifieur de mots
L’essentiel en 30 secondes
- Une probabilité est un décompte dans un sous-groupe : les cas qui comptent, divisés par les cas possibles.
- Le modèle part d’un score qui est une somme pondérée des variables, exactement le calcul d’un neurone.
- L’exponentielle rend positif, et la fraction
 donne une probabilité entre 0 et 1.
- Le logarithme change les produits en sommes sans modifier le meilleur choix de coefficients.
- Les coefficients se règlent en sens opposé à la pente, pas à pas.
Une probabilité, c’est un décompte
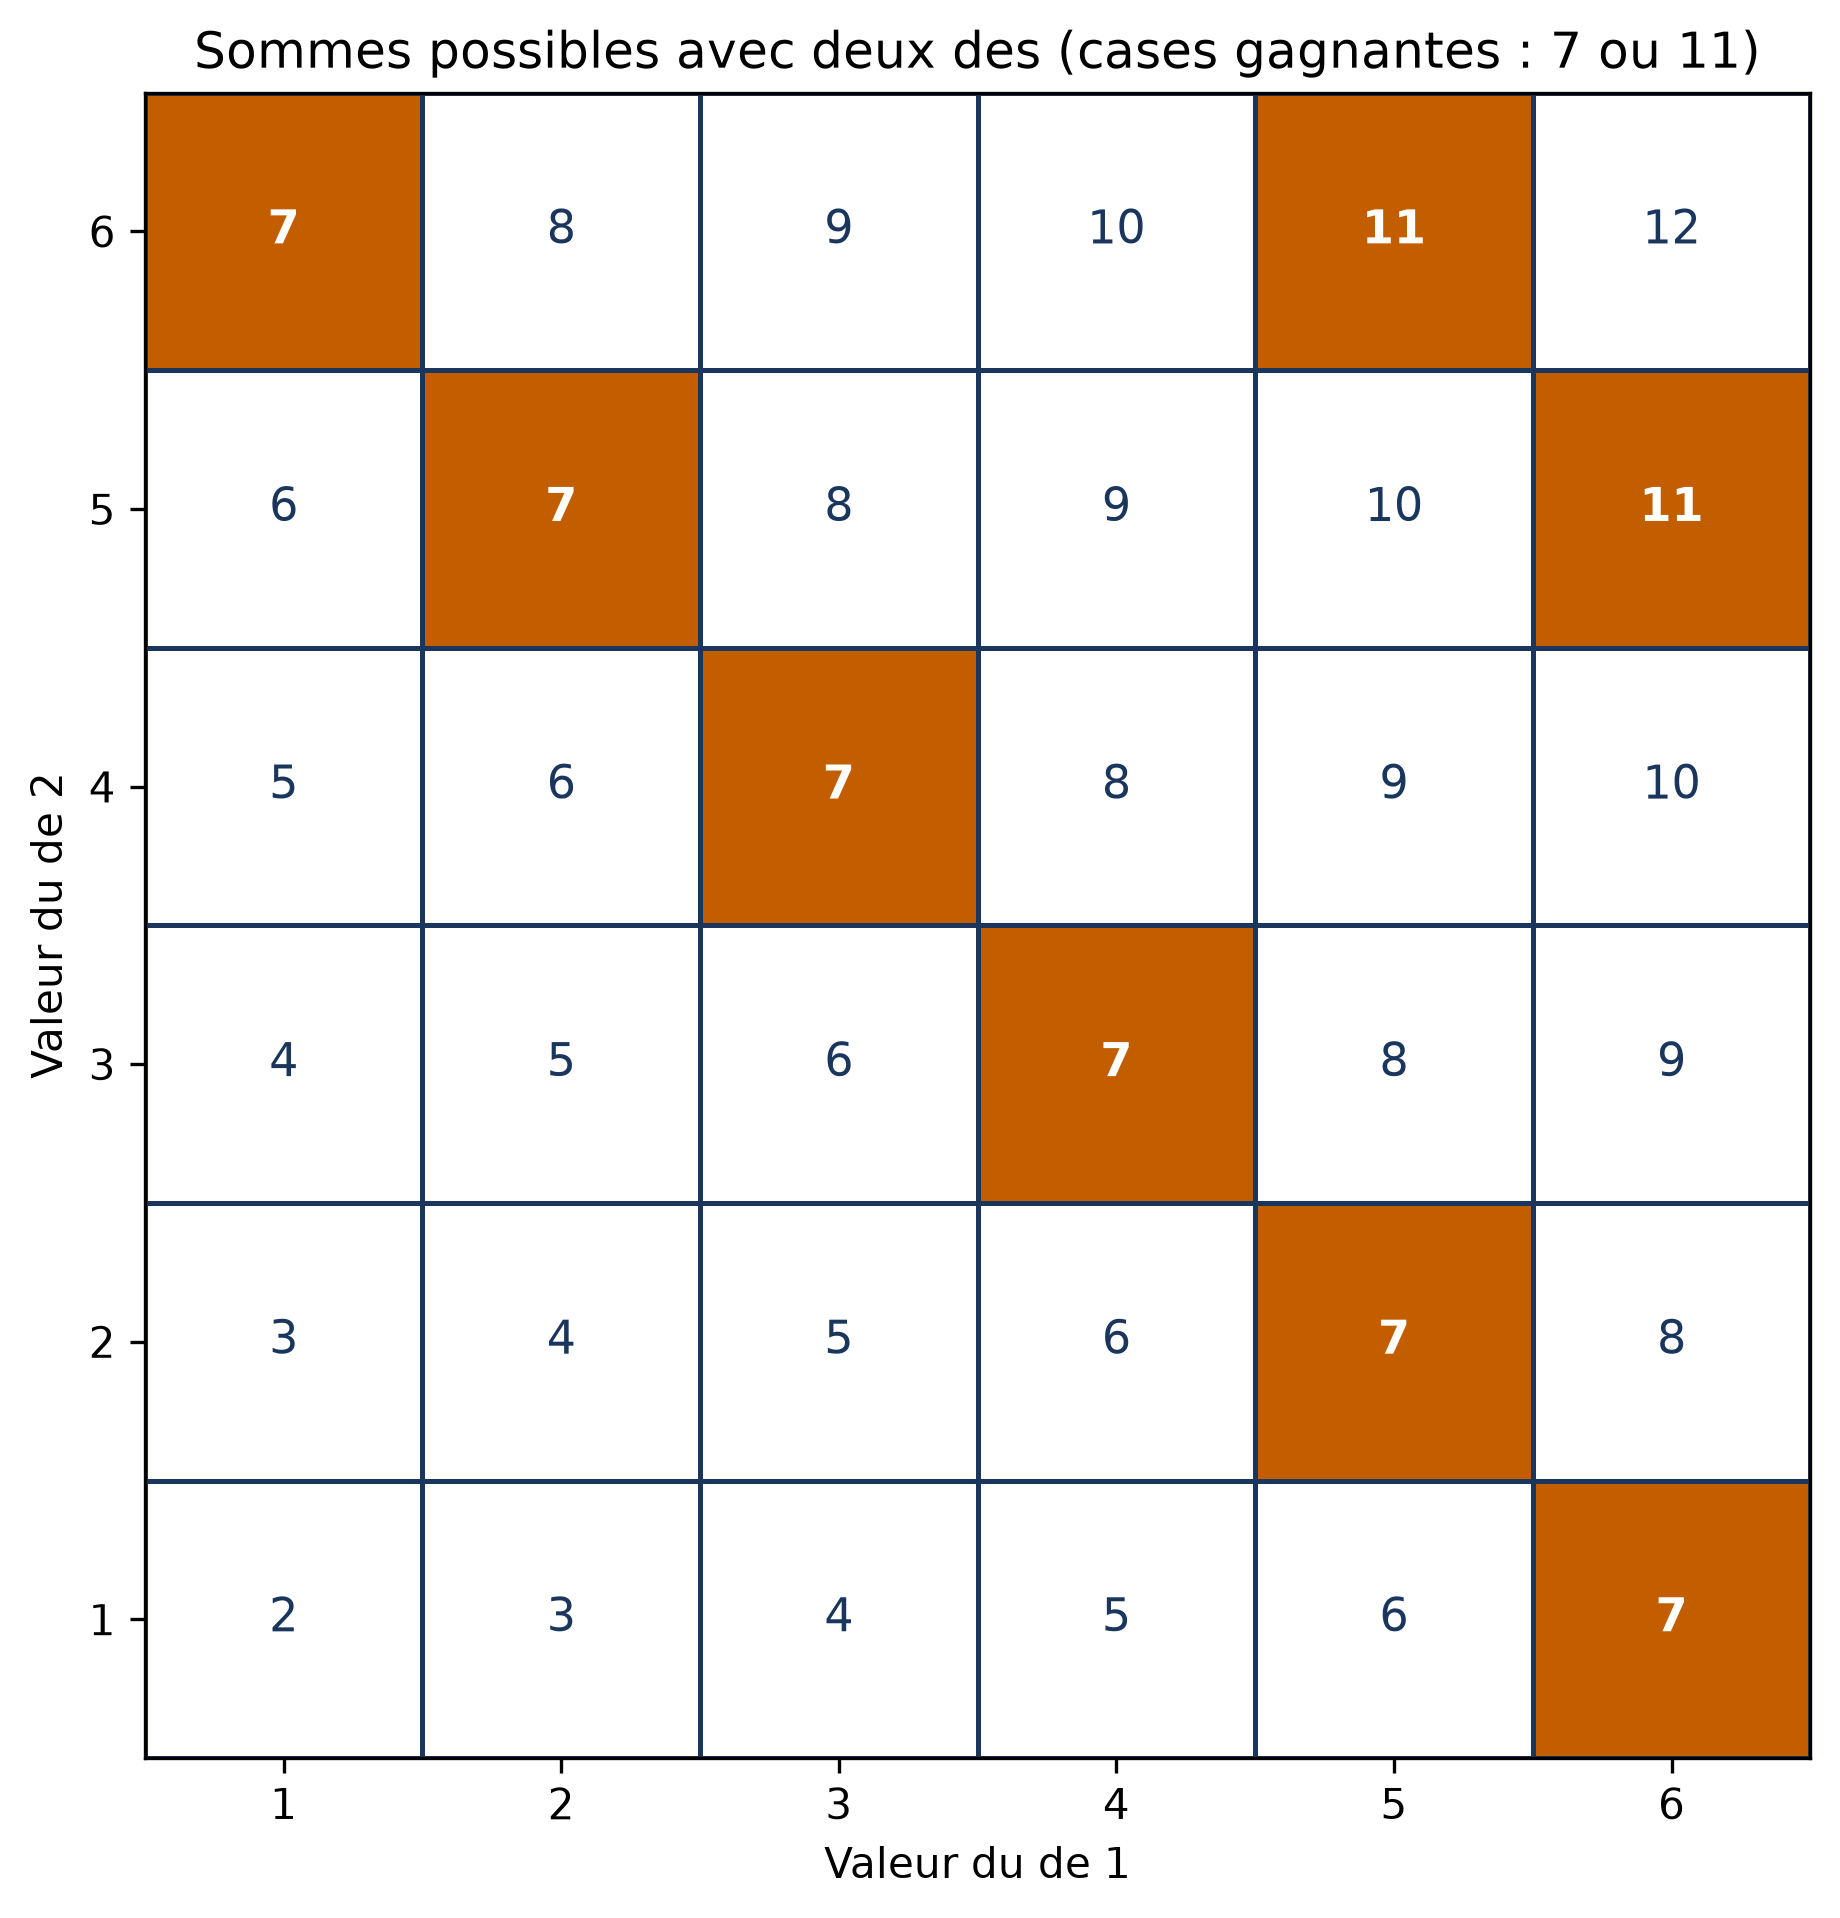
Lance deux dés équilibrés. Chaque dé a six faces, donc il existe 6 × 6 = 36 combinaisons. Six d’entre elles donnent une somme de 7 et deux donnent 11 : cela fait 8 combinaisons gagnantes sur 36, soit 2/9, environ 22,22 %. Voilà tout le secret : cas favorables sur cas possibles.
Revenons au dépistage. L’arbre ci-dessous sépare les 1 120 personnes en 140 malades et 980 sains, puis chaque groupe selon le résultat du test.
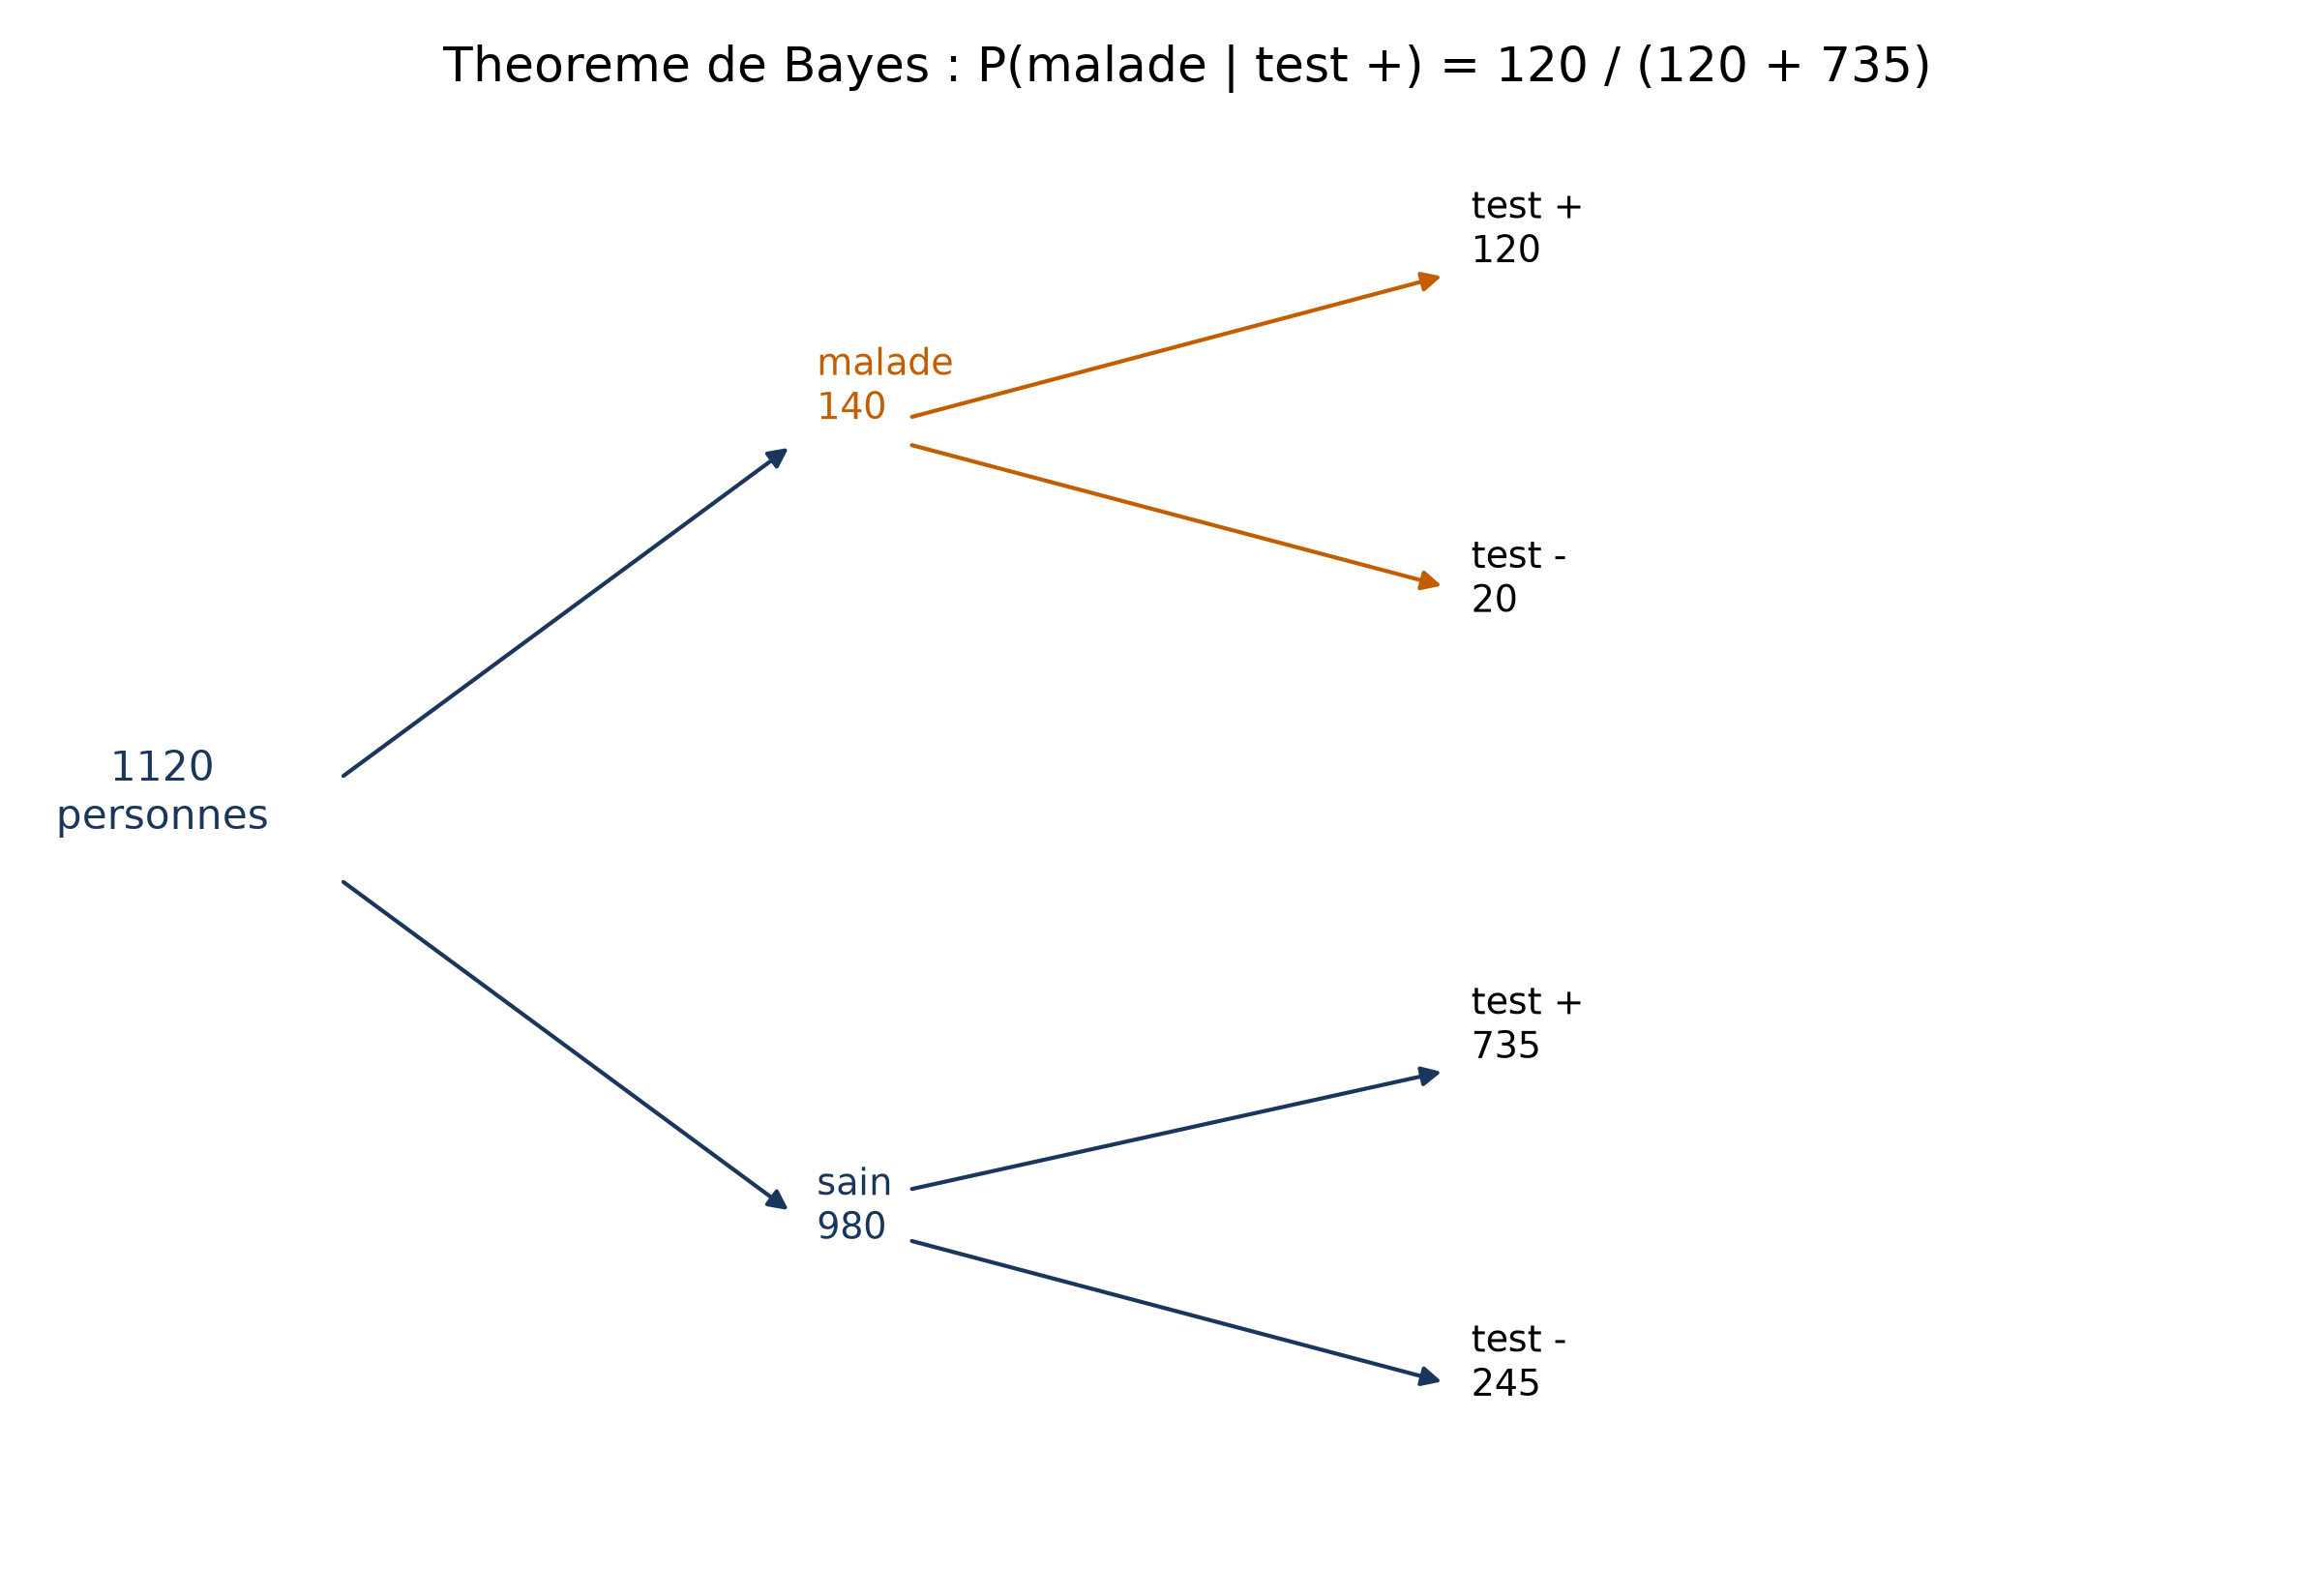
Pour la chance d’être malade quand on est positif, on ne regarde plus que les cas positifs : 120 malades parmi 120 + 735 = 855 personnes. On note cela 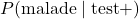 , et la barre verticale se lit « sachant que ». Elle signifie que l’on compte dans le sous-groupe qui suit la barre, rien d’autre.
Ce que calcule une régression logistique est de cette famille : la probabilité d’une réponse (oui ou non) sachant les valeurs observées. La seule différence est que le « sachant que » ne porte plus sur un résultat de test, mais sur des nombres, comme un solde ou une température.
⚠️ Piège Ne confonds pas les deux sens de la barre. Parmi les 140 malades, 120 sont positifs, soit environ 86 % ; parmi les 855 positifs, seuls 120 sont malades, soit 14 %. Inverser un « sachant que » donne un tout autre nombre.
Un score se fabrique en additionnant des poids
Avant la moindre probabilité, le modèle fabrique un score, un nombre quelconque. Il le calcule en donnant un poids à chaque variable, puis en additionnant. Avec les variables  et leurs poids
 , cela s’écrit :
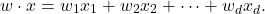
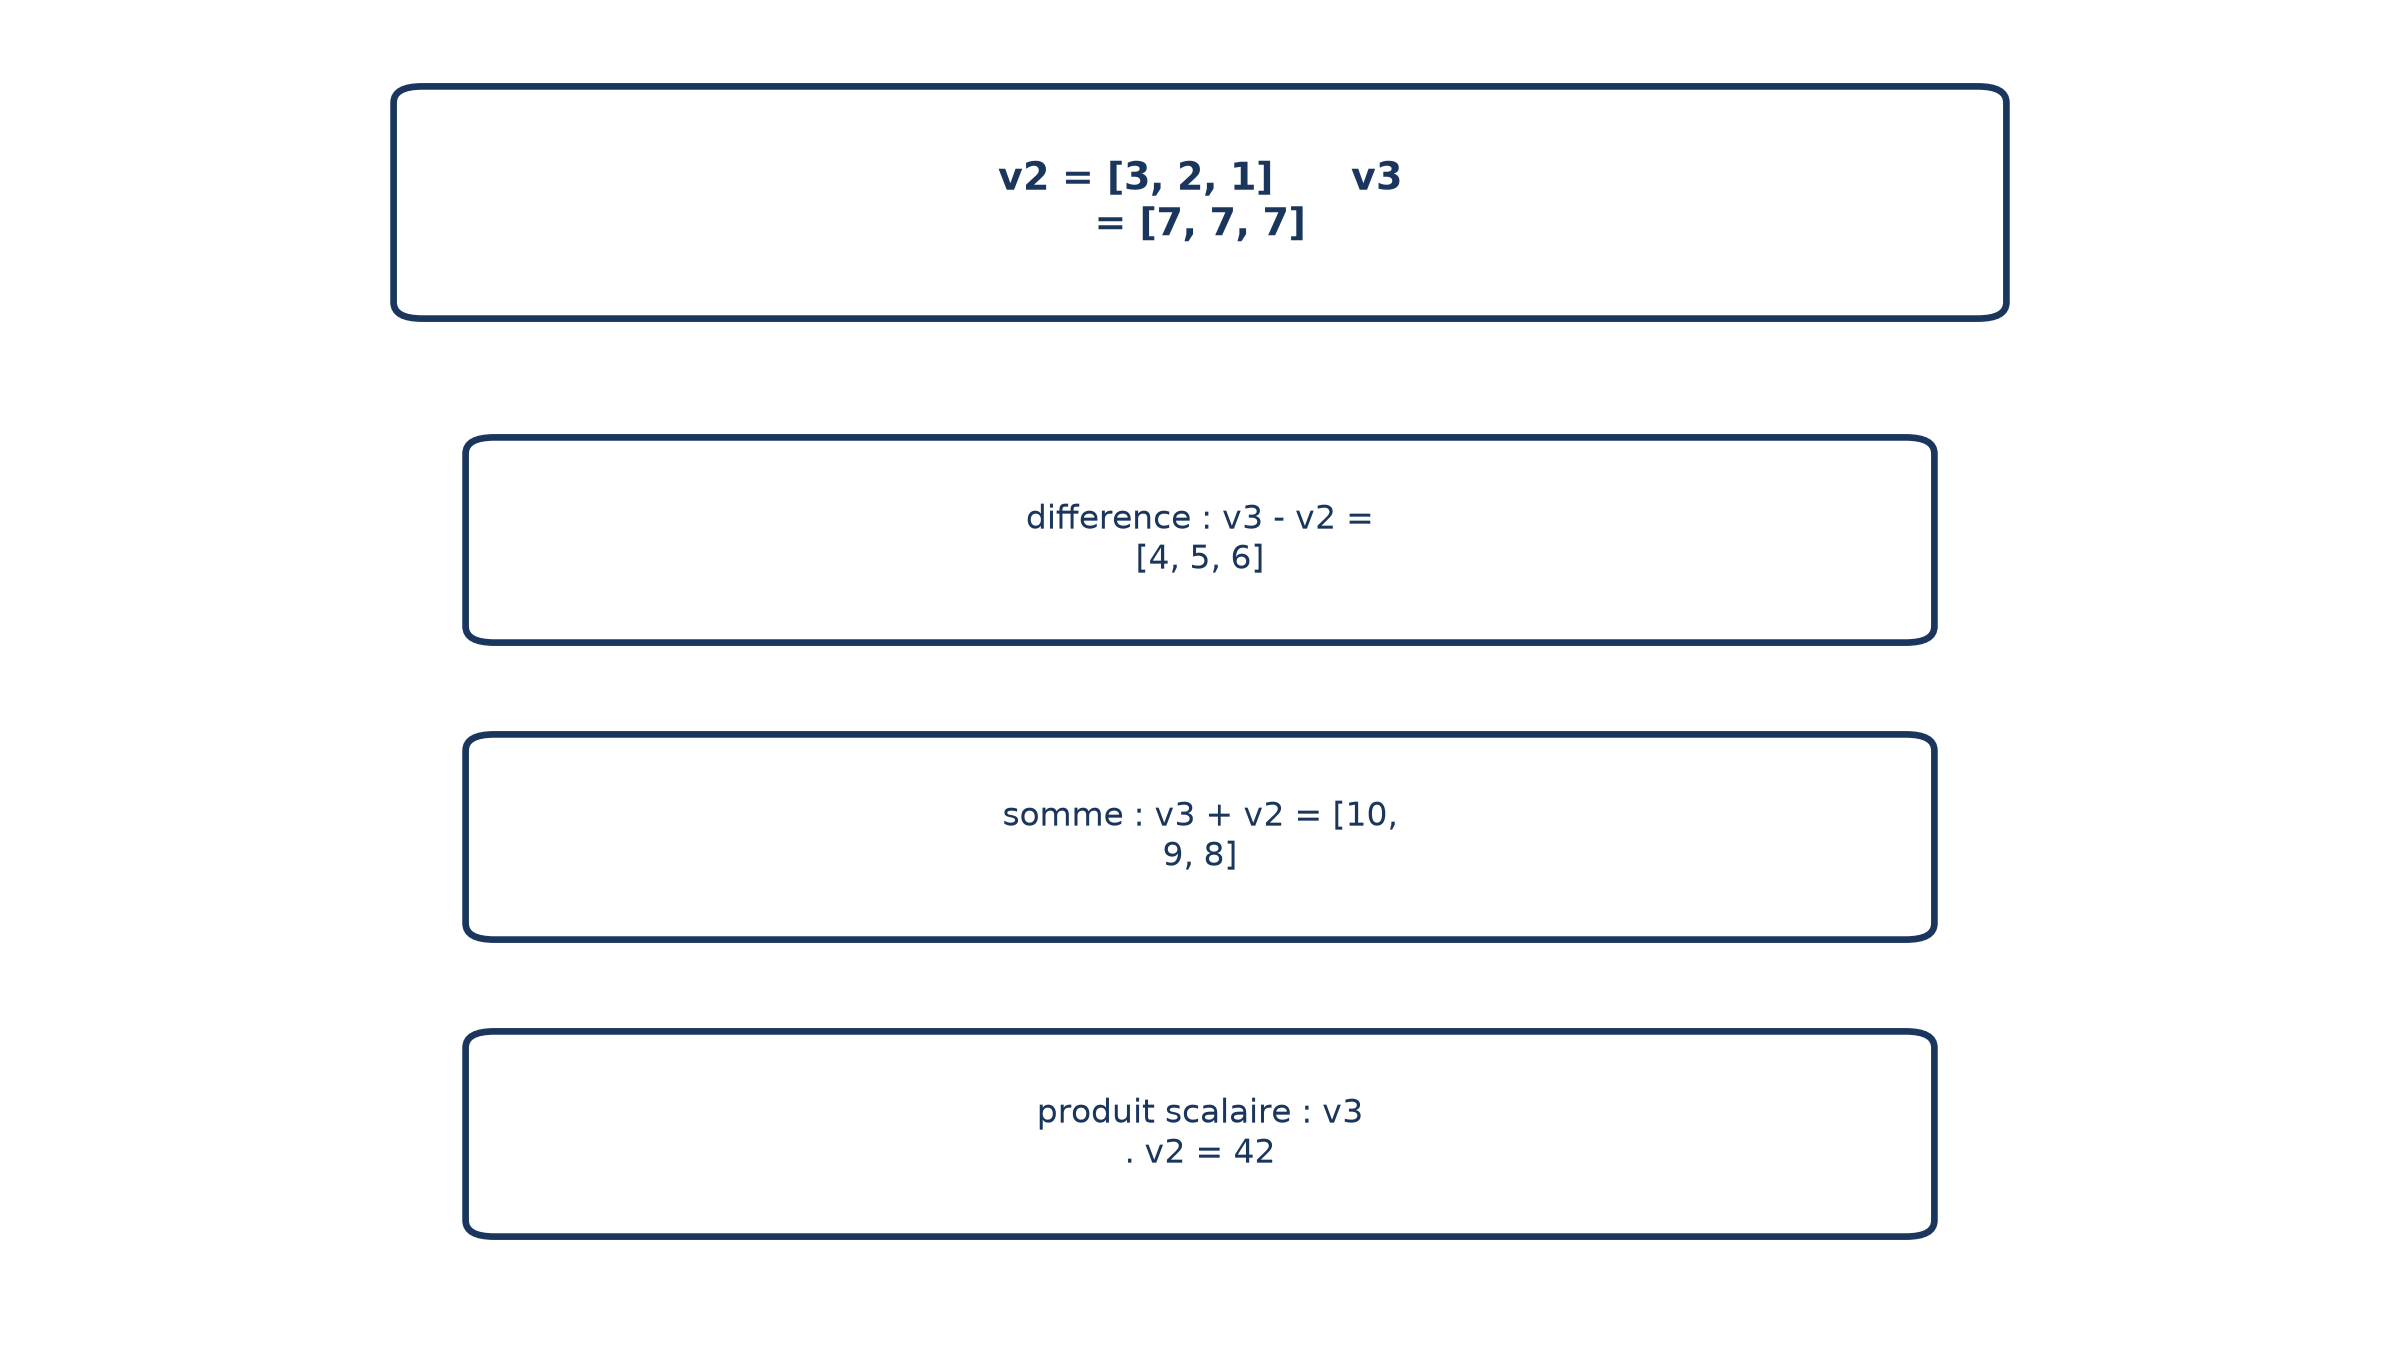
Chaque poids dit combien la variable correspondante compte ; le calcul s’appelle un produit scalaire. Un exemple chiffré : avec les listes  et
 , on obtient
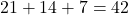 . Un neurone artificiel pratique ce même calcul sur ses entrées.
On ajoute en général un point de départ au score, ce qu’on appelle l’ordonnée à l’origine : une droite s’écrit  , avec
 pour le point de départ et
 pour la pente. On trouve aussi ces poids notés
 . Le problème : ce score peut valoir −50 ou 4 000, alors qu’une probabilité est coincée entre 0 et 1. Il faut un convertisseur.
L’exponentielle rend positif, la fraction ramène entre 0 et 1
La fonction exponentielle  , où
 , passe toujours par le point
 et ne touche jamais l’axe horizontal, même si elle s’en approche indéfiniment. Conséquence simple : quel que soit le score mis à la place de
 , le résultat reste au-dessus de zéro. L’exponentielle sert donc à fabriquer du positif à partir de n’importe quel nombre.
Le convertisseur lui-même est la fonction sigmoïde, que l’on trouve aussi appelée fonction logistique :
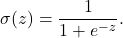
Teste-la avec trois scores. Pour  ,
 vaut 1 et le résultat est 1/2. Pour un
 très grand,
 devient minuscule et le résultat s’approche de 1. Pour un très négatif, devient énorme et le résultat s’approche de 0.
Cette fonction est bornée entre 0 et 1 et toujours croissante : plus le score monte, plus la probabilité monte, sans jamais déborder.
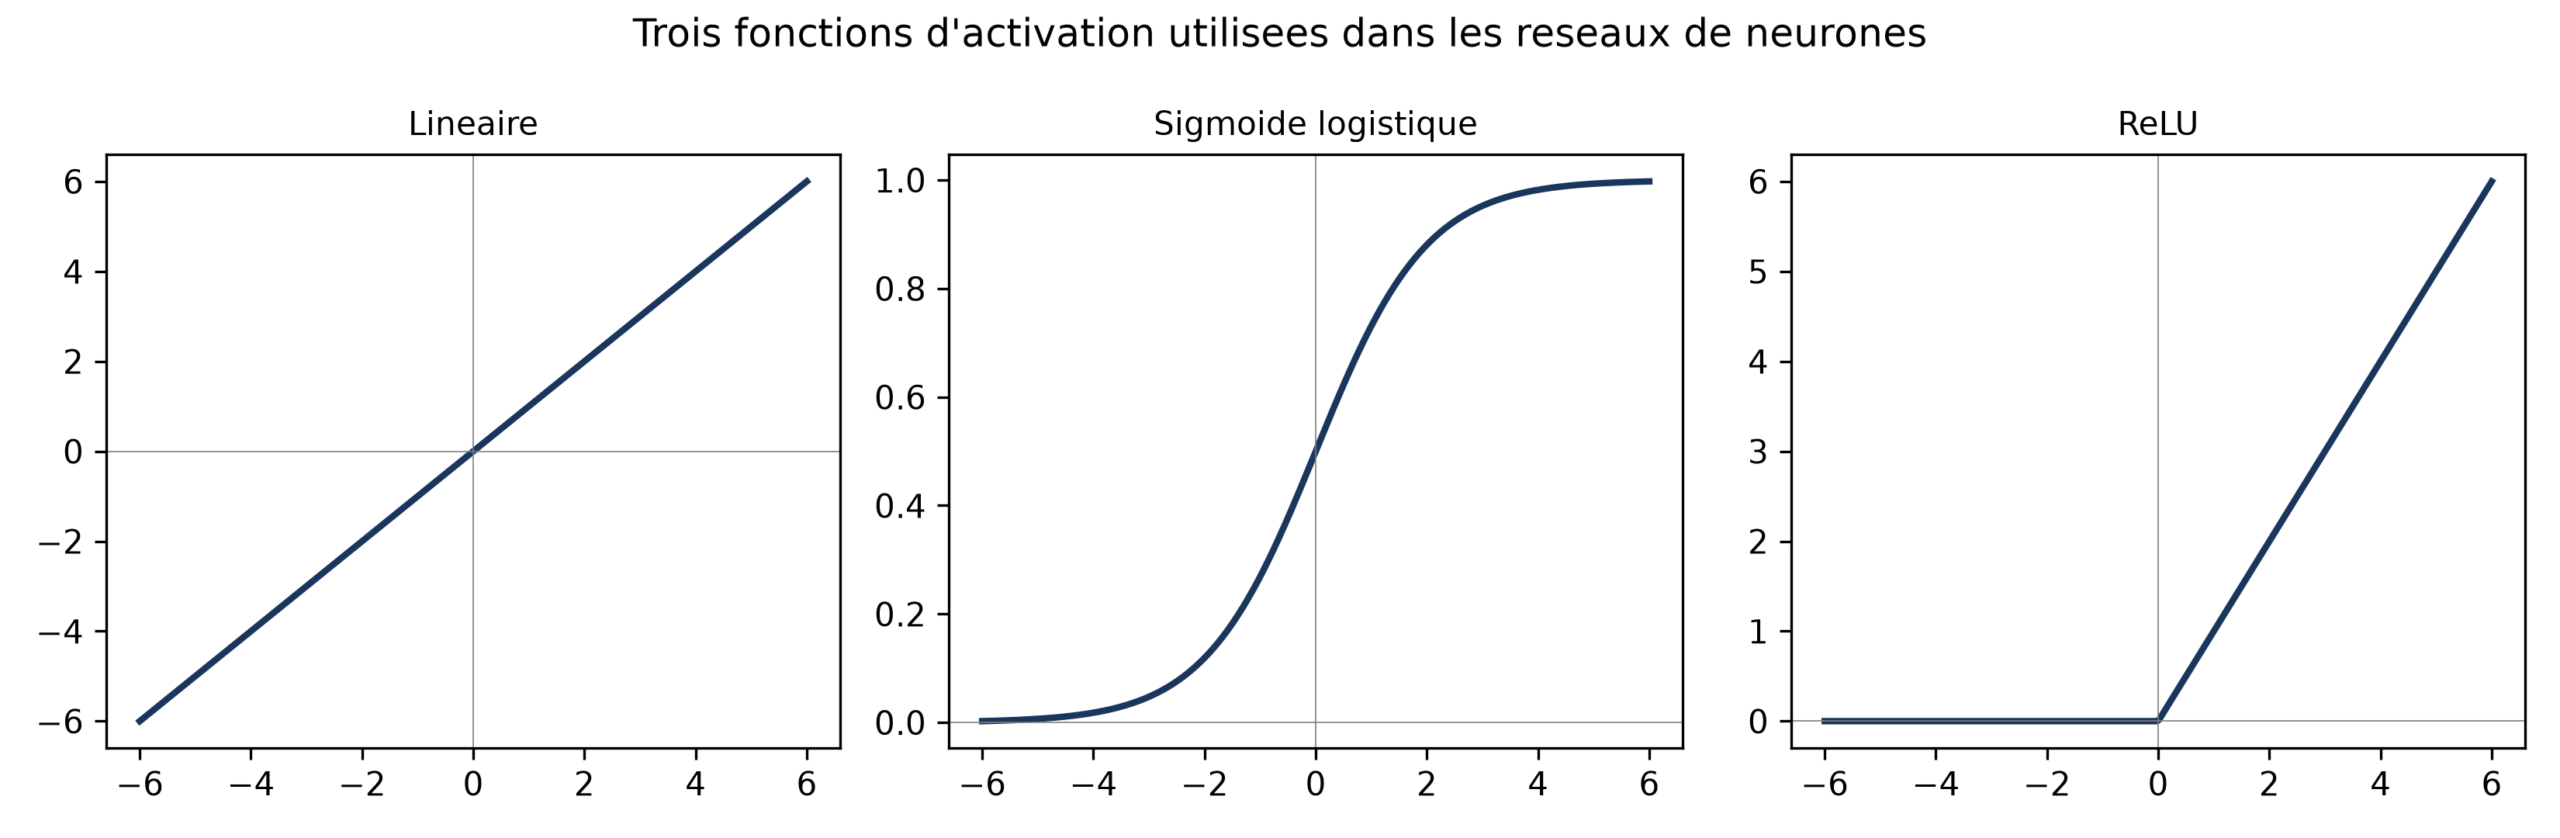
⚠️ Piège Une courbe plate ne bouge presque plus : sa pente y est quasi nulle. Dans les réseaux profonds, cette pente quasi nulle finit par éteindre le signal d’erreur, d’où le recours à d’autres fonctions que la sigmoïde.
Le logarithme : un pont entre multiplications et additions
Le logarithme est la fonction réciproque de l’exponentielle : il défait ce qu’elle a fait. Quand la base est  , on le note
 , et son graphe est le symétrique de celui de par rapport à la droite
 . Retiens son talent principal : il change les produits en sommes.
Pour lui donner du travail, il faut une grandeur à comparer. La cote (odds) est le rapport entre la probabilité d’un événement et celle de son contraire, soit  . Reprends nos 855 positifs : 120 sont malades et 735 sont sains. La cote vaut 120 / 735, soit environ 0,16, ce qui veut dire à peu près un malade pour six sains, là où la probabilité, elle, est de 14 %.
Le modèle pose alors son score sur le logarithme de cette cote :
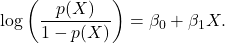
À gauche, la probabilité  transformée en cote puis en logarithme ; à droite, le score. La sigmoïde de la section précédente est simplement le trajet inverse : du score à la probabilité. Et comme le logarithme change les produits en sommes, ajouter un peu au score revient à multiplier la cote.
Pourquoi on additionne des logarithmes au lieu de multiplier des probabilités
Pour juger un jeu de coefficients, on regarde la probabilité qu’il attribue à ce qui s’est réellement passé, et on combine toutes les observations : c’est la vraisemblance, un produit de probabilités, une par observation. On cherche le jeu de coefficients qui rend ce produit le plus grand possible.
Les mathématiciens ne maximisent pas ce produit, mais son logarithme, par commodité de calcul. Les produits deviennent alors des sommes, bien plus faciles à manipuler. Reste une inquiétude : prendre le logarithme ne risque-t-il pas de changer le gagnant ?
⚠️ Piège Non, et la raison est simple : le logarithme est strictement croissant, donc si un jeu de coefficients bat un autre avant, il le bat encore après. Le logarithme ne change pas le classement, seulement la difficulté du calcul.
Corriger les coefficients : la pente dit dans quel sens tourner
Il reste à trouver les bons coefficients. Pour la régression logistique, il n’existe pas de formule qui les donne d’un coup : on avance donc par petites corrections. Le guide de ces corrections est la pente.
La dérivée mesure la pente de la courbe en un point. C’est la vitesse instantanée d’un objet qui avance : la limite de sa vitesse moyenne sur un intervalle de temps qui rétrécit jusqu’à zéro.
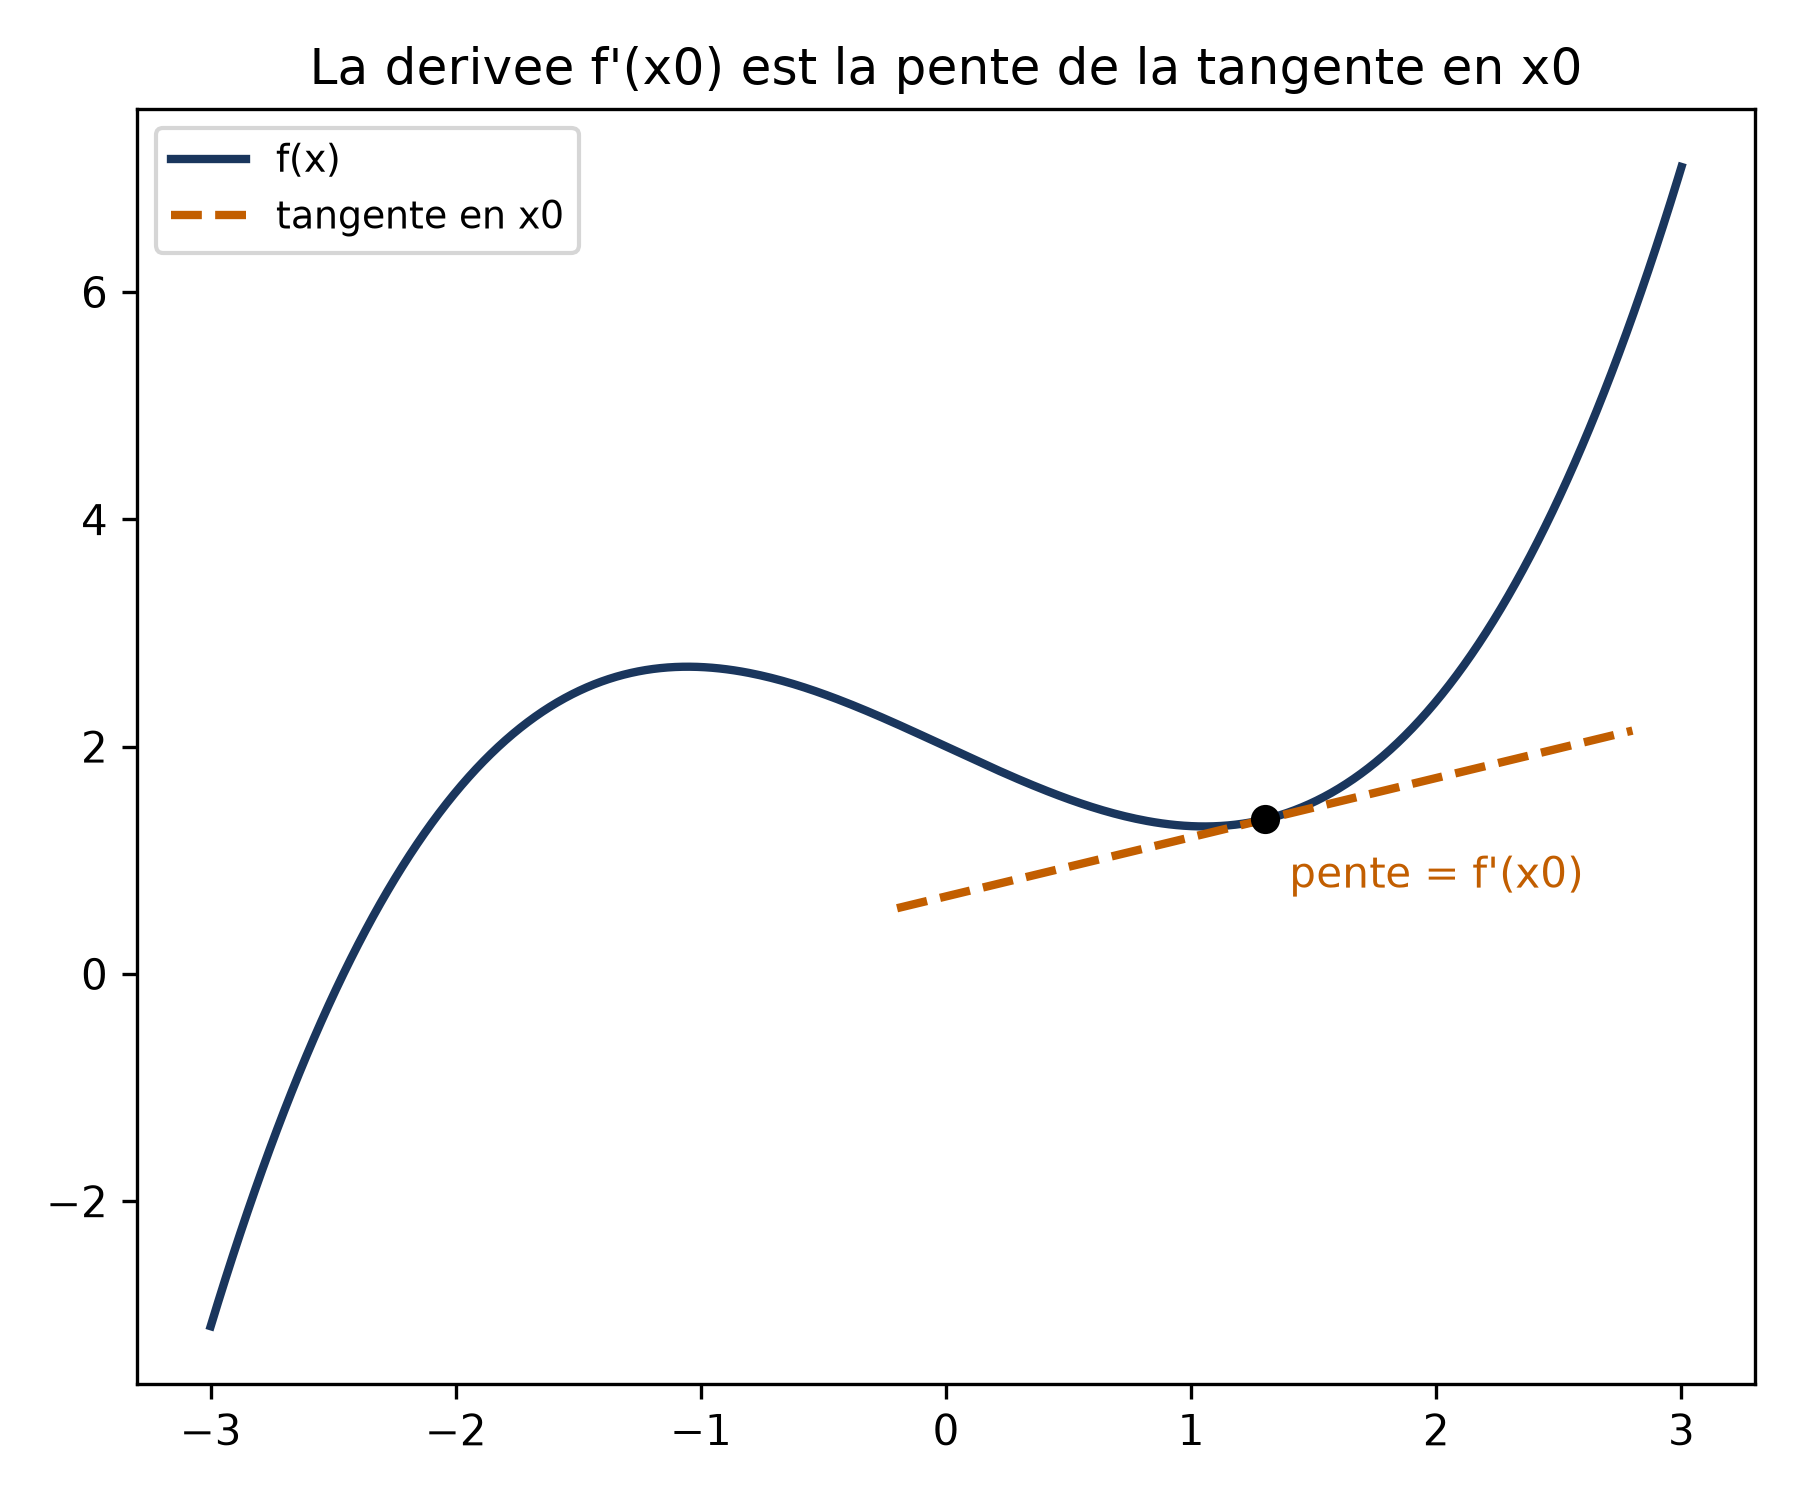
Le signe de cette pente est une boussole. Là où elle est positive, la courbe monte ; là où elle est négative, elle descend ; là où elle s’annule, la tangente est horizontale, et un minimum peut se cacher.
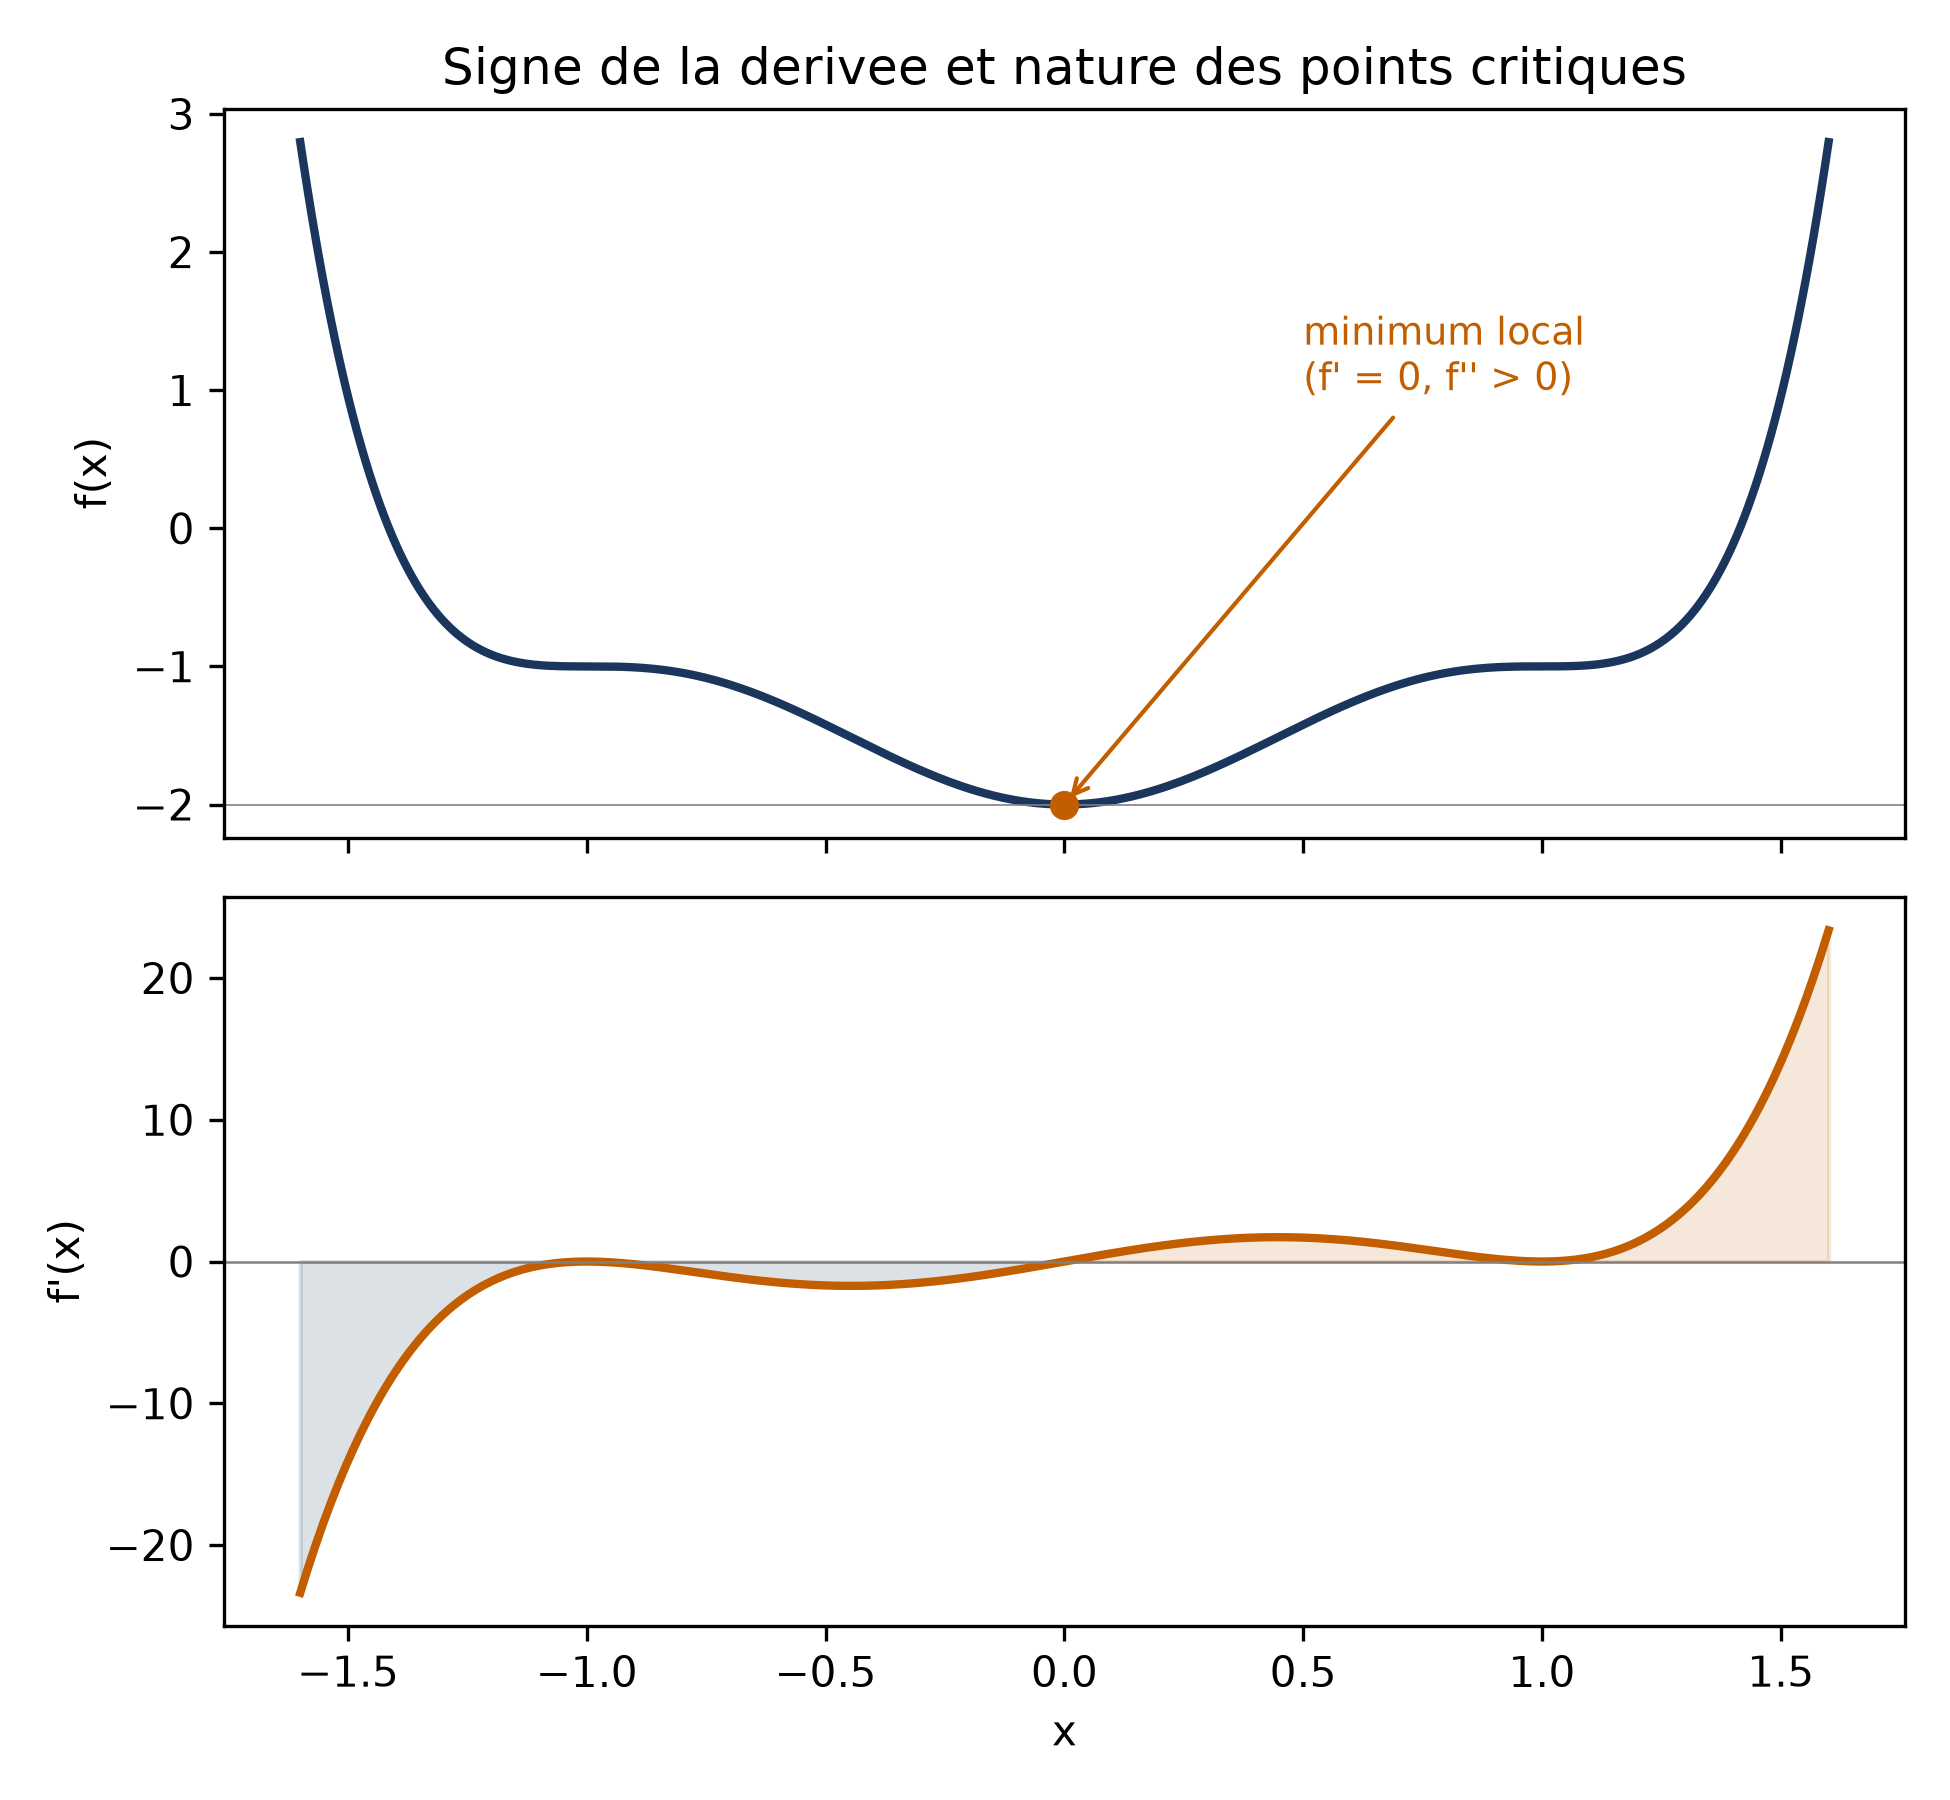
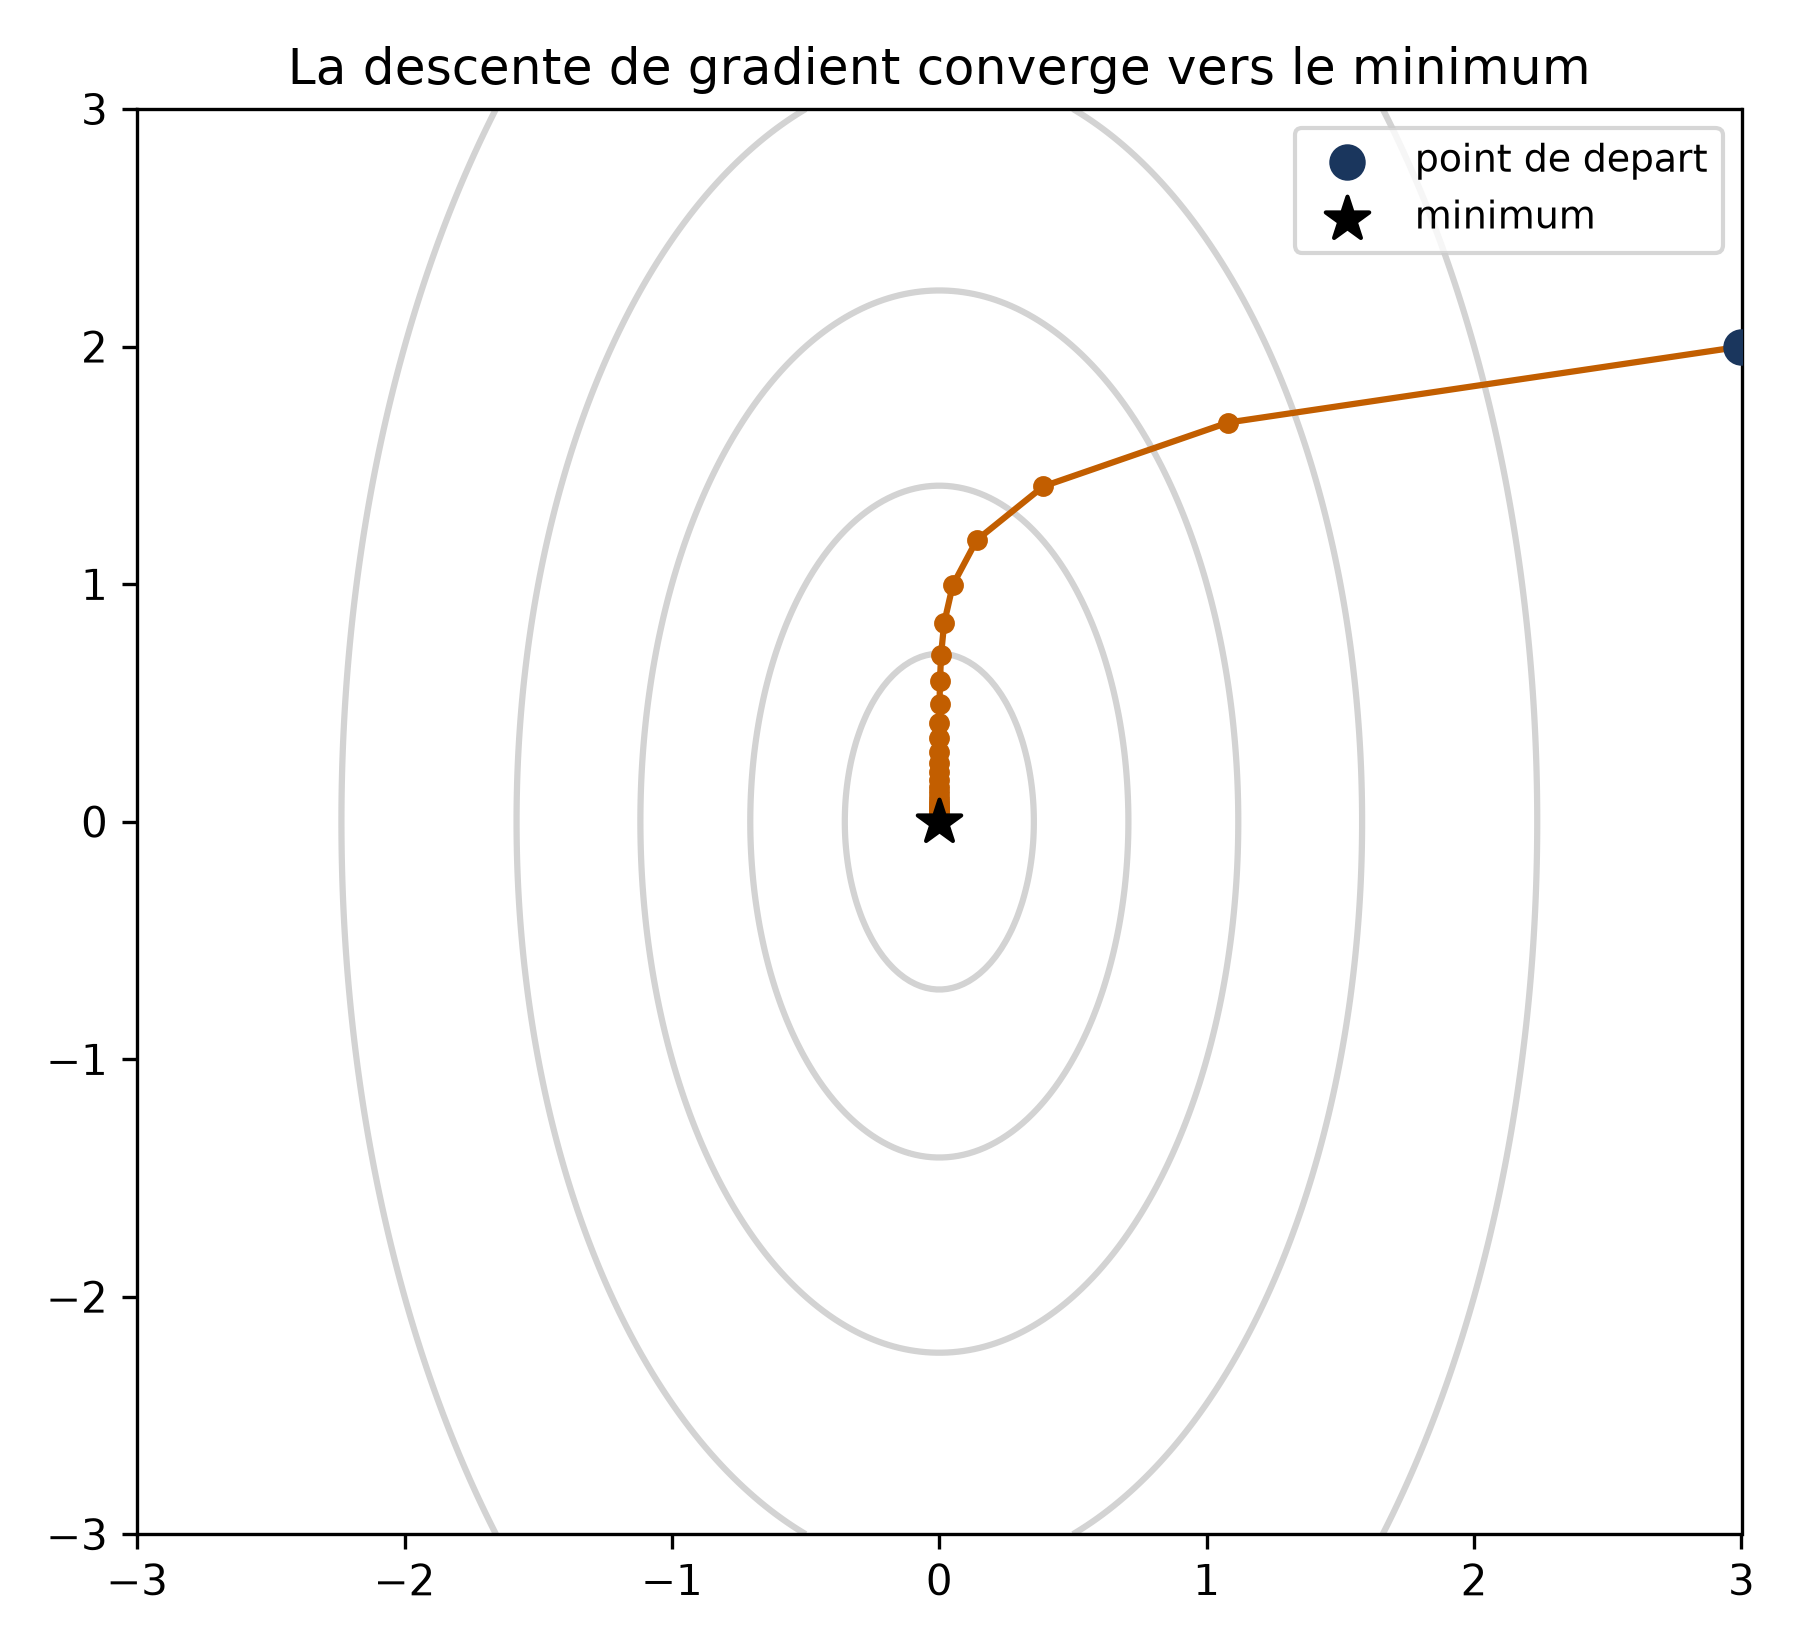
Quand plusieurs coefficients sont à régler, on rassemble toutes les pentes dans un vecteur, le gradient, qui pointe vers la plus forte montée. Pour descendre, on fait donc le contraire. À chaque étape, on déplace chaque coefficient en sens opposé à sa pente, d’un pas  :
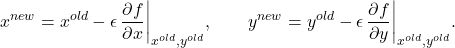
Ici  est la quantité à faire descendre, et
 les deux réglages, et
 la pente de quand seul bouge. Le pas s’appelle le taux d’apprentissage : trop grand, il dépasse le creux à chaque étape ; trop petit, il rend la descente très lente.
💡 Intuition Imagine une douche à deux robinets, chacun à régler un peu à chaque essai dans le sens qui rend l’eau moins désagréable. Un robinet tourné trop fort fait passer de l’eau glacée à l’eau brûlante ; tourné trop doucement, il faut des heures. La descente de gradient n’est rien d’autre que cette habitude.
La même brique dans un neurone et dans un classifieur de mots
Ces idées ne servent pas qu’à classer des clients. Un neurone artificiel pondère ses entrées, les additionne (le produit scalaire de plus haut), puis transforme la somme avec une fonction d’activation. La sigmoïde était longtemps le choix par défaut ; sans non-linéarité, un réseau, aussi profond soit-il, se réduirait à un simple modèle linéaire.
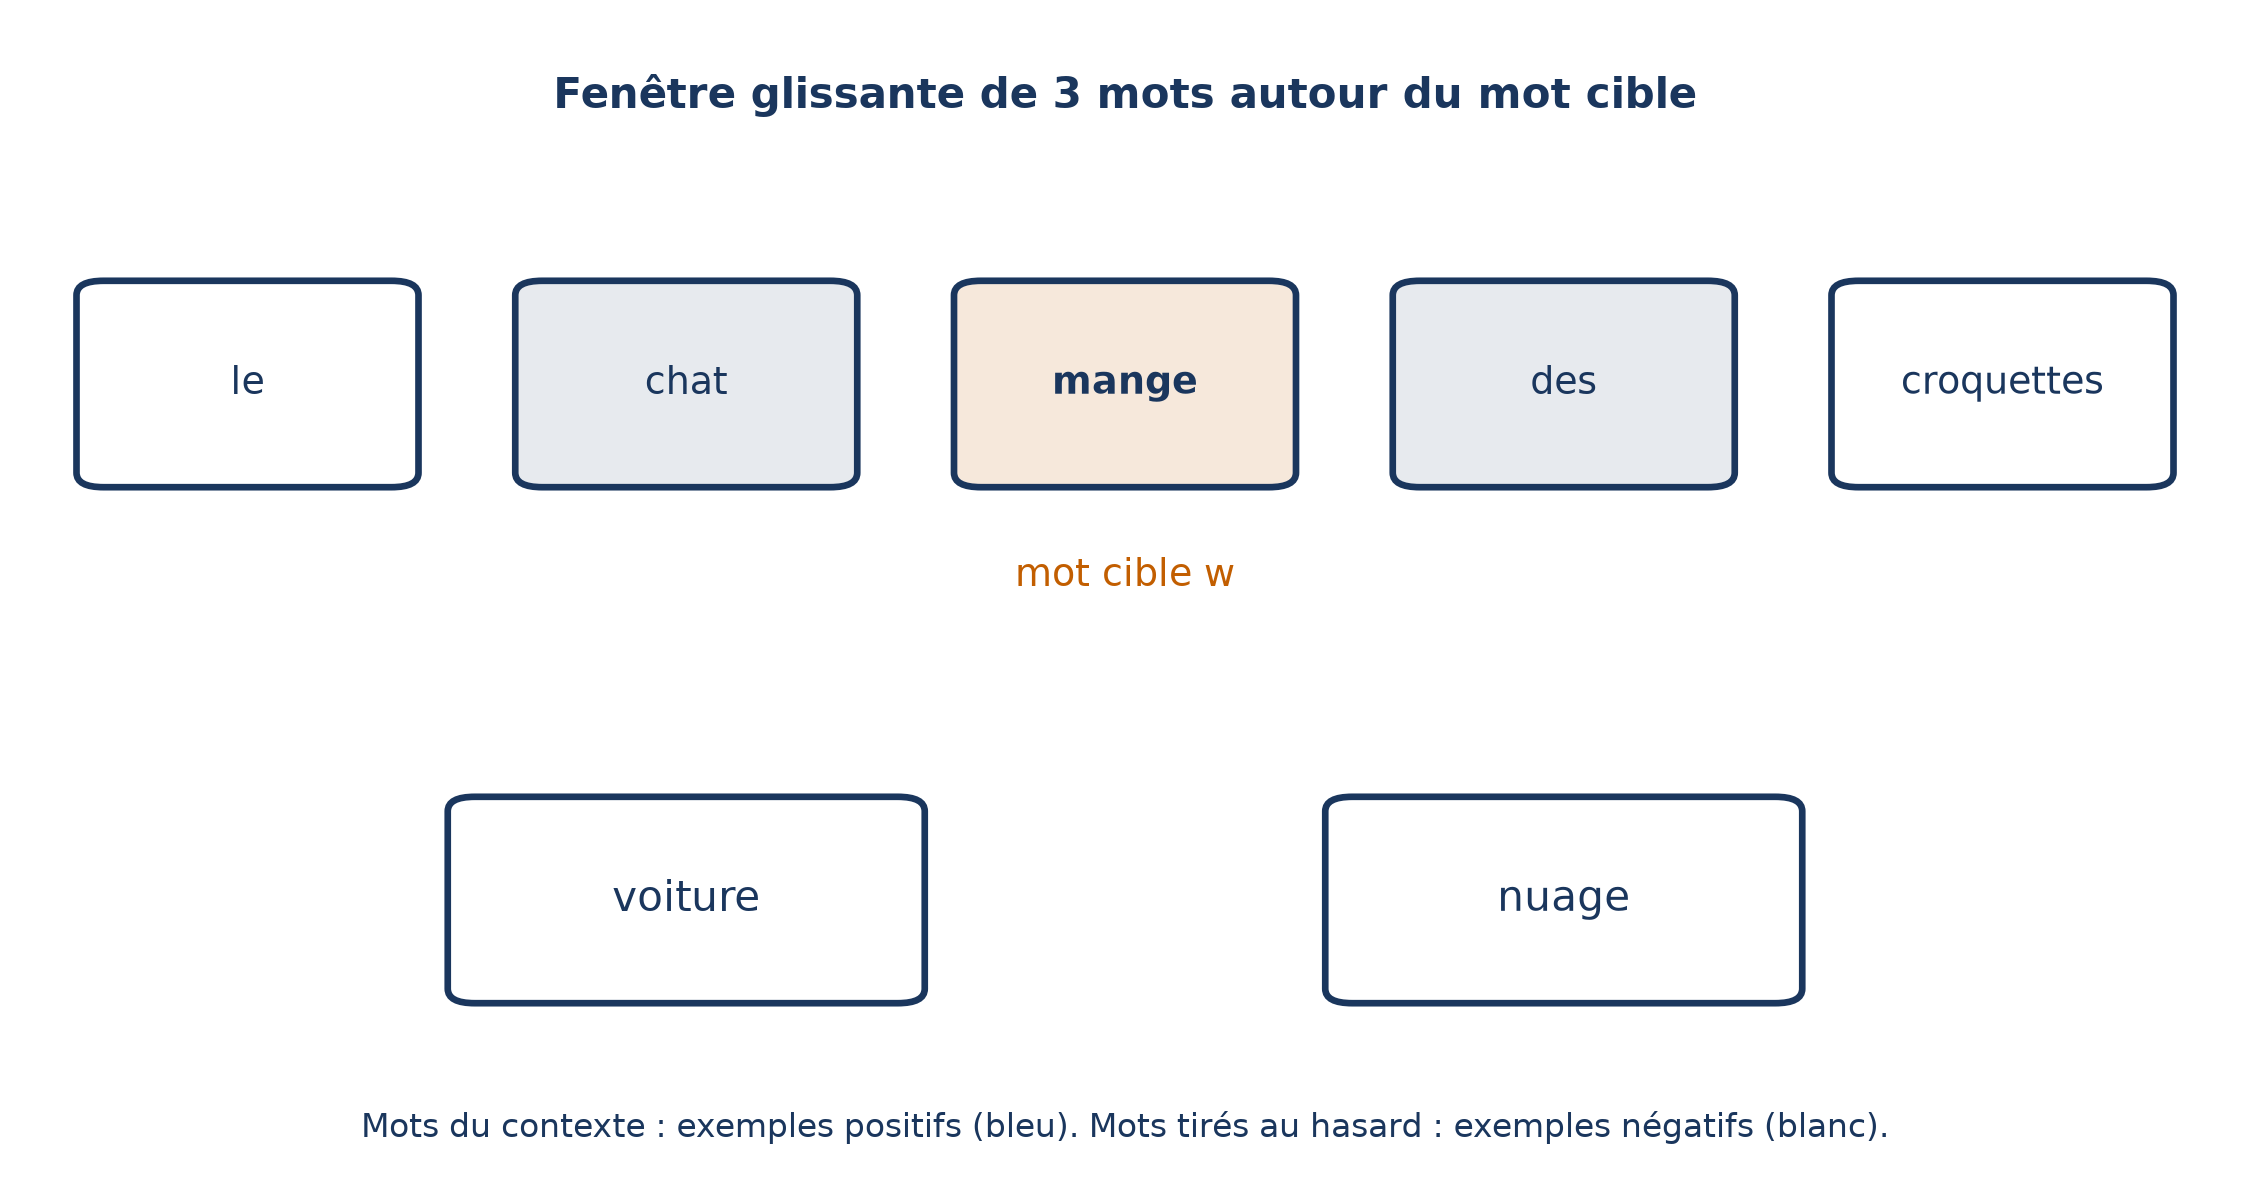
Un exemple sur du texte. Pour apprendre à représenter des mots par des vecteurs, on pose une question oui ou non : tel mot est-il attendu autour de tel autre ? On fait glisser une fenêtre sur la phrase : les mots voisins sont des exemples positifs, des mots tirés au hasard sont des exemples négatifs. Le classifieur utilisé est une régression logistique.
On retrouve ici chacune de nos briques. Le score est un produit scalaire entre deux vecteurs, la probabilité vient de la sigmoïde :
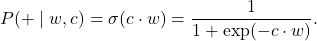
Ici  est le mot cible,
 un mot du contexte, et
 la probabilité que la paire soit valide. Les probabilités des mots de la fenêtre se multiplient, puis le logarithme les change en sommes, ce qui donne la quantité que l’on cherche à rendre petite :
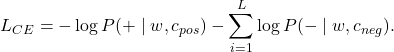
Le premier terme porte sur la vraie paire, la somme sur les  paires tirées au hasard ; minimiser cette quantité pousse le modèle à donner une grande probabilité aux vrais contextes et une petite aux faux.
📌 À retenir Une probabilité se compte, un score se fabrique en additionnant des poids, l’exponentielle et la fraction le convertissent en probabilité, le logarithme transforme les produits en sommes, et la pente dit dans quel sens corriger. Ces cinq idées suffisent à raconter la méthode.