Imagine un assistant vocal dont le moteur de synthèse génère la parole plus vite qu’on ne peut l’écouter. Au-delà du rythme du temps réel, chaque token supplémentaire est du travail que personne n’entendra : de la performance payée pour rien. Savoir quand optimiser un moteur d’inférence, c’est donc aussi savoir quand le gain cesse de compter. Tu repars d’ici avec les signaux qui disent « fonce », ceux qui disent « regarde ailleurs », et le critère pour poser les outils.
Sommaire
- L’essentiel en 30 secondes
- Fixer une cible chiffrée avant de toucher à quoi que ce soit
- Écarter les autres couches avant d’accuser le moteur
- Essayer d’abord un modèle plus petit
- Lire le symptôme pour savoir quelle ressource manque
- Ce que coûte un essai, avant même le premier gain
- Savoir s’arrêter
- Ce qui doit te faire rouvrir le chantier
L’essentiel en 30 secondes
- Optimise quand une mesure chiffrée sort d’une cible que tu as écrite avant de commencer, pas parce que le moteur te semble « lent ».
- Avant de régler le moteur, écarte les autres couches : client, réseau, file d’attente, infrastructure. Le temps passé sur le GPU n’est qu’une fraction de ce que ton utilisateur attend.
- Choisis le levier d’après le symptôme : un premier mot qui tarde pointe le calcul, un débit de mots trop bas pointe la bande passante mémoire, une erreur de mémoire pointe la capacité de VRAM.
- Un modèle plus petit, bien choisi et évalué sur ton produit, t’évite souvent tout le chantier.
- Chaque essai coûte du temps d’ingénierie et des GPU : il ne vaut que si ton banc d’essai ressemble à ta production.
- Arrête-toi quand la cible est tenue et que la qualité est intacte ; rouvre le chantier quand tes métriques, ton trafic ou le paysage des modèles bougent.
Fixer une cible chiffrée avant de toucher à quoi que ce soit
Une plainte comme « les réponses sont lentes » ne dit pas quand tu auras fini. Une exigence exploitable est chiffrée : au lieu de « réponse rapide », on écrit « neuf requêtes sur dix servies en moins de 2 secondes », avec des métriques de succès fixées dès le départ et distinctes des objectifs métier eux-mêmes.
Le bon chiffre dépend de ce que ton utilisateur perçoit. Pour un agent conversationnel qui diffuse sa réponse en continu, on suit le TTFT, l’attente avant que le premier mot apparaisse, puis le rythme des mots suivants. Pour un appel d’outil par un agent, les tokens ne servent pas un par un : on mesure alors le temps de réponse total.
En synthèse vocale, l’équivalent du TTFT s’appelle TTFB (time to first byte) et peut descendre jusqu’à 150 millisecondes pour le modèle Orpheus sur un seul H100. Une autre mesure colle mieux encore à l’expérience : le temps jusqu’à la première phrase, qui chronomètre la première portion de parole vraiment utile.
💡 Intuition Une cible utile tient en une phrase : un chiffre, un percentile, un usage. « 90 % des requêtes en moins de 2 secondes » en est une ; « plus rapide » n’en est pas une. Tant que tu ne l’as pas écrite, tu ne peux ni savoir s’il faut optimiser, ni reconnaître le moment où c’est fini.
Pourquoi on exprime ces cibles en percentiles plutôt qu’en moyenne, et ce que mesurent exactement TTFT et TPS, est expliqué dans « Optimiser un moteur d’inférence : les 6 techniques qui comptent ».
Écarter les autres couches avant d’accuser le moteur
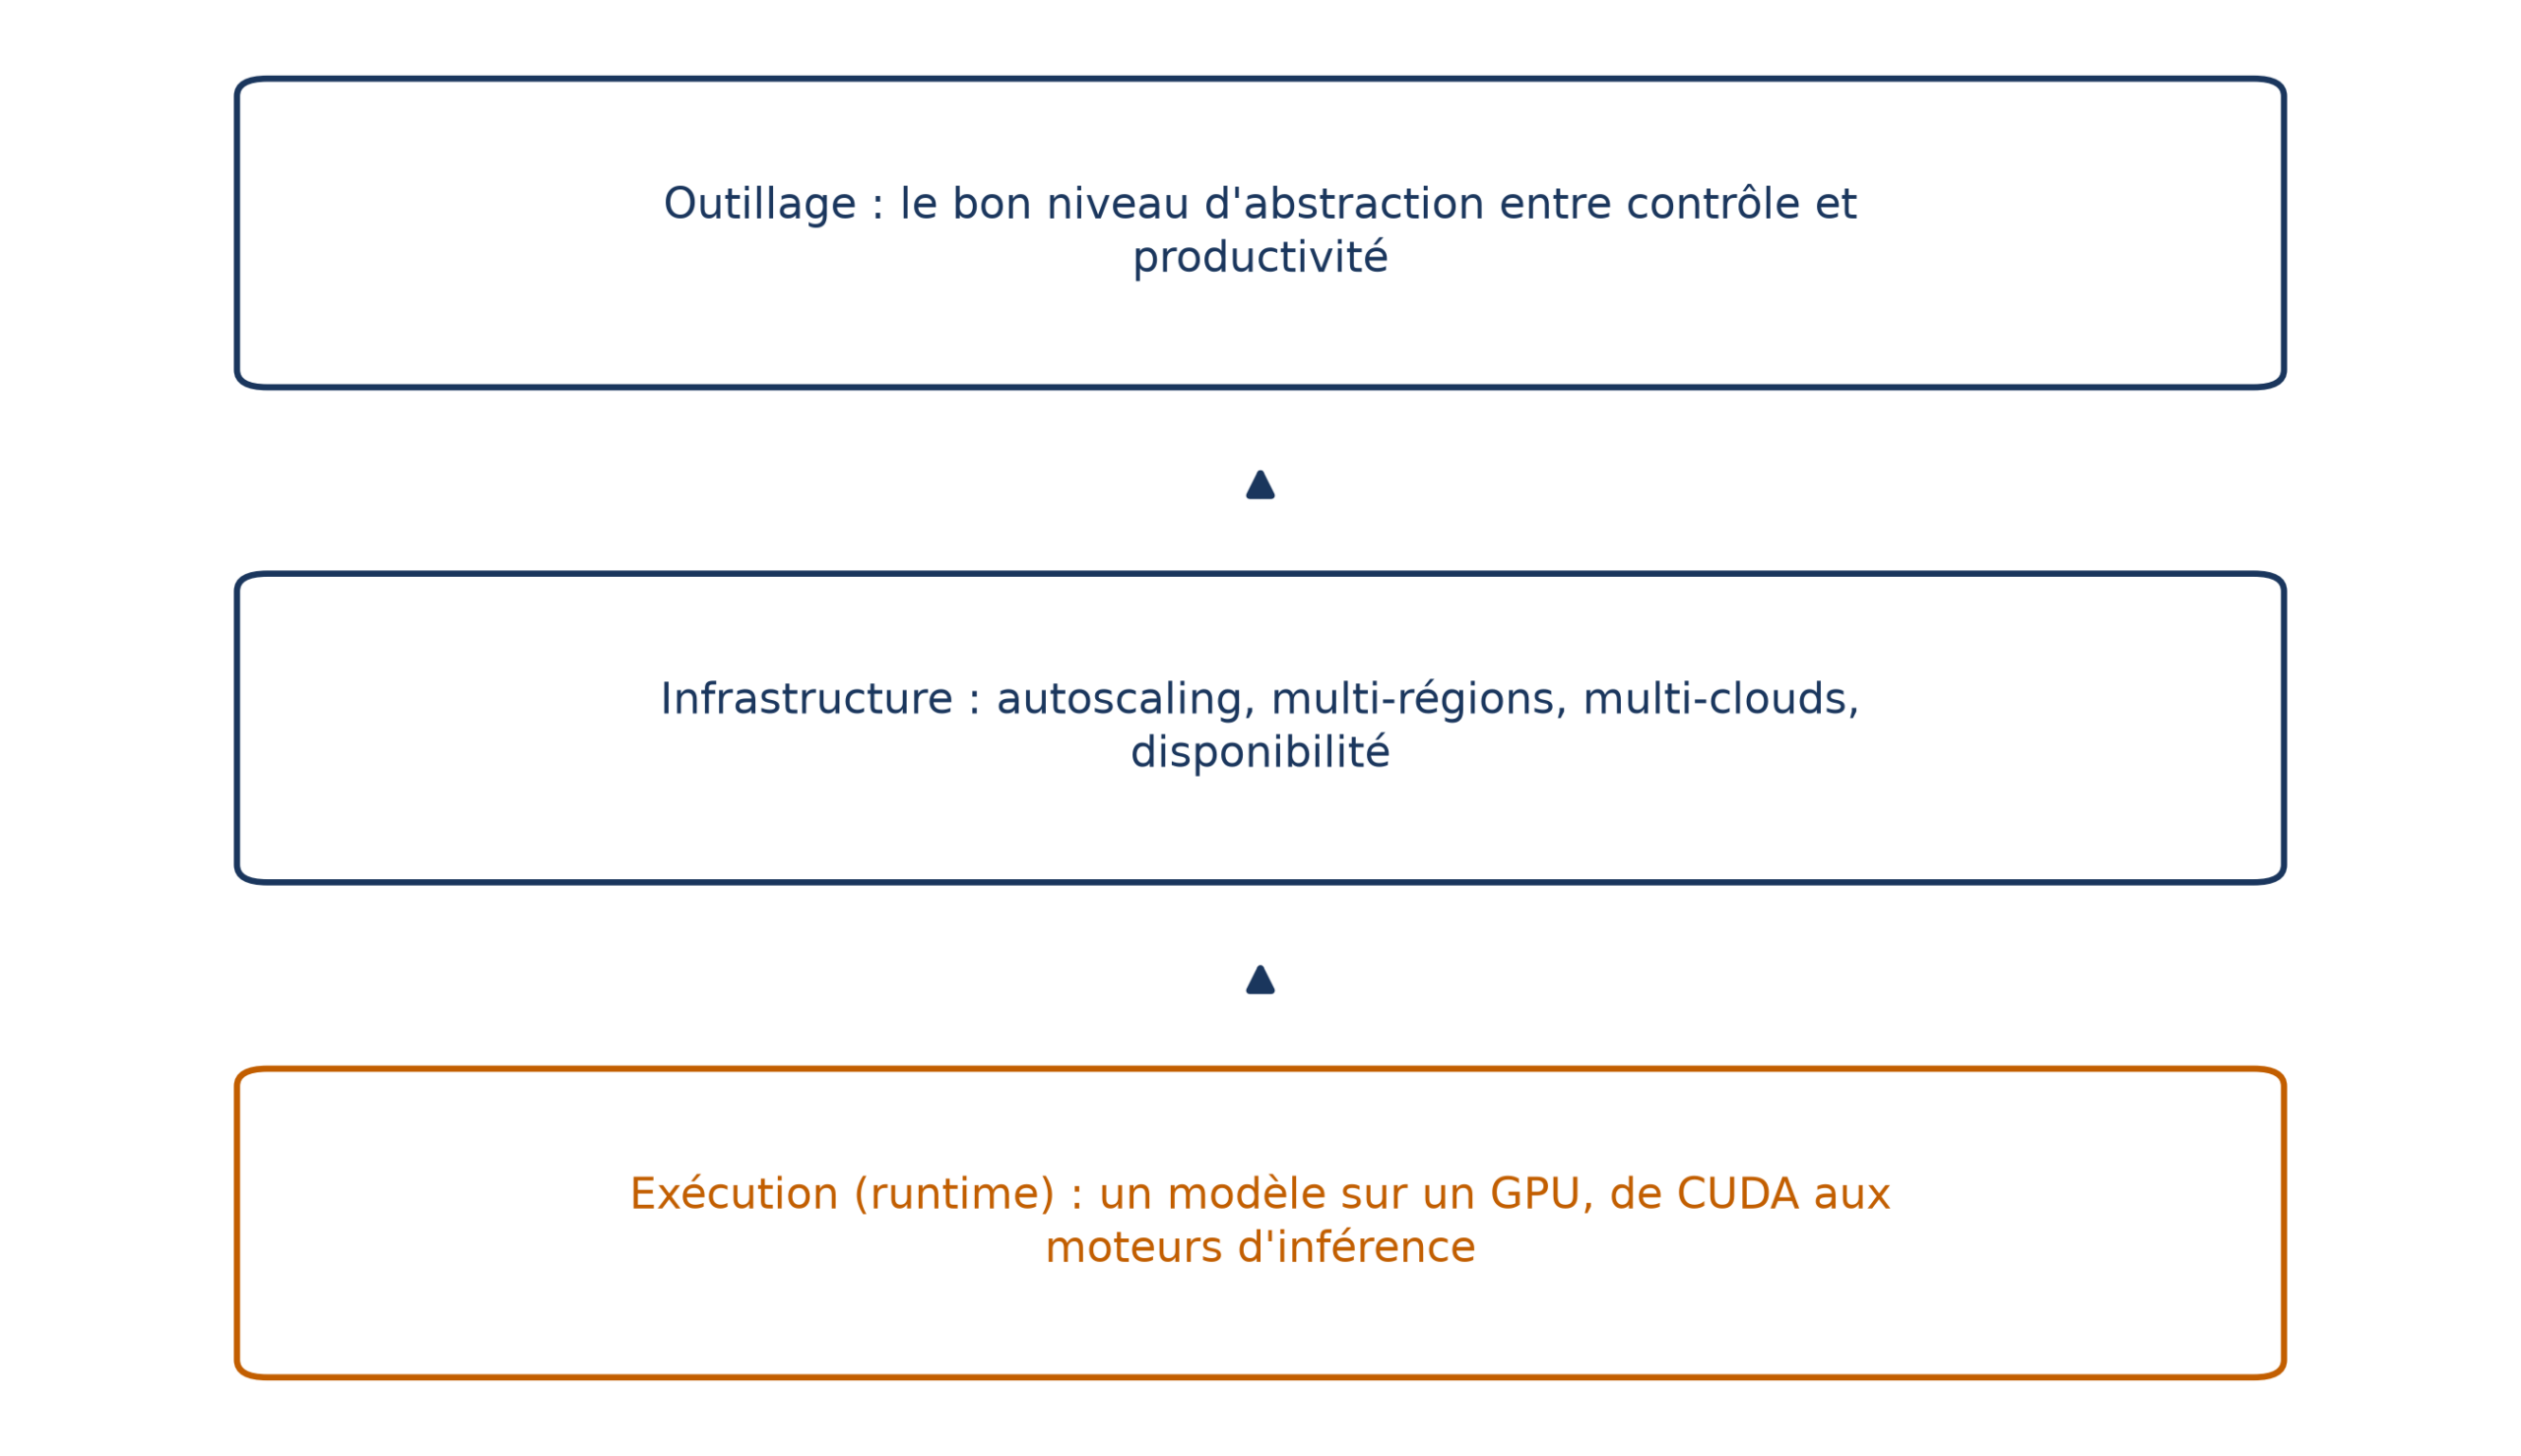
Un moteur d’inférence n’est qu’une des trois couches d’un service d’IA générative. L’exécution optimise un modèle sur une instance de GPU. L’infrastructure fait passer à l’échelle sur des clusters, des régions et des clouds tout en gardant une bonne disponibilité. L’outillage donne le bon niveau d’abstraction entre contrôle et productivité.
L’écart entre le temps passé sur le GPU et le temps ressenti se joue souvent chez le client, c’est-à-dire le navigateur, l’agent ou l’application qui envoie la requête. Établir une session avec le serveur prend quelques dizaines de millisecondes : avec un engagement de latence de bout en bout de 300 millisecondes au P95, une poignée de main TLS en consomme au moins dix pour cent avant même que l’inférence commence.
Les requêtes suivantes d’un même client doivent donc réutiliser la session. Les SDK courants comme celui d’OpenAI le font en silence, mais un client maison pour une modalité non standard doit y penser. Pour le temps réel, un autre protocole que HTTP, comme les WebSockets, peut aussi s’imposer pour garder une connexion continue.
Pour trancher, lis les métriques côte à côte. L’observabilité de l’inférence suit le volume de requêtes, la taille des entrées et des sorties, les codes de réponse (2XX, 4XX, 5XX), la latence en P50, P90 et P99, le nombre de réplicas, l’utilisation du CPU et du GPU, et la profondeur de file pour le trafic asynchrone. Ces courbes sont liées : un pic de latence peut venir du volume, mais aussi de séquences d’entrée plus longues, et les voir ensemble dit non seulement ce qui se passe, mais pourquoi.
La distinction entre temps d’inférence et mesure de bout en bout est posée dans « Optimiser un moteur d’inférence : les 6 techniques qui comptent » ; ici, on regarde ce qui se cache dans l’écart.
Essayer d’abord un modèle plus petit
L’article sur les six techniques le rappelle : le choix du modèle pèse plus lourd que n’importe quel réglage du moteur. Voici ce qui rend ce choix concret.
D’abord, mesure si le modèle sert à quelque chose. L’évaluation de modèle, la mesure systématique de son intelligence sur ton produit, évite de perdre du temps à accélérer un modèle inutile, et fournit une base de comparaison, puisque certaines techniques de performance dégradent la qualité. Les bancs d’essai généraux sont saturés, voire truqués, et la loi de Goodhart s’applique : quand une mesure devient une cible, elle cesse d’être une bonne mesure. Rien ne remplace la mesure directe sur ton application.
Ensuite, ne présume pas que le prix prédit la qualité. Sur MMLU, un banc d’essai général de connaissances, DeepSeek-v3 obtient 87,2 pour un prix relatif de 2,75 en entrée et 3,65 en sortie, alors que Claude 4 Opus en réflexion étendue obtient 86,5 pour 75 et 125. La référence à 1, c’est Llama 3.1 : 0,20 $ par million de tokens en entrée et 0,60 $ en sortie. Performance et prix ne sont donc pas directement corrélés, et ces scores ne font qu’orienter : seul un essai sur ta propre tâche tranche.
Enfin, regarde si un petit modèle affiné suffit. Si tu parviens à l’affiner jusqu’à ce qu’il réussisse tes évaluations, tes cibles de latence et de coût deviennent bien plus faciles à atteindre. Le cas extrême est la traduction de l’anglais vers SQL : un minuscule modèle affiné de quelques milliards de paramètres peut égaler, sur cette tâche, des modèles de code généralistes de plusieurs centaines de milliards. Tous les domaines n’autorisent pas une telle réduction ; il y faut un domaine bien délimité, de bons critères d’évaluation et de bonnes données étiquetées.
Les petits modèles progressent vite. Phi-3-mini (3,8 milliards de paramètres) a égalé les 60 % de MMLU de PaLM (540 milliards), soit une réduction de taille d’un facteur 142 en deux ans. Comme repère : sous huit milliards de paramètres, ils sont imbattables pour l’inférence sur appareil ou à bas coût ; de 8 à 70 milliards, ils offrent un bon compromis pour le raisonnement général ; au-delà, les géants propriétaires dominent encore l’exactitude à fort enjeu.
La distillation ouvre aussi un chemin. À côté de son R1 de 671 milliards de paramètres, DeepSeek a publié des versions distillées sur Llama 3 et Qwen 2.5 : leurs scores sont moins bons, leur raisonnement semblable, et leur petite taille leur permet de profiter du travail de performance déjà fait sur ces architectures.
⚠️ Piège Peaufiner à l’extrême la sélection du modèle ne rapporte souvent que des gains marginaux : sauf contrainte d’échelle, démarrer simplement suffit. Et la « meilleure » famille de petits modèles d’aujourd’hui sera peut-être éclipsée dans quelques mois : appuie-toi sur des classements tiers de confiance (HELM de Stanford, Papers With Code, Evaluation on the Hub).
Lire le symptôme pour savoir quelle ressource manque
Si ni la couche, ni le modèle ne sont en cause, il reste à savoir quelle ressource du GPU sature. Le principe (deux phases, l’une limitée par le calcul, l’autre par la mémoire) est expliqué dans l’article sur les six techniques ; voici seulement la correspondance entre ce que tu observes et ce qu’il faut regarder côté matériel.
| Ce que tu observes | Ressource en cause | Où agir côté matériel |
|---|---|---|
| Le premier mot tarde (TTFT élevé) | Le calcul : le prefill, la génération d’images et de vidéos y sont limités | L’accélérateur qui offre le plus de FLOPS |
| Les mots s’enchaînent lentement (TPS bas) | La bande passante mémoire, à tailles de lot faibles ou moyennes | L’accélérateur à plus forte bande passante, comme le H200 plutôt que le H100 |
| Erreur de mémoire insuffisante, inférence lente ou qui plante | La capacité de VRAM : poids du modèle plus au moins 50 % de marge pour le cache KV | Plus de VRAM, davantage de marge si contextes longs, gros lots ou vidéo |
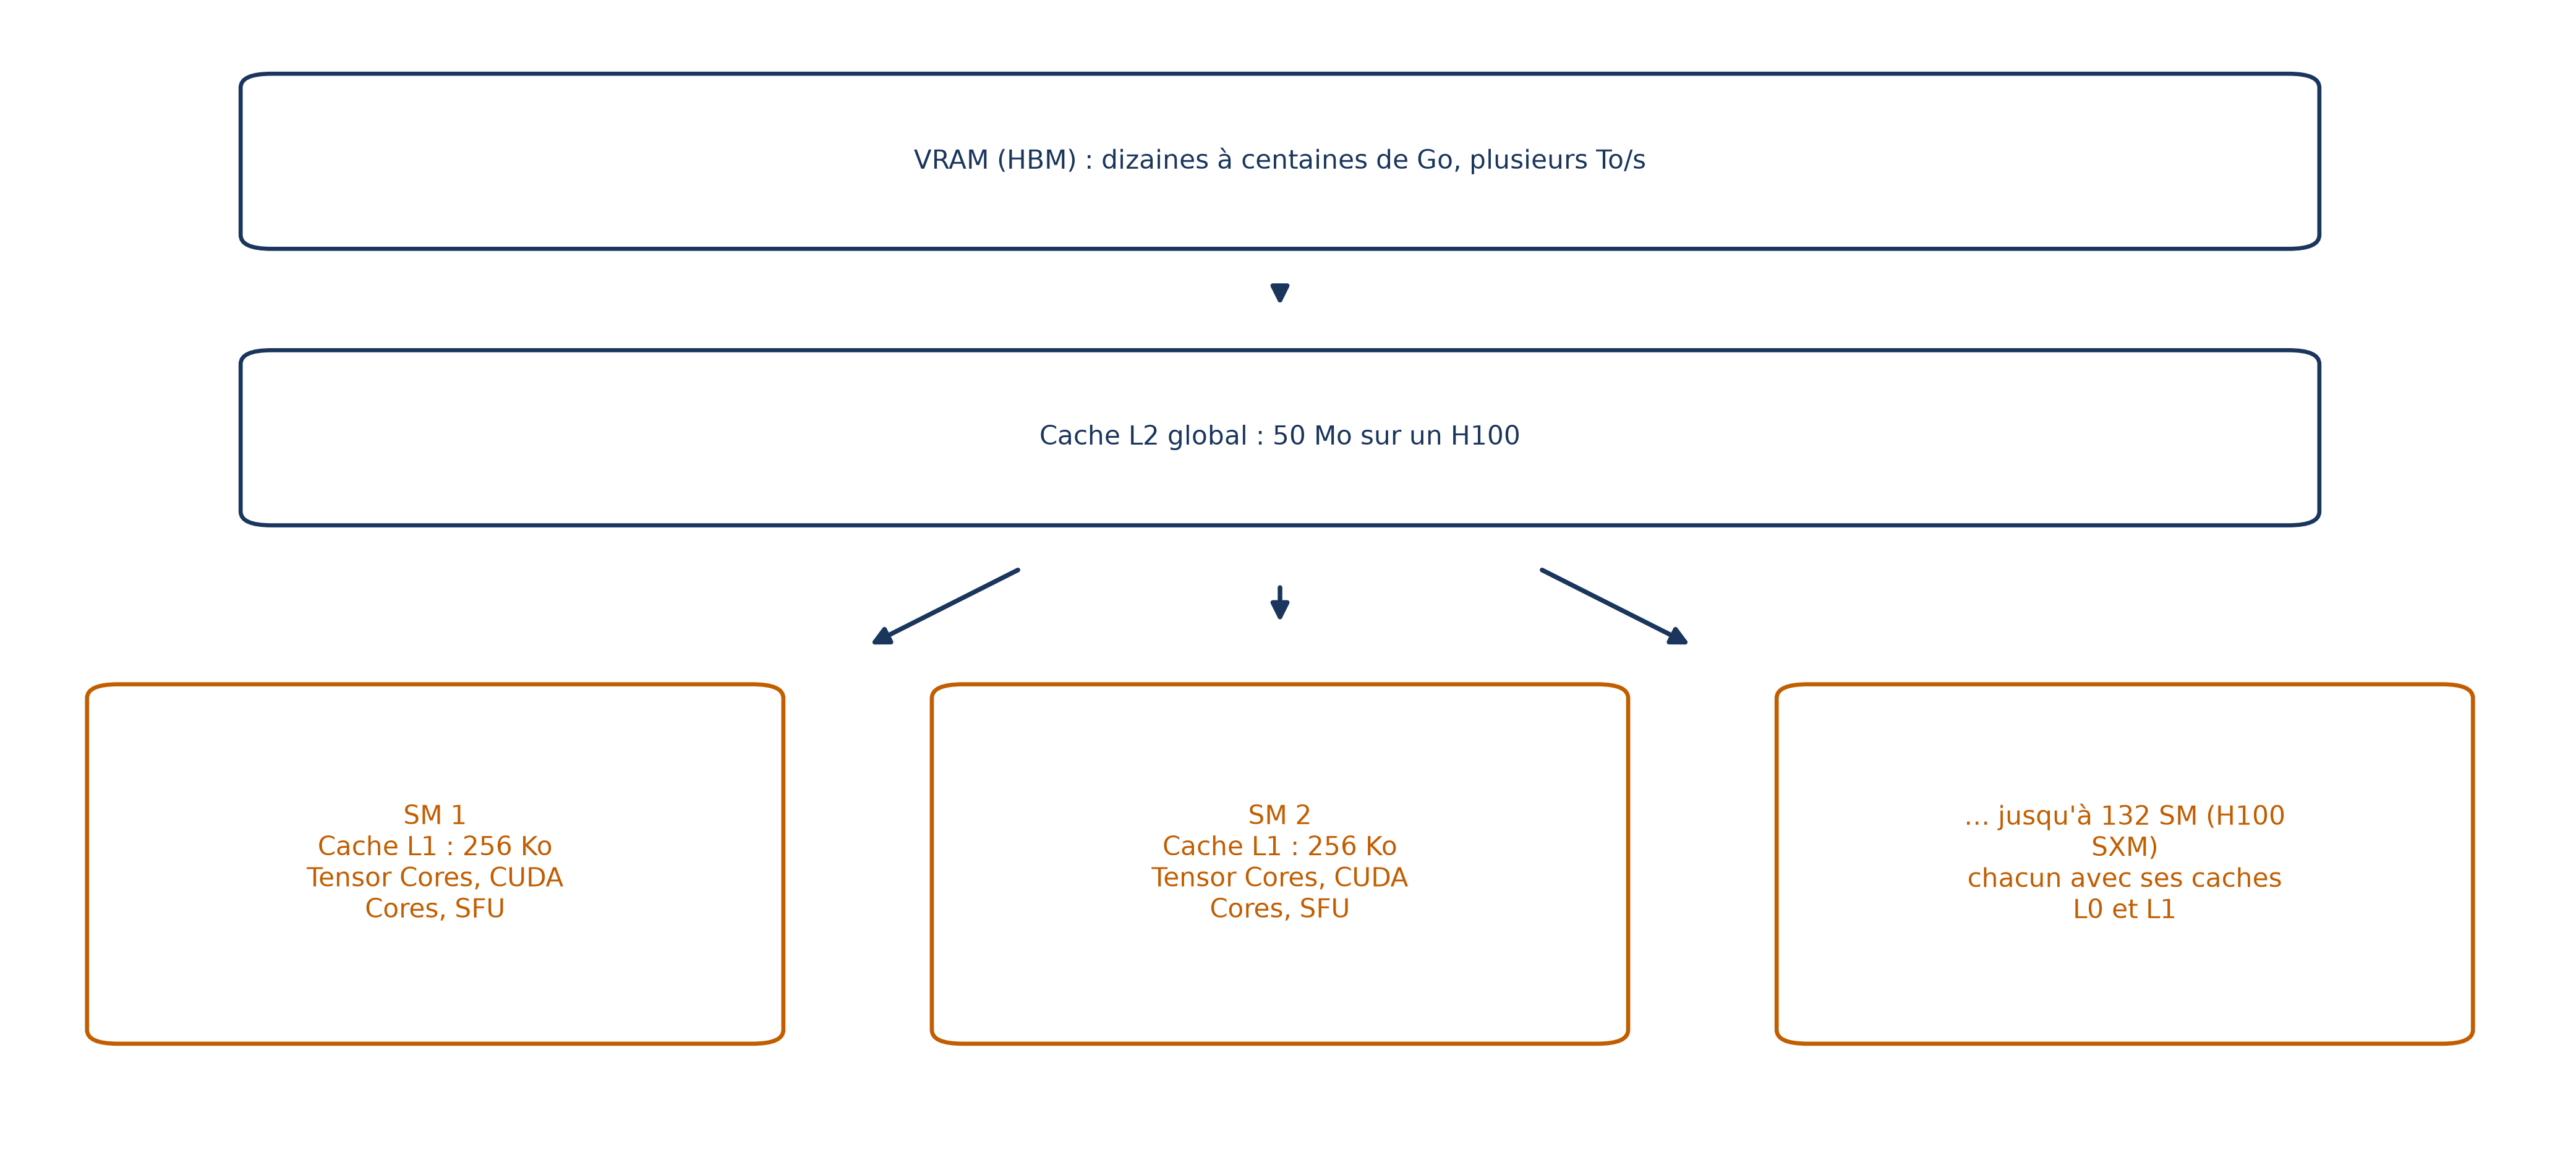
⚠️ Piège Quand tu compares des GPU sur FLOPS, lis les chiffres sans parcimonie : par défaut l’inférence est dense, et les FLOPS avec parcimonie valent souvent le double. Compare aussi à précision identique, car les FLOPS doublent généralement à chaque division par deux de la précision.
Quand le matériel est fixé et que le symptôme persiste, c’est alors que les techniques logicielles entrent en jeu : elles sont détaillées dans « Optimiser un moteur d’inférence : les 6 techniques qui comptent ».
Ce que coûte un essai, avant même le premier gain
Tester un service d’inférence est coûteux : il faut du temps d’ingénierie pour monter les tests et mesurer les résultats, et des GPU pour traiter le trafic de test. C’est en partie le prix à payer, mais on peut le réduire : un test en trafic fantôme (copie du trafic réel vers un déploiement de test) peut commencer par un échantillon aléatoire de la production, suivi d’un test de charge plus court. Garde en tête que l’usage des produits d’IA fluctue selon des cycles quotidiens et hebdomadaires.
Le meilleur banc d’essai double le trafic réel en production ; à défaut, il faut simuler l’usage en faisant correspondre quatre dimensions :
- les longueurs de séquence : le TTFT et l’usage mémoire dépendent du nombre de tokens du prompt et de la réponse ;
- le volume et le motif du trafic : le regroupement et la charge du serveur dépendent du nombre de requêtes simultanées, qu’il faut faire varier ;
- le contenu des requêtes : le prompt réel influe sur le taux de succès du cache et sur l’acceptation des tokens de brouillon ;
- les paramètres d’entrée : température, effort de raisonnement, à régler sur leurs valeurs de production.
⚠️ Piège Maximiser la performance d’un banc d’essai alimenté de mauvaises entrées ne produit pas la performance attendue en production. Un banc qui envoie des prompts sans rapport avec ceux de tes utilisateurs ne mesure ni le cache ni la spéculation tels que tu les vivras.
Côté outils, quelques noms reviennent : Genai-bench (équipe SGLang), GenAI-Perf (NVIDIA, côté client) et Locust, un outil libre de test de charge qui simule jusqu’à des millions d’utilisateurs simultanés. Les jeux d’évaluation libres, de MMLU et gsm8k à SWE-bench, fournissent des entrées variées et réalistes, et permettent de vérifier que les optimisations n’ont pas dégradé la qualité ; mieux vaut choisir celui qui épouse ton usage, comme HumanEval pour réduire la latence d’une complétion de code.
Pour que les chiffres se comparent, pars d’une base de référence solide, garde une configuration de test constante, envoie assez de trafic pour une lecture correcte et, dans le doute, relance plusieurs fois en moyennant.
Faut-il en plus un profileur, qui montre où chaque milliseconde est passée ? Probablement pas. Avec un moteur déjà très performant comme TensorRT-LLM, le travail est un cycle de configuration et d’évaluation. Le profilage devient nécessaire pour contribuer à un cadre comme vLLM ou SGLang, écrire son propre service en PyTorch ou travailler à la pointe d’une nouvelle modalité comme la vidéo.
Savoir s’arrêter
Quand la vitesse dépasse le besoin
Reviens à l’assistant vocal. Selon le modèle, il faut de 80 à 100 tokens par seconde pour générer de l’audio en temps réel ; au-delà, produire plus de tokens par seconde n’apporte rien. Une fois ce seuil franchi, la performance change de fonction : elle sert à augmenter le nombre de sorties temps réel simultanées. Si un seul GPU supporte beaucoup d’utilisateurs en même temps, le coût de synthèse par utilisateur chute spectaculairement.
Le gain suivant ne vient d’ailleurs plus du moteur. Pour la synthèse en temps réel, la couche d’exécution est déjà optimisée (TensorRT-LLM, quantification, décodeur compilé), et ce qui reste à gagner tient surtout à l’infrastructure : le flux par WebSocket est le plus grand déblocage face à l’envoi de texte et à la réception d’audio par morceaux distincts. On teste combien de flux simultanés le moteur tient, puis on fixe la taille de lot et le nombre de WebSocket actifs pour une utilisation élevée mais stable.
Quand la qualité décroche
Pour toute optimisation qui touche au modèle, le critère de sortie est la qualité. Une quantification n’est prête pour la production que si l’on ne perçoit aucune perte de qualité : l’écart de score avec l’original doit être indiscernable du bruit, puisque les LLM sont non déterministes et que les scores varient légèrement d’une exécution à l’autre.
Au-delà de ce bruit, l’optimisation a dépassé son but, même si les courbes de latence sont superbes.
Ce qui doit te faire rouvrir le chantier
Une fois la cible atteinte, ce sont tes métriques qui disent quand reprendre. Un P90 qui franchit la cible fixée au départ, une file qui ne se vide plus ou un pic de latence qui suit la longueur des entrées sont autant de déclencheurs. Branche-les sur tes outils d’alerte existants, comme Grafana, Datadog, PagerDuty ou Sentry, pour lire l’information d’inférence avec le reste de l’application.
Deux autres déclencheurs viennent de l’extérieur du système. Le premier est le rythme de l’usage : parce qu’il suit des cycles quotidiens et hebdomadaires, un test réalisé sur une seule plage horaire risque de ne pas représenter le reste. Le second est le paysage des modèles, qui bouge en quelques mois : le chantier de demain sera peut-être de passer à un modèle plus petit, plus simple à servir que celui d’aujourd’hui.
📌 À retenir Un moteur ne s’optimise pas parce qu’il pourrait aller plus vite, mais parce qu’une mesure sort d’une cible écrite à l’avance. Le chantier se termine quand la cible est tenue, que la qualité est intacte et que la surveillance reste silencieuse.