Une courbe qui monte, redescend, puis remonte ne se résume pas à une seule droite. Tu voudrais pourtant la suivre sans deviner sa forme à l’avance. La régression locale répond à ce besoin : elle ne cherche pas une équation valable partout, mais une estimation fiable près de l’endroit où tu te trouves.
Sommaire
- L’essentiel en 30 secondes
- Une courbe que la droite ne suit pas
- Refaire un petit ajustement à chaque point
- Le seul bouton : la taille du voisinage
- Un cousin lissé : les splines de lissage
- Ce qu’elle n’est pas
L’essentiel en 30 secondes
- Un petit ajustement par point : pour chaque valeur à prédire, on ajuste un modèle simple sur les observations voisines.
- Des poids selon la distance : les points proches comptent beaucoup, les points lointains presque rien.
- Un réglage principal : la largeur du voisinage, qui décide de la souplesse de la courbe.
- Aucune forme imposée : la courbe finale est lisse sans être forcément une droite ou une parabole.
- Un cousin des splines de lissage : même compromis entre fidélité et régularité, avec un autre réglage.
Une courbe que la droite ne suit pas
Une régression linéaire impose sa forme dès le départ. Si la vraie relation n’est pas une droite, l’estimation commet forcément une erreur systématique, appelée biais.
C’est là qu’intervient la régression locale : au lieu d’un modèle unique pour tout le nuage, elle en construit un par point.
Refaire un petit ajustement à chaque point
Pour estimer la valeur attendue en un point donné, on ne regarde que les observations qui l’entourent. On y ajuste une droite, ou un polynôme de bas degré, et les points les plus proches reçoivent le plus de poids.
Puis on recommence pour le point suivant. Chacun de ces petits ajustements n’est fiable que près de son point, mais, mis bout à bout, ils forment une courbe lisse.
💡 Intuition Imagine une loupe qui glisse le long de la courbe. À chaque position, elle ne montre qu’un petit morceau ; la suite des morceaux redessine le tracé complet.
Le seul bouton : la taille du voisinage
Le paramètre qui compte s’appelle la portée (span) : il fixe la largeur du voisinage. Un voisinage étroit colle aux points et donne une courbe très flexible, mais bruitée, qui suit les accidents du hasard. Un voisinage large lisse la courbe, mais la rend peut-être trop rigide pour capter les vraies variations.
Ce réglage obéit au compromis qui traverse toute la statistique. Plus une méthode est flexible, plus sa variance augmente, c’est-à-dire plus l’ajustement change si on lui donne d’autres données ; en revanche son biais diminue. Le bon réglage est celui qui rend l’erreur de test la plus basse.
Un cousin lissé : les splines de lissage
Les splines de lissage visent le même objectif par une autre voie. Au lieu de découper un voisinage, elles pénalisent la courbure de la fonction. Le réglage devient un paramètre continu, noté λ : à λ = 0, la courbe passe par chaque point ; quand λ grandit sans limite, elle se réduit à la droite des moindres carrés.
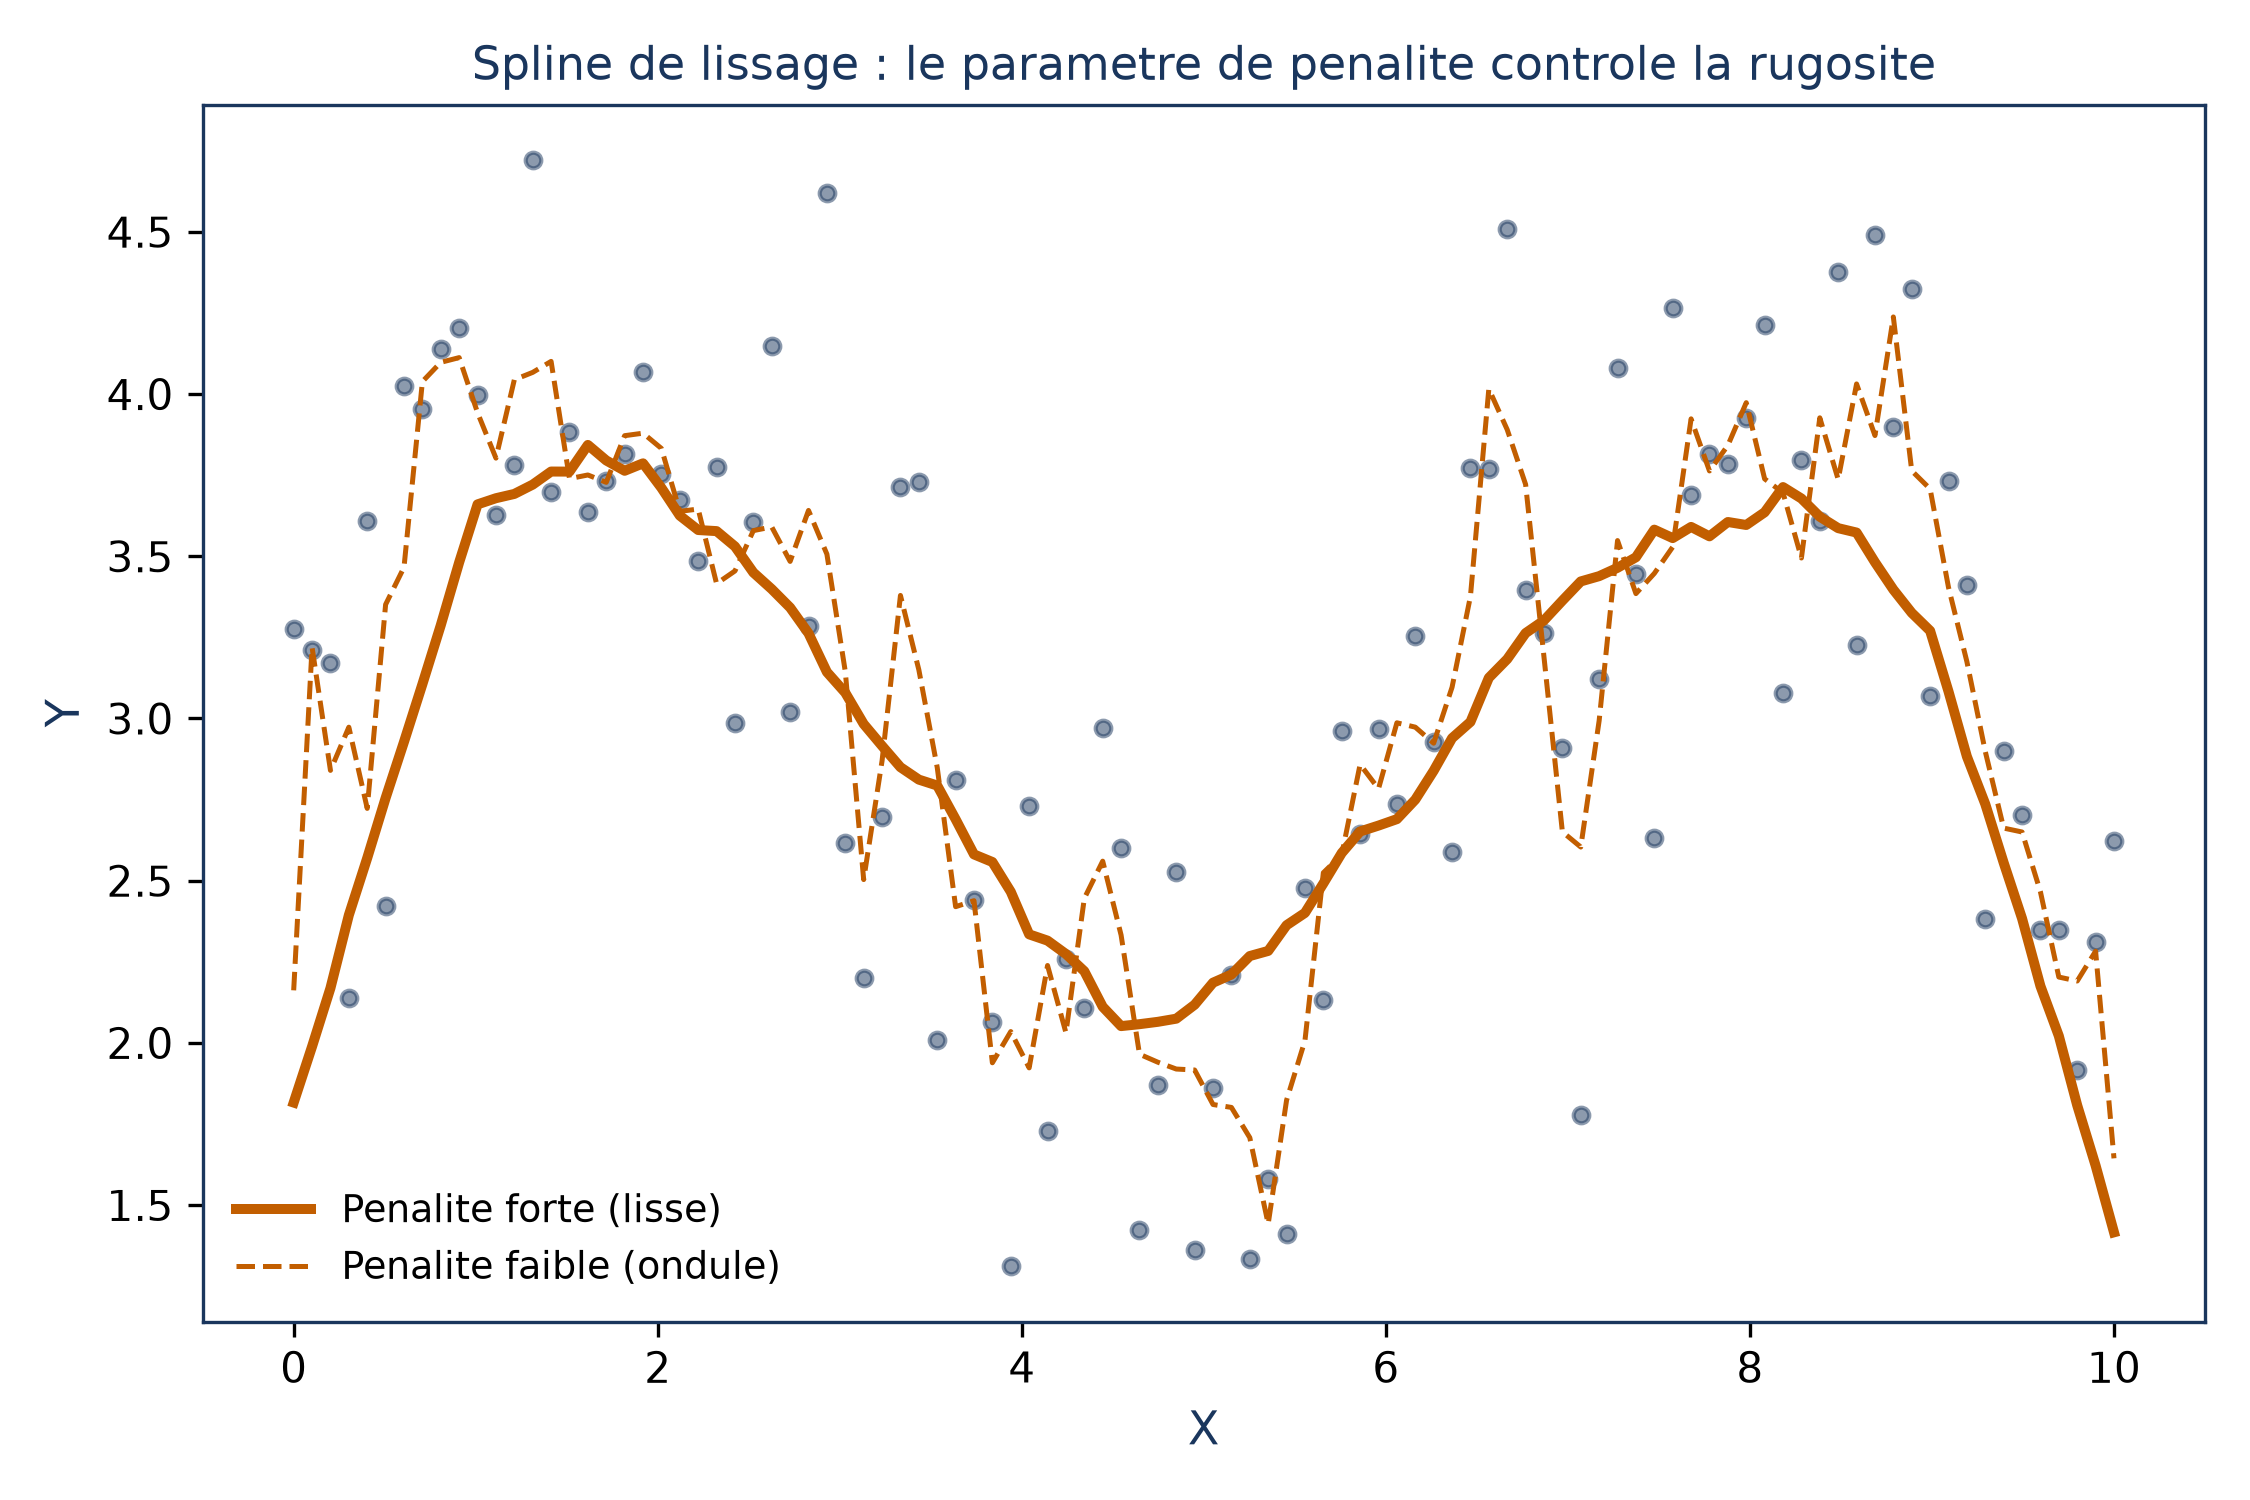
La flexibilité effective se mesure alors par un nombre de degrés de liberté qui varie de façon continue entre n et 2. La portée de la régression locale joue le même rôle que λ : dans les deux cas, un seul curseur règle le compromis entre suivre les données et rester lisse.
Ce qu’elle n’est pas
Attention à l’image trompeuse : la régression locale n’est pas une simple moyenne glissante. À chaque point, la pente compte autant que le niveau, ce qui lui permet de suivre une tendance qui monte ou descend localement.