Une image de 28 × 28 pixels, la position des pièces sur un échiquier, un graphe de nœuds et de liens : trois objets sans aucun rapport, et pourtant la même famille de machines sait les lire. Pour la reconnaître, tu n’as pas besoin de connaître son architecture sur le bout des doigts. Il suffit de regarder ce qui entre et ce qui sort. Tu vas prendre ce réflexe, puis lire la dernière couche d’un réseau comme un cahier des charges.
Sommaire
- L’essentiel en 30 secondes
- Tout ce qui entre est un tenseur
- De 784 valeurs à 10 sorties : un réseau en quelques lignes
- Ce que le réseau doit rendre décide de sa dernière couche
- Quand l’entrée est un graphe, pas une grille
- Le point commun : des poids que le gradient règle
L’essentiel en 30 secondes
- Un réseau de neurones est une machine qui prend un tenseur et en rend un autre : une liste de nombres, une grille, ou leurs variantes à plus de dimensions.
- Ses neurones sont rangés en couches, et chacun pondère ses entrées avant de les passer dans une fonction d’activation.
- Ce que le réseau doit produire fixe sa dernière couche : dix scores, une probabilité par action, une valeur par action.
- Quand les données forment un graphe plutôt qu’une grille, un réseau de graphes fait dialoguer chaque nœud avec ses voisins.
- Quelle que soit la forme, la recette de réglage est la même : des poids ajustés par le gradient.
Tout ce qui entre est un tenseur
Prends la position des pièces sur un échiquier : on la décrit par une matrice, c’est-à-dire une grille de nombres. Les actions que l’on peut jouer se représentent elles aussi par un tenseur. Ce mot regroupe les cas que tu rencontres tout le temps : un vecteur est une liste de nombres, une matrice une grille de nombres, et le tenseur en est la forme générale.
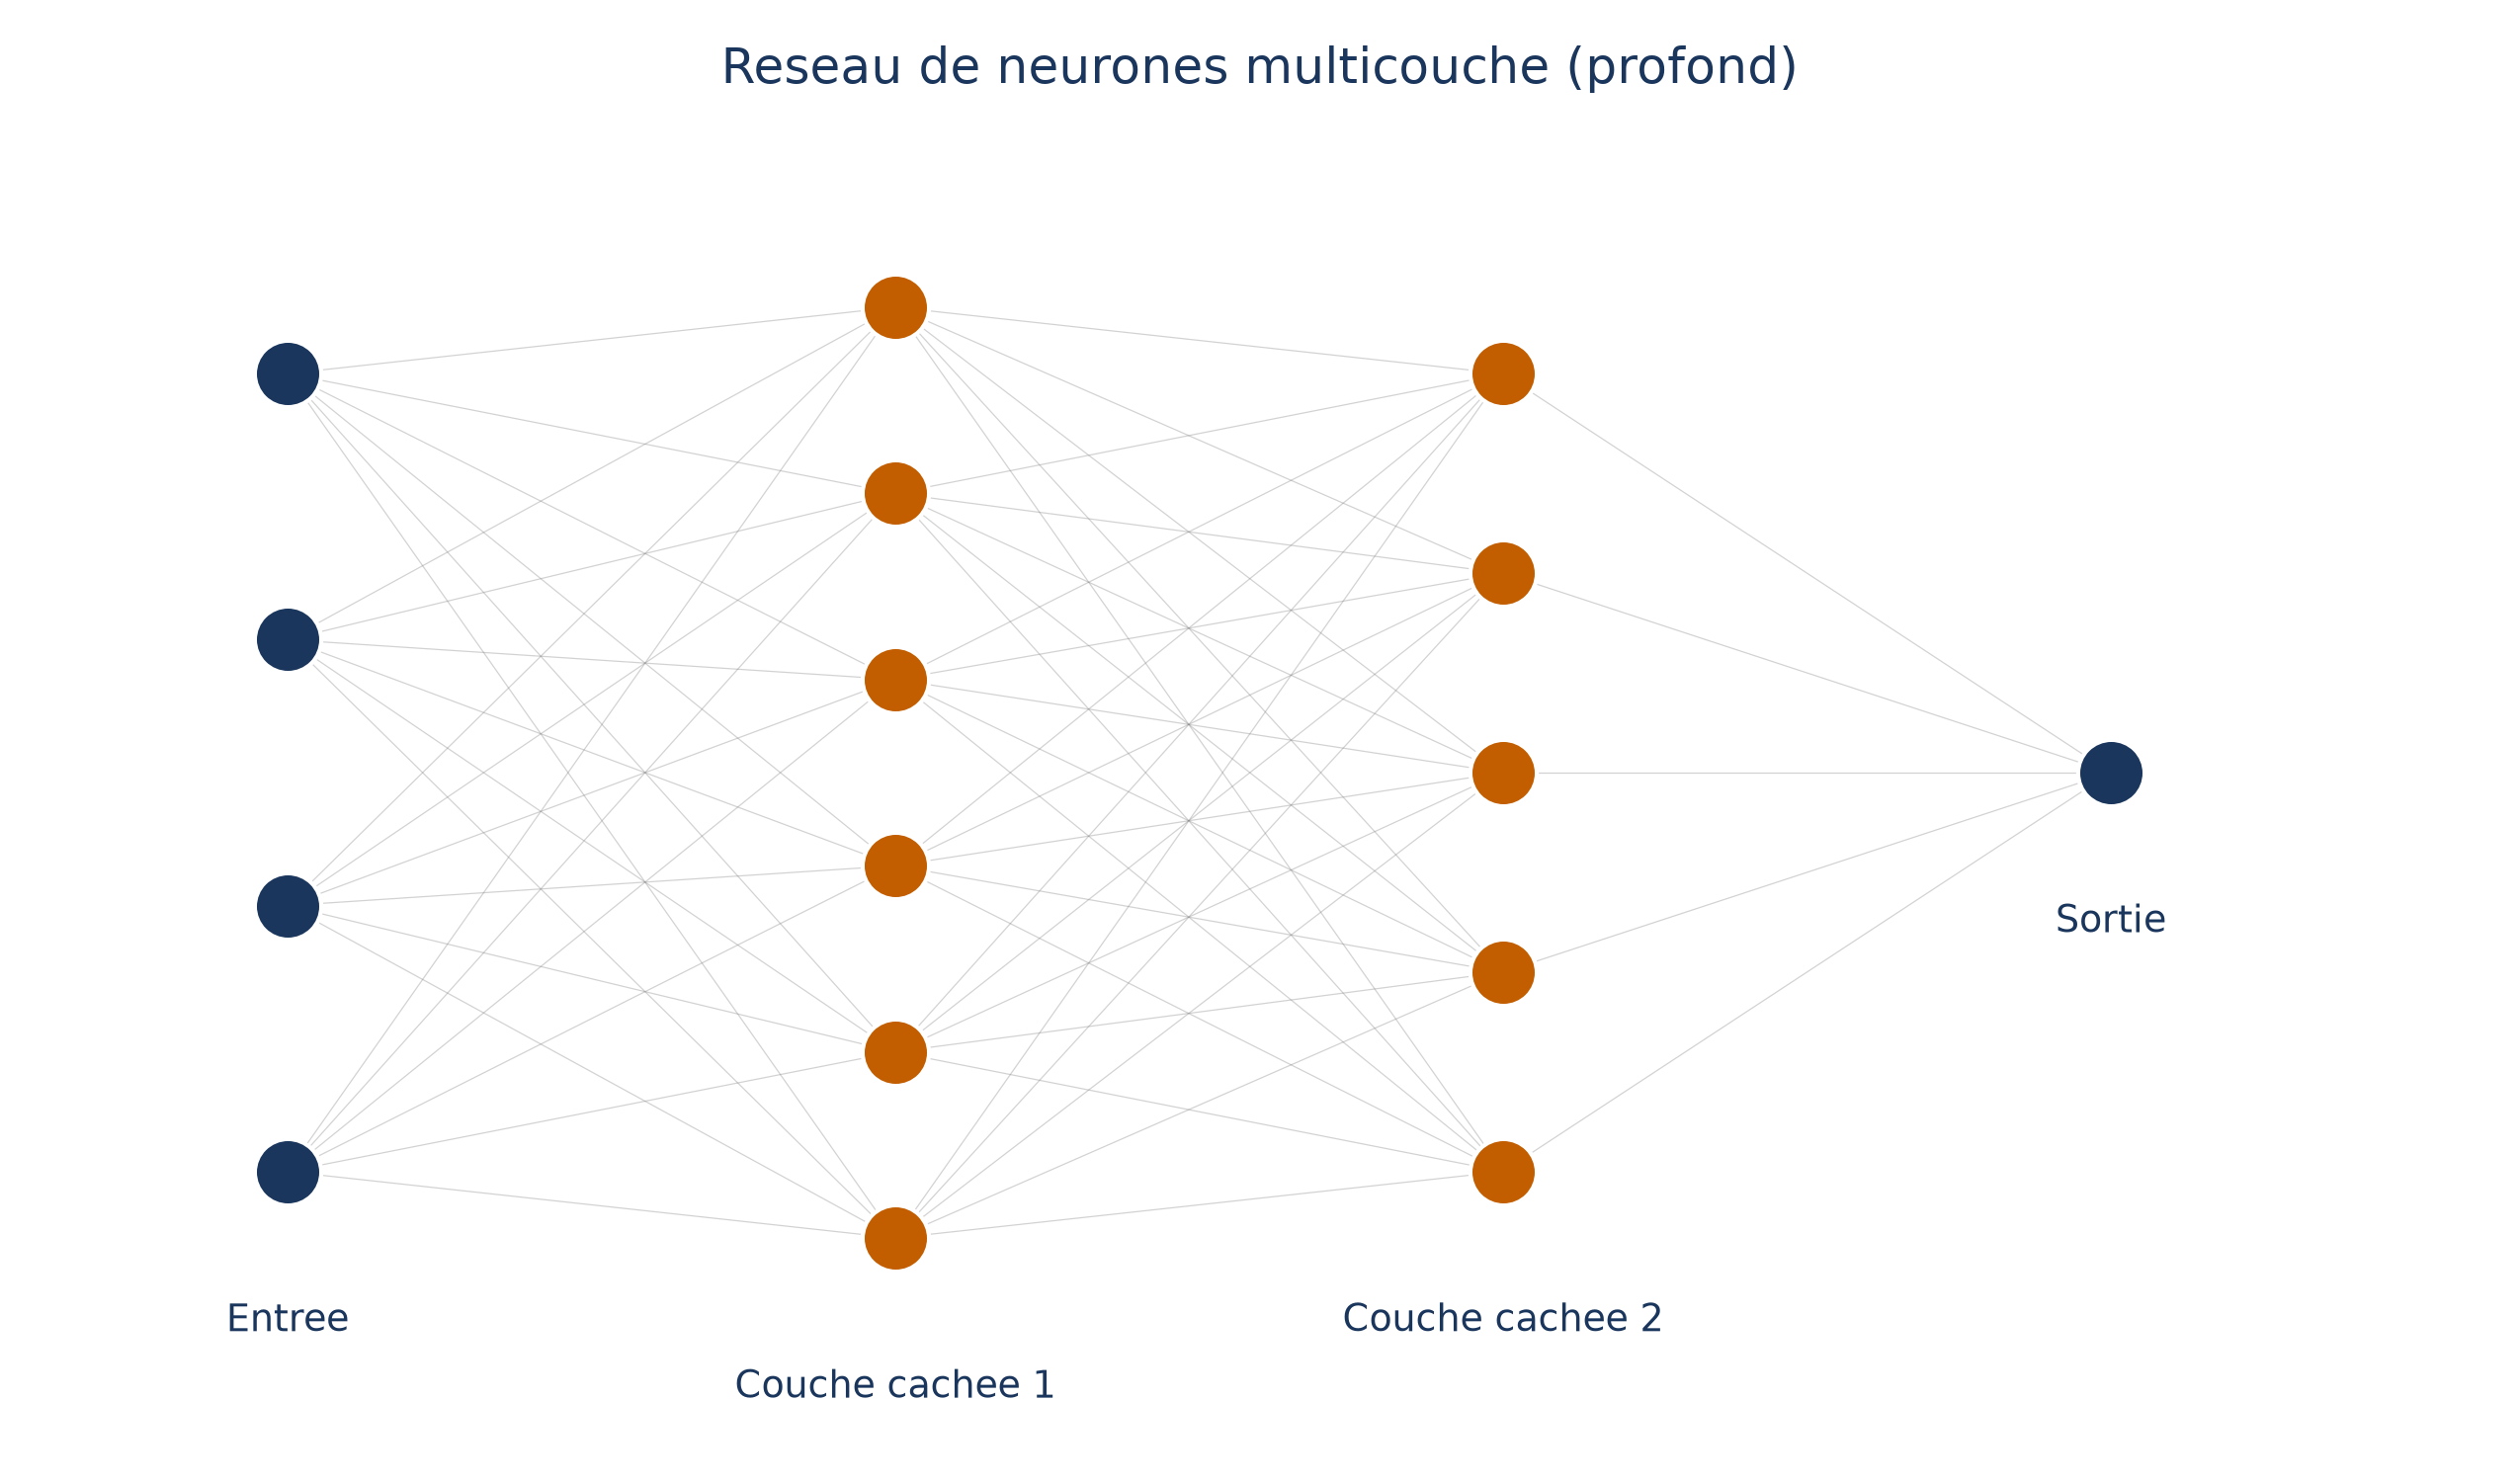
Ces structures sont courantes en apprentissage automatique, et c’est ce que l’on donne en entrée à un modèle d’apprentissage profond. Le réseau de neurones lui-même se compose de neurones organisés en couches : il prend un tenseur en entrée et produit un tenseur en sortie.
Chaque neurone pondère ses entrées, les additionne, puis fait passer la somme dans une fonction d’activation. Voilà la brique de base, et tout le reste n’est qu’une affaire d’assemblage.
💡 Intuition Un réseau de neurones ressemble à une prise normalisée : pour le brancher, ce qui compte est la forme de la fiche d’entrée et celle de la fiche de sortie. L’intérieur vient après.
De 784 valeurs à 10 sorties : un réseau en quelques lignes
PyTorch est un paquet Python qui décrit des opérations sur des tenseurs. C’est la technologie standard de l’industrie pour entraîner comme pour faire tourner les modèles génératifs, et il sait entraîner tout type de réseau de neurones. Sa documentation en montre un exemple de base, que voici (l’extrait suppose que le module torch.nn a été importé sous le nom nn) :
class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.flatten = nn.Flatten()
        self.linear_relu_stack = nn.Sequential(
            nn.Linear(28*28, 512),
            nn.ReLU(),
            nn.Linear(512, 512),
            nn.ReLU(),
            nn.Linear(512, 10),
        )

    def forward(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
Lis-le en commençant par ses deux extrémités. À l’entrée, nn.Linear(28*28, 512) attend 28 × 28 = 784 valeurs, ce qui correspond à une image de 28 × 28 pixels : le nom nn.Flatten() dit ce qu’il fait, il aplatit l’image en une seule liste. À la sortie, nn.Linear(512, 10) rend dix nombres, que le code appelle logits.
Entre les deux, deux couches de 512 neurones séparées par des nn.ReLU() : ce sont les couches linéaires et les activations qui forment les pièces essentielles d’un réseau. La méthode forward décrit le trajet complet, qui consiste à aplatir l’entrée, à la faire traverser la pile, puis à renvoyer les dix sorties.
L’exemple est très simple, mais il contient déjà la forme de tout réseau : tenseur fixe en entrée, tenseur fixe en sortie. Reste à savoir ce que ce dernier tenseur doit contenir.
Ce que le réseau doit rendre décide de sa dernière couche
Les dix nombres du code précédent sont des scores, mais rien n’oblige un réseau à en rendre dix. Sa dernière couche épouse la tâche. Reprends l’échiquier du début : un agent qui joue reçoit l’état de la partie, c’est-à-dire la position des pièces, et doit choisir une action. Deux réseaux peuvent répondre à cette même entrée, avec deux sorties différentes.
Une probabilité par action
Le premier réseau prend l’état courant en entrée et produit une distribution de probabilité sur toutes les actions possibles. On l’appelle une politique stochastique, parce qu’il ne rend pas directement une action mais des probabilités.
Au départ, ses poids sont aléatoires, donc les actions le sont aussi. On laisse alors l’agent jouer en tirant chaque action dans la distribution rendue, ce qui produit une trajectoire, c’est-à-dire la suite des états et des actions. Si elle rapporte de fortes récompenses, on modifie les poids pour la rendre plus probable ; si l’agent se comporte mal, la mise à jour vise à la rendre moins probable.
⚠️ Piège Une probabilité par action n’est pas une action. Il reste à en tirer une dans la distribution, et c’est ce tirage qui rend la politique stochastique.
Apprendre directement une politique convient aux espaces d’actions continus, alors qu’un réseau qui rendrait une valeur par action, comme le suivant, s’y prête beaucoup moins bien.
Une valeur par action
Le second réseau reçoit le même état mais rend autre chose. Pour le comprendre, pars de la table du Q-learning : une ligne par état, une colonne par action, et dans chaque cellule la récompense future espérée si l’agent mène cette action depuis cet état puis suit la meilleure stratégie. Dans les environnements complexes, cette table devient impraticable à cause de sa taille potentiellement massive et de son coût de calcul.
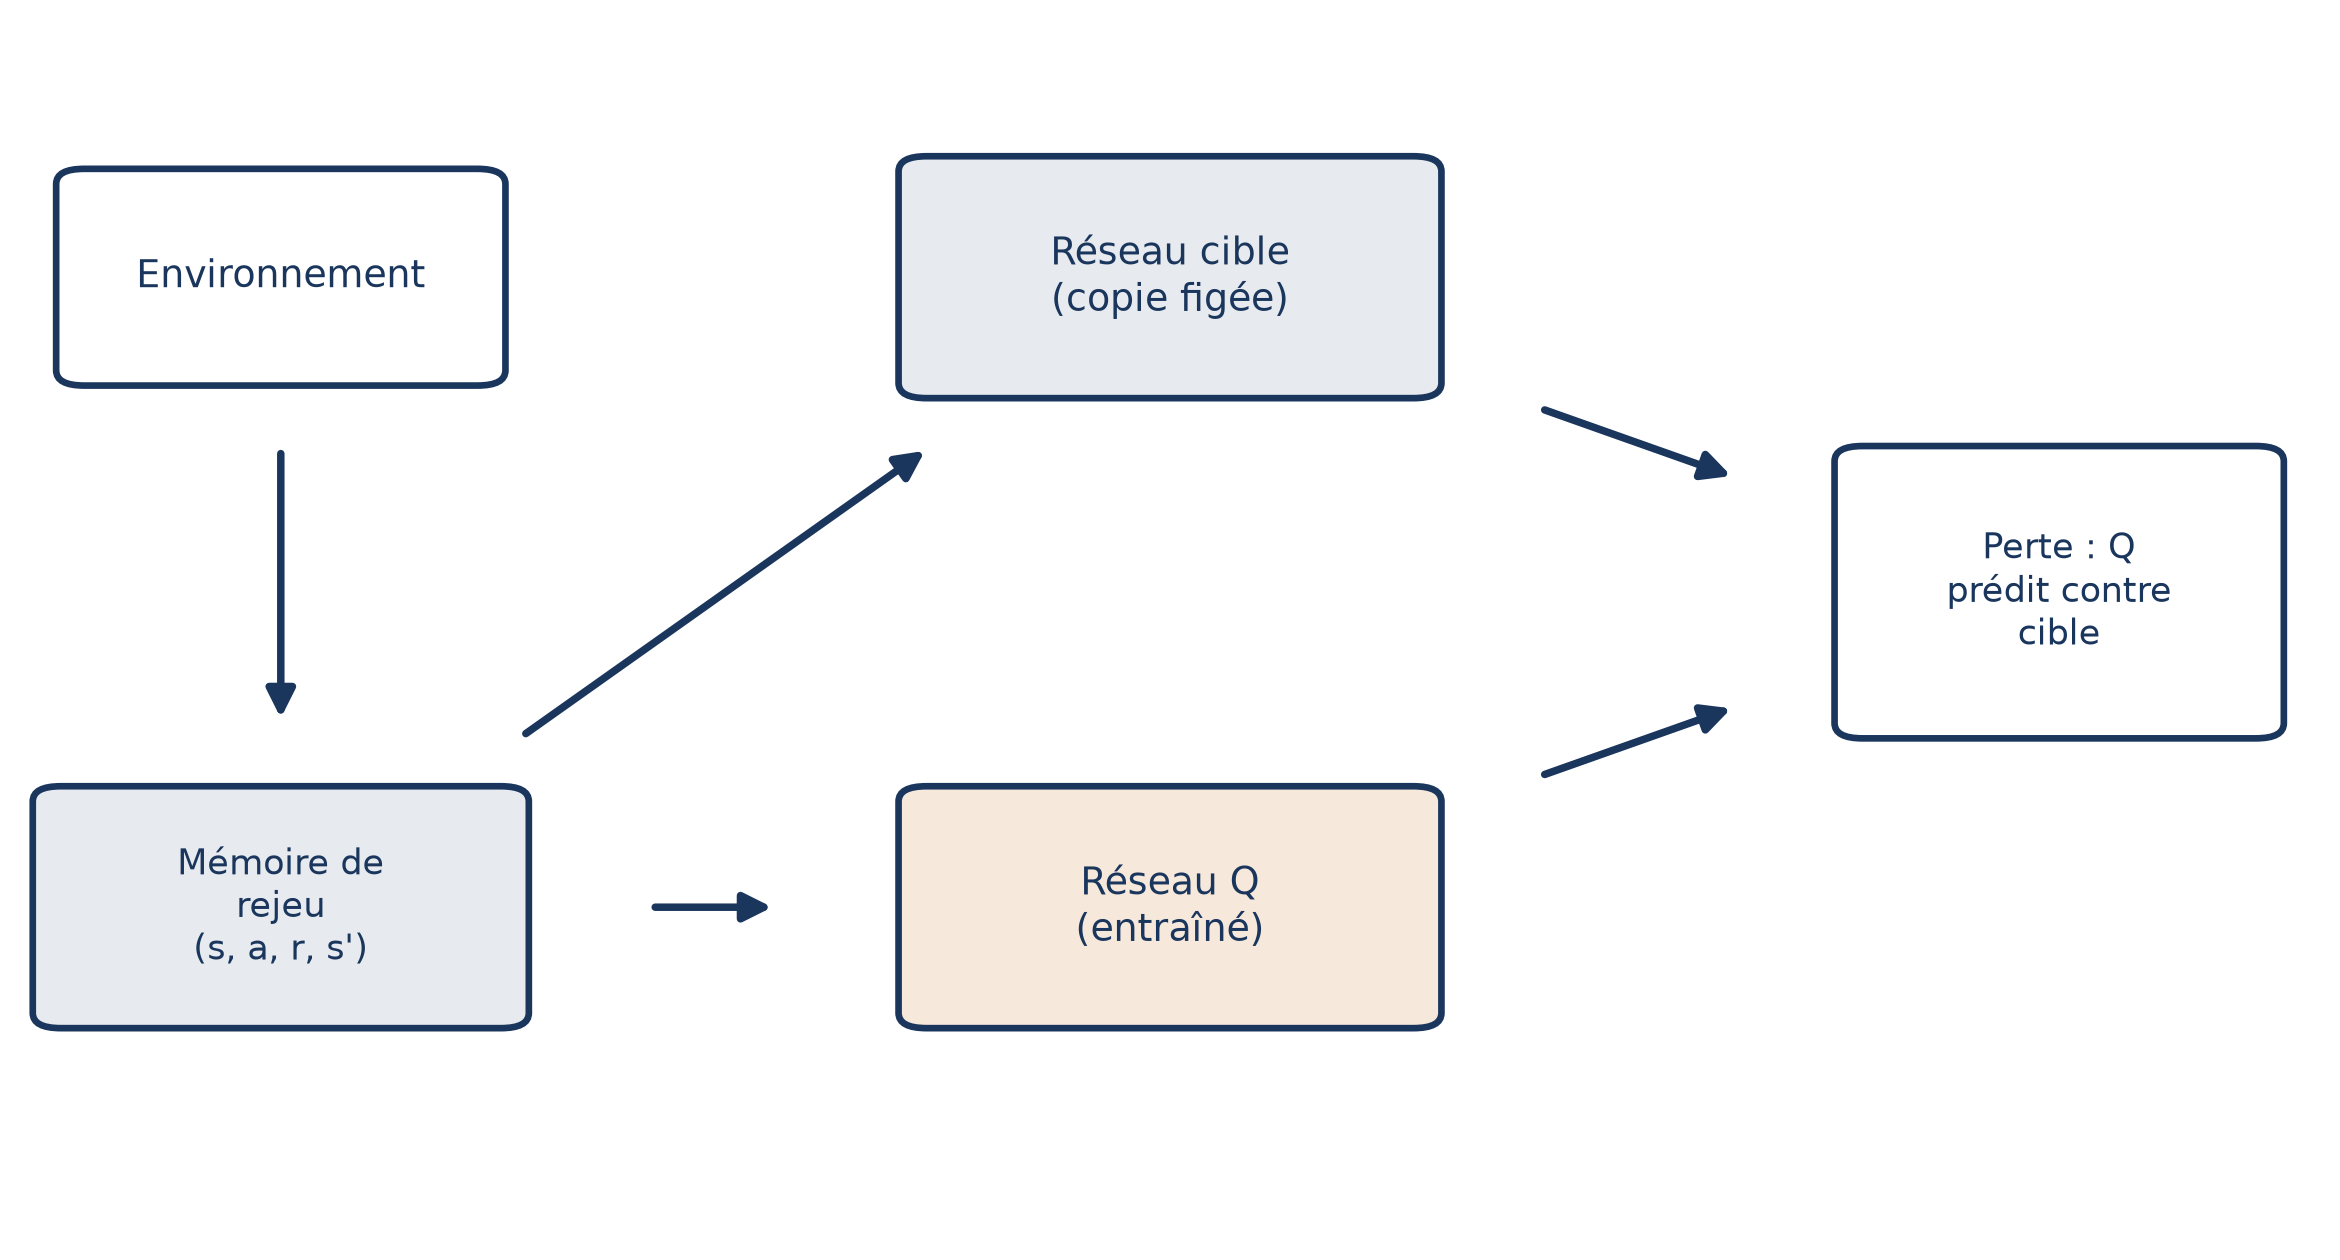
On la remplace donc par un réseau : on lui donne l’état en entrée, et il fournit en sortie la valeur de chaque action possible depuis cet état. Ce réseau Q ne travaille pas seul dans le DQN, l’algorithme utilisé par DeepMind pour entraîner un agent à résoudre des jeux vidéo. Il a deux compagnons :
- la mémoire de rejeu range chaque expérience (état, action, récompense, état suivant) ; à l’entraînement, on y tire des lots au hasard, mélange d’anciennes et de nouvelles expériences, ce qui casse la corrélation entre expériences consécutives et réutilise le passé ;
- le réseau cible est une copie du réseau Q qui fournit les valeurs à atteindre ; toutes les quelques milliers d’étapes, on remplace ses poids par ceux du réseau Q, ce qui stabilise l’entraînement.
À chaque entraînement, le réseau Q prédit la valeur des actions pour un état et le réseau cible prédit la valeur cible ; l’écart entre les deux, avec la récompense observée, donne la perte qui règle le réseau Q.
Ce montage sait extraire seul les caractéristiques d’espaces de grande dimension comme les images : il a ainsi maîtrisé des jeux Atari à partir de pixels bruts. Il a ses limites : il demande beaucoup d’échantillons, reste sensible au choix des hyperparamètres, et se montre instable avec des actions continues, alors qu’il se comporte bien sur des actions en nombre fini.
Quand l’entrée est un graphe, pas une grille
Les modèles classiques attendent des données rectangulaires ou en grille. Un graphe n’entre pas dans cette case, et pour une tâche on voudrait pourtant exploiter à la fois ses nœuds, ses arêtes, son contexte global et sa connectivité.
La connectivité est la plus difficile à représenter. On emploie d’ordinaire une matrice d’adjacence, qui grossit beaucoup avec le nombre de nœuds et se révèle peu efficace en espace. Pire, un graphe n’ayant pas d’ordre, plusieurs matrices différentes disent la même chose, sans qu’un modèle sache forcément les reconnaître comme identiques.
Un réseau de neurones de graphes (GNN) prend le graphe tel quel et exploite sa structure pendant l’apprentissage. Son principe est le passage de messages : à chaque pas, chaque nœud collecte les représentations de ses voisins, applique une fonction d’agrégation (elle varie selon les architectures), puis une non-linéarité. Pour une version courante, la règle de mise à jour s’écrit :
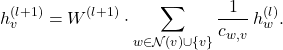
Lis-la de la droite vers la gauche.  est la représentation du nœud
 à la couche
 ; on additionne celles des voisins de
 (l’ensemble
 ) et celle de lui-même, chacune divisée par un coefficient de normalisation
 . Le total est multiplié par une matrice de poids
 partagée, ce qui donne la nouvelle représentation
 du nœud. La non-linéarité s’applique ensuite.
Un GNN classique enchaîne plusieurs blocs de ce type, puis une couche finale qui exploite la représentation apprise pour la tâche. Il a un avantage : tout en s’entraînant sur sa tâche, il apprend un embedding pour chaque nœud. L’entrée est un graphe, la sortie une représentation par nœud, et c’est toujours un réseau de neurones.
Le point commun : des poids que le gradient règle
Que le réseau rende dix scores, une probabilité par action, une valeur par action ou un embedding par nœud, il se règle de la même façon. Optimiser la politique, c’est optimiser les paramètres du réseau. Les réseaux de neurones sont des modèles bien connus et on sait les optimiser : avec des méthodes fondées sur le gradient, on mesure comment une modification des paramètres change le résultat.
Devant n’importe quel réseau, tu peux donc poser trois questions :
- Quel tenseur entre : une liste, une grille, un graphe ?
- Que doit rendre la dernière couche : des scores, des probabilités, des valeurs, une représentation par nœud ?
- Que règle-t-on : les poids, à partir d’un signal comme une cible ou une récompense ?
📌 À retenir Un réseau de neurones transforme un tenseur en un autre, par des couches de neurones à poids réglables. Sa dernière couche épouse la tâche, et son réglage suit le gradient.