Ouvre un cours sur la probabilité de défaut d’un client, un autre sur les réseaux de neurones, un troisième sur la mémoire des LSTM : une même petite courbe en S s’est glissée dans les trois. Elle ne calcule presque rien, et pourtant elle est partout. À la fin de cette page, tu sauras écrire sa formule, lire sa pente et mesurer ce que cette pente change quand un neurone apprend.
Sommaire
- L’essentiel en 30 secondes
- Une courbe en S qui range tout nombre entre 0 et 1
- Sa pente dit où elle réagit et où elle s’endort
- Ce que sa pente change quand un neurone apprend
- Quatre métiers, une seule courbe
- Trois idées reçues à lâcher
L’essentiel en 30 secondes
- La sigmoïde est une courbe en S bornée entre 0 et 1, toujours croissante :
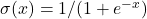 .
- Sa pente s’écrit avec la courbe elle-même : sensible au centre, endormie aux bords.
- Son métier est de convertir un score en proportion : une probabilité, l’activité d’un neurone ou l’ouverture d’une porte.
- Pour un neurone, la pente est le facteur qui module chaque correction pendant l’entraînement.
- Elle n’est ni la régression logistique ni l’activation par défaut : c’est une pièce réutilisable.
Une courbe en S qui range tout nombre entre 0 et 1
Commence par une notion de base. Une fonction est bornée quand une constante  l’empêche de sortir d’un couloir :
 pour tout
 . Le cosinus l’est, puisqu’il ne dépasse jamais 1 ; la fonction
 ne l’est pas près de zéro, où elle dépasse n’importe quelle borne fixée à l’avance.
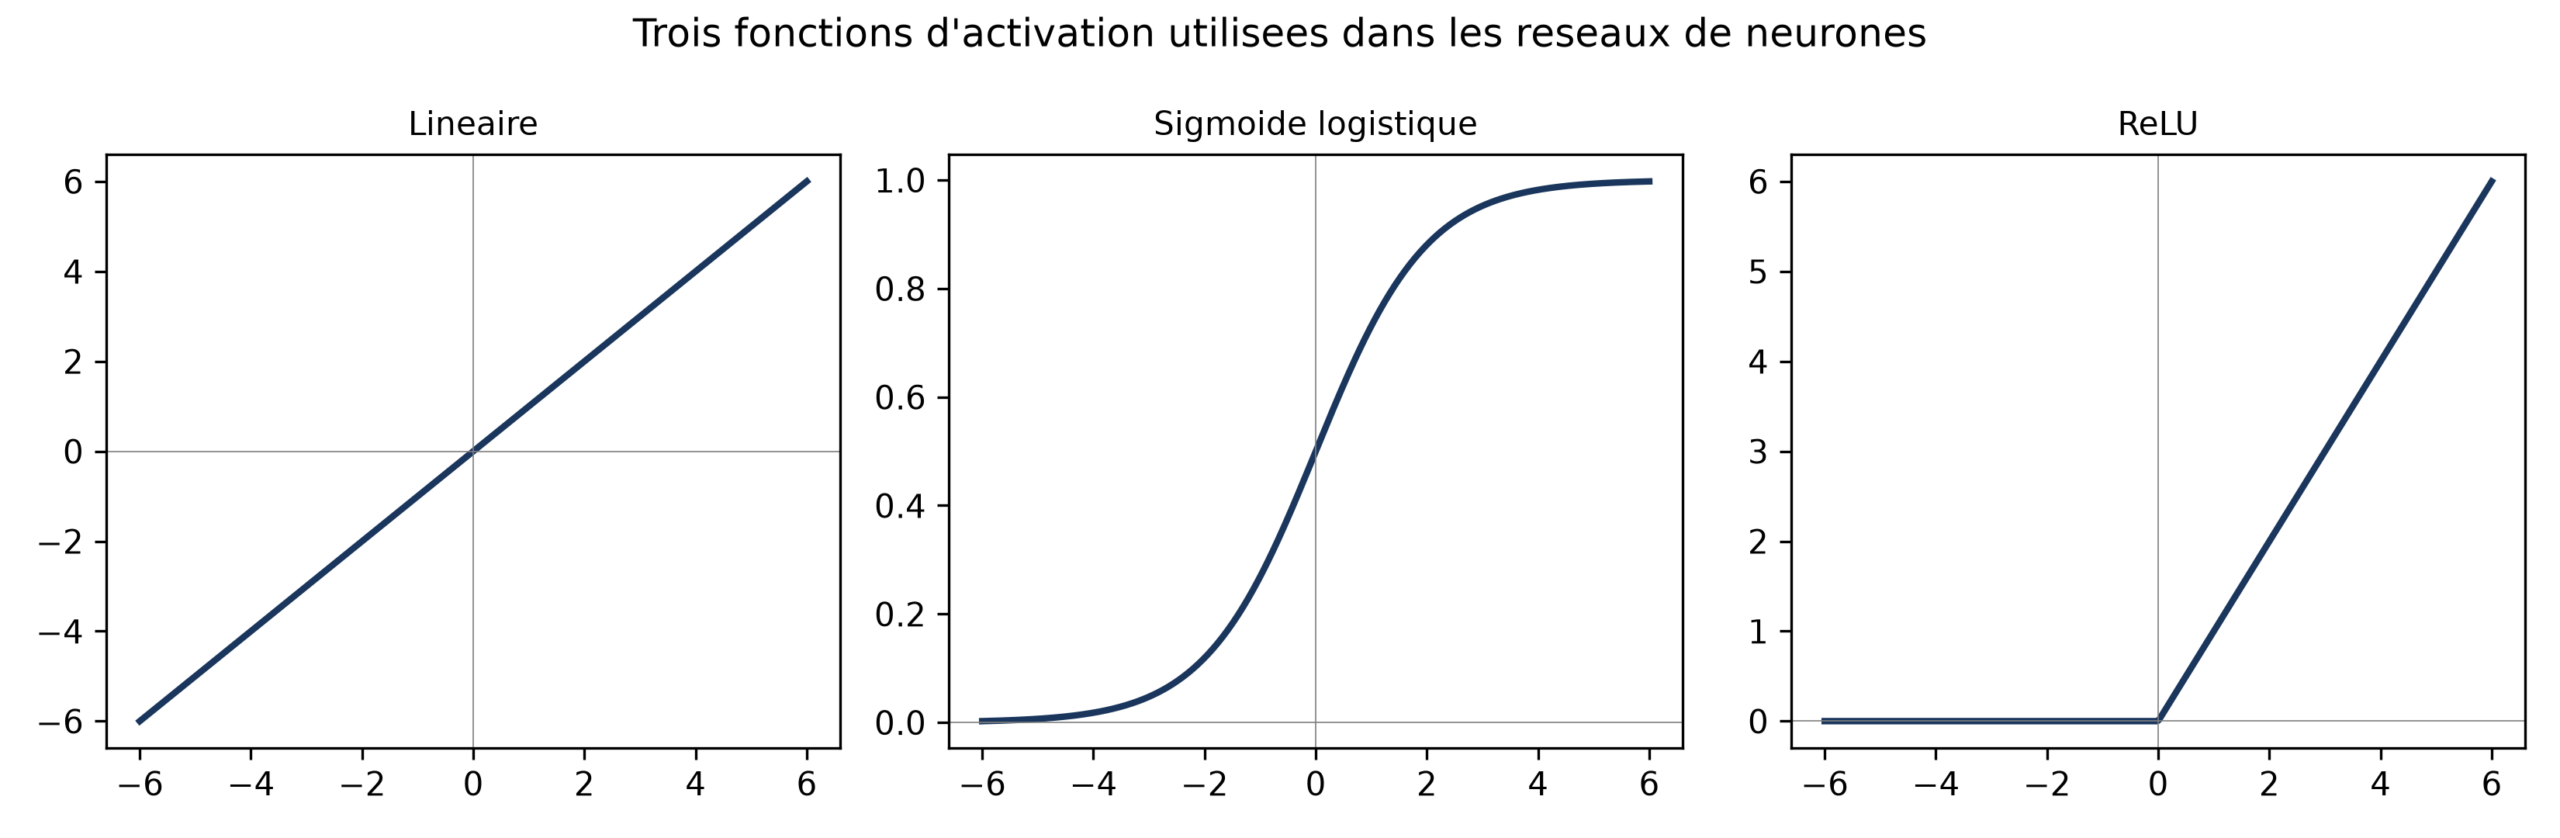
La sigmoïde est bornée, et avec précision : elle ne quitte jamais l’intervalle de 0 à 1. Elle est aussi monotone croissante : si  , alors
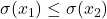 , donc elle ne redescend jamais.
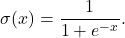
Ici est un nombre réel quelconque et  la base de l’exponentielle. Au centre, pour
 , la courbe vaut exactement 1/2 ; elle monte ensuite d’un seul geste vers 1 à droite et descend vers 0 à gauche, sans jamais s’en détacher.
Tu la croiseras aussi sous le nom de fonction logistique, écrite  : c’est la même courbe en S, avec
 à la place de .
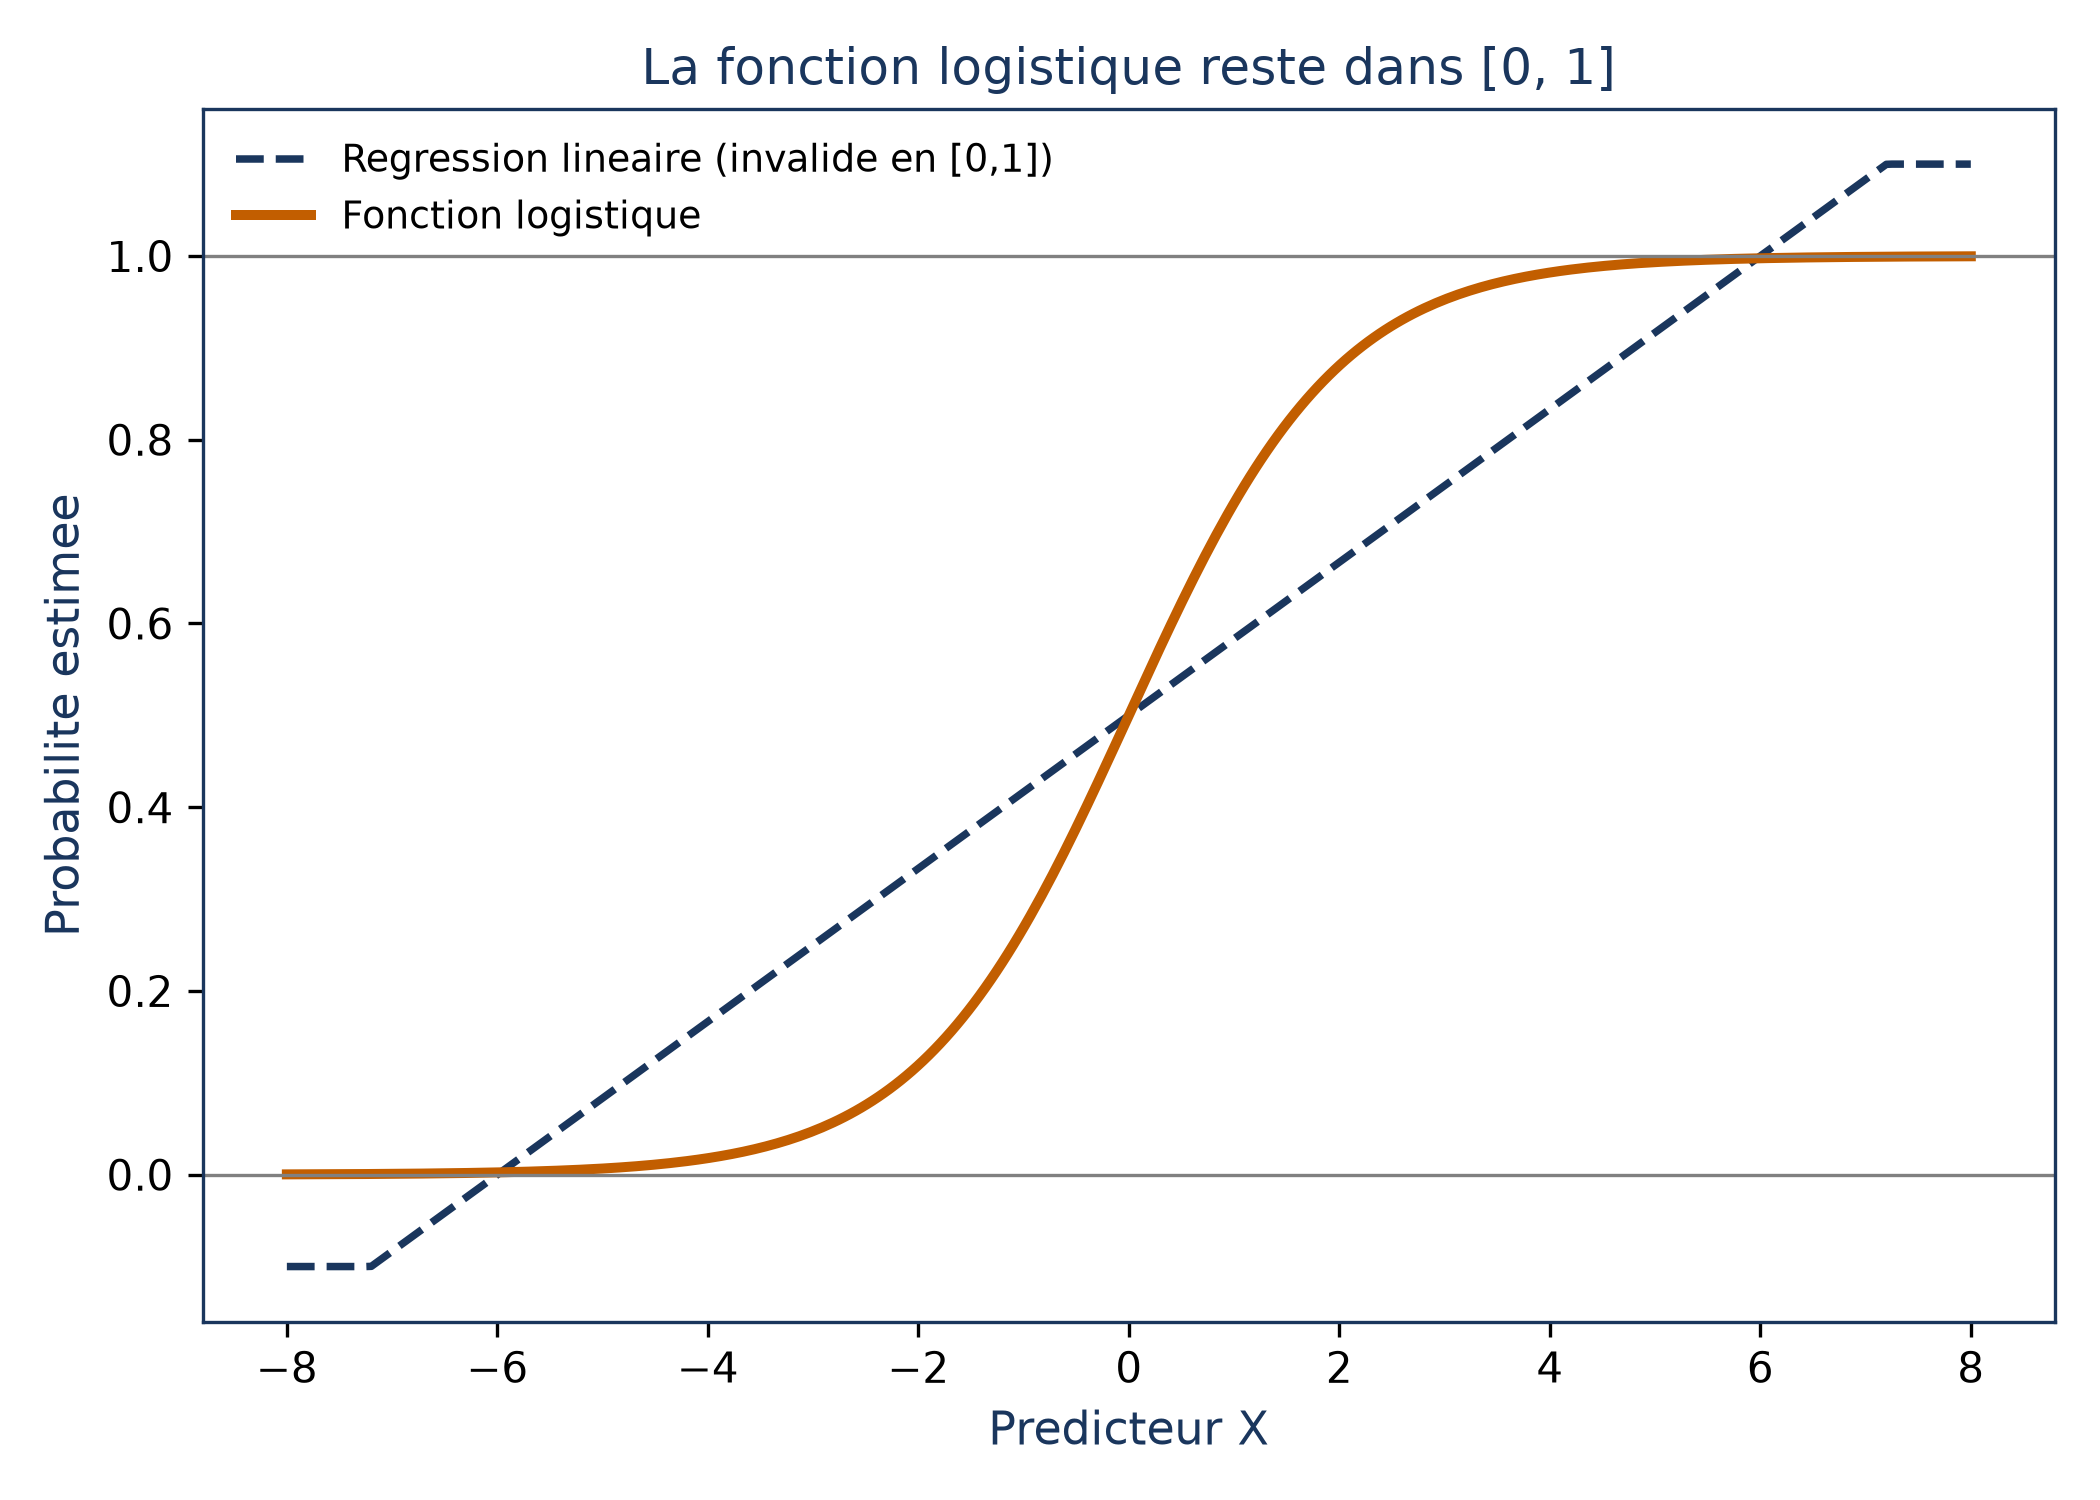
💡 Intuition Pense au curseur d’un variateur de lumière : tu peux le pousser aussi loin que tu veux, la lampe ne dépassera jamais 100 % ni ne descendra sous 0 %. La sigmoïde est cette butée douce, appliquée à n’importe quel nombre qu’on lui présente.
Sa pente dit où elle réagit et où elle s’endort
Où la courbe est-elle sensible à ce que tu lui donnes ? Sa dérivée, qui chiffre l’inclinaison en chaque point, a une propriété rare : elle s’exprime avec la sigmoïde elle-même.
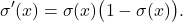
Lis ce produit comme deux nombres qui se partagent une unité :  et son complément
 s’additionnent toujours à 1. Leur produit est le plus grand quand ils sont égaux, donc au centre où chacun vaut 1/2 : la pente y plafonne à 1/4. Dès qu’on s’éloigne, l’un des deux facteurs file vers zéro et la pente s’effondre.
Une pente quasi nulle signifie qu’un changement de ne bouge presque plus la sortie : on dit que la courbe est saturée. La sensibilité se concentre au centre, et c’est la signature du S.
Un cas chiffré montre cette zone sensible. Un modèle estime la probabilité de défaut d’un client à partir du solde de sa carte. Quand le solde passe de 1 000 $ à 2 000 $, la probabilité prédite passe de 0,6 % à 58,6 % : l’essentiel de la variation se concentre sur une plage de soldes relativement étroite.
Ce que sa pente change quand un neurone apprend
Un neurone calcule une somme pondérée  de ses entrées, puis la transforme par une fonction d’activation
 pour obtenir sa sortie
 . Le poids
 relie l’entrée
 à la sortie
 .
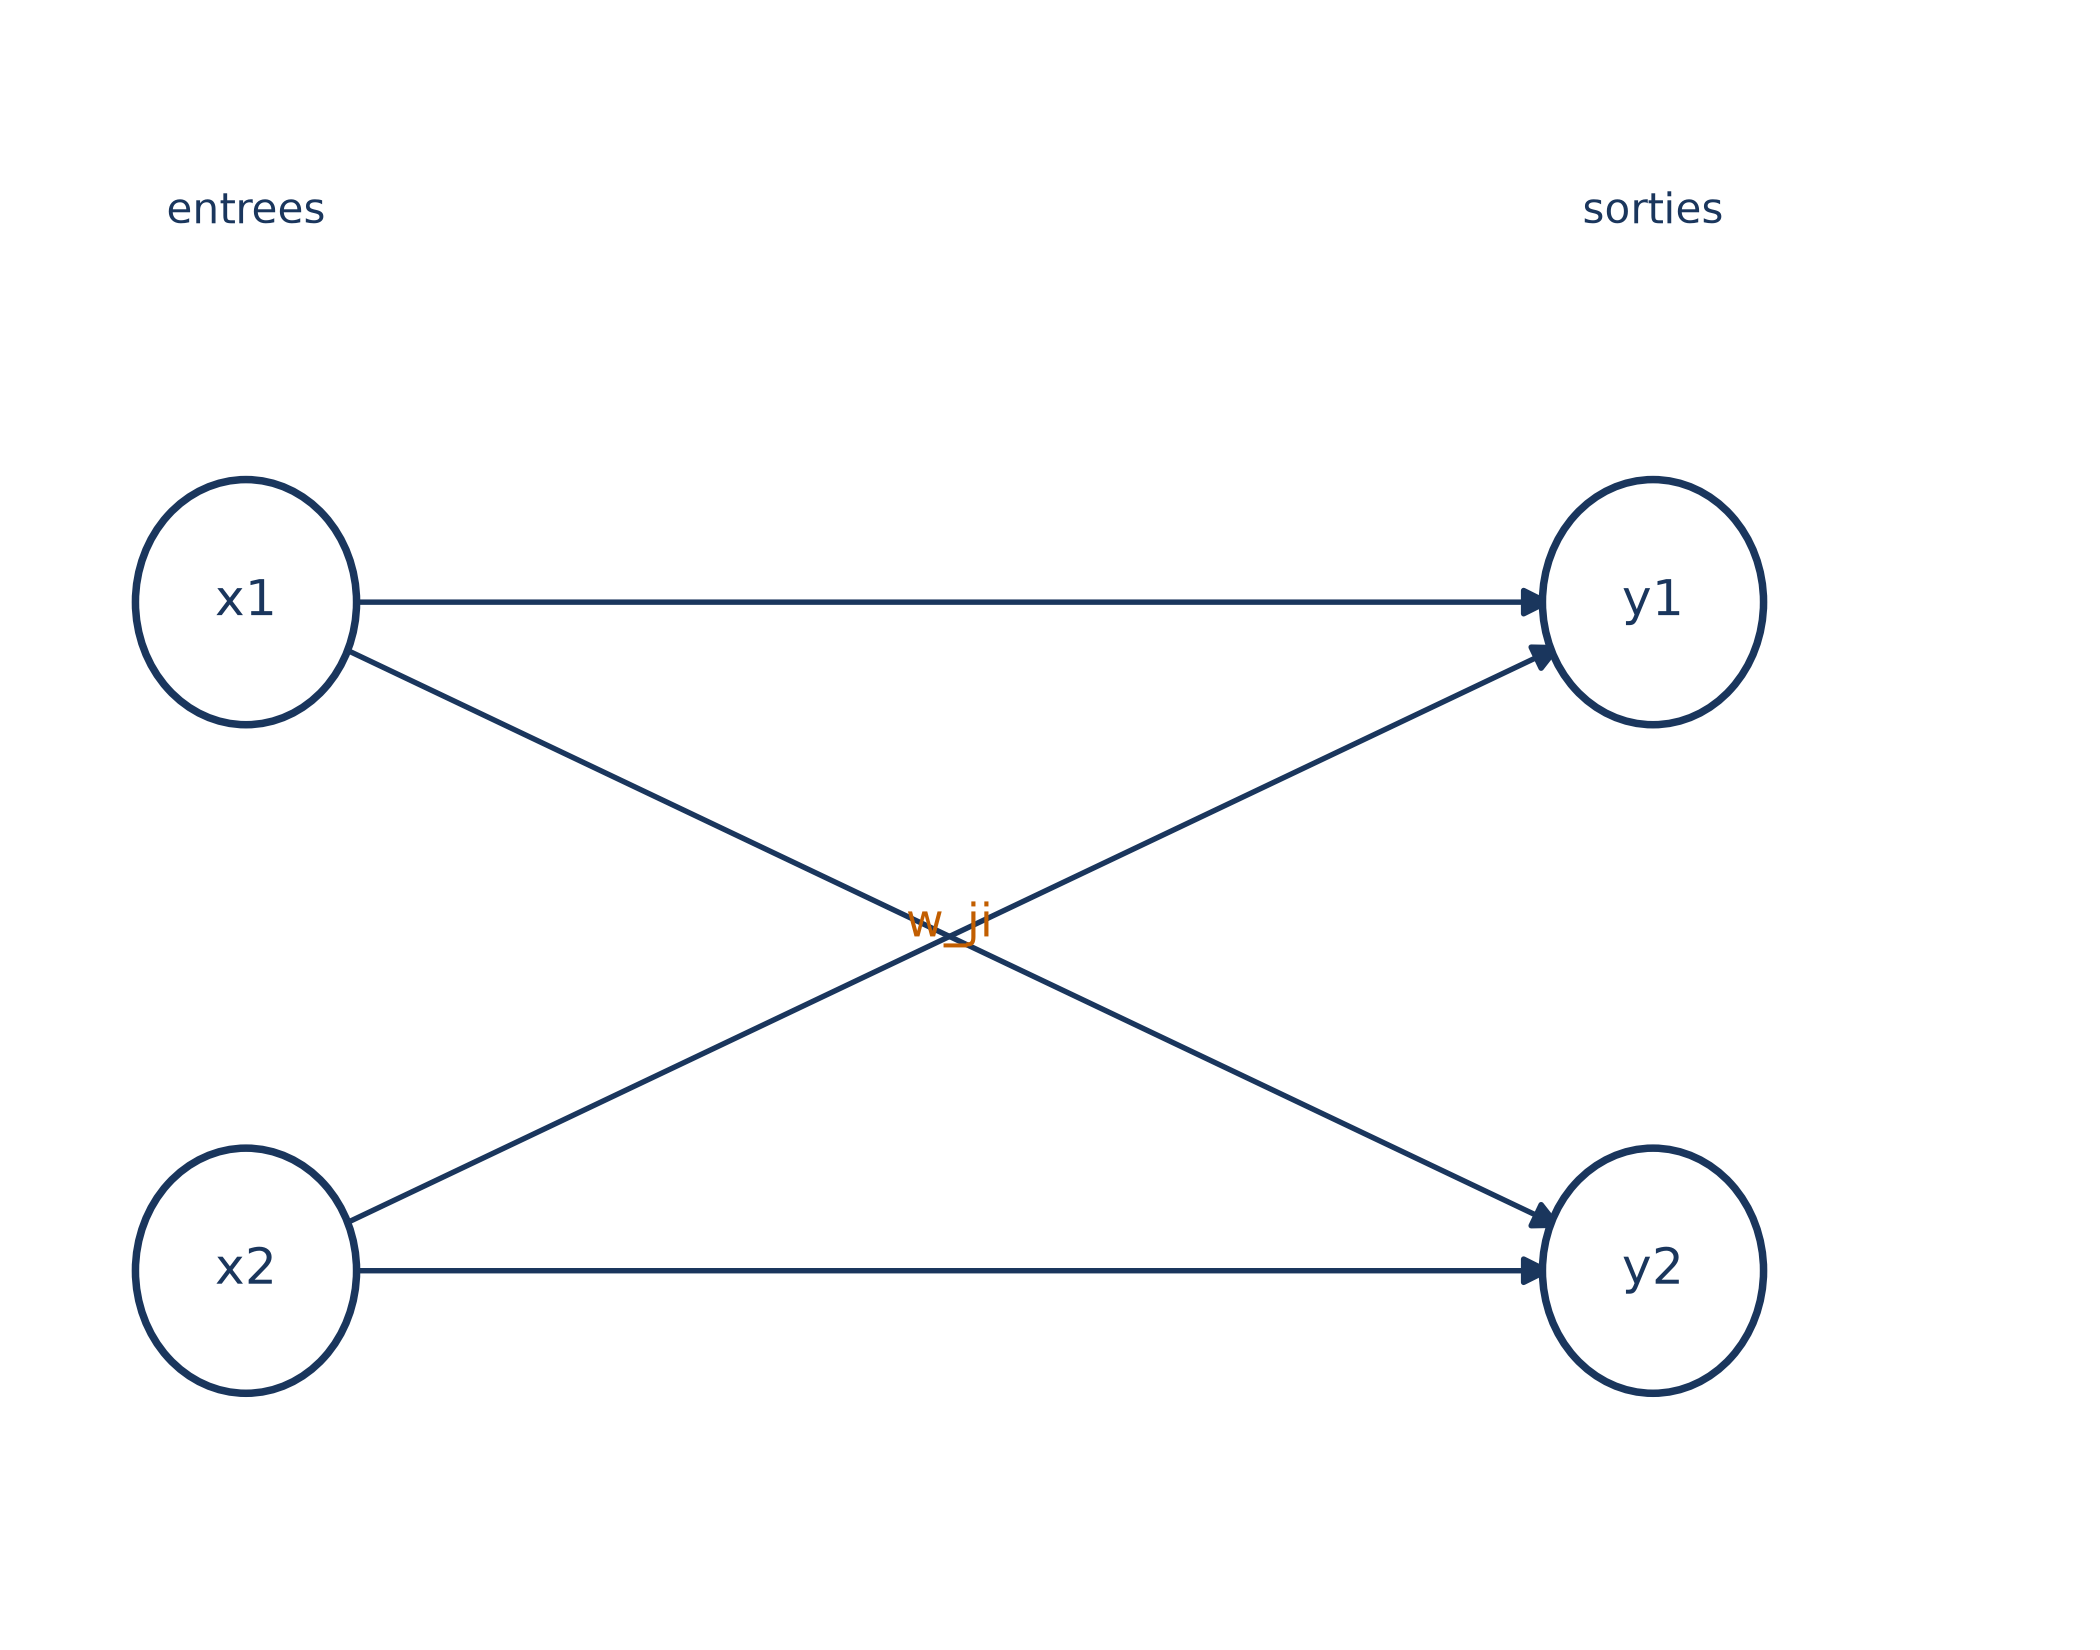
Suis une flèche de la colonne « entrées » vers la colonne « sorties » : chacune porte un poids , et c’est lui que l’entraînement corrige.
Pour savoir de combien corriger, on mesure l’erreur sur un exemple, avec  la cible attendue, puis on déplace chaque poids contre la pente de cette erreur, d’un pas
 :
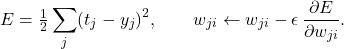
Avec une activation linéaire,  , la dérivée de l’erreur vaut
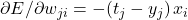 : la correction est proportionnelle à l’écart à la cible et à l’entrée. Avec la sigmoïde, le calcul se complique à peine. On pose
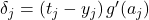 , l’erreur corrigée attribuable au neurone
 , et la dérivée devient :
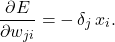
C’est la formule du cas linéaire, à un facteur près : la pente 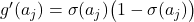 . Ce facteur vaut au plus 1/4 et tend vers 0 sur les bords. Un neurone dont la somme tombe loin du centre reçoit donc des corrections minuscules, même quand son écart à la cible est grand.
⚠️ Piège Un neurone sigmoïde très sûr de lui et pourtant faux est celui qui apprend le plus lentement. Son erreur
est grande, mais sa pente est presque nulle, et c’est le produit des deux qui décide de la correction.
Quatre métiers, une seule courbe
La sigmoïde intervient chaque fois qu’un nombre sans limites doit devenir une proportion. Le tableau range quatre cas que le même calcul remplit.
| Où tu la croises | Ce qui entre | Ce que la sortie représente |
|---|---|---|
| Classification entre deux catégories | une combinaison linéaire des caractéristiques | la probabilité d’appartenir à la catégorie |
| Neurone caché d’un réseau | une somme pondérée des entrées | l’activité de ce neurone |
| Porte d’un LSTM ou d’un GRU | l’entrée courante et l’état caché précédent | la part d’information qui traverse |
| Embeddings de mots | le produit scalaire de deux vecteurs | la probabilité qu’une paire de mots soit valide |
Dans les quatre cas, la même transformation fait le travail : un score sans bornes entre, une proportion ressort. Elle ne tranche pas, elle gradue.
Trois idées reçues à lâcher
« La sigmoïde, c’est la régression logistique »
La régression logistique s’en sert pour convertir une combinaison linéaire en probabilité, mais la courbe existe sans elle : le tableau plus haut la montre dans des neurones, des portes et des embeddings de mots. La sigmoïde est une pièce, pas un modèle.
« C’est la fonction d’activation par défaut »
Elle l’a été : on la privilégiait autrefois dans les couches cachées. Le choix moderne le plus courant est la ReLU, qui vaut si  et 0 sinon.
« Sa saturation la condamne »
Pour un neurone isolé, la saturation n’est qu’un ralentissement, comme tu viens de le voir. Elle devient grave quand on empile de nombreuses couches sigmoïdes : à chaque couche traversée, le signal d’erreur est multiplié par un facteur de pente d’au plus 1/4, et il n’en reste presque rien à l’entrée. C’est le gradient qui s’évanouit.
📌 À retenir La sigmoïde transforme un nombre quelconque en proportion entre 0 et 1. Sa pente, maximale au centre et presque nulle sur les bords, décide de la part de l’erreur qui revient à un neurone : tout l’intérêt, et toute la limite, de la courbe en S tiennent dans ce facteur.