Envoie une question à un grand modèle de langage : avant que le premier mot de la réponse apparaisse, ta phrase a traversé des dizaines, parfois des centaines de couches empilées. Chacune reprend ce que la précédente a produit et le transforme un peu. Cette pile s’appelle un réseau profond. Tu vas voir comment elle est construite, ce qui change d’un étage à l’autre, ce qui l’empêche de s’écrouler, et pourquoi on peut aussi la tailler.
Sommaire
- L’essentiel en 30 secondes
- Trois étages, dont un répété des centaines de fois
- La taille du vecteur change d’une couche à l’autre
- Pourquoi empiler plutôt qu’élargir
- Ce qui empêche la pile de s’écrouler
- Deux réflexes à corriger
L’essentiel en 30 secondes
- Un réseau profond se lit en trois étages : une entrée, une pile cachée, une sortie.
- Dans un grand modèle de langage, bloc central répété des dizaines de fois.
- D’une couche à l’autre, la taille des vecteurs change : elle grandit pour du texte, elle diminue pour des images.
- Empiler des couches exploite mieux les paramètres que de les entasser au même niveau.
- Des raccourcis et une normalisation gardent la pile entraînable, et l’on peut ensuite en retirer des morceaux.
Trois étages, dont un répété des centaines de fois
Ouvre un grand modèle de langage : son corps empile des dizaines à des centaines de blocs transformeurs, au cœur d’un réseau à trois sortes de couches. À l’entrée, la couche d’embedding prend des tokens et renvoie des embeddings, c’est-à-dire des vecteurs de nombres. Au milieu, les blocs transformeurs sont les couches cachées : ce sont eux qui produisent la prédiction. À la sortie, la tête de modélisation du langage convertit ce que les blocs ont calculé en un vecteur de logits, un par token du vocabulaire.
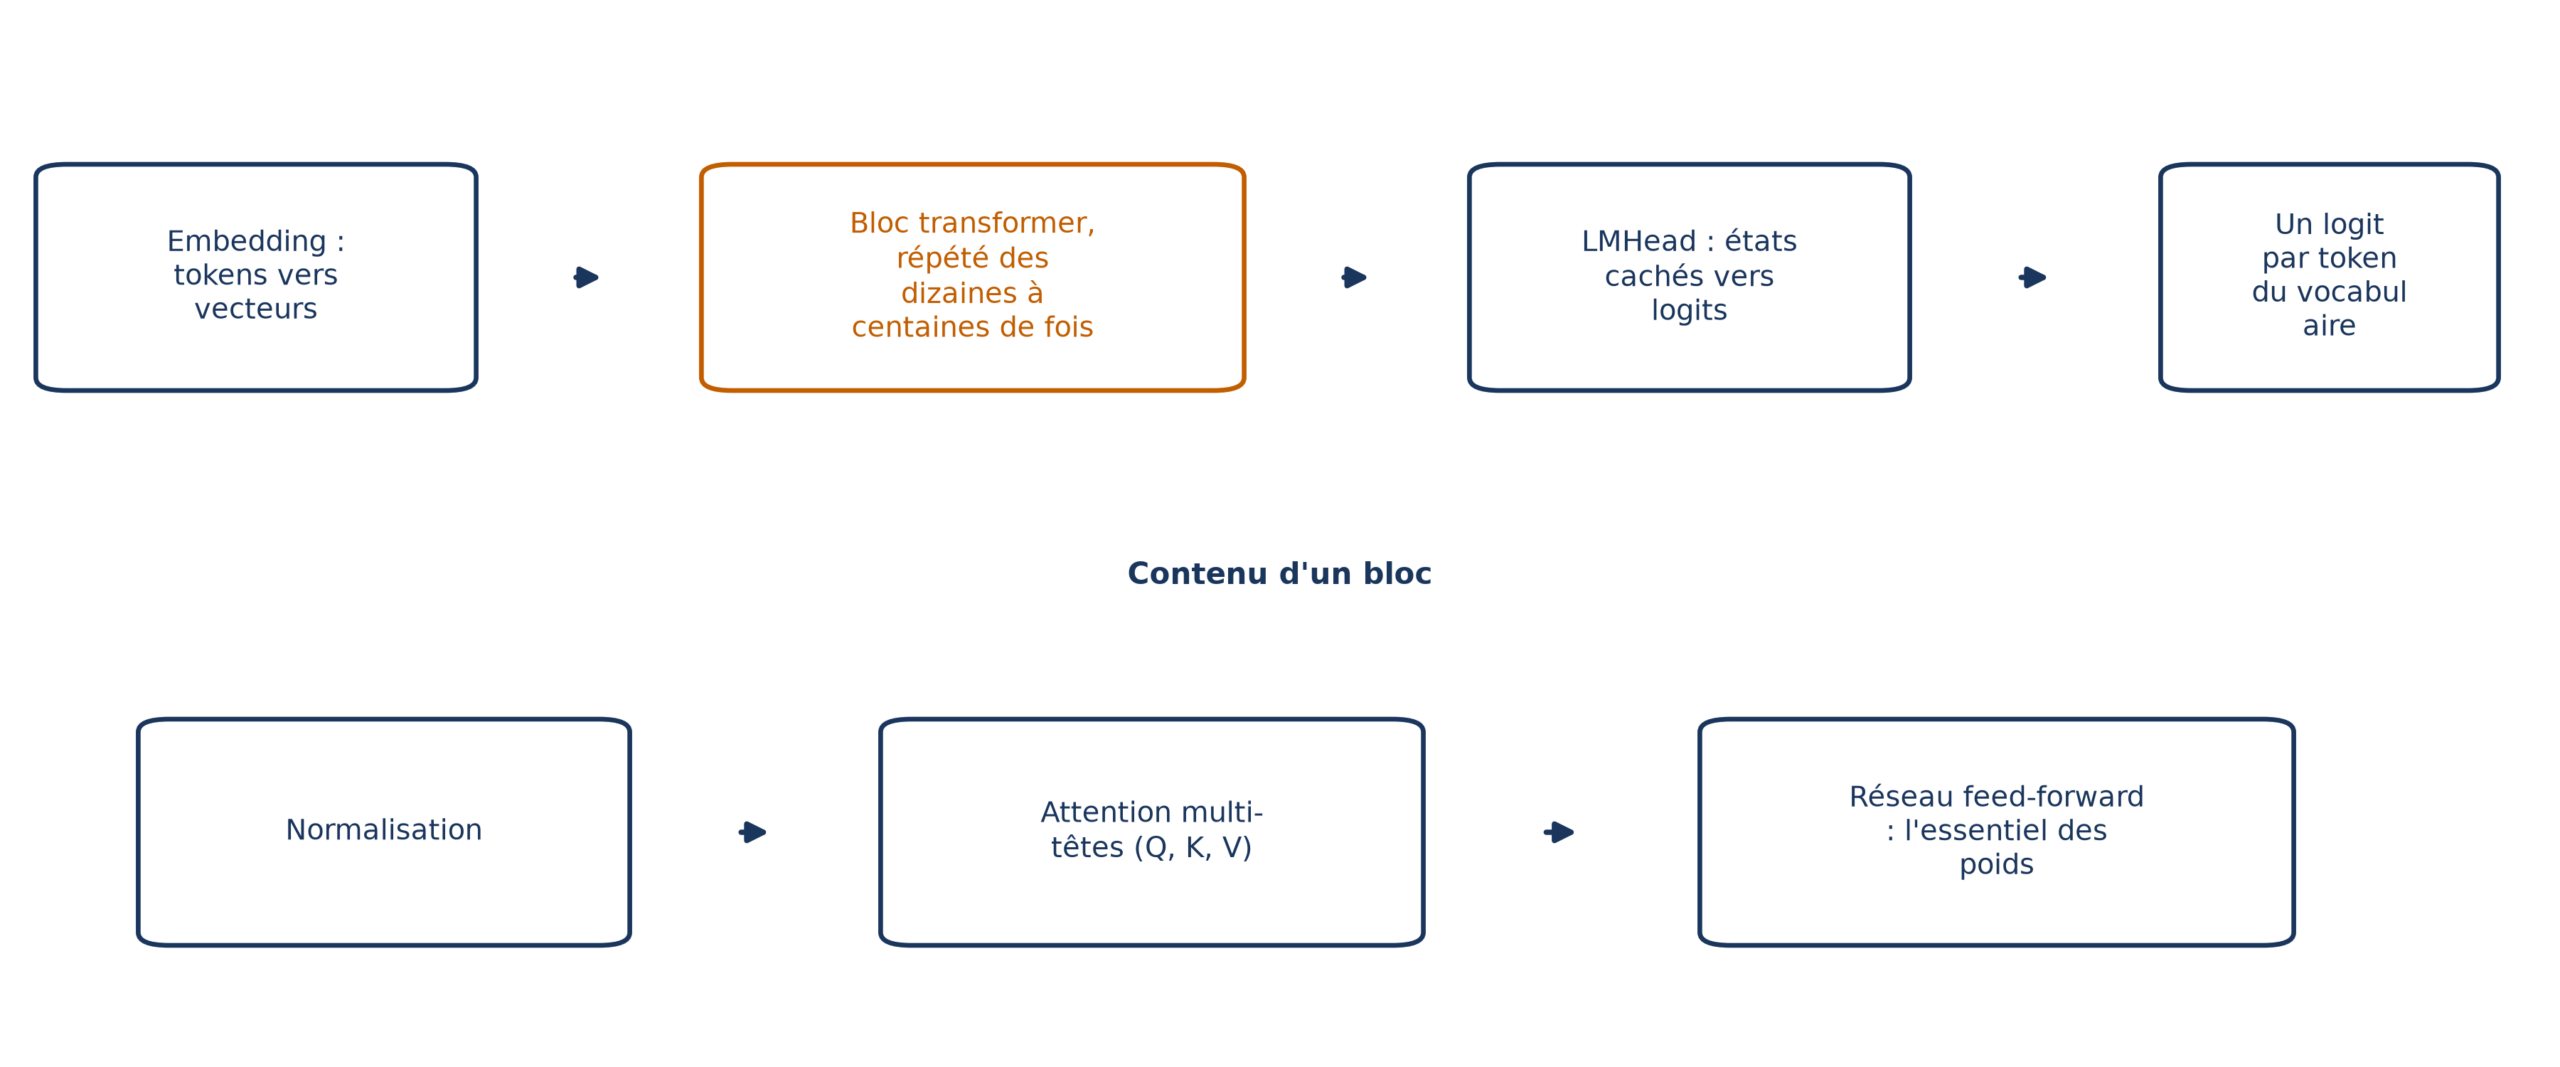
Cette dernière remarque se vérifie en comptant. Le feed-forward est un perceptron multicouche, et ses sous-couches linéaires forment la majorité des poids entraînables d’un modèle de langage, devant les sous-couches d’attention. Normalisations et fonctions d’activation, elles, restent négligeables dans le total.
Le mot « profond » compte donc ces blocs cachés empilés les uns derrière les autres. Une pile de deux ou trois couches et une pile de cent couches obéissent au même plan ; seule change la hauteur.
La taille du vecteur change d’une couche à l’autre
Chaque couche cachée produit une sortie que la suivante lit. Cette sortie est une représentation interne des données, et l’une de ses caractéristiques essentielles est sa dimensionnalité, autrement dit le nombre de valeurs que contient chaque vecteur. Or cette taille ne reste pas figée du début à la fin de la pile.
Pour du texte, les représentations internes l’augmentent : des morceaux de texte deviennent des vecteurs de centaines ou de milliers de nombres, assez larges pour capter le sens. Pour des modèles d’images, c’est l’inverse : elles la réduisent, en passant de millions de pixels à une taille que l’on sait manipuler.
Certains réseaux se spécialisent dans cette transformation. Un encodeur prend une entrée, texte ou image, et en fait une représentation interne enrichie d’informations et de sens. Un décodeur s’en sert pour générer une sortie, texte ou image. Les modèles de langage actuels sont des décodeurs seuls ; les modèles à encodeur seul, dont la famille BERT, sont devenus rares.
Whisper, très utilisé pour transcrire de l’audio, suit le schéma complet : un encodeur traite le son, un décodeur génère les tokens de texte. Et comme les réseaux sont composables, on peut en combiner plusieurs dans un seul modèle ou les enchaîner en pipeline.
Dans le code, tout cela se résume à quelques nombres. Voici les réglages d’un classifieur de texte : no_layers fixe le nombre de couches empilées, embedding_dim la taille des vecteurs à l’entrée, hidden_dim celle de l’état caché, c’est-à-dire de ce que chaque couche transmet à la suivante.
# Hyperparameters
no_layers = 3
vocab_size = len(vocab) + 1  # extra 1 for padding
embedding_dim = 300
output_dim = 1
hidden_dim = 256
# Initialize the model
model = SentimentRNN(no_layers, vocab_size, hidden_dim,
                     embedding_dim, drop_prob=0.5)
vocab est le vocabulaire des mots connus (le « +1 » réserve une place au remplissage), et SentimentRNN assemble embeddings, couches récurrentes et sortie. Lis les tailles dans l’ordre : les mots entrent sous forme de vecteurs de 300 nombres, la pile travaille avec 256 unités, et output_dim = 1 indique que tout se termine par un seul nombre, dont on tire une probabilité. La profondeur, ici trois couches, n’est qu’un réglage parmi d’autres.
Pourquoi empiler plutôt qu’élargir
On pourrait imaginer une seule couche très large plutôt qu’une pile. Le constat est pourtant net : les réseaux profonds sont utiles parce que davantage de couches utilisent plus efficacement leurs paramètres et encodent plus de sens dans leurs états cachés. À budget de paramètres comparable, répartir le travail sur plusieurs étages rapporte plus.
💡 Intuition Pense à une chaîne de montage : au lieu d’un poste gigantesque qui fabriquerait l’objet d’un seul geste, chaque poste reprend la pièce du précédent et n’ajoute qu’une petite transformation.
Cette souplesse a une base théorique. Un réseau de neurones peut, en théorie, représenter n’importe quelle fonction complexe : c’est le théorème d’approximation universelle. En pratique, on lui reconnaît plusieurs qualités : c’est un approximateur de fonctions très expressif, qui représente des relations non linéaires complexes ; il passe bien à l’échelle sur de grands espaces d’entrée ; il généralise à des situations jamais rencontrées.
Dernier atout : il accepte des données de natures variées (capteurs, images, vidéo) sans ingénierie de caractéristiques écrite à la main. La pile s’occupe elle-même de fabriquer, étage après étage, les représentations utiles.
Ce qui empêche la pile de s’écrouler
Empiler cent blocs ne marche pas tout seul : il faut que l’information et l’erreur circulent d’un bout à l’autre. Dans le bloc transformeur, deux ingrédients s’en chargent, en plus du réseau feed-forward dont voici la formule :
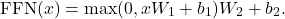
Lis-la de gauche à droite. Le vecteur  subit une première transformation linéaire (matrice
 , biais
 ), puis passe dans
 , la fonction d’activation qui met à zéro les valeurs négatives, avant une seconde transformation linéaire (matrice
 , biais
 ). Ce feed-forward ajoute une étape de non-linéarité à l’auto-attention et se parallélise facilement, ce qui explique son choix.
Premier ingrédient : les connexions résiduelles. Elles font passer l’information entre deux couches sans la faire traverser la transformation intermédiaire. Développées d’abord pour les réseaux convolutifs, elles créent un raccourci qui aide le gradient à redescendre vers les couches basses. Dans le transformeur, il y en a autour de l’attention et autour du feed-forward : l’entrée est simplement additionnée à la sortie.
Elles lissent aussi la surface de la fonction de perte, ce qui aide le modèle à trouver un meilleur minimum sans rester coincé dans un minimum local. L’effet est spectaculaire sur les visualisations de paysage de perte publiées par Li et ses collègues.
⚠️ Piège Une couche de plus n’est pas une garantie de plus : sans raccourci, c’est le signal d’erreur qui peine à redescendre vers les étages du bas.
Second ingrédient : la normalisation de couche, qui facilite l’entraînement parce qu’elle garde les valeurs des couches cachées dans une plage donnée. Pour chaque vecteur, on calcule la moyenne et l’écart-type, puis on le met à l’échelle ; c’est une alternative à la normalisation par lots.
Deux réflexes à corriger
« Chaque couche de la pile est indispensable »
Pas forcément. Une fois un modèle entraîné, on peut l’alléger par l’élagage : supprimer des poids, des connexions, voire des couches entières. La version non structurée est la plus simple : on met à zéro les connexions dont la valeur est sous un seuil, car les poids déjà proches de zéro contiennent peu d’information. Revers : elle peut créer des modèles creux, dont l’inférence est sous-optimale.
L’élagage structuré est plus sophistiqué. Il élimine des neurones, des groupes de neurones, des couches ou des blocs entiers, en cherchant à préserver la performance tout en équilibrant précision et compression. La pile n’est donc pas un monolithe : on peut en retirer des morceaux.
« Plus on entraîne, mieux c’est »
Suis, à chaque itération, l’erreur sur les données d’entraînement et sur des données de validation mises de côté. La première décroît sans cesse. La seconde commence par baisser, puis se remet à monter : c’est le signe que le réseau apprend les particularités de son jeu d’entraînement plutôt que la structure générale des données.
L’arrêt précoce en tire la conséquence : on interrompt l’entraînement dès que l’erreur de validation cesse de s’améliorer. À chaque itération, on ne garde le modèle que s’il bat le meilleur obtenu jusque-là, et l’on s’arrête dès que ce n’est plus le cas. Sa simplicité en fait une seconde ligne de défense, sans toucher à la fonction objectif.
📌 À retenir Un réseau profond, c’est un bloc qu’on répète entre une entrée et une sortie, avec une taille de vecteur qui évolue et des raccourcis qui gardent l’ensemble stable. Sa hauteur se règle, se taille, et se surveille pendant l’entraînement.