Complète cette phrase : « Le chat dort sur le ___ depuis ce matin. » Pour deviner le mot manquant, tu as pris appui sur ce qui précède le trou, mais aussi sur « depuis ce matin », qui vient après. Un modèle de langage classique lit de gauche à droite et se prive de ce second indice. BERT a été conçu pour exploiter les deux. Tu vas voir ce que son nom veut dire, comment on lui apprend à lire, comment on l’emploie pour classer des documents et pourquoi il a cédé du terrain.
Sommaire
- L’essentiel en 30 secondes
- Un nom qui dit tout : B, E, R, T
- Apprendre à lire avec un texte à trous
- Classer des documents pour une question : deux montages
- Reclasser des résultats : le code
- La famille BERT : variantes et allègements
- BERT face aux modèles qui génèrent
- Quatre idées reçues sur BERT
L’essentiel en 30 secondes
- BERT est un encodeur de Transformer bidirectionnel : chaque mot est lu avec ce qui le précède et ce qui le suit.
- Il apprend en retrouvant des mots masqués, et en jugeant si deux phrases sont liées.
- Il ne rédige pas : il fournit des représentations réutilisables pour classer, répondre ou comparer.
- Pour chercher dans des documents, on le monte en encodeur unique ou en bi-encodeur, l’un précis, l’autre rapide.
- Face aux modèles qui génèrent du texte, il garde un rôle sur les tâches rapides, avec une fenêtre de 512 jetons.
Un nom qui dit tout : B, E, R, T
BERT est l’abréviation de Bidirectional Encoder Representations from Transformers. Chaque mot de ce nom correspond à un choix de conception : en les prenant un à un, tu obtiens la définition complète du modèle.
T : une variante du Transformer
Le Transformer a été une révolution, mais BERT a beaucoup fait pour le populariser : cette variante a montré ce dont ce type de modèle est capable. Elle a été pensée dès le départ pour des applications comme les questions-réponses, le résumé ou la traduction.
B : bidirectionnel
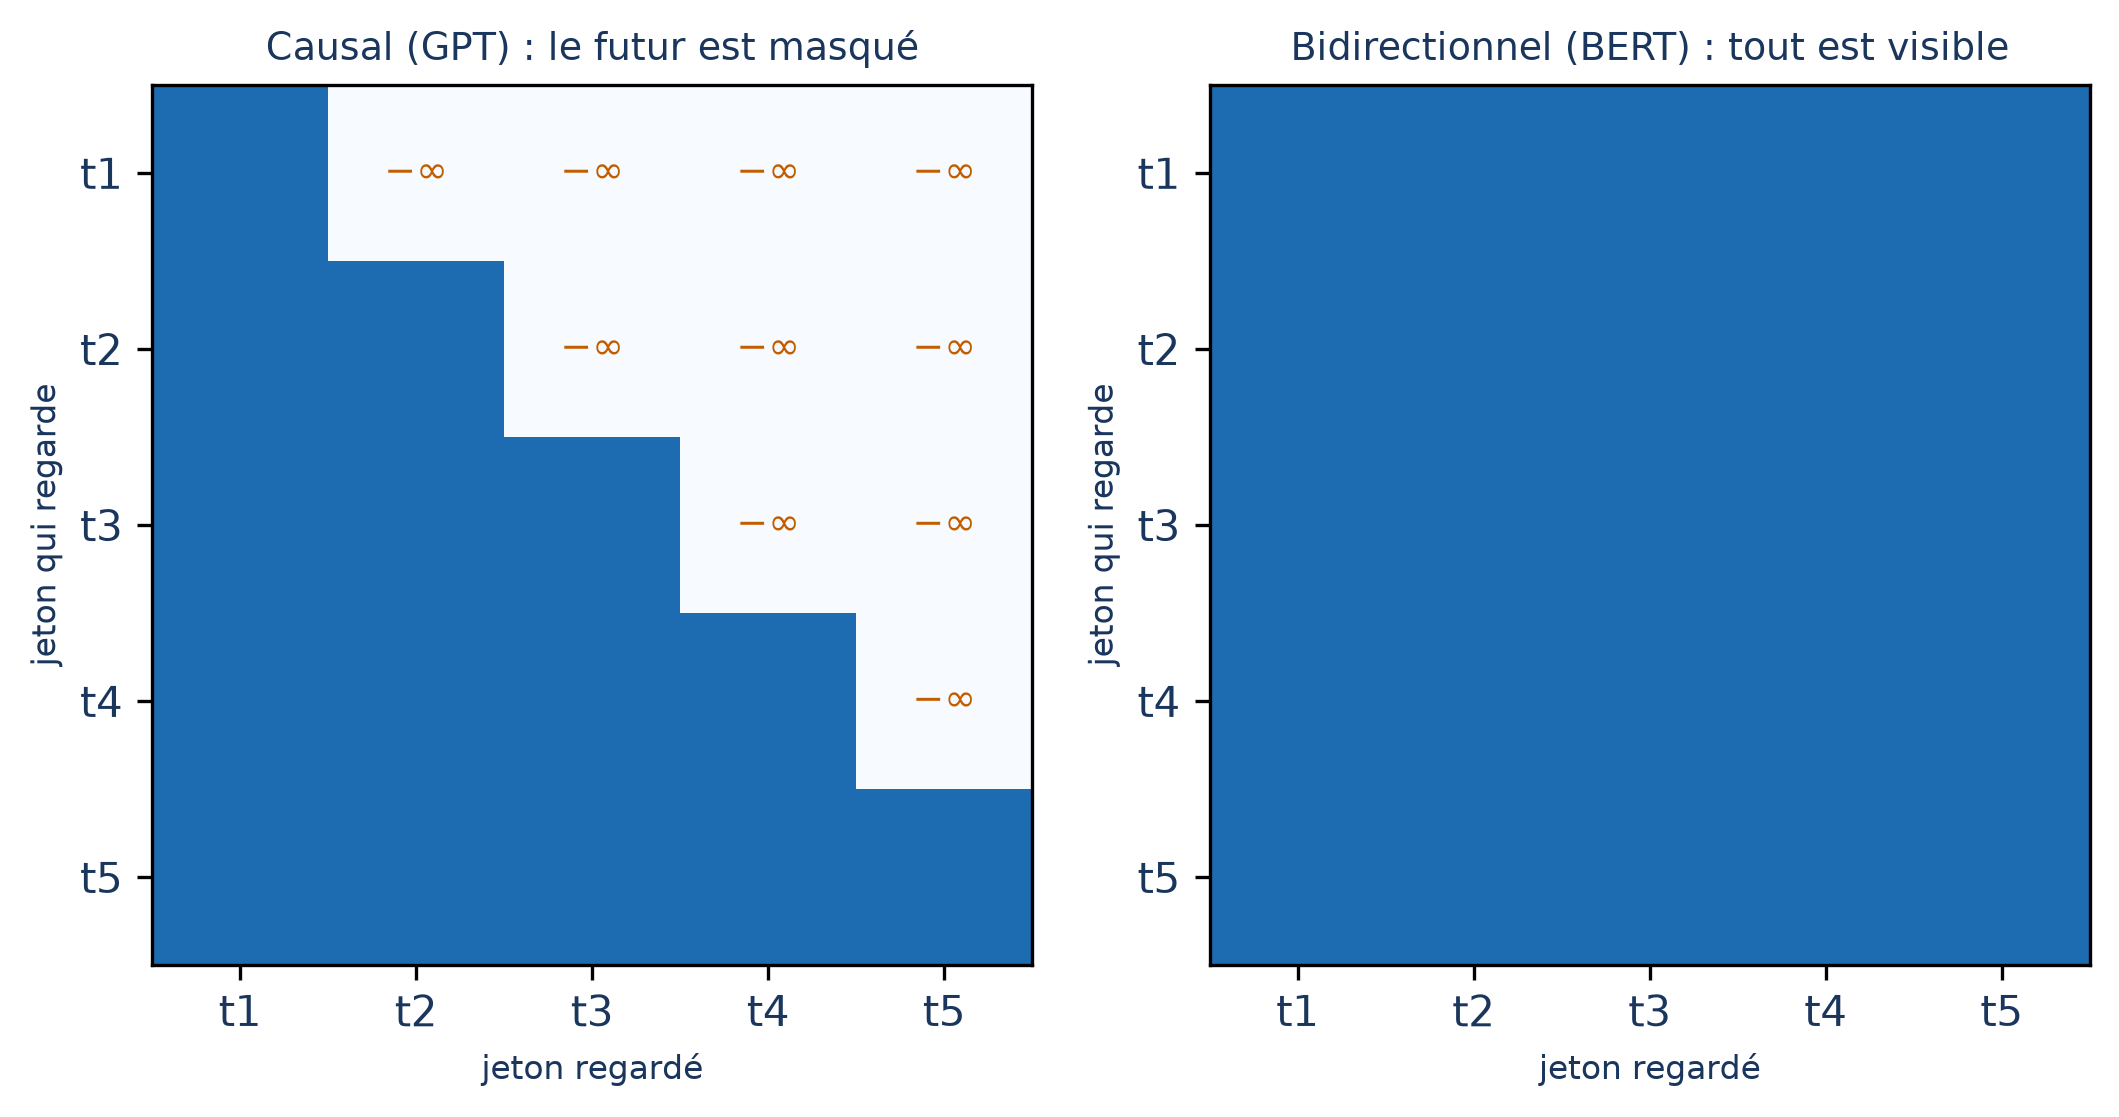
Le Transformer d’origine lit la séquence de gauche à droite. Quand il rencontre une entité, il ne peut pas la relier à ce qui se trouve à sa droite, alors que pour répondre à une question ou résumer, le contexte des deux directions compte. Un encodeur bidirectionnel lève cette limite : chaque jeton peut chercher des relations sur toute la séquence.
E : un encodeur, rien d’autre
Dans un montage encodeur-décodeur, l’encodeur fabrique une représentation interne enrichie d’informations et de sens, puis le décodeur s’en sert pour générer la sortie. BERT s’arrête à la première moitié : il n’est composé que de l’encodeur et lit la séquence entière d’un seul coup. Le reste de la chaîne est familier : embedding, encodage de position, blocs, projection linéaire, softmax.
Le modèle d’origine existe en deux tailles, qui diffèrent par la profondeur et par la largeur des vecteurs qui circulent entre les couches :
| BERT-BASE | BERT-LARGE | |
|---|---|---|
| Couches | 12 | 24 |
| Dimension des vecteurs internes | 768 | 1 024 |
| Têtes d’attention par couche | 12 | 24 |
| Paramètres | 110 millions | 340 millions |
R : des représentations
Le dernier mot du nom annonce ce que BERT fournit : non pas du texte, mais une représentation du texte que d’autres composants exploitent. C’est elle qui sert ensuite aux tâches pour lesquelles il a été pensé, du résumé à la comparaison de documents.
Apprendre à lire avec un texte à trous
Pour qu’un modèle apprenne une langue sans qu’on lui fournisse d’exemples annotés, il faut une tâche dont la réponse est déjà dans le texte. Deux grandes familles existent. Dans la première, le causal language modeling, le modèle écrit la suite sans jamais voir autre chose que le passé. Dans la seconde, le masked language modeling (MLM), on perce des trous dans le texte et le modèle les comble en regardant avant comme après.
BERT relève de la seconde famille, exactement comme dans ton exercice d’ouverture : un jeton est remplacé par un jeton spécial <MASK>, et le modèle doit retrouver le mot caché. À l’origine, 15 % des jetons étaient masqués au hasard. On ne cache pas le futur comme chez un modèle causal, puisque l’on veut que le modèle ait conscience de tout le contexte. La perte se calcule comme pour la prédiction du mot suivant, avec le jeton masqué à la place.
💡 Intuition Un modèle causal lit comme on écoute une phrase au fil de la parole. BERT lit comme on corrige une copie, stylo en main, avec toute la page sous les yeux.
Cette tâche est plus souple qu’il n’y paraît : le principe général consiste à corrompre l’entrée puis à demander au modèle de la reconstruire. Masquer n’est qu’une façon de la corrompre ; on peut aussi réordonner les éléments ou appliquer d’autres transformations. Cette souplesse se paie : seuls 15 % des jetons servent à apprendre à chaque passage, ce qui rend le modèle peu efficace.
Le système a un second exercice. On peut en effet l’étendre à la prédiction de la phrase suivante, qui consiste à deviner si deux phrases sont liées (paraphrase, cohérence, implication). BERT a été entraîné avec des paires de phrases reliées positivement et non reliées, un jeton [SEP] placé entre elles et une softmax finale pour la classification. Cela montre à quel point le dispositif s’adapte à des tâches différentes.
Classer des documents pour une question : deux montages
Imagine une collection de documents et une question. Un moteur de recherche doit apparier la question aux documents pertinents, puis les renvoyer par ordre de pertinence. La recherche par mots-clés comme BM25 y trouve ses limites : elle comprend mal la sémantique, ne capte pas le contexte des termes polysémiques et souffre de l’inadéquation de vocabulaire, quand la question et les documents ne se recouvrent pas.
La parade consiste à utiliser des vecteurs denses qui contiennent de l’information contextuelle, et un encodeur bidirectionnel comme BERT sait en produire. Pour cela, deux stratégies existent.
Premier montage : un encodeur unique
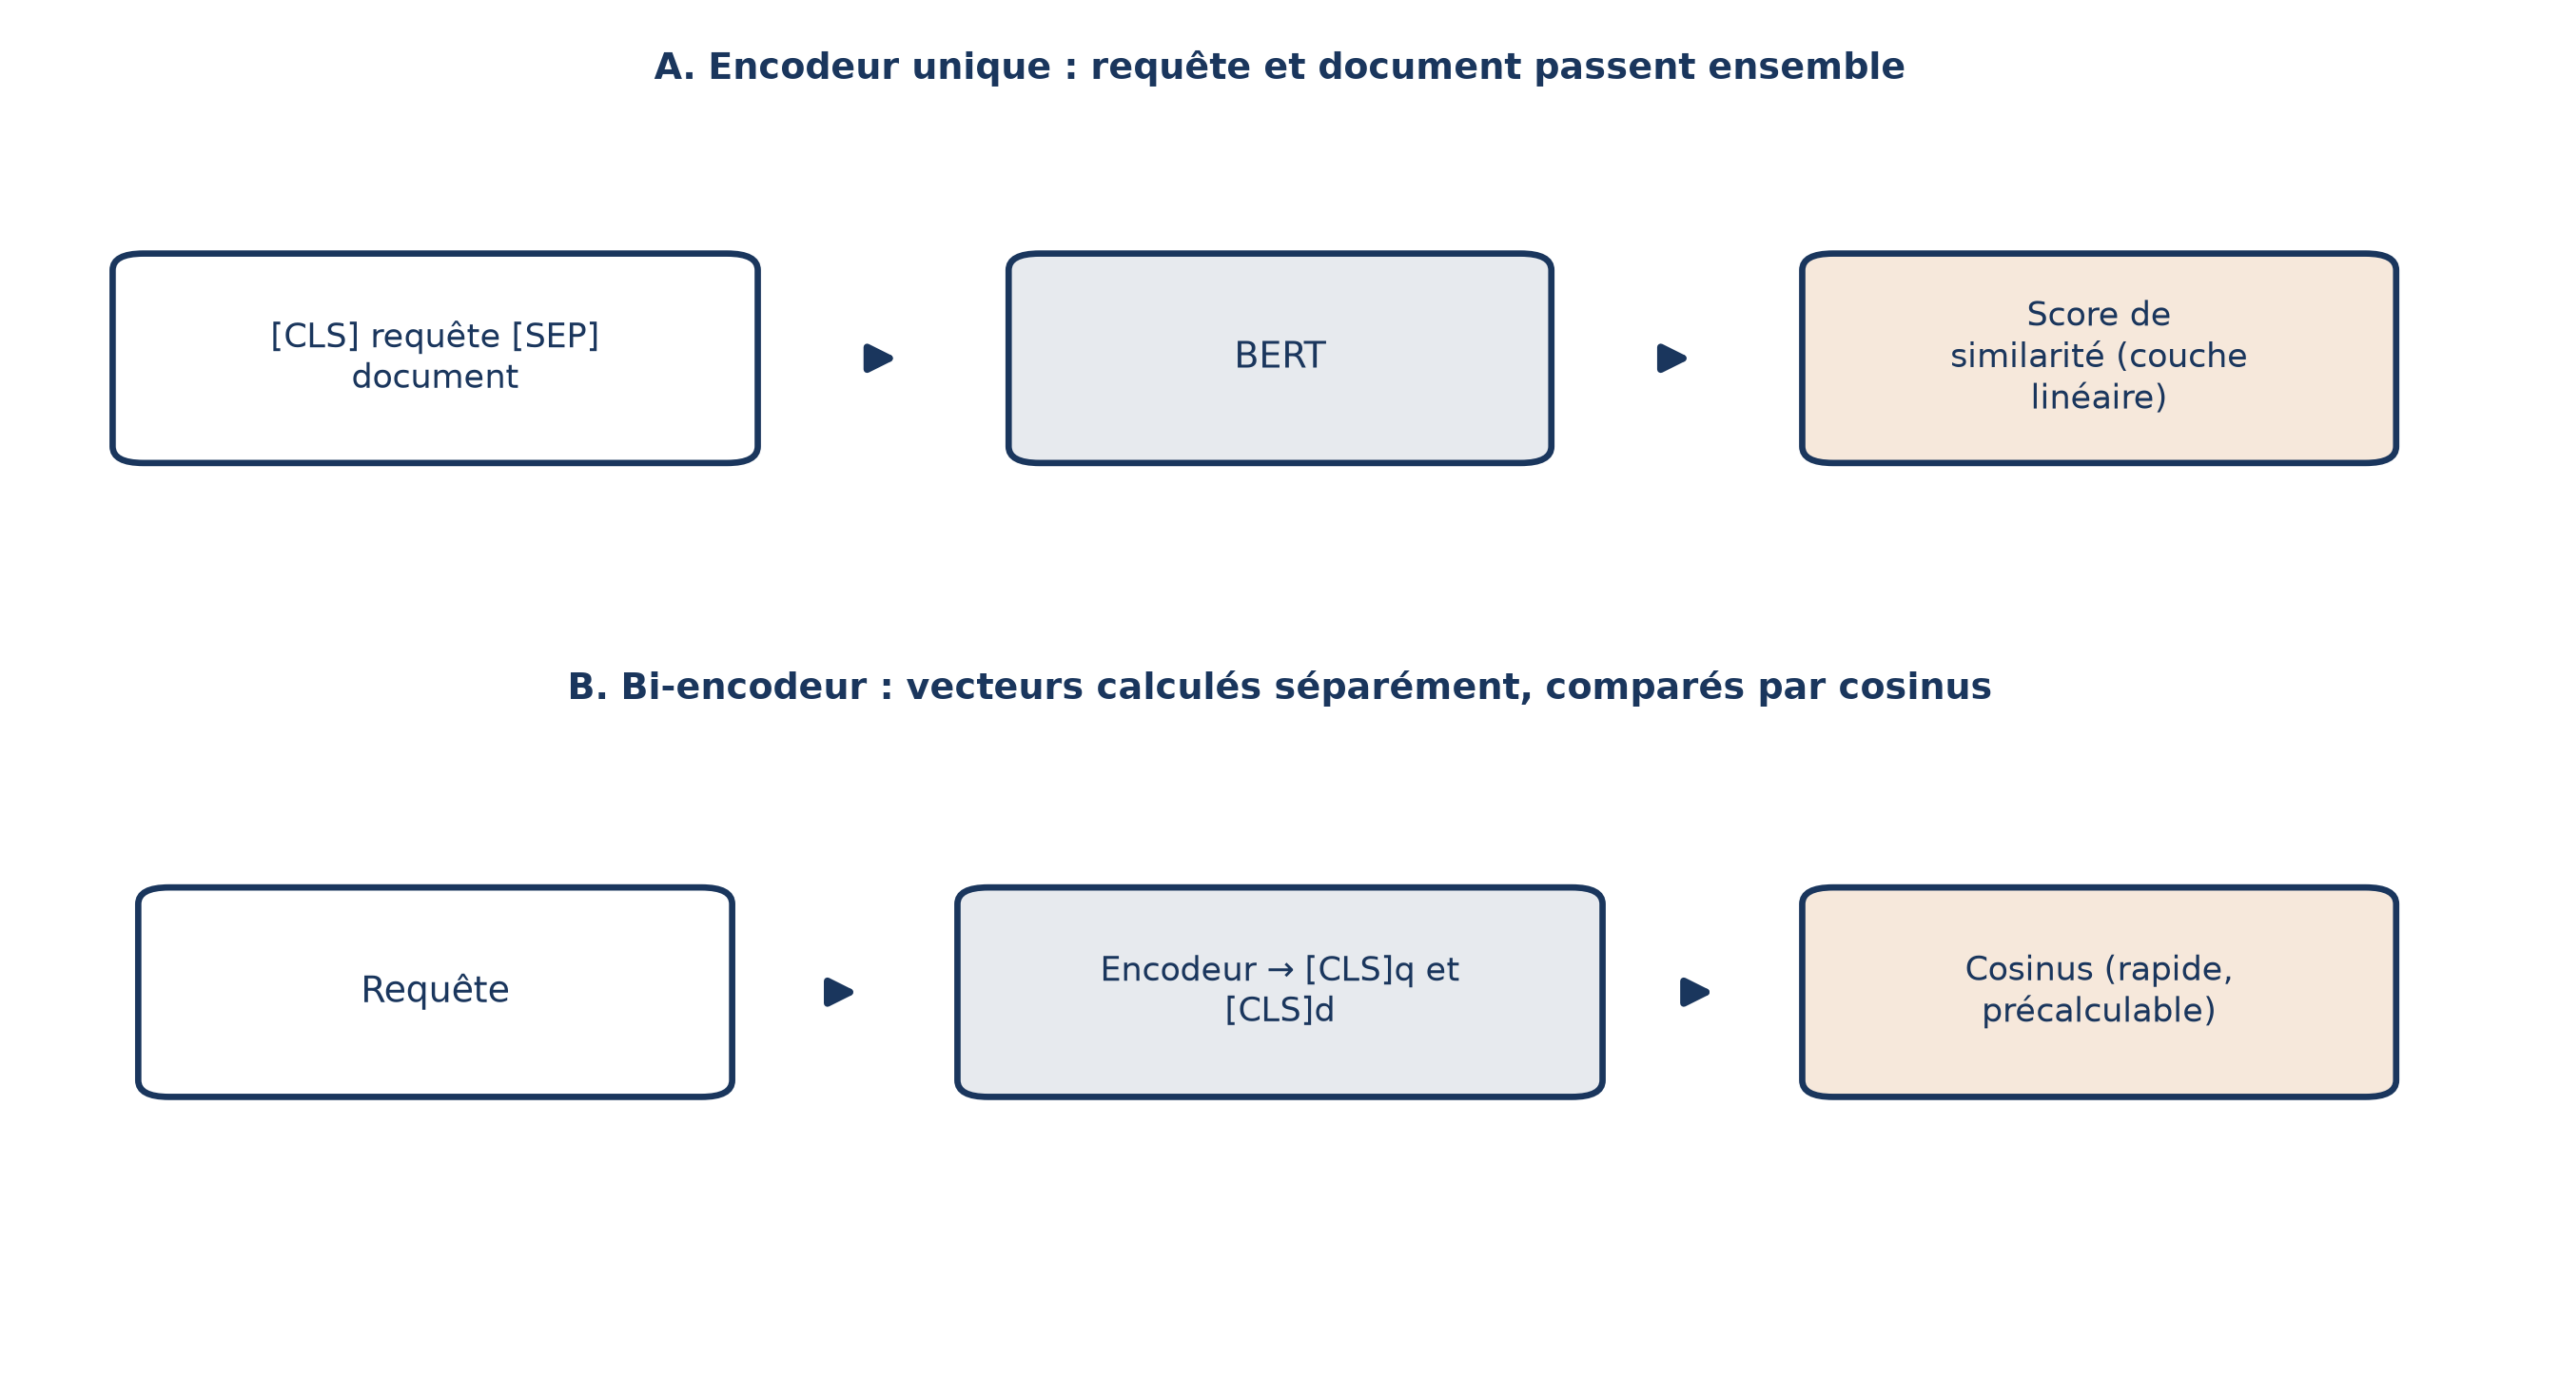
On donne au modèle la question et le document en même temps, au format [CLS] question [SEP] document. L’auto-attention bidirectionnelle circule alors sur tous les jetons : la représentation du document tient compte de la question, et inversement. La représentation du jeton [CLS] passe ensuite dans une couche linéaire qui produit le score de similarité ; c’est cette couche que l’on ajuste.
Deux contraintes pèsent sur ce montage. D’abord, la taille : pour BERT, le contexte est de 512 jetons, question et document compris, donc on traite des fragments qui ne se recouvrent pas plutôt que des documents entiers. Ensuite, le coût : il faut repasser la question avec chaque document du corpus.
Second montage : le bi-encodeur
Pour réduire ce coût, on a conçu le bi-encodeur. Un encodeur extrait la représentation de la question, notée [CLS]q, et un autre celle de chaque document ou fragment, notée [CLS]d. Les représentations des documents se calculent une fois pour toutes et se rangent dans une base ; à l’arrivée d’une question, il suffit de la comparer à tous les vecteurs de la base.
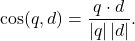
Ici  est le vecteur de la question,
 celui du document,
 leur produit scalaire et
 ,
 leurs longueurs. Le résultat ne dépend que de l’angle : plus il est proche de 1, plus les deux textes se ressemblent.
| Encodeur unique | Bi-encodeur | |
|---|---|---|
| Ce que reçoit BERT | question et document ensemble | question d’un côté, document de l’autre |
| Interactions entre les mots | toutes conservées | en partie perdues |
| Documents | repassés à chaque question | vecteurs calculés d’avance, rangés en base |
| Vitesse | lent | rapide |
Reclasser des résultats : le code
Voici le premier montage au travail. Une recherche a déjà ramené des documents ; il s’agit de les remettre dans l’ordre de leur pertinence pour la question, avec un BERT préentraîné.
def rerank_documents(query, documents):
    """
    Reranks the retrieved documents based on their relevance to the
query using a pre-trained
    BERT model.
    Args:
        query (str): The user's query.
        documents (list): A list of documents retrieved from the
search.
    Returns:
        list: A list of reranked documents, sorted by relevance.
    """
    inputs = [rerank_tokenizer.encode_plus(query, doc, return_
tensors='pt', truncation=True, padding=True) for doc in documents]
    scores = []
    for input in inputs:
        outputs = rerank_model(**input)
        logits = outputs.logits
        probabilities = F.softmax(logits, dim=1)
        positive_class_probability = probabilities[:, 1].item()
        scores.append(positive_class_probability)
    ranked_docs = sorted(zip(documents, scores), key=lambda x: x[1],
reverse=True)
    return [doc for doc, score in ranked_docs]
Ce code suppose déjà chargés rerank_tokenizer (le découpeur de texte en jetons) et rerank_model (le modèle BERT), ainsi que F, les fonctions de PyTorch.
Lis-le en trois temps. Pour chaque document, encode_plus(query, doc, ...) prépare la question et le document ensemble, exactement comme dans le montage à encodeur unique. Le modèle rend alors des scores bruts (logits), que F.softmax convertit en probabilités. Enfin, probabilities[:, 1] isole la probabilité de la classe positive, qui sert de note au document.
La dernière ligne trie les documents par note décroissante. Comme ce montage repasse la question avec chaque document, il est logique de ne l’appliquer qu’à une courte liste déjà retrouvée plutôt qu’à tout un corpus.
La famille BERT : variantes et allègements
BERT a fait école, et plusieurs variantes en sont nées. RoBERTa en est une. SpanBERT masque un segment entier plutôt qu’un seul jeton, avec de meilleurs résultats : le trou de l’exercice d’ouverture devient plus large, et la devinette change. SciBERT, lui, est adapté à un domaine.
Pour alléger, on distille : DistilBERT est une version distillée de BERT. Un modèle distillé capte les connaissances d’un modèle bien plus grand sans perte notable de performance, tout en étant beaucoup plus maniable.
Une autre voie ne touche presque pas au modèle. Les adaptateurs sont de petites couches ajustables, glissées à l’intérieur des blocs et construites comme un autoencodeur. Si les couches du modèle ont 1 024 dimensions, un adaptateur projette vers 24 puis reprojette vers 1 024, ce qui représente moins de 50 000 paramètres par adaptateur. Lors de leurs débuts, ils ont rattrapé l’ajustement complet de BERT pour seulement 3,6 % de paramètres supplémentaires à entraîner, là où la méthode classique les entraîne tous.
📌 À retenir La famille BERT décline une même idée dans trois directions : changer l’exercice de masquage (SpanBERT), changer le domaine (SciBERT), réduire le coût (DistilBERT, adaptateurs).
BERT face aux modèles qui génèrent
Les modèles de type GPT font le choix inverse : ils sont causaux, chaque jeton ne voit que son passé, et ils produisent le texte un jeton à la fois. Les grands modèles de langage actuels sont, pour la plupart, des décodeurs seuls. Les modèles à encodeur seul, dont la famille BERT pour l’embedding de texte à l’ancienne, sont devenus rares.
L’architecture encodeur-décodeur n’a pas disparu pour autant : elle sert de nombreux modèles d’autres modalités. Whisper, populaire pour la transcription audio, emploie un encodeur pour traiter le son et un décodeur pour générer les jetons de texte.
Côté embeddings, le paysage se divise en deux. D’un côté, des modèles bâtis comme BERT, sous le milliard de paramètres ; de l’autre, des modèles dérivés de grands modèles de langage, qui montent jusqu’à huit milliards et affichent des capacités nettement supérieures.
Quatre idées reçues sur BERT
« Il comprend si bien qu’il rédige aussi bien »
Non : un encodeur dressé par masquage se prête mal à la génération, contrairement aux décodeurs. Lire dans les deux sens et écrire de gauche à droite sont deux métiers différents.
« Il lit n’importe quel document en entier »
Sa fenêtre est de 512 jetons, question comprise. Au-delà, il faut découper les documents en fragments avant de les lui présenter.
« Il apprend sur tout le texte à chaque passage »
Pas tout à fait : avec le masquage, seuls 15 % des jetons nourrissent l’apprentissage. C’est le prix à payer pour que le modèle voie les deux côtés du trou.
« Puisqu’il est devenu rare, il ne sert plus à rien »
Ce serait aller trop vite. Les modèles de type BERT servent encore à des tâches simples et sensibles à la latence, comme la classification, là où la rapidité de réponse compte.
⚠️ Piège « Bidirectionnel » ne veut pas dire « meilleur partout ». C’est un outil pour comprendre un texte déjà écrit : pour en produire un, on prend l’architecture inverse.