Dans la documentation d’un moteur d’inférence, deux noms se suivent comme des jumeaux : FlashAttention, PagedAttention. Même suffixe, même rayon, et pourtant ils ne s’occupent pas de la même chose : l’un touche à la manière de calculer l’attention, l’autre à l’endroit où l’on range ce qu’elle laisse derrière elle. À la fin, tu sauras dire lequel fait quoi, et pourquoi on n’a jamais à choisir entre les deux.
Sommaire
- L’essentiel en 30 secondes
- Deux noms jumeaux, deux métiers différents
- L’atelier et l’entrepôt : deux mémoires, deux vitesses
- FlashAttention : calculer sur le plan de travail
- Le cache KV, ce locataire qui grossit
- PagedAttention : ranger par pages plutôt que d’un seul tenant
- Trois idées reçues à écarter
- Où les trouver en pratique
L’essentiel en 30 secondes
- FlashAttention est une série de noyaux d’attention qui réduisent les lectures et écritures en mémoire : même opération mathématique, sans stocker de grosses matrices intermédiaires.
- PagedAttention est une technique de gestion mémoire : elle range le cache KV en pages de taille fixe, ce qui réduit fragmentation et duplication.
- Elles ne règlent pas le même problème : l’une le calcul, l’autre la mémoire.
- Ni l’une ni l’autre ne dégrade les réponses : ce sont des optimisations sans perte de qualité.
- L’attention reste quadratique : elles changent la façon de l’exécuter, pas sa complexité.
Deux noms jumeaux, deux métiers différents
Commençons par les définitions les plus courtes possibles. FlashAttention désigne une série d’articles de recherche et de noyaux d’attention optimisés, conçus pour réduire les lectures et écritures en mémoire. PagedAttention désigne une technique de gestion mémoire : elle stocke le cache KV en pages de taille fixe.
Mises côte à côte, les deux idées se distinguent presque ligne à ligne :
| FlashAttention | PagedAttention | |
|---|---|---|
| Ce qu’elle touche | le calcul de l’attention | le rangement du cache KV |
| Ce qu’elle évite | l’écriture puis la relecture de grosses matrices intermédiaires | la fragmentation et la duplication de la mémoire |
| Là où elle rapporte | les charges limitées par le calcul (prefill, vidéo) | les grands caches, les longs contextes |
| Qualité des réponses | inchangée | inchangée |
Garde cette image en tête pour la suite : FlashAttention, c’est une façon de cuisiner ; PagedAttention, une façon de ranger le garde-manger. Deux gestes différents, pour un même repas.
L’atelier et l’entrepôt : deux mémoires, deux vitesses
Pour comprendre ce que FlashAttention économise, il faut savoir que le GPU possède deux sortes de mémoire. La VRAM est la grande : de la mémoire à haute bande passante (HBM3, HBM3e ou HBM4), de quelques dizaines à quelques centaines de gigaoctets. Sur la puce elle-même vit la SRAM, plus rapide et plus chère, qui se compte en kilo- ou mégaoctets, sous forme de caches.
Pense à un cuisinier. L’entrepôt est vaste mais lointain ; le plan de travail est minuscule mais à portée de main. Le travail efficace consiste à rapporter les ingrédients une fois, tout préparer sur le plan de travail, puis ne ressortir que le plat fini. Une implémentation naïve de l’attention fait l’inverse : elle fait trois allers-retours.
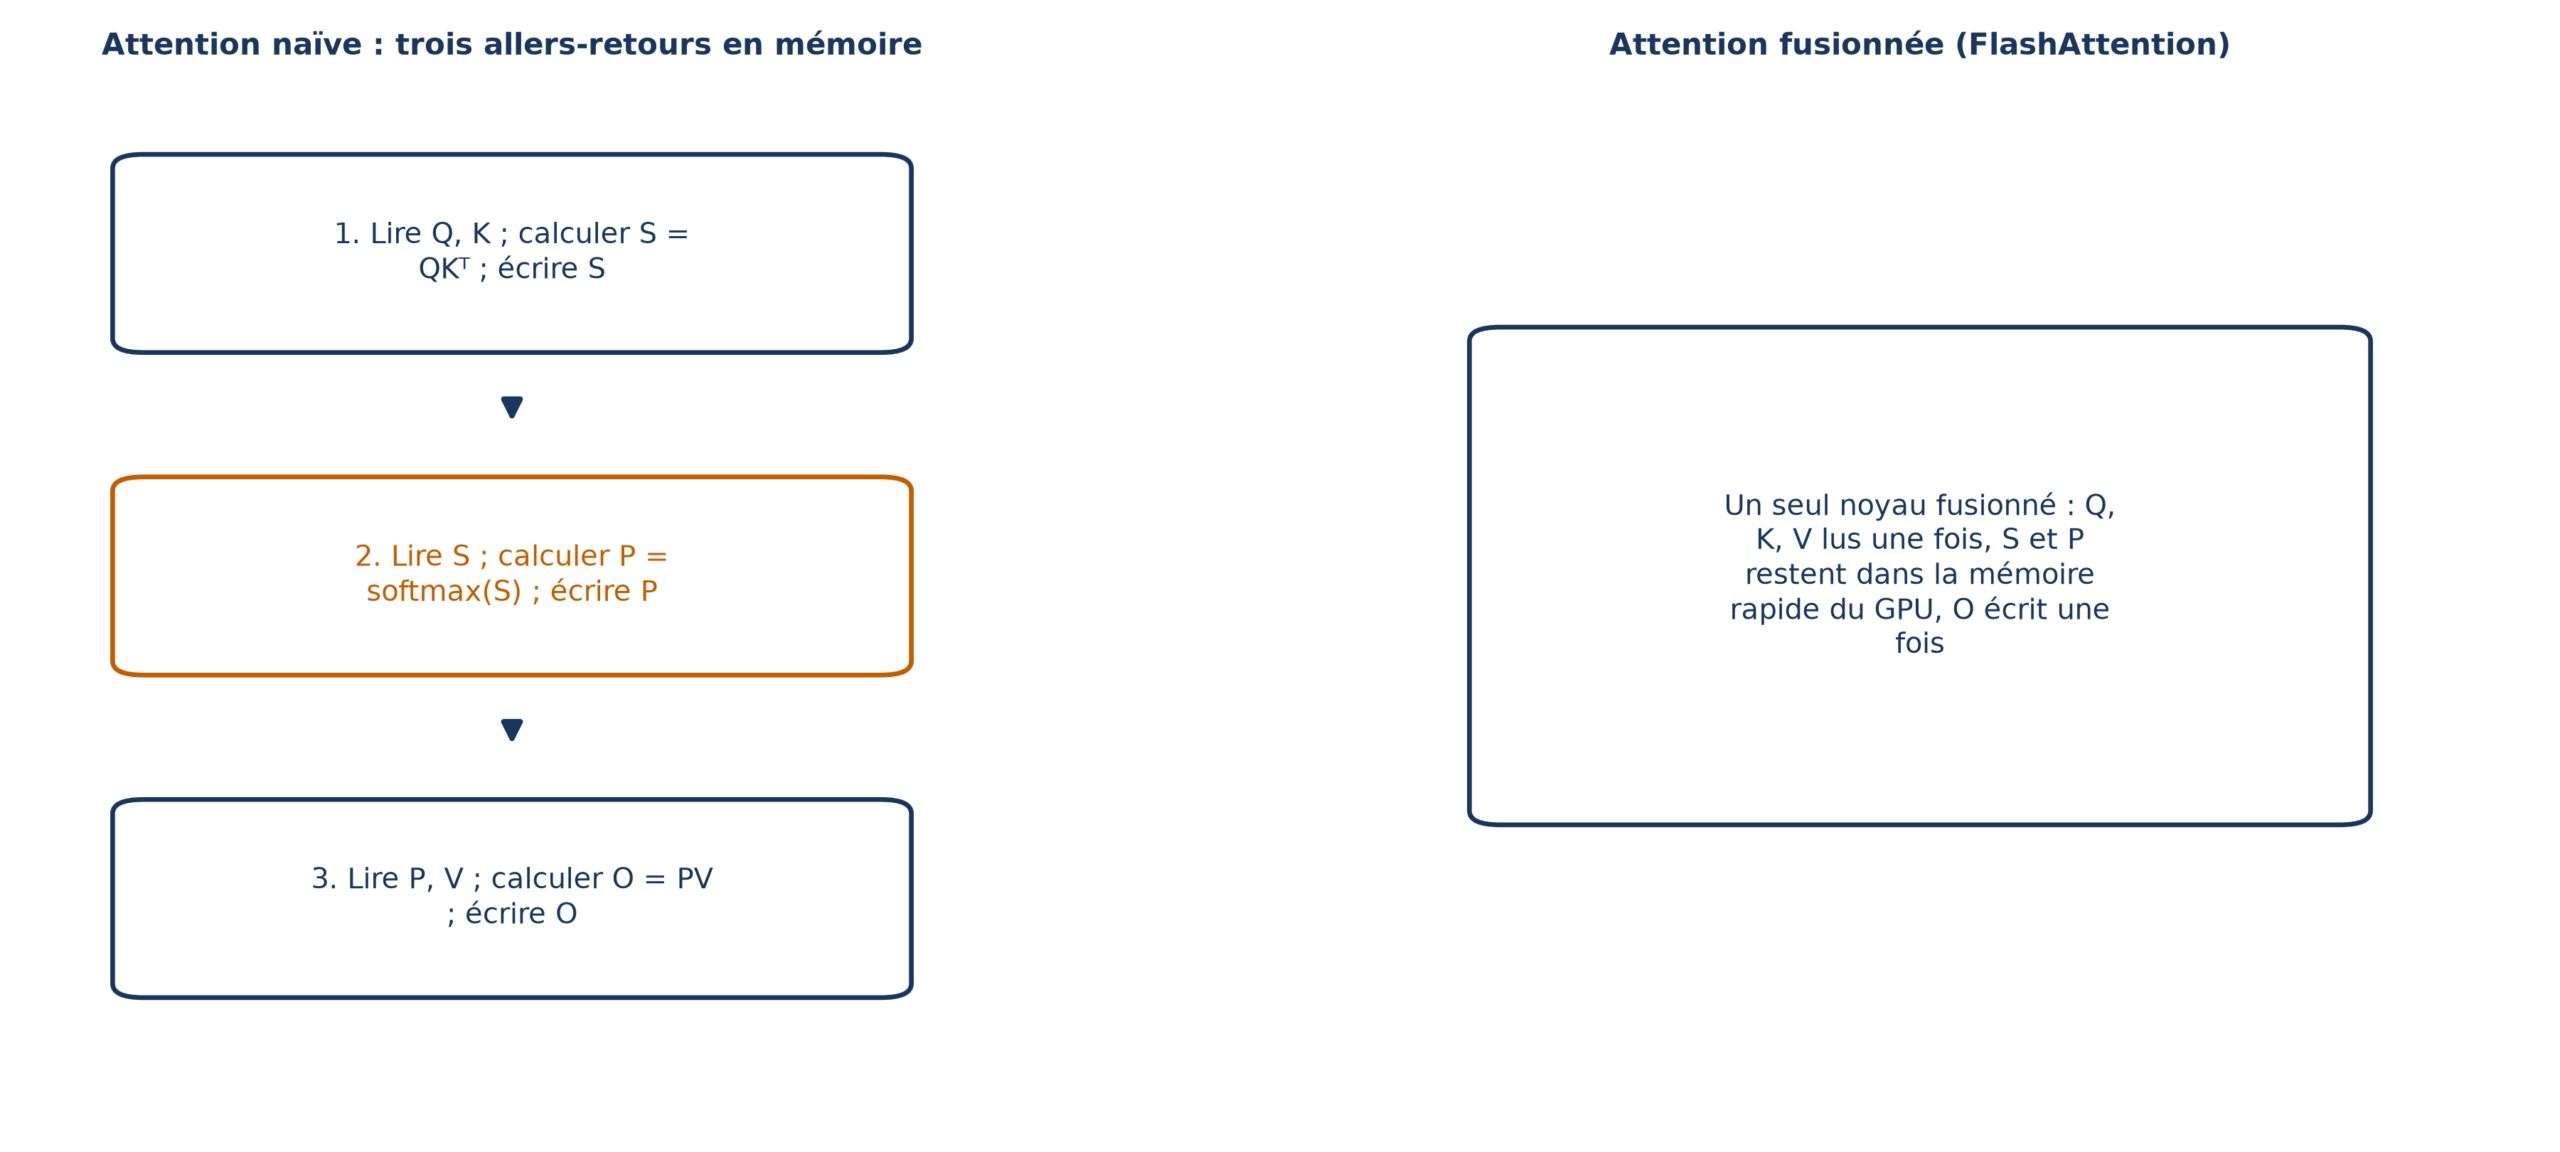
Les ordres de grandeur expliquent pourquoi cela compte. Un de ces tableaux intermédiaires, pour une séquence de 4096 tokens, pèse environ 32 Mio en FP16. Sur un H100, le cache L1 de chaque SM fait 256 Ko, et le cache L2 global 50 Mo au total. Le tableau ne tient donc pas d’un bloc dans la mémoire la plus rapide, ce qui explique qu’on le traite par morceaux.
💡 Intuition Réduire les lectures et écritures, ce n’est pas faire moins de calculs : c’est cesser de payer le trajet jusqu’à l’entrepôt pour des résultats qui ne servent qu’une fois.
FlashAttention : calculer sur le plan de travail
Côté mathématiques, rien ne change. C’est toujours l’attention d’origine :
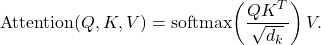
Ici  (requêtes),
 (clés) et
 (valeurs) sont les trois tableaux issus de l’entrée ;
 met chaque requête en face de chaque clé, puis la softmax ramène chaque score à un poids compris entre 0 et 1, avec lequel on pèse les valeurs. Entre le début et la fin, deux tableaux carrés apparaissent : les scores
 et les poids
 . FlashAttention a pour principe de traiter l’attention par petits blocs plutôt que de stocker ces grandes matrices intermédiaires, d’où un calcul plus rapide et moins de mémoire utilisée.
Le prix de cette sobriété, c’est la complexité du code. L’algorithme d’attention traditionnel tient en quelques dizaines de lignes ; FlashAttention en demande des dizaines de milliers, pour exprimer la même opération de façon plus économe sur un GPU précis. Les compilateurs repèrent seuls les fusions simples, mais pas celle-là : elle exige des noyaux fusionnés à la main, branchés comme modules d’extension au moment de l’inférence.
Ce travail sur mesure se retrouve dans les versions successives. De nombreux modèles d’images utilisent d’emblée FlashAttention 2, mais les versions 3 et 4 de FlashAttention donnent de meilleures performances sur Hopper et Blackwell respectivement. La version 3 s’appuie sur CUTLASS, une bibliothèque de gabarits pour écrire des noyaux performants ; la version 4 repose beaucoup sur le découpage en tuiles des chargements, des calculs et des écritures, exécutés dans des pipelines asynchrones.
Porter des noyaux écrits à la main d’une génération de GPU à la suivante demande un effort d’ingénierie substantiel : un noyau pensé pour un H100 n’exploite sans doute pas un B200, et l’inverse peut être incompatible avec Hopper. Là où FlashAttention rapporte le plus : le prefill des LLM et la génération de vidéo, deux charges limitées par le calcul.
Le cache KV, ce locataire qui grossit
Passons à l’autre jumeau, avec un cas simple. Un modèle écrit son quinzième jeton. Pour cela, il lui faut tout le contexte précédent : sans mémoire, il recalculerait les clés et les valeurs des jetons 1 à 14, d’où un coût quadratique. Le cache KV garde ces clés et ces valeurs : chacune n’est calculée qu’une fois, et l’attention n’a plus à traiter que le nouveau jeton, pour un coût proche du linéaire.
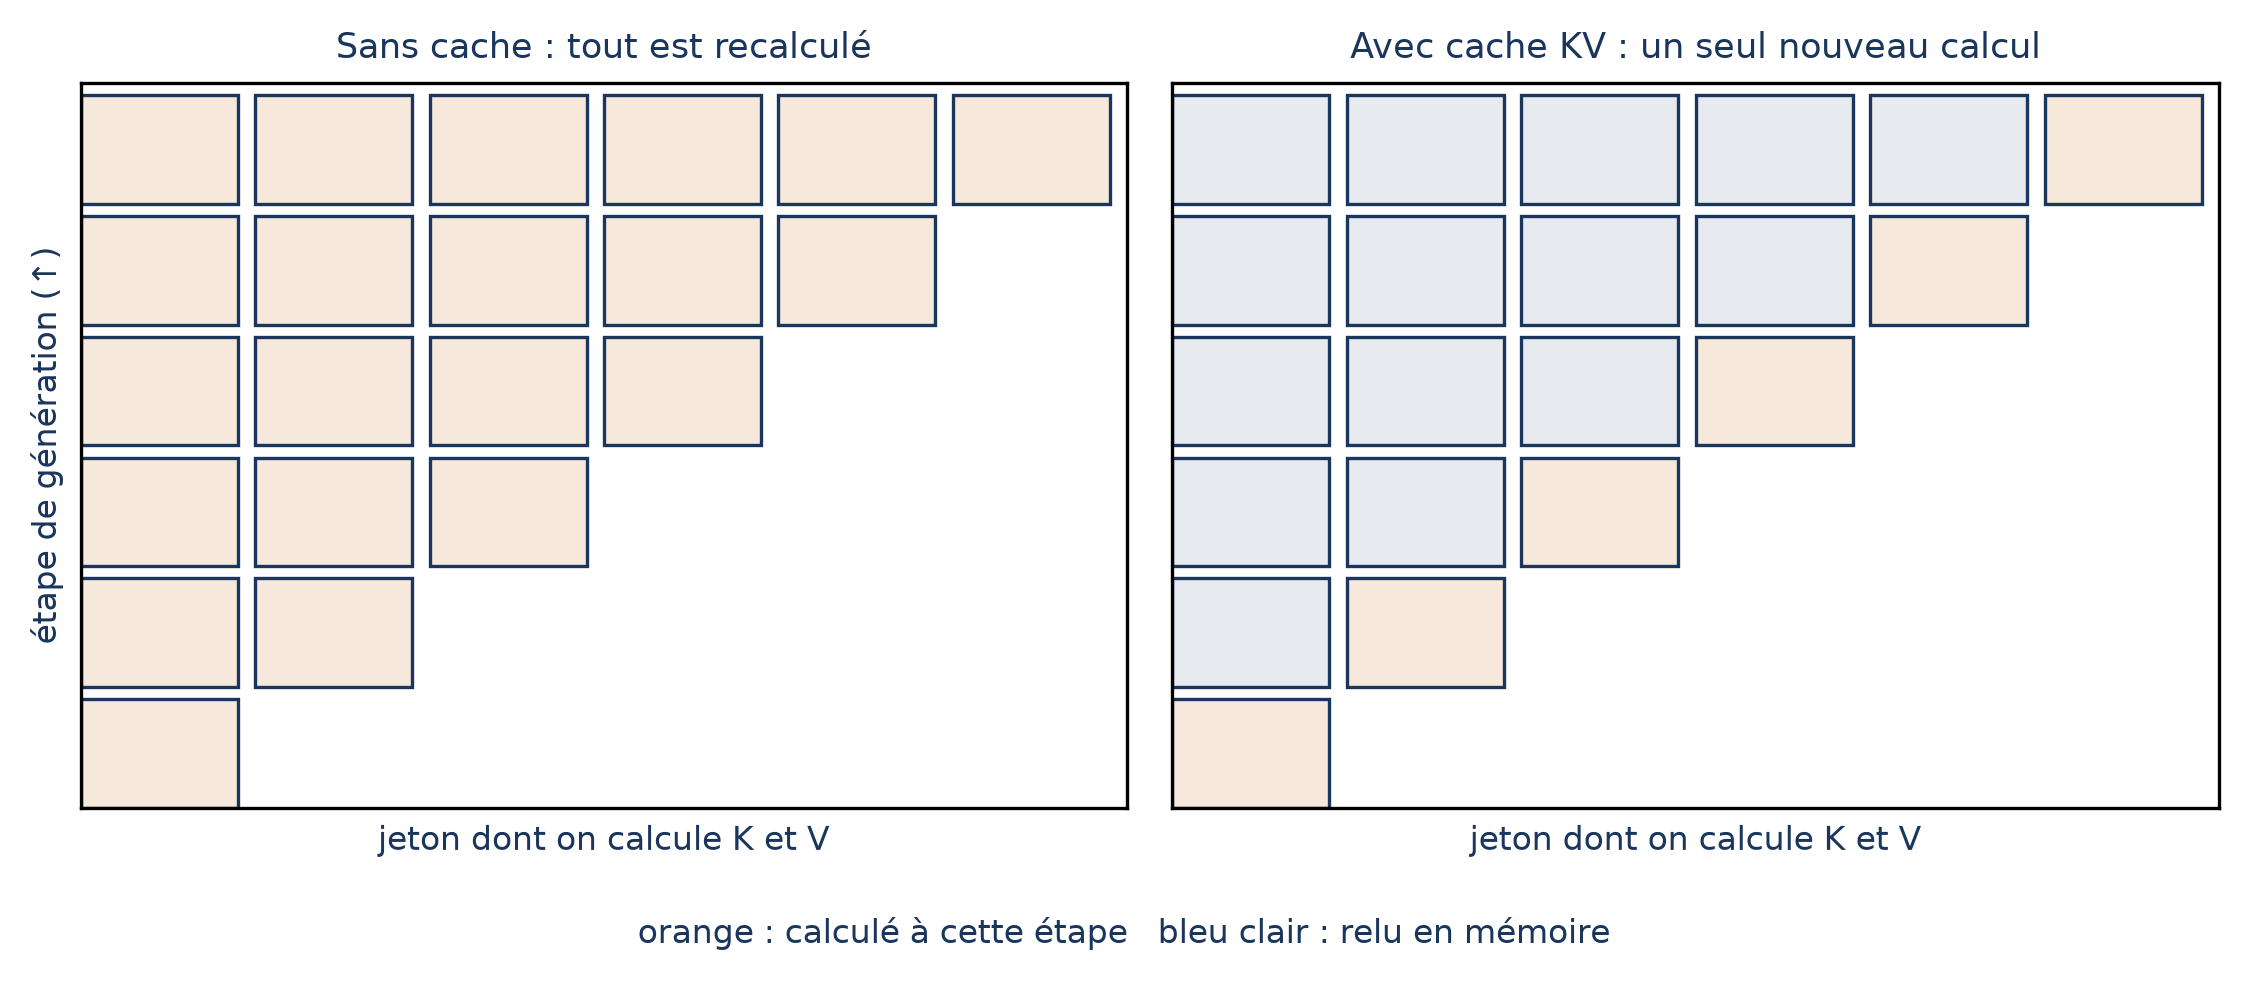
Cet espace n’est pas anodin. Le cache se conserve pour chaque jeton, dans chaque tête d’attention de chaque couche, ce qui limite la taille de fenêtre de contexte utilisable. Comme règle de budget, prévois en plus des poids du modèle une marge d’au moins 50 % pour lui, davantage pour les longs contextes ou les grandes tailles de lot. Sans cette marge, l’inférence est lente ou plante.
Un autre coût s’ajoute à la place prise : les caches KV prennent du temps à lire. Et si chaque cache doit occuper un seul bloc continu de mémoire, la VRAM se découpe peu à peu en trous inutilisables : c’est la fragmentation, que PagedAttention est là pour combattre.
PagedAttention : ranger par pages plutôt que d’un seul tenant
L’idée de PagedAttention (« attention paginée ») est empruntée aux systèmes d’exploitation : elle gère le cache KV comme un système de mémoire virtuelle. Au lieu d’un bloc continu, le cache est découpé en petites pages de taille fixe, accessibles par une table de correspondance qui dit où chacune se trouve.
Imagine un roman dont chaque partie serait rangée dans un rayon différent de la bibliothèque, avec un sommaire qui indique le rayon de chacune. Tu lis dans l’ordre sans que les parties aient besoin d’être voisines. Pour le cache, cela signifie qu’il se loge dans des emplacements dispersés, sans exiger un seul tenant.
Les bénéfices décrits tiennent en trois mots : moins de fragmentation, moins de duplication, et une consommation réduite sur les longs contextes, avec à la clé une latence moindre. Aucun calcul n’est modifié ; seul l’endroit où l’on range change.
📌 À retenir FlashAttention agit sur l’étape de calcul de l’attention, PagedAttention sur la mémoire qui conserve son historique. Elles s’ajoutent l’une à l’autre.
Trois idées reçues à écarter
« Ce sont deux versions de la même optimisation »
Non. Elles visent deux endroits différents de la chaîne : le noyau qui calcule, et la gestion mémoire du cache. Ce sont deux approches générales, distinctes, pour optimiser l’attention standard, et l’une n’a pas vocation à remplacer l’autre.
« Elles rendent l’attention moins coûteuse sur le papier »
Elles ne touchent pas à la complexité : l’attention reste quadratique avec la longueur de la séquence. Pour changer cela, il faut un autre algorithme, comme l’attention à fenêtre glissante, qui regarde seulement les  derniers tokens, mais qui sacrifie un peu de qualité pour gagner du temps et de la place. FlashAttention et PagedAttention restent du côté des améliorations d’implémentation, sans perte, ce qui compte car de petites erreurs d’attention s’accumulent vite.
« Elles ne concernent que le texte »
Les modèles d’images et de vidéos ont eux aussi une attention exigeante en calcul. Pour eux, l’optimisation commence par la sélection des noyaux : on essaie FlashAttention, DeepGemm, CuTe ou CUTLASS pour voir lesquels conviennent le mieux au modèle.
Où les trouver en pratique
Bonne nouvelle : tu n’as presque jamais à les écrire. La plupart des ingénieurs ne rédigeront jamais leurs propres noyaux, mais la sélection de noyaux, c’est-à-dire le choix du meilleur parmi plusieurs, fait partie de l’optimisation. Elle est le plus souvent automatique : PyTorch comme TensorRT-LLM l’incluent dans leur compilation.
Les briques existent déjà. CUTLASS fournit des gabarits pour écrire des noyaux performants, CuTe des abstractions pour les opérations par tuiles sur les architectures récentes, et FlashInfer une bibliothèque de noyaux d’attention optimisés pour l’inférence des LLM, avec des fonctions d’échantillonnage fusionnées. TensorRT-LLM apporte de son côté un noyau, XQA, pour une attention rapide.
Ces noyaux de bas niveau se logent tout en bas d’une pile logicielle qui va de CUDA et PyTorch jusqu’aux moteurs d’inférence : ils apportent des gains considérables sans que tu aies à y toucher.