Tu poses ta question à un assistant, et pendant un court instant, rien ne s’affiche. Puis le premier mot apparaît, et la suite défile. Ce silence n’est pas une panne : c’est le modèle qui lit, d’un coup, tout ce que tu lui as envoyé. Tu vas voir ce qu’il calcule pendant cette lecture, ce qu’il en garde, et pourquoi elle pèse de plus en plus lourd quand le prompt s’allonge.
Sommaire
- L’essentiel en 30 secondes
- Ce que le modèle reçoit avant d’écrire un mot
- Le prefill en une phrase : lire d’un coup, puis écrire
- Ce que calcule le modèle pour chaque token
- Le cache KV : la trace que laisse la lecture
- Pourquoi un prompt long coûte plus qu’un prompt court
- Trois idées reçues sur le prefill
- Quand le prefill devient le poste qui pèse
L’essentiel en 30 secondes
- Le prefill est la première phase de l’inférence : le modèle traite d’un coup toute la séquence d’entrée.
- Il laisse deux produits : le cache KV et le premier token.
- Chaque token d’entrée reçoit sa requête, sa clé et sa valeur : des calculs parallèles, que les GPU digèrent bien.
- Le coût de l’attention croît avec le carré de la longueur du prompt.
- Le prefill ne domine la charge que si les entrées sont longues et le trafic massif.
Ce que le modèle reçoit avant d’écrire un mot
Imagine que tu construis un assistant censé répondre à « Who won the 2023 Cricket World Cup? » en s’appuyant sur des documents. Il n’envoie pas la question seule au modèle : il va d’abord chercher un passage pertinent dans une base, puis colle question, passage et consignes dans un seul texte.
query = "Who won the 2023 Cricket World Cup?"
retrieved_docs = vector_store.similarity_search(query, k=2)
retrieved_context = retrieved_docs[0].page_content

augmented_prompt = f"""
Given the context below, answer the question.
Question: {query}
Context : {retrieved_context}
Remember to answer only based on the context provided and not from any other
source.
If the question cannot be answered based on the provided context, say I don't
know.
"""
Ici, vector_store est la base de passages déjà indexés, et similarity_search en ramène les k=2 plus proches de la question. Le code garde le premier, l’insère dans le texte avec une consigne stricte (répondre uniquement d’après ce contexte), et range le tout dans augmented_prompt.
C’est ce texte entier, converti en tokens, que le modèle reçoit. La question tient en une ligne ; le passage récupéré, lui, peut être bien plus long. Or la latence augmente beaucoup avec un long prompt, et le coût par requête aussi.
Avant qu’un seul mot de réponse ne sorte, tout ce texte doit donc être lu. Cette lecture a un nom : le prefill.
Le prefill en une phrase : lire d’un coup, puis écrire
Le prefill est la phase où le moteur traite la séquence d’entrée pour calculer l’attention de chaque token d’entrée et ranger le résultat dans un cache KV. Contrairement à ce que l’on pourrait croire, il ne lit pas token après token : son attention parcourt toute la séquence d’entrée d’un coup.
Il se termine par le calcul du premier token. Le moteur de prefill produit alors le cache KV et ce premier token, puis passe la main à la phase de génération, le decode, qui calcule tous les suivants.
💡 Intuition Pense à un traducteur qui lit tout le paragraphe avant de poser le premier mot de sa traduction. Le prefill est cette lecture ; le decode, la rédaction qui s’appuie sur elle.
À quoi sert de lire avant d’écrire ? À ne pas relire. Le cache KV garde les paires clé-valeur de chaque token précédent : au lieu de les recalculer à chaque fois, on les lit en mémoire.
Ce que calcule le modèle pour chaque token
Place-toi à l’entrée du modèle. Ton prompt est un tableau  : une ligne par token, chaque ligne étant le vecteur qui le représente. Trois matrices de poids apprises,
 ,
 et
 , le transforment en trois nouveaux tableaux.
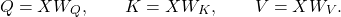
Lis ces trois produits comme trois rôles.  , la requête, est le centre d’attention du moment ;
 , les clés, renseignent le modèle sur les entrées précédentes ;
 , les valeurs, servent à en extraire l’information finale. Comme contient tous les tokens du prompt, un seul produit de matrices donne , et pour chacun d’eux.
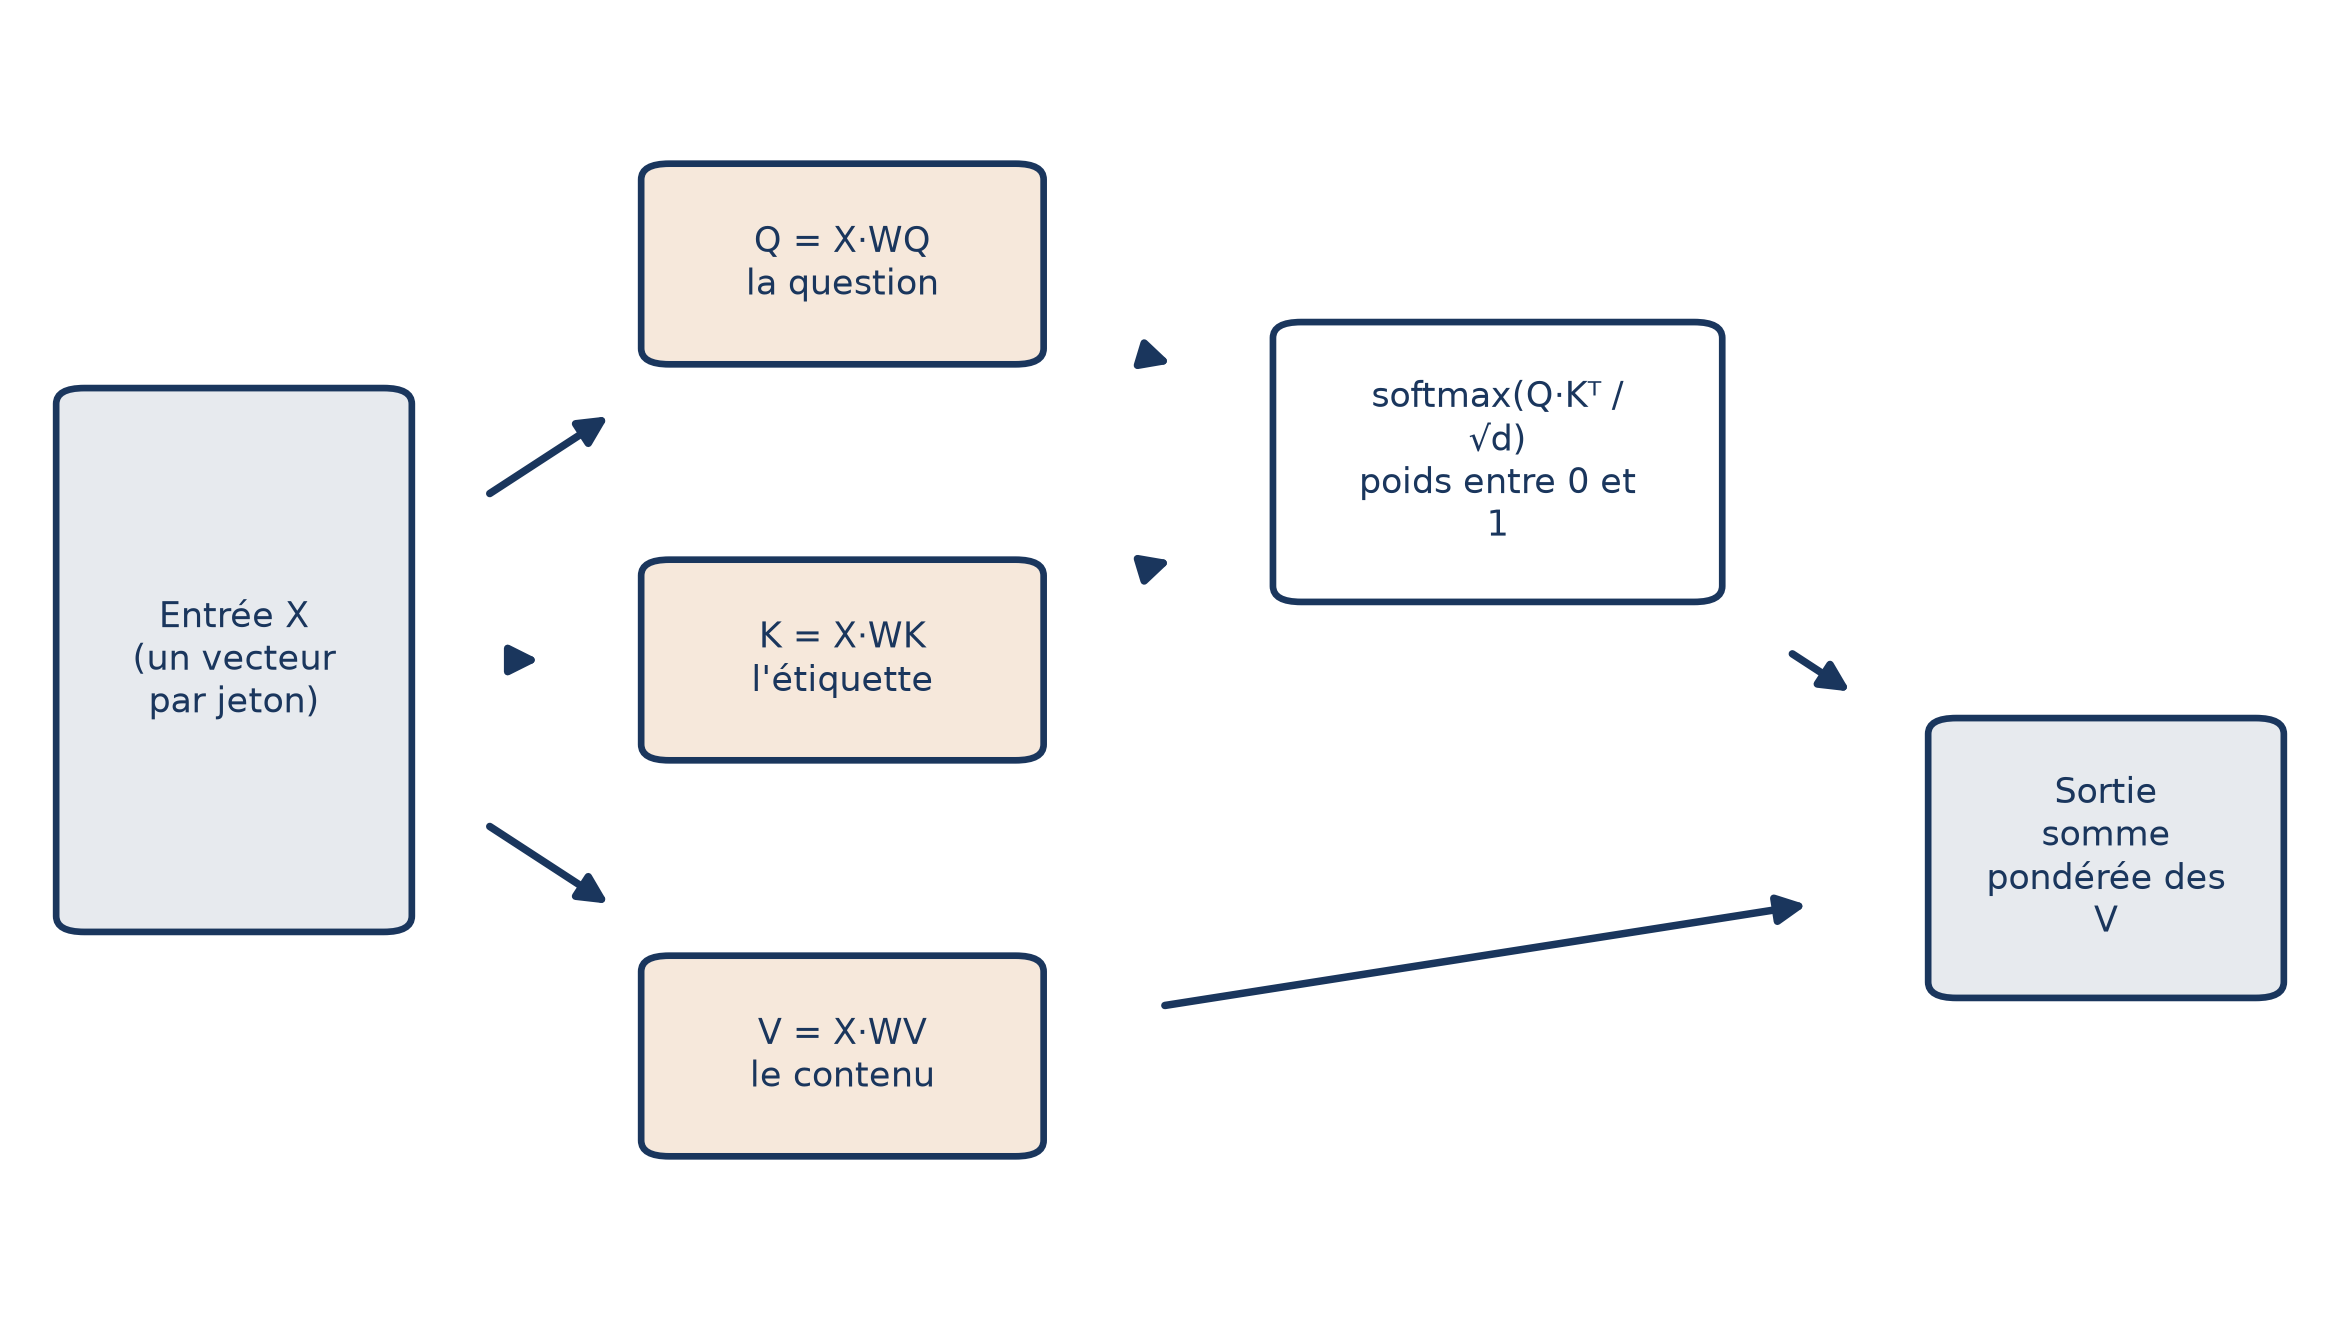
Les poids viennent de la formule d’attention proprement dite :
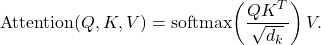
Dans cette expression, chaque requête est mise face à chaque clé par  , et la softmax convertit ces scores en poids entre 0 et 1, qui dosent ensuite les valeurs . Quant à
 , la racine de la dimension des clés, il empêche des produits scalaires trop grands de concentrer toute la masse sur quelques éléments.
Deux détails distinguent le cas d’un LLM. D’abord, un masque causal empêche chaque token de regarder ceux qui le suivent : même si tout est calculé en une fois, un token ne voit que son passé. Ensuite, l’attention est multi-têtes : chaque tête est une opération d’attention, les têtes tournent en parallèle, et chacune peut s’occuper d’une relation différente, comme l’accord sujet-verbe.
Cette organisation explique pourquoi le prefill convient si bien au matériel. Tous les calculs peuvent se faire en parallèle, donc sur GPU, chaque tête étant indépendante. Et l’on relie des mots éloignés sans attendre les pas de temps successifs qu’imposaient les réseaux récurrents.
Le cache KV : la trace que laisse la lecture
À la fin de cette lecture, il reste quelque chose : les clés et les valeurs de chaque token du prompt. C’est le cache KV, un composant standard de l’attention. Il est construit pendant le prefill, utilisé et mis à jour pendant le decode, et vit par défaut dans la mémoire du GPU.
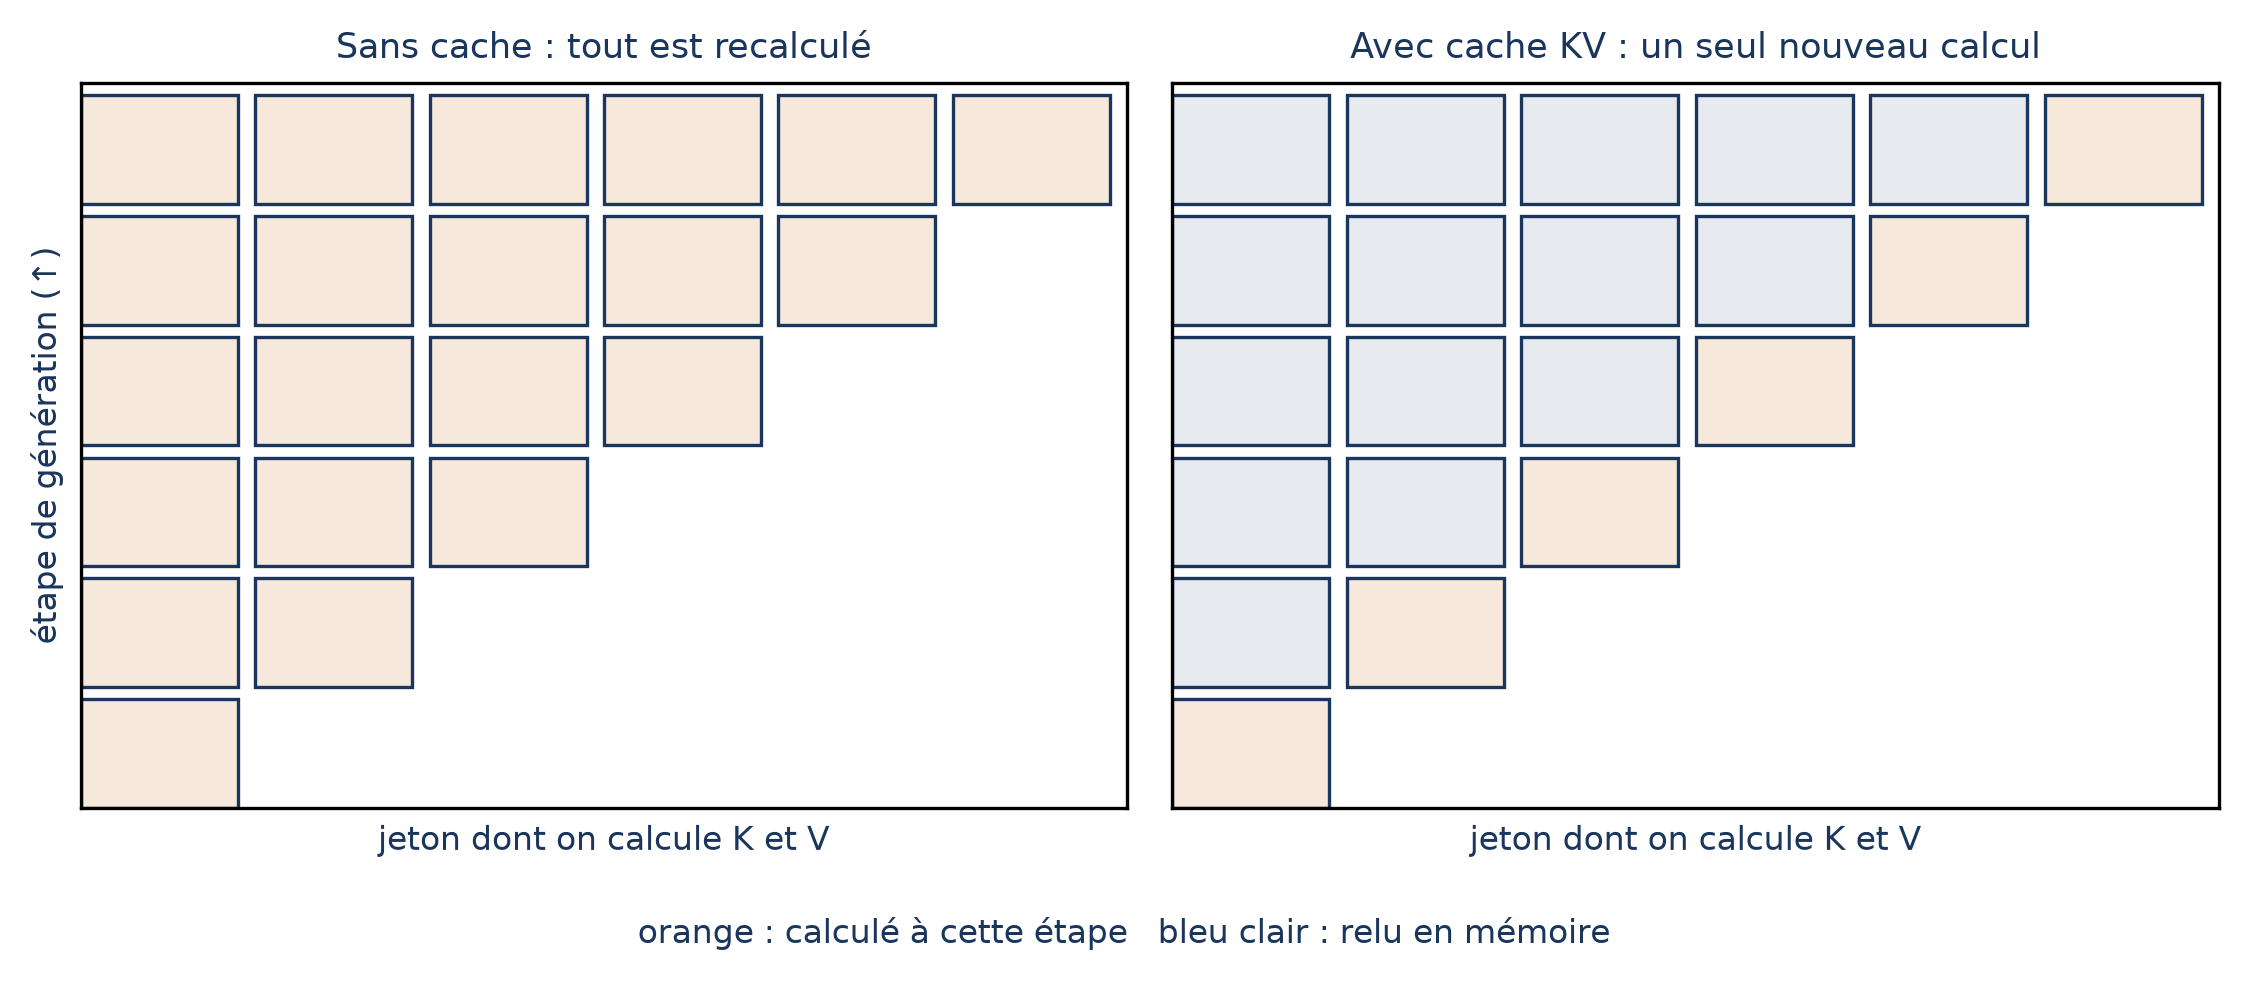
Cette trace n’est pas gratuite. Une séquence devient « long contexte » quand elle produit un cache KV assez grand pour poser problème pendant l’inférence. Selon le modèle, le matériel, le moteur et le trafic, cela arrive au-delà de seuils comme 32 000, 64 000 ou 128 000 tokens.
⚠️ Piège Avec de longues séquences, le cache peut devenir le principal consommateur de VRAM, la ressource même qui limite le decode. Un prefill qui avale un très long prompt prépare donc, sans bruit, un decode à l’étroit.
Pourquoi un prompt long coûte plus qu’un prompt court
Revenons à la formule d’attention. Chaque token y dépend des clés et des valeurs de tous les tokens qui le précèdent : le coût de l’attention croît donc de façon quadratique avec la longueur d’entrée. Pour une séquence de longueur  et une dimension
 , le temps et l’espace s’écrivent :

Le terme en  domine dès que le prompt s’allonge, et le produit scalaire en est le coupable. Mesure ce que cela signifie : doubler multiplie ce terme par quatre. Dans notre assistant, passer d’un passage récupéré à deux fait presque doubler le prompt, donc presque quadrupler la part quadratique de la lecture.
Heureusement, la note n’est pas payée à chaque token. Pendant la génération, grâce au cache KV, l’attention redevient linéaire en pratique. Elle reste malgré tout l’une des parties les plus chères de l’inférence, quels que soient le modèle et l’architecture, et de nombreuses variantes ont été proposées pour la réduire.
Trois idées reçues sur le prefill
« Le prefill, c’est le début de la réponse »
À moitié vrai. Il produit bien le premier token, mais le reste de la réponse relève du decode, un autre moteur dans les systèmes qui séparent les deux phases. Ce que le prefill fait pour l’essentiel, c’est lire et mémoriser, pas rédiger.
« Il avance token par token, comme la génération »
Non. Le prefill traite le prompt en parallèle, alors que la génération produit ses tokens l’un après l’autre. C’est pour cela que la lecture d’un long prompt se fait en une passe massive plutôt qu’en milliers de petits pas.
« Seuls les modèles de texte ont un prefill »
Ce n’est pas si simple. Les modèles d’images et de vidéos génèrent par débruitage itératif, non par génération autorégressive, mais leur attention doit considérer l’objet entier d’un coup, et leur inférence est limitée par le calcul, comme le prefill.
Pour un modèle qui lit des images avec du texte, l’effet est direct : images et vidéos sont converties en tokens visuels, et une représentation haute résolution demande environ quatre fois plus de tokens qu’une basse résolution. Quatre fois plus de tokens à lire, c’est un prefill nettement plus lourd.
Quand le prefill devient le poste qui pèse
Le prefill mérite des GPU à part dans un cas précis : quand on sépare la lecture de la rédaction, c’est-à-dire quand on désagrège les deux phases. Cette désagrégation n’a de sens que si trois conditions se réunissent.
- Un grand volume de trafic, de cent millions à un milliard de tokens par jour selon la taille du modèle.
- Un modèle d’au moins cent milliards de paramètres.
- Un trafic lourd en prefill, c’est-à-dire de longues séquences d’entrée.
Si l’une des deux premières conditions manque, tu gaspilles probablement du matériel pour un gain minime. Si c’est la troisième, mieux vaut ajouter des réplicas : les moteurs de decode sont plus efficaces pour de courtes séquences ou quand le cache de préfixe réussit.
Le cas d’école est un éditeur de code : de nombreux développeurs y envoient en même temps de gros morceaux de code variés comme contexte, ce qui donne des quantités de tokens, surtout de prefill, sur un LLM de mille milliards de paramètres.
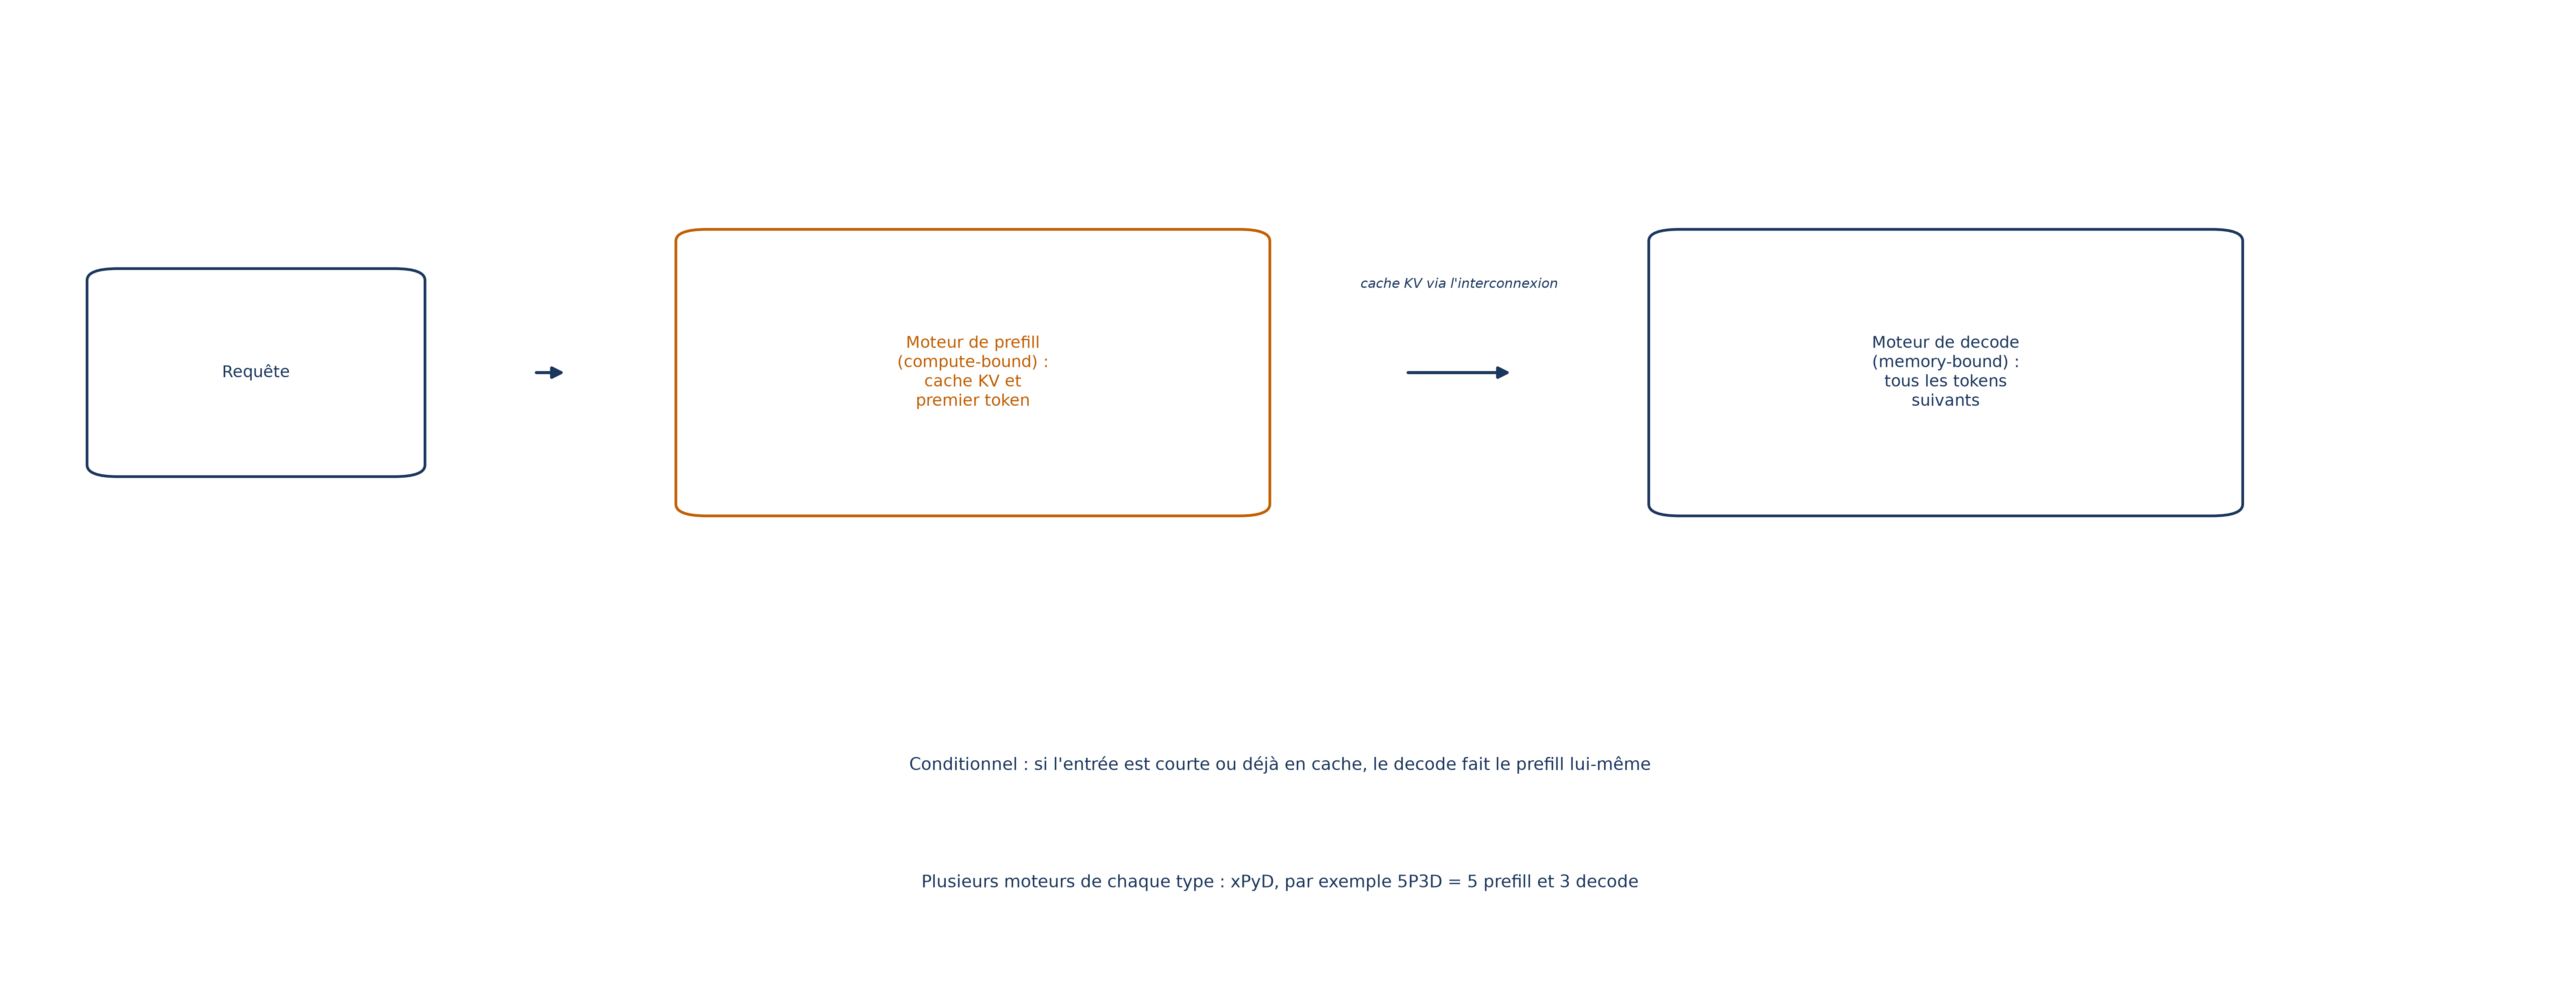
Un avantage de cette séparation : chaque moteur s’optimise pour son travail. Le moteur de prefill, limité par le calcul, demande par exemple un parallélisme tensoriel plus bas que le moteur de decode, limité par la mémoire.
Pour décider si cela te concerne, regarde ton propre trafic. Si tes prompts ressemblent à celui de notre assistant, avec beaucoup de tokens en entrée, le prefill est ton poste principal. Si les entrées sont courtes, ton temps se joue ailleurs, et le prefill restera, pour toi, une simple lecture rapide avant le premier mot.