Colle un long document dans un assistant : il l’absorbe presque d’un bloc. Puis il se met à répondre, et les mots tombent un à un, comme au compte-gouttes. Cette asymétrie n’a rien d’un effet d’affichage : elle vient de la manière dont le modèle fabrique son texte. Tu vas voir ce qu’il fait à chaque tour de boucle, ce qui limite sa vitesse et comment on lit son rythme.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi l’écriture ne peut pas se faire d’un coup
- Anatomie d’un tour de boucle
- Lire le rythme du decode
- Un GPU plus puissant écrit-il plus vite ?
- Le même tour, pour d’autres modèles
- Decode, décodeur, décodage : ne pas les confondre
L’essentiel en 30 secondes
- Le decode est la seconde phase de l’inférence : après la lecture du prompt, le modèle écrit sa réponse en faisant une passe avant par token.
- Il est séquentiel par nature : chaque token dépend du précédent, donc rien ne se produit d’un coup.
- Une passe se termine sur un vecteur de scores, pas sur un mot : un tirage réglable (température, top-k, top-p) choisit le token.
- Son goulot est la bande passante mémoire, pas le nombre d’opérations par seconde.
- Son rythme se lit en tokens par seconde, mais « TPS » recouvre deux mesures : une latence ou un débit.
Pourquoi l’écriture ne peut pas se faire d’un coup
Une fois ton prompt tokenisé puis lu par le prefill, le moteur entre dans le decode. Il y enchaîne des passes avant dans le modèle pour générer les tokens de façon autorégressive : un LLM produit ses nouveaux tokens un par un, en se fondant sur tous les tokens précédents.
Dans sa forme ordinaire, chaque passe produit un seul token. Une réponse de 300 tokens, par exemple, réclame donc 300 passes avant, l’une derrière l’autre.
Pourquoi ne pas lancer toutes ces passes en parallèle, comme le prefill le fait avec les tokens du prompt ? Parce que le token suivant ne peut pas être calculé avant que le précédent existe : chaque token dépend du précédent. Le travail de préparation (tokenisation, embedding, calcul des clés et des valeurs) coûte cher mais se parallélise bien sur un GPU ; la génération, elle, reste séquentielle.
💡 Intuition Écris une phrase à la main : tu ne peux pas fixer le dixième mot avant d’avoir choisi le neuvième, puisque ce choix oriente tout le reste. Le modèle subit le même verrou, token par token.
Anatomie d’un tour de boucle
Que se passe-t-il, concrètement, entre un token et le suivant ? Le schéma ci-dessous montre la boucle complète ; concentre-toi sur ses deux cases du milieu.
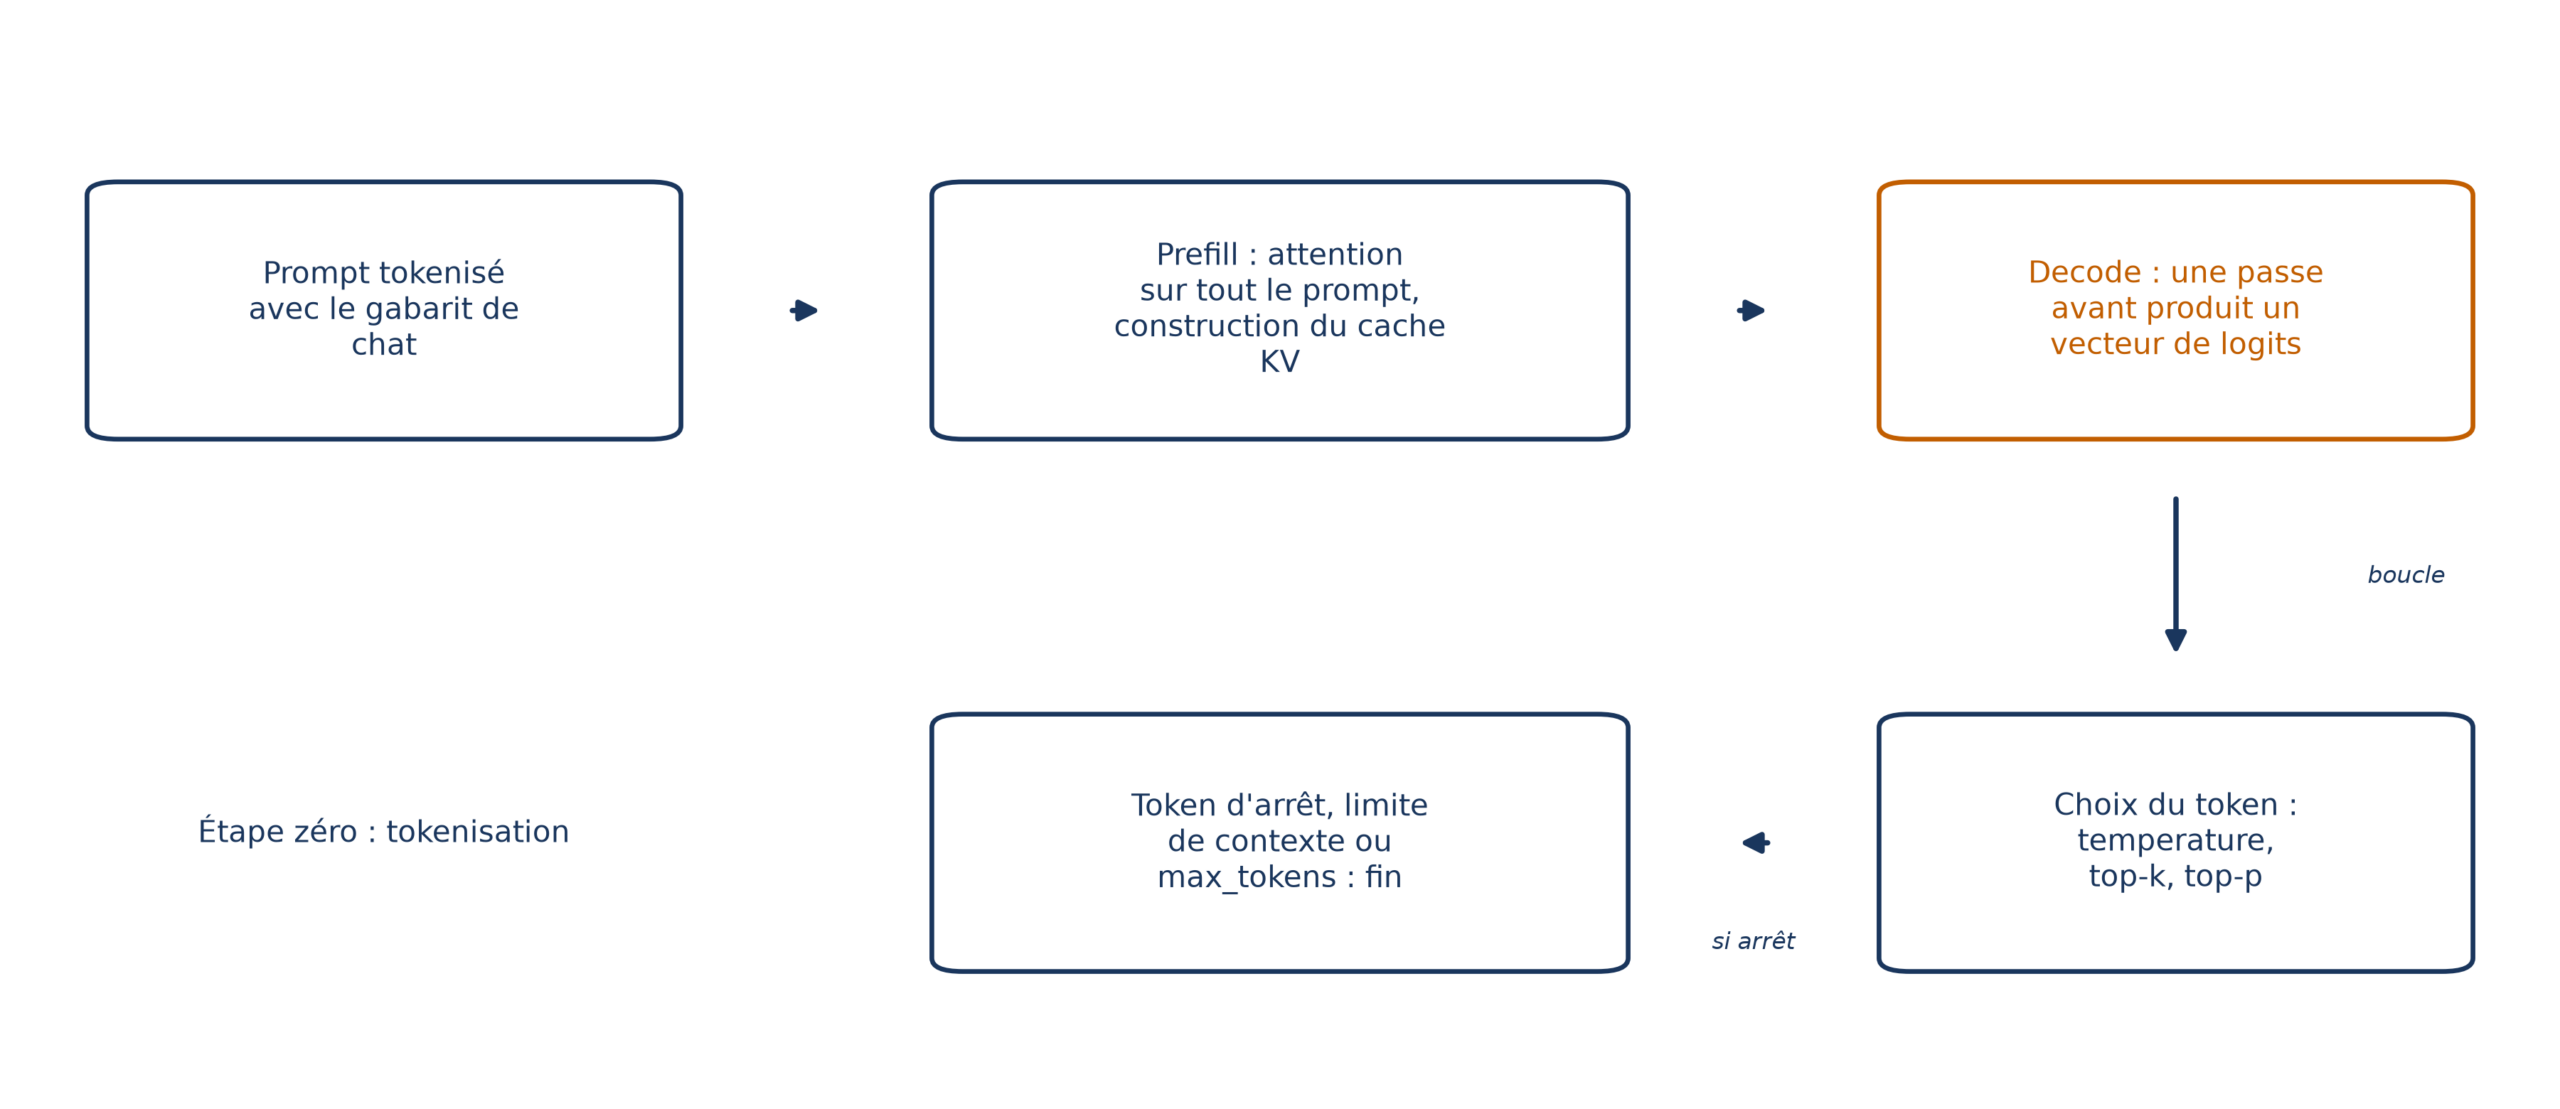
La passe avant sort des scores, pas des mots
Un réseau de neurones renvoie des vecteurs, pas des tokens. La couche de sortie produit donc un vecteur de logits, aussi long que le vocabulaire : un score par token possible. Une fois normalisés, ces scores représentent la probabilité que chaque token du vocabulaire soit la bonne sortie.
Le tirage : où chaque réglage intervient
Le token n’est pas simplement le gagnant du classement : il est choisi par un tirage aléatoire pondéré par ce vecteur de probabilités. Trois réglages l’infléchissent, chacun à un endroit précis de la passe.
| Réglage | Où il agit | Ce qu’il fait |
|---|---|---|
| Température | Sur les logits, avant la normalisation | Les ajuste directement |
| Top-k | Après la normalisation | Garde les k tokens les plus probables, puis renormalise |
| Top-p | Sur les probabilités | Garde le plus petit ensemble de tokens dont les probabilités totalisent p |
Plus ces valeurs sont basses, plus la sortie est prévisible. Avec une température nulle ou un top-k égal à 1, le tirage devient déterministe : le token retenu est alors toujours le plus probable.
Quand la sortie doit suivre un schéma
Pour une sortie structurée, qui suit un schéma comme du JSON, d’autres outils, dont le biais de logits, orientent encore la sortie après chaque passe avant. Ils soutiennent des capacités essentielles comme l’appel d’outils, et leur bonne implémentation compte pour une inférence de qualité.
Le cache KV, vu depuis le decode
Le cache KV, construit pendant le prefill, est mis à jour à chaque token du decode. Comme la valeur d’un nouveau token dépend de tous les précédents, produire le quinzième token sans cache obligerait à recalculer les clés et les valeurs des tokens 1 à 14, pour un coût quadratique. Avec le cache, on les calcule une seule fois et l’attention ne s’applique plus qu’au nouveau token : le coût devient proche du linéaire.
La contrepartie est la mémoire. Chaque token ajoute ses clés et ses valeurs dans chaque tête d’attention et dans chaque couche, et cet empilement plafonne la fenêtre de contexte utilisable.
📌 À retenir Un tour de decode, c’est une passe avant, un vecteur de logits, un tirage, puis un token qui repart en entrée pendant que le cache s’enrichit. Ces passes, avec la construction du cache au prefill, prennent l’écrasante majorité du temps et des ressources.
Lire le rythme du decode
La vitesse du decode se mesure d’abord par la latence inter-token (ITL), le temps qui sépare deux tokens successifs. Le mot « TPS » (tokens per second) est plus piégeux, parce qu’il recouvre deux mesures différentes.
Le TPS perçu est le nombre de tokens par seconde que reçoit un utilisateur après le premier : c’est une latence. Le TPS total est le nombre de tokens générés chaque seconde par tout le service : c’est un débit.
Imagine 50 utilisateurs servis chacun à 100 tokens par seconde : le TPS perçu vaut 100, le TPS total 5 000. Un service peut donc afficher un total impressionnant pendant que chacun reçoit ses mots lentement, puisque le total additionne tous les utilisateurs. La plupart des gens emploient « TPS » au sens du perçu, par utilisateur ; dans le doute, précise duquel tu parles.
Un GPU plus puissant écrit-il plus vite ?
Pas forcément. Le decode fait partie des étapes limitées par la bande passante mémoire, et non par le calcul. Cette bande passante de la VRAM est le débit de pointe entre les cœurs du GPU et la VRAM, via le bus mémoire ; elle alimente toute la hiérarchie de caches.
Les deux chiffres ne se ressemblent pas. Un H100 en FP16 aligne 989 téraFLOPS de calcul dense, mais seulement 3,35 To/s de bande passante. Pendant le decode, c’est le second qui plafonne la vitesse d’écriture, pas le premier.
⚠️ Piège Ce raisonnement vaut à tailles de lot faibles ou moyennes. Dans ce cas, ajouter du calcul revient à dépenser au mauvais endroit, puisque le goulot se trouve ailleurs.
Des fabricants ont d’ailleurs bâti leur offre sur ce constat. Cerebras et Groq atteignent de hauts scores de tokens par seconde en accélérant le decode avec une mémoire ultra-rapide ; d’autres misent plutôt sur l’efficacité énergétique ou sur l’intégration à une plateforme cloud.
Le même tour, pour d’autres modèles
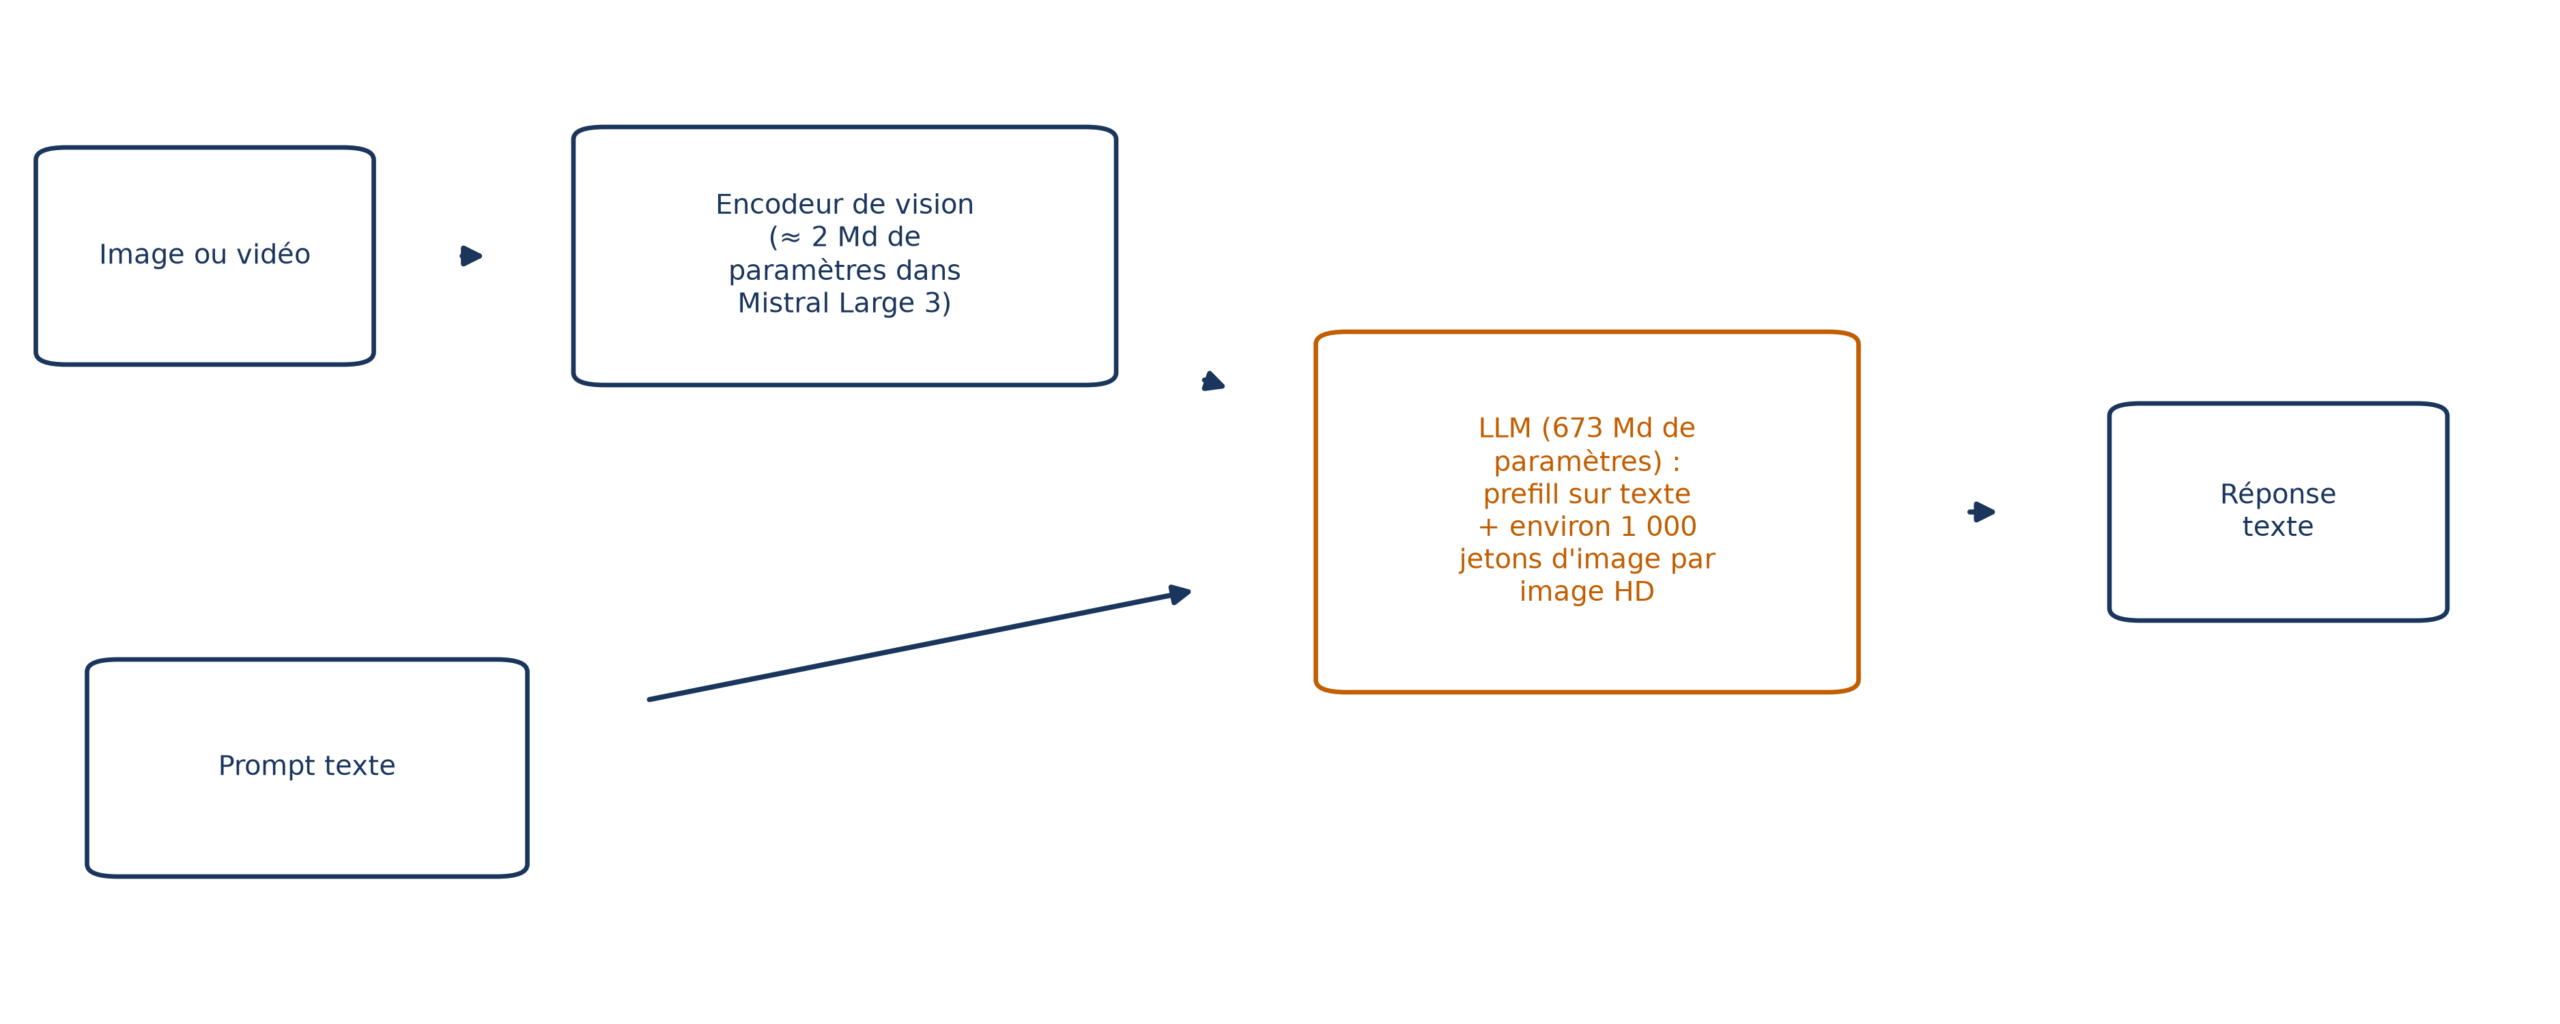
Le decode ne concerne pas que le texte pur. Dans un modèle vision-langage, les images sont d’abord converties en tokens et lues au prefill ; ce qui écrit ensuite la réponse est un LLM, et au decode la mécanique est identique à celle d’un texte seul. Seul change le contexte : plus long, avec un cache KV plus gros.
La reconnaissance vocale et la synthèse vocale rejoignent la même famille, celle de la génération autorégressive de tokens, et reposent sur des architectures voisines : les mêmes moteurs et techniques s’appliquent. Pour une synthèse vocale bâtie sur un LLM, on élargit le vocabulaire de dizaines de milliers de tokens audio ; le modèle génère alors des tokens dont on mesure la vitesse de decode, comme pour un texte.
Decode, décodeur, décodage : ne pas les confondre
Le même radical se cache derrière plusieurs notions qui n’ont pas le même rôle. Les distinguer évite bien des contresens à la lecture d’une documentation.
| Mot | Ce que c’est |
|---|---|
| Decode | La phase de l’inférence qui génère les tokens de façon autorégressive, par des passes avant |
| Décodeur | Une pièce d’architecture qui s’appuie sur une représentation interne pour générer une sortie, texte ou image ; les LLM modernes sont des décodeurs seuls |
| Décodage spéculatif | Une technique qui exploite le calcul disponible pour tenter de produire plusieurs tokens par passe avant |
| Décodeur audio | En synthèse vocale, la pièce qui convertit les tokens audio produits en forme d’onde |
Un LLM moderne est donc un décodeur au sens de l’architecture, et il exécute le decode au sens de la phase. Quand tu croises « décodage » ou « décodeur » dans un texte technique, vérifie de laquelle de ces notions il parle.
Retiens l’image d’ensemble : le decode est une boucle de petits pas, chacun appuyé sur tous les précédents. Sa lenteur, son appétit de mémoire et son vocabulaire découlent de cette seule dépendance.